Florence: A New Foundation Model for Computer Vision

多模态变体—Florence:微软的视觉语言模型 Florence 论文提出了该模型的核心技术。大规模数据训练:基于超过 9 亿个图像-文本对训练,使其在多种任务中具备强泛化能力。多任务学习:支持图像分类、目标检测、图像-文本检索、语义分割等任务。对比学习 + Transformer 结构:利用对比学习增强跨模态关联,并结合 Transformer 进行高效建模。可扩展性强:Florence 可以适应不同任务需求,无需为每个任务训练单独的模型。 阅读详情

Florence:计算机视觉的一个新的基础模型

基础模型:

        基础模型的术语首次被引入指的是任何从大规模数据中训练的模型 ,这些模型能够被适应 (例如微调)到广泛的下游任务 。由于其令人印象深刻的性能和泛化能力,基础模型变得很有前途。

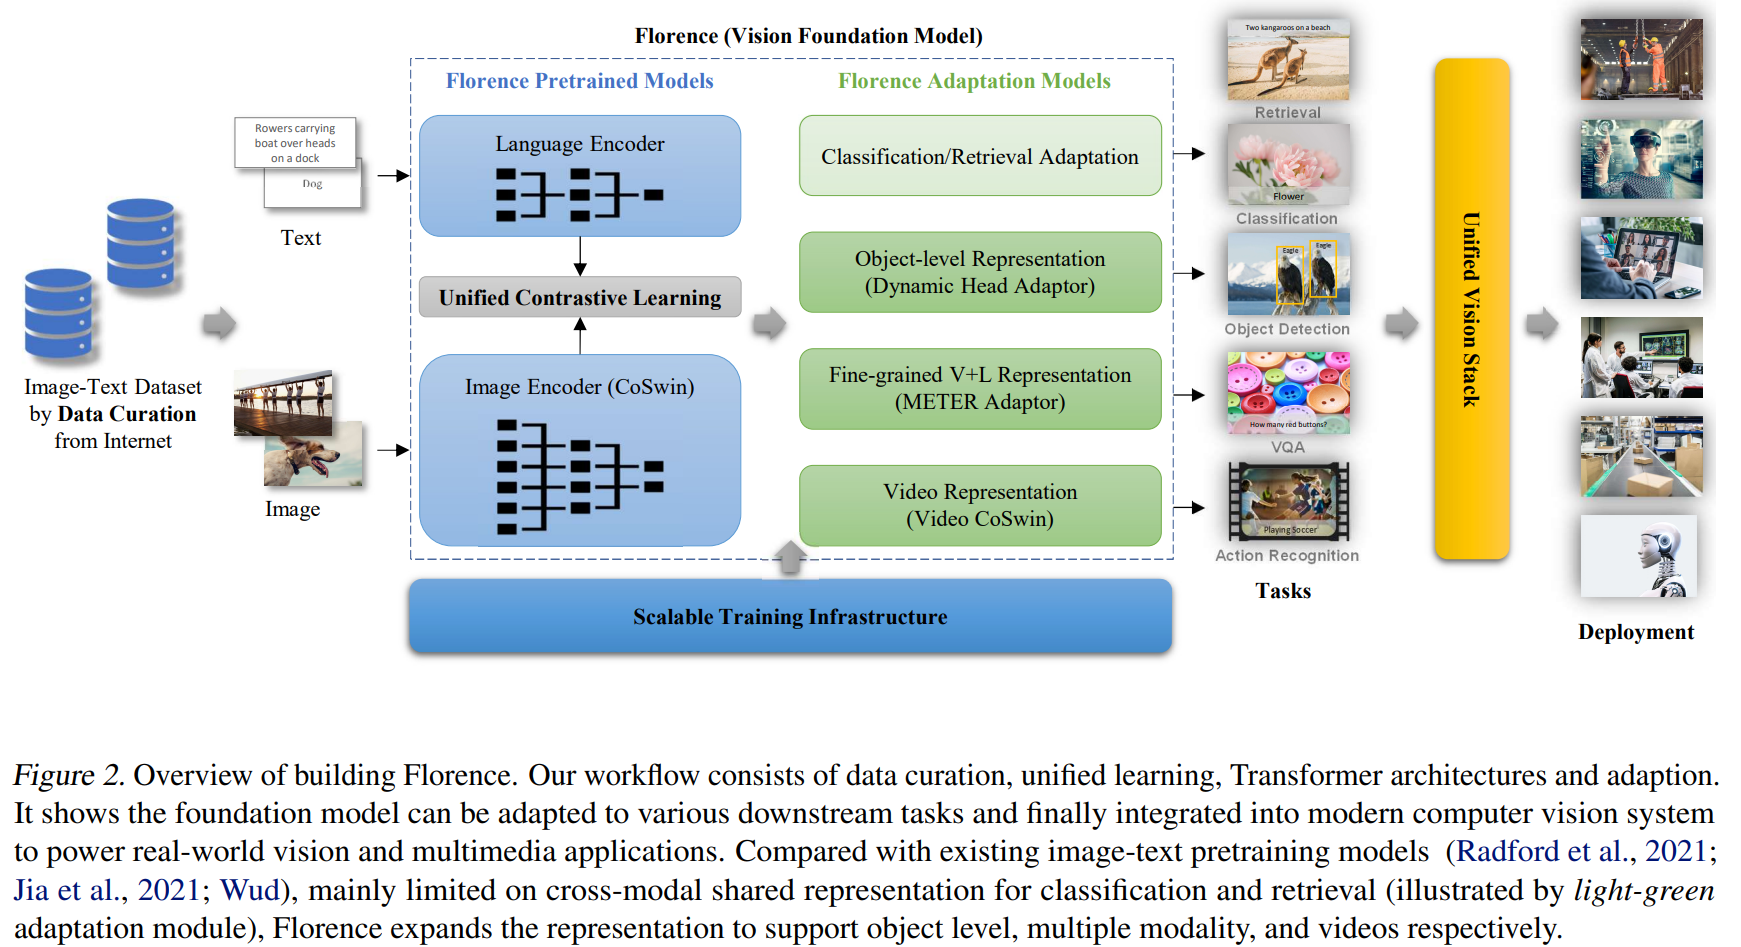
        由于视觉理解的多样性 ,我们将计算机视觉的基础模型重新定义为一个预训练模型及其适配器 , 用于解决这个时空模态空间中的所有视觉任务, 具有可迁移性 ,如零/少样本学习和完全微调等。

一、创新点

        现有的视觉基础模型,如CLIP、ALIGN等,主要侧重于将图像和文本映射到一种跨模态的共享表征。

        Florence则将表征进行了拓展,不仅拥有从粗略(场景)到精细(对象)的表征能力,还将视觉能力从静态(图像)扩展到动态(视频),从RGB图像扩展到多模态(文字、深度信息)。

       通过整合图像-文本数据的通用视觉语言表示能力,Florence可以轻松适用于各种计算机视觉任务,如分类、目标检测、VQA、看图说话、视频检索和动作识别,在多种类型的迁移学习中均表现出色。

二、方法​​​​​​​

1. 数据集的选取

        利用互联网上公开的大量图像-文本数据,微软构建了FLD-900M(FLorenceDataset)数据集。

        FLD-900M包含了9亿图像-文本对,970万个独特的查询,总共75亿个标记,通过一个程序化的数据整理管道,并行处理大约30亿张互联网图像及其原始描述得到,并进行了严格的数据过滤以确保数据相关性和质量。

2. 基于Transformer的预训练模型

        Florence预训练模型使用双塔结构:一个12层的Transformer作为语言编码器,类似于CLIP,和一个分层的视觉Transformer作为图像编码器。

        分层的视觉Transformer采用的是一个经过修改的Swin Transformer,具有卷积嵌入功能,名为CoSwin Transformer。

        Florence使用具有全局平均池的CoSwin Transformer来提取图像特征。在图像编码器和语言编码器的顶部添加了两个线性投影层,以匹配图像和语言特征的尺寸。

        Florence预训练模型总共有893M的参数,包括有256M参数的语言Transformer和有637M参数的CoSwin-H Transformer,需要用512个NVIDIA A100 GPU训练10天。

3. 统一的图像-文本对比学习

        CLIP隐式地假设了每个图像-文本对都有其独特的标注,其他图像会被认为是负样本。然而,在实际的网页数据中,多个图像可能会对应相同的标注。

        其中,FLD-900M就包含了3.5亿个这种类型的图像-文本对。在对比学习中,所有与相同文本相关的图像都可以被视为正样本对。

        为此,本文决定采用统一图像-文本对比学习(UniCL),其中Florence在图像-标签-描述空间中被预训练。

        图像-标签空间的统一学习将两种流行的学习范式统一起来,将图像映射到标签上以学习辨别性的表征(即监督学习),并给每个描述分配一个独特的标签以进行语言-图像预训练(即对比学习)。

        实验表明,具有丰富内容的长篇语言描述比短篇描述(如一两个词)更有利于图像-文本表征学习,微软通过生成提示模板的方式来丰富描述,并作为数据的补充。

4. V+L(Vision+Language tasks)表征学习

        在视觉问题回答(VQA)和图像标注方面,细粒度的表征(即对象级别)也是必不可少的。

        因此,在Florence的V+L(Vision+Language tasks)适应模型中,研究人员用预训练的CoSwin和预训练的Roberta作为语言编码器,以及METER作为adapter。

研究人员将上述两种模式融合在一起,用基于coattention的Transformer学习上下文表征。

        共同注意力模型可以将文本和视觉特征分别送入两个Transformer,每个Transformer的顶层编码层包括一个自注意力块、一个交叉注意力块和一个前馈网络块。

        训练时,先用图像-文本匹配损失和掩码语言建模损失来训练模型。然后,在下游的VQA任务上对模型进行微调。

三、实验结果


【重磅消息】微软开源了自家的Florence-2,处理各种视觉任务的统一模型 总之,Florence-2 是一个开创性的视觉基础模型,展示了多任务学习以及文本和视觉信息融合的巨大潜力。它为各种任务提供了高效的解决方案,而无需进行大量的微调。该模型能够处理从图像级理解到细粒度视觉语义配准等各种任务,标志着向统一视觉基础迈出了重要一步。Florence-2 的架构体现了序列到序列学习的威力,为综合表征学习树立了新的标准。展望未来,Florence-2 为未来的视觉基础模型铺平了道路。它的成功强调了在训练中考虑不同任务和粒度水平的重要性,从而有望建立适应性更强、更稳健的机器学习模型。 阅读详情

相关推荐

VLA-2025-03:GR00T N1【骨架:Eagle-2;端到端双系统VLA:S2 VLM+S1 DiT+FM;数据:单/双臂+人形,机器人+人类+仿真+神经共592.9M帧/8375.7小时】

通用机器人需要多功能的躯体和智能的头脑。近年来,人形机器人的发展在构建人类世界中通用自主性的硬件平台方面展现出巨大潜力。一个基于海量多样化数据源训练的机器人基础模型,对于使机器人能够推理新情况、稳健应对现实世界的多变性以及快速学习新任务至关重要。为此,我们推出了GR00T N1,一个面向人形机器人的开放基础模型。GR00T N1是一个具有双系统架构的视觉‑语言‑动作(VLA)模型。视觉语言模块(系统2)通过视觉和语言指令来解读环境。随后的扩散Transformer模块(系统1)实时生成流畅的电机动作。

u013250861的博客 286

【大模型开发】Florence多模态大模型概述

Florence 是微软推出的一款强大的多模态大模型,旨在通过图像和文本的对齐来进行跨模态学习,适用于一系列视觉和语言任务。Florence采用了先进的深度学习架构,尤其注重跨模态的理解与推理能力,在图像理解、图像生成、视觉问答等领域具有广泛应用。

人工智能(AI)技术,大模型技术,深度学习,机器学习,计算机视觉,AI工具实践应用等分享 1505

在目标检测数据集上微调Florence-2

Florence-2是由微软开源的轻量级视觉-语言模型,采用MIT许可。该模型在任务如图像描述、目标检测、定位和分割中展示了强大的零样本和微调能力。图1。图示展示了每个任务所表达的空间层次和语义细粒度水平。来源:Florence-2:推进多种视觉任务的统一表示。该模型将图像和任务提示作为输入,并以文本格式生成所需结果。它使用DaViT视觉编码器将图像转换为视觉标记嵌入,然后将这些嵌入与BERT生成的文本嵌入连接在一起,并通过基于Transformer的多模态编码器-解码器处理,以生成响应。图2。

u012374012的专栏 2602

横扫40+个SOTA!22位华人共同打造佛罗伦萨模型,一统图像视频文本,含9亿图像-文本对...

点击 机器学习算法与Python学习 ,选择加星标精彩内容不迷路新智元报道近日,微软正式发布了一个新的计算机视觉基础模型Florence(佛罗伦萨),要用一个模型一统多模态天下!F...

机器学习算法与Python学习 884

python爬虫抖音 个人资料 仅供学习参考 切勿用于商业

本文仅供学习参考 切勿用于商业 本次爬取使用fiddler+模拟器(下载抖音APP)+pycharm 1. 下载最新版本的fiddler(自行百度下载),以及相关配置 1.1.依次点击,菜单栏-Tools-Options-HTTPS,如图1红框打钩,HTTPS旁边Connections配置,如图2红框打钩 1.2.再次点击HTTPS栏,点击Actions选择第二个…to ...

dbva7063的博客 1491

PX4|Gazebo模型加载失败排查指南:从环境变量到资源路径的全面解析

本文针对PX4与Gazebo联合仿真中常见的'Unable to get model name'错误,提供了从环境变量配置、资源路径排查到网络访问问题的全面解决方案。详细解析了GZ_SIM_RESOURCE_PATH等关键变量的作用与设置方法,并给出了离线模型库部署等一劳永逸的修复指南,帮助开发者彻底解决无人机模型加载失败问题。

weixin_29243063的博客 1228

Florence-2模型:开启统一视觉基础模型的新篇章

Florence-2是由微软Azure AI团队开发的一款多功能、统一的视觉模型。它通过统一的提示处理不同的视觉任务,表现出色且优于许多大型模型。Florence-2的设计理念是将文本提示作为任务指令,并以文本形式生成理想的结果,无论是字幕、对象检测、基础还是分割。

寻道AI,探索AI无限可能! 3340

Vivado实战:如何用BUFGMUX_CTRL实现FPGA双时钟热切换(附时序约束模板)

本文详细介绍了如何使用Xilinx FPGA中的BUFGMUX_CTRL原语实现双时钟热切换的工业级解决方案。通过分析BUFGMUX_CTRL的核心机制、PCB布局约束和电源噪声抑制方法,提供Vivado实现全流程和时序约束模板,帮助工程师在工业自动化、车载电子等场景中提升系统可靠性。

weixin_29186249的博客 576

【论文精读】Florence: A New Foundation Model for Computer Vision

本文介绍了微软2021年提出的多模态基础模型Florence,该模型通过统一架构处理多种视觉任务。Florence采用分层视觉Transformer(CoSwin)作为图像编码器,利用移位窗口机制平衡计算效率与感受野,并通过大规模预训练提升泛化能力。模型创新性地将图像-文本对比学习扩展到多正例场景,并设计了动态头适配器(DynamicHead)和视频适配器(VideoCoSwin)分别用于对象检测和视频任务。Florence通过统一预训练和任务适配机制,在多种视觉基准测试中实现了领先性能,为多模态基础模型提

shenxianasi博客 1144

10X Genomics数据实战:手把手教你用Seurat处理单细胞PBMC数据(附完整代码)

本文详细介绍了如何使用Seurat处理10X Genomics的单细胞PBMC数据,从数据获取、质控到降维分析和细胞分群的全流程。通过实战代码演示,帮助研究者掌握单细胞RNA测序数据分析的核心技术,提升对细胞异质性的理解。

weixin_29053577的博客 253

SLUB DEBUG 检测slab 内存泄漏

文章介绍如何定位linux 内核中slab 内存泄漏。

一叶知秋的博客 1491

屠榜40+个SOTA!22位华人打造Florence:CV基础模型新范式!一统多模态天下

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达本文转载自:新智元编辑:小咸鱼 好困 LRS【导读】近日,微软正式发布了一个新的计算机视觉基础模型Florence(佛...

阿木寺的博客 3213

太空安全卫士:基于YOLOv5的空间态势感知系统(实现轨道碰撞预警与太空环境保护)

做完这个项目,你会发现自己完整走过了“数据采集→标注→模型训练→功能集成→界面开发”的毕设全流程,这不仅是技术能力的证明,更是对“技术守护宇宙安全”这一理念的实践。答辩时,你可以重点讲这几点:系统解决了航天监测的哪些痛点、YOLOv5在太空目标检测中的性能优势、系统未来能怎么优化(比如对接航天监测网络、实现实时轨道预测)。未来,这个系统还能往“更智能”的方向发展:比如结合轨道计算预测碰撞风险、开发移动端APP让天文爱好者参与太空垃圾上报、在航天任务中实现全自动避障决策……想象空间很大。

m0_71589036的博客 90

π0:面向通用机器人控制的视觉-语言-动作流模型

Physical IntelligenceKevin Black, Noah Brown, Danny Driess, Adnan Esmail, Michael Equi, Chelsea Finn, Niccolo Fusai, Lachy Groom, Karol Hausman, Brian Ichter, Szymon Jakubczak, Tim Jones, Liyiming Ke, Sergey Levine, Adrian Li-Bell, Mohith Mothukuri, Suraj

u013250861的博客 55

【车载以太网】ATU(Address Translation Unit / Address Table Unit)

【车载以太网】ATU(Address Translation Unit / Address Table Unit)

天赐好车的博客 151

Windows安装 OpenClaw详细教程(使用wsl2+ubuntu)

OpenClaw 是一款于 2026年1月 正式对外开源的个人AI助手平台(AI Agent),由 PSPDFKit 创始人彼得·斯坦伯格(Peter Steinberger) 开发。它不仅仅是一个聊天机器人,更是一个能够主动执行任务的“数字管家”。OpenClaw的核心特点是本地化部署、隐私可控以及强大的自动化执行能力。OpenClaw 项目在开发过程中经历过两次更名,最终定为现名:初名:Clawdbot(因与 Claude 名称过于相似引发侵权争议而改名)。

猿小白的博客 1007

【大模型开发】Florence多模态大模型详解与扩展

Florence作为一款领先的多模态大模型,在图像-文本理解、图像生成、视觉问答等任务中展示了巨大的潜力。通过其强大的Transformer架构和跨模态对齐机制,Florence为多模态学习开辟了新的方向。尽管如此,Florence仍面临着诸如计算效率、长文本理解、多语言支持等挑战,未来需要在这些方向上进行进一步的改进和创新。随着技术的不断发展和数据集的扩展,Florence有望成为更广泛应用的多模态学习模型,在图像搜索、自动标注、跨模态推理等领域发挥更大的作用。

人工智能(AI)技术,大模型技术,深度学习,机器学习,计算机视觉,AI工具实践应用等分享 810

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Milvus×Florence:一文读懂如何构建多任务视觉模型

近两年来多任务学习(Multi-task learning)正取代传统的单任务学习(single-task learning),逐渐成为人工智能领域的主流研究方向。其原因在于,多任务学习可以让我们以最少的人力投入,获得尽可能多的AI能力。比如ChatGPT,就是一种基于多任务学习的自然语言生成模型。通过海量的数据训练,以及针对特定任务的模型微调,ChatGPT可以拥有极高的性能以及广泛的通用性。这...

ZILLIZ 1636

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

微软全新开源视觉语言模型!能够执行超过10种不同的视觉任务,检测、分割、识别一切图片

Florence-2:微软全新开源视觉模型!当遇到如下场景,我们希望有一个AI模型能马上给出答案:上传一张超市货架的照片,让其精准找出牛奶的所在位置。上传一张公园里的照片,让模型给该图像起一个对应的标题。上传一张果园果树的照片,让模型解释一下该果树上有多少可摘的水果。上述不同的视觉任务的理解需要大模型的支持,最近Microsoft 推出了多模态视觉语言模型(VLM)Florence-2,该模型能够执行超过10种不同的视觉任务,包括图像字幕生成、目标检测、图像区域关联和分割等。

m0_59235245的博客 1415

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Florence-2视觉语言模型简明教程

Florence-2 由微软于 2024 年 6 月发布。它旨在在单个模型中执行多项视觉任务。它是一个开源模型,在 Hugging Face 上根据宽松的 MIT 许可证提供。

新缸中之脑 4845

Florence2:使用LLM助力你的AI绘图,仅需一个模型搞定提示反推&对象检查&蒙版识别&文字识别&咨询建议多功能一体

大家好我是阿道夫!!!Florence2是一款革命性的AI绘图工具,它将LLM(大型语言模型)的强大功能与AI绘图技术完美结合。本文将介绍Florence2的五大核心功能:提示反推、对象检查、蒙版识别、文字识别及咨询建议,以及如何使用一个模型轻松搞定这些功能,助力您的AI绘图创作。在LLM大语言模型快速发展下,视觉大模型已成为主流,能够精准的等,甚至可以根据输入图像实现等,模拟现实世界物理运动反馈和回应。同时以SD、MJ为首的绘图模型在下也得到的快速的发展,模仿垫图一直是绘图过程中重要需求之一。

阿道夫的博客 6253

Florence-2:通过单一 VLM 模型推动多个视觉任务的进展

近年来,计算机视觉领域见证了基础模型的崛起,这些模型无需训练定制模型即可进行图像注释。我们已经看到像 CLIP [2]这样的分类模型,GroundingDINO [3]用于物体检测,和 SAM [4]用于图像分割——每个模型在各自领域中表现优异。但是,如果我们有一个能够同时处理所有这些任务的单一模型呢?如果你没有付费的 Medium 账户,你可以在这里免费阅读。

龙哥盟 1445

9亿训练集、通用CV任务,微软打造Florence模型打破分类、检索等多项SOTA

点击上方“AI遇见机器学习”,选择“星标”公众号 重磅干货,第一时间送达 来自:机器之心来自微软的研究者另辟蹊径,提出了一种新的计算机视觉基础模型 Florence。在广泛的视觉和视觉 -...

weixin_36896856的博客 367

Florence2-通用表征完成多种视觉任务的视觉基础模型

Florence-2 是由微软于 2024 年 6 月发布的开源模型,目的是使用通用的表征完成一系列复杂任务,如QA问答、描述、检测、分割、OCR等。Florence-2-base和large模型的参数量分别为 0.23B和0.77B,参数量虽小,但实现了SOTA性能。数据集:FLD-5B,包含 1.26 亿张图像的 54 亿条全面的视觉标注。在计算机视觉当中,希望能够实现通用的表征来完成一系列复杂的任务。比如说QA问答任务、描述任务、检测任务、分割任务、OCR任务等等。

qq_38384924的博客 1412

如何使用Florence-2来做计算机视觉任务

点击上方“AI公园”,关注公众号,选择加“星标“或“置顶”作者:Ajay Kumar Reddy编译:ronghuaiyang导读在这篇指南中,我们将深入了解这款由微软发布的名为Florence-2的模型,它旨在解决多种不同的视觉任务。引言原始Transformer的引入为当前的大型语言模型铺平了道路。同样,在引入变换器模型之后,视觉变换器(ViT)也被提出。就像擅长理解文本和根据响应生成文本的变...

AI公园 2808

【计算机视觉】Vision and Language Pre-Trained Models算法介绍合集(二)

【计算机视觉】Vision and Language Pre-Trained Models算法介绍合集(二)

wzk4869的博客 1297
上一篇: LXMERT: Learning Cross-Modality Encoder Representationsfrom Transformers
下一篇: Greedy Gradient Ensemble for Robust Visual Question Answering
pinkshell_1314
博客等级 码龄6年 16粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值