


本文从宏观架构层面和微观实现层面分析了Kafka如何实现高性能。包含Kafka如何利用Partition实现并行处理和提供水平扩展能力,如何通过ISR实现可用性和数据一致性的动态平衡,如何使用NIO和Linux的sendfile实现零拷贝以及如何通过顺序读写和数据压缩实现磁盘的高效利用。
原创文章,转载请务必将下面这段话置于文章开头处。
本文转发自技术世界,原文链接 http://www.jasongj.com/kafka/high_throughput/
摘要
上一篇文章《Kafka设计解析(五)- Kafka性能测试方法及Benchmark报告》从测试角度说明了Kafka的性能。本文从宏观架构层面和具体实现层面分析了Kafka如何实现高性能。
宏观架构层面
利用Partition实现并行处理
Partition提供并行处理的能力
Kafka是一个Pub-Sub的消息系统,无论是发布还是订阅,都须指定Topic。如《Kafka设计解析(一)- Kafka背景及架构介绍》一文所述,Topic只是一个逻辑的概念。每个Topic都包含一个或多个Partition,不同Partition可位于不同节点。同时Partition在物理上对应一个本地文件夹,每个Partition包含一个或多个Segment,每个Segment包含一个数据文件和一个与之对应的索引文件。在逻辑上,可以把一个Partition当作一个非常长的数组,可通过这个“数组”的索引(offset)去访问其数据。
一方面,由于不同Partition可位于不同机器,因此可以充分利用集群优势,实现机器间的并行处理。另一方面,由于Partition在物理上对应一个文件夹,即使多个Partition位于同一个节点,也可通过配置让同一节点上的不同Partition置于不同的disk drive上,从而实现磁盘间的并行处理,充分发挥多磁盘的优势。
利用多磁盘的具体方法是,将不同磁盘mount到不同目录,然后在server.properties中,将log.dirs设置为多目录(用逗号分隔)。Kafka会自动将所有Partition尽可能均匀分配到不同目录也即不同目录(也即不同disk)上。
注:虽然物理上最小单位是Segment,但Kafka并不提供同一Partition内不同Segment间的并行处理。因为对于写而言,每次只会写Partition内的一个Segment,而对于读而言,也只会顺序读取同一Partition内的不同Segment。
Partition是最小并发粒度
如同《Kafka设计解析(四)- Kafka Consumer设计解析》一文所述,多Consumer消费同一个Topic时,同一条消息只会被同一Consumer Group内的一个Consumer所消费。而数据并非按消息为单位分配,而是以Partition为单位分配,也即同一个Partition的数据只会被一个Consumer所消费(在不考虑Rebalance的前提下)。
如果Consumer的个数多于Partition的个数,那么会有部分Consumer无法消费该Topic的任何数据,也即当Consumer个数超过Partition后,增加Consumer并不能增加并行度。
简而言之,Partition个数决定了可能的最大并行度。如下图所示,由于Topic 2只包含3个Partition,故group2中的Consumer 3、Consumer 4、Consumer 5 可分别消费1个Partition的数据,而Consumer 6消费不到Topic 2的任何数据。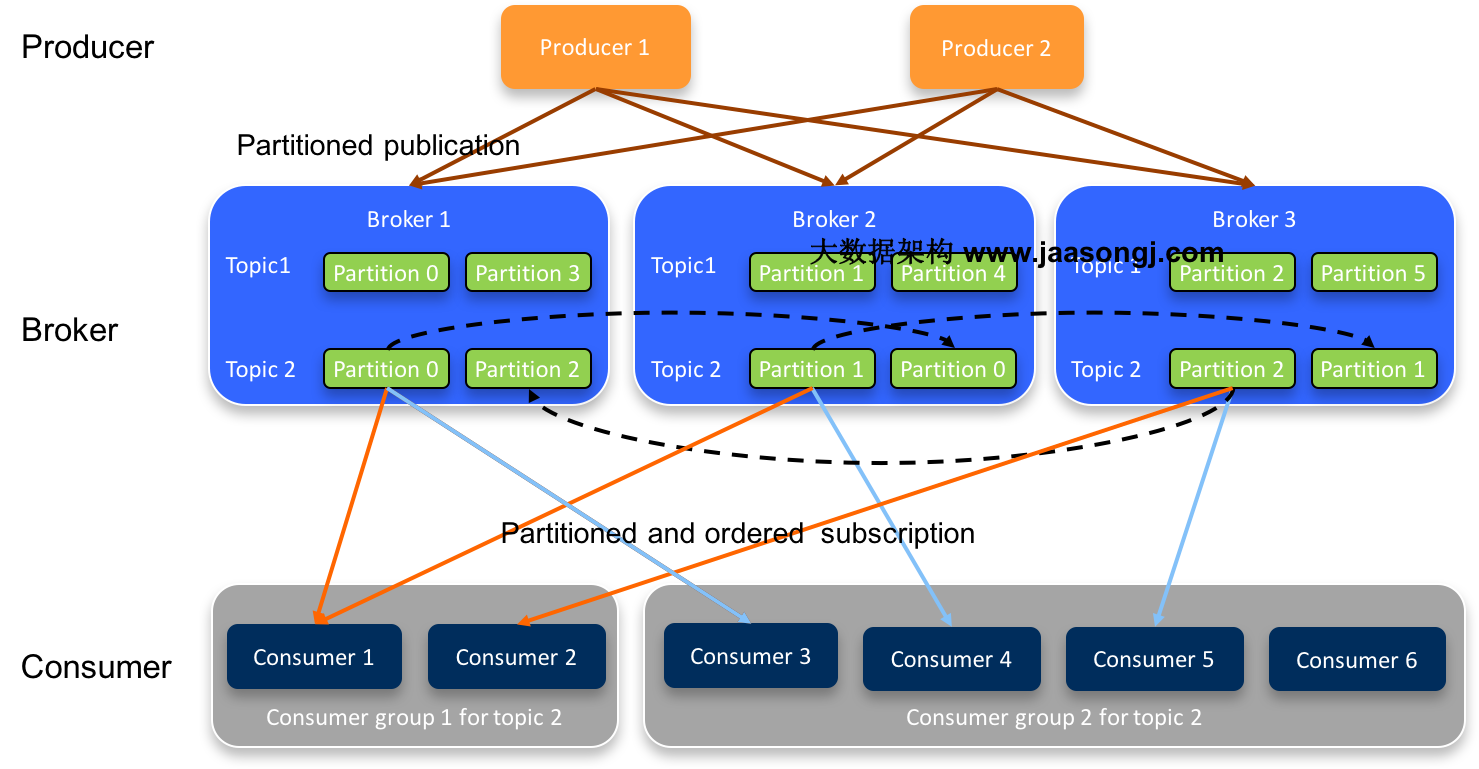
以Spark消费Kafka数据为例,如果所消费的Topic的Partition数为N,则有效的Spark最大并行度也为N。即使将Spark的Executor数设置为N+M,最多也只有N个Executor可同时处理该Topic的数据。
ISR实现可用性与数据一致性的动态平衡
CAP理论
CAP理论是指,分布式系统中,一致性、可用性和分区容忍性最多只能同时满足两个。
一致性
- 通过某个节点的写操作结果对后面通过其它节点的读操作可见
- 如果更新数据后,并发访问情况下后续读操作可立即感知该更新,称为强一致性
- 如果允许之后部分或者全部感知不到该更新,称为弱一致性
- 若在之后的一段时间(通常该时间不固定)后,一定可以感知到该更新,称为最终一致性
可用性
- 任何一个没有发生故障的节点必须在有限的时间内返回合理的结果
分区容忍性
- 部分节点宕机或者无法与其它节点通信时,各分区间还可保持分布式系统的功能
一般而言,都要求保证分区容忍性。所以在CAP理论下,更多的是需要在可用性和一致性之间做权衡。
常用数据复制及一致性方案
Master-Slave
- RDBMS的读写分离即为典型的Master-Slave方案
- 同步复制可保证强一致性但会影响可用性
- 异步复制可提供高可用性但会降低一致性
WNR
- 主要用于去中心化的分布式系统中。DynamoDB与Cassandra即采用此方案或其变种
- N代表总副本数,W代表每次写操作要保证的最少写成功的副本数,R代表每次读至少要读取的副本数
- 当W+R>N时,可保证每次读取的数据至少有一个副本拥有最新的数据
- 多个写操作的顺序难以保证,可能导致多副本间的写操作顺序不一致。Dynamo通过向量时钟保证最终一致性
Paxos及其变种
- Google的Chubby,Zookeeper的原子广播协议(Zab),RAFT等
基于ISR的数据复制方案
如《 Kafka High Availability(上)》一文所述,Kafka的数据复制是以Partition为单位的。而多个备份间的数据复制,通过Follower向Leader拉取数据完成。从一这点来讲,Kafka的数据复制方案接近于上文所讲的Master-Slave方案。不同的是,Kafka既不是完全的同步复制,也不是完全的异步复制,而是基于ISR的动态复制方案。
ISR,也即In-sync Replica。每个Partition的Leader都会维护这样一个列表,该列表中,包含了所有与之同步的Replica(包含Leader自己)。每次数据写入时,只有ISR中的所有Replica都复制完,Leader才会将其置为Commit,它才能被Consumer所消费。
这种方案,与同步复制非常接近。但不同的是,这个ISR是由Leader动态维护的。如果Follower不能紧“跟上”Leader,它将被Leader从ISR中移除,待它又重新“跟上”Leader后,会被Leader再次加加ISR中。每次改变ISR后,Leader都会将最新的ISR持久化到Zookeeper中。
至于如何判断某个Follower是否“跟上”Leader,不同版本的Kafka的策略稍微有些区别。
- 对于0.8.*版本,如果Follower在
replica.lag.time.max.ms时间内未向Leader发送Fetch请求(也即数据复制请求),则Leader会将其从ISR中移除。如果某Follower持续向Leader发送Fetch请求,但是它与Leader的数据差距在replica.lag.max.messages以上,也会被Leader从ISR中移除。 - 从0.9.0.0版本开始,
replica.lag.max.messages被移除,故Leader不再考虑Follower落后的消息条数。另外,Leader不仅会判断Follower是否在replica.lag.time.max.ms时间内向其发送Fetch请求,同时还会考虑Follower是否在该时间内与之保持同步。(不再用消息条数判断是否落后,用时间判断,这是科学的,因为在吞吐量很大时,虽然落后消息多但是时延少啊) - 0.10.* 版本的策略与0.9.*版一致
对于0.8.*版本的replica.lag.max.messages参数,很多读者曾留言提问,既然只有ISR中的所有Replica复制完后的消息才被认为Commit,那为何会出现Follower与Leader差距过大的情况。原因在于,Leader并不需要等到前一条消息被Commit才接收后一条消息。事实上,Leader可以按顺序接收大量消息,最新的一条消息的Offset被记为LEO(Log end offset)。而只有被ISR中所有Follower都复制过去的消息才会被Commit,Consumer只能消费被Commit的消息,最新被Commit的Offset被记为High watermark。换句话说,LEO 标记的是Leader所保存的最新消息的offset,而High watermark标记的是最新的可被消费的(已同步到ISR中的Follower)消息。而Leader对数据的接收与Follower对数据的复制是异步进行的,因此会出现Hight watermark与LEO存在一定差距的情况。0.8.*版本中replica.lag.max.messages限定了Leader允许的该差距的最大值。
Kafka基于ISR的数据复制方案原理如下图所示。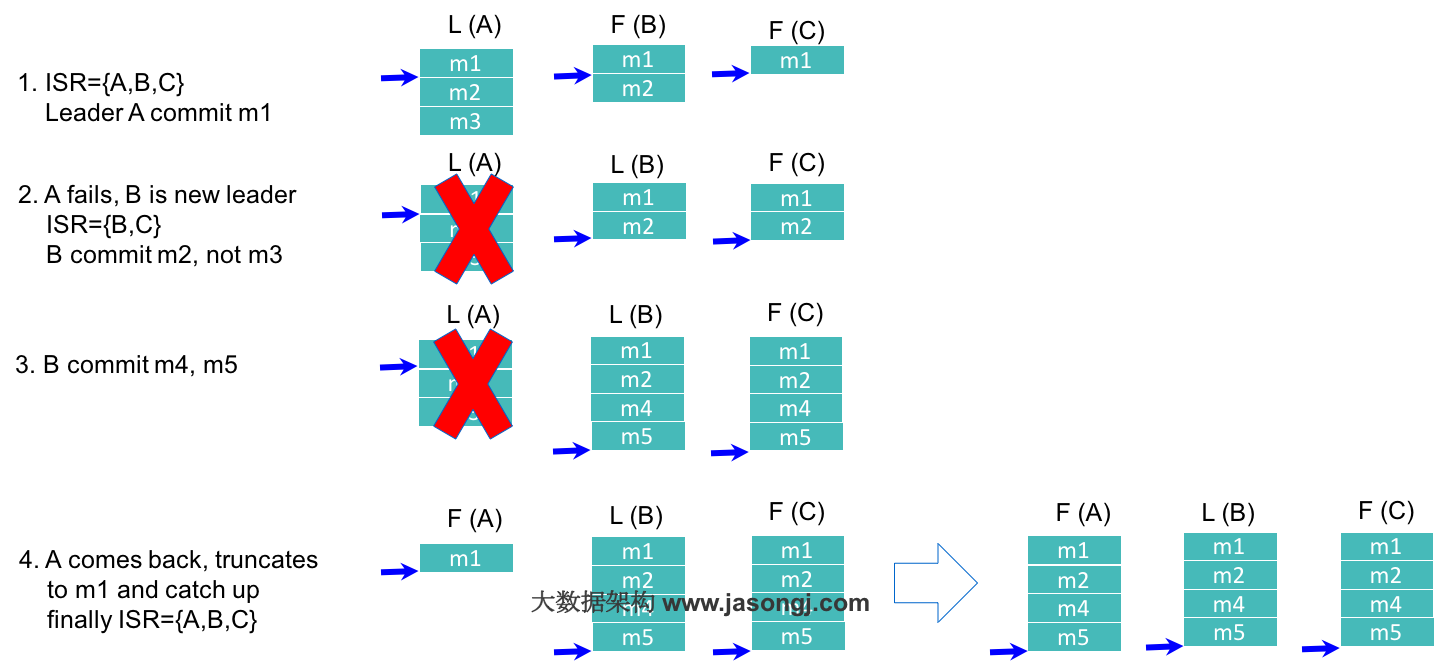
如上图所示,在第一步中,Leader A总共收到3条消息,故其high watermark为3,但由于ISR中的Follower只同步了第1条消息(m1),故只有m1被Commit,也即只有m1可被Consumer消费。此时Follower B与Leader A的差距是1,而Follower C与Leader A的差距是2,均未超过默认的replica.lag.max.messages,故得以保留在ISR中。在第二步中,由于旧的Leader A宕机,新的Leader B在replica.lag.time.max.ms时间内未收到来自A的Fetch请求,故将A从ISR中移除,此时ISR={B,C}。同时,由于此时新的Leader B中只有2条消息,并未包含m3(m3从未被任何Leader所Commit),所以m3无法被Consumer消费。第四步中,Follower A恢复正常,它先将宕机前未Commit的所有消息全部删除,然后从最后Commit过的消息的下一条消息开始追赶新的Leader B,直到它“赶上”新的Leader,才被重新加入新的ISR中。(如果A没有恢复正常,m3永远丢了?)
使用ISR方案的原因
- 由于Leader可移除不能及时与之同步的Follower,故与同步复制相比可避免最慢的Follower拖慢整体速度,也即ISR提高了系统可用性。
- ISR中的所有Follower都包含了所有Commit过的消息,而只有Commit过的消息才会被Consumer消费,故从Consumer的角度而言,ISR中的所有Replica都始终处于同步状态,从而与异步复制方案相比提高了数据一致性。
- ISR可动态调整,极限情况下,可以只包含Leader,极大提高了可容忍的宕机的Follower的数量。与
Majority Quorum方案相比,容忍相同个数的节点失败,所要求的总节点数少了近一半。(想要高吞吐,就要牺牲可用性)
ISR相关配置说明
- Broker的
min.insync.replicas参数指定了Broker所要求的ISR最小长度,默认值为1。也即极限情况下ISR可以只包含Leader。但此时如果Leader宕机,则该Partition不可用,可用性得不到保证。 - 只有被ISR中所有Replica同步的消息才被Commit,但Producer发布数据时,Leader并不需要ISR中的所有Replica同步该数据才确认收到数据。Producer可以通过
acks参数指定最少需要多少个Replica确认收到该消息才视为该消息发送成功。acks的默认值是1,即Leader收到该消息后立即告诉Producer收到该消息,此时如果在ISR中的消息复制完该消息前Leader宕机,那该条消息会丢失。而如果将该值设置为0,则Producer发送完数据后,立即认为该数据发送成功,不作任何等待,而实际上该数据可能发送失败,并且Producer的Retry机制将不生效。更推荐的做法是,将acks设置为all或者-1,此时只有ISR中的所有Replica都收到该数据(也即该消息被Commit),Leader才会告诉Producer该消息发送成功,从而保证不会有未知的数据丢失。(所有节点确认收到才commit)
具体实现层面
高效使用磁盘
顺序写磁盘
根据《一些场景下顺序写磁盘快于随机写内存》所述,将写磁盘的过程变为顺序写,可极大提高对磁盘的利用率。
Kafka的整个设计中,Partition相当于一个非常长的数组,而Broker接收到的所有消息顺序写入这个大数组中。同时Consumer通过Offset顺序消费这些数据,并且不删除已经消费的数据,从而避免了随机写磁盘的过程。
由于磁盘有限,不可能保存所有数据,实际上作为消息系统Kafka也没必要保存所有数据,需要删除旧的数据。而这个删除过程,并非通过使用“读-写”模式去修改文件,而是将Partition分为多个Segment,每个Segment对应一个物理文件,通过删除整个文件的方式去删除Partition内的数据。这种方式清除旧数据的方式,也避免了对文件的随机写操作。
通过如下代码可知,Kafka删除Segment的方式,是直接删除Segment对应的整个log文件和整个index文件而非删除文件中的部分内容。
/**
 * Delete this log segment from the filesystem.
 *
 * @throws KafkaStorageException if the delete fails.
 */
def delete() {
  val deletedLog = log.delete()
  val deletedIndex = index.delete()
  val deletedTimeIndex = timeIndex.delete()
  if(!deletedLog && log.file.exists)
    throw new KafkaStorageException("Delete of log " + log.file.getName + " failed.")
  if(!deletedIndex && index.file.exists)
    throw new KafkaStorageException("Delete of index " + index.file.getName + " failed.")
  if(!deletedTimeIndex && timeIndex.file.exists)
    throw new KafkaStorageException("Delete of time index " + timeIndex.file.getName + " failed.")
}
充分利用Page Cache
使用Page Cache的好处如下
- I/O Scheduler会将连续的小块写组装成大块的物理写从而提高性能
- I/O Scheduler会尝试将一些写操作重新按顺序排好,从而减少磁盘头的移动时间
- 充分利用所有空闲内存(非JVM内存)。如果使用应用层Cache(即JVM堆内存),会增加GC负担
- 读操作可直接在Page Cache内进行。如果消费和生产速度相当,甚至不需要通过物理磁盘(直接通过Page Cache)交换数据
- 如果进程重启,JVM内的Cache会失效,但Page Cache仍然可用
Broker收到数据后,写磁盘时只是将数据写入Page Cache,并不保证数据一定完全写入磁盘。从这一点看,可能会造成机器宕机时,Page Cache内的数据未写入磁盘从而造成数据丢失。但是这种丢失只发生在机器断电等造成操作系统不工作的场景,而这种场景完全可以由Kafka层面的Replication机制去解决。如果为了保证这种情况下数据不丢失而强制将Page Cache中的数据Flush到磁盘,反而会降低性能。也正因如此,Kafka虽然提供了flush.messages和flush.ms两个参数将Page Cache中的数据强制Flush到磁盘,但是Kafka并不建议使用。
如果数据消费速度与生产速度相当,甚至不需要通过物理磁盘交换数据,而是直接通过Page Cache交换数据。同时,Follower从Leader Fetch数据时,也可通过Page Cache完成。下图为某Partition的Leader节点的网络/磁盘读写信息。
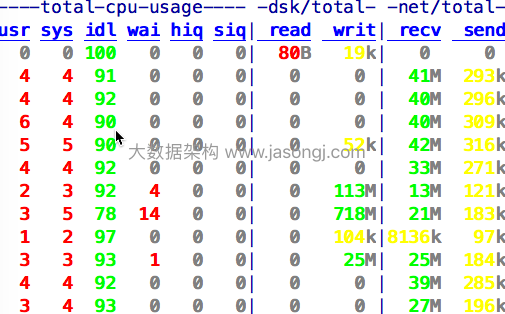
从上图可以看到,该Broker每秒通过网络从Producer接收约35MB数据,虽然有Follower从该Broker Fetch数据,但是该Broker基本无读磁盘。这是因为该Broker直接从Page Cache中将数据取出返回给了Follower。
支持多Disk Drive
Broker的log.dirs配置项,允许配置多个文件夹。如果机器上有多个Disk Drive,可将不同的Disk挂载到不同的目录,然后将这些目录都配置到log.dirs里。Kafka会尽可能将不同的Partition分配到不同的目录,也即不同的Disk上,从而充分利用了多Disk的优势。
零拷贝
Kafka中存在大量的网络数据持久化到磁盘(Producer到Broker)和磁盘文件通过网络发送(Broker到Consumer)的过程。这一过程的性能直接影响Kafka的整体吞吐量。
传统模式下的四次拷贝与四次上下文切换
以将磁盘文件通过网络发送为例。传统模式下,一般使用如下伪代码所示的方法先将文件数据读入内存,然后通过Socket将内存中的数据发送出去。
| |
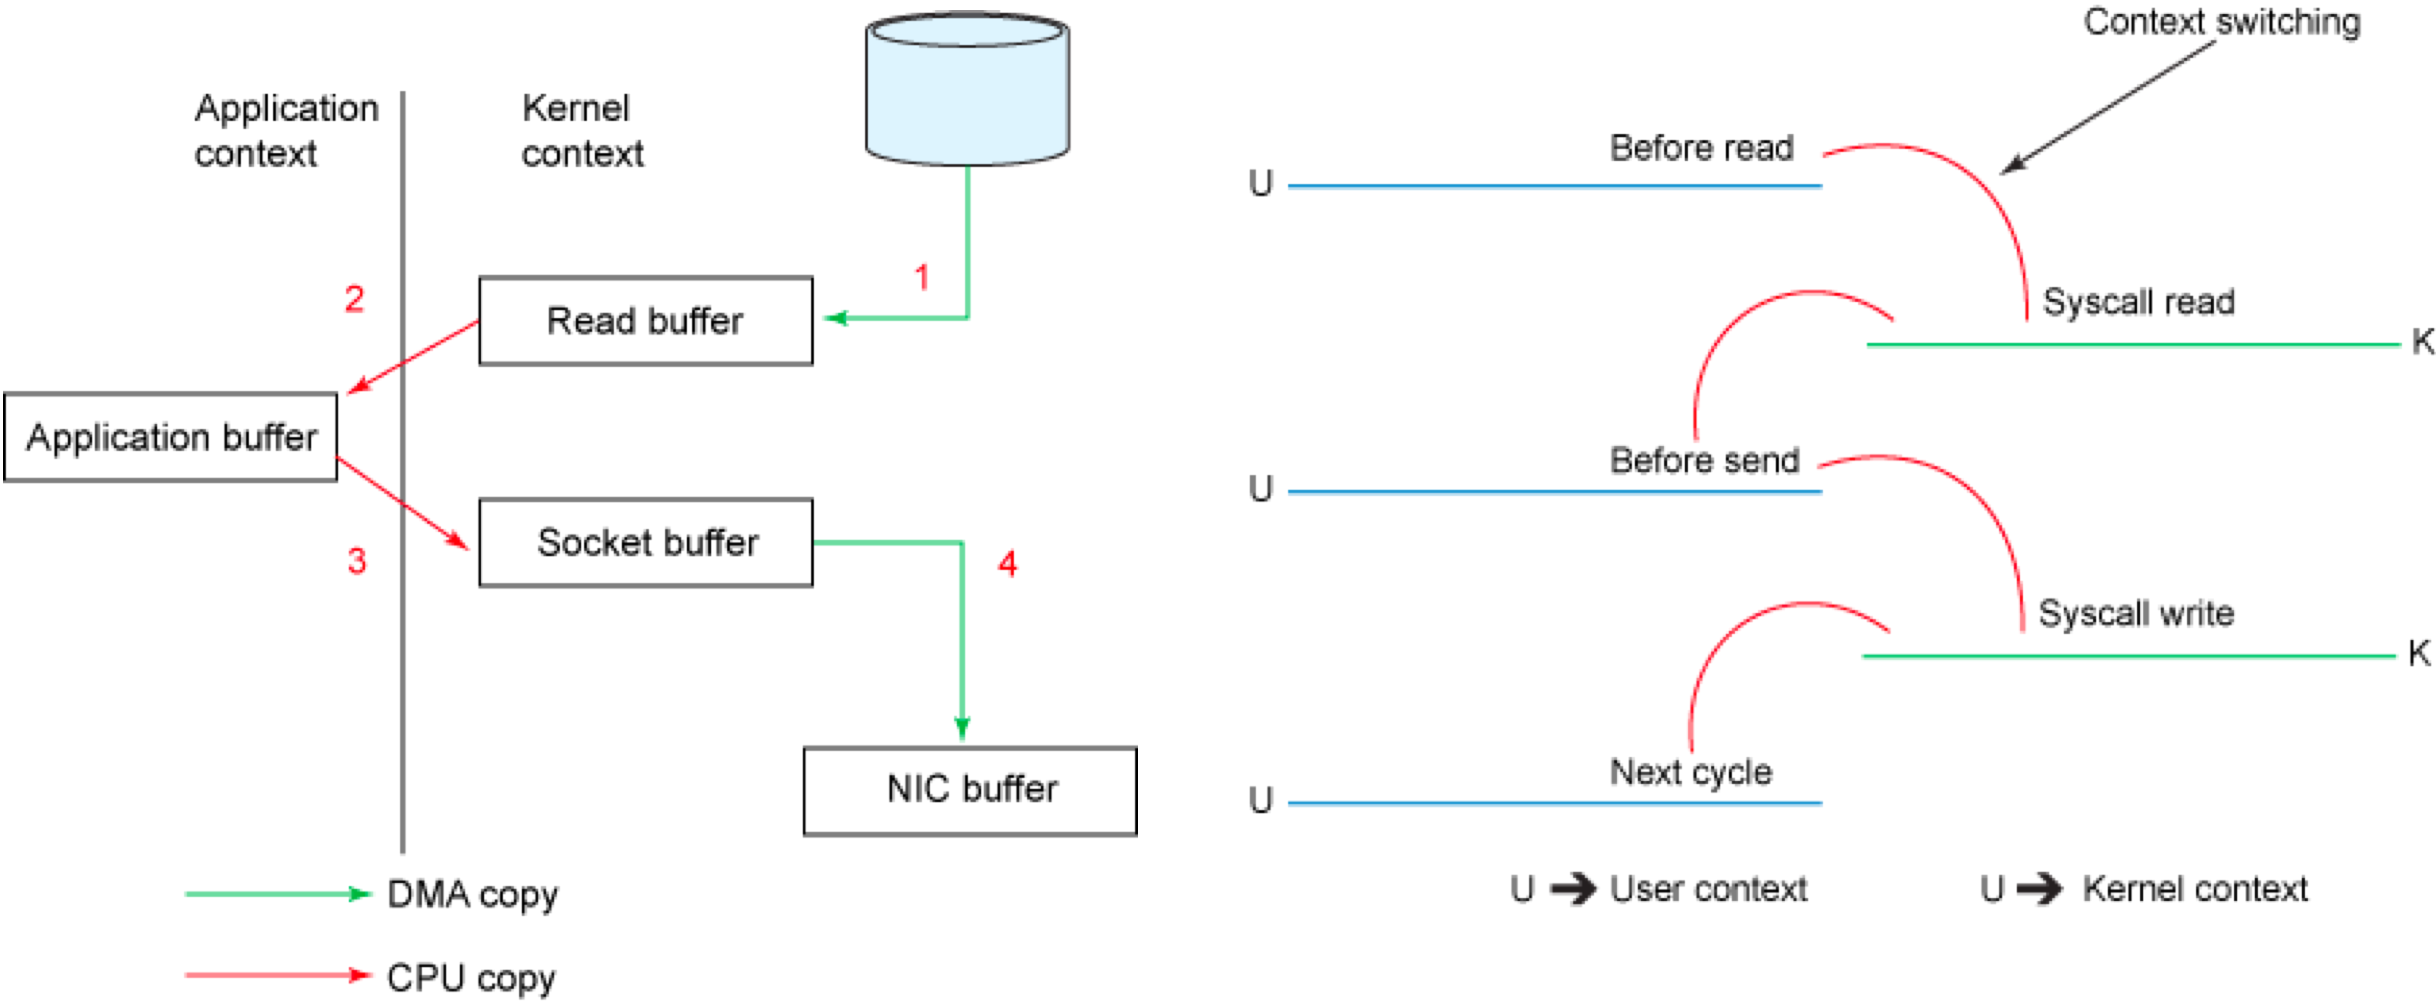
这一过程实际上发生了四次数据拷贝。首先通过系统调用将文件数据读入到内核态Buffer(DMA拷贝),然后应用程序将内存态Buffer数据读入到用户态Buffer(CPU拷贝),接着用户程序通过Socket发送数据时将用户态Buffer数据拷贝到内核态Buffer(CPU拷贝),最后通过DMA拷贝将数据拷贝到NIC Buffer。同时,还伴随着四次上下文切换,如下图所示。
sendfile和transferTo实现零拷贝
Linux 2.4+内核通过sendfile系统调用,提供了零拷贝。数据通过DMA拷贝到内核态Buffer后,直接通过DMA拷贝到NIC Buffer,无需CPU拷贝。这也是零拷贝这一说法的来源。除了减少数据拷贝外,因为整个读文件-网络发送由一个sendfile调用完成,整个过程只有两次上下文切换,因此大大提高了性能。零拷贝过程如下图所示。
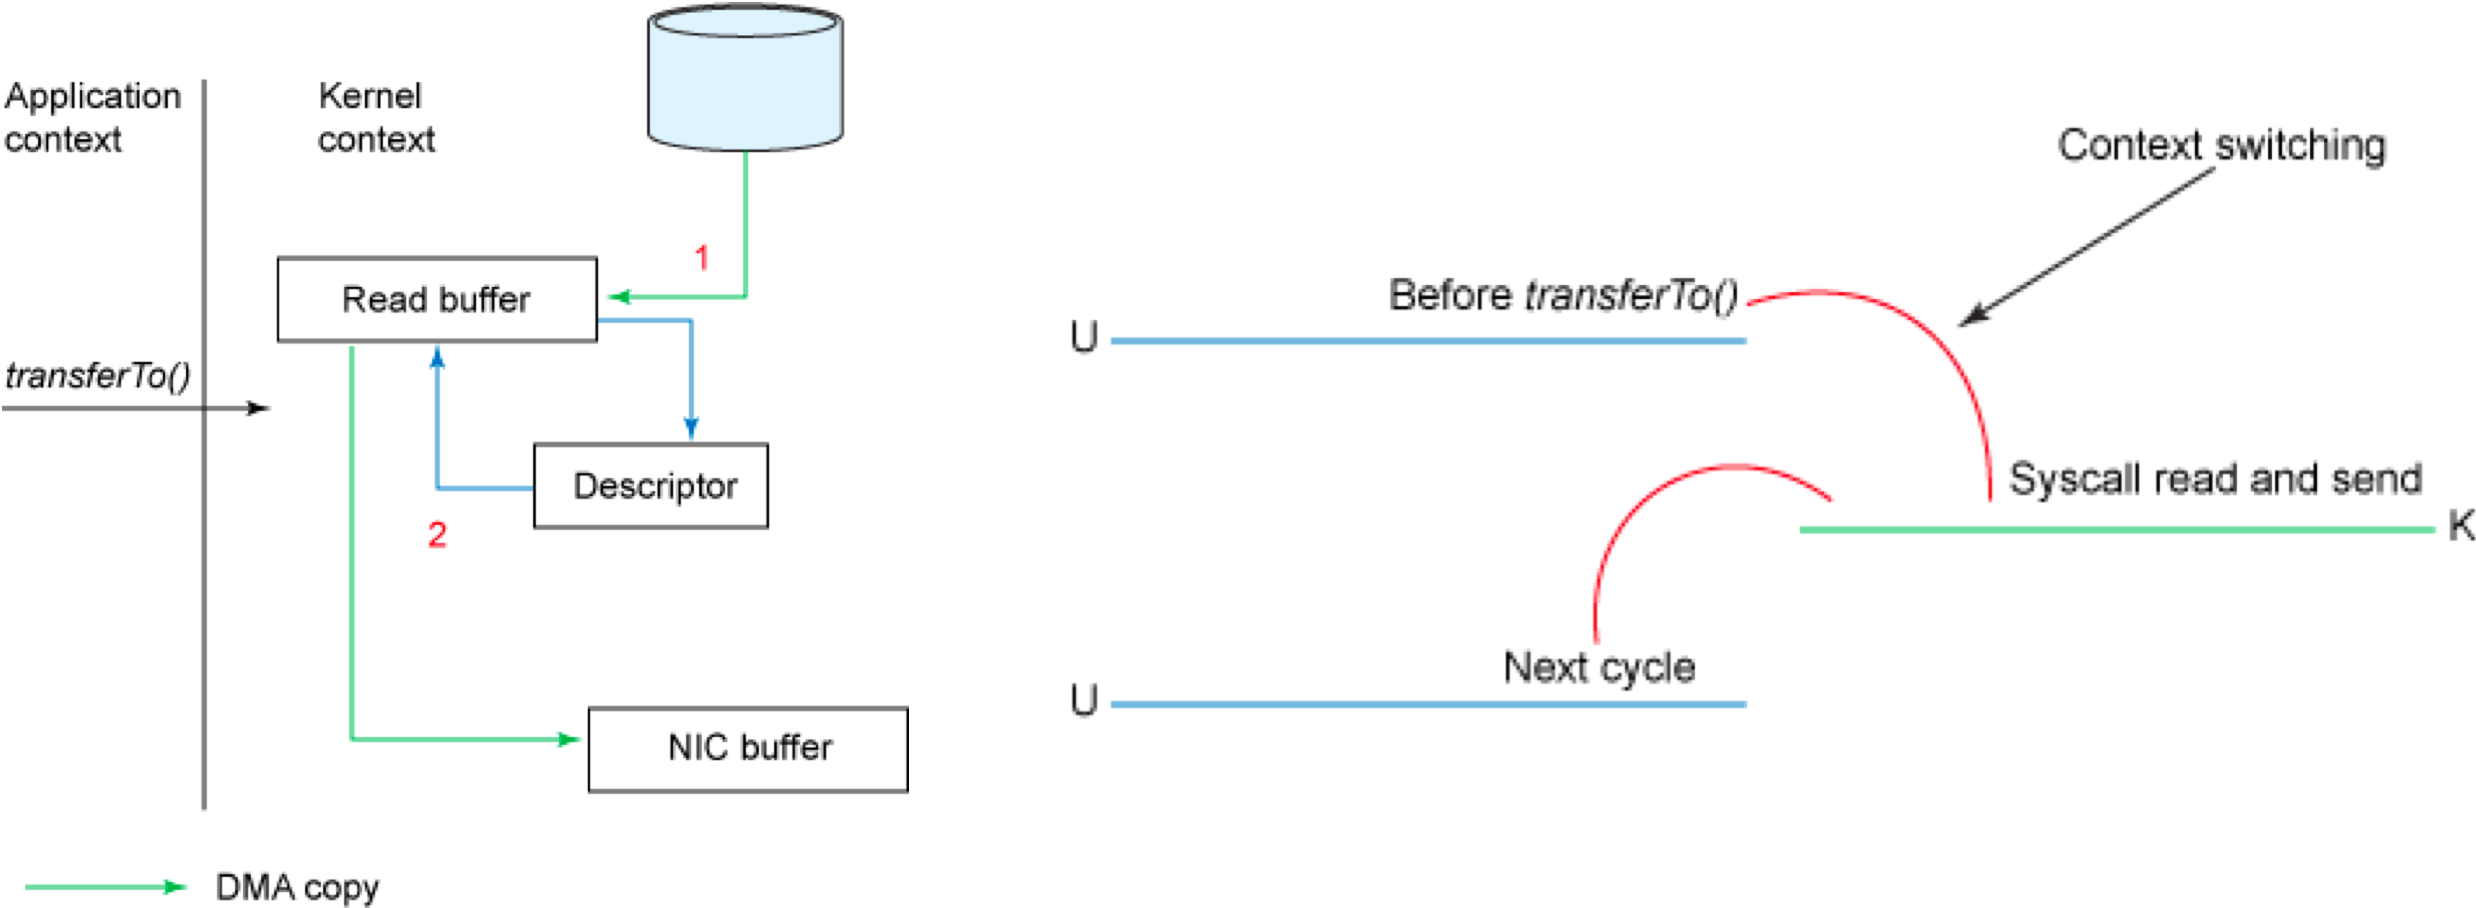
从具体实现来看,Kafka的数据传输通过TransportLayer来完成,其子类PlaintextTransportLayer通过Java NIO的FileChannel的transferTo和transferFrom方法实现零拷贝,如下所示。
| |
注: transferTo和transferFrom并不保证一定能使用零拷贝。实际上是否能使用零拷贝与操作系统相关,如果操作系统提供sendfile这样的零拷贝系统调用,则这两个方法会通过这样的系统调用充分利用零拷贝的优势,否则并不能通过这两个方法本身实现零拷贝。
减少网络开销
批处理
批处理是一种常用的用于提高I/O性能的方式。对Kafka而言,批处理既减少了网络传输的Overhead,又提高了写磁盘的效率。
Kafka 0.8.1及以前的Producer区分同步Producer和异步Producer。同步Producer的send方法主要分两种形式。一种是接受一个KeyedMessage作为参数,一次发送一条消息。另一种是接受一批KeyedMessage作为参数,一次性发送多条消息。而对于异步发送而言,无论是使用哪个send方法,实现上都不会立即将消息发送给Broker,而是先存到内部的队列中,直到消息条数达到阈值或者达到指定的Timeout才真正的将消息发送出去,从而实现了消息的批量发送。
Kafka 0.8.2开始支持新的Producer API,将同步Producer和异步Producer结合。虽然从send接口来看,一次只能发送一个ProducerRecord,而不能像之前版本的send方法一样接受消息列表,但是send方法并非立即将消息发送出去,而是通过batch.size和linger.ms控制实际发送频率,从而实现批量发送。
由于每次网络传输,除了传输消息本身以外,还要传输非常多的网络协议本身的一些内容(称为Overhead),所以将多条消息合并到一起传输,可有效减少网络传输的Overhead,进而提高了传输效率。
从零拷贝章节的图中可以看到,虽然Broker持续从网络接收数据,但是写磁盘并非每秒都在发生,而是间隔一段时间写一次磁盘,并且每次写磁盘的数据量都非常大(最高达到718MB/S)。
数据压缩降低网络负载
Kafka从0.7开始,即支持将数据压缩后再传输给Broker。除了可以将每条消息单独压缩然后传输外,Kafka还支持在批量发送时,将整个Batch的消息一起压缩后传输。数据压缩的一个基本原理是,重复数据越多压缩效果越好。因此将整个Batch的数据一起压缩能更大幅度减小数据量,从而更大程度提高网络传输效率。
Broker接收消息后,并不直接解压缩,而是直接将消息以压缩后的形式持久化到磁盘。Consumer Fetch到数据后再解压缩。因此Kafka的压缩不仅减少了Producer到Broker的网络传输负载,同时也降低了Broker磁盘操作的负载,也降低了Consumer与Broker间的网络传输量,从而极大得提高了传输效率,提高了吞吐量。
高效的序列化方式
Kafka消息的Key和Payload(或者说Value)的类型可自定义,只需同时提供相应的序列化器和反序列化器即可。因此用户可以通过使用快速且紧凑的序列化-反序列化方式(如Avro,Protocal Buffer)来减少实际网络传输和磁盘存储的数据规模,从而提高吞吐率。这里要注意,如果使用的序列化方法太慢,即使压缩比非常高,最终的效率也不一定高。

 2877


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


