paddle语音识别

【飞桨PaddleSpeech语音技术课程】— 语音识别-流式服务 阅读详情

1 安装PaddleSpeech

# 安装paddle
pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple

# 安装paddlespeech
pip install pytest-runner
pip install paddlespeech

# 语音切割包
pip install pydub

# 参考网址
https://github.com/PaddlePaddle/PaddleSpeech

2 简单使用

from paddlespeech.cli.asr.infer import ASRExecutor
asr = ASRExecutor()
# 使用的是官网上的音频
result = asr(audio_file="./data/zh.wav")
print(result)

3 出现的问题

# 提示缺少
Microsoft Visual C++ 14.0 is required.

解决方法

方法1

下载“VC_redist.x64.exe”,下载后安装即可

# 下载地址1
https://visualstudio.microsoft.com/zh-hans/downloads/#microsoft-visual-c-redistributable-for-visual-studio-2022
# 下载地址2
https://learn.microsoft.com/zh-cn/cpp/windows/latest-supported-vc-redist?view=msvc-170
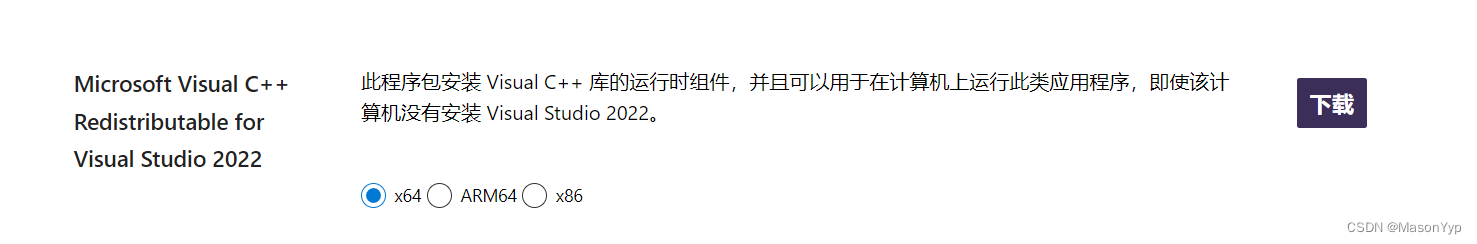
在这里插入图片描述

方法2

如果上述方法无法解决,下载“vs_BuildTools.exe”

# 下载地址
https://visualstudio.microsoft.com/zh-hans/visual-cpp-build-tools/

选择“单个组件”中C++ ATL v141 生成工具(x86 & x64)

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-h1xEVEKM-1665992974381)(paddle语言识别.assets/image-20221017154548989.png)]

PaddleSpeech 实战:开发与打包离线语音识别(ASR)命令行应用 《基于PaddleSpeech构建离线语音识别工具指南》摘要: 本文详细介绍如何利用PaddleSpeech构建离线语音识别工具的全流程。首先通过Conda创建隔离环境并安装PaddleSpeech,验证单文件识别功能后,开发了批量处理脚本(支持递归处理子目录音频文件)。针对离线部署需求,使用PyInstaller将Python脚本和模型打包成独立可执行文件,重点解决了模型本地加载问题。最终工具可在无网络、无Python环境的服务器上运行,自动将指定目录及其子目录下的.wav文件转换为文本,输出同名.txt 阅读详情

相关推荐

【飞桨PaddleSpeech语音技术课程】— 声音分类

【飞桨PaddleSpeech语音技术课程】— 声音分类

小湉湉的博客 3492

一键智能视频语音转文本——基于PaddlePaddle语音识别与Python轻松提取视频语音并生成文案

这个项目的核心算法是基于PaddlePaddle的语音识别加Python实现了一键从视频转成文本的功能,项目支持可以处理短语音识别、长语音识别、实现输入的语音识别,项目有完整的代码,带UI界面。

知来者逆的博客 9752

比较流行的一些音频AI模型

一些流行的音频模型介绍

weixin_59602119的博客 2881

基于PaddleSpeech实现语音识别

遍历每一个文件,将它们分别送入ASRExecutor进行识别,所有识别文本集中保存到列表words里,最终写入result.csv文件。通过auditok.split来对音频进行切分,切分后新建目录:change/audio/文件名/,将文件存入该目录。一段python办公自动化抖音广告语,因为有背景音乐,所以判断为Music。执行后qiefen(“1.wav”)后,可以把1.wav进行切分。PaddleSpeech识别最长语音为50s,故需要切分。这段广告语被完整识别出来,唯一的问题是不带标点符号。

直到世界的尽头 2078

python paddle实现语音识别、语音合成

python paddle实现语音识别和语音合成

qq_30895747的博客 831

paddle 语谱图对比

首先,我们导入了PaddlePaddle和Paddle Audio模块,以及一些用于处理音频的特征提取器,例如LogMelSpectrogram、MFCC、Spectrogram和MelSpectrogram。然后,我们选择一个特征提取器,并用它处理我们的音频数据。在这里,我们使用LogMelSpectrogram特征提取器,它可以将音频数据转化为音频信号的时频图像,并返回一个包含提取的特征的张量。接下来,我们使用Paddle Audio中的load函数导入一个音频文件,返回值为音频数据和采样率。

东方佑 566

Paddle-Lite赋能智能家居:语音识别模型端侧部署全指南

你是否经历过这样的场景:清晨唤醒智能音箱时,它总是需要3-5秒才能响应指令;对话过程中频繁出现"网络连接超时";设备在播放音乐时无法同时处理语音命令?这些体验痛点的背后,是传统云端语音识别方案在**响应延迟**(平均300ms+网络往返)、**隐私安全**(语音数据上传风险)和**离线可用性**(断网时功能失效)三个维度的固有缺陷。 Paddle-Lite作为飞桨推出的端侧推理引擎,通过**模型...

gitblog_00242的博客 980

dnSpy 6.1.8终版指南:反编译、调试与修改.NET程序集

在.NET开发与运维中,程序集(DLL)作为编译产物,常因源码缺失而成为排查与修复的难点。反编译工具通过解析元数据与IL指令,将二进制还原为可读的C#代码,是理解黑匣子行为的关键技术。dnSpy作为一款集反编译、调试、修改与回写于一体的桌面工具,不仅支持无PDB的进程附加与断点调试,还能直接编辑C#或IL并保存程序集,特别适用于第三方DLL修复、线上故障分析及安全研究等场景。本文以dnSpy 6.1.8终版为核心,围绕环境配置、反编译操作、调试技巧、程序集改写及常见坑位展开,为无源码维护提供一套可落地的工程

weixin_33984032的博客 435

2021-10-13 paddle实际运行语音识别

使用第十个epoch生成的模型进行语音识别,报错: {'error': 1, 'msg': 'audio read fail!'} 怀疑语音采样频率问题,使用 QVE音频剪辑 (qvevideo.com)http://www.qvevideo.com/business/audio?source=baidu&plan=QVEgeshizhuanhuan&unit=QVE-geshizhuanhuan&keyword=yinpinzhuanhuanlvsemiananzhuangb

weixin_44228114的博客 1018

Gamma变换算法之Matlab&FPGA实现

Gamma映射原理 什么是Gamma曲线 人眼的感光与光强并不是呈线性关系的,而是呈非线性关系(指数型关系,如下图左-曲线。在低照度下,人眼更容易分辨出亮度的变化,随着照度的增加,人眼不易分辨出亮度的变化。而图像传感器与输入光强呈线性关系(如下图左-直线)。从图中可见,当传感器感光在20%左右时,人眼感光响应达到了50%,人眼对低照度的变化更为敏感。从下图右侧可见,Reference Tone为人眼感光50%的亮度,而传感器在感光50%时则相对暗的多(见Select,近似中性灰)。这种将原始图像通过映射操

CrazyBingo的博客 7406

死磕GMSSL通信-java/Netty系列(二)

Netty-tcnative再linux编译比较好编译,但是再window编译,我尝试了各种办法,总是编译失败,所以我采用半自动的方式进行编译,Netty-tcnative会生成临时文件,直接用vs打开,设置openssl的头文件和静态库路径,然后生成静态库,静态库改个名字放到jar包里边,其实自动编译也是这个原理哈哈O(∩_∩)O。直接传输五个证书的路径吗,之前有的是说要转成x509之类的,转来转去的有点麻烦,这个是直接传输证书路径,由底层gmssl去解析,格式必须是pem格式。然而,若项目已依赖于。

qq_36577699的博客 3025

asr 语音识别方法 基于paddle的方法

asr声音内容识别

sslfk的博客 826

一文讲清CAN和CANFD的区别

本文将从技术原理、协议特性到应用场景,深度解析两者的核心差异。

文章主要涉及嵌入式软件开发、测试、项目管理等,欢迎交流,共同进步。 3209

paddle记录

W0415 16:40:54.818552 17125 device_context.cc:362] Please NOTE: device: 0, GPU Compute Capability: 7 OSError: (External) Cudnn error, CUDNN_STATUS_INTERNAL_ERROR (at /paddle/paddle/fluid/platform/dev W0418 11:28:11.296656 1805 device_context.cc:362] Pl

u012720552的专栏 1538

数字IC后端笔记-libcell命名规则与标准单元库介绍

ND3D1BWP13T40P140HVTND3D1BWP13T40P140HVTTSMC两种工艺,Metalization Stack的截面示意图:还有一层AP用来走RDL,RDL这层是最厚的一层,一般用于连接IO的bump,信号线基本上不会用这层绕线。

sinat_41774721的博客 2465

越野换了逐飞的ips200pro的屏幕后代码烧录中报错: “Cannot initialize device connection” 和 “Flashing failed” ...如何解决?

🏆 本文收录于《全栈Bug调优(实战版)》专栏,致力于分享我在项目实战过程中遇到的各类Bug及其原因,并提供切实有效的解决方案。无论你是初学者还是经验丰富的开发者,本文将为你指引出一条更高效的Bug修复之路,助你早日登顶,迈向财富自由的梦想🚀!同时,欢迎大家关注、收藏、订阅本专栏,更多精彩内容正在持续更新中。让我们一起进步,Up!Up!Up!    备注: 部分问题/难题源自互联网,经过精心筛选和整理,结合数位十多年大厂实战经验资深大佬经验总结所得,数条可行方案供所需之人参考。

**My Coding Family** 1150

5分钟搞定语音识别:飞桨实战避坑指南

想要快速上手深度学习语音识别?飞桨PaddlePaddle为你提供了一套完整的解决方案!作为百度开源的深度学习平台,飞桨在语音识别领域有着丰富的预训练模型和工具库,让开发者能够轻松构建高效的语音转文字应用。本文将为你提供一个完整的5分钟快速入门指南,帮助你避开常见陷阱,快速实现语音识别功能。 ## 🚀 为什么选择飞桨进行语音识别开发? 飞桨PaddlePaddle作为工业级深度学习框架,在语

gitblog_01075的博客 330

基于MATLAB的奇异谱分析(SSA)算法详解

本文详细介绍了基于MATLAB的奇异谱分析(SSA)算法。文章首先阐述了SSA的基本概念、历史发展及其与传统信号分析方法的对比优势,指出SSA作为一种非参数、非线性时间序列分析方法,特别适合处理非平稳信号。随后详细解析了SSA算法的核心原理与数学模型,包括轨迹矩阵构建、奇异值分解、分组与重构四个关键步骤。文章还提供了完整的MATLAB实现框架和代码解析,涵盖参数检查、轨迹矩阵构建、SVD分解、分组策略和重构过程。最后,通过信号分解、去噪和预测三个应用案例展示了SSA的实际效果。

qq_42212808的博客 168

PaddleSpeech音频工具包终极指南:全面适配Paddle 3.0的语音处理利器

PaddleSpeech r1.5.0版本正式发布,这是一款功能强大的开源音频工具包,专为语音识别、文本转语音等应用场景设计。新版本全面适配Paddle 3.0框架,带来了更出色的性能和易用性,让语音处理变得更加简单高效。 ## 🎯 为什么选择PaddleSpeech音频工具包? **五大核心优势让你无法抗拒:** - **全面兼容Paddle 3.0** - 充分利用最新框架特性 - *

gitblog_00408的博客 986

2025华为od机试真题B卷【停车场费用统计】Python实现

2025华为od机试真题B卷【停车场费用统计】Python实现

MISAYAONE的博客 538

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

PaddleSpeech r1.5.0重磅发布:全面适配Paddle 3.0的音频工具包

你是否还在为语音处理工具包的版本兼容问题头疼?是否期待一个功能更强大、使用更便捷的音频处理框架?PaddleSpeech r1.5.0版本正式发布,全面适配Paddle 3.0,带来了诸多令人振奋的新特性和优化。读完本文,你将了解到PaddleSpeech r1.5.0的核心亮点、适配Paddle 3.0的具体改进、快速上手指南以及丰富的应用场景,让你轻松上手这款强大的音频工具包。 ## 新版本...

gitblog_00439的博客 418

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

终极指南:如何使用Paddle Lite快速部署移动端深度学习模型

Paddle Lite是百度推出的高性能移动端深度学习推理框架,专为移动设备和嵌入式设备设计,能够将复杂的AI模型高效运行在资源受限的环境中。作为一款轻量级、灵活性强且易于扩展的框架,Paddle Lite支持多种硬件平台和操作系统,让开发者能够轻松实现模型的移动端部署。🚀 ## Paddle Lite的核心优势 **极致轻量化**:Paddle Lite通过模型优化、算子融合等技术,显著减

gitblog_00028的博客 439

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

dockers、nvidia-dicker、nvidia-container-toolkit踩坑记

关于深度学习项目的docker部署踩坑记录,主要用来告诉大家一件事情,安装nvidia-container-toolkit而不是nvidia-docker,不要浪费时间在找没用的帖子身上,食用方式,一只手握住鼠标,一只手握住一杯卡布奇诺,嘶。。。

m9_743106469350的博客 7507

PaddlePaddle-DeepSpeech Nvidia Jetson部署:边缘计算语音识别实战指南

想要在边缘设备上实现高效的语音识别吗?PaddlePaddle-DeepSpeech为Nvidia Jetson开发板提供了完整的语音识别解决方案,让您能够在边缘计算环境中实现实时中文语音识别。本文将为您详细介绍如何在Nvidia Jetson设备上部署和运行这个强大的语音识别框架。 ## 为什么选择PaddlePaddle-DeepSpeech在边缘设备上运行? PaddlePaddle-D

gitblog_01063的博客 980

PaddlePaddle镜像在智能家居语音控制中的轻量化部署

利用PaddlePaddle官方镜像与Paddle Lite推理引擎,实现中文语音模型在低功耗设备上的高效端侧部署。统一开发环境、模型压缩与离线推理能力,显著降低响应延迟和隐私风险,助力智能音箱、空调等设备真正实现本地化语音控制。

weixin_42143092的博客 770
上一篇: 简单使用OnlyOffice
下一篇: Hadoop3.1.3 集群环境搭建
MasonYyp
博客等级 码龄9年 301粉丝 297原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
