


k8s+helm部署Milvus和Qdrant
- 操作系统: CentOS 7 (Core)
- 集群架构: 3 节点 (1 Master: 10.8.15.151, 2 Workers: 10.8.15.157, 10.8.15.206)
- 硬件资源: 每节点 10核 CPU / 13GB 内存
- 容器运行时: Containerd v1.6+
- 部署组件: Milvus Standalone (v2.4.6/v2.6.x), Attu UI (v2.4.0)
Kubernetes v1.28.0集群部署
集群环境规划
| 角色 | IP 地址 | 主机名 | 存储目录 |
|---|---|---|---|
| Master | 10.8.15.151 | k8s-master | /home/k8s-storage |
| Node1 | 10.8.15.157 | k8s-node1 | /home/k8s-storage |
| Node2 | 10.8.15.206 | k8s-node2 | /home/k8s-storage |
基础环境准备 (所有节点)
# 停止防火墙
systemctl stop firewalld && systemctl disable firewalld

# 禁用 SELinux
sudo setenforce 0
sudo sed -i 's/SELINUX=enforcing/SELINUX=disabled/g' /etc/selinux/config

# 关闭 Swap 分区 (K8s 要求)
sudo swapoff -a
sudo sed -i '/swap/d' /etc/fstab
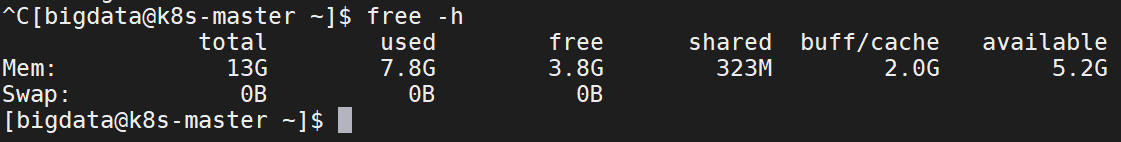
# 检查:free -h (确保 Swap 一栏为 0)
修改主机名与 Hosts 映射
# 根据机器身份分别执行:
# Master: sudo hostnamectl set-hostname k8s-master
# Node1:  sudo hostnamectl set-hostname k8s-node1
# Node2:  sudo hostnamectl set-hostname k8s-node2

# 在三台机器上都执行:
cat <<EOF | sudo tee -a /etc/hosts
10.8.15.151 k8s-master
10.8.15.157 k8s-node1
10.8.15.206 k8s-node2
EOF
优化内核参数与模块
# 加载内核模块
sudo modprobe br_netfilter
sudo modprobe overlay

# 优化网络参数
cat <<EOF | sudo tee /etc/sysctl.d/k8s.conf
net.bridge.bridge-nf-call-ip6tables = 1
net.bridge.bridge-nf-call-iptables = 1
net.ipv4.ip_forward = 1
vm.max_map_count = 262144
EOF

# 应用配置
sudo sysctl --system
安装 Containerd运行时 (所有节点)
sudo yum install -y yum-utils
sudo yum-config-manager --add-repo http://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo
sudo yum makecache fast
sudo yum install -y containerd.io
配置 Containerd
sudo mkdir -p /etc/containerd
containerd config default | sudo tee /etc/containerd/config.toml

# 1. 修改 Cgroup 驱动为 systemd
sudo sed -i 's/SystemdCgroup = false/SystemdCgroup = true/g' /etc/containerd/config.toml

# 2. 替换 pause 镜像源为阿里云
sudo sed -i 's#sandbox_image = "registry.k8s.io/pause:3.6"#sandbox_image = "registry.aliyuncs.com/google_containers/pause:3.9"#' /etc/containerd/config.toml

sudo systemctl restart containerd
sudo systemctl enable containerd
安装 Kubernetes 组件 (所有节点)
cat <<EOF | sudo tee /etc/yum.repos.d/kubernetes.repo
[kubernetes]
name=Kubernetes
baseurl=https://mirrors.aliyun.com/kubernetes/yum/repos/kubernetes-el7-x86_64/
enabled=1
gpgcheck=1
repo_gpgcheck=1
gpgkey=https://mirrors.aliyun.com/kubernetes/yum/doc/yum-key.gpg https://mirrors.aliyun.com/kubernetes/yum/doc/rpm-package-key.gpg
EOF
安装指定版本工具
sudo yum install -y kubelet-1.28.0 kubeadm-1.28.0 kubectl-1.28.0 --disableexcludes=kubernetes
sudo systemctl enable --now kubelet
k8s集群初始化 (Master 节点)
仅在 10.8.15.151 (Master) 上运行:
sudo kubeadm init \
  --apiserver-advertise-address=10.8.15.151 \
  --image-repository registry.aliyuncs.com/google_containers \
  --pod-network-cidr=10.244.0.0/16 \
  --kubernetes-version=v1.28.0
在 10.8.15.157 (Node1) 和 10.8.15.206 (Node2) 上运行初始化后生成的 join 命令:
sudo kubeadm join 10.8.15.151:6443 --token <your-token> \
        --discovery-token-ca-cert-hash sha256:<your-hash>
配置管理权限:
mkdir -p $HOME/.kube
sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
sudo chown $(id -u):$(id -g) $HOME/.kube/config
在主节点上初始化后,会生成一段加入集群的join 命令
在 10.8.15.157 (Node1) 和 10.8.15.206 (Node2) 上运行初始化后生成的 join 命令:
sudo kubeadm join 10.8.15.151:6443 --token <your-token> \
        --discovery-token-ca-cert-hash sha256:<your-hash>

#例如
kubeadm join 10.8.15.151:6443 --token opd5mu.3ok9pqrq86c6p2fz \
        --discovery-token-ca-cert-hash sha256:29d01bdc3b81689066a032bbe8aef0de7d6be71f0165df8f8006682a3b4ff61a
安装网络插件 (Master 节点)
在 Master 节点上安装 Flannel 以实现 Pod 互通:
kubectl apply -f https://raw.githubusercontent.com/flannel-io/flannel/master/Documentation/kube-flannel.yml
持久化存储配置(Local Path Provisioner)
创建物理目录 (所有节点)
sudo mkdir -p /home/k8s-storage
sudo chmod 777 /home/k8s-storage
部署 Local Path Provisioner (Master 节点)
kubectl apply -f https://raw.githubusercontent.com/rancher/local-path-provisioner/v0.0.26/deploy/local-path-storage.yaml

# 修改配置以指向自定义目录 /home/k8s-storage
# 找到 config.json 里的路径并修改
kubectl edit cm local-path-config -n local-path-storage

# 设置为默认存储类
kubectl patch storageclass local-path -p '{"metadata": {"annotations":{"storageclass.kubernetes.io/is-default-class":"true"}}}'
安装 Helm 工具 (Master 节点)
# 下载并解压
wget https://get.helm.sh/helm-v3.13.1-linux-amd64.tar.gz
tar -zxvf helm-v3.13.1-linux-amd64.tar.gz

# 移动二进制文件
sudo mv linux-amd64/helm /usr/local/bin/helm
sudo chmod +x /usr/local/bin/helm

# 验证
helm version
集群状态验证 (Master 节点)
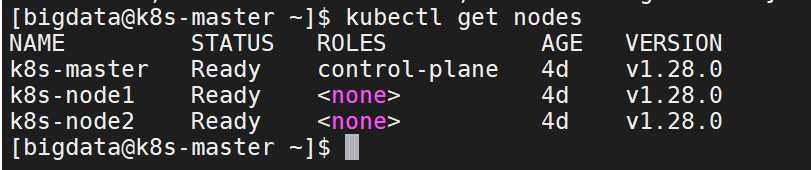
# 检查节点状态 (预期为 Ready)
kubectl get nodes

# 检查所有 Pod 状态
kubectl get pods -A
milvus部署
环境资源痛点:
当前集群单节点内存仅为 13GB。Milvus 官方的 Cluster(集群)模式 强依赖重量级的消息队列(Pulsar集群),在当前资源下极易触发 OOM(内存溢出)导致全线崩溃。
解决方案:3 节点 K8s + Milvus Standalone 分布式调度架构
这是一个经常被误解的概念:K8s 节点多 ≠ 必须用集群微服务模式。
我们采用 Standalone(单机版) 模式部署,但完美利用了 Kubernetes 的 分布式调度机制。一个完整的 Milvus 数据库包含三大核心组件,K8s 会自动将它们“打散”到你的 3 台物理机上运行:
| 组件名称 | 作用 | 预期调度节点 (示例) | 资源消耗评估 |
|---|---|---|---|
| Etcd | 元数据存储 | k8s-node1 | 内存消耗较高,负责集群元数据强一致性 |
| MinIO | 对象存储 | k8s-node1 | 负责向量数据的落盘持久化 |
| Milvus Standalone | 核心计算引擎 | k8s-node2 | 最吃 CPU 和内存,独享 Node2 算力进行向量检索与索引构建 |
| Attu UI | 可视化前端 | k8s-master | 轻量级 Web 服务,处理外部浏览器请求 |
此架构的核心优势:
- 极限负载均衡:避免了所有组件挤在一台 13GB 机器上导致系统瘫痪。
- 高可用故障转移 (Failover):如果 k8s-node2 物理机突然宕机,K8s 控制平面会立刻在存活的 Master 或 Node1 上重新拉起 Milvus 核心引擎,业务自动恢复,这是传统物理机单机部署无法做到的。
准备 Milvus Helm Chart
由于国内服务器直接从 GitHub 或官方 Helm 仓库拉取容易出现超时(unexpected EOF 等错误),建议直接使用下载好的离线 Chart 包
# 在 Master 节点下载 (或者在有网的电脑下载后传到服务器)
wget https://github.com/zilliztech/milvus-helm/releases/download/milvus-5.0.15/milvus-5.0.15.tgz

# 解压备用 (可选,直接使用 .tgz 文件也可以)
tar -zxvf milvus-5.0.15.tgz
创建精简版配置文件 (values-minimal.yaml)
为了防止 OOM (内存溢出) 以及规避 Helm 默认配置中 requests 大于 limits 导致的安装失败,我们需要创建一个高度定制的配置文件。同时,在此配置文件中直接将依赖组件(Etcd/MinIO)的镜像源指向国内阿里云同步仓,避免 ImagePullBackOff。
最暴力且绝对有效的解法:直接在 Helm 的 values.yaml 中,将所有组件的 image.repository 硬编码替换为你的“阿里云个人专属加速器前缀 + 原镜像路径”。这样可以彻底绕过 Docker Hub 的网络封锁。
在 Master 节点创建 values-minimal.yaml:
cluster:
  enabled: false

etcd:
  replicaCount: 1
  image:
    repository: bc91867c.mirror.aliyuncs.com/etcd
    tag: 3.5.9
  resources:
    limits: { memory: "512Mi" }
    requests: { memory: "256Mi" }

minio:
  mode: standalone
  image:
    #直接使用阿里云个人专属镜像加速地址
    repository: bc91867c.mirror.aliyuncs.com/minio/minio
    tag: RELEASE.2024-12-18T13-15-44Z
  resources:
    limits: { memory: "512Mi" }
    requests: { memory: "256Mi" }

pulsar:
  enabled: true
  broker:
    replicaCount: 1
    image:
      repository: bc91867c.mirror.aliyuncs.com/apachepulsar/pulsar
      tag: 3.0.3
    resources:
      limits: { memory: "512Mi" }
      requests: { memory: "256Mi" }
  bookkeeper:
    replicaCount: 1
    image:
      repository: bc91867c.mirror.aliyuncs.com/apachepulsar/pulsar
      tag: 3.0.3
    resources:
      limits: { memory: "512Mi" }
      requests: { memory: "256Mi" }
  zookeeper:
    replicaCount: 1
    image:
      repository: bc91867c.mirror.aliyuncs.com/apachepulsar/pulsar
      tag: 3.0.3
    resources:
      limits: { memory: "512Mi" }
      requests: { memory: "256Mi" }
  proxy:
    replicaCount: 1
    image:
      repository: bc91867c.mirror.aliyuncs.com/apachepulsar/pulsar
      tag: 3.0.3
    resources:
      limits: { memory: "256Mi" }
      requests: { memory: "128Mi" }

standalone:
  image:
    repository: bc91867c.mirror.aliyuncs.com/milvusdb/milvus
    tag: v2.4.6
  resources:
    limits: { memory: "2Gi" }
    requests: { memory: "1Gi" }

mixcoord:
  resources:
    limits: { memory: "512Mi" }
    requests: { memory: "256Mi" }

metrics: { enabled: false }
grafana: { enabled: false }
prometheus: { enabled: false }
执行 Helm 部署
# 创建命名空间
kubectl create namespace milvus

# 执行部署 (使用本地 tgz 包和配置)
helm install my-milvus ./milvus-5.0.15.tgz -n milvus -f values-minimal.yaml
观察服务启动状态
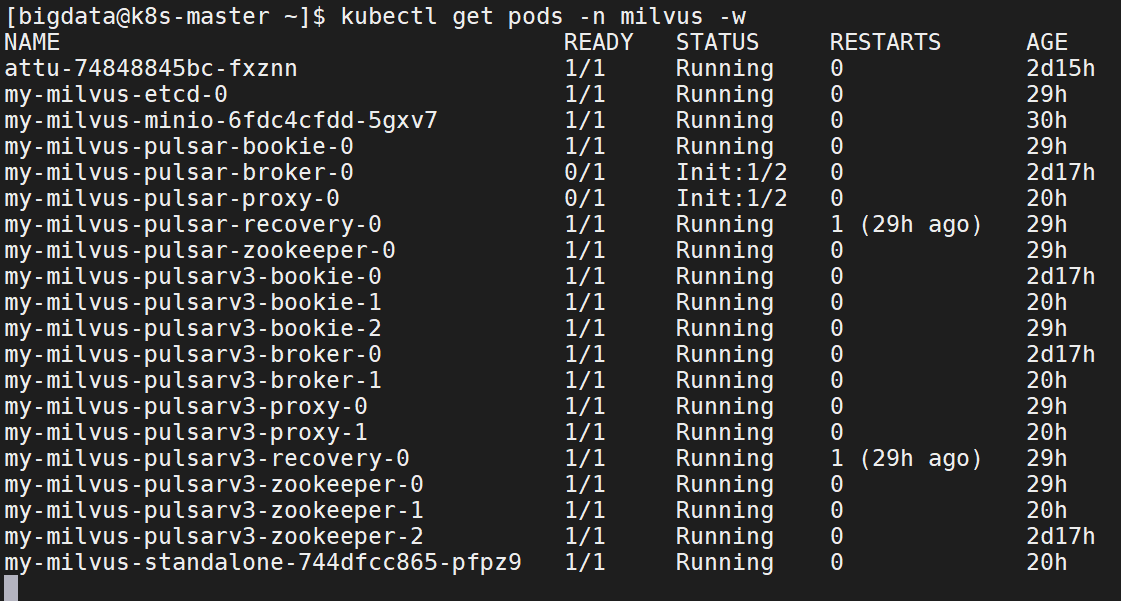
# 实时监控 Pod 状态
kubectl get pods -n milvus -w
部署 Attu (图形化可视化界面)
Attu 是 Milvus 官方提供的 Web 管理工具。由于它是外部客户端,必须通过 K8s 内部 DNS 连接到 Standa。
cat << 'EOF' > attu.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: milvus-attu
  namespace: milvus
spec:
  replicas: 1
  selector:
    matchLabels:
      app: attu
  template:
    metadata:
      labels:
        app: attu
    spec:
      containers:
      - name: attu
        image: zilliz/attu:v2.4.0
        ports:
        - containerPort: 3000
        env:
        # 关键配置:指向 Milvus Standalone 的 K8s 内部集群域名
        - name: MILVUS_URL
          value: "my-milvus.milvus.svc.cluster.local:19530"
---
apiVersion: v1
kind: Service
metadata:
  name: attu-svc
  namespace: milvus
spec:
  selector:
    app: attu
  ports:
  - protocol: TCP
    port: 3000
    targetPort: 3000
  type: ClusterIP
EOF
应用配置并启动
kubectl apply -f attu.yaml

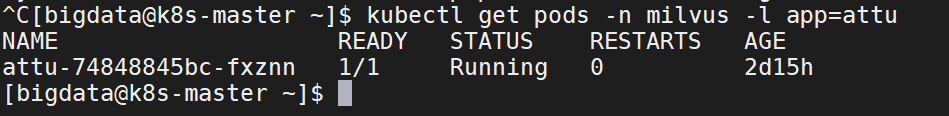
# 检查 Attu 是否启动成功
kubectl get pods -n milvus -l app=attu
暴露端口供外部访问 (关键步骤)
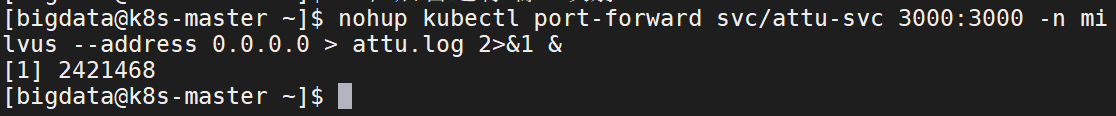
# 在后台运行端口映射
nohup kubectl port-forward svc/attu-svc 3000:3000 -n milvus --address 0.0.0.0 > attu.log 2>&1 &
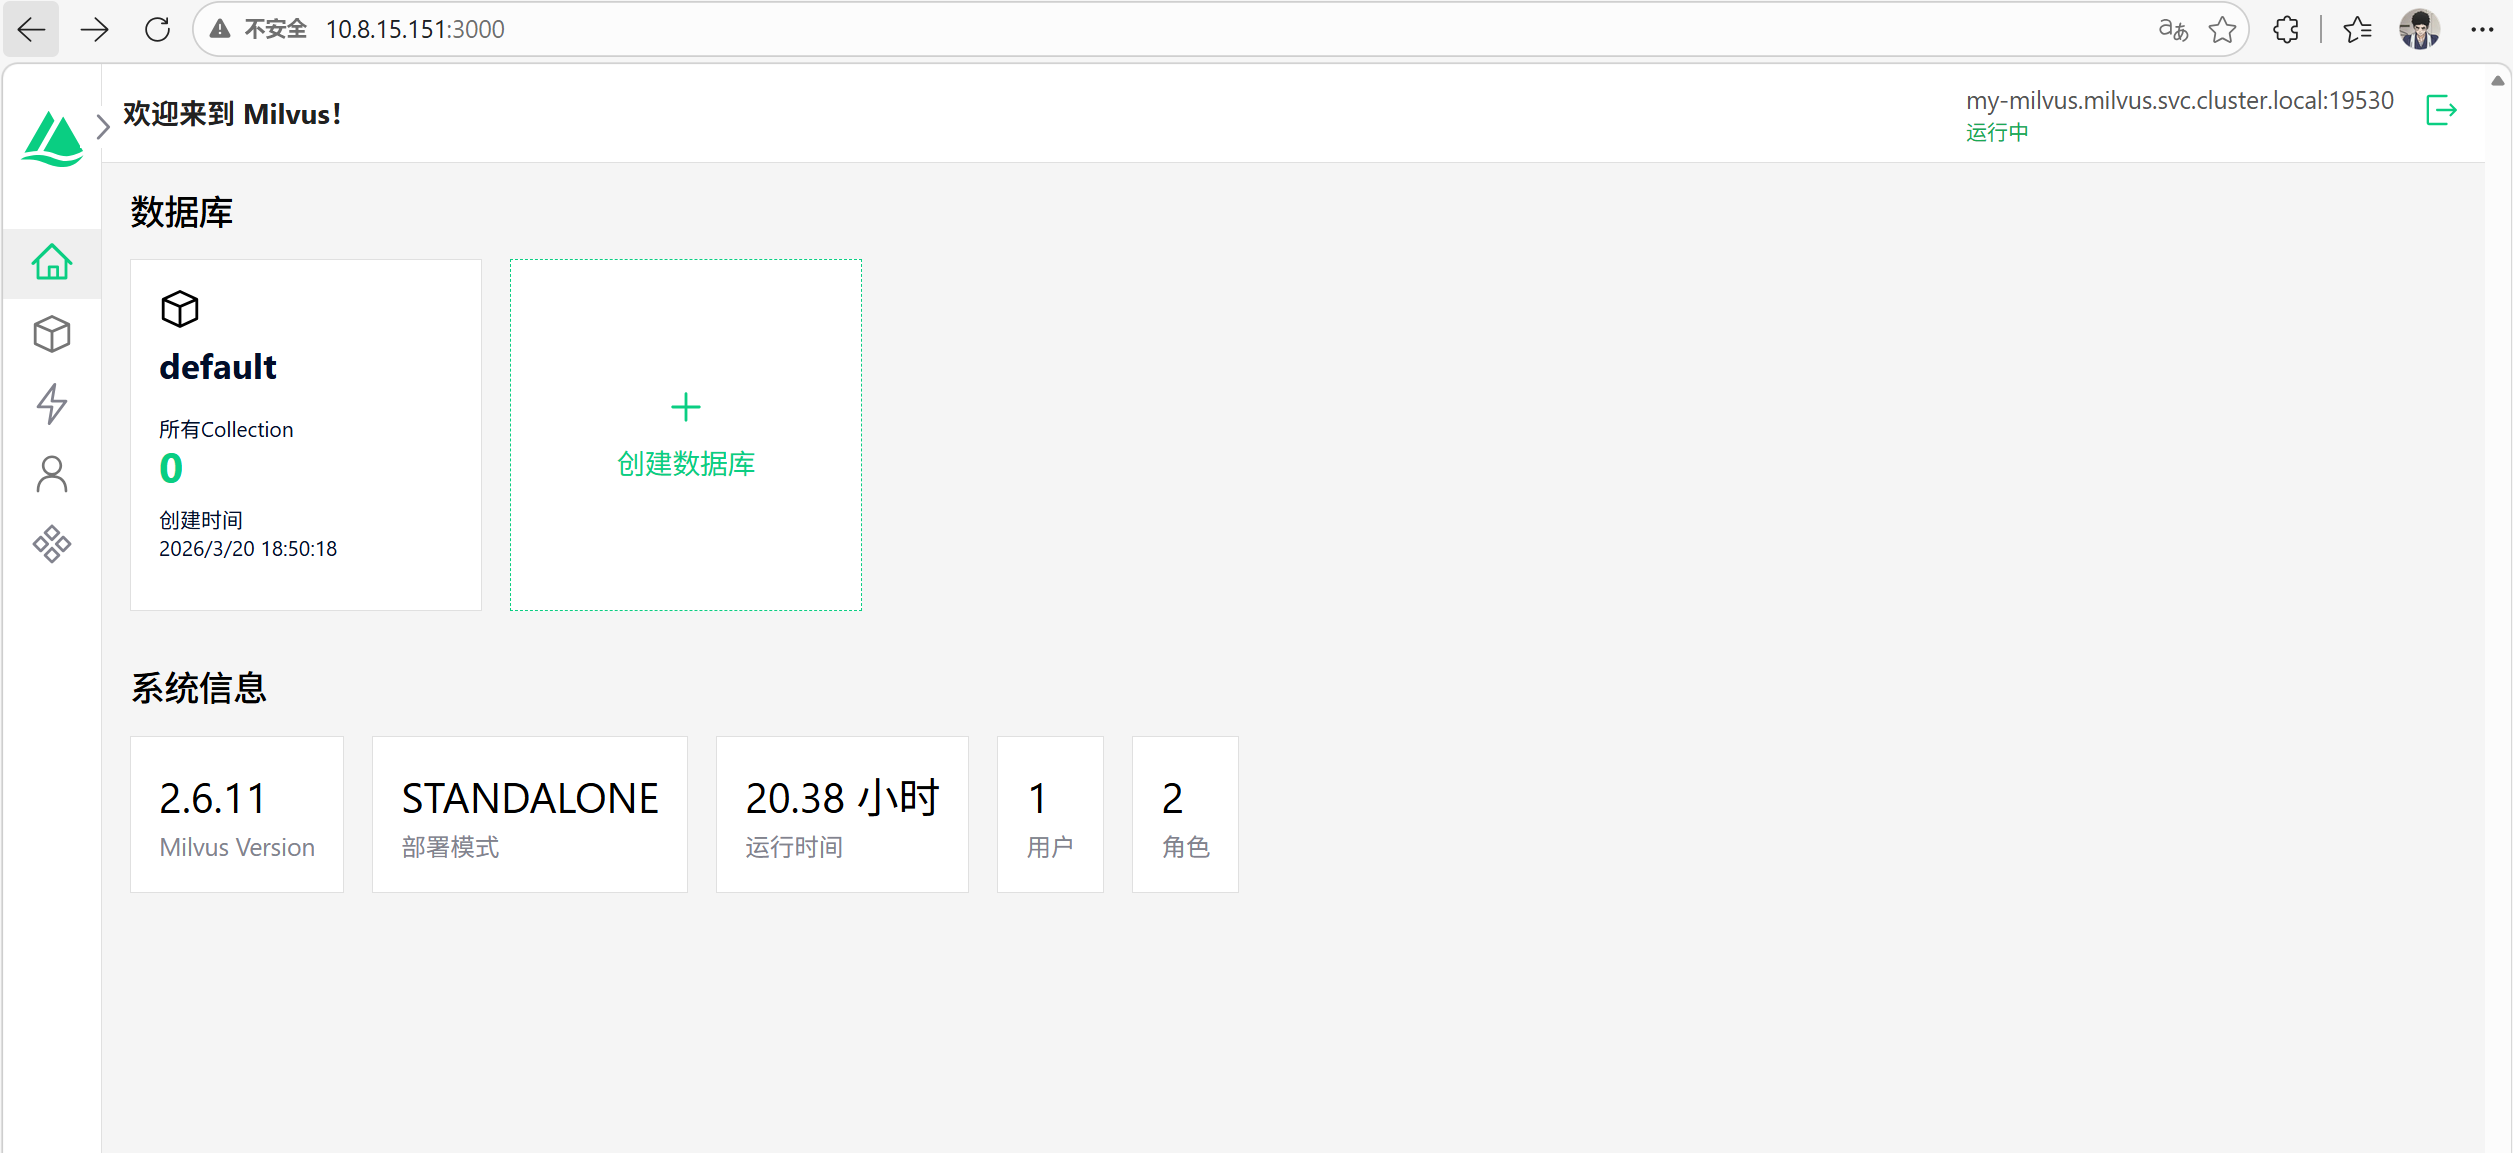
访问方式:
打开浏览器,访问:http://10.8.15.151:3000
账号密码留空,直接点击 Connect 即可进入 Milvus 控制台
🚨核心故障避坑记录 (Troubleshooting)
| 故障现象 | 根本原因 | 修复方案 / 避坑指南 |
|---|---|---|
| Kube-apiserver 启动崩溃 lookup localhost on 8.8.8.8:53 timeout | CentOS 节点的 /etc/hosts 文件中丢失了 localhost 的解析定义。 | 在所有节点的 /etc/hosts 顶部补充: 127.0.0.1 localhost ::1 localhost |
| Helm 安装报错 requests: Invalid value: “2Gi”: must be less than limits 512Mi | Values 配置中只强行压缩了 limits 内存,未同步修改 requests。 | 在编写 values.yaml 时,requests 和 limits 必须成对配置,且 requests <= limits。 |
| 镜像拉取假死 ContainerCreating 卡住,最终抛出 ErrImagePull | 国内彻底屏蔽了 docker.io,且高版本 Containerd 对旧版 mirrors 语法不兼容。 | 放弃网络拉取。统一在 Master 使用可用代理拉取后,通过 ctr images export 和 scp 物理分发,用 ctr import 导入本地。 |
| Attu 界面打不开 浏览器访问 3000 端口报 ERR_CONNECTION_REFUSED | kubectl port-forward 默认只绑定 127.0.0.1 接口。 | 必须先 kill 掉旧的映射进程,重新执行端口映射时,末尾务必加上 --address 0.0.0.0。 |
| 在编写 values.yaml 时,requests 和 limits 必须成对配置,且 requests <= limits。 | ||
| 镜像拉取假死 ContainerCreating 卡住,最终抛出 ErrImagePull | 国内彻底屏蔽了 docker.io,且高版本 Containerd 对旧版 mirrors 语法不兼容。 | 放弃网络拉取。统一在 Master 使用可用代理拉取后,通过 ctr images export 和 scp 物理分发,用 ctr import 导入本地。 |
| Attu 界面打不开 浏览器访问 3000 端口报 ERR_CONNECTION_REFUSED | kubectl port-forward 默认只绑定 127.0.0.1 接口。 | 必须先 kill 掉旧的映射进程,重新执行端口映射时,末尾务必加上 --address 0.0.0.0。 |
| Pod 陷入 CrashLoopBackOff | 启动顺序竞争:Milvus 核心进程启动极快,但 Etcd 还没拉起,导致连不上元数据中心而自杀。 | 无需人工干预。等待 Etcd 和 MinIO 状态变为 Running 后,Milvus 核心 Pod 会在下一次自动重启时成功拉起。 |
Qdrant部署
一.环境信息
| 项目 | 配置 |
|---|---|
| Kubernetes 版本 | v1.28.0 |
| 部署方式 | Helm Chart |
| Chart 版本 | qdrant-1.17.0 |
| 应用版本 | v1.17.0 |
| 命名空间 | qdrant |
| 节点数 | 3(master + 2 worker) |
二.节点信息
#查看k8s的集群状态,正常如下表格所示
kubectl get nodes -o wide
| 节点 | IP | 角色 | 状态 |
|---|---|---|---|
| k8s-master | 10.8.15.151 | control-plane | Ready |
| k8s-node1 | 10.8.15.157 | worker | Ready |
| k8s-node2 | 10.8.15.206 | worker | Ready |
三.前置条件
3.1 内核模块配置(所有节点)
# 加载 br_netfilter 模块
sudo modprobe br_netfilter

# 设置 sysctl 参数
cat <<EOF | sudo tee /etc/modules-load.d/k8s.conf
br_netfilter
EOF

cat <<EOF | sudo tee /etc/sysctl.d/k8s.conf
net.bridge.bridge-nf-call-iptables = 1
net.bridge.bridge-nf-call-ip6tables = 1
net.ipv4.ip_forward = 1
EOF

sudo sysctl --system
3.2 安装 Helm
curl https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 | bash
3.3 添加 Qdrant Helm 仓库
helm repo add qdrant https://qdrant.github.io/qdrant-helm
helm repo update
四.部署配置
4.1 创建命名空间
kubectl create namespace qdrant
4.2 准备 values.yaml
# qdrant-values.yaml
replicaCount: 3

image:
  repository: docker.io/qdrant/qdrant
  tag: v1.17.0
  pullPolicy: IfNotPresent

config:
  cluster:
    enabled: true
    p2p:
      port: 6335
      enable_tls: false
    consensus:
      tick_period_ms: 100
  service:
    enable_tls: false

service:
  type: NodePort
  ports:
    - name: http
      port: 6333
      targetPort: 6333
      protocol: TCP
    - name: grpc
      port: 6334
      targetPort: 6334
      protocol: TCP
    - name: p2p
      port: 6335
      targetPort: 6335
      protocol: TCP

persistence:
  enabled: true
  size: 50Gi
  accessModes:
    - ReadWriteOnce

resources:
  limits:
    cpu: 2000m
    memory: 2500Mi
  requests:
    cpu: 500m
    memory: 1000Mi

affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
            - key: app.kubernetes.io/name
              operator: In
              values:
                - qdrant
        topologyKey: kubernetes.io/hostname

podManagementPolicy: Parallel

updateVolumeFsOwnership: true
4.3 执行部署
helm install qdrant-cluster qdrant/qdrant \
  --namespace qdrant \
  --version 1.17.0 \
  -f qdrant-values.yaml
五.验证部署
5.1 查看 Pod 状态
kubectl get pods -n qdrant -o wide
预期输出:
NAME               READY   STATUS    RESTARTS   AGE
qdrant-cluster-0   1/1     Running   0          5m
qdrant-cluster-1   1/1     Running   0          5m
qdrant-cluster-2   1/1     Running   0          5m
5.2 查看 Service
kubectl get svc -n qdrant
输出:
NAME                      TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)
qdrant-cluster            NodePort    10.99.68.118   <none>        6333:31063/TCP,6334:31332/TCP,6335:30783/TCP
qdrant-cluster-headless   ClusterIP   None           <none>        6333/TCP,6334/TCP,6335/TCP
5.3 健康检查
# 端口转发
kubectl port-forward svc/qdrant-cluster 6333:6333 -n qdrant &

# 健康检查
curl http://127.0.0.1:6333/healthz
# 预期输出: healthz check passed
六.访问方式
6.1 Web UI Dashboard
http://<节点IP>:31063/dashboard
可用地址:
- http://10.8.15.151:31063/dashboard
- http://10.8.15.157:31063/dashboard
- http://10.8.15.206:31063/dashboard
6.2 API 端点
| 协议 | 地址 | 端口 |
|---|---|---|
| HTTP | http://10.8.15.151:31063 | 31063 |
| gRPC | http://10.8.15.151:31332 | 31332 |
七、Python 客户端测试
7.1 安装客户端
pip install qdrant-client
7.2 测试脚本
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, VectorParams, PointStruct
import numpy as np

# 连接配置
client = QdrantClient(host="10.8.15.151", port=31063)

# 创建集合
client.create_collection(
    collection_name="test_collection",
    vectors_config=VectorParams(size=128, distance=Distance.COSINE),
)

# 插入数据
points = [
    PointStruct(
        id=i,
        vector=np.random.rand(128).tolist(),
        payload={"name": f"item_{i}", "category": f"cat_{i % 5}"}
    )
    for i in range(100)
]
client.upsert(collection_name="test_collection", points=points)

# 搜索测试
results = client.query_points(
    collection_name="test_collection",
    query=np.random.rand(128).tolist(),
    limit=5,
    with_payload=True
)

print(f"找到 {len(results.points)} 个结果")
for r in results.points:
    print(f"ID={r.id}, Score={r.score:.4f}")
 541


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


