


Spark SQL 2.4.0 性能调优实战指南 (基于 CDH 6.3.2)
一、 集群硬件资源统计总结 (Baseline)
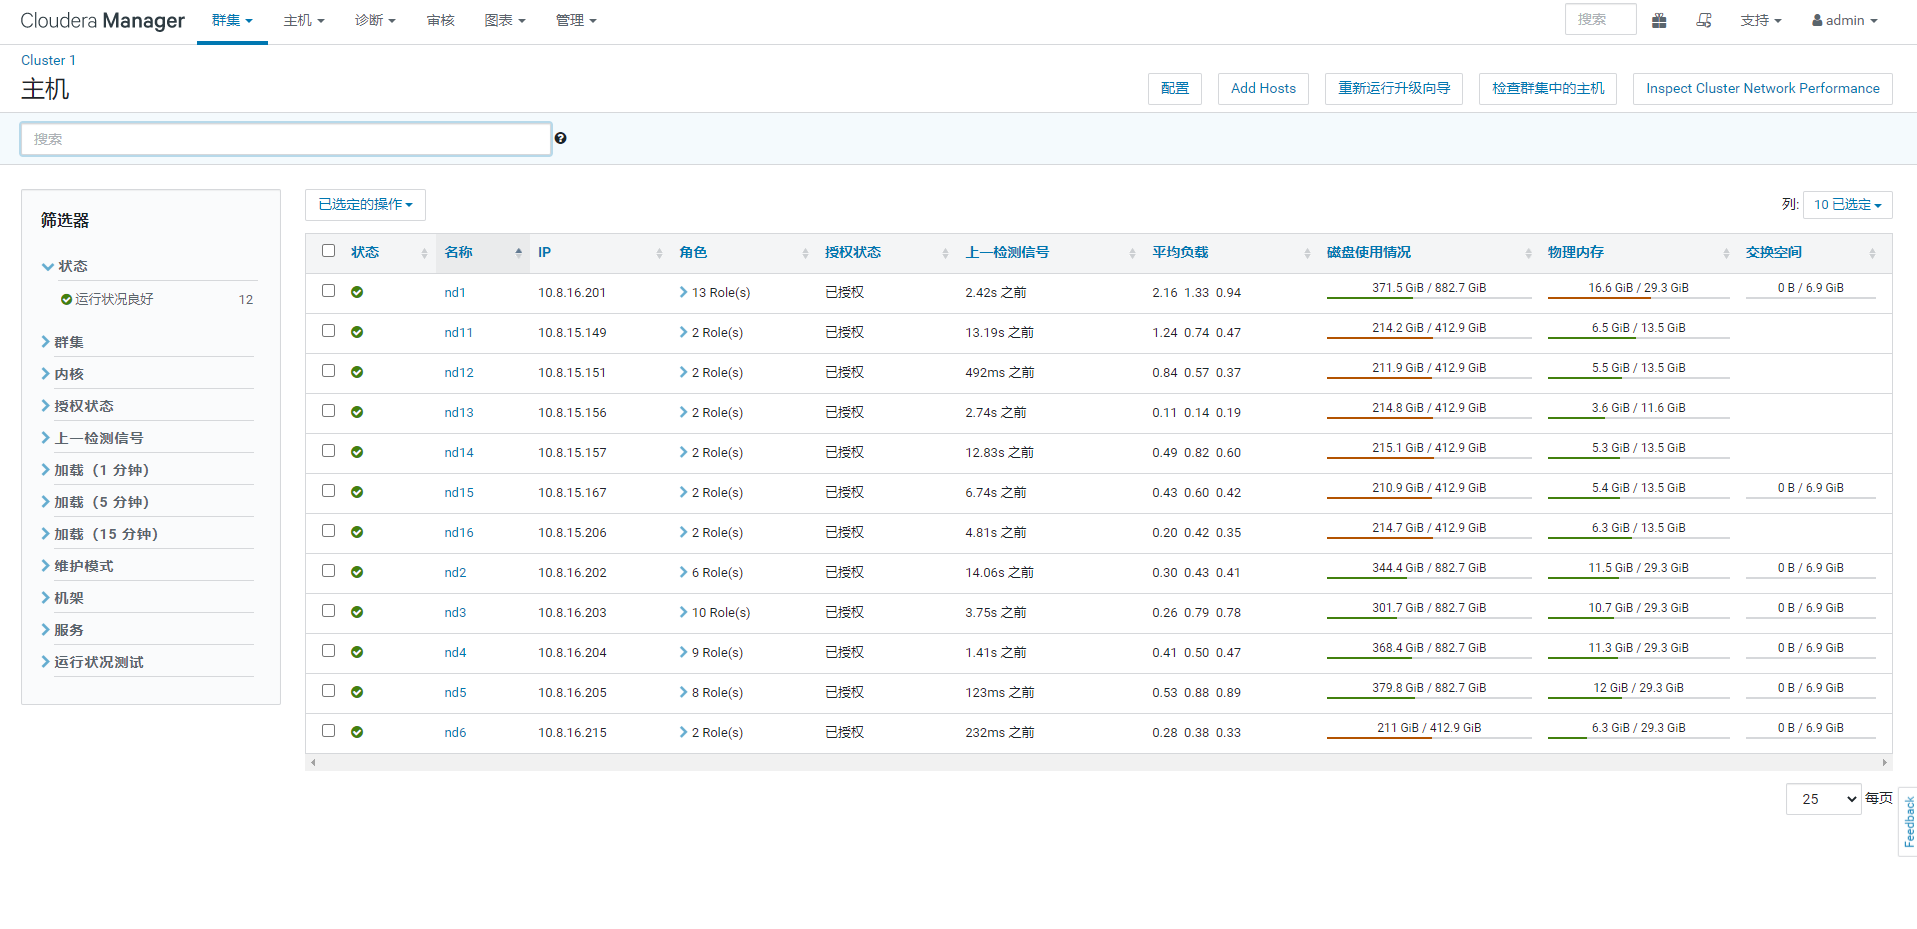
- 高性能组 (nd1-nd5): 5台,14核 CPU,约 30GB 内存。
- 标准组 (nd6, nd11-nd16): 7台,10核 CPU,约 13GB 内存。
- 总结: 全集群总计 140 vCPU,约 250GB 物理内存。由于内存极度有限,调优核心在于:严控 Executor 内存,防止 Yarn 杀进程。
业务背景:千万级招投标大数据治理项目
在企业级数据仓库建设中,招投标数据是极具商业价值但也极具治理挑战的一类数据。本项目主要针对 5000万级关联单位数据、5000万级招投标基础信息以及1600万级正文详情进行深度清洗、去重与标准化治理。
1.1 数据现状与规模
治理对象涉及三张核心业务表,部署于 CDH 6.3.2 (Spark 2.4.0) 集群:
- 基础信息表 (
t_bidding_info): 约 2000 万条记录(rowdatasize数据为2298725621 即20.77gb),作为治理的主干。 - 关联单位表 (
t_bidding_related): 约 5000 万条记录,涉及复杂的“一对多”关系。 - 正文内容表 (
t_bidding_content): 约 1600 万条记录,包含核心字段content_html。该字段存储完整的 HTML 网页源代码,单行体积巨大。
1.2 技术痛点:大文本与极度倾斜
- 大文本内存压力:
content_html在 Shuffle 过程中涉及高频序列化与反序列化。若堆外内存(Overhead)不足,Yarn 会因Memory limits exceeded频繁杀掉 Container。 - 计算逻辑复杂: 治理过程包含多层嵌套、窗口函数 (
row_number) 去重、跨表LEFT JOIN补全地域维表(省市区三级映射),对计算引擎的并行度控制要求极高。 - 硬件资源受限: 节点存在 13.5GB 内存短板,无法盲目通过增加 Executor 内存来解决问题。
1.3 治理目标
- 高稳定性: 解决大字段导致的 OOM 和 Yarn 容器被杀问题,确保任务 100% 成功。
- 防倾斜: 通过参数规避和 SQL “加盐”技术,解决招投标行业常见的“热点 Key”导致的计算长尾。
- 高性能: 在有限资源下,通过优化并行度和 Join 策略,使任务在最短时间内完成。
二、 官方核心参数详解与测算逻辑
在调优前,可以参考以下官方权威指南以确保参数语义准确:
2.1 核心参数调优逻辑
| 参数名称 | 官方默认值 | 核心作用与计算意义 |
|---|---|---|
| spark.executor.memory | 1G | 堆内内存。用于 Join 哈希表、窗口函数缓存、Task 执行。 |
| spark.executor.cores | 1 (YARN模式) | 并发能力。一个 Executor 进程内同时运行的任务线程数。 |
| memoryOverhead | max(384M, 10% memory) | 堆外内存。用于 NIO 缓存、字符串序列化、管理开销。 |
| num-executors | 2 | 资源总量。在集群中启动的计算单元(车间)总数。 |
| shuffle.partitions | 200 | 任务粒度。Shuffle 阶段将数据横向切分的份数。 |
在 Spark 2.4 环境下,调优的核心策略是:“基于短板定单体,基于总量定并发”。
2.1 单体 Executor 规格测算:为何锁定 6GB?
虽然标准组节点(13.5GB)的 YARN 极限约为 9GB,但将单体容器(Container)上限锁定为 6GB。
- 总内存上限: 6GB
- 堆外内存 (Overhead): 建议设为 2GB (应对 HTML 序列化缓冲区)。
- 堆内内存 (Executor Memory): 6GB - 2GB = 4GB。
(1) 理由:异构集群的“填充效率”
- 大节点 (nd1-nd5, 24G可用):若设为 8G,每台放 3 个容器(Container);若设为 6G,每台放 4 个容器(Container)。
- 小节点 (nd6/11-16, 9G可用):无论 6G 还是 8G,都只能放 1 个容器(Container)。
- 推理结论:6G 规格作为“原子单位”,能在大内存节点多出 33% 的并发槽位,避免资源碎块化浪费。
(2) 理由:系统稳定性与“呼吸空间”
- 测算过程:小节点物理总额 13.5G。若 YARN 占满 9G,剩下 4.5G 需支撑 OS、DataNode 和 NodeManager。
- 风险:处理大 HTML 时瞬时申请内存极高,若无冗余会触发 Linux OOM Killer 导致挂机。
- 决策:设定单体 6G,为物理机留出约 3.5GB 安全缓冲。
2.2 内部配比测算:堆内 vs 堆外
针对 content_html 大文本任务,内存必须向堆外(Overhead)倾斜。
(1) 堆外内存 (MemoryOverhead) 测算
堆外内存主要用于 NIO 缓存、字符串序列化(处理 content_html)及管理开销。
-
通用计算公式:
MemoryOverhead = max(384MB, executor-memory* 0.1) -
本项目实战测算:
由于治理对象包含 1600 万条大文本 HTML 源码,Kryo 序列化缓冲区压力巨大。默认的 10% 比例( 384MB)不足以支撑高频的序列化操作。
-
默认值:max(384M, 10% memory)。对于 默认的1G堆内,默认仅 384M。
-
推理:千万级 HTML 源码在网络传输缓冲区、Kryo 序列化缓存中占用极高。384MB 在大文本面前极易导致 Container 被 YARN 杀掉。
-
设定值:强行锁定 2GB (2048MB)。
(2) 堆内内存 (Executor-Memory) 测算
-
公式:
ExecutorMemory=ContainerSize−MemoryOverhead -
过程:
6GB−2GB=4GB -
决策:设定为 4GB,用于 Join 时的哈希表存储。
2.3 执行数量 (num-executors) 测算
(1) 资源总量配比
-
当前 YARN 限额:120 GB。(以方案A为例)
-
计算公式:
num−executors=TotalYarnMemory/单体大小(6GB) -
过程:
120/6=20个 -
决策:考虑到 Driver 占用及资源抖动,实操建议设定 18 - 20 个。
2.4 并发核数 (executor-cores) 测算
(1) 人均内存压测
保证单核拥有 2GB 稳健空间处理正则截取等复杂逻辑,若设为 4 核则人均仅 1GB,极易 OOM。
-
公式:
Cores=ExecutorMemory(堆内内存)/PerTaskMem(单个任务(Task)平均可占用的堆内内存空间) 4g/2=2核 -
推理:
- 若给 4 核:人均仅 1GB,处理千万级 SQL 极易 OOM。
- 若给 2 核:人均 2GB,能稳健处理 MD5、正则截取等计算。
-
决策:设定为 2。
2.5 Shuffle 并行度 (partitions) 测算
(1) 数据块大小匹配
需要计算三个表的Shuffle数据量大小
--info表
ANALYZE TABLE hive_dim_syx_reg_info4000w_hive_ods_info2000w_related5000w_content1600w.ods_q_db_df_bidding_t_bidding_info_2
COMPUTE STATISTICS FOR COLUMNS;
DESCRIBE FORMATTED hive_dim_syx_reg_info4000w_hive_ods_info2000w_related5000w_content1600w.ods_q_db_df_bidding_t_bidding_info_2;
--content表
ANALYZE TABLE  hive_dim_syx_reg_info4000w_hive_ods_info2000w_related5000w_content1600w.ods_q_db_df_bidding_t_bidding_info_2
COMPUTE STATISTICS FOR COLUMNS;
DESCRIBE FORMATTED hive_dim_syx_reg_info4000w_hive_ods_info2000w_related5000w_content1600w.ods_q_db_df_bidding_t_bidding_content_2_4_orc;
--relted表
ANALYZE TABLE hive_dim_syx_reg_info4000w_hive_ods_info2000w_related5000w_content1600w.ods_q_db_df_bidding_t_bidding_related_2_4
COMPUTE STATISTICS FOR COLUMNS;
DESCRIBE FORMATTED hive_dim_syx_reg_info4000w_hive_ods_info2000w_related5000w_content1600w.ods_q_db_df_bidding_t_bidding_related_2_4;
Spark 和 Hive 统计信息中的 rawDataSize (真实的数据大小,没有被压缩)是以 Byte(字节) 为单位的原始数值,而我们在调优文档中使用的 GiB 是基于 二进制(1024进制) 计算的。
info表:rawDataSize:44440317967 换算为GB/1024/1024/1024 = 41.39 GiB
relted表:rawDataSize:39,117,864,576换算为GB/1024/1024/1024 = 36.43 GiB
content表:rawDataSize:12,455,028,051换算为GB/1024/1024/1024 = 11.60 GiB
-
数据画像:数据 Shuffle 量预估 89.42 GiB。
-
目标:每个 Task 处理 128MB 数据。
-
公式:
partitions=TotalShuffleSize/128MB89.42*1024/128mb=715
-
决策:设定为 715。若存在极度数据倾斜,调大至 1000-2000 以细化分片。
2.6 Driver 内存 (driver-memory) 测算逻辑
Driver 进程负责解析 SQL、生成 DAG 图、管理数千个 Task 的状态以及存储广播变量,其内存需求由以下三部分组成:
(1) 计算公式
DriverMemory = BaseInternalMemory + MetadataBuffer + (BroadcastTableSize * ExpansionFactor)
(2) 推导逻辑与测算过程
- 基础开销 (BaseInternalMemory): SparkContext 及 JVM 运行所需的保底内存,固定预留 1 GB。
- 任务元数据缓冲 (MetadataBuffer):
- 背景: 本项目
shuffle.partitions设定为 1000 - 2000,Driver 需维护数千个 Task 的运行信息。 - 复杂度: 窗口函数和多层嵌套 JOIN 的执行计划非常庞大。
- 测算: 为支撑高并发任务调度,预留 1 GB。
- 背景: 本项目
- 广播变量扩展 (Broadcast Expansion):
- 数据量:
autoBroadcastJoinThreshold调高至 100MB。 - 膨胀系数: 广播表在 Driver 端以 Java 对象形式存储,通常会有 2-3 倍的内存膨胀。
- 计算: 100MB 的3 倍 300MB。考虑到同时可能存在多个维表广播,预留 2 GB 以确保绝对安全。
- 数据量:
(3) 测算结论与建议
- 稳定跑方案 (方案 A): 1GB (基础) + 1GB (元数据) + 2GB (广播) = 4 GB。
- 决策建议: 设定为 4GB。这能确保在千万级数据治理场景下,Driver 不会因为管理开销或广播维表而发生 OOM 崩溃
三、 防倾斜与内存优化 (Stability)
3.1 数据倾斜治理 (Spark 2.4 手动挡)
Spark 2.4 缺乏 3.x 的自动拆分倾斜分区功能,必须手动干预:
- 策略 A:利用广播解决 (Map-side Join)
- 参数:
spark.sql.autoBroadcastJoinThreshold - 优化:默认 10MB,建议调大至 50MB - 100MB。
- 作用:强制维度表走广播,彻底规避 Shuffle,从根源消除倾斜。
- 参数:
- 策略 B:增加并行度
- 优化:将
shuffle.partitions调大至 2000。 - 作用:更细的分片可分散倾斜 Key 的压力,即使单个 Task 耗时,也能降低 OOM 风险。
- 优化:将
3.2 内存与磁盘交互优化
- spark.memory.fraction (0.7): 提高执行内存占比,应对复杂的 JSON 和 HTML 解析逻辑。
- spark.memory.storageFraction (0.2): 调低存储占比。治理任务不涉及缓存 (
cache),应将内存全力供应给计算逻辑。
四、 业务场景推荐参数配置表
| 参数项 | 稳定跑 (生产常规) |
|---|---|
| 测算目标 | 不报错,速度均匀 |
| executor-memory | 4GB |
| executor-cores | 2 |
| memoryOverhead | 2GB |
| num-executors | 20 |
| shuffle.partitions | 1000 |
| driver-memory | 4GB |
 255


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


