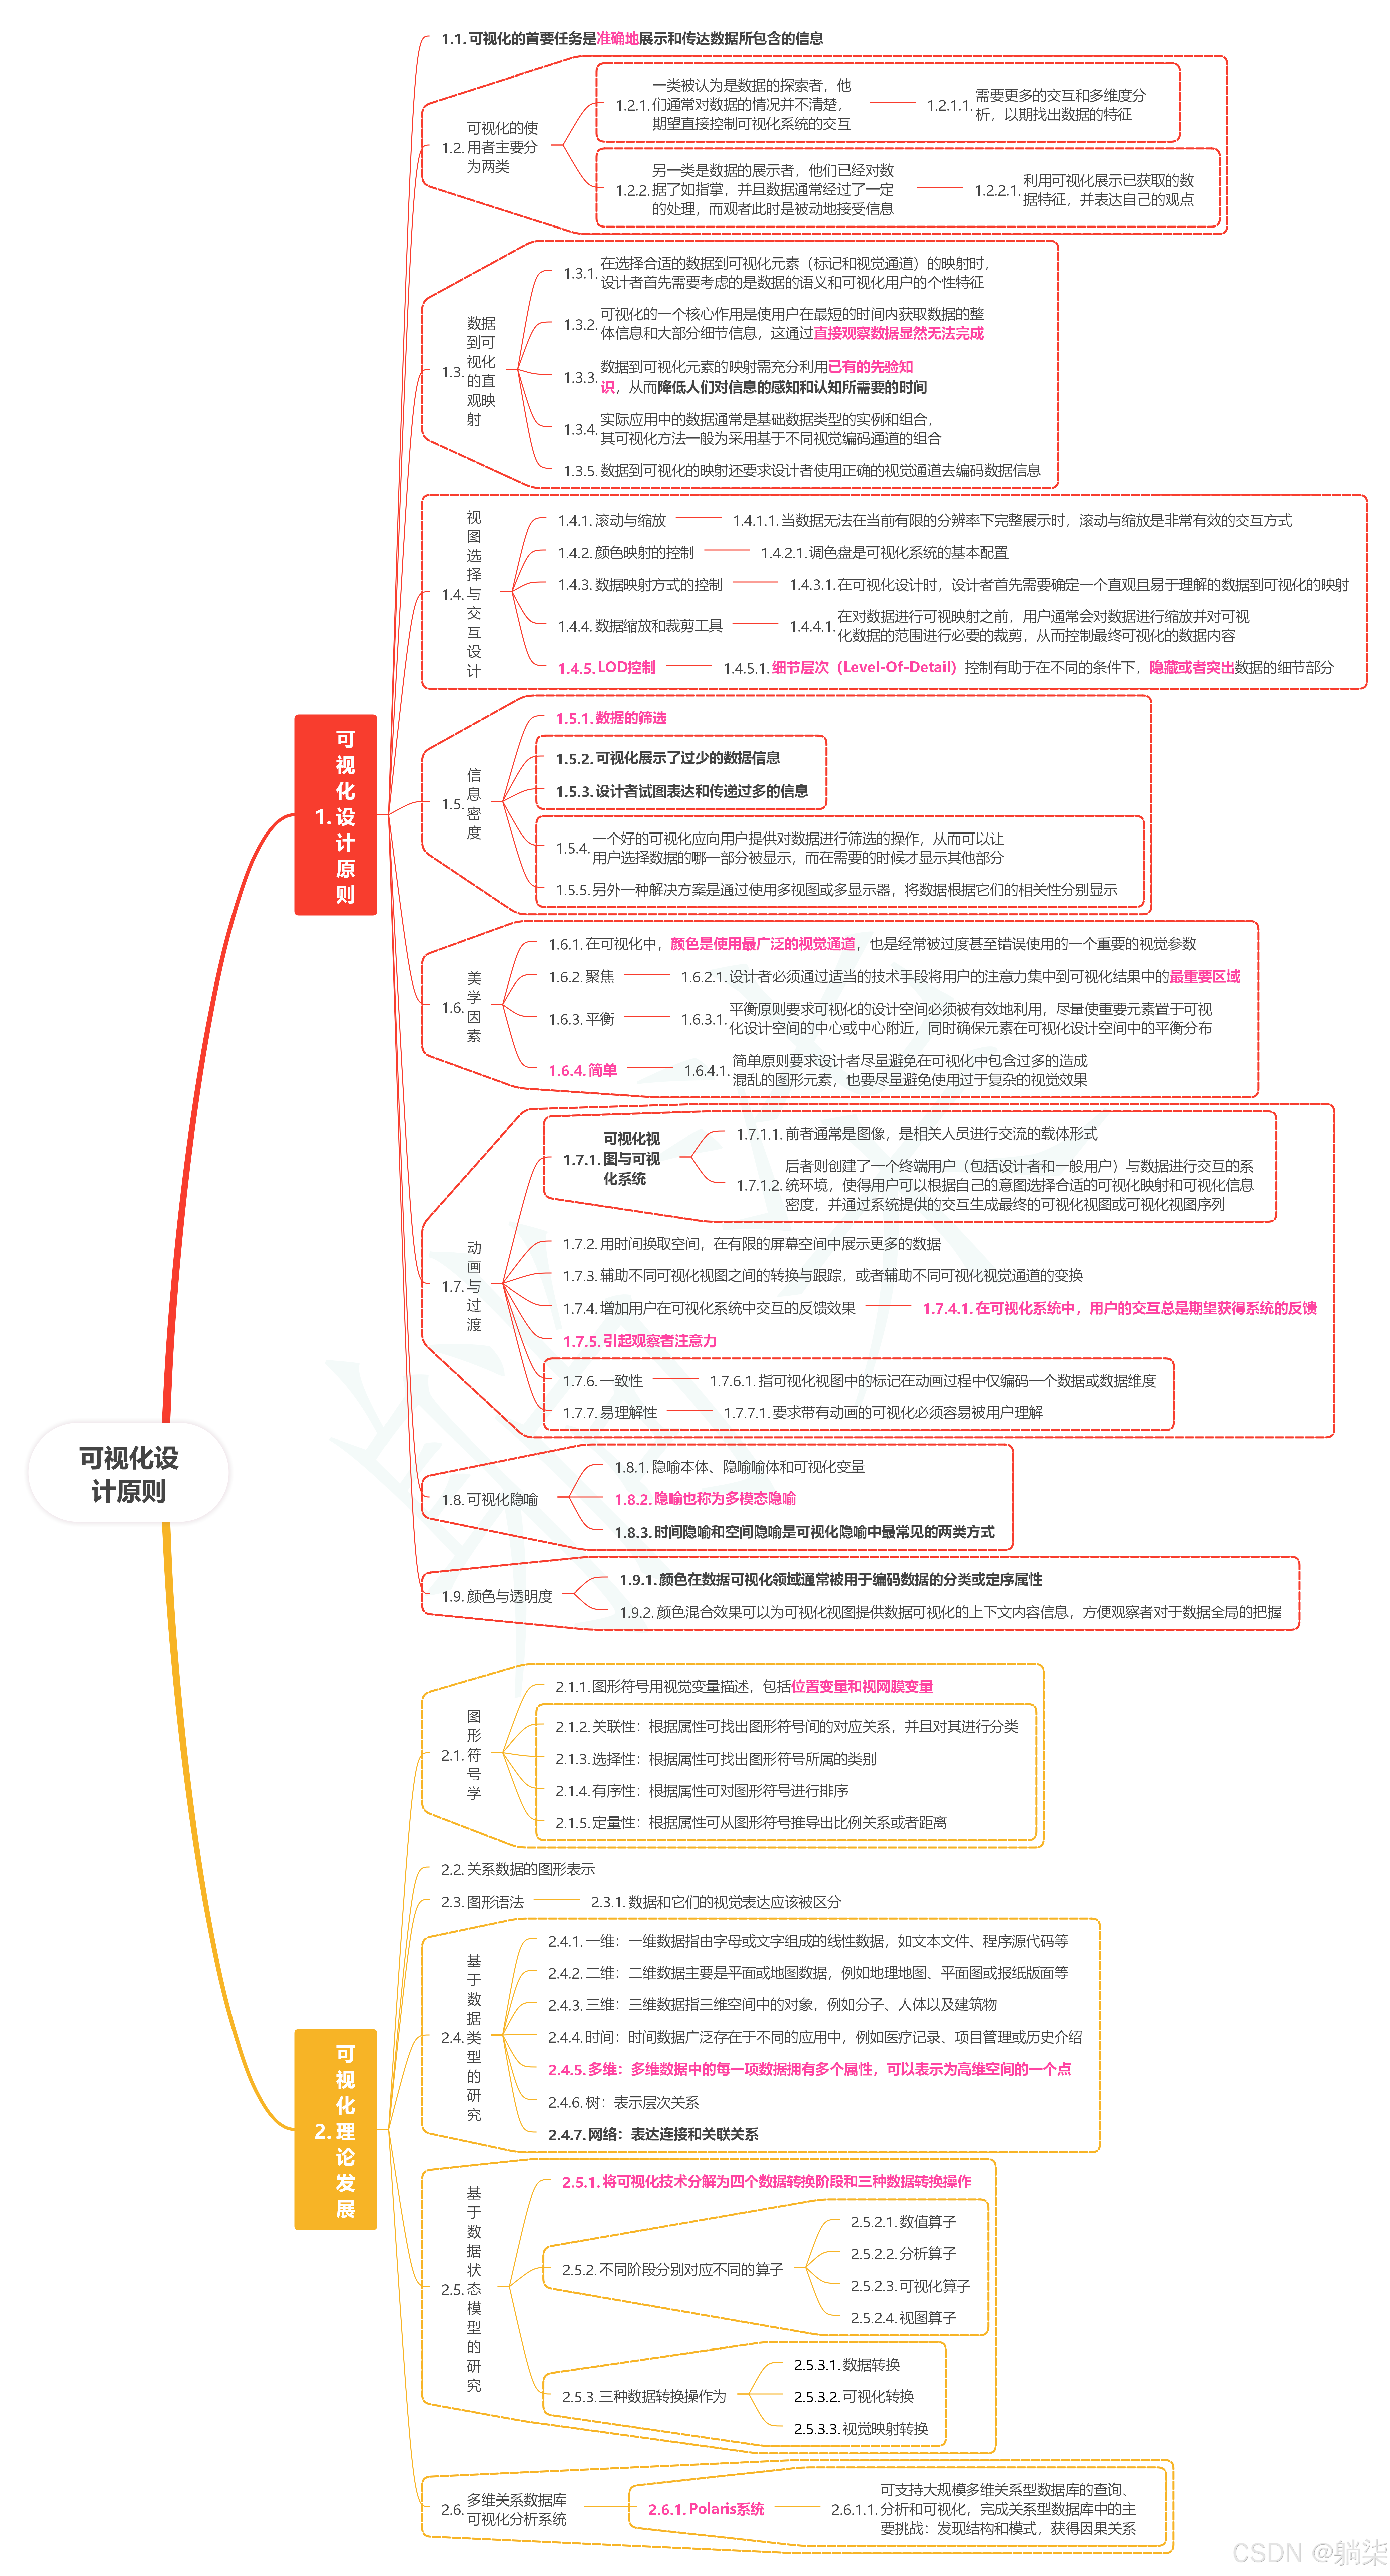
读数据可视化12可视化设计原则

CANoe环境中UDS 28服务仿真测试完整指南 深入讲解在CANoe环境中实现UDS 28服务的完整仿真与测试流程,涵盖配置步骤与典型应用场景,帮助开发者高效掌握uds 28服务的通信控制机制。 阅读详情

1. 可视化设计原则

1.1. 可视化的首要任务是准确地展示和传达数据所包含的信息

1.2. 可视化的使用者主要分为两类

  • 1.2.1. 一类被认为是数据的探索者,他们通常对数据的情况并不清楚,期望直接控制可视化系统的交互

    • 1.2.1.1. 需要更多的交互和多维度分析,以期找出数据的特征
  • 1.2.2. 另一类是数据的展示者,他们已经对数据了如指掌,并且数据通常经过了一定的处理,而观者此时是被动地接受信息

    • 1.2.2.1. 利用可视化展示已获取的数据特征,并表达自己的观点

1.3. 数据到可视化的直观映射

  • 1.3.1. 在选择合适的数据到可视化元素(标记和视觉通道)的映射时,设计者首先需要考虑的是数据的语义和可视化用户的个性特征

  • 1.3.2. 可视化的一个核心作用是使用户在最短的时间内获取数据的整体信息和大部分细节信息,这通过*直接观察数据显然无法完成

  • 1.3.3. 数据到可视化元素的映射需充分利用已有的先验知识,从而*降低人们对信息的感知和认知所需要的时间

  • 1.3.4. 实际应用中的数据通常是基础数据类型的实例和组合,其可视化方法一般为采用基于不同视觉编码通道的组合

  • 1.3.5. 数据到可视化的映射还要求设计者使用正确的视觉通道去编码数据信息

1.4. 视图选择与交互设计

  • 1.4.1. 滚动与缩放

    • 1.4.1.1. 当数据无法在当前有限的分辨率下完整展示时,滚动与缩放是非常有效的交互方式
  • 1.4.2. 颜色映射的控制

    • 1.4.2.1. 调色盘是可视化系统的基本配置
  • 1.4.3. 数据映射方式的控制

    • 1.4.3.1. 在可视化设计时,设计者首先需要确定一个直观且易于理解的数据到可视化的映射
  • 1.4.4. 数据缩放和裁剪工具

    • 1.4.4.1. 在对数据进行可视映射之前,用户通常会对数据进行缩放并对可视化数据的范围进行必要的裁剪,从而控制最终可视化的数据内容
  • 1.4.5. LOD控制

    • 1.4.5.1. 细节层次(Level-Of-Detail)*控制有助于在不同的条件下,隐藏或者突出数据的细节部分

1.5. 信息密度

  • 1.5.1. 数据的筛选

  • 1.5.2. 可视化展示了过少的数据信息

  • 1.5.3. 设计者试图表达和传递过多的信息

  • 1.5.4. 一个好的可视化应向用户提供对数据进行筛选的操作,从而可以让用户选择数据的哪一部分被显示,而在需要的时候才显示其他部分

  • 1.5.5. 另外一种解决方案是通过使用多视图或多显示器,将数据根据它们的相关性分别显示

1.6. 美学因素

  • 1.6.1. 在可视化中,颜色是使用最广泛的视觉通道,也是经常被过度甚至错误使用的一个重要的视觉参数

  • 1.6.2. 聚焦

    • 1.6.2.1. 设计者必须通过适当的技术手段将用户的注意力集中到可视化结果中的*最重要区域
  • 1.6.3. 平衡

    • 1.6.3.1. 平衡原则要求可视化的设计空间必须被有效地利用,尽量使重要元素置于可视化设计空间的中心或中心附近,同时确保元素在可视化设计空间中的平衡分布
  • 1.6.4. 简单

    • 1.6.4.1. 简单原则要求设计者尽量避免在可视化中包含过多的造成混乱的图形元素,也要尽量避免使用过于复杂的视觉效果

1.7. 动画与过渡

  • 1.7.1. 可视化视图与可视化系统

    • 1.7.1.1. 前者通常是图像,是相关人员进行交流的载体形式

    • 1.7.1.2. 后者则创建了一个终端用户(包括设计者和一般用户)与数据进行交互的系统环境,使得用户可以根据自己的意图选择合适的可视化映射和可视化信息密度,并通过系统提供的交互生成最终的可视化视图或可视化视图序列

  • 1.7.2. 用时间换取空间,在有限的屏幕空间中展示更多的数据

  • 1.7.3. 辅助不同可视化视图之间的转换与跟踪,或者辅助不同可视化视觉通道的变换

  • 1.7.4. 增加用户在可视化系统中交互的反馈效果

    • 1.7.4.1. 在可视化系统中,用户的交互总是期望获得系统的反馈
  • 1.7.5. 引起观察者注意力

  • 1.7.6. 一致性

    • 1.7.6.1. 指可视化视图中的标记在动画过程中仅编码一个数据或数据维度
  • 1.7.7. 易理解性

    • 1.7.7.1. 要求带有动画的可视化必须容易被用户理解

1.8. 可视化隐喻

  • 1.8.1. 隐喻本体、隐喻喻体和可视化变量

  • 1.8.2. 隐喻也称为多模态隐喻

  • 1.8.3. 时间隐喻和空间隐喻是可视化隐喻中最常见的两类方式

1.9. 颜色与透明度

  • 1.9.1. 颜色在数据可视化领域通常被用于编码数据的分类或定序属性

  • 1.9.2. 颜色混合效果可以为可视化视图提供数据可视化的上下文内容信息,方便观察者对于数据全局的把握

2. 可视化理论发展

2.1. 图形符号学

  • 2.1.1. 图形符号用视觉变量描述,包括*位置变量和视网膜变量

  • 2.1.2. 关联性:根据属性可找出图形符号间的对应关系,并且对其进行分类

  • 2.1.3. 选择性:根据属性可找出图形符号所属的类别

  • 2.1.4. 有序性:根据属性可对图形符号进行排序

  • 2.1.5. 定量性:根据属性可从图形符号推导出比例关系或者距离

2.2. 关系数据的图形表示

2.3. 图形语法

  • 2.3.1. 数据和它们的视觉表达应该被区分

2.4. 基于数据类型的研究

  • 2.4.1. 一维:一维数据指由字母或文字组成的线性数据,如文本文件、程序源代码等

  • 2.4.2. 二维:二维数据主要是平面或地图数据,例如地理地图、平面图或报纸版面等

  • 2.4.3. 三维:三维数据指三维空间中的对象,例如分子、人体以及建筑物

  • 2.4.4. 时间:时间数据广泛存在于不同的应用中,例如医疗记录、项目管理或历史介绍

  • 2.4.5. 多维:多维数据中的每一项数据拥有多个属性,可以表示为高维空间的一个点

  • 2.4.6. 树:表示层次关系

  • 2.4.7. 网络:表达连接和关联关系

2.5. 基于数据状态模型的研究

  • 2.5.1. 将可视化技术分解为四个数据转换阶段和三种数据转换操作

  • 2.5.2. 不同阶段分别对应不同的算子

    • 2.5.2.1. 数值算子

    • 2.5.2.2. 分析算子

    • 2.5.2.3. 可视化算子

    • 2.5.2.4. 视图算子

  • 2.5.3. 三种数据转换操作为

    • 2.5.3.1. 数据转换

    • 2.5.3.2. 可视化转换

    • 2.5.3.3. 视觉映射转换

2.6. 多维关系数据库可视化分析系统

  • 2.6.1. Polaris系统

    • 2.6.1.1. 可支持大规模多维关系型数据库的查询、分析和可视化,完成关系型数据库中的主要挑战:发现结构和模式,获得因果关系

ESP32物联网入门:从环境监测到自动浇灌的两个实战项目 物联网系统由感知、传输、处理、执行四层构成,传感器采集数据后需通过无线通信协议上送,再基于数据触发控制动作。理解这一闭环是入门关键。ESP32作为集成Wi-Fi与蓝牙的低成本主控,搭配BME280环境传感器和电容式土壤湿度传感器,可快速搭建环境监测站与植物自动浇灌系统。MQTT协议负责设备与服务器解耦,配合阈值控制、滞后区间与超时保护,保证系统稳定可靠。这类项目覆盖从数据采集到物理执行的完整链路,既能用于室内环境可视化,也能实现智能节水浇灌,是物联网工程实践的高价值起点。基于两个实战项目,可掌握传感选型、数 阅读详情

相关推荐

Unity延迟渲染深度解析:从原理到实战的性能优化指南

在实时计算机图形学中,渲染管线决定了场景如何从3D模型转换为最终屏幕像素。前向渲染作为传统方案,其光照计算复杂度会随场景几何体与光源数量呈指数级增长,成为性能瓶颈。延迟渲染通过架构革新解决了这一问题,它将渲染流程解耦为几何通道与光照通道,先将所有表面的材质属性(如法线、反照率)存储到G-Buffer中,再在屏幕空间统一计算光照,使得光照开销与场景复杂度脱钩。这项技术的核心价值在于能高效支持海量动态光源,为FPS、开放世界等需要复杂光照交互的应用场景提供了可行的解决方案。本文聚焦Unity引擎中的延迟渲染实践

weixin_34342905的博客 392

DeepSeek-R1-Distill-Qwen-1.5B实操手册:Prometheus指标暴露+Grafana监控看板

本文介绍了如何在星图GPU平台上自动化部署🐋 DeepSeek-R1-Distill-Qwen-1.5B 本地智能对话助手 (Streamlit 驱动) 镜像,快速构建可监控的轻量级AI对话服务。通过集成Prometheus与Grafana,实现对响应延迟、GPU显存占用及请求成功率的实时观测,适用于边缘设备上的稳定智能问答场景。

weixin_42591413的博客 363

R语言神经网络实战:可解释、可交付的企业级建模

神经网络本质上是一种强大的非线性建模工具,其核心价值在于捕捉复杂变量关系并支持业务决策。在实际工程中,模型的可解释性与可交付性往往比参数规模更重要——前者确保结果可信、可追溯,后者决定能否真正嵌入业务流程并被非程序员用户使用。R语言凭借公式语法简洁、生态稳定、Shiny无缝集成等优势,在中小规模预测任务中展现出独特竞争力,尤其适合需要快速验证、本地部署、结果可视化和临床/业务可解读的场景。本文聚焦R中neuralnet与Keras两大主流方案,详解从数据预处理、结构设计、训练调优到模型保存与解释的完整链路,

weixin_33736649的博客 239

从多路选择器到寄存器:用Logisim拆解MIPS数据通路设计原理

本文通过Logisim可视化工具,详细拆解了MIPS处理器数据通路的核心——寄存器文件的设计原理。文章从多路选择器和译码器的协同工作入手,逐步构建了一个支持并发读写的寄存器文件,并深入分析了其在MIPS指令执行与流水线中的关键角色,帮助读者从实践出发,深刻理解计算机组成原理。

weixin_29182481的博客 403

Claude Code科研AI助手:16大场景Skills配置与实战指南

在人工智能辅助编程领域,MCP(Model Context Protocol)协议通过标准化接口实现了AI模型与外部工具的深度集成,其核心价值在于将通用AI能力转化为特定领域的专业化解决方案。这一技术原理通过构建模块化的Skills体系,显著提升了科研工作流中代码生成、数据处理和文献分析等任务的效率与可靠性。对于科研工作者而言,这意味着能够将AI助手从通用编程伙伴转变为精通生物信息学、统计建模等交叉学科的专业协作工具。在实际应用场景中,通过配置如文献智能解析、学术图表生成等定制化Skills,研究人员可以快

weixin_30896511的博客 455

MATLAB命令历史与单元模式:从交互探索到可维护脚本的高效工作流

在数据分析与科学计算中,交互式探索是快速验证想法、调试代码的关键环节。其核心原理在于通过即时反馈循环,允许用户逐条执行命令并观察结果,从而理解数据行为与算法效果。这种工作方式的技术价值在于能极大提升探索效率,但常导致操作过程零散、难以复现。为解决此痛点,MATLAB提供了命令历史记录与单元模式两大功能。命令历史自动保存所有交互命令,形成一个带时间戳的原始代码库;而单元模式则允许将脚本划分为独立、可单独执行的代码块,实现模块化组织。结合这两项技术,工程师能将一次性的交互操作,系统性地转化为结构清晰、参数可调、

congdi7904的博客 464

DataEase 权限管理完全指南:从角色设计到行级数据控制

上周有两起几乎酿成事故的小事:一位销售打开共享仪表板,看到了隔壁区域的客户联系方式;一位新来的实习生"顺手清理",把一张生产仪表板点没了。两件事的根源相同——系统回答不了"谁,能拿哪些数据,能干什么"。 DataEase 权限管理就是为回答这个问题设计的:用户账号解决"你是谁",角色解决"权限怎么打包",资源-操作二维模型解决"具体能干什么"。这篇实战指南带你从模型设计、权限落地到一键部署,一天

gitblog_00638的博客 442

基于Python的电商用户行为分析与可视化系统实践

在电商业务中,用户行为日志是理解消费链路的核心数据资产,但原始日志往往规模庞大、字段杂乱。数据分析的首要任务是将这些非结构化的行为记录转化为可读、可用的结构化数据,这一过程涉及数据清洗、指标定义与口径统一。依托Python生态中的Pandas、NumPy等工具,可以高效完成数据预处理与聚合计算,而PyECharts配合Flask则能快速搭建交互式可视化大屏,让PV/UV、转化率、复购率等关键指标直观呈现。RFM用户分层模型在行为日志场景下的落地,进一步帮助运营识别高价值用户并制定精准策略。这类技术方案适用于

weixin_34392435的博客 454

AWS Step Functions 编排机器学习流水线实战指南

机器学习流水线编排是指对数据预处理、模型训练、评估、部署等多阶段任务进行协调调度的技术实践。其核心原理在于通过有状态的工作流引擎实现任务依赖管理、错误恢复与执行可观测性。相比脚本化或Airflow等通用调度器,专用编排服务在长周期、多分支、需强容错的ML场景中具备显著技术价值:支持等待、并行、条件判断与原生重试机制。典型应用场景包括金融风控模型日更、电商推荐AB测试、IoT设备预测等生产级AI系统。本文聚焦AWS Step Functions与SageMaker深度集成方案,详解如何构建可追溯、可回滚、事件

weixin_30231327的博客 258

从零搭建高效Matlab工具箱:AKtoolbox实战指南

在科研与工程实践中,重复性代码和零散脚本往往消耗大量时间,而合理的代码复用与模块化开发正是提升效率的关键。Matlab作为常用的数值计算平台,其内置函数虽强大,但面对非标需求时,自建工具箱成为更灵活的选择。通过封装高频操作、统一接口设计以及规范路径管理,开发者能将常用功能沉淀为可复用的函数库。例如,信号处理中的潮汐调和分析、图像处理中的亮度平衡以及文件批处理等场景,均可通过简洁的函数调用代替冗长脚本。同时,结合并行计算与可视化封装,可大幅减少重复劳动。本文以自研工具箱AKtoolbox为例,系统讲解从目录结

weixin_30225755的博客 266

基于YOLOv11的视频人脸检测工具:从原理到工程实践

目标检测是计算机视觉的核心任务之一,旨在识别图像或视频中的特定物体并定位其位置。其基本原理是通过深度学习模型学习图像特征,生成边界框和类别预测。这项技术具有极高的实用价值,是实现智能监控、内容审核、自动驾驶等应用的关键。在众多目标检测模型中,YOLO系列以其出色的速度与精度平衡著称,尤其适合实时视频流处理。本文聚焦于将最新的YOLOv11模型与视频处理流水线相结合,构建一个高效、易部署的实时人脸检测工具。该工具采用多线程架构,有效协调视频读取、模型推理和结果写入,解决了实时处理中的性能瓶颈问题。通过详细的代

weixin_30235225的博客 485

C++实现ROS IMU传感器数据采集与sensor_msgs/Imu消息发布指南

在机器人系统中,传感器数据采集与处理是感知层的基础。惯性测量单元(IMU)作为核心传感器,通过测量角速度和加速度来感知自身运动状态。其工作原理基于微机电系统(MEMS),将物理运动转换为电信号。在工程实践中,原始传感器数据需经过标准化处理才能被上层算法使用。ROS(Robot Operating System)作为机器人软件框架,通过标准化消息格式实现模块化通信,其中sensor_msgs/Imu是IMU数据的标准消息类型。将IMU原始数据封装成ROS话题发布,打通了从硬件驱动到算法应用的链路,这对于**四

weixin_30268071的博客 449

VSCode连接SAP ABAP开发环境

本文介绍了使用VSCode连接ABAP开发环境的详细步骤。首先通过SICF或SMICM事务码获取ABAP连接地址,然后安装ABAP remote filesystem插件。提供了两种创建连接的方法:通过命令面板逐步配置(输入服务器地址、账号、系统标识等)或直接编辑JSON配置文件。最后通过命令面板选择已创建的连接即可完成连接,连接成功后可在VSCode左侧工作区查看ABAP系统内容进行开发。JSON配置方式更为简便推荐。整个流程帮助开发者摆脱复杂的Eclipse配置,实现快速便捷的ABAP开发环境搭建。

weixin_45293769的博客 2217

AI智能体测试开发转行指南:从传统测试到质量评测全攻略

随着大模型技术从概念验证走向生产环境,AI智能体在企业业务流中的落地速度远超预期,其非确定性的概率输出特性,使得质量保障成为比功能开发更关键的环节。传统测试基于“输入-输出”的确定性断言,而AI智能体需要引入事实准确性、幻觉检测、指令遵循、稳定性等语义评测维度,将主观质量感受转化为可量化的工程指标。这一转变催生了“AI测试开发”这一新兴岗位,要求从业者具备Python脚本、RAG架构认知、测试数据集设计以及自动化评测能力。无论是知识库检索的召回率评估,还是多轮对话的状态一致性校验,都需要测试人员从端到端的视

weixin_34087307的博客 280

SVPWM原理与MCU/FPGA实现:从数学推导到工程实战

空间矢量调制(SVPWM)是实现高性能电机驱动控制的核心算法之一,其通过六个基本电压矢量与零矢量的伏秒平衡,在一个PWM周期内合成任意方向的旋转电压圆,相比传统SPWM可提升约15%的直流电压利用率。该技术不仅涉及扇区判断、作用时间计算、过调制限幅等数学原理,还在MCU与FPGA两种硬件平台上有不同的工程实现路径,包括中心对齐PWM配置、死区插入、定点数流水线设计等。在电动工具、无人机、机器人及车载执行器等电池供电场景中,SVPWM直接决定续航与扭矩表现。本文从数学原理出发,详细拆解MCU和FPGA实现细节

weixin_34265814的博客 301

postgresql 数据库 timescaledb 函数time_bucket_gapfill()报错解决及更换 license

最近在工作中使用postgresql 和 timescaledb 的time_bucket_gapfill()函数 报错,让更换license,在网上找了一大圈,没有找到,最后解决了这个问题,这篇文章记录我的解决办法查看timescaledb.license参数命令:show timescaledb.license;修改命令: 结果不行,报错如下:lter system set timescaledb.license=‘timescale’;那只能换包了如果出现上面那种情况,那我们只能先从官网上下载带 '

yang_z_1的博客 3250

redis基础篇

1.sql:关系型数据库,结构化的,所谓结构就是各种各样的约束,约束着数据(类型,索引,约束等),有事务满足ACID特性2.NoSql:非关系型数据库,没有结构约束,数据类型任意(value一般是json格式),数据间没有关联,想要有关联需要自己设计,且redis是一种键值型数据库key-value,即NoSql。

m0_74939967的博客 1011

一窥Memory测试算法及自我修复机制

摘要 为了满足新一代设备的需求,Memory的大小每三年就会增加4倍。深亚微米设备包含大量面积更小、访问速度更快的Memory。针对此类设计制定自动测试策略可以减少ATE(自动测试设备)的时间和成本。 内存故障的行为与经典的“Stuck-At”故障不同。因此,Memory的故障模型(由于其阵列结构)与标准逻辑的设计也是不同的。Memory测试除了进行故障检测和定位,还可以实现用冗余单元对...

路科验证 2万+

Python第五次作业:函数封装与文件读写实战指南

在编程学习过程中,函数与文件操作是绕不开的核心基础。函数通过封装逻辑实现代码复用,而文件读写则让程序能与外部数据交互。理解两者的原理,有助于初学者从“写代码”进阶到“设计程序”。掌握函数定义、参数传递与返回值,并配合列表、字典进行数据处理,是解决实际工程问题的关键。在自动化报表、日志分析、成绩统计等场景中,这些技术被广泛应用。本文以Python作业中常见的综合任务为例,梳理函数封装、文件读写、异常处理等知识要点,并给出完整实例与避坑指南,帮助学习者顺利完成从基础语法到工程实践的过渡。针对Python第五次作

weixin_34162228的博客 240

AlphaFold-multimer 复合物结构预测

是DeepMind开发的AlphaFold项目的一个扩展,旨在预测蛋白质多聚体的三维结构。蛋白质多聚体是由多个蛋白质亚单位相互组装而成的结构,如酶、膜蛋白复合物和病毒颗粒。理解多聚体的结构对于揭示蛋白质的功能和相互作用非常重要。

MurphyStar的博客 5650

信息抽取实战:三元组抽取(限定领域 vs 开放领域)(附代码)

信息抽取实战:三元组抽取 目录信息抽取实战:三元组抽取一、限定领域的三元组抽取比赛介绍数据分析序列标注模型关系分类模型三元组提取总结开放领域的三元组抽取标注平台文本分类新数据进行三元组抽取总结参考文献 一、限定领域的三元组抽取   本项目将会介绍在2019语言与智能技术竞赛的三元组抽取比赛方面的一次尝试。由于该比赛早已结束,当时也没有参加这个比赛,因此没有测评成绩,我们也只能拿到训练集和验证集。但是,这并不耽误我们在这方面做实验。 比赛介绍   该比赛的网址为:http://lic2019.ccf.org.

南有芙蕖 2万+

数据库——MySQL

MySQL数据库基础教程全面介绍了关系型数据库的核心概念和操作。

qq_46518480的博客 418

损失函数大汇总(六十一)(Signed Distance Map Loss附公式推导与代码)

摘要 本文介绍了Signed Distance Map (SDM) Loss,一种将形状先验直接融入分割任务的方法。SDM将每个像素表示为到目标边界的带符号距离(内部为负,外部为正),相比二值mask能更连续地表达形状几何信息。SDM Loss的核心思想是让网络学习这个隐式形状场,通过可微的Heaviside函数近似将SDM转换为分割结果。文中重点分析了一种product-based regression loss,它能同时关注距离数值和内外符号的正确性,对边界区域尤为敏感。SDM Loss通常与传统的分割

悦学共鸣,温柔以待,汇聚光芒,共同成长 189

软考高级-系统架构设计师 知识点整理【万字长文】

操作系统定义:能有效地组织和管理系统中的各种软/硬件资源,合理地组织计算机系统工作流程,控制程序的执行,并且向用户提供一个良好的工作环境和友好的接口。操作系统有三个重要的作用第一,管理计算机中运行的程序和分配各种软硬件资源;第二,为用户提供友善的人机界面。第三,为应用程序的开发和运行提供一个高效率的平台。操作系统的4个特征是并发性、共享性、虚拟性和不确定性。所谓信息摘要,就是一段数据的特征信息,当数据发生了改变,信息摘要也会发生改变。

qq8565408的博客 1921

RK3588 buildroot 双网口bonding调试

本文介绍了Rockchip Buildroot中配置网络冗余的方法,通过bonding技术将多个物理网口合并为逻辑接口。主要内容包括:1)7种常见bonding模式的特点及适用场景;2)RK3588的具体配置流程,包括内核配置(启用bonding驱动、修改dts)、添加ifenslave工具;3)系统编译和网络状态检查。

501846585_QQAndroid_java 460

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

2026年分布式系统设计趋势深度解析:从CAP到BASE,从一致性到可用性的平衡艺术

2026年分布式系统设计迎来范式重构,核心在于动态平衡一致性与可用性。基于CAP定理的“动态CAP”理念,结合边缘计算与AI驱动的共识优化,系统可实时切换CP/AP模式。BASE理论演进为事件驱动、CRDT与Saga三类最终一致实现路径。Raft算法在AI预测选举、流式日志复制中深化应用,而Serverless环境则通过事件溯源与CRDT重构状态管理。架构趋势指向“反CAP”的边缘自治、智能共识与无状态协同,标志着分布式系统从理论约束走向场景自适应的工程新纪元。

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 96

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

上一篇: 读数据可视化11数据可视化基础
下一篇: 读数据可视化13空间标量场(上)
躺柒
博客等级 码龄4年 7004粉丝 1322原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值