Spark中DataFrame与DataSet的使用

Spark-SQL中DataFrame与DataSet的互操作|DataFrame转为DataSet|Dataset转为DataFrame|RDD、DataFrame和DataSet之间的关系 DataFrame转为DataSet 使用as方法,转成Dataset,这在数据类型是DataFrame又需要针对各个字段处理时极为方便。在使用一些特殊的操作时,一定要加上 import spark.implicits._ 不然toDF、toDS无法使用。 val df = spark.read.json("/opt/module/spark-local/examples/src/main/r... 阅读详情

概述:本文主要介绍了DataFrame、DataSet常见API的使用

1、DataFrame的使用

object DataFrameApp {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder().master("local[2]").getOrCreate()
​
    //将json转为DataFrame
    val peopleDF = spark.read.format("json").load("file:///F:/people.json") 
   //hdfs://hadoop:8020/input/wc/people.json
    peopleDF.printSchema()
    //默认输出前20条记录
    peopleDF.show()
​
    //查询某列数据
    peopleDF.select("name", "age").show()
    //查询列数据并进行计算
    peopleDF.select(peopleDF.col("name"), (peopleDF.col("age") + 9).as("newAge"))
​
    //条件查询
    peopleDF.filter(peopleDF.col("age") > 19).show()
    peopleDF.where(peopleDF.col("age") > 19).show()
​
    //分组与聚合操作 select age,count(1) from table group by age
    peopleDF.groupBy("age").count().show()
    spark.stop()
  }
}

2、RDD与DataFrame的互操作

(1)反射方式

object DataFrameRDDApp {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder().appName("DataFrameRDDApp").master("local[2]").getOrCreate()
    //RDD转DataFrame
    val rdd = spark.sparkContext.textFile("file:///F:/people.txt")
    //toDF需要导入隐式转换
    import spark.implicits._
    val peopleDF = rdd.map(_.split(",")).map(line => people(line(0).toInt, line(1).toString, line(2).toInt)).toDF()
    peopleDF.printSchema()
    peopleDF.show()
    peopleDF.filter(peopleDF.col("age")<25).show()
    //创建临时视图 使用sql操作数据库
    peopleDF.createOrReplaceTempView("peopleTmpView")
    spark.sql("select p.id ID,p.name USERNAME,p.age AGE from  peopleTmpView p WHERE name LIKE '%an%'").show()
    spark.stop()
  }
  case class people(id: Int, name: String, age: Int)
}
​

(2)编程方式

使用情形:

  • When case classes cannot be defined ahead of time (for example, the structure of records is encoded in a string, or a text dataset will be parsed and fields will be projected differently for different users).

创建DataFrame步骤:

  • Create an RDD of Rows from the original RDD;
  • Create the schema represented by a StructType matching the structure of Rows in the RDD created in Step 1.
  • Apply the schema to the RDD of Rows via createDataFrame method provided by SparkSession.

代码:

object DataFrameRDDApp {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder().appName("DataFrameRDDApp").master("local[2]").getOrCreate()
    //RDD转DataFrame
    val rdd = spark.sparkContext.textFile("file:///F:/people.txt")
    val peopleRDD = rdd.map(_.split(",")).map(line => Row(line(0).toInt, line(1).toString, line(2).toInt))
    val structType = StructType(Array(StructField("id", IntegerType, true), StructField("name", StringType, true), StructField("age", IntegerType, true)))
    val peopleDF = spark.createDataFrame(peopleRDD, structType)
    peopleDF.printSchema()
    peopleDF.show()
    peopleDF.filter(peopleDF.col("age") < 25).show()
    //创建临时视图 使用sql操作数据库
    peopleDF.createOrReplaceTempView("peopleTmpView")
    spark.sql("select p.id ID,p.name username,p.age AGE from  peopleTmpView p WHERE name LIKE '%li%'").show()
    spark.stop()
  }
}

模糊查询结果:
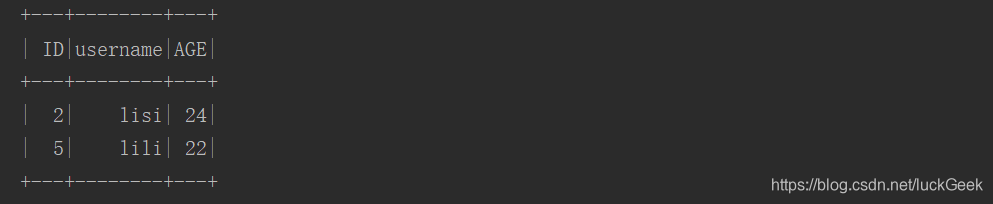
选型说明:如果字段名称、类型可知,优先选择反射方式

(3)DataFrame其他API

object DataFrameCase {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder().appName("DataFrameCase ").master("local[2]").getOrCreate()
    //RDD转DataFrame
    val rdd = spark.sparkContext.textFile("file:///F:/student.data")
    import spark.implicits._
    val studentDF = rdd.map(_.split("\\|")).map(line => student(line(0).toInt, line(1).toString, line(2).toString, line(3).toString)).toDF()
    studentDF.first()
    studentDF.printSchema()
    studentDF.show(30,false)
    studentDF.filter("name='' OR name='null'")
    //查找以M开头的学生
    studentDF.filter("SUBSTR(name,0,1)='E'").show()
    studentDF.sort(studentDF("name")).show()
    studentDF.sort("name","email").show()
    studentDF.sort(studentDF("name").desc).show()
    studentDF.select(studentDF("name").as("studentName")).show()
    //默认内连接 需要使用三个=
    val newStudentDF = rdd.map(_.split("\\|")).map(line => student(line(0).toInt, line(1).toString, line(2).toString, line(3).toString)).toDF()
    studentDF.join(newStudentDF,studentDF("id")=!=newStudentDF("id"),"right").show(500,false)
    studentDF.take(10).foreach(println)
    studentDF.first()
    studentDF.head(5)
    spark.stop()
  }
  case class student(id:Int,name:String,phone:String,email:String)
}

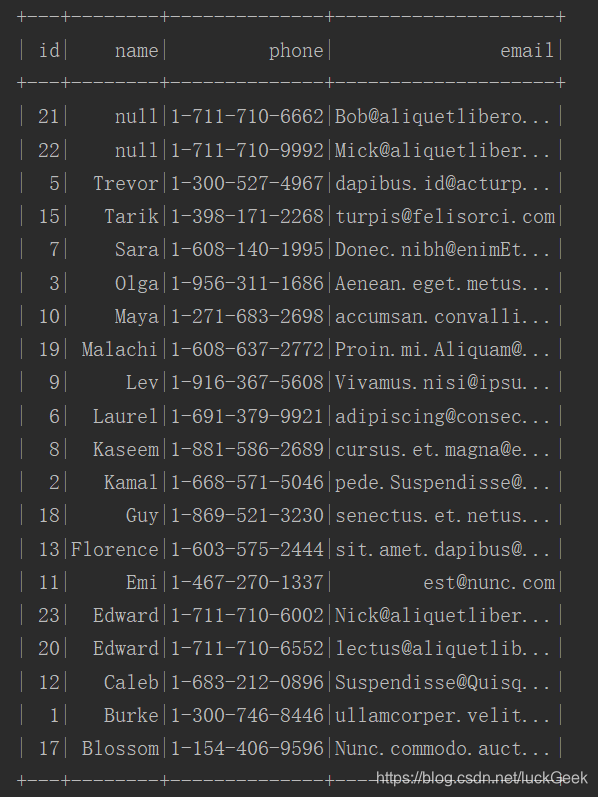
根据姓名排序结果:
3、DataSet的使用

(1)DataFrame转DataSet

object DataSetApp {
  def main(args: Array[String]): Unit = {
    val spark = SparkSession.builder().appName("DataSetApp").master("local[2]").getOrCreate()
    val path = "file:///F:/student.csv"
    //解析csv文件 外部数据源功能
    val df = spark.read.option("header", "true").option("inferSchema", true).csv(path)
    df.show()
    //隐式转换 df转ds
    import spark.implicits._
    val ds = df.as[student]
    ds.map(line=>line.email).show()
    spark.stop()
  }
  case class student(id: Int, studentName: String, phone: String, email: String)
}

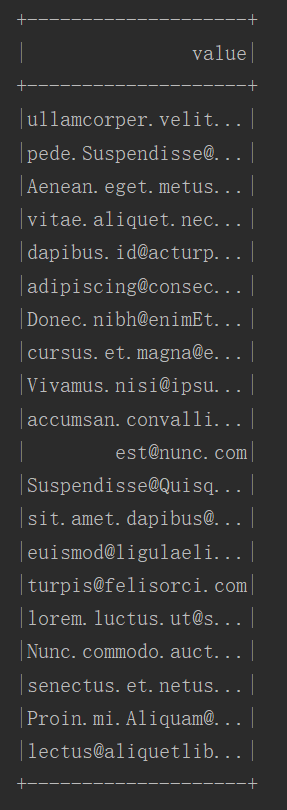
DataSet的查询邮箱结果:
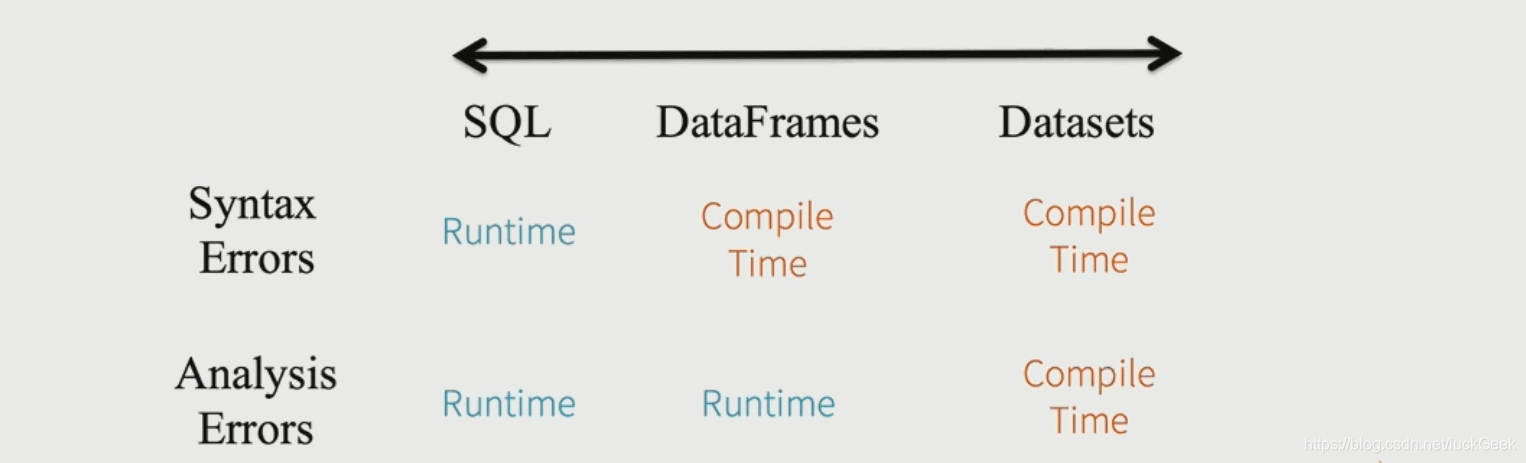
(2)DataSet静态类型(Static-typing)和运行时类型安全(runtime type-safety)
说明:

  • spark.sql("seletc * from emp e join dept d on e.deptno=d.deptno").show()编译可以通过,执行sql时报错
  • studentDF.seletc(studentDF("name").as("studentName")).show()中编译将不能通过
  • ds.map(line=>line.emails).show()中编译将不能通过,Dataset不管是哪种状态都是安全的,即静态类型和运行时类型安全,因为Dataset两种状态都能把错误抛出来。
Spark之Spark Session、Dataframe、Dataset Spark SQL简介 Spark SQL架构: Spark SQL是Spark的核心组件之一(2014.4 Spark1.0) 能够直接访问现存的Hive数据 提供JDBC/ODBC接口供第三方工具借助Spark进行数据处理 提供了更高层级的接口方便地处理数据 支持多种操作方式:SQL、API编程 支持多种外部数据源:Parquet、JSON、RDBMS等 Spark SQL是Spark的一个模块,主要用于处理结构化的数据。与基础的Spark RDD API不同的是,Spark SQL的接口会向提供 阅读详情

相关推荐

Spark DataFrame Dataset 的java使用入门

问题描述 环境介绍 依赖库: spark-core_2.11 version: ‘2.4.0’ hadoop-client version: ‘3.1.1’ spark-sql_2.11 version: ‘2.4.0’ jackson-module-scala_2.11 version: ‘2.8.8’ DataFrame 和 Dataset是 spark中的一种重要数据格式,它支持使用SQ...

踩坑小王子 1万+

Spark中的DataFrame和DataSet

在SparkSql中要求被操作的数据必须是结构化的,所以引入了俩种数据类型,DataFrame和DataSet。DataFrame是spark1.3之后引入的分布式集合,DataSet是spark1.6之后引入的分布式集合。在spark2.0之后,DataFrame和DataSet的API统一了,DataFrame是DataSet的子集,DataSet是DataFrame的扩展。 (type DataFrame = org.apache.spark.sql.Dataset[org.apache.spark

qq_42456324的博客 2559

Spark之RDD、DataSet、DataFrame转换

前面已经给大家说过RDD、DataSet、DataFrame三者之间的关系以及区别,各自都有各自的优劣。RDD、DataFrame、Dataset三者有许多共性,有各自适用的场景常常需要在三者之间转换。今天就给大家说说他们直接按的无缝转换。 DataFrame/Dataset转RDD 这个转换很简单,只需要在类型的后面.rdd就可以转换成RDD。 如何创建DataFrame/Dataset的方法在前面已经说过在这里就不多说了。 val createDS = spark.createDataset(1 to

zp17834994071的博客 1004

dataframe 如何选中某列的一行_Spark中的RDD、DataFrame和DataSet讲解

本文作为Spark SQL的第二篇文章,主要讲述一下RDD、DataFrame/DataSet之间的关系及相互转换。文章主要从以下几个方面进行阐述:1、Spark中的模块2、什么是DataFrame3、RDD和DataFrame的区别4、什么是DataSet5、RDD和Dataset的区别6、Dataset和DataFrame的区别与联系7、DataSet的创建8、RDD转DataFrame原因及...

weixin_39990029的博客 670

Spark SQL之RDD, DataFrame, DataSet详细使用

Spark SQL之RDD, DataFrame, DataSet详细使用

congge_study的博客 2万+

CPRI原理及应用--帧结构

对于CPRI 控制字,协议将1个超帧(256基本帧)的控制数据划分为一个“子通道”,将子通道内超帧内的控制字进行行列划分,分为4列X64行,每64个基本帧组成1列。如下图所示。每个Xs子通道内Ns的定义基本相同,在做控制字设计时,主要已Xs和Ns和X.Y.Z开展控制字映射。

u014035968的博客 2325

SparkSQL核心编程

目录基本介绍DataFrame创建 DataFrameDataSet创建 DataSetRDD 转换为 DataSetDataSet 转换为 RDDDataFrame 和 DataSet 转换RDD、DataFrame、DataSet 三者的关系三者的共性三者的区别三者的互相转换 基本介绍 DataFrame 和 DataSet 模型是Spark SQL 所提供的两个编程抽象,SparkSQL核心编程主要是关于使用DataFrame 和 DataSet 模型进行编程以及它们之间的关系和转换。 Spark C

一入大数据深似海?别怕!“数据极客圈”就是你的救生圈,走对圈子跟对人,趣析数据、畅聊趋势,快进圈子! 1083

AD20丝印层导入图片logo保姆级教程(附黑白预览避坑技巧)

本文提供了一份详尽的AD20丝印层导入图片Logo的实战指南。核心在于将图片预处理为高质量的单色BMP位图,并独家分享了利用Windows画图工具进行“黑白预览”的关键技巧,以提前规避转换失真。教程涵盖了从脚本获取、图片处理、参数设置到生产规范的完整流程,帮助硬件工程师高效、准确地在PCB的Top Overlay层添加个性化标识。

weixin_29194255的博客 386

RDD、DataFrame和DataSet的区别

参考文章:RDD、DataFrame和DataSet的区别 SparkSQL_Dataset和DataFrame简介 一、Spark SQL简介 Spark SQL 是 Spark 中的一个子模块,主要用于操作结构化数据。它具有以下特点: 能够将 SQL 查询与 Spark 程序无缝混合,允许您使用 SQL 或 DataFrame API 对结构化数据进行查询; 支持多种开发语言; 支持多达上百种的外部数据源,包括 Hive,Avro,Parquet,ORC,JSON 和 JDBC 等; 支持

justlpf的专栏 5673

AMBA VIP基础使用方式(AXI)

AXI环境配置 1)基础配置 作为master或者slave使用时,对应的is_active = 1 只作为i监测(monitor)使用时,对应slave_cfg的is_active = 0(对应端口连接也有所区别) class smu_axi_cfg extends svt_axi_system_configuration; `uvm_object_utils(smu_aix_cfg) function new(string name="smu_axi_cfg); super.new(n..

qq_37573794的博客 7984

MICROSAR OS:第一个task是如何执行起来的?

MICROSAR OS是Vector公司开发的符合AUTOSAR OS规范的实时操作系统。本文介绍MICROSAR

humu7733的博客 2570

jeethink-crm客户关系管理系统

jeethink-CRM是一款简单实用的客户关系管理系统(CRM),同时集成办公、财务、进销存等一体化解决方案,专为中小企业设计,以简单实用为主。 在设计上力求简单、实用,一看就能懂。使用吉想CRM,可以永久保存客户资料及相关信息不丢失,有效积累客户,防止撞客,提高销售业绩,防止因员工离职导致客户流失,并有效促进团队协作。 在线体验 项目地址(V1.0版本):http://www.jeethink.vip/crm 项目地址(最新版):http://www.jeethink.vip/crm2 账号密码

xingyuan2010000的专栏 3262

语言模型推理能力与计算表达力深度解析

语言模型的推理能力本质上是一种知识迁移与泛化应用的过程,其核心在于Transformer架构中的自注意力机制和前馈网络的协同作用。计算表达力作为衡量模型能力的关键指标,涉及函数逼近、组合泛化和上下文理解等多个维度。随着模型规模的扩大,涌现能力现象揭示了参数规模与推理能力之间的非线性关系。在实际应用中,通过提示工程和微调策略可以有效激活和优化模型的推理表现。当前研究正探索模块化架构和世界模型整合等方向,以突破长程推理和因果关系建模等前沿挑战。本文深入探讨了语言模型推理泛化的技术原理与实践方法,为理解计算表达力

weixin_42521032的博客 343

Spark中RDD、DataFrame和DataSet的区别与联系

RDD代表弹性分布式数据集。它是记录的只读分区集合。RDD是Spark的基本数据结构。它允许程序员以容错方式在大型集群上执行内存计算。与RDD不同,数据以列的形式组织起来,类似于关系数据库中的表。它是一个不可变的分布式数据集合。Spark中的DataFrame允许开发人员将数据结构(类型)加到分布式数据集合上,从而实现更高级别的抽象。ApacheSpark中的Dataset是DataFrameAPI的扩展,它提供了类型安全(type-safe),面向对象(object-oriented)的编程接口。...

大数据 7893

FPGA实现串口升级及MultiBoot(十)串口升级SPI FLASH实现

采用软核进行串口升级的原因主要有以下几点:1、官方推荐:官方以前也推出了针对逻辑进行升级的程序《XAPP1081_QuickBoot》,但是从今年起(2024年)官方就停止更新相关例程了(详见下面截图),所以采用官方推荐的软核更新;2、简单并具有通用性:针对SPI或者BPI官方都有相关的IP,可应对市场上80%以上的FLASH,并且官方IP通用性极强,只需要修改几个参数就可以对不同厂家的芯片进行升级操作;

OpenFPGA的博客 1998

9.9华为OD机试真题 新系统 - 受限任务分配 (Java/Py/C/C++/Js/Go)

华为OD机试真题 新系统【受限任务分配】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【受限任务分配】多语言题解。

qq_45776114的博客 731

Spark中DataFrame与DataSet区别详解

可以把它们看作是 Spark 中处理结构化数据的两个紧密相关的 API,DataSet 是 DataFrame 的类型安全超集。DataFrame:本质上是。它是一个分布式的行对象(Row)集合。Row 是泛化的、无类型的 JVM 对象,意味着编译器无法检查其字段的数据类型,类型检查在运行时进行。DataSet:从 Spark 1.6 开始引入。它是DataSet[T],其中T是一个强类型的 JVM 类(例如,在 Scala 中是 case class,在 Java 中是 POJO)。编译器在编译时。

ITHomeZSL的博客 773

<PLC><汇川>汇川PLC基于EtherCat协议使用转矩模式控制SV630N伺服驱动电机

本系列是关于PLC相关的博文,包括PLC编程、PLC与上位机通讯、PLC与下位驱动、仪器仪表等通讯、PLC指令解析等相关内容。PLC品牌包括但不限于西门子、三菱等国外品牌,汇川、信捷等国内品牌。除了PLC为主要内容外,PLC相关元器件如触摸屏(HMI)、交换机等工控产品,如果有值得记录的内容,也会添加进来。

用沸腾的热血,支付我们的人生吧! 4159

Spark RDD、DataFrame、Dataset相互转换

目录 1. RDD转DataFrame 2. RDD转DataSet 3. DataFrame/Dataset 转RDD 4. DataFrame转Dataset 5.Dataset转DataFrame 1. RDD转DataFrame 1. 构建schema 主要有三步: 构建RDD[Row] 构建schema 调用createDataFrame方法 object...

L, there! 8214

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Spark中Dataset和DataFrame的区别

ds.filter(_.age > 30).select(_.name) // 类型信息辅助物理优化。ds.map(_.age * 2) // 比df.select($"age" * 2)更高效。df.filter("age > 30") // 字符串表达式,编译时不检查列是否存在。ds.filter(_.age > 30) // 编译时检查age字段是否存在。// Dataset创建(需定义case class)// DataFrame转Dataset。// Dataset转DataFrame。

m0_73889530的博客 1006

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Spark中RDD、DataFrame和DataSet三者的区别

Spark中RDD、DataFrame和DataSet三者的关系1.共性:2.区别:1.RDD2.DataFrame3.DataSet3.Spark millb简介:1. Spark包含一个提供常见的机器学习(ML)功能的程序库,叫做MLlib。2.MLlib的设计理念:把数据以RDD的形式表示,然后在分布式数据集上调用各种算法。 1.共性: 1.RDD、 DataFrame、DataSet都是spark平台下的分布式数据集,为处理超大型数据提供便利; 2.三者都有惰性机制,在进行创建、转换时,不会立即执行

不会打球的摄影师不是好程序员 2401

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Spark——Spark RDD、Dataset、DataFrame及区别

文章目录RDD1. 不可变性2. 分区性3. 并行操作4. RDD内部结构5. RDD宽依赖、窄依赖1. 窄依赖2. 宽依赖6. RDD的重用DatasetDataFrame参考 RDD RDD(Resilient Distributed Dataset,弹性分布式数据集)是Spark中的基本抽象。RDD代表一种可并行操作的不可变的分区元素集合,它有3个特性: RDD是不可变的 RDD是分区的 RDD是可以并行操作的 1. 不可变性 RDD是不可变的,只能在其他的RDD上通过Transformation

aof 826

spark scala dataset、dataframe、RDD 、SQL使用

Dataset[String] to Data[case class] dataset[String] to Dataset[ThrDynamicRowV001] `val ds: Dataset[ThrDynamicRowV001] = spark.read.textFile(inputThrFile).map(row => { val split_str = row.split(",") for (i <- 0 to 13) { if (split_str(i).isEmpt

qq_18617299的博客 759

Spark SQL-DataFrame,DataSet与RDD

Spark SQL 目录 DataFrame DataSet RDD DataFrame,DataSet与RDD之间转换 DataFrame,DataSet与RDD之间的关系 DataFrame,DataSet与RDD之间共性与区别 1.Spark SQL Spark SQL是Spark用来处理结构化数据的一个模块,它提供了2个编程抽象:DataFrame和DataSet,并且作为分布式...

夜歌的博客 433

Spark中的RDD、DataFrame、DataSet简单总结

三者概念 RDD(Resilient Distributed DataSet) 弹性分布式数据集,是Spark中最基本的数据处理模型。在代码中是抽象类,代表一个弹性的、不可变、可分区、里面的元素可并行计算的集合。 弹性 存储的弹性:内存与磁盘的自动切换; 容错的弹性:数据丢失可以自动恢复; 计算的弹性:计算出错重试机制; 分片的弹性:可按需重新分片 不可变 RDD封装了计算逻辑不可改变,只能通过产生新的RDD并在新的RDD里面封装计算逻辑以此来改变 数据抽象 是一个抽象类,需要子类具体

Airy的博客 2745

spark rdd dataframe dataset

RDD RDD(Resilient Distribute Datasets)弹性分布式数据集,是spark的核心概念,表示分布式存储的只读集合,可以基于RDD进行数据的转换操作(map,filter等) Spark通过RDD的抽象概念,实现了分区计算存储、DAG、依赖等编程接口 rdd介绍:https://www.infoq.cn/article/spark-core-rdd RDD vs Dat...

upupfeng的博客 317
上一篇: Hive环境搭建与测试
下一篇: Spark SQL的简单使用
JeeThink
博客等级 码龄8年 12粉丝 23原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值