


文章目录
承接上一篇:戏有了,情绪还是假
Part 8 处理了追问轮数的问题:剧情蓝图生成后,让 AI 追问优化 1 轮就够。但稿子读起来仍然差一口气——故事该有的都有了(反派在攻心、主角在反击、反转也有),就是没有真人作者那种"跟着心跳"的感觉。问题出在情绪。
网上的去 AI 味教程普遍说"情绪词堆太多,要 show don’t tell,用动作表现"。我们照做之后发现无效。本文就是回答"为什么无效、问题到底在哪"的。
写给谁: 用 AI 写完后觉得"故事对但没感情"、被去 AI 味教程反复折腾、想搞清楚问题在哪的作者。
本篇的实验目的(两个实验,各回答一个问题)
实验一(测量+找差异): 先立一套能区分"真情绪"和"堆情绪词"的测量方法。为什么不能直接数情绪词?因为 AI 稿情绪词最多、读起来却最假。再用这套方法测出 AI 稿和真人原文到底差在哪。
实验二(解法验证): 网上常见的去 AI 味手段(情绪词黑名单 + 行为映射表 + 弧线指令)能不能让 AI 的情绪表达向真人靠拢?——验证一个具体假设:词表层面的约束能否解决情绪假的问题。
最终结论: AI 稿和真人原文的差距,主要在于"情绪载体单一化"——AI 把所有情绪塞进同一种表达方式。而网上流行的词表约束(黑名单、映射表、弧线指令)对这种差距没有作用。下一步,得换一种思路:不在写的时候管它用什么词,而是先在结构上规定好情绪怎么铺。
一、 先解决"怎么测情绪"
1.1 数情绪词为什么不行
最朴素的测量是统计情绪词密度(紧张/愤怒/悲伤这类词的出现频率)。拿一批真人原文和 AI 稿对比,结果是:AI 稿情绪词密度高达 104/千字,真人原文仅为 9.2/千字,约 11 倍。
但真正的问题在于:真人网文——以男频垃圾话风格为例——表达情绪靠嘴炮、动作、表情符号,几乎不用"他感到紧张"这类词;而 AI 稿恰恰相反,标准情绪词堆得越多,读起来反而越假。情绪词密度测的不是"情绪好不好",是"用了多少标准情绪词"。拿它当"情绪好不好"的尺子,AI 词多反而得分更高——可 AI 写得最假。方向是反的。
这里要补充一点:这批 AI 稿是攻心对峙戏、真人原文是男频垃圾话风格。"垃圾话"指角色靠嘴炮、互怼、粗口或表情符号表达情绪,而非书面化的心理描写。两者题材和对话密度本就不同,所以 11 倍里含一部分题材偏差——方向相反是确定的,倍数只能当量级参考。
1.2 LLM 语义标注:把"情绪靠什么撑"显形
既然数词不准,就不数词了。改让大模型逐段阅读,每段标三个字段:
| 字段 | 含义 | 取值 |
|---|---|---|
emotion_intensity | 情绪强度 | 0-10 |
emotion_type | 情绪类型 | 紧张/悲壮/震惊/幽默… |
carrier | 情绪载体 | 四选一,见下 |
情绪载体(本文的核心概念)——这段情绪主要靠什么撑起来的:
直述情绪词:“他感到愤怒”“心情复杂”动作-微表情:“指节发白”“攥紧纸杯”“碾碎碎石”对话-台词:嘴炮、垃圾话、表情符号节奏-结构:短句骤停、留白、句长变化
需要说明:这个四分类是本文提出的工作分类,参考了 show-don’t-tell 的写作常识——情绪用行为而非直述承载。但它没有引用成熟的叙事学或心理学框架,是否完备(比如内心独白、环境烘托算哪类)、四类是否正交,都没有验证,属于"先够用、后补验"的工作定义,下文结论受此限定。
本文的核心假设(先抛出来,第二节用数据验证):
AI 与真人原文的情绪差异,不在"有没有情绪词",而在情绪载体是否单一化——真人原文分散使用多种载体,AI 倾向于把所有情绪堆到同一种载体上(初稿靠对话、校准后靠动作-微表情)。
1.3 测量流程与可复现方法
原始文本
  → 清洗(去 Markdown 标记/空白)
  → 切窗(每 500 字一刀,位置归一化 0-100%)
  → 逐窗喂 LLM(temperature=0,固定 prompt)
  → 每窗输出 {intensity, type, carrier}
  → 汇总:各 carrier 占比(这篇的"载体指纹")
  → 多篇/多组做统计检验,看差异是否显著
量级参考:2000 字约 4 窗,7000 字约 14 窗。每窗一次 LLM 调用,60 篇约 100+ 次调用,deepseek 花费几块钱以内。完整的切分代码和标注 prompt 在文末附录,想复现照着做就行。
测量方法的两个已知局限(先交代,免得误导):
- 单模型单次标注,未做信度检验。 所有窗口都是 deepseek 标一次。严谨做法应抽 10% 窗口用第二个模型或人工重标、算 Cohen’s kappa(标注者间一致性指标,越高说明标得越一致);没做这一步之前,“测量可行"的说法需要打个折扣——准确地说,应该是"该测量在单模型标注下能区分三档样本,但标注信度与分类效度尚未验证”。temperature=0 降低随机性,但不能保证完全可复现。
- 强制单选载体。 prompt 要求"只能选一类,若混合取主导"。真人原文的情绪往往是"台词+动作+节奏"混合承载,强制取主导可能低估其混合度,甚至**“载体单一化"这个发现里,有一部分是标注规则逼出来的**——标注器被迫在每个窗口只能挑一个主导载体,自然显得"集中”。验证方法:改用"主载体+辅载体"双字段或打权重,看分布是否还高度集中。
二、 测量结果:三档样本,载体分布差异显著
实验一要回答的: 这套 LLM 语义标注方法能不能把真人原文和 AI 稿区分开?以及测出的差异是什么——即 1.2 的核心假设是否成立。
样本设计: 真人原文 5 章(男频垃圾话风格)为基准;AI 校准正稿 3 章(经过文风校准,出自正稿流程);AI 未校准初稿 15 篇(生成初稿)。三档窗口数 17-30 不等。
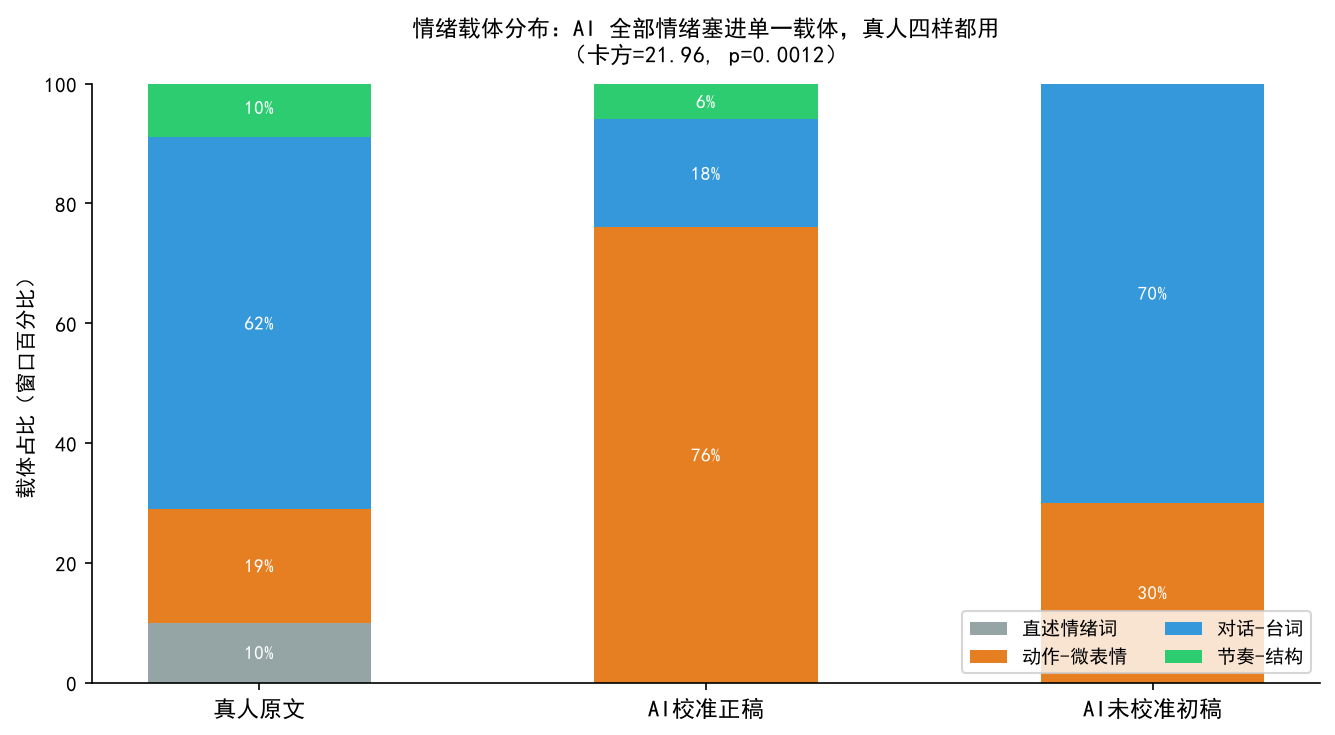
载体分布(窗口占比):
| 样本 | 窗数 | 直述情绪词 | 动作-微表情 | 对话-台词 | 节奏-结构 | 强度均值 |
|---|---|---|---|---|---|---|
| 真人原文 | 21 | 10% | 19% | 62% | 9% | 5.19 |
| AI 校准正稿 | 17 | 0% | 76% | 18% | 6% | 5.94 |
| AI 未校准初稿 | 30 | 0% | 30% | 70% | 0% | 7.67 |
统计检验: 卡方=21.96,p=0.0012。(表中各行为四舍五入后的百分比,合计约 100%。统计保留见 4.2。)
三个可观察到的现象:
1. 初稿的情绪类型高度单一。 未校准初稿 30 个窗口里,"紧张对峙/紧张"出现 15 次,几乎只有这一种情绪。强度虚高到 7.67,因为它靠对话反复表达同一种紧张。
2. 校准后载体转移到动作-微表情。 校准正稿的直述情绪词确实清零了(校准有效),但动作-微表情升到 76%。"指节发白/攥紧/瞳孔颤动"成了新的高频写法。强度从初稿的 7.67 拉回到 5.94,但仍高于原文的 5.19——校准压低了虚高,但没有完全回到真人的水位。
3. 真人原文四种载体都占,没有哪一种被堆满。 对话 62% 为主,但动作 19%、情绪词 10%、节奏 9% 都有。情绪类型多样,强度适中 5.19。
用一段具体文本感受"载体单一化":基于对 60 篇生成稿的通读观察,AI 稿的典型写法是连续堆砌动作描写;真人原文的典型写法是对话与动作交替。下面用示意文本各演示一段(两段均为人工构造,不来自任何真实作品,仅用于直观展示概念):
AI 稿(载体集中到动作-微表情): 陆清玄攥紧封魔印,指节压得发白。他瞳孔微缩,死死盯着鼎口,喉结上下滚动。玉衡真人猛地攥紧扶手,骨节发白,嘴唇颤抖了好一阵。
真人风稿(载体分散): "凭什么是我去?!"小师弟一拍桌案站起来,"就因为我入门最晚?"大师兄眼皮都没抬:"你少来这套,上次你也是这么说的。"小师弟愣了半秒,气得笑出来:"行,你厉害。"大师兄这才慢悠悠补一句:“我不厉害,我就是不想背这个黑锅。”
拆开看真人风稿的载体轮换:"拍桌站起来"是动作,"凭什么是我去"是对话,"眼皮都没抬"又是动作,"行,你厉害"是对话——载体在交替。而 AI 稿从头到尾都是"攥紧/发白/颤动"这类动作描写。这就是"载体单一化"的直观感受。
这里说明一下样本量:AI 校准正稿只有 3 章 17 窗,明显小于初稿的 30 窗,因为校准正稿生产成本高、需人工逐句审校。方向性结论可靠,具体比例待扩大样本验证。
回到核心假设:数据支持"载体单一化"。 AI 稿(无论校准与否)都把情绪集中到一种载体;真人原文四种载体分散使用。1.2 提出的核心假设成立。
三、 验证一个常见解法:词表约束有没有用
实验二要验证的假设: 既然差异是载体单一化,那网上主流去 AI 味教程给的三个药方——① 情绪词黑名单(别写"愤怒"“紧张”);② 行为-情绪映射表(把情绪转写成动作);③ 弧线/结构指令(先定情绪曲线再写)——能不能把载体分布扳向真人原文?
这组约束并非闭门造车,而是来自被广泛传播的"去 AI 味"教程。在实验二中,我们按阶梯叠加的方式控制变量验证:B 组只在 A 组基础上加一层约束,C 组再叠一层,这样能看出每一层各自起不起作用。
实验设计(三组阶梯,控制变量):
| 组 | 约束内容 |
|---|---|
| A 基线 | 反套路蓝图 prompt(与 Part 7/8 同素材) |
| B | A + 情绪词黑名单 + 行为-情绪映射表 + “同一写法至多 1 次” |
| C | B + 弧线定位 + 节奏指令 + 结尾纪律 |
- 场景:陆清玄×情魔 攻心戏(与 Part 7/8 同素材,可比)
- 模型:doubao,temperature=0.7,每组 20 篇,共 60 篇
- 测量:上文的方法(同窗口、同标注 prompt)
- 指标:黑名单遵守率(写后 lint)+ 载体分布 + 强度
C 组弧线指令的具体内容(避免"无效"被误读为"任何结构指令都无效"):C 组加的是主流教程推荐的结构级指令——先抑后扬的弧线定位、情绪最高点用短句骤停、氛围处用长句、结尾用动作或对话收束(禁止总结感悟)。它代表当前提示词工程在结构控制上的常见做法,不是随手写的。
但要提醒:这是"模糊的结构指令"——只规定了情绪出现的位置,没规定用什么载体实现。真正的结构级干预(强制载体轮换)不在本组测试范围,见 4.1。
先看约束被遵守了吗(写后 lint 扫描黑名单词命中):
| 组 | 黑名单词/千字 |
|---|---|
| A(基线) | 0.5 |
| B | 0.0 |
| C | 0.0 |
约束被遵守——B/C 组的黑名单词命中清零。
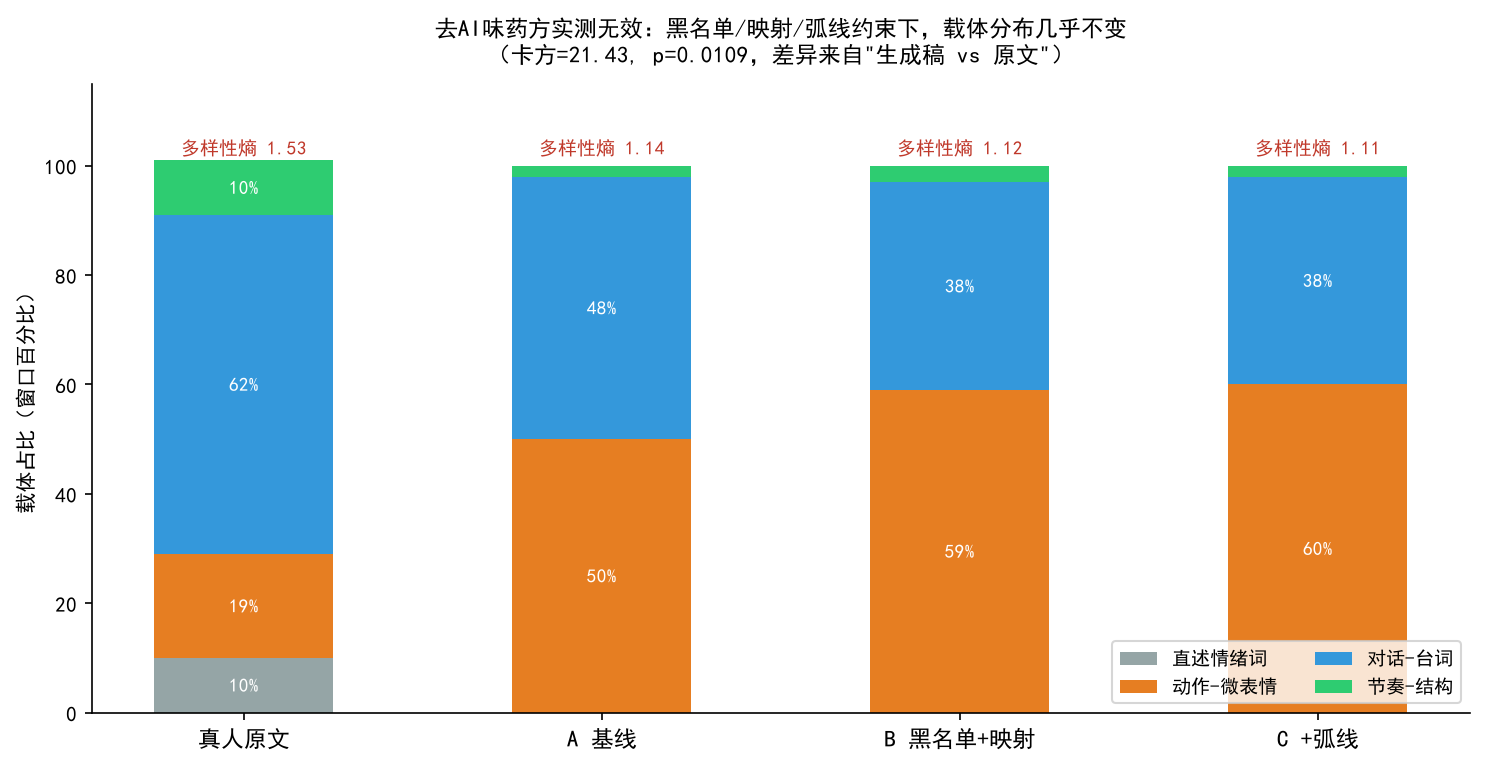
再看载体分布有没有变:(多样性熵:衡量载体分布均匀程度的指标,越高说明载体越分散,越低说明越集中、越单一。真人原文 1.53,生成稿约 1.1。)
| 组 | 多样性熵 | 直述情绪词 | 动作-微表情 | 对话-台词 | 节奏-结构 | 强度均值 |
|---|---|---|---|---|---|---|
| 真人原文 | 1.53 | 10% | 19% | 62% | 9% | 5.19 |
| A 基线 | 1.14 | 0% | 50% | 48% | 2% | 7.40 |
| B 黑名单+映射 | 1.12 | 0% | 59% | 38% | 3% | 7.03 |
| C +弧线 | 1.11 | 0% | 60% | 38% | 2% | 7.05 |
统计检验: 卡方=21.43,p=0.0109。(表中各行为四舍五入后的百分比,合计约 100%;统计保留见 4.2。)差异主要来自"生成稿 vs 原文"这一档:三组生成稿之间几乎没差别,但三组都明显偏离原文——载体分布、情绪类型(都高度集中成"紧张对峙/紧张")、强度(~7 vs 原文 5.19)彼此接近,都没有向原文靠拢。
(一个额外保留:熵的组间差异没做显著性检验,三组熵值 1.11-1.14 很接近,只能判断"组间差异不大",不能下更精确的结论。)
结论:约束在词面层被遵守,在结构层没有效果。 模型不再用"指节泛白"和"一丝",改用"指节压得发白"和"一点"——情绪还是用同一个载体、同一种强度、同一种类型表达。
一个帮助理解的比喻: 这像教一个只会用锤子的人干活。你告诉他"不许用铁锤"(黑名单),他会换成木锤或橡胶锤——换了词——但他解决问题的方式依然是"砸",也就是同一个载体。词表约束改变的是工具的表面,没有教他用螺丝刀、扳手等其他工具(多样载体)。
一个过程记录: 这套实验先跑了每组 2 篇试跑,当时 C 组多样性熵明显上升(1.14→1.36)、强度下降,看起来弧线指令有效。补满每组 20 篇后,C 组的优势消失(熵 1.11)。载体分布这类结构性指标,小样本波动大,下结论前需要把样本跑满。
四、 结论与边界
4.1 对应实验目的,逐个回答
实验一:测量方法能用吗?测出的差异是什么?
- 方法: 数情绪词不是有效指标(AI 词多反而更假,1.1 已详述)。改用 LLM 语义标注(每窗标强度 + 载体),在单模型标注下能把真人原文和 AI 稿分开(三档差异 p=0.0012,方向性参考)。测量方法初步可用,信度与效度待补检。
- 测出的差异——载体单一化: AI 倾向于把所有情绪集中到单一载体上(初稿靠对话、校准后靠动作-微表情),而真人原文则是四种载体分散使用。校准能清零直述情绪词,但载体转移到动作-微表情,单一化的结构没有变。
实验二:词表约束能解决载体单一化吗?
- 不能。 黑名单+映射表+弧线指令三组约束,载体分布、情绪类型、强度与无约束基线几乎相同。
- 约束在词面层被遵守(黑名单命中清零),在结构层没有效果:模型换一套词,表达方式不变。
- 注意区分: C 组测的是"模糊的结构指令"(只规定情绪位置、不规定载体),真正的结构级干预(强制载体轮换)尚未测试,区别见实验设计节 C 组的说明。
4.2 边界与局限
以下局限按严重程度排序:前两条(标注信度、强制单选)直接影响核心发现,务必先看;其余是常规边界,不影响"载体单一化"这个方向的成立。
以下是另外几条局限。标注信度、强制单选那两条已在 1.3 说过,这里不重复:
- 窗口非独立:卡方以窗口为单位,同章窗口自相关,有效样本量可能小于窗数,p 值可能被低估。正式结论应以"章/篇"为单位复检。
- 卡方前提:列联表有单元格期望频数 <5,严谨做法补 Fisher 精确检验,此处 p 值为方向性参考。
- 题材差异:情绪词密度约 11 倍对比中,AI 稿与真人原文题材不同,倍数含题材成分。
- 样本量有限:实验一每档 3-15 篇,实验二每组 20 篇。方向可靠,具体比例会有波动。
- 单一场景、单一模型:攻心对话戏 + doubao 生成/deepseek 标注。跨题材、跨模型未验证。
- 标注的循环性风险:我们让 LLM 来评判"情绪写得好不好",但问题恰恰是"LLM 写不好情绪"。如果评判的模型和写文的模型对"好情绪"有同样的偏见,那测出来的可能只是"两个模型口味一致",而不是"AI 和真人有差距"。本实验评判用 deepseek、写文用 doubao,两个模型不同,减小了这个风险,但没完全排除。
- "先规划情绪曲线再写正文"是推理方向,尚未做成完整实验验证。
五、 本期数据与样本
- 实验一(测量):23 篇样本(真人原文 5 章 + AI 校准 3 章 + AI 初稿 15 篇),68 个窗口的 LLM 标注原始数据
- 实验二(约束实验):60 篇生成稿(A/B/C 各 20 篇)+ 全部窗口标注 + 写后 lint 数据
- 标注 JSON、统计脚本、生成脚本——评论区或私信找作者要。
附录:完整可复现的测量代码与标注 prompt
切分和调用骨架(30 行):
import re, json

def load_text(path):
    t = open(path, encoding='utf-8').read()
    t = re.sub(r'^#.*$', '', t, flags=re.M)      # 去 Markdown 标题
    t = re.sub(r'\*\*|`', '', t)                  # 去加粗/代码标记
    return re.sub(r'\s+', '', t)                  # 去所有空白

def split_windows(text, size=500):
    return [text[i:i+size] for i in range(0, len(text), size)]

def annotate_window(llm_client, window, prompt):
    out = llm_client(prompt.format(text=window), temperature=0)
    out = re.sub(r'^```json\s*|\s*```$', '', out.strip())
    return json.loads(out)   # {"emotion_intensity":7, "emotion_type":"紧张", "carrier":"动作-微表情"}
标注 prompt(完整版,直接可复制):
你是网文情绪分析工具。下面是一段修仙网文的局部(约500字)。
请判断这段文字承载的主要情绪及其强度、以及情绪主要由什么载体承载。

【情绪载体定义】:
- 直述情绪词:直接写"他感到紧张/恐惧/愤怒""心情复杂""慌了神"
- 动作-微表情:通过动作/神态承载("指节绷得发白""攥紧纸杯")
- 对话-台词:通过对话/台词承载(嘴炮、垃圾话、表情符号)
- 节奏-结构:通过句子长短、段落节奏、留白(如短句连发)

【重要】:
情绪词的密集出现不等于情绪强度高。请基于整体叙事效果判断真实情绪强度,
并判断情绪主要靠哪种载体传递(只能选一类,若混合取主导)。

文本:
---
{text}
---

输出严格JSON(不要其他内容):
{"emotion_intensity": 0到10的整数, "emotion_type": "情绪类型", "carrier": "直述情绪词|动作-微表情|对话-台词|节奏-结构"}
复现时的两个注意点(代码层面,不在 prompt 里):
- 调用 LLM 时 temperature 设 0——保证同一段文本重测结果一致,实验可复现。
- 标注输出用固定模型(如 deepseek)——换模型可能改变标注口径,同批样本不要混用两个标注模型。
(prompt 里已经写死的"情绪词密集 ≠ 情绪强度高"是防 LLM 被情绪词密度带偏,属于 prompt 内容本身,不用额外改。)
本系列进度: Part 1(实验框架)→ Part 2(样本量)→ Part 3(约束数量)→ Part 4(规则形态)→ Part 5(文风标杆)→ Part 6(大纲端的剧情设计上限)→ Part 7(剧情蓝图)→ Part 8(追问优化)→ Part 9(情绪测量 + 载体单一化,本篇)
 320


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


