AI网文写作实验笔记(十一):AI 的情绪曲线,只能控制一半——压抑释放能控,峰值位置只有趋势

GPT重度用户32个月情绪曲线:从蜜月期到认知共生的技术演进 大语言模型(LLM)作为现代知识工作者的核心协作者,其实际应用体验远非‘好用’或‘不好用’所能概括。理解GPT类模型的本质——自回归概率采样器、无持久记忆、上下文即临时工作区——是管理人机协作预期的前提。当用户跨越新手阶段,真实挑战逐渐浮现:幻觉并非故障而是概率输出的必然表现,响应漂移源于动态温度调节,上下文坍塌暴露注意力机制局限。这些技术原理直接重塑用户的认知负荷、验证习惯与情绪节律。本文基于32个月、17类专业工作流的实证观察,揭示GPT从‘玩具’进化为‘认知外延’过程中,提示工程疲劳、工具链位移与人机 阅读详情

承接上一篇:载体能控了,曲线能不能控?

承接AI网文写作实验笔记(十):AI 写情绪只有对话拿得出手。

系列走到 Part 10,能控制的东西又多了一样:每段用什么载体承载情绪(载体蓝图,80% 遵守)。但"一段之内情绪怎么起伏"还是靠 AI 自由发挥——写之前我们只规定了"这段是对话、那段是动作",没说"情绪第几段最高、压抑多久才爆"。

这篇问的是下一个层次:情绪曲线的"形状",能不能按指令控制?

具体是两个结构参数:

  1. 峰值位置:情绪最高点能不能放到指定的位置(50%?70%?90%?)
  2. 压抑-释放:"压抑多久、释放多猛"能不能指定?

如果这两个能控,配合 Part 10 的载体蓝图,“情绪曲线"就能从"AI 随机发挥、看完再调"走向"人先指定,AI 照做”——这是从"写作"到"编程"的关键一步。

本篇实测下来:一强一弱——压抑-释放能控(统计显著),峰值位置只有趋势(统计不显著)。下面细说。

写给谁: 看完 Part 10、想知道"除了载体,情绪的高度和节奏能不能也控制"的作者。

本篇的实验目的(两个实验,各回答一个问题)

实验一(峰值位置): 让 AI 把情绪峰值放到 50% / 70% / 90%,它会不会照做?放得准不准?——第一节设计、第二节测量、第三节给结果。

实验二(压抑-释放): 让 AI"压抑得久一点、再爆",它会不会自动把释放推得更猛?——第一节设计、第二节测量、第四节给结果。

最终问题: 这两个参数能不能都进正稿流程(配合载体蓝图),把"情绪曲线"变成一个可以指定的环节?——第五节回答。


30秒极简版

两个结构参数实测,结果一强一弱:

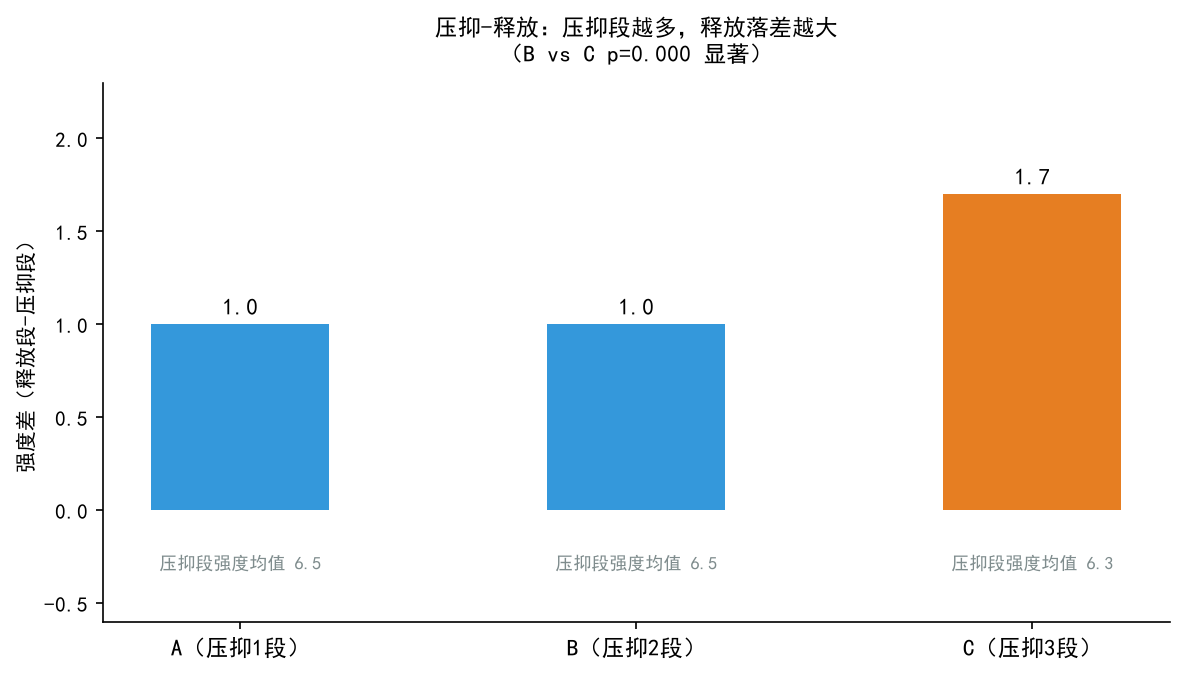
  1. 压抑-释放——可靠:压抑段越多,释放越猛(强度差从 1.0 升到 1.7),"先抑后扬"AI 会自动落实,统计显著(B vs C p=0.000)。
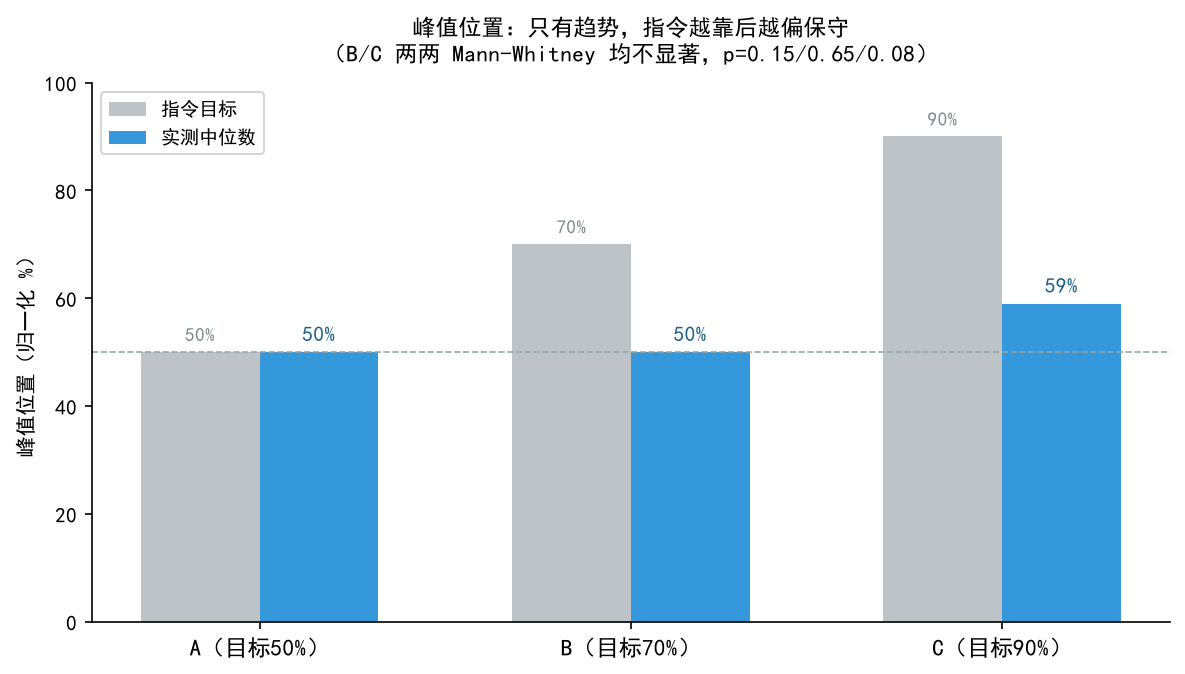
  2. 峰值位置——只有趋势:让 AI 放 50%/70%/90%,实测中位数 50%/50%/59%,有"越靠后越偏后"的方向,但三组差异统计不显著、测量本身有波动。

结论:压抑释放能控,峰值位置只能"试着指定",不能指望精确。


一、 实验设计:两个参数,各三组

沿用系列一贯的攻心戏场景(陆清玄×情魔)、doubao 模型、每组 20 篇。

为什么选这两个参数: 峰值位置和压抑-释放是"情绪曲线"最核心的两个形状参数——一个管"最高点放在哪",一个管"涨跌的节奏"。每组 3 个档位分别覆盖"中 / 偏后 / 末"和"短 / 中 / 长压抑",其余完全同素材、同 prompt,只改这一个变量,才能把差异归因到参数本身。

实验一:峰值位置

组指令含义
A峰值在 50% 位置情绪最高点在场景中间
B峰值在 70% 位置偏后段
C峰值在 90% 位置接近结尾

prompt 里用"段数"落地(不说百分比,直接说"峰值放第 3 段"):场景分 5 段,A 组峰值放第 3 段、B 组第 4 段、C 组第 5 段。峰值段统一用对话承载——固定载体,避免峰值落到 AI 弱项载体上写崩、干扰位置测量(Part 10 已证对话相对最不烂)。

实验二:压抑-释放比例

组指令含义
A前 1 段压抑 + 后 4 段释放压抑 20%,快速进入释放
B前 2 段压抑 + 后 3 段释放压抑 50%
C前 3 段压抑 + 后 2 段释放压抑 70%,压抑时间长

压抑段要求低强度(压制/铺垫),释放段要求高强度(爆发/绝杀)。


二、 测量方法:粒度必须匹配场景

这次的测量,先要过一个粒度关。 场景只有 5 段(每段一两百字),用 Part 9 那套 500 字窗口去切,一整篇也就剩下 1-2 个窗口。窗口一压,段与段之间的强度差异就被抹平了——峰值位置直接退化成"0% / 50% / 100%"几个死值,根本测不出 50/70/90 的区别。

实测确实撞墙了:初版用窗口测,标注输出全是 [7,0]、[7] 这种二值噪声(一两段里只挑出一个最高强度),峰值位置要么 0、要么 50、要么 100,完全不可用——A 组的窗口版数据现在还在库里,翻开就是一片死亡值。

改法:按段落标强度。 场景就 5 段,每段标一个 0-10 的强度值,峰值 = 强度最高段的位置,归一化到 0-100%。5 段分别对应 0 / 25 / 50 / 75 / 100 五档,比窗口版细多了,才看得出 50/70/90 的差别。

这印证了系列反复出现的一条铁律:测量粒度必须匹配内容粒度。 短场景按段测,长章节才用窗口(Part 9 测整章用窗口、Part 10 测短场景用段落级,都是同一回事)。


三、 结果一:峰值位置——有趋势,但统计上不显著

每组 20 篇,按段落标强度,取最高强度段的位置(归一化 0-100%):

组目标位置实测中位数实测均值
A50%50%43%
B70%50%53%
C90%59%55%

在这里插入图片描述

三个关键观察:

  1. 有方向趋势但统计不可靠:中位数 50 → 50 → 59%,均值 43 → 53 → 55%,指令越靠后,峰值确实偏后。但 A/B/C 两两 Mann-Whitney 检验均不显著(p=0.15/0.65/0.08)——只能说有趋势,不能说"能控制"。
  2. A 组正中目标:要求 50%,实测中位数正好 50%。中段位置相对最准。
  3. 越靠后越提前(偏保守 20-30%):B 组要 70% 只到 50%,C 组要 90% 只到 59%。模型到不了真正的末段——倾向于在靠后段就达到峰值,不一定落在指定的最后一两段。

用单篇看"能到哪": A 组一篇的段落强度是 [6,7,8,9,8]——峰值 9 落在第 4 段(75% 位置),然后回落。这个"爬升→触顶→回落"的形状做得对,说明 AI 理解"情绪得有起伏";但它落在第 4 段而不是正中的第 3 段,说明"精确到段"做不到。反过来,C 组也有个别篇真的把峰值放到了末段(强度 [7,7,8,6,10],峰值第 5 段)——个别能到,但从整组中位数看,峰值总是被提前到倒数第二段附近。

测量稳定性说明:峰值位置这个指标对同一批文本重测,中位数会有 ±10% 左右的波动——本身不够稳定,这可能是三组差异不显著的原因之一。


四、 结果二:压抑-释放——先抑后扬,AI 自动会

每组 20 篇,算"释放段平均强度 − 压抑段平均强度":

组压抑段数强度差中位数压抑段均值释放段均值
A11.06.57.5
B21.06.57.5
C31.76.38.0

在这里插入图片描述

强度差是什么: “释放段平均强度 − 压抑段平均强度”,衡量"先抑后扬"的落差有多陡。真人写先抑后扬,压抑段通常压到情绪谷底(强度很低),落差会更大;AI 的 1.0→1.7 说明"有落差、够用,但还不够陡"。

两个关键观察:

  1. 压抑越久,释放越猛:压抑 1-2 段时强度差 1.0,压抑 3 段时跳到 1.7——"先抑后扬"AI 会自己落实,并按压抑长度自动调节释放力度。
  2. 但压抑段压得不够狠:压抑段均值 6.3-6.5,在 0-10 的尺子上还是偏高。模型能做出"前低后高"的落差,但"低"得不够低——它理解的"压抑"更像"略平静",不是"被压到谷底"。

五、 结论:情绪曲线部分"可编程",部分存疑

对应篇首的两个实验目的,逐个回答:

实验一(峰值位置)能控吗?——只有趋势,不能指望精确。 三组中位数 50→50→59% 方向是对的(指令越靠后、峰值越偏后),但两两 Mann-Whitney 都不显著(p=0.15/0.65/0.08),且指标本身重测有 ±10% 波动。用途有限:只能当"粗调方向",不能当精确控制手段。

实验二(压抑-释放)能控吗?——能,统计显著。 压抑 3 段比 1 段的强度差显著更大(B vs C p=0.000、A vs C p=0.029),"压抑越久释放越猛"AI 自动落实。唯一的保留:压抑段压得不够低(均值 6.3-6.5)。

对照 Part 10,情绪曲线"骨架"可编程成立吗?——成立,但只限三个参数:

参数能不能控检验结果
载体(Part 10)✅ 能80% 遵守(卡方 p<0.0001 显著)
峰值位置⚠️ 趋势,不显著三组两两 p 均>0.05,测量本身有波动
压抑-释放✅ 能A vs C p=0.029、B vs C p=0.000 显著

一句话:情绪曲线的"骨架"(载体、压抑释放)可以按指令搭,峰值位置只能粗调。 具体怎么用在落地节。


六、 落地:写场景时怎么用

  1. 峰值位置:可以试,但别指望精确——有"越靠后峰值越偏后"的趋势(中位数 50→59%),可以指定"峰值放第 X 段"或"靠后段",但统计不显著、测量有波动,别当精确控制手段
  2. 要先抑后扬更狠,把压抑段拉长——这个可靠(B vs C p=0.000):压抑 3 段比 1 段的强度差大 70%
  3. 把精力放在压抑释放上——它统计显著、效果明确;峰值位置只能作为粗调方向

七、 本期数据与样本

  • 峰值位置实验:A/B/C 三组各 20 篇 + 段落级强度标注
  • 压抑-释放实验:A/B/C 三组各 20 篇 + 段落级强度标注
  • 生成脚本、标注 JSON——评论区或私信找作者要。

八、 实验边界与局限

按影响核心结论的程度排序:

  1. 峰值位置指标本身不稳(最关键):同一批文本重测中位数有 ±10% 波动——“三组不显著"里有一部分是"测不准"造成的,不显著不等于"没效果”,只能说"够不稳"。
  2. 5 段档位粗:峰值只能落到 0/25/50/75/100 五档,50/70/90 的间隔近乎小于档间距离,测量天然只落"最近档"。段数越多可能越准。
  3. 20 篇/组,探索性结论:峰值组间 p 值在 0.08-0.15 边缘,扩大样本可能改变"不显著"的判断。
  4. 压抑段压不狠:均值 6.3-6.5,可能是 prompt 表述问题、也可能是模型对"低强度"理解弱,未深挖。
  5. 单场景、单模型:攻心对话戏 + doubao 生成 / deepseek 标注,跨题材、跨模型未验证。
  6. 未做双模型一致性校验(系列一贯局限)。

九、 一句话总结

情绪曲线两个结构参数,一强一弱:压抑-释放能控且统计显著(压抑 3 段比 1 段强度差大 70%),峰值位置只有方向趋势、三组差异不显著、测量有波动。配合 Part 10 的载体蓝图,"情绪曲线的骨架"部分可编程(载体、压抑释放),峰值位置还不能当精确控制手段。


附录:段落级强度标注与两个指标的计算(可复现)

段落级强度标注 prompt(逐段调用,每段输出一个 JSON):

你是网文情绪分析工具。下面是一段修仙网文的局部段落。
判断这段文字承载情绪的真实强度(0-10)。

【重要】:情绪词的密集出现不等于情绪强度高。请基于整体叙事效果
判断情绪被压得有多狠、有多高涨。

文本:
---
{text}
---

输出严格 JSON(不要其他内容):
{"emotion_intensity": 0到10的整数}

两个指标怎么算:

  • 峰值位置:找出强度最高段;归一化到 0-100%(5 段场景对应 0/25/50/75/100)。强度最高的段有并列时取靠前段。
  • 强度差(压抑-释放):释放段强度均值 − 压抑段强度均值。压抑段=指令要求低强度的段,释放段=指令要求高强度的段。

复现注意点(与上篇一致):

  1. 标注固定用同一模型(deepseek)、temperature=0,保证同批样本口径一致、结果可复现。
  2. 场景只有 5 段,峰值位置天然只落在五档之一,组的中位数也一样——对比不同组时看"落在哪一档",别当连续变量苛求。(对应局限第 2 条)

本系列进度: Part 1(实验框架)→ Part 2(样本量)→ Part 3(约束数量)→ Part 4(规则形态)→ Part 5(文风标杆)→ Part 6(大纲端的剧情设计上限)→ Part 7(剧情蓝图)→ Part 8(追问优化)→ Part 9(情绪测量 + 载体单一化)→ Part 10(载体蓝图 + 载体能力不均)→ Part 11(情绪曲线工程化,本篇) → Part 12(81 章长文实测:OOC/伏笔/记忆)→ Part 13(系列总结)

Grok-3小说工业化实战:长文本连贯性与角色记忆的爆款生成逻辑 小说AI辅助创作正从‘文字生成’迈向‘叙事工程化’,其核心在于长文本连贯性、角色状态一致性与情绪节奏可控性三大技术基座。Grok系列模型通过双轨注意力机制、角色状态向量持久化及叙事熵值控制等原生设计,显著提升网文长篇稳定性与读者留存率。相比通用大模型,Grok-3在128K上下文管理、微表情延迟建模和钩子强度量化等维度形成差异化能力,尤其适配番茄、七猫等平台对‘章节留存率’‘3秒完播率’等注意力经济指标的刚性要求。本文聚焦Grok-3在小说工业化流水线中的真实落地路径,涵盖选题热力图分析、人设卡牌系统、章节 阅读详情

相关推荐

StoryFlow:基于Qwen2.5-14B-Instruct的本地化AI小说创作工作站

小说AI辅助创作正从模糊提示走向工程化生产。叙事一致性、长程伏笔控制与风格稳定性是核心挑战,而Qwen2.5-14B-Instruct凭借在中文语境下的指令遵循能力与长文本连贯性,成为兼顾质量与本地部署可行性的优选基座模型。LoRA技术在此不再仅是轻量微调手段,而是可编程的‘叙事滤镜’,支持古风武侠、儿童童话等多题材毫秒级切换与组合调控。结合结构化世界建模、角色图谱推演与章节骨架AB测试,StoryFlow将创作流程拆解为可验证、可回溯、可归档的标准化单元,真正实现AI从‘代笔’到‘协作者’的跃迁。

weixin_34356310的博客 391

AI网文写作实验笔记(十三):系列总结——12 篇实验、8 条核心结论,把“AI 写小说“每一步拆开验证

AI 写小说这条路能走通,但关键不在"提示词",在"结构"。人给蓝图和结构(戏蓝图、大纲、情绪曲线、伏笔规则),AI 填血肉,独立模型去 AI 味,工具管长线。12 篇实验把这条路每一步都用数据验证过,没有玄学,只有可复现的结论。本系列完结。Part 1-13 全部发布。

loopne的博客 714

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

jks212454的博客 439

腾讯云AIGC全栈方案:漫剧工业化生产实战指南

AIGC(人工智能生成内容)正从单点工具演进为覆盖文本理解、多模态生成与工程交付的全栈能力。其核心原理在于大模型对行业语义的深度解析、跨模态一致性约束及可审计的资产化输出,技术价值体现在大幅降低内容返工率与人力协调成本。在网文IP影视化、短视频竖屏漫剧、轻量化动画量产等场景中,已实现日更千集级稳定交付。本文聚焦腾讯云基于混元大模型的AIGC落地实践,详解文生图、文生视频与音频合成如何协同支撑工业化漫剧产线。

weixin_34216196的博客 419

船载 OpenHarmony AIS 航海工作台:告警与防碰撞预警系统

船载OpenHarmony AIS航海工作台的告警与防碰撞系统,集成十余类告警(超速、偏航、会遇、SOS等),通过网格空间索引实现高效邻近判定,保障实时性。告警管理器统一调度规则、去重、通知与日志,支持悬浮球、语音、跑马灯、弹窗多渠道触达,确保航行安全。SOS紧急通道独立运行,避免干扰。系统设计强调性能优化与多场景适配,为航海安全提供核心支撑。

专注于计算机研发知识和资讯分享 494

Python实战:用Py2neo轻松玩转Neo4j图数据库(附完整CRUD示例)

本文通过构建武侠知识图谱的实战案例,详细介绍了如何使用Python的Py2neo库对Neo4j图数据库进行CRUD操作。内容涵盖环境搭建、节点与关系创建、Cypher查询、数据更新删除及事务管理,帮助开发者直观高效地处理复杂关联数据,实现从入门到进阶的完整交互流程。

weixin_29034963的博客 185

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 331

工业视觉检测实战指南:从硬件配置到AI算法部署

本文提供了一套完整的工业视觉检测系统搭建实战指南。从硬件选型(相机、光源、镜头、工控机)到AI算法(深度学习模型)部署,详细解析了如何为生产线配置一双“会思考的眼睛”。重点探讨了深度学习算法在复杂缺陷识别中的应用,并分享了模型训练、优化及云边协同部署的实战心得,旨在帮助工程师实现从实验室Demo到7x24小时稳定运行的工业落地。

weixin_29051193的博客 462

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 263

wps js宏获取工作簿、工作表、单元格的值、链接转图片、单元格区域数据转二维数组、保存工作簿的常用Excel操作

wps js宏入门看这里,我写了常用的js操作Excel的方法:获取工作簿对象、获取工作表对象、获取单元格的值、链接转图片、生成条形码图片、单元格区域数据转二维数组方法、保存工作簿、弹出输入框、YesNo选择框,助你从VBA转战JS。

huaermeier的博客 3万+

【博客汇总】UV打印机博客汇总

UV平板机博客汇总

Print World的专栏 1753

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 611

从GitHub到海浪模拟:手把手教你配置WAVEWATCHⅢ 6.07.0的完整开发与测试环境

本文详细指导如何在Ubuntu系统中配置WAVEWATCHⅢ 6.07.0的开发与测试环境,涵盖虚拟机设置、依赖安装、源码编译及案例验证的全流程。通过步骤化教程,帮助科研人员快速搭建高效的海浪模拟平台,提升海洋数值模拟的研究效率。

weixin_42568801的博客 326

抽象主义人工智能和生命体AI的内在联系

彭军辉提出“抽象主义人工智能”作为第四大AI范式,批判符号主义、连接主义、行为主义剥离生命本体的误区,确立“智能是现象,生命是本体”的核心公理。主张原生智能必须依附具备存续诉求的生命本体,提出“生命体AI理论”,构建七层演化阶梯与自闭环工程框架,强调智能不可跳过底层存续机制直接模拟语言。该体系为生成式AI提供科学边界,推动从“仿真表象”向“原生智能”的范式跃迁,开辟硅基人工生命新赛道。

抽象主义人工智能和生命体AI 201

37、OpenMP:并行编程的强大工具

本文详细介绍了 OpenMP 的核心功能和使用方法,包括执行环境例程、线程同步与协调机制,如关键区域、屏障、原子操作、归约子句、刷新构造和锁机制。此外,还提供了多个实践练习,涵盖矩阵乘法的并行实现、任务池与流水线模式的应用、读写锁的扩展与移植,以及客户端-服务器模式的实现与优化。通过这些内容,读者可以全面掌握 OpenMP 在并行编程中的实际应用与性能优化技巧。

www00的博客 106

SAP Parallel Accounting(平行分类账业务)配置及操作手册(超详细的说明和测试)

非常详细的介绍了SAP 的平行分类账配置以及测试效果哦

nopicture的博客 4346

OpenAI Control Room 架构拆解:给企业 AI Agent 加一套可审计的急停系统

OpenAI 公开了用于追踪和停止研究模型工作负载的 Control Room。本文拆解 job_id、推理前鉴权、35 秒撤销窗口与 Fail Closed 设计,并给出企业 AI Agent 急停控制面的数据模型、FastAPI 参考实现、缓存撤销策略和故障演练清单。

jerry764的博客 334

Kylin操作系统下OpenLDAP安装

Kylin操作系统下OpenLDAP安装

跟着大数据和AI去旅行 1612

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 340

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

AI赋能智慧港口建设|造形家快速生成港口全要素三维场景

随着智慧港口、港口数字孪生项目的持续推进,港口三维场景的需求日益旺盛。传统港口三维建模,往往需要航拍倾斜摄影采集数据,再人工搭建吊机、岸桥、船舶、集装箱等大量工业设施模型,项目周期长、人力成本高,修改迭代繁琐,制约港口可视化项目落地效率。国产AI三维建模工具,依托卫星影像 AI 识别能力,无需航拍作业,一键快速搭建港口完整三维场景,为港口数字孪生、方案汇报、投标演示提供高效的场景解决方案。

m0_69539167的博客 81

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

从设备增点到治理闭环:老旧小区物业数智化落地实践

系统连接合同审批、银行流水、收费记录与项目台账,执行到期提醒、收入核验、异常标色和月度对账,让每一笔资金来源明确、去向可查。针对设施老旧、诉求响应慢、公共收益不透明等问题,津南以6类小区为试点场景,统一建设物业数字化底座,关联楼栋、单元、房屋、业主、空间、设施设备、工单、公共收益等核心数据。系统采用统一编码管理,将摄像头、路灯、井盖、道路、绿化等设施纳入资产台账,解决纸质记录更新滞后、故障责任难追溯的问题。基于历史工单建立分类模型和知识库,辅助识别照明、给排水、电梯、环境秩序、秩序维护等问题;

wuyeshuzhihua的博客 155

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

企业微信iPad协议详解:接口接入、实时消息同步与语音转码实践

深入解析企业微信iPad协议的技术架构与开发思路,涵盖API接口接入、长连接通信、实时消息同步、Silk语音转码、异常重连及高并发优化,帮助开发者了解企业微信自动化系统的设计与实现。

欢迎来到祖安! 505

Product Hunt 热榜 2026-11-13:Plurai Simulation、YouArt Desktop App、Omnigraph

2026-11-13 Product Hunt 新产品精选:Plurai Simulation、YouArt Desktop App、Omnigraph。汇总 15 款产品的中文介绍、功能关键词和产品链接。

LaughingZhu的博客 607

【AI Agent面试系列】AI Agent可观测、评测、安全相关的知识点

之前的文章介绍了和,本文主要介绍AI Agent的测评、可观测等知识。

390

Docling 原理解读:是什么、为什么、怎么样

从论文视角拆解 Docling 的整体架构、DoclingDocument 数据模型、PDF 预处理、版面分析、OCR、TableFormer 双解码器、阅读顺序与装配流程,并解释版面框与 OCR 框的区别。

PLANTTHESON的博客 401

WorkBuddy 实战:一句话需求 → 七屏可交互原型,户外徒步 App 的 AI 设计全流程

WorkBuddy 实战:一句话需求 → 七屏可交互原型,户外徒步 App 的 AI 设计全流程,跟着博主一起来还原整个过程。

夜郎King的博客 5131
上一篇: AI网文写作全景调研(六):五大瓶颈——为什么主流工具都写不出合格网文?
下一篇: AI网文写作全景调研(七):路线价值判断——7条路线,每条的天花板在哪?
loopne
博客等级 码龄11年 0粉丝 26原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值