


 本文详述通过7步工程化优化将RAG知识库准确率从60%提升至95%的实战方法:语义分块、上下文前缀注入、混合检索(向量+BM25)、Rerank重排序、版本化文档清理及标准化评估体系。强调知识库构建需兼顾检索精度、上下文完整性与可量化验证,是大模型应用层落地的关键技术环节。
本文分享了作者如何通过7步优化将一个内部知识库Agent的准确率从60%提升至95%的经验。主要优化步骤包括:改进分块策略、添加上下文前缀、实施混合检索、使用Rerank模型、清理旧版本文档以及建立评估体系。文章强调了知识库构建不仅仅是将文档简单导入,而是需要精细化的工程系统设计,才能有效提升用户体验。
上线第一天,老板就拿着截图来找我。
“你做的知识库,问它’退货地址是什么’,它跟我说’我们没有退货服务’。退货地址就写在文档第一页第一行。”
我没话说。
这是一个给公司内部做的知识库 Agent。把产品手册、FAQ、操作文档全灌进去,员工有问题直接问 Agent。
Demo 的时候效果很好。一上线就翻车——回答准确率大概 60%。也就是说,10 个问题有 4 个答错或者答不上来。
用户给这个 Agent 起了个外号:“人工智障”。
我花了两周,做了 7 步优化,准确率从 60% 拉到 95%。今天把每一步拆开讲。
第 1 步:搞清楚为什么找不到
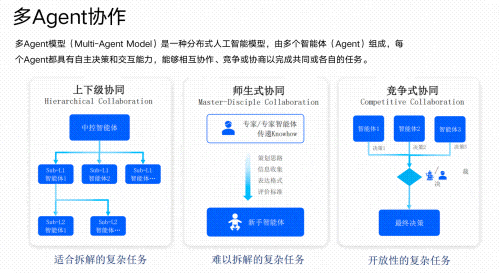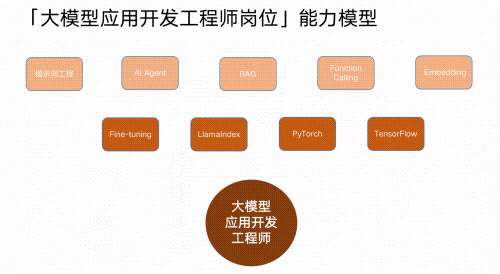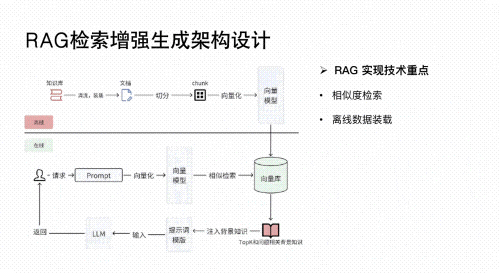
RAG 的原理不复杂:用户提问 → 把问题转成向量 → 在知识库里找最相似的文档片段 → 把片段塞给模型回答。
问题出在中间那步——“找最相似的文档片段”。
我加了日志,把每次检索的 query、命中的文档片段、相似度分数全打出来。看了 200 条日志,发现三种典型的"找不到":
分块切断了语义。文档里有一段:"退货地址:上海市浦东新区XX路XX号。收件人:退货组。电话:021-XXXXXXXX。“我的分块策略是按 500 字切,这段话被切到了两个块里——地址在前一个块的末尾,收件人和电话在后一个块的开头。检索命中了前一个块,但里面只有地址,没有收件人和电话。模型一看信息不完整,就说"我们没有退货服务”。
问法不匹配。用户问"怎么退货",文档里写的是"退换货流程"。语义相近,但向量距离不够近——因为"退货"和"退换货"在向量空间里差了那么一点。
多个答案冲突。产品手册更新了三个版本,旧版本没删。用户问"产品 A 的价格",检索同时命中了旧版和新版,模型拿到了两个不同的价格,选了旧的那个。
找到病因,开始逐个治。
第 2 步:智能分块——别再按字数切了
按固定字数分块是最粗暴的做法。就像把一本书每 500 字切一刀,不管切在了哪里。
更好的方式是按语义分块——遇到段落标题就切、遇到列表结束就切、遇到话题转换就切。
public class SmartChunker
{
public List Split(string document, string docTitle)
{
var chunks = new List();
var lines = document.Split('\n');
var currentChunk = new StringBuilder();
var currentSection = docTitle;
foreach (var line in lines)
{
// 遇到标题就切
if (line.StartsWith(”
# ”) || line.StartsWith(”## ”))
{
if (currentChunk.Length > 0)
{
chunks.Add(new Chunk
{
Content = currentChunk.ToString(),
Section = currentSection,
Source = docTitle
});
currentChunk.Clear();
}
currentSection = line.TrimStart('#', ' ');
}
currentChunk.AppendLine(line);
// 超过 800 字且有自然断点(空行)就切
if (currentChunk.Length > 800 && string.IsNullOrWhiteSpace(line))
{
chunks.Add(new Chunk
{
Content = currentChunk.ToString(),
Section = currentSection,
Source = docTitle
});
currentChunk.Clear();
}
}
if (currentChunk.Length > 0)
{
chunks.Add(new Chunk
{
Content = currentChunk.ToString(),
Section = currentSection,
Source = docTitle
});
}
return chunks;
}
}
关键改进:
- 按标题切:每个 section 独立成块,不会被截断
- 重叠窗口:相邻块之间重叠 100 字,防止关键信息恰好在边界
- 块大小弹性:目标 800 字,但如果段落更长就不强行切
第 3 步:给每个块加"上下文前缀"
分块之后,每个块是独立的。但独立意味着丢失了"我在哪"的信息。
一个块的内容是"退货地址:上海市浦东新区XX路XX号",但它不知道自己是"售后服务"章节下的内容。
解决方案:给每个块加上它所属的章节路径作为前缀。
public record Chunk
{
public string Content { get; init; }
public string Section { get; init; }
public string Source { get; init; }
// 用于检索的文本 = 章节路径 + 内容
public string SearchableText => $”[{Source} > {Section}] {Content}”;
}
// 示例:
// [产品手册 > 售后服务] 退货地址:上海市浦东新区XX路XX号。收件人:退货组。
这个改动看起来很小,但效果显著。检索的时候,向量不仅包含"退货地址"的语义,还包含"产品手册 > 售后服务"的上下文。用户问"退货地址是什么",跟"[售后服务] 退货地址"的相似度比跟"[产品功能] 退货地址"更高——即使两个块的内容差不多。
第 4 步:混合检索——向量搜索不够,还得加关键词
纯向量搜索有个盲区:精确匹配。
用户问"Order-2024-001 的物流状态",“Order-2024-001"是一个精确的订单号。向量搜索会把"Order-2024-001"转成向量,然后找"语义相似"的文档——但订单号没有"语义”,它需要的是精确匹配。
解决方案:混合检索(Hybrid Search)——向量搜索 + BM25 关键词搜索,结果合并。
public class HybridRetriever
{
private readonly VectorStore _vectorStore;
private readonly BM25Index _bm25Index;
public async Task> SearchAsync(string query, int topK = 5)
{
// 向量搜索:语义匹配
var vectorResults = await _vectorStore.SearchAsync(query, topK: topK * 2);
// BM25 搜索:关键词精确匹配
var bm25Results = _bm25Index.Search(query, topK: topK * 2);
// RRF(Reciprocal Rank Fusion)合并
var merged = vectorResults
.Concat(bm25Results)
.GroupBy(r => r.ChunkId)
.Select(g => new SearchResult
{
ChunkId = g.Key,
Score = g.Sum(r => 1.0 / (60 + r.Rank)),  // RRF 公式
Chunk = g.First().Chunk
})
.OrderByDescending(r => r.Score)
.Take(topK)
.ToList();
return merged;
}
}
RRF 合并的好处:不依赖两个搜索的原始分数(它们的分数尺度不同),只看排名。一个结果在向量搜索排第 2、BM25 排第 3,它的 RRF 分数就比只在一个搜索里排第 1 的更高。
第 5 步:Rerank——检索完再排一次序
检索出来的 5 个结果,顺序不一定对。向量搜索觉得最相关的可能排第一,但实际上第三个回答更准确。
用Rerank 模型做二次排序:先粗检索 20 个,再用 Rerank 模型精排,取 Top 5。
public class RerankRetriever
{
private readonly HybridRetriever _baseRetriever;
private readonly RerankClient _rerankClient;
public async Task> SearchAsync(string query, int topK = 5)
{
// 粗检索:多拿一些候选
var candidates = await _baseRetriever.SearchAsync(query, topK: 20);
// Rerank:用交叉编码器精排
var rerankResults = await _rerankClient.RerankAsync(
query,
candidates.Select(c => c.Chunk.SearchableText).ToList(),
topK: topK);
return rerankResults
.Select(r => candidates[r.Index] with { Score = r.Score })
.ToList();
}
}
Rerank 模型推荐用 Cohere Rerank 或 BGE-Reranker。费用不高,但能显著提升 Top 1 的准确率——通常能提升 10-15%。
第 6 步:清理旧版本——知识库不是垃圾堆
第三步发现的"多个答案冲突"问题,根因是旧版文档没清理。
解决方案听起来简单:给文档加版本号,检索时只返回最新版本。
public record Document
{
public string Id { get; init; }
public string Title { get; init; }
public string Version { get; init; }
public DateTime UpdatedAt { get; init; }
public bool IsLatest { get; init; }  // 关键标记
public string Content { get; init; }
}
// 上传新版文档时
public async Task UploadNewVersion(string docId, string newContent, string newVersion)
{
// 旧版标记为非最新
await _db.UpdateAsync(docId, d => d.IsLatest = false);
// 插入新版
await _db.InsertAsync(new Document
{
Id = docId,
Title = ”产品手册”,
Version = newVersion,
UpdatedAt = DateTime.UtcNow,
IsLatest = true,
Content = newContent
});
// 重建向量索引(只索引最新版)
await RebuildIndexAsync(docId);
}
// 检索时过滤
var results = await _vectorStore.SearchAsync(query,
filter: d => d.IsLatest == true);
第 7 步:评估体系——不能靠感觉说"好了"
最后一步,也是最重要的一步:建立评估体系。
没有评估,你就不知道优化有没有用。"感觉好了"不是指标。
我建了一个测试集:200 个真实用户问题 + 标准答案。每次优化后跑一遍,看准确率。
public class RagEvaluator
{
public async Task EvaluateAsync(List testCases)
{
int correct = 0;
int partial = 0;
var results = new List();
foreach (var tc in testCases)
{
var retrieved = await _retriever.SearchAsync(tc.Question, topK: 5);
var answer = await _agent.RunAsync(tc.Question);
// 检索评估:标准答案所在的块是否被检索到
bool retrievedCorrectly = retrieved.Any(r =>
r.Chunk.Source == tc.ExpectedSource);
// 回答评估:用另一个模型判断回答是否正确
var judgeResult = await _judgeAgent.RunAsync(
$”问题:{tc.Question}\n标准答案:{tc.ExpectedAnswer}\n实际回答:{answer.Last().Text}\n\n判断实际回答是否正确,输出 YES/PARTIAL/NO”);
var verdict = judgeResult.Last().Text.Trim().ToUpper();
if (verdict == ”YES”) correct++;
else if (verdict == ”PARTIAL”) partial++;
results.Add(new TestCaseResult
{
Question = tc.Question,
RetrievedCorrectly = retrievedCorrectly,
Verdict = verdict
});
}
return new EvalResult
{
Total = testCases.Count,
Correct = correct,
Partial = partial,
Accuracy = (double)correct / testCases.Count,
RetrievalRate = (double)results.Count(r => r.RetrievedCorrectly) / testCases.Count
};
}
}
每次改代码,跑一遍评估。准确率涨了就是有效,没涨就是白忙。
7 步做完,准确率变化:
| 步骤 | 准确率 | 变化 |
|---|---|---|
| 基线(暴力分块+纯向量) | 60% | — |
| +智能分块 | 72% | +12% |
| +上下文前缀 | 78% | +6% |
| +混合检索 | 85% | +7% |
| +Rerank | 91% | +6% |
| +清理旧版本 | 93% | +2% |
| +评估体系(持续调优) | 95% | +2% |
从"人工智障"到"还真能用",用了两周。
2026年AI行业最大的机会,毫无疑问就在应用层!
字节跳动已有7个团队全速布局Agent
大模型岗位暴增69%,年薪破百万!
腾讯、京东、百度开放招聘技术岗,80%与AI相关……
如今,超过60%的企业都在推进AI产品落地,而真正能交付项目的 大模型应用开发工程师 **,**却极度稀缺!
落地AI应用绝对不是写几个prompt,调几个API就能搞定的,企业真正需要的,是能搞定这三项核心能力的人:
✅RAG:融入外部信息,修正模型输出,给模型装靠谱大脑
✅Agent智能体:让AI自主干活,通过工具调用(Tools)环境交互,多步推理完成复杂任务。比如做智能客服等等……
✅微调:针对特定任务优化,让模型适配业务
目前,脉脉上有超过1000家企业发布大模型相关岗位,人工智能岗平均月薪7.8w!实习生日薪高达4000!远超其他行业收入水平!
技术的稀缺性,才是你「值钱」的关键!
具备AI能力的程序员,比传统开发高出不止一截!有的人早就转行AI方向,拿到百万年薪!👇🏻👇🏻
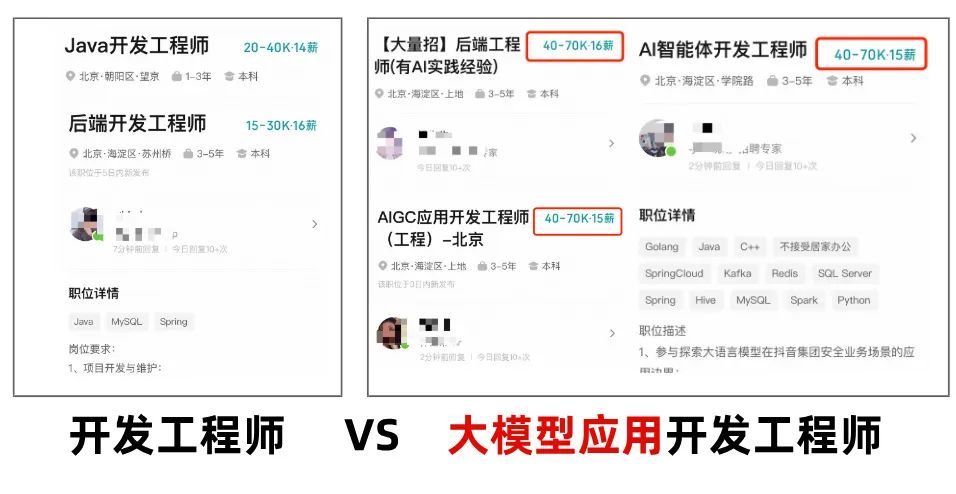
AI浪潮,正在重构程序员的核心竞争力!现在入场,仍是最佳时机!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

⭐️从大模型微调到AI Agent智能体搭建
剖析AI技术的应用场景,用实战经验落地AI技术。从GPT到最火的开源模型,让你从容面对AI技术革新!
大模型微调
-
掌握主流大模型(如DeepSeek、Qwen等)的微调技术,针对特定场景优化模型性能。
-
学习如何利用领域数据(如制造、医药、金融等)进行模型定制,提升任务准确性和效率。
RAG应用开发
- 深入理解检索增强生成(Retrieval-Augmented Generation, RAG)技术,构建高效的知识检索与生成系统。
- 应用于垂类场景(如法律文档分析、医疗诊断辅助、金融报告生成等),实现精准信息提取与内容生成。
AI Agent智能体搭建
- 学习如何设计和开发AI Agent,实现多任务协同、自主决策和复杂问题解决。
- 构建垂类场景下的智能助手(如制造业中的设备故障诊断Agent、金融领域的投资分析Agent等)。
如果你也有以下诉求:
快速链接产品/业务团队,参与前沿项目
构建技术壁垒,从竞争者中脱颖而出
避开35岁裁员危险期,顺利拿下高薪岗
迭代技术水平,延长未来20年的新职业发展!
……
那这节课你一定要来听!
因为,留给普通程序员的时间真的不多了!
立即扫码,即可免费预约
「AI技术原理 + 实战应用 + 职业发展」
「大模型应用开发实战公开课」
👇👇

👍🏻还有靠谱的内推机会+直聘权益!!
完课后赠送:大模型应用案例集、AI商业落地白皮书


 扫一扫


 383

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


