


大模型在当今人工智能领域占据着核心地位,其强大的能力正不断推动各行业的变革与创新。无论是对人工智能充满好奇的初学者,还是希望在该领域深入发展的专业人士,掌握大模型相关知识和技能都至关重要。以下为你详细介绍 2026 年从零基础入门到精通大模型的学习路线。
一、基础准备阶段
(一)数学基础
- 线性代数:熟练掌握矩阵运算,包括矩阵乘法、加法、求逆等,理解向量空间的概念,明晰特征值与特征向量的含义及计算方法。这对于理解大模型中数据的变换和特征提取极为关键,例如在图像识别任务中,图像数据常以矩阵形式表示,线性代数运算用于图像处理和特征抽取。
- 概率统计:深入学习随机变量,熟知常见的概率分布如正态分布、泊松分布等。掌握贝叶斯定理,其在模型的不确定性估计和推理中广泛应用,大模型在处理自然语言等任务时,需借助概率统计来评估语言生成的可能性。
- 微积分:重点理解梯度、偏导数的概念和计算,它们是大模型训练中优化算法的核心,通过计算梯度来调整模型参数,使模型在训练过程中不断优化性能,如在神经网络训练中,利用梯度下降算法寻找最优参数。可通过 Khan Academy 的线性代数和微积分课程,以及 Coursera 上的 “Probability and Statistics for Business and Data Science” 课程辅助学习。
(二)编程基础
- Python:作为大模型开发的首选语言,要全面了解基本的数据结构,如列表、字典、元组等,熟练运用控制流语句,包括条件判断(if - else)、循环(for、while)等,同时掌握函数式编程的基本概念,如函数定义、调用、参数传递等。
- NumPy:精通数组操作,能够高效地创建、索引、切片和修改数组。熟悉 NumPy 提供的丰富数学函数,用于执行向量和矩阵运算,这在处理大模型中的数据时必不可少。可参考 Udacity 的 “Intro to Programming” 和 “Intro to NumPy” 课程进行学习。
(三)深度学习基础
- 神经网络基础:深入理解前馈神经网络的结构和工作原理,掌握卷积神经网络(CNN)在图像识别领域的应用,了解循环神经网络(RNN)及其变种(如 LSTM、GRU)在处理序列数据(如自然语言)方面的优势。理解神经网络通过神经元之间的连接权重来学习数据特征的过程。
- 训练技巧:掌握反向传播算法,它是计算模型误差并更新参数的关键方法。熟悉梯度下降及其变种(如随机梯度下降 SGD、Adagrad、Adadelta 等)优化算法,了解如何通过调整学习率等超参数来提高模型训练的效率和稳定性。
二、核心技术学习阶段
(一)Transformer 模型
- 原理深入剖析:透彻理解 Transformer 的核心 —— 自注意力机制,包括自我注意层如何计算输入序列中每个位置与其他位置之间的关联权重,以及多头注意力机制如何通过多个不同的注意力头并行计算,从而捕捉输入序列中更丰富的特征和关系。理解位置编码的作用,它为输入序列中的每个位置添加位置信息,使模型能够感知序列中元素的顺序。
- 结构与变种:掌握 Transformer 整体架构,包括编码器和解码器模块的结构和功能。研究 Transformer 的多种变种,如 BERT(基于双向编码器的预训练模型,在自然语言处理的多种任务如文本分类、问答系统中表现出色)、GPT(自回归生成式模型,擅长文本生成任务,如生成文章、对话等)、T5(文本到文本统一框架,可将多种自然语言处理任务统一为文本到文本的转换)等,分析它们在结构和应用场景上的差异。深入研读《Attention Is All You Need》(Transformer 原论文)、《BERT: Pre-training of Deep Bidirectional Transformers》等经典论文。
(二)预训练技术
- 预训练原理:掌握大模型预训练的基本原理,理解如何在大规模无监督数据上进行预训练,使模型学习到通用的语言或数据特征表示。例如,在自然语言处理中,通过掩码语言模型(Masked Language Modeling,MLM)任务,模型学习预测文本中被随机掩码的单词,从而捕捉语言的语法和语义信息;通过下一句预测(Next Sentence Prediction,NSP)任务,模型学习文本段落中句子之间的逻辑关系。
- 方法与技巧:了解不同的预训练方法和技巧,如数据增强技术(在文本数据中可采用同义词替换、随机删除单词等方式扩充数据)、多任务预训练(同时在多个相关任务上进行预训练,提升模型的泛化能力)等。学习如何选择合适的预训练模型作为基础,以及如何根据具体任务和数据对预训练模型进行调整和优化。
(三)自然语言处理基础(针对大模型在 NLP 领域应用)
- 文本预处理技术:熟练掌握文本清洗,去除文本中的噪声,如特殊字符、HTML 标签等;学会分词,将连续的文本分割成一个个单词或子词,常见的分词方法有基于规则的分词、基于统计的分词等;了解词性标注,为每个单词标注其词性(如名词、动词、形容词等),这有助于后续的语法分析和语义理解。
- 词嵌入:理解词嵌入的概念,如 Word2Vec、GloVe 等传统词嵌入方法如何将单词映射到低维向量空间,使得语义相近的单词在向量空间中距离较近。掌握基于预训练模型的词嵌入,如 BERT 嵌入,其能够捕捉单词在上下文中的语义信息,相比传统词嵌入更具优势。
- 语言模型:学习语言模型的基本概念和评估指标,了解传统语言模型(如 N - gram 模型)的原理和局限性,深入理解基于神经网络的语言模型(如循环神经网络语言模型、Transformer 语言模型)如何通过对大量文本的学习,预测下一个单词出现的概率,从而生成连贯的文本。可参考书籍《Speech and Language Processing》(Jurafsky),学习斯坦福 CS224N(NLP with Deep Learning)课程。
三、实战项目阶段
(一)基础实战项目
- 经典大模型项目复现:尝试复现一些经典的大模型项目,如 GPT 系列、BERT 等。在复现过程中,深入理解模型的架构搭建、参数设置、训练流程等细节。例如,使用 PyTorch 或 TensorFlow 框架搭建 BERT 模型,加载预训练权重,并在特定的自然语言处理任务(如文本分类)上进行微调训练,通过实践加深对大模型技术和应用的理解。可参考 Hugging Face 教程,使用 Hugging Face 提供的工具和接口,快速调用 API 进行模型的加载和使用,如:
from transformers import pipeline
generator = pipeline("text - generation", model = "gpt2")
print(generator("Hello, I’m learning LLM because", max_length = 50))
- 简单应用开发:基于所学的大模型知识,开发一些简单的应用,如文本摘要生成器,输入一篇文章,模型能够自动生成简洁的摘要;或者开发一个情感分析工具,判断给定文本的情感倾向(积极、消极或中性)。通过这些基础项目,锻炼将理论知识转化为实际应用的能力。
(二)领域特定实战项目
- 根据兴趣或职业需求选择领域:如果对医疗领域感兴趣,可以构建基于大模型的医学命名实体识别系统,从医学文献中识别出疾病名称、药物名称、症状等实体;若从事金融行业,可开发基于大模型的金融风险预测模型,利用金融数据和文本信息预测市场风险。
- 项目实施与优化:在项目实施过程中,深入了解特定领域的数据特点和任务需求,对数据进行收集、清洗、标注等预处理工作。针对具体任务选择合适的大模型架构,并进行微调优化。例如,在构建医疗命名实体识别系统时,可选择在医学领域有较好表现的 BioBERT 模型进行微调,通过调整超参数、增加领域特定数据等方式,提高模型在医疗文本上的识别准确率。同时,学习使用评估指标(如准确率、召回率、F1 分数等)对项目结果进行评估,不断优化项目性能。可参与 Kaggle 竞赛(如 NLP 竞赛:文本生成、摘要生成等),与其他开发者交流经验,提升项目实践能力。
四、高级技能学习阶段
(一)大模型 API 应用开发
- 主流大模型 API 使用:学习如何使用 OpenAI API、百度文心一言 API、阿里通义千问 API 等主流大模型的 API 进行应用开发。了解如何注册账号、获取 API 密钥,熟悉 API 的接口文档和调用方式。例如,使用 OpenAI 的 ChatGPT API 开发一个智能客服聊天机器人,通过调用 API 发送用户的问题,并接收模型返回的回答,实现与用户的交互。
- Python 接口接入与开发技巧:掌握使用 Python 编写代码接入大模型 API 的方法,学会处理 API 请求和响应数据,包括数据的格式转换、错误处理等。例如,将用户输入的文本数据转换为符合 API 要求的格式进行请求发送,对接收到的 API 响应结果进行解析和处理,根据响应内容进行相应的业务逻辑处理。学习如何优化 API 调用的效率,如合理设置请求参数、缓存常用结果等,以降低应用的运行成本。
(二)大模型应用架构实践
- LangChain 框架学习:深入学习 LangChain 框架,它提供了一系列工具和组件,用于构建基于大模型的复杂应用。了解 LangChain 中的提示词管理、文档加载与处理、链(Chain)和代理(Agent)等概念和功能。例如,使用 LangChain 构建一个智能文档问答系统,通过加载文档数据,利用链和代理机制,结合大模型实现对文档内容的智能问答。
- Agents 等框架应用:学习其他相关框架,如 AutoGPT、MetaGPT 等多 Agent 系统框架。理解 Agent 的概念,即能够自主决策和执行任务的智能体。掌握如何使用这些框架构建多 Agent 协作的应用,如通过 AutoGPT 实现一个能够自主完成复杂任务(如制定旅行计划、撰写研究报告等)的智能体系统,每个 Agent 负责不同的子任务,通过相互协作完成最终目标。同时,学习使用可视化工具(如 Coze、Dify 等)辅助大模型应用的开发和调试,通过可视化界面更直观地管理和优化应用流程。
(三)模型微调与私有化部署
- 大模型微调技术:深入掌握大模型的微调技术,理解如何根据特定任务对预训练模型进行微调。了解不同的微调方法,如全量微调(对模型的所有参数进行调整)、部分微调(只对模型的特定层或部分参数进行调整)、基于适配器(Adapter)的微调(如 LoRA 低秩适应技术,通过在模型中添加低秩矩阵来进行微调,减少计算量和内存需求)等。学习如何选择合适的微调策略,根据任务特点和数据量确定微调的参数设置,如学习率、训练轮数等。例如,在构建一个法律领域的文本分类模型时,使用 LoRA 技术对预训练的大模型进行微调,利用少量的法律领域标注数据,使模型能够准确地对法律文本进行分类。
- 私有化部署:了解模型私有化部署的流程和方法,掌握如何选择合适的硬件设备(如 GPU 服务器)来支持模型的运行。学习使用推理部署框架,如 Ollama、vLLM 等,实现模型的快速部署和推理。了解如何进行模型的优化和加速,如模型量化(将模型参数从高精度数据类型转换为低精度数据类型,减少内存占用和计算量)、模型蒸馏(将复杂的大模型知识迁移到较小的模型上,提高推理效率)等技术在私有化部署中的应用。同时,关注模型部署过程中的安全和隐私问题,确保模型和数据的安全。
五、持续学习与探索
(一)关注前沿技术
- 学术研究跟踪:持续关注大模型领域的最新学术研究进展,定期阅读顶级学术会议(如 NeurIPS、ICLR、ACL、EMNLP 等)和期刊上的相关论文。关注 ArXiv、Papers With Code 等论文库,及时了解新的模型架构、算法改进、应用拓展等方面的研究成果。例如,关注多模态模型(如结合文本、图像、音频等多种数据模态的模型)的研究进展,了解如何将不同模态的数据融合到一起,提升模型的综合能力;关注参数高效微调技术的发展,不断探索更高效、更灵活的模型微调方法。
- 行业动态关注:关注 OpenAI、Google AI、Meta AI 等行业领先机构的博客和技术报告,了解他们在大模型研发和应用方面的最新动态。关注开源大模型项目(如 Llama 2、Falcon、Mistral 等)的发展,学习其代码实现和创新点,参与开源社区的讨论和贡献。同时,关注大模型在各个行业的应用案例和商业落地情况,分析行业趋势和市场需求,为自己的学习和实践提供方向。
(二)加入社区与交流
- 参与国际社区:积极加入 GitHub、Reddit 等国际知名的技术社区,在相关的大模型讨论板块与全球的开发者、研究者交流心得、分享经验。在 GitHub 上参与大模型相关的开源项目,通过阅读和贡献代码,学习优秀的代码实践和项目经验。在 Reddit 的 r/MachineLearning 等论坛上,关注热门话题讨论,与其他学习者共同探讨大模型技术的难题和解决方案,拓宽自己的视野。
- 中文社区互动:参与国内的知乎、掘金等技术社区,关注 AI 大模型相关的话题和专栏,与国内的同行进行交流。关注 AI 相关的公众号(如「李 rumor」「机器之心」等),获取最新的行业资讯、技术解读和学习资源推荐。同时,可以加入一些大模型学习交流群,与志同道合的朋友一起学习、互相督促,共同进步。
(三)实践与创新
- 实际项目参与:在工作或学习中,积极寻找机会参与实际的大模型项目,将所学知识应用到真实场景中。通过解决实际问题,不断积累经验,提升自己的实践能力。例如,参与企业的智能客服系统升级项目,利用大模型提升客服效率和质量;或者参与科研项目,探索大模型在新领域的应用可能性。
- 创新尝试:在实践的基础上,勇于尝试新的想法和技术,进行创新性探索。可以结合自己的专业知识和兴趣,开展一些小型的创新项目,如开发基于大模型的个性化教育辅助工具、探索大模型在艺术创作领域的应用(如生成音乐、绘画等)。参与各类人工智能竞赛,如 Kaggle、天池等平台上的大模型相关竞赛,与其他参赛者竞争和交流,激发创新思维,提升自己的创新能力。
学习大模型是一个持续且充满挑战的过程,需要不断投入时间和精力,保持对新技术的好奇心和探索精神。通过以上系统的学习路线,从基础准备逐步迈向精通,相信你能够在大模型领域取得显著的进步,为未来的职业发展或学术研究打下坚实的基础。
结语:抓住大模型时代的职业机遇
AI大模型的发展不是“替代人类”,而是“重塑职业价值”——它淘汰的是重复性、低附加值的工作,却催生了更多需要“技术+业务”交叉能力的高端岗位。对于求职者而言,想要在这波浪潮中立足,不仅需要掌握Python、TensorFlow/PyTorch等技术工具,更要深入理解目标行业的业务逻辑(如金融的风险控制、医疗的临床需求),成为“懂技术、懂业务”的复合型人才。
无论是技术研发岗(如算法工程师、研究员),还是业务落地岗(如产品经理、应用工程师),大模型都为不同背景的职场人提供了广阔的发展空间。只要保持学习热情,紧跟技术趋势,就能在AI大模型时代找到属于自己的职业新蓝海。
最近两年大模型发展很迅速,在理论研究方面得到很大的拓展,基础模型的能力也取得重大突破,大模型现在正在积极探索落地的方向,如果与各行各业结合起来是未来落地的一个重大研究方向
大模型应用工程师年包50w+属于中等水平,如果想要入门大模型,那现在正是最佳时机
2025年Agent的元年,2026年将会百花齐放,相应的应用将覆盖文本,视频,语音,图像等全模态
如果你对AI大模型入门感兴趣,那么你需要的话可以点击这里大模型重磅福利:入门进阶全套104G学习资源包免费分享!
扫描下方csdn官方合作二维码获取哦!

给大家推荐一个大模型应用学习路线
这个学习路线的具体内容如下:
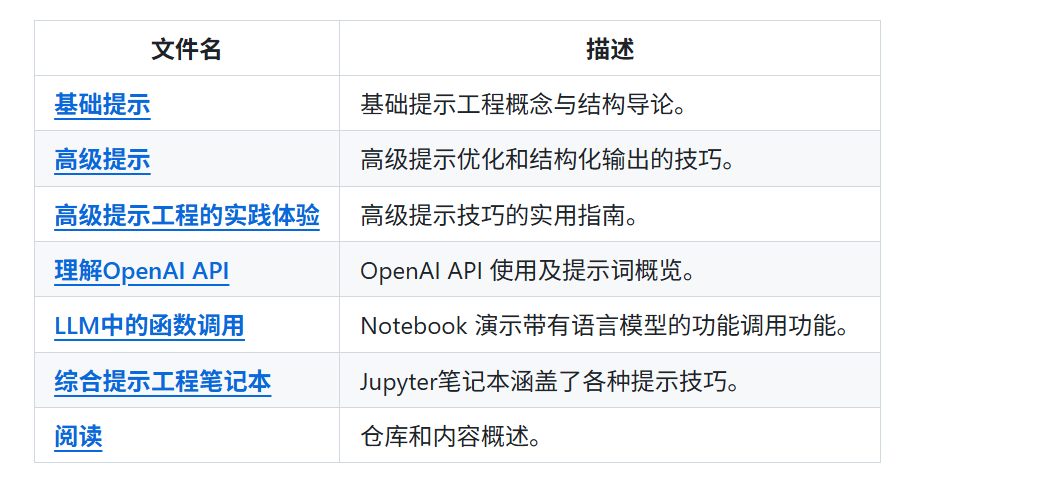
第一节:提示词工程
提示词是用于与AI模型沟通交流的,这一部分主要介绍基本概念和相应的实践,高级的提示词工程来实现模型最佳效果,以现实案例为基础进行案例讲解,在企业中除了微调之外,最喜欢的就是用提示词工程技术来实现模型性能的提升
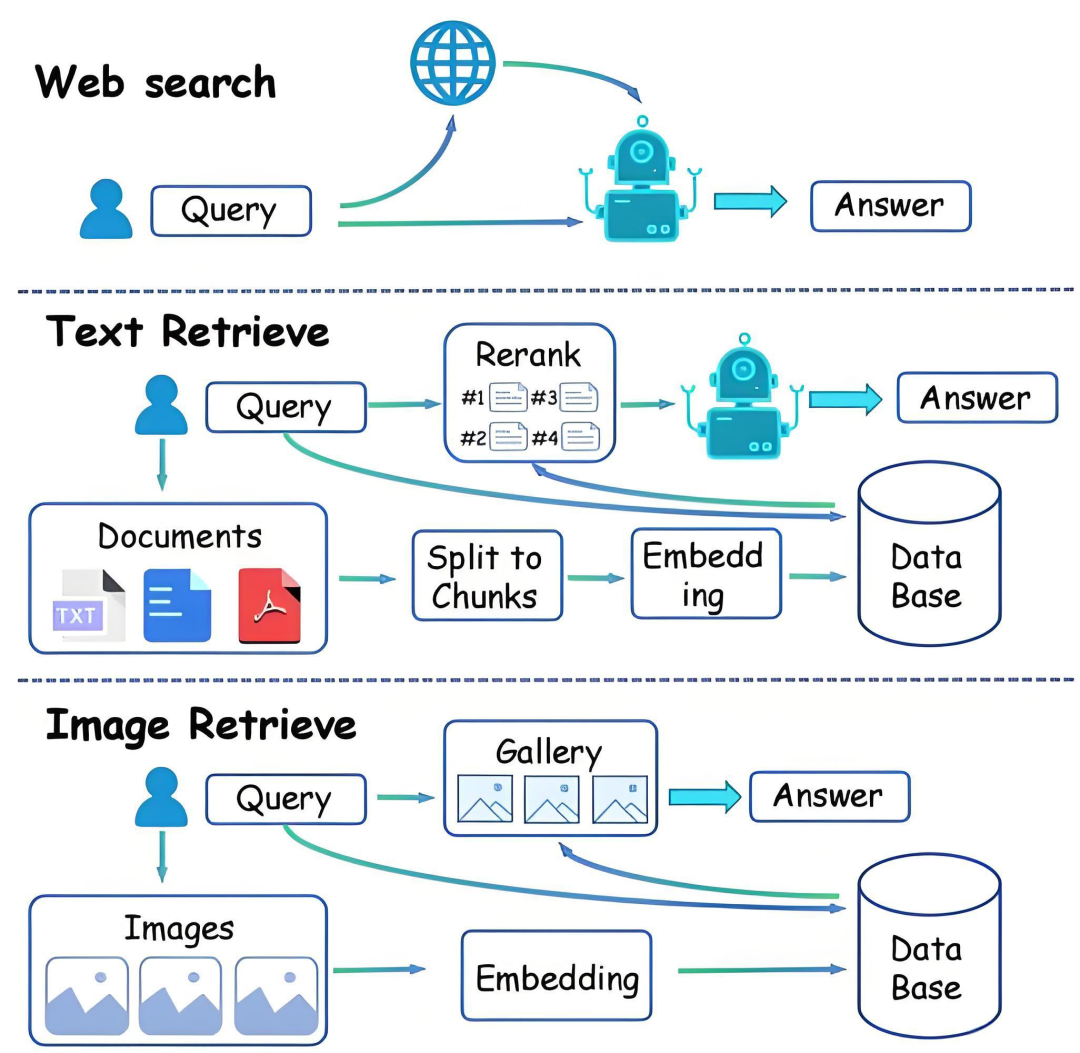
第二节:检索增强生成(RAG)
可能大家经常会看见RAG这个名词,这个就是将向量数据库与大模型结合的技术,通过外部知识来增强改进提升大模型的回答结果,这一部分主要介绍RAG架构与组件,从零开始搭建RAG系统,生成部署RAG,性能优化等
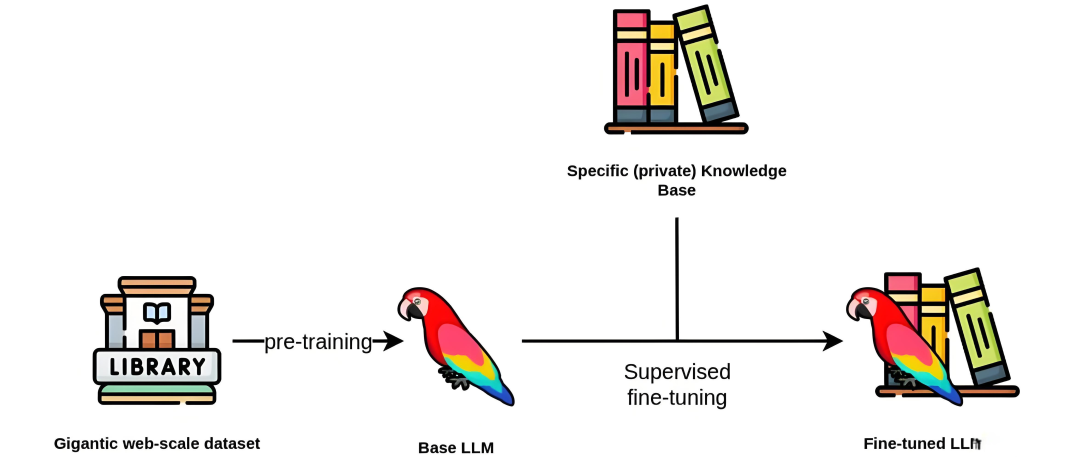
第三节:微调
预训练之后的模型想要在具体任务上进行适配,那就需要通过微调来提升模型的性能,能满足定制化的需求,这一部分主要介绍微调的基础,模型适配技术,最佳实践的案例,以及资源优化等内容
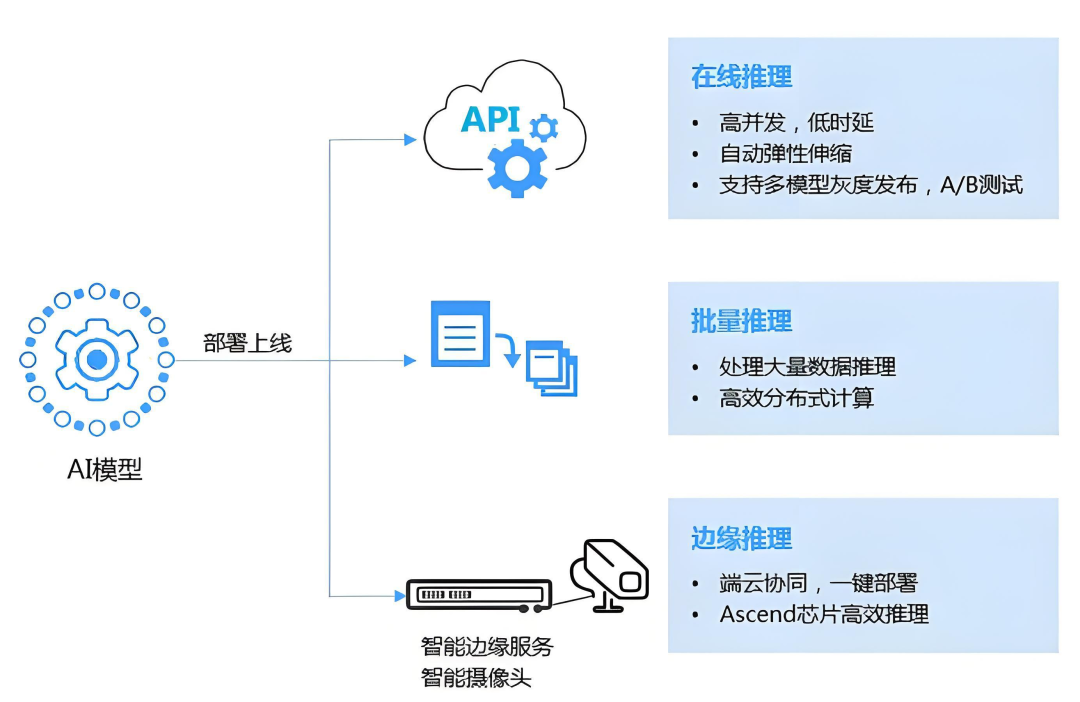
第四节:模型部署
想要把预训练或者微调之后的模型应用于生产实践,那就需要部署,模型部署分为云端部署和本地部署,部署的过程中需要考虑硬件支持,服务器性能,以及对性能进行优化,使用过程中的监控维护等
第五节:人工智能系统和项目
这一部分主要介绍自主人工智能系统,包括代理框架,决策框架,多智能体系统,以及实际应用,然后通过实践项目应用前面学习到的知识,包括端到端的实现,行业相关情景等
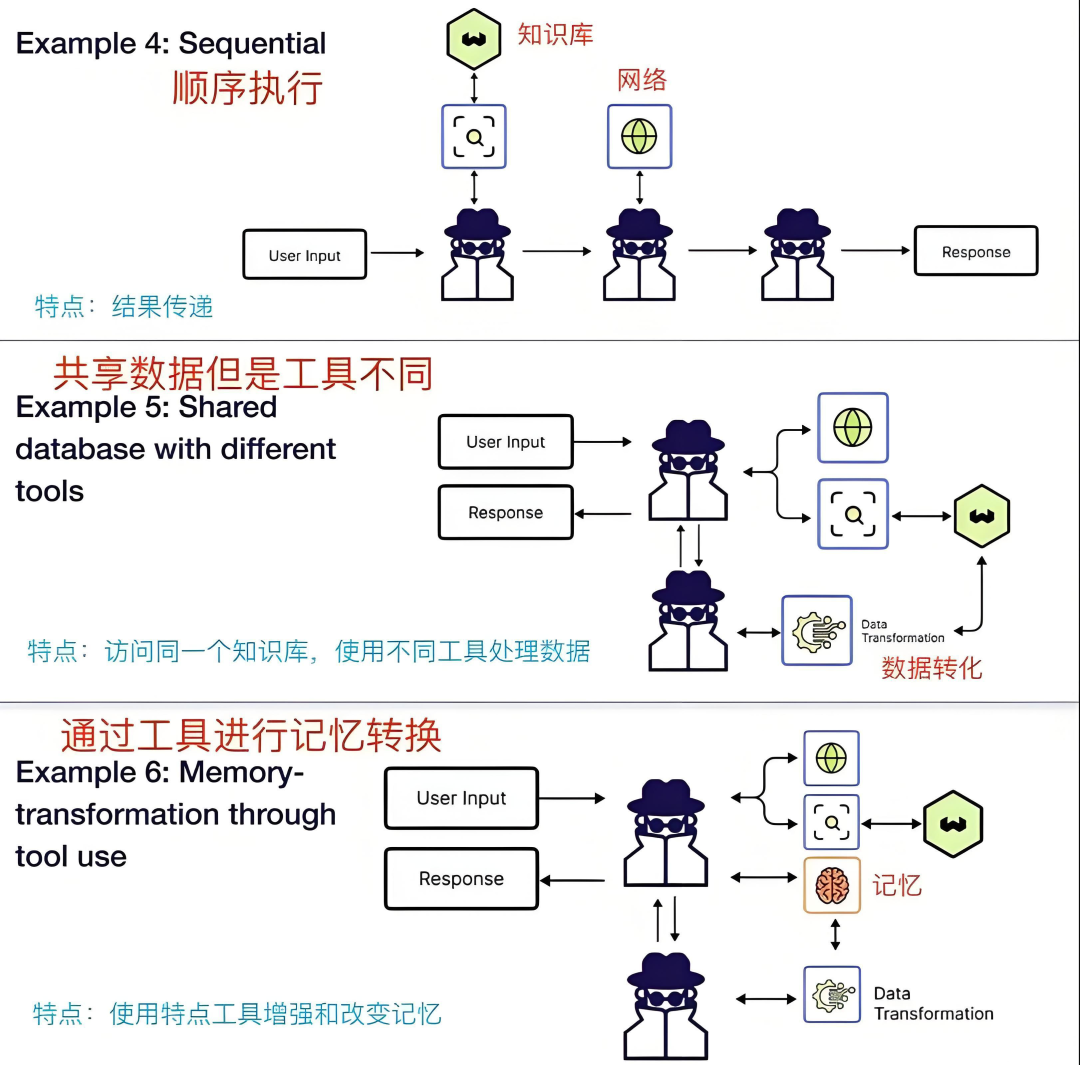
学完上面的大模型应用技术,就可以去做一些开源的项目,大模型领域现在非常注重项目的落地,后续可以学习一些Agent框架等内容
上面的资料做了一些整理,有需要的同学可以下方添加二维码获取(仅供学习使用)

 2878


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


