AWS携手vLLM推出Multi-LoRA,终结大模型微调算力浪费与高成本!

RTX AI PC 和工作站上部署多样化 AI 应用支持 Multi-LoRA LoRA 是一种热门的参数高效微调技术,可以调节少量参数。其他参数称为 LoRA 适配器,表示网络密集层中变化的低秩分解。只有这些低级别的附加适配器是自定义的,而在此过程中,模型的剩余参数会被冻结。经过训练后,这些适配器将在推理期间通过合并到基础模型进行部署,从而在推理延迟和吞吐量方面尽可能减少,甚至不增加任何开销。图 1. A 和 B 中的参数表示可训练的参数,以展示 LoRA 技术(来源:LoRA:大型语言模型的低阶适应图 1 展示了有关 LoRA 技术的更多详细信息。 阅读详情

本文重点介绍 AWS 联合 vLLM 社区推出的 Multi-LoRA 解决方案,专治大模型微调部署中“算力闲置率高、成本高昂”的痛点。

  • 针对 MoE(混合专家)模型叠加 LoRA 带来的“双重稀疏性”和内核计算复杂度,AWS 开发了融合算子 fused_moe_lora。
  • 通过引入 do_not_specialize 解决编译造成的首字延迟(TTFT)暴涨、使用 Split-K 与 CTA Swizzling 优化瘦高矩阵计算、以及利用 EVEN_K 跳过无效掩码检查,成功提升了系统的吞吐量(OTPS)。
  • 目前该技术已在 vLLM 0.15.0+ 中全面支持,开发者只需简单配置即可实现单 GPU 挂载多模型的极速推理。挂载方法见正文。

先说痛点

你们有没有遇到过这种情况:

公司有5个不同的微调模型(可能是不同业务场景、不同客户定制的),每个模型单独部署都只占用10%的GPU算力。

**结果:**5个GPU各自闲着90%的算力,钱包刺客拉满了。💸

以前没辙,现在 AWS 联合 vLLM 社区给出了解决方案:Multi-LoRA。

什么是 Multi-LoRA?

先回顾一下 LoRA 的基本原理 🔧

LoRA(Low-Rank Adaptation)不做全参数微调,而是:

  • 冻结原始权重 W(几百GB的基座模型不动)
  • 额外训练两个小矩阵 A 和 B
  • 推理时:输出 = xW + xAB

A 的shape:h_in × r(r通常是16-64)
B 的shape:r × h_out

💡 这样一份基座模型,可以同时挂载多个 LoRA 适配器。推理时动态切换,哪个请求用哪个适配器,GPU 共享!

**📌 想象一下:**5个客户每人只占用10%的GPU,现在可以拼单到1个GPU上跑。

⚠️ MoE + LoRA = 地狱难度

问题来了:如果是 MoE(混合专家)模型,那就更复杂了。

技术难点1:每个 Expert 需要4个 LoRA 操作

MoE 模型的每个 Expert 有两个投影:

  • **gate_up:**展开 hidden state(4096 → 11008 维)
  • **down:**压缩回去(11008 → 4096 维)

每个投影需要两个 LoRA 操作:

  • **shrink:**xA(高维 → 低维 r)
  • **expand:**xB(低维 r → 高维)

所以 每个 Expert 需要4个 LoRA kernel 操作,比普通模型复杂得多。

技术难点2:两 sparsity 叠加

MoE 本身就有 expert routing(路由选择哪些 expert 激活),现在又加了 adapter selection(请求用哪个 LoRA),两种稀疏性叠加,需要全新的内核设计。

📌 之前 vLLM 没有针对 MoE 的 LoRA 内核,现成的 dense multi-LoRA 内核根本搞不定 expert routing。

解决方案:fused_moe_lora kernel

AWS 团队自己写了个融合内核 fused_moe_lora,把 LoRA 操作直接融合进 MoE 的 forward 过程。

核心思路:

  • 复用 fused_moe 的逻辑
  • 增加一个维度:LoRA index
  • 一次 kernel 调用完成所有计算

但这只是开始,真正的坑在后面。

优化路上的三个大坑 🕳️

坑1:TTFT 暴涨 10 倍

优化前测试,Multi-LoRA 的 TTFT(首token延迟)比基线模型高了 10 倍。

用 NVIDIA Nsight 一查,好家伙:Triton 编译器把 输入长度相关的变量当成编译时常量,每次不同 context length 就重新编译一次。GPU 在那儿等着编译完才能跑,中间空转。

👉 **解决方案:**加 do_not_specialize 编译提示,告诉 Triton 别犯傻,一次编译到处复用。

坑2:矩阵太瘦,GPU 不会算

LoRA 的 shrink/expand 操作,矩阵维度是:1 × h_in 乘 h_in × r。

r 通常是 16-64,但 h_in 是 4096,差了 100-300 倍。标准 GEMM 内核是为接近方形的矩阵设计的,遇到这种瘦高矩阵直接摆烂。

👉 解决方案:

  • 💡 策略1:Split-K 切分求和策略
  • 💡 策略2:CTA Swizzling 提高缓存命中率

坑3:大量无意义的 Mask 检查

Triton 内核按固定块大小加载数据,但矩阵维度不一定能整除。

👉 **解决方案:**加个 EVEN_K 参数,能整除就跳过所有 masking 检查。

调参:隐藏的大Boss

内核写完了,还要调参。Triton 内核有大量超参:BLOCK_SIZE_M / N / K、GROUP_SIZE_M、SPLIT_K…

但默认配置是为标准 fused MoE 优化的,根本不管 LoRA 那多出来的维度。AWS 团队针对 MoE LoRA 场景专门调了一版参数,用在 SageMaker AI 和 Bedrock 上。

性能数据 📊

指标vLLM 0.11.1rc3vLLM 0.15.0AWS 优化版
OTPS-+454%+19%
TTFT--87%-8%

测试模型:GPT-OSS 20B(MoE),输入1600 tokens,输出600 tokens,LoRA rank=32,8个 adapter 并行。

📌 顺带一提,部分优化对 dense 模型也有效。Qwen3 32B 的 OTPS 提升了 99%。

总结一下

优化手段效果
do_not_specialize解决 10× TTFT 问题
Split-K + CTA Swizzling解决瘦矩阵计算效率
EVEN_K去掉无意义 masking
专用参数调优额外 19% OTPS 提升

现在 vLLM 0.15.0+ 已经支持 Multi-LoRA,MoE 模型包括:GPT-OSS、Qwen3-MoE、DeepSeek、Llama MoE。

💻 快速上手指南

既然最新版已经全面支持了,我们怎么在生产环境把它跑起来呢?非常简单,并且完全兼容 OpenAI 的 API 规范:

1. 启动 vLLM 服务

在启动基座模型时,只需要加上 --enable-lora 参数,并使用 --lora-modules 指定你要挂载的 LoRA 适配器及路径即可:

vllm serve Qwen/Qwen3-MoE-A2.7B-Instruct \
--enable-lora \
--lora-modules lora-customerA=/path/to/customerA_lora \
lora-customerB=/path/to/customerB_lora \
--max-loras 4

2. 客户端调用

服务启动后,在客户端发送请求时,只需将 model 参数替换为你想要使用的特定 LoRA 名称(例如 lora-customerA)。vLLM 底层会自动为你完成计算和路由,无需手动切换权重!

curl http://localhost:8000/v1/chat/completions \ -H "Content-Type: application/json" \
-d '{ "model": "lora-customerA", "messages": [ {"role": "user", "content": "你好,请根据客户A的特定业务场景回复我。"} ] }'

💡 核心收益: 只要并发的 LoRA 数量不超过配置的 --max-loras 限制,你就可以在同一个物理基座模型上,同时处理多个截然不同的微调任务。显存占用极小,计算效率起飞!🚀

01

什么是AI大模型应用开发工程师?

如果说AI大模型是蕴藏着巨大能量的“后台超级能力”,那么AI大模型应用开发工程师就是将这种能量转化为实用工具的执行者。

AI大模型应用开发工程师是基于AI大模型,设计开发落地业务的应用工程师。

这个职业的核心价值,在于打破技术与用户之间的壁垒,把普通人难以理解的算法逻辑、模型参数,转化为人人都能轻松操作的产品形态。

无论是日常写作时用到的AI文案生成器、修图软件里的智能美化功能,还是办公场景中的自动记账工具、会议记录用的语音转文字APP,这些看似简单的应用背后,都是应用开发工程师在默默搭建技术与需求之间的桥梁。

他们不追求创造全新的大模型,而是专注于让已有的大模型“听懂”业务需求,“学会”解决具体问题,最终形成可落地、可使用的产品。

优快云粉丝独家福利

给大家整理了一份AI大模型全套学习资料,这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
在这里插入图片描述

02

AI大模型应用开发工程师的核心职责

需求分析与拆解是工作的起点,也是确保开发不偏离方向的关键。

应用开发工程师需要直接对接业务方,深入理解其核心诉求——不仅要明确“要做什么”,更要厘清“为什么要做”以及“做到什么程度算合格”。

在此基础上,他们会将模糊的业务需求拆解为具体的技术任务,明确每个环节的执行标准,并评估技术实现的可行性,同时定义清晰的核心指标,为后续开发、测试提供依据。

这一步就像建筑前的图纸设计,若出现偏差,后续所有工作都可能白费。

技术选型与适配是衔接需求与开发的核心环节。

工程师需要根据业务场景的特点,选择合适的基础大模型、开发框架和工具——不同的业务对模型的响应速度、精度、成本要求不同,选型的合理性直接影响最终产品的表现。

同时,他们还要对行业相关数据进行预处理,通过提示词工程优化模型输出,或在必要时进行轻量化微调,让基础模型更好地适配具体业务。

此外,设计合理的上下文管理规则确保模型理解连贯需求,建立敏感信息过滤机制保障数据安全,也是这一环节的重要内容。

应用开发与对接则是将方案转化为产品的实操阶段。

工程师会利用选定的开发框架构建应用的核心功能,同时联动各类外部系统——比如将AI模型与企业现有的客户管理系统、数据存储系统打通,确保数据流转顺畅。

在这一过程中,他们还需要配合设计团队打磨前端交互界面,让技术功能以简洁易懂的方式呈现给用户,实现从技术方案到产品形态的转化。

测试与优化是保障产品质量的关键步骤。

工程师会开展全面的功能测试,找出并修复开发过程中出现的漏洞,同时针对模型的响应速度、稳定性等性能指标进行优化。

安全合规性也是测试的重点,需要确保应用符合数据保护、隐私安全等相关规定。

此外,他们还会收集用户反馈,通过调整模型参数、优化提示词等方式持续提升产品体验,让应用更贴合用户实际使用需求。

部署运维与迭代则贯穿产品的整个生命周期。

工程师会通过云服务器或私有服务器将应用部署上线,并实时监控运行状态,及时处理突发故障,确保应用稳定运行。

随着业务需求的变化,他们还需要对应用功能进行迭代更新,同时编写完善的开发文档和使用手册,为后续的维护和交接提供支持。

03

薪资情况与职业价值

市场对这一职业的高度认可,直接体现在薪资待遇上。

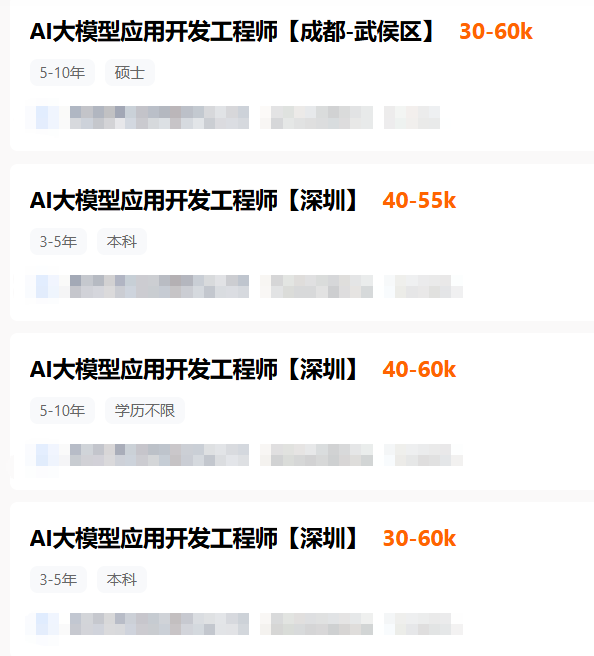
据猎聘最新在招岗位数据显示,AI大模型应用开发工程师的月薪最高可达60k。
图片

在AI技术加速落地的当下,这种“技术+业务”的复合型能力尤为稀缺,让该职业成为当下极具吸引力的就业选择。

AI大模型应用开发工程师是AI技术落地的关键桥梁。

他们用专业能力将抽象的技术转化为具体的产品,让大模型的价值真正渗透到各行各业。

随着AI场景化应用的不断深化,这一职业的重要性将更加凸显,也必将吸引更多人才投身其中,推动AI技术更好地服务于社会发展。

优快云粉丝独家福利

给大家整理了一份AI大模型全套学习资料,这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
在这里插入图片描述

MLoRA多LoRA协同实战:原理、路由选型与工程落地 大模型微调中,LoRA以低秩适配方式实现了高效的参数更新,成为主流选择。但面对多任务、多风格或持续学习场景时,单个LoRA难以兼顾,多个LoRA简单叠加又容易产生冲突。MLoRA(多LoRA协同/混合低秩适配)应运而生,它通过并行组合或门控路由统一编排多个低秩适配器,让不同任务共享底座、按需融合,兼顾效率与效果。本文从LoRA数学原理出发,梳理MLoRA的两种协同范式,并通过代码示例展示如何训练独立LoRA、运行时切换以及为LoRA添加路由器,同时剖析显存、耗时、精度等工程代价。适合已掌握LoRA、正在探索 阅读详情

相关推荐

大模型推理工具:vLLM的入门使用

vLLM是一个快速且易于使用的LLM推理和服务库。最先进的服务吞吐量使用PagedNote有效管理注意力键和值内存传入请求的连续批处理使用CUDA/HIP图快速执行模型量化:GPTQ、AWQ、SqueezeLLM、FP8 KV缓存优化的CUDA内核与流行的拥抱脸模型无缝集成高吞吐量服务于各种解码算法,包括并行采样、波束搜索等分布式推理的张量并行性支持流式输出与OpenAI兼容的API服务器支持NVIDIA GPU和AMD GPU(实验性)前缀缓存支持。

2401_84215165的博客 2万+

AI大模型底层技术——Multi-LoRA Combination Methods

"Multi-LoRA Combination Methods" 指的是在 LoRA (Low-Rank Adaptation) 微调的基础上,使用多个 LoRA 模块,并通过特定的方法将它们组合起来,以适应多任务学习、领域自适应或模型个性化等场景的技术。与传统的 LoRA 方法只使用单个 LoRA 模块不同,"Multi-LoRA Combination Methods" 能够利用多个 LoRA 模块的优势,实现更灵活、更强大的模型微调。

Arthur Guo 的专栏 1774

保姆级教程:用TI IWR6843雷达板跑通3D人体追踪demo(附CCS/UniFlash避坑指南)

本文提供了一份详尽的TI IWR6843毫米波雷达开发板3D人体追踪demo实现指南,涵盖开发环境搭建、工程导入编译、固件烧录及可视化工具配置全流程。特别针对CCS和UniFlash使用中的常见问题给出解决方案,帮助开发者快速掌握3D People Tracking技术应用。

weixin_29159441的博客 504

Multi-LoRA Composition | 无需训练的任意LoRA组合

推出 LoRA Switch 和 LoRA Composite,这些方法旨在在准确性和图像质量方面超越传统技术,尤其是在复杂的构图中。提出的多LoRA组合方法(LORA SWITCH和LORA COMPOSITE)可以应用于多种图像生成场景,尤其是在需要精确控制和组合多个视觉元素的情况下。这些应用场景展示了多LoRA组合方法在图像生成领域的广泛潜力,尤其是在需要高度定制化和创意表达的场合。这两种方法分别是LORA SWITCH和LORA COMPOSITE,它们都是在解码过程中应用的,

具身机器人和通用AI 1341

Polars简明基础教程一:Polars快速入门

在这个例子中,我们将添加一个列,其中包含每个舱位中乘客的最大年龄。在Python中(而不是特指Polars),当我们将代码包裹在括号中时,我们可以在新行上调用一个新方法——在这种情况下是select。在这里,我们看到一个使用表达式API的简单示例,其中我们在select语句中选择Pclass、Name和Age列(我们将在第3节中深入了解select语句)。表达式是一个函数,它接受一个Series(或DataFrame中的列)作为输入,并返回一个Series(或DataFrame中的列)。

sosogod的博客 3879

电机控制必看!SVPWM谐波优化:5段式与7段式全参数对比测试

本文通过实测数据,对比分析了电机控制中5段式与7段式SVPWM控制算法的谐波性能。实验表明,7段式SVPWM在电流波形质量(THD)和低速性能上更优,而5段式SVPWM则在开关损耗和效率方面表现突出。文章为工程师在不同应用场景(如对噪音、效率或动态响应的侧重)下的算法选型提供了清晰的依据和实用的工程指南。

weixin_28331555的博客 178

(2024,动态 LoRA,LoRA Switch,LoRA Composite,组合图像生成)用于图像生成的多 LoRA 组合

现有方法在组合多个 LoRA 时面临挑战。为此,本文提出了两种无需训练的方法:LoRA Switch,它在每个去噪步骤中在不同的 LoRA 之间交替,以及 LoRA Composite,它同时整合所有 LoRA 以引导更一致的图像合成。

qq_44681809的博客 1997

实战:如何用MIPI CSI-2高效传输RAW10图像数据(附带宽优化技巧)

本文深入探讨了MIPI CSI-2协议在RAW10图像数据传输中的高效应用,详细解析了4像素5字节打包机制及其带宽优化技巧。通过动态Lane分配、位深度自适应压缩和虚拟通道交错传输等实战方法,显著提升传输效率,适用于IoT摄像头开发等低功耗场景。

css33的专栏 732

m-LoRA:如何在单GPU上高效微调数十个大语言模型

作者: qiqi,mike,maomao单位: 四川大学 KDE Lab来自:AINLP快来!NLP论文投稿、LLM交流、论文直播群大型语言模型(LLM)对现代应用产生了显著影响,应用领域从自然语言处理拓展到包括OpenAI的Chatgpt及微调的LLM在内的更多特定领域任务。通常LLM先在大数据集上预训练,再根据具体应用进行微调。然而,传统微调方法成本高昂,涉及更新所有预训练参数。LoRA技术通...

zenRRan的博客 829

133、神经渲染与AI RAW:从RAW域到sRGB的端到端学习

去年在调试某款旗舰手机的主摄时,遇到一个让人头疼的问题——夜景模式下,暗部细节虽然保留得不错,但色彩总是偏紫,而且高光边缘有诡异的“水彩感”。ISP的3A统计跑了几十版,降噪强度从0调到100,甚至把去马赛克算法换成了自适应方向插值,问题依旧。后来团队里一位做AI的同事说:“要不试试端到端?从RAW直接出sRGB。”当时我第一反应是“这玩意儿能稳定吗?”结果试了一版,偏紫消失了,高光边缘的伪影也没了。从那以后,我开始认真研究神经渲染与AI RAW这条路线。

sundong_81的博客 33

23 中望CAD二次开发(ZRX C++)-自定义实体(二)

本文详细介绍了自定义图形实体,如何实现几何变换、捕捉、节点编辑,并介绍了CAD代理的概念。

cilvsuanna的博客 437

【收藏必备】从LoRA到Multi-LoRA:原理深度解析+代码实战指南

本文探讨了从单场景LoRA到多场景Multi-LoRA的技术发展路径。通过分析qLoRA、DoRA等LoRA变体的原理差异,指出同类型LoRA适配器可混合部署。重点介绍了Multi-LoRA方案,其通过共享基础模型实现多业务场景适配,显著提升GPU资源利用率。文中以MNIST手写数字识别为例,演示了Multi-LoRA的训练实践流程:先训练基础模型,再冻结参数并分别微调不同数字的适配器,最后测试验证各适配器的识别效果差异。该方案为多任务AI模型部署提供了高效解决方案。

优快云_430422的博客 515

YOLOv13添加轻量化的EMA模块Faster_EMA,轻量又涨点!map50提升4.56个点,召回率提升9.66!

本文介绍了YOLOv13模型的优化移植方法,通过添加Faster_EMA模块和超参数调整,使模型性能显著提升。主要修改包括:1) 创建新的模型配置文件yolov13-Faster_EMA.yaml;2) 在tasks.py中添加新模块;3) 修改__init__.py和block.py文件,新增Partial_conv3和DropPath类。优化后模型mAP50提升4.56%,召回率提升9.66%,验证了改进方案的有效性。代码实现了局部卷积和随机深度等先进技术,为YOLO系列模型性能优化提供了新思路。

FJN110的博客 2605

探索多模态智能:Multi-LoRAs - 搭建更强大、更灵活的预训练模型

探索多模态智能:Multi-LoRAs - 搭建更强大、更灵活的预训练模型 在人工智能领域,预训练模型的进步正在不断推动着自然语言处理的边界。而Multi-LoRAs,这个创新的工具包,为我们提供了一种全新的方式来融合和利用多个LoRA(低秩自适应)模块,以实现根据不同查询自动选择最佳答案的能力。它不仅简化了从高效参数微调模型中提取LoRA模块的过程,还包含了将这些模块集成到基础模型中的工具以及一...

gitblog_00061的博客 711

【Windows Server 2019】企业虚拟专用网络服务的配置和管理(上)

博文介绍了部署企业虚拟专用网的定义,目的,以及好处。同时说明了实验拓扑图以及虚拟专用网络的工作原理。

VMware, Windows, Linux, Cisco, Container, Kubernetes, Kali 1万+

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

单GPU实现LLM多LoRA微调

基于transformer的LLM在不同领域表现出出色的性能,特别是针对特定领域进行微调时。微调LLM所需的资源可以通过低秩自适应(LoRA)等高效参数微调方法来节省。虽然LoRA有效减少了计算负担和资源需求,但它目前仅支持单作业微调。本文提出了ASPEN,一个高吞吐量的LLM微调框架,其利用共享的预训练模型和自适应调度,使用LoRA在单个GPU上有效地训练多个作业。实验表明,ASPEN在。

具身机器人和通用AI 1239

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

**mLoRA:多路低秩适应器的高效工厂**

mLoRA:多路低秩适应器的高效工厂 在当今人工智能领域,对大型语言模型(LLM)的微调已成为不可或缺的一环,特别是在个性化定制和场景适应方面。然而,传统的微调策略往往资源消耗巨大,尤其当需为不同任务创建多个适应器时。正是在这种背景下,mLoRA——一个旨在高效构建多个LoRA适配器的开源框架,应运而生。 项目介绍 mLoRA(即Multi-LoRA Fine-Tune),是一个基于Python环...

gitblog_00085的博客 1118

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

微软AI文生图新突破,用于图像生成的多LoRA组合训练模型Multi-LoRA-Composition

通过引入LoRA技术、采用免训练方法以及提出基于GPT-4V的评估工具,他们成功地创造出了高度个性化且细节丰富的图像。微软近期在文本至图像生成领域取得了一项重要突破,通过引入多重低秩适应(LoRA)技术,成功地创造出了高度个性化和细节丰富的图像。这一研究不仅为我们带来了全新的图像生成方法,还为我们提供了一种基于GPT-4V的图像质量评估工具。通过该平台,研究人员可以对基于LoRA的可组合图像生成任务进行定量评估,从而更加客观地评价生成图像的质量。与传统的需要微调的方法不同,这项研究采用了免训练的方法。

heehelcom的博客 1578

【vllm多LORA部署】

要在使用vllm serve命令时调用特定的 LoRA 模块(如lora1和lora2),您需要在启动服务器时通过参数指定每个 LoRA 模块的名称和路径。使用vllm serve命令启动服务器,并添加参数以启用 LoRA 支持。然后,使用参数指定每个 LoRA 模块的名称和路径。请将和替换为您的 LoRA 模块的实际路径。启动服务器后,您可以通过发送 API 请求来调用特定的 LoRA 模块。在请求中,您可以通过model参数指定要使用的 LoRA 模块。例如,如果您想要调用lora1。

一休 6288

多LoRA适配器的原理、方法、实现及优势

虽然vLLM框架支持同时加载多个适配器,但它通过高效的内存管理机制,确保这些适配器在内存中的占用最小化。LoRA适配器通过低秩矩阵分解技术,只对预训练模型的部分参数进行微调,而不是对整个模型进行完整的微调。这种方法显著减少了微调所需的计算资源和时间。例如,通过微调适配器,可以使模型在特定类型的问题上表现得更好。如果你的应用需要高效、快速的响应,且可以通过微调模型来显著提升特定任务的性能,LoRA适配器可能更合适。如果你的应用需要实时访问和使用最新的外部信息,或者需要处理大量背景知识,RAG方法可能更适合。

具身机器人和通用AI 935

推荐文章:m-LoRA,开启高效大模型微调新纪元

推荐文章:m-LoRA,开启高效大模型微调新纪元 在当下人工智能的浪潮中,大型语言模型(LLMs)正扮演着越来越关键的角色。然而,如何有效地对这些庞然大物进行微调,以适应特定场景的需求,成为了一个挑战。今天,我们要向您隆重推荐一款开源神器——m-LoRA:多路LoRA优化下的大规模语言模型微调框架,它将改变这一格局。 项目介绍 m-LoRA是一个旨在提升LLMs微调效率的开源工具包,通过巧妙运用高...

gitblog_00084的博客 655

【大模型】一个基座模型部署多个lora

vllm推出了一个很棒的功能,可以分别加载base模型和lora层,并且可以加载多个lora层,通过指定lora层名字确定到底调用哪一个。这种特性是非常有价值的:同时加载N套微调参数,这样做不会影响大模型原有能力,通过选择微调层可以提供给用户不同的专项微调能力,而且可以实现权限管控,防止敏感信息泄露,此外更多新微调能力的接入也非常方便。这对GPU的消耗也太高了吧!一种很直接的思路是,将多个微调任务整合起来,一次性lora微调多个任务,这样就只需要部署一个微调模型了。

己亥孟陬 4014

Multi-LoRAs 项目使用教程

Multi-LoRAs 项目使用教程 1. 项目的目录结构及介绍 Multi-LoRAs 项目的目录结构如下: multi_loras/ ├── LICENSE ├── Makefile ├── README.md ├── setup.py ├── multi_loras/ │ ├── __init__.py │ ├── extract_lora.py │ ├── merge_lora...

gitblog_00163的博客 975

vllm加载多个Lora部署

本文介绍了如何利用vLLM框架实现高效的大模型微调部署方案。通过只加载基座模型(Qwen2.5-72B-Instruct)并动态加载不同微调权重(LoRA适配器),显著降低了多模型部署的资源消耗。文章提供了Python实现代码,展示了如何创建聊天对话、加载基座模型、以及分别使用不同LoRA适配器进行文本生成的方法。这种方案支持在单一基座模型上切换多个微调版本(如v1/v2),同时保留原始模型生成能力,为大规模语言模型部署提供了灵活高效的解决方案。

qq_43318374的博客 856

使用vLLM在一个基座模型上部署多个lora适配器

使用LoRA适配器,可以将LLM专门化用于特定的任务或域。这些适配器需要加载在LLM之上进行推理。vLLM可以同时为多个适配器提供服务,而不会出现明显的延迟,从而允许无缝使用多个LoRA适配器。最后需要注意的是,如果你在使用bitsandbytes(即使用QLoRA)量化的模型之上对适配器进行微调,则在启动vLLM时需要使用bitsandbytes量化模型。理论上,vLLM在量化模型之上支持bitsandbytes和加载适配器。

deephub 6109
上一篇: AI大模型将迎来智能体爆发时代?2026-2030年布局指南,速看!
下一篇: AI大模型的前十岗位薪资,谁还说读书没用?大模型零基础入门到精通非常详细
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值