大模型微调新思路:强化学习(RFT)如何让AI更懂你?速看!

LLM 算法工程师的速成指南:微调、强化学习微调与偏好微调 **①强化学习微调(Reinforcement Fine-Tuning):** 仅需少量高质量数据(数十到数千个),模型即可通过强化学习处理复杂任务。 **②偏好微调 (Preference Fine-Tuning, PFT) :** 采用直接偏好优化 (例如Direct Preference Optimization, DPO) 算法,通过比较不同的模型输出,让 AI 能够学习并区分 “更好” 的回复,从而在语气、风格、创造性等主观性任务上表现更出色。 阅读详情

本文介绍了强化学习微调(RFT)在大模型中的应用,阐述了其训练过程演进及与SFT的对比。RFT通过奖励机制优化模型,使其更符合人类偏好。文章详细解析了RFT的适用场景、奖励模型以及PPO、DPO、GRPO等优化算法,并以GSM8K数据集为例,展示了GRPO的实操步骤。通过RFT,大模型在推理、结构化输出等方面表现更优,助力AI智能化提升。


大模型的强化学习微调

一. RT强化学习

1.1 训练过程的演进
  • • 第一阶段:self-supervised Learning,这里我们可以理解为基座大模型,输入:人工智,输出:慧
  • • 第二阶段:supervised Learning,这里就是SFT,输入:你是谁?输出:我
  • • 第三阶段:Reinforcement Learning, 强化学习,输入:世界上最高的山是?输出:喜马拉雅山(而不是输出 我不知道)
1.2 什么是RFT

RFT:reinforcement fine-tuning是强化学习微调。就是在已经预训练好的大模型基础上,用 “奖励机制” 再训练一遍,让模型越来越会做你想要它做的事。

  • • Fine-tuning:微调,在已经训练好的模型上,用少量数据再训练,让模型更贴合你的任务
  • • Reinforcement:强化学习,给模型回答的结果进行打分,进行奖励/惩罚

这里使用李宏毅老师的讲解RF的ppt,我们就能很直观的了解RF是什么了

1.3 为什么LLM需要RFT

对于LLM来说,什么样的输出才能算 “好文本”呢:它不仅仅关乎语法或事实,还关乎人类的品味、思路的连贯性、推理的正确性、消除输出中不必要的偏见等等。

因此我们需要强化学习来帮忙LLM来适应 符合人类的偏好:

  • • **人类来评判LLM,而非公式:**人类成为我们的“奖励函数”。
  • • **学习人类的喜好:**我们训练 LLM 生成人类更可能喜欢的文本。
1.4 RFT和SFT的对比
RFTSFT
训练量级少于10010w以上
训练时间更快漫长
模型学习基于正反case进行迭代对于输入和输出的关联进行记忆
类比教会了AI如何去思考+行为用信息数据填充AI的脑子里面
1.5 什么场景适用于RFT
  • • 没有标签数据:可以通过自己定义的验证代码来判别输出结果的正确性
  • • 只有少量的标签数据:没有足够的量级支持SFT
  • • 需要COT来提升模型表现:RFT能让COT的过程控制变短,从而提升模型推理速度
  • • 需要多个步骤的逻辑推理:当需要模型需要一步一步进行决策的时候,而不是简单的直接映射关系,RFT更适合
  • • 更快速的进行模型的迭代:以更快的速度,更短时间进行模型的实时迭代
1.6 Function Call中RF的应用

如果大家在项目中经常使用function call或者需要将大模型输出的结果进行二次解析的话,经常就会遇到一个很蛋疼的问题,那就是 明明提示词写的就是让LLM输出 指定的json结构的返回结果,但是往往 LLM 最终输出的都是非结构化的数据。

因此我们可以利用RF对模型进行训练,专门强化输出结构化的推理结果。

二. RT的演进

2.1 奖励模型

为什么需要奖励模型?

我们不能让人类在LLM的训练过程中对每个次训练迭代的输出结果进行评判,那样会太慢了,因此我们需要训练一个奖励模型——一个学习模仿人类偏好的AI评判模型:

  • • **奖励模型 = AI 口味测试员:**我们使用人类偏好数据对其进行训练。它会学习给人类倾向于喜欢的文本赋予更高的分数。
  • • **强化学习算法使用奖励模型:**诸如 PPO、DPO 和 GRPO 之类的算法使用这种奖励模型来指导语言学习模型 (LLM) 的学习。LLM 尝试生成能够获得 AI 评委高分的文本。
2.2 PPO

PPO论文:https://arxiv.org/abs/1707.06347

InstructGPT论文:https://arxiv.org/abs/2203.02155

这个是OpenAI在17年提出的近端策略优化 (PPO),到22年OpenAI提出了InstructGPT之后,将 PPO 提升到了一个全新的高度。这篇论文展示了如何利用 PPO 根据人类偏好来微调大规模语言模型(例如 GPT-3)。InstructGPT 不再仅仅是预测下一个词,而是学会了生成人类真正喜欢的文本——既有帮助又无害的文本。

以下是PPO训练的步骤:

  • • 生成文本:LLM通过不同提示词来生成推理的文本
  • • 奖励模型对生成的文本进行评分。
  • • 利用广义优势估计 (GAE)来计算优势:它会考虑多个词的奖励,平衡方差(MC)和偏差(TD)之间的权衡。这就像不仅在最后给予奖励,而且在过程中也会对表现良好的“小步骤”给予奖励,能计算每个词选择的提升幅度。
  • • KL散度的惩罚:新旧结果的差异很大,会施加惩罚,从而增强稳定性。
  • • 更新价值函数:训练价值函数,使其准确地预测不同文本生成的“好坏”。
2.3 DPO

DPO论文地址:https://arxiv.org/abs/2305.18290

这是斯坦福大学在24年7月发布的直接偏好优化 Direct Preference Optimization(DPO):

  • • 直接:DPO 就像直接告诉 LLM:“ A 比 B 好。多像 A,少像 B!”它省去了策略更新步骤中的中间环节(强化学习中用于策略优化的奖励模型)。
  • • 不需要迭代循环:利用类似分类的损失——直接使用logits损失函数,该函数直接比较两个模型的概率 ,直接基于人类偏好数据优化 LLM

2.4 GRPO

GRPO论文:https://arxiv.org/pdf/2402.03300

这个是DeepSeek在24年8月发布的强化学习的方式:Group Relative Policy Optimization(GRPO)。GRPO基于PPO,旨在简化RLHF训练流程,使其速度更快,尤其适用于复杂的推理任务。

  • • 去掉了PPO的Value Model:更加轻量高效
  • • 核心Group Relative Policy Optimization:不再通过分组分数来估算基线,从而显著减少训练资源消耗。使用一组由 LLM 生成的针对同一提示的回答,来评估每个回答相对于组内其他回答的“优劣” 。

三. 基于GSM8K数据集的GRPO的实操

3.1 数据准备

这里用推荐的GSM8K数学问答的数据集

from datasets import load_datasetdefextract_hash_answer(text):    """Extract numerical answer from GSM8K format (#### marker)"""    if"####"notin text:        returnNone    return text.split("####")[1].strip()defprocess_dataset_example(example):    """Convert GSM8K example to conversation format for GRPO training"""    question = example["question"]    answer = extract_hash_answer(example["answer"])    prompt = [        {"role": "system", "content": system_prompt},        {"role": "user", "content": question},    ]    return {        "prompt": prompt,  # Input conversation        "answer": answer,  # Ground truth for reward functions    }defload():    dataset = load_dataset("openai/gsm8k", "main", split="train")    # Apply conversation formatting to all examples    dataset = dataset.map(process_dataset_example)    return dataset
3.2 定义奖励机制

实施四种互补的奖励函数来评估数学推理的不同方面:

    1. 格式完全匹配:结构完全一致
    1. 近似匹配:格式元素部分得分
    1. 答案正确性:数学准确性,分级评分
    1. 数字提取:解析和输出数值结果的能力

这里举其中第一个例子

def match_format_exactly(completions, **kwargs):    """    完美遵守格式可获得高额奖励(3.0)    确保模型学习完整的结构化输出模式    """    scores = []    for completion in completions:        response = completion[0]["content"]        # Check if response matches complete format pattern        score = 3.0 if match_format.search(response) is not None else 0.0        scores.append(score)    return scores
3.3 训练

训练过程其实和sft很类似,都是基于lora进行训练,但是唯一差别就是定义了reward function

# Configure GRPO training parameters for mathematical reasoningtraining_args = GRPOConfig(    learning_rate=5e-6,    per_device_train_batch_size=2,    gradient_accumulation_steps=8,    max_prompt_length=1024,     max_completion_length=1024,    max_steps=10,     logging_steps=1,     output_dir="./trl_grpo_outputs",    max_grad_norm=0.1,)trainer = GRPOTrainer(    model=model,          reward_funcs=[                           match_format_exactly,           ],    args=training_args,                   train_dataset=dataset,            )

2026年AI行业最大的机会,毫无疑问就在应用层!

字节跳动已有7个团队全速布局Agent

大模型岗位暴增69%,年薪破百万!

腾讯、京东、百度开放招聘技术岗,80%与AI相关……

如今,超过60%的企业都在推进AI产品落地,而真正能交付项目的 大模型应用开发工程师 **,**却极度稀缺!

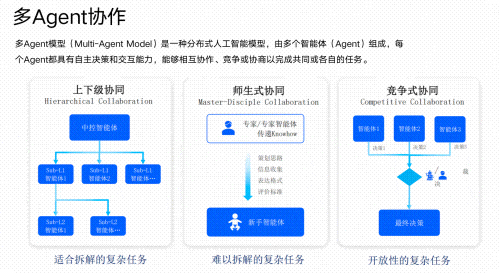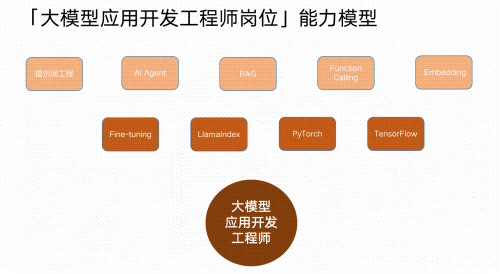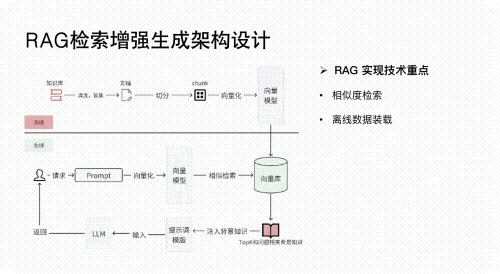
落地AI应用绝对不是写几个prompt,调几个API就能搞定的,企业真正需要的,是能搞定这三项核心能力的人:

✅RAG:融入外部信息,修正模型输出,给模型装靠谱大脑

✅Agent智能体:让AI自主干活,通过工具调用(Tools)环境交互,多步推理完成复杂任务。比如做智能客服等等……

✅微调:针对特定任务优化,让模型适配业务

目前,脉脉上有超过1000家企业发布大模型相关岗位,人工智能岗平均月薪7.8w!实习生日薪高达4000!远超其他行业收入水平!

技术的稀缺性,才是你「值钱」的关键!

具备AI能力的程序员,比传统开发高出不止一截!有的人早就转行AI方向,拿到百万年薪!👇🏻👇🏻
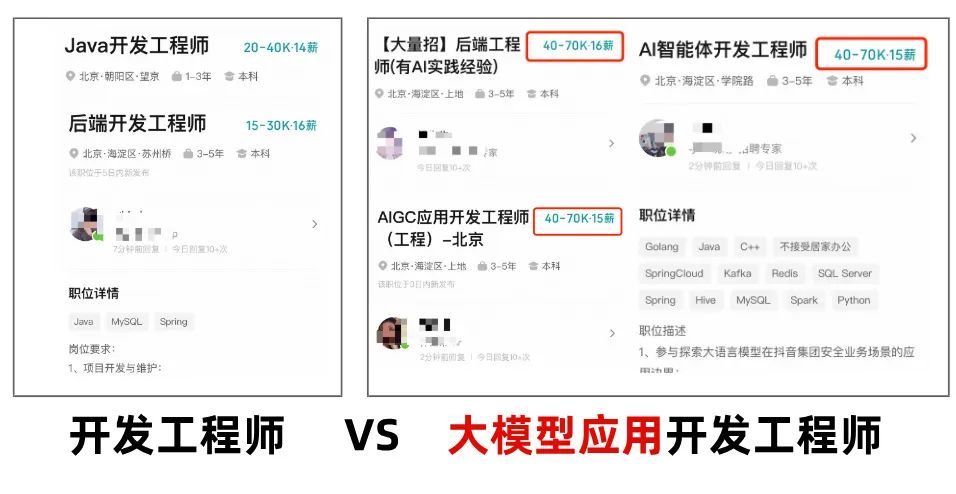
图片

AI浪潮,正在重构程序员的核心竞争力!现在入场,仍是最佳时机!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

⭐️从大模型微调到AI Agent智能体搭建

剖析AI技术的应用场景,用实战经验落地AI技术。从GPT到最火的开源模型,让你从容面对AI技术革新!

大模型微调

  • 掌握主流大模型(如DeepSeek、Qwen等)的微调技术,针对特定场景优化模型性能。

  • 学习如何利用领域数据(如制造、医药、金融等)进行模型定制,提升任务准确性和效率。

RAG应用开发

  • 深入理解检索增强生成(Retrieval-Augmented Generation, RAG)技术,构建高效的知识检索与生成系统。
  • 应用于垂类场景(如法律文档分析、医疗诊断辅助、金融报告生成等),实现精准信息提取与内容生成。

AI Agent智能体搭建

  • 学习如何设计和开发AI Agent,实现多任务协同、自主决策和复杂问题解决。
  • 构建垂类场景下的智能助手(如制造业中的设备故障诊断Agent、金融领域的投资分析Agent等)。
图片

如果你也有以下诉求:

快速链接产品/业务团队,参与前沿项目

构建技术壁垒,从竞争者中脱颖而出

避开35岁裁员危险期,顺利拿下高薪岗

迭代技术水平,延长未来20年的新职业发展!

……

那这节课你一定要来听!

因为,留给普通程序员的时间真的不多了!

立即扫码,即可免费预约

「AI技术原理 + 实战应用 + 职业发展」

「大模型应用开发实战公开课」

👇👇

在这里插入图片描述

👍🏻还有靠谱的内推机会+直聘权益!!

完课后赠送:大模型应用案例集、AI商业落地白皮书

大模型训练方法全面解析:SFT、RFT、TRPO、DPO、PPO、GRPO、RLH、RLHF技术深度剖析 大模型训练方法全面解析 本文系统介绍了当前主流的大模型训练和对齐技术,包括监督微调(SFT)、拒绝采样微调(RFT)、信任域策略优化(TRPO)、直接偏好优化(DPO)、近端策略优化(PPO)等。这些方法各有特点:SFT简单高效但数据依赖性强;RFT通过质量筛选提升输出质量;TRPO训练稳定但计算复杂;PPO是RLHF核心算法,平衡探索与利用。文章详细分析了各方法的实现原理、优势劣势及适用场景,为开发者选择合适的大模型训练策略提供参考。 阅读详情

相关推荐

大模型训练方式:SFT、RLHF、DPO、SimPO、RFT之间的对比

摘要: 本文对比分析了SFT(监督微调)、RLHF(基于人类反馈的强化学习)、DPO(直接偏好优化)、SimPO(模拟偏好优化)和RFT(强化微调)五种模型训练方法。SFT通过标注数据微调模型,简单快速但依赖高质量数据;RLHF结合人类反馈优化输出质量,但成本高;DPO直接利用偏好数据优化,计算效率高;SimPO通过模拟数据降低收集成本;RFT自动化评估优化,灵活性不足。选择方法需权衡任务需求(如通用适配、高质量输出、低成本或自动化)与资源条件。

gzgenius的博客 1627

RLHF强化学习微调LLM

强化学习

一千零一夜的博客 1116

OpenAI Agent RFT:如何利用强化学习微调,打造兼具效率与智能的超级AI工具体

摘要:AgentRFT(智能体强化学习微调)是OpenAI推出的关键技术,通过在生产工作流中直接探索和学习,显著提升智能体在特定业务场景中的性能与效率。其核心突破在于训练期间允许模型调用工具并与环境互动,实现端到端学习。实验数据显示,AgentRFT能减少工具调用次数(如FinQA案例从6.9次降至4.2次)、降低延迟(约10%)并提升推理效率。该技术在金融分析、医疗诊断等领域展现出强大通用性,即使数据稀缺(如100个样本)也能实现性能飞跃。但需警惕"奖励欺骗"问题,需设计鲁棒的自定义评

老孙 | Ethan Sun 的博客:AI 智能体与 AI 原生软件的工程实践 836

SFT与RFT大模型微调全对比:一篇读懂两种核心优化技术!

SFT(监督微调)和RFT(强化学习微调)是优化大型语言模型(LLMs)的两种核心技术,它们在理念、实现方式和适用场景上有着显著区别。

2401_85343303的博客 1192

Visual-RFT:视觉强化微调

这篇论文提出了一种全新的多模态模型微调范式,名为视觉强化微调(Visual-RFT)。它将语言模型中已有的强化微调(RFT)方法,首次拓展到了视觉任务上。论文的核心思想是:通过设计可验证的奖励函数(如分类是否正确、检测框与真实框的IoU和置信度等),用强化学习算法(特别是GRPO)来优化大型视觉语言模型(LVLMs),从而在少样本甚至极少样本场景下,实现对图像分类、物体检测、推理定位、开放词汇检测等任务的显著提升。与传统的监督微调(SFT)相比,Visual-RFT不仅更数据高效,而且更能促使模型“理解”任

lemonzjk的博客 1408

(超全面,超基础)Kriging插值推导理论笔记,算法,普通克里金

最近老师让我再重新推导一下克里金插值的方法如何求出预测结果,于是我又无数次地打开了大神的推导原理过程链接????:克里金(Kriging)插值的原理与公式推导 作者:xg1990,但是不可避免地在推导过程中,数学知识基础薄弱的我卡住在一些公式推导的步骤中。 所以就想基于上面大神的推导过程,将里面的推导写得更具体些,当然觉得毫不吃力可以进行推导的大神们可以不看我的注释,直接点开链接看就好。 我看到csdn中很多关于克里金推导的博客里面的内容直接截屏或者复制了上面链接里大神发表的内容,也不注

Olivel1997的博客 1万+

强化微调 (RFT) 如何助你打造更聪明的专业 AI 模型?

面对高难度任务,你的 AI 模型如何真正学会深度思考?需求当你需要让 AI 模型在医疗、法律、工程或金融等专业领域中真正实现「深度思考」与「精准决策」时,或许会发现传统的方法并不能让模型真正突破。你曾试过通过「监督式微调(SFT, Supervised Fine-Tuning)」来训练你的模型,即让它模仿已有数据中的标准答案。但这种方式更像是「背题库」,一旦出现超出训练数据范围的复杂问题,模型就显...

玉树芝兰 1076

opencv去除印章痕迹

今天看到一个很有意思的程序,就是去除票据上的红色印章,觉得很有意思,就把它抄过来记录一下,同时自己也开了一下脑洞。 原来的程序来自:https://www.cnblogs.com/skyfsm/p/7638301.html 可以看到图像效果很不错,下面是源码实现: #include <iostream> #include <opencv2/imgproc/imgpro...

zeng_haoyu的博客 7957

RFT与SFTAI模型微调的两种路径

监督微调(SFT)是微调中最常见的方式。简单来说,它利用带有明确标签的数据,通过监督学习的方式调整预训练模型,使其输出更符合特定任务的需求。强化学习微调(RFT)则是一条更灵活但也更复杂的路径。它借鉴了强化学习(Reinforcement Learning, RL)的思想,通过奖励机制来优化模型,而不是直接依赖标注数据。SFT和RFT代表了微调AI模型的两种哲学:一个追求精确,一个探索自由。选择哪种方法,取决于你的任务需求、数据条件和计算资源。

hello.reader 1879

手把手教你用CsvView分析大疆无人机飞行日志(附实战CTF题解)

本文详细介绍了如何使用CsvView工具分析大疆无人机飞行日志,包括环境搭建、日志提取、核心功能解析及CTF实战技巧。通过实战案例,帮助读者掌握无人机取证的关键技术,提升日志分析能力,特别适合网络安全竞赛和实际取证场景。

weixin_42652674的博客 457

Qt6.8.0(win64)安装教程

启动 Visual Studio 2022 Community,选择 “继续但无需代码” 运行,然后打开Option设置,Add一条版本配置,Location 选择 D:\Qt\6.8.0\msvc2022_64\bin\qmake,点击确定。我是win11系统,所以选择windows版,下载路径二选一即可。方案1:默认情况下,额外勾选图中两个组件(总共40多G)方案2:按图中自定义勾选组件(总共5.8G)选择Custom Installation。我选的方案2,总共5.81G。

D4G1TIAO的博客 9070

SFT 和 RFT 有什么不同?大模型微调方法对比详解

监督微调(SFT)和强化学习微调(RFT)是大语言模型(LLMs)领域两种核心的定制化技术,两者在原理、实现方式和应用场景上存在显著差异。以下从定义、核心机制、典型案例及对比维度展开详细说明:

2401_85325726的博客 2196

Ubuntu22.04下3分钟搞定GitHub加速:SwitchHosts+小鱼工具保姆级配置指南

本文提供Ubuntu22.04下快速解决GitHub下载超时问题的保姆级教程,通过SwitchHosts图形化工具和小鱼一键换源工具实现高效加速。详细步骤包括环境准备、工具安装配置及验证方法,帮助开发者轻松优化GitHub访问速度,提升工作效率。

weixin_29258297的博客 564

收藏必备!一文读懂OpenAI两大新微调技术:RFT与PFT让AI模型能力飙升

本文详细介绍了OpenAI最新提出的两种微调技术:强化学习微调(RFT)和偏好微调(PFT)。RFT利用少量高质量数据通过强化学习提升模型的推理能力,特别适用于专业领域。PFT采用DPO算法,通过比较不同输出来学习"更好"的回复,在创意写作等主观性任务上表现更佳。文章还解释了微调的基本概念、应用场景以及与SFT的区别,为开发者提供了优化大语言模型性能的新思路。

2401_84815887的博客 1490

用Python+NumPy手把手实现分数阶傅里叶变换(FRFT),搞定线性调频信号分析

本文详细介绍了如何使用Python和NumPy实现分数阶傅里叶变换(FRFT),特别针对线性调频信号(Chirp信号)分析。通过从零开始的代码实现和可视化案例,展示了FRFT在时变信号处理中的强大能力,帮助工程师和研究人员高效分析频率随时间变化的信号。

weixin_29062823的博客 218

【Python百日进阶-Web开发-Feffery】Day385 -“一起Dash”训练营Lesson-07_利用fac构建表单(上)

文章目录前言:fac是什么?“人生苦短,我用Python;Web开发,首选Feffery!”↓↓↓ 今日笔记 ↓↓↓一、费老师课堂1.1 什么是表单1.2 页面效果1.3 课堂源码二、课后作业2.1 页面效果2.2 项目源码 前言:fac是什么? feffery-antd-components(简称fac),是国内大佬费弗里(Feffery)老师基于著名的React UI组件库ant design进行二次开发,将ant design中的诸多实用组件及特性引入Dash,帮助开发者使用极低的纯Python代

专注于医院数据分析技术与系统开发的创作与分享。 251

让 AI 更懂你:微调、RLHF、强化学习微调和偏好微调,大模型训练的“进阶秘籍”

一个预训练的语言模型可以进行各种文本任务,但如果我们想让它专门做客服机器人,就可以用客服对话数据对它进行微调,让它更擅长回答用户的问题。利用奖励模型的打分,不断调整 AI 模型的参数,让它生成更高分的内容,就像小狗为了获得更多零食而不断改进自己的动作。我们可以收集大量的用户对不同新闻标题的偏好数据,然后用 DPO 来训练一个新闻标题生成模型,让它生成更吸引人的标题。则是一种更高效的微调方法,是OpenAI提出的一种新型微调技术,借鉴了强化学习的思想,但减少了对人类反馈的依赖。

simoncool23的博客 1089

cuMotion 入门教程(一)面向机器人学的GPU加速运动生成技术

NVIDIA cuMotion是一款高性能机器人运动生成库,专注于机械操作任务,利用GPU加速技术提升性能。开发者预览版支持运动学/逆运动学、碰撞感知路径规划、轨迹优化等功能,兼容任意自由度机器人。该库提供C++和Python接口,支持从URDF/XRDF文件加载机器人模型,包含世界建模、碰撞检测等工具。教程详细介绍了安装配置、机器人描述加载、运动学计算、世界建模、逆运动学求解以及轨迹优化等核心功能。cuMotion整合了Lula和cuRobo库的技术优势,将成为Isaac ROS的核心组件,适用于工业机器

2506_90492529的博客 2198

【AI论文】Visual-RFT:视觉强化微调(Visual Reinforcement Fine-Tuning)

为了将RFT扩展到视觉任务,本文提出了视觉强化微调(Visual Reinforcement Fine-Tuning, Visual-RFT),成功地将RFT应用于增强大型视觉-语言模型(Large Vision-Language Models, LVLMs)在各种多模态任务中的性能。Visual-RFT的实施细节如图2(b)所示,对于每个输入,它使用LVLMs生成包含推理标记和最终答案的多个响应。关键在于,我们为不同的任务设计了基于规则的可验证奖励函数,以指导策略优化算法(如GRPO)更新模型。

m0_66899341的博客 4087

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

RFT强化微调解析调研

强化微调(RFT)是 OpenAI 推出的一种技术,旨在通过强化学习方法定制大型语言模型(LLM),特别是其推理模型(如 o1 模型),以适应特定任务或领域。它的核心优势在于数据效率高,仅需几十个训练示例即可实现高性能,这与传统监督微调(SFT)相比是一个显著进步。RFT 是一种由 OpenAI 开发的技术,专注于通过强化学习定制 LLM,特别是其推理模型(如 o1 模型)。根据的报道,RFT 能够以极少的数据(通常几十个示例)实现高效微调,这与传统监督微调(SFT)需要大量标注数据形成对比。

weixin_62508889的博客 1010

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

大厂AI 大模型面试:监督微调(SFT)与强化微调(RFT)原理

还在为AI大模型面试中被微调原理问倒而发愁?看这!本文超3万字深扒AI大模型监督微调(SFT)与强化微调(RFT)原理,从数据准备到模型训练,源码逐行解读。掌握这些,面试稳过,轻松拿下心仪Offer

Android开发领域创作者 884

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

OpenAI RFT API:让强化学习微调更简单,为语言模型带来突破性进展

通过强化学习微调(RFT),开发者不仅能够以更高效的方式微调语言模型,还能够实现更具针对性的行为优化。这不仅提升了模型在特定任务中的性能和适应性,还显著改善了用户体验和应用效果。RFT 的引入,标志着强化学习技术在实际应用中的进一步普及和深化,为AI模型的定制化和智能化发展提供了强有力的支持。

XianxinMao的博客 1429

医疗场景实战:百条数据 RFT 微调盘古大模型,精度大幅提升

RFT强化微调是一种新型LLM微调方法,通过强化学习与传统微调结合,少量数据即可显著增强领域场景的模型能力。

华为云官方博客 1312

大模型微调:监督微调(SFT)与强化微调(RFT)分析

监督微调是一种基于有监督学习的微调方法。其核心思想是利用标注好的数据集对预训练的大模型进行进一步训练,使得模型能够更好地适应特定的任务。在监督微调过程中,模型会根据输入的样本和对应的标注标签,通过最小化损失函数来调整模型的参数。监督微调的核心在于利用标注好的数据,通过最小化损失函数来调整模型的参数。在训练过程中,模型不断学习输入数据和标注标签之间的映射关系,从而提高在特定任务上的性能。强化微调结合了强化学习和微调的思想。

AI技术改变世界 1357

Visual-RFT:基于强化学习的视觉语言模型微调技术研究

Visual-RFT代表了视觉语言模型微调方法的技术变革。通过整合类人推理过程与强大的强化学习框架,该方法在传统上受数据可用性制约的任务中实现了显著性能提升。无论是细粒度图像分类、少样本对象检测还是推理定位,Visual-RFT都为模型提供了迭代学习和动态适应的能力,为未来视觉语言模型开发提供了新的技术路径。

大模型教程的博客 899
上一篇: 30天速成AI大模型高手!从入门到实战,这份保姆级计划助你抢占风口!【收藏必备】30天大模型速成计划
下一篇: MCP+Agent跑通任务?别急!没有Ontology,你的AI工厂只能“昙花一现”
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值