

Stable Diffusion安装及入门教程(全面导引)

绘世启动器+秋叶整合包:本地部署ComfyUI与显卡排障指南 AI绘画基于深度学习模型,Stable Diffusion是最流行的开源生成模型之一。ComfyUI采用节点式工作流,将模型加载、提示词、采样等组件可视化连接,但原生安装需手动配置Python、PyTorch、CUDA等环境,对新手不友好。秋叶整合包将ComfyUI本体、依赖和模型目录封装为免安装文件夹,绘世启动器则提供环境检测、一键启动、参数调优与模型管理,显著降低本地部署门槛。同时,显卡驱动问题(如nvlddmkm事件ID 153)常导致生成失败,可通过启动器参数调整和驱动重装解决。这套方案兼顾小白友好 阅读详情
AI摘要

本文是Stable Diffusion的安装及入门教程,适合小白。介绍了基础概念,如Checkpoint、Lora模型等;说明了下载安装步骤,包括秋叶启动器的使用;讲解了绘世启动器和SD WebUI界面,以及插件安装方法;还介绍了多个插件功能,并提供了AI绘画学习资料。

目录

一、Stable Diffusion基础概念

1.名词解释

Checkpoint(大模型)

Lora模型

Embedding

VAE(变分自编码器)

ControlNet

2.一些概念

二、下载及安装

三、界面说明

1.绘世启动器(秋叶)

2.SD WebUI界面说明

3.插件安装方法

4.如何在其它的机器访问你的SD?

四、关于插件

1.ADetailer(修复脸、手、身)

2.Tiled Diffusion和Tiled VAE

3.ControlNet控制图像(常用)

4.Segment Anything蒙版

5.后期处理

6.PNG图片信息

7.VRAM Estimator

8.3D OpenPose

9.Depth Library手指调整

10.Inpaint Anything蒙版

11.WD1.4场景器(反推提示词)

结语


一、Stable Diffusion基础概念

网上有许多关于SD的教程,我再出详细教程有点多此一举,不过我的教程特点是适合小白入门,顺序渐进且做好引导,会让你跳转链接去……去看别人的教程。

可别小看这一举措,有时候因为不理解概念而到处胡乱寻找资料,可是要花掉大把时间的。

所以,我的教程特点是:不教,只做导引。

1.名词解释

Checkpoint(大模型)

定义与作用:Checkpoint是Stable Diffusion中的核心组件,是预训练的大型模型,包含了丰富的图像和风格数据。它决定了生成图像的基本风格和质量,是图像生成过程的基础。

选择合适的Checkpoint:选择合适的checkpoint对于生成期望风格的图像至关重要。用户应根据自己的需求(如写实风格、漫画风格等)选择相应的checkpoint。通常,checkpoint的文件名后缀为.ckpt和.safetensors,模型大小从2GB到8GB不等。

checkpoint文件放置路径:\models\Stable-diffusion

Lora模型

定义与作用:Lora模型是一种微调技术,可以在不显著增加计算成本的情况下,调整生成图像的特定细节。它主要用于雕刻人物特征、控制画风、固定特征动作等,提高图像的细节和质量。

使用场景:Lora模型适用于需要对图像的特定部分进行微调的场景。用户可以根据需要选择是否使用Lora模型,并通过特定的触发词激活其效果。Lora模型的文件名后缀通常为.safetensors,大小在20MB到300MB不等。

Lora放置路径:\models\lora

Embedding

定义与作用:Embedding是一种特殊的文本处理技术,它允许用户通过简单的词语来代表一连串的复杂概念或属性。这种方法简化了创建复杂prompt的过程,使得用户可以更容易地控制生成图像的细节。

简化Prompt创建:通过使用embedding,用户可以将复杂的描述简化为单一或少数几个词语。例如,如果已有“皮卡丘”的embedding,用户只需输入“皮卡丘”,而不需要详细描述其特征。

embedding文件放置路径:\embedding

VAE(变分自编码器)

定义与作用:VAE是Stable Diffusion中的另一个关键组件,主要用于调整图像的色彩和细节,以达到更自然和真实的效果。它相当于给图像加载一个滤镜,修正最终输出的图片色彩。

应用方法:VAE的使用可以根据需要自动或手动进行。在某些情况下,特别是当图像出现色彩失真时,使用VAE可以显著改善图像质量。VAE文件的后缀一般为.downloading、.safetensors、.ckpt、.pt。

VAE文件的放置路径:\models\vae

ControlNet

边缘检测模型或线稿模型提取线稿(可提取参考图片线稿,或者手绘线稿),再根据提示词和风格模型对图像进行着色和风格化。 应用模型: Canny、SoftEdge、Lineart。 Canny 边缘检测: Canny 是比较常用的一种线稿提取方式,该模型能够很好的识别出图像内各对象的边缘轮廓。

2.一些概念

目前我们所使用的是秋叶启动器,原本SD是一系列的代码和命令行,有了WebUI版本之后才有了界面,但操作还是困难,现在有了秋叶启动器,封装了所有的功能,变成简单易操作的可视化界面,并向公众免费。

在此感恩秋叶大佬!

秋叶B站官网链接:

【AI绘画】绘世启动器正式发布!一键启动/修复/更新/模型下载管理全支持!_哔哩哔哩_bilibili

WebUI下载:AUTOMATIC1111/stable-diffusion-webui: Stable Diffusion web UI (github.com)

截止至今日,还有SDXL、CompyUI、forge等其它模型和UI,后面有时间再介绍。

二、下载及安装

秋叶启动器下载地址:

链接:https://pan.baidu.com/s/10oc_OtEpybeUc8fhjtUhmw?pwd=XYSD

提取码:XYSD

下载完了之后,把压缩包解开,然后点击“启动器运行依赖”的蓝色图标。

把controlnet文件夹中的文件复制到:models/ControlNet

这是 ControlNet(ControlNet是一款用于控制出图内容的可选插件)的模型。

按以上操作完成之后,点击那个二次元的图标,便可以运行。

以为这样就结束了吗?呵呵~

三、界面说明

1.绘世启动器(秋叶)

  1. 所有生成后文件存放目录,定期清理;
  2. 启动。

若需要在局域网应用,这两个要打开,但需要下载安装扩展时,此处要关闭。

所有模型目录可在这里点击进入,如果你从其它网站下载好模型之后,可以点击右上角的“+添加模型”导入。

2.SD WebUI界面说明

1.选择大模型,模型安装后在这里刷新;

2.VAE,默认就好;

3.导航

4.提示词文本框

现在的提示词并不复杂,输入会自动关联提示词,也可用deelp.com或有道翻译。

注意提示词先后顺序和权重。

通用反面词:

(worst quality:2),(low quality:2),(normal quality:2),lowres,bad anatomy,bad hands,text,error,missing fingers,extra digit,fewer digits,cropped,jpeg artifacts,signature,watermark,username,blurry,bad_pictures,DeepNegativeV1.x_V175T,nsfw,

nsfw是防黄设置。

如有需要,可以自行下载其它模型,以下是模型下载推荐网站:

https://civitai.com/ C站(推荐)

吐司 tusi.cn | 可在线生图的 AI 模型分享社区,还是免费的!

LiblibAI·哩布哩布AI - 中国领先的AI创作平台

这里有份入门手册,特别详细:

Stable Diffusion入门修炼手册_stable diffusion checkpoint-优快云博客

在上图中,我安装了以下这些checkpoint模型:

Detail Asian Realistic - v5.0 | Stable Diffusion Checkpoint | Civitai

AgainMix - v1.8 | Stable Diffusion Checkpoint | Civitai

majicMIXlux麦橘辉耀 - v3 | 吐司 TusiArt.com

majicMIX realistic麦橘写实 - v7 | 吐司 TusiArt.com

我常用的是majic v7这个模型,你可以按照你自己的需要去下载。

图片变化公式:迭代步数*重绘幅度,这两个数调越大变化越大。

采样方式默认就好DPM++ 2M Karras。

提示词引导系数:默认7,但很多情况下需要调高提示词,否则会生成怪物或不理想图片。

随机数种子:在未生成之前不存在种子,生成后觉得好的图片想要延伸其它,可以保留种子再生成,-1即是随机。

如果你要添加Lora,就按图中操作,在正向提示词文本框就会自动生成一组提示词。

lora:macc-平面模特\_v2.0:1最后的数字是调整权重,比如:

lora:macc-平面模特\_v2.0:1.2

再往下看,你会发现有很多选项,这些都是插件:

如果你按我上面说的安装,那么有些插件你是没有的,你还要再补充,当然,有些你并不需要。

3.插件安装方法

从这里可以看到各种扩展,可安装也可删除。

点击“可下载”再点击“加载扩展列表”可以看到插件列表。

在文本框中也可以输入插件名进行安装。

如果你在别的地方找到一些插件,列表中没有的,可以点击“从网址安装”,输入代码托管平台的网址即可安装。

注意:如果处于共享网络可访问状态,是无法安装的,要先退出后去启动器那边把共享网络关掉:

4.如何在其它的机器访问你的SD?

有两种方式,一种是局域网内访问你的SD,一种是通过内网穿透后其它网络也可以访问。

这里说说局域网的。

在启动器的主界面把这两个打开。

然后键盘按下Win+R,输入cmd进行命令行模式,在命令行中输入ipconfig,获得本机IP地址。

这样可以看到我本机的IP地址是:192.168.3.79,所以,在局域网内的其它机器采用这个网址即可访问:http://192.168.3.79:7860

四、关于插件

1.ADetailer(修复脸、手、身)

可以下拉框中选模型,有face的是脸,hand是手,person是身体。

注意事项:

先调试好参数,确认没有问题后,在生成时,先点选ADetailer脸部修复,这样能一次性生成完整图片。

ADetailer修复身体会造成衣服变化,而手部越修越糟糕。

ADetailer后期生成,就不要用高清图,因为高清图会在ADetailer变得不清晰,并且文件还很大。

2.Tiled Diffusion和Tiled VAE

想要高清图可以选这两项,下面是相关教程:

Stable diffusion生成细节度拉满的超高分辨率画面|Ultimate SD upscale|Tiled Diffusion教程_哔哩哔哩_bilibili

3.ControlNet控制图像(常用)

这是很常用的功能,也非常重要。

关于控制类型可以查看详细教程:AI绘画,一文讲清楚ControlNet实用教程 - 知乎 (zhihu.com)

选项卡中有单元1、单元2……就是指同时可以添加多种控制,我自己在生成模特的时候,一般 常用的就是OpenPose和canny或softEdge,其它的都没怎么用。

可以定位好姿势。

还有Tile也是生成高清图需要用到的。

这是关于Tile的教程:stable diffusion中tile模型的应用技巧,看完后我终于明白了它的原理和使用场景! - 知乎 (zhihu.com)

4.Segment Anything蒙版

链接:https://pan.baidu.com/s/1sDML8ve-LX3lcUFl5QuJFA?pwd=XYSD

提取码:XYSD

里面有三个文件,都是类似这样的文件名:sam_vit_h_4b8939.pth

注意看中间的字母h,这是什么意思呢?

很简单:显存10G+用h,6-10用l,小于的用b

下载后放置到这个文件夹中:\extensions\sd-webui-segment-anything\models\sam

然后重新加载界面:

来到segment anything中:

鼠标左键点击想要蒙版部分(黑点),右键点击不想要蒙版的部分(红点)

这样会生成多张高清蒙版供选择。

5.后期处理

点击总导航选项卡中的“后期处理”,可以把图片放大。

注意选择好放大算法。

6.PNG图片信息

由SD生成的png图片你忘词了?可以在这里提取出来。

7.VRAM Estimator

经常出现爆显存?可以安装好这个插件,然后运行基准测试,运行约15分钟至数小时不等,这是测试你显卡的性能。然后会生成图表,你不用去看这些图表,它的作用是当你每次设置完准备跑图的时候,就会给你计算出你的显存是否能跑:

比如我这个这次跑图是占到84.84%

如果超太多,就跑不了了。

8.3D OpenPose

当你上传图片之后,它就会自动调整图片中的骨架结构。

3D OpenPose它有别于ControlNet中的OpenPose,它支持更多角度的姿势调节。

不过使用不是很顺手,骨架的操作比较难。

9.Depth Library手指调整

生成的图片如果出现坏手,那么可以用这个工具手动去调整。

其实关于调整手部有很多方法,建议可下这个教程:

stablediffusion手指修复方法 各种手势姿态调整,controlnet openpose教程_哔哩哔哩_bilibili

10.Inpaint Anything蒙版

我觉得它这个蒙版比之前那个Segment Anything要容易操作很多。

先在这里选好模型,老样子,带10G以上显存的用h,6~10的用l,小的用b。

左侧上传图片,点击下方按钮,右边会呈现色块,用鼠标点击色块代表选中蒙版。

比如我们要替换图片中的黑色衣服,每个色块都要点,右上角的笔标可以调整笔尖大小。

点击“创建蒙版”按钮,在下方就会生成蒙版。

右上角同样有毛笔可以修剪或添加蒙版内容。

确定好蒙版之后,再回到左右点击选项卡“仅蒙版”,点击“获取蒙版”,这样就完成了。

在蒙版下方可点击发送到图生图,这样就大功告成了!

11.WD1.4场景器(反推提示词)

当你在左右上传一张图片后,会自动根据图片帮你反推提示词。

结语

教程我有空就会更新,模型训练方面我还没有时间研究,所以一些功能我还不知道怎么使用,后续工作上有用到就会逐渐更新。

接下来可能会更新一些案例,以及视频生成和工作流的方法,敬请期待。

关于AI绘画技术储备

学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!

对于0基础小白入门:

如果你是零基础小白,想快速入门AI绘画是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以找到适合自己的学习方案

包括:stable diffusion安装包、stable diffusion0基础入门全套PDF,视频学习教程。带你从零基础系统性的学好AI绘画!

需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
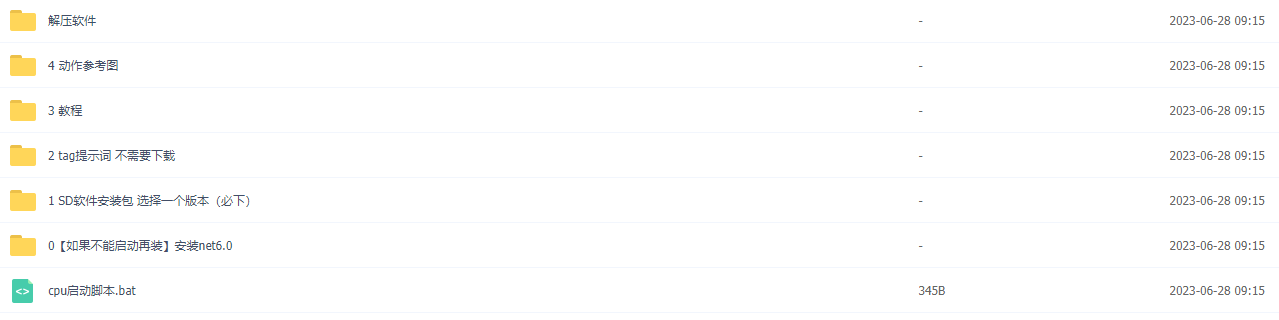
1.stable diffusion安装包 (全套教程文末领取哈)

随着技术的迭代,目前 Stable Diffusion 已经能够生成非常艺术化的图片了,完全有赶超人类的架势,已经有不少工作被这类服务替代,比如制作一个 logo 图片,画一张虚拟老婆照片,画质堪比相机。

最新 Stable Diffusion 除了有win多个版本,就算说底端的显卡也能玩了哦!此外还带来了Mac版本,仅支持macOS 12.3或更高版本。
在这里插入图片描述

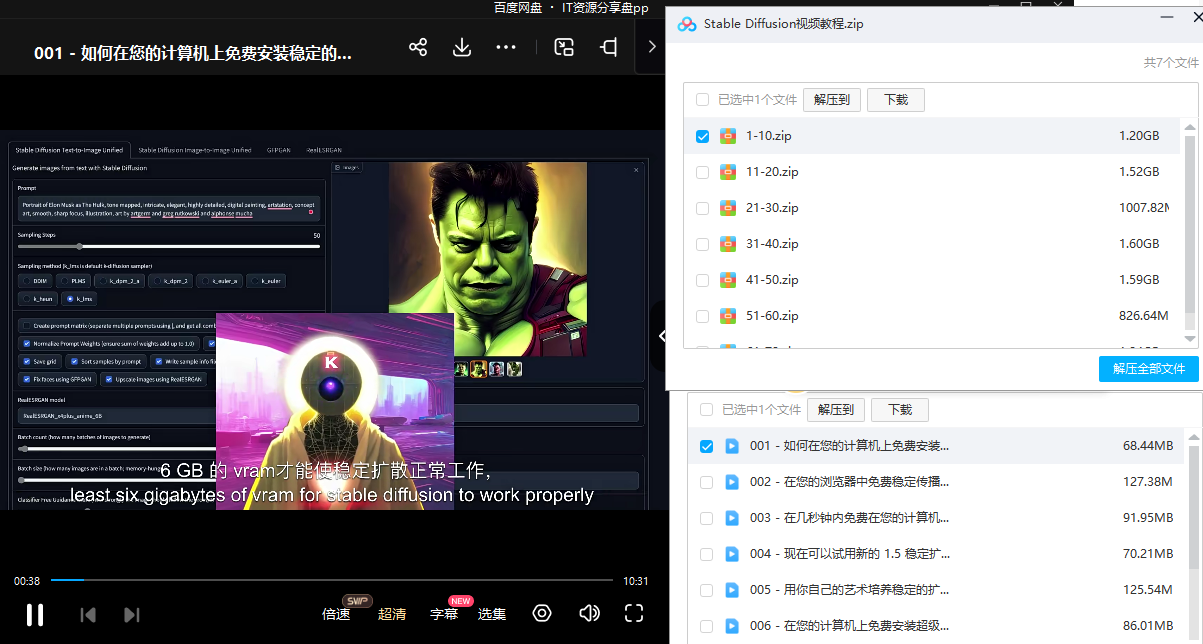
2.stable diffusion视频合集

我们在学习的时候,往往书籍代码难以理解,阅读困难,这时候视频教程教程是就很适合了,生动形象加上案例实战,一步步带你入门stable diffusion,科学有趣才能更方便的学习下去。
在这里插入图片描述

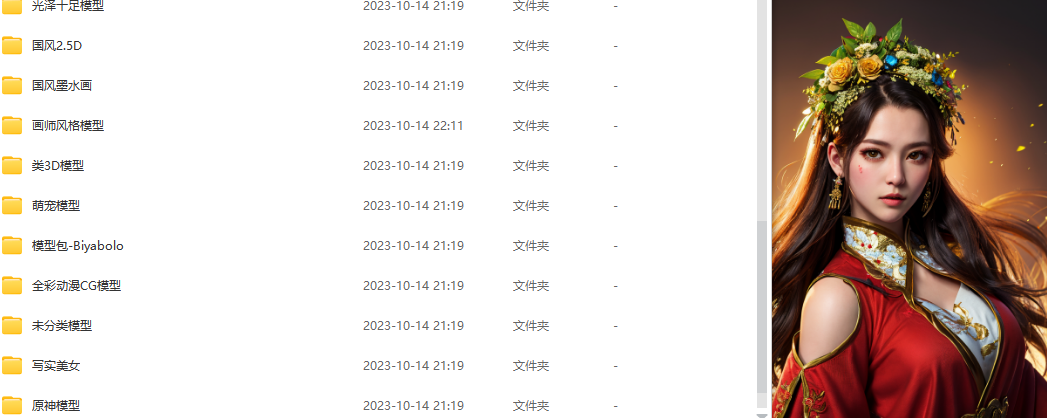
3.stable diffusion模型下载

stable diffusion往往一开始使用时图片等无法达到理想的生成效果,这时则需要通过使用大量训练数据,调整模型的超参数(如学习率、训练轮数、模型大小等),可以使得模型更好地适应数据集,并生成更加真实、准确、高质量的图像。
在这里插入图片描述

4.stable diffusion提示词

提示词是构建由文本到图像模型解释和理解的单词的过程。可以把它理解为你告诉 AI 模型要画什么而需要说的语言,整个SD学习过程中都离不开这本提示词手册。
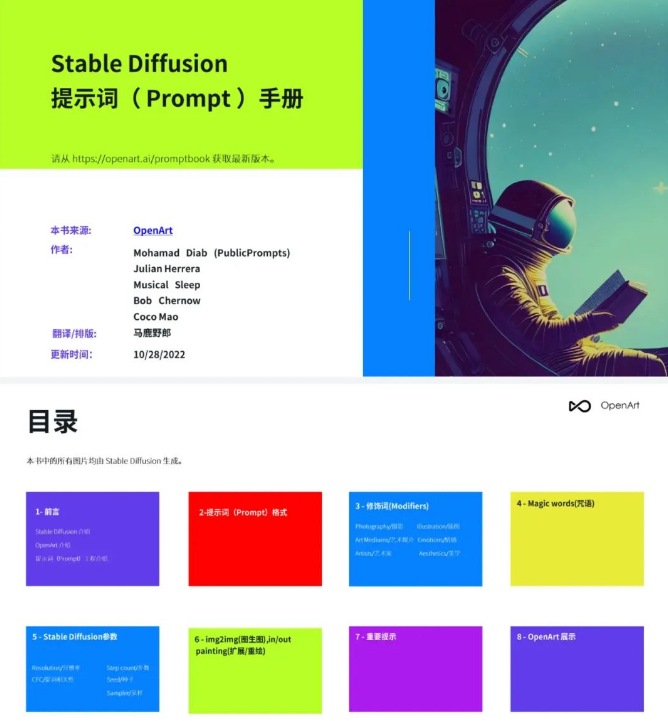
在这里插入图片描述

5.AIGC视频教程合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
在这里插入图片描述

实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
在这里插入图片描述
这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

2026游戏本性能评估新范式:从跑分到场景化四维实测 游戏本性能已不再等同于GPU算力或3DMark分数,而是融合AI推理延迟、光追吞吐、能效比与热稳定性的动态多维指标。随着DLSS 4、NPU协处理、动态功耗映射和预测式散热等技术普及,传统双烤测试与峰值跑分全面失效。真实体验取决于具体应用场景——如开放世界帧生成稳定性、FPS端到端输入延迟、AI创作工作流加速效率等。本文基于2026年实测数据,揭示如何用CapFrameX帧时间分析、HWiNFO传感器监控与场景化功耗报告,构建可复现的性能评估体系,直击‘2026游戏本性能排行榜’背后的工程真相。 阅读详情

相关推荐

多模态大语言模型视觉依赖性评估与优化

多模态大语言模型(MLLMs)在视觉问答任务中面临核心挑战:如何确保模型真正理解图像内容而非依赖文本推理。通过引入信息密度指标(如IC9600)和视觉约束生成系统,可量化评估模型的视觉依赖性。VC-IFEngine架构采用三级数据筛选机制和认知验证模板,显著提升视觉信息利用率。该技术在智能会议记录、景区安全管理等场景中,使模型视觉相关性错误减少63%,指令跟随精确度提升41%,为多模态评估体系建立了新的技术标准。

weixin_30627341的博客 354

绘世启动器(ComfyUI整合包)本地安装——秋叶

双击.exe文件运行程序。可能会出现一个报错,点击确定,它会打开你的浏览器,自动下载一个组件。ConfyUI-aki_免费高速下载|百度网盘-分享无限制 (baidu.com)下载.7z的压缩包就行。其它根据自己情况自行选择。下载完成后,按流程安装就行。会有一个弹窗要求一个权限,点确定。完成后会要求你重启。重启后打开电脑,再次双击.exe文件,运行。点击下图中第一排 右侧。,在右侧更改语言设置。

github_73913334的博客 4万+

边缘AI实战:Jetson Orin Nano 2开发、TensorRT加速与实体机器人部署全解析

在边缘计算领域,如何将AI模型高效部署到资源受限的硬件上,始终是工程实践的核心课题。边缘AI要求设备在本地完成实时推理,以降低延迟、节省带宽并保障数据隐私,其技术价值在机器人、无人机、AGV等实体AI场景中尤为突出。要实现这一目标,开发者需深入理解硬件算力特性、软件生态兼容性以及推理优化链路。NVIDIA Jetson Orin Nano 2作为入门级边缘AI平台的代表,凭借67 TOPS算力、Ampere架构GPU及TensorRT加速支持,为中小型项目提供了高性价比的落地方案。本文从硬件选型逻辑出发,详

weixin_34186128的博客 404

绘世启动器-秋叶发布

AIGC研究及应用

duhaining1976的博客 9498

秋叶启动器SD V4.9更新[项目代码]

本文详细介绍了2024年秋叶启动器Stable Diffusion V4.9版本的更新内容及安装教程。新版本修复了BUG并支持最新的SD3模型,提供了新用户安装和老用户模型迁移的详细步骤。安装包需重新下载,不能覆盖旧版本,但支持模型和设置文件的迁移。文章还介绍了WebUI的个性化设置,包括扩展模型、实时预览模式和controlnet设置的优化。此外,还分享了Stable Diffusion的安装包、视频教程、模型下载、提示词手册和实战演练资料,帮助用户更好地使用这一AI绘画工具。

Fluent新手必看:如何正确解读scaled residuals曲线(附常见问题排查)

本文详细解析了Fluent中scaled residuals曲线的解读方法及常见问题排查技巧。针对continuity残差居高不下、湍流模型收敛困难等典型问题,提供了网格质量检查、边界条件验证和求解策略调整的实用解决方案,帮助CFD新手快速掌握计算收敛性的关键判断标准。

weixin_28698059的博客 377

Linux云端部署stable diffusion保姆级教程——基于腾讯云,ubuntu系统

下面我会汉化,配自己习惯的设置,然后补插件all-in-one,civitai helper,controlnet,deforum,segment等,你可以根据你自己需要补插件,在网页里补就行,这里不赘述具体方法。#防火墙放通你设定的端口,这里也就是得放通1234端口,不会放通的,自行百度搜索 “腾讯云如何配置防火墙,放通需要的端口” ,这里不赘述。#本教程也参考了其他教程,这个是整合版,带#的是注释,不带#的就是命令,需要一行一行复制,然后按回车执行。

qq_45054988的博客 3454

Bootloader详解,理解Bootloader看这篇就够了

这里写目录标题一、Bootloader作用(目的)二、完成Boot最终目的的前提条件三、对前提条件的详细说明3.1、对前提条件(1)的说明:3.2、对前提条件(2)的说明:3.3、对前提条件(3)的说明:3.4、对前提条件(4)的说明:3.4、对前提条件(5)的说明:四、loader是干啥的 一、Bootloader作用(目的) Bootloader=Boot + loader Boot的目的: 最终目的:跳到C语言中;为了C语言运行程序会进行一系列的初始化,系统一上电后如何通过一系列的设置让软件程序员

iduuigdg的博客 11万+

Auto-Photoshop-StableDiffusion-Plugin:在Photoshop中无缝集成AI图像生成,打破创意边界的技术革命

在数字创作领域,**Auto-Photoshop-StableDiffusion-Plugin** 正在重新定义设计师与AI协作的工作流程。这款开源插件将Stable Diffusion的强大AI图像生成能力无缝嵌入Photoshop环境,让设计师无需在多个应用程序间切换,即可在熟悉的创作界面中调用最先进的AI技术。通过智能图层集成和原生编辑支持,该插件不仅提升了40%的图像创作效率,更将AI从辅

gitblog_00674的博客 846

船舶轨迹预测中的5个常见坑:基于LSTM单步预测的避坑实践

本文针对船舶轨迹预测中LSTM单步预测的常见问题,系统总结了五个典型陷阱及避坑实践。重点分析了如何正确处理AIS数据的非均匀采样与清洗、对航向角进行周期性编码、采用轨迹级归一化策略、缓解单步滚动预测的误差累积,并设计贴合业务的评估指标。这些实践能有效提升预测模型的准确性与实用性。

cnn8visionary的博客 632

uniapp(全端兼容) - 最新详细实现接入腾讯视频播放器功能插件,uniapp全平台端(小程序/H5网页/App/nvu)调用引入并使用腾讯视频播放组件完整全流程(详细示例源码,一键复制开箱即用)

uniapp腾讯视频,uniapp微信小程序腾讯视频,uniapp小程序接入腾讯视频详细示例教程源码,uniapp怎么在微信小程序平台使用腾讯视频插件,在uni-app中使用腾讯视频插件播放视频,uniapp调用腾讯视频,uniapp引入腾讯视频插件,uniapp小程序中引入腾讯视频无法播放,uniapp微信小程序平台引入腾讯视频播放不了黑屏,在uniapp开发的微信小程序中使用腾讯视频,uniapp如何引入腾讯视频插件播放视频,uni-app小程序平台引入腾讯视频插件播放腾讯视频,uniapp 小程序接入

✅ 精选推荐文章 1万+

“无中生有做3D”——游戏行业的AI革命

在更强大的AI及相关技术的加持下,游戏行业将出现怎样的变革?4月13日周三,方正证券分析师杨晓峰发表了题为《游戏的AI革命:StableDiffusion到Nerf》的行业研究报告。在这份报告中,方正证券表示,游戏行业能够根据现有的AI模型——GPT、Stable Diffusion以及Nerf,GPT文本生成神器的功能已被大众所熟知,这里方正证券着重介绍了Stable Diffusion和NeRF模型。

m0_71746299的博客 1016

Field Characteristics 深入解析,理解 SAP ABAP Analytics 中 Dimension 与 Measure 的真正边界

在SAP ABAP Analytics数据模型中,字段应建模为Dimension还是Measure,关键在于业务语义而非数据类型。Dimension提供分析上下文,构成数据坐标系,支持钻取与切片;Measure则需具备明确聚合语义(如#SUM、#MIN、#MAX),且必须满足Distinct(无重复)与Complete(无缺失)原则,确保聚合结果准确。错误的建模会导致聚合偏差,根源常在事实粒度不清或关联关系不当。因此,正确划分字段角色,本质是让Analytical Engine准确理解业务数据的分析逻辑。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 57

使用SD3.5 FP8生成赛博朋克风格建筑群的视觉冲击力测评

本文实测Stable Diffusion 3.5结合FP8量化技术在生成高分辨率赛博朋克风格建筑群中的表现,展示其在视觉质量、生成速度、显存占用和能效比方面的显著提升,并探讨其在游戏、影视、城市可视化等领域的应用潜力。

weixin_42405592的博客 1012

【系统分析师】核心考点:100个高频知识点汇总

本文系统梳理了系统分析师考试的11大领域高频考点,重点解析了计算机硬件与体系结构的7个核心知识点:计算机五大部件(CPU/存储器/总线等)、校验码类型(奇偶/海明/CRC)、CISC与RISC指令系统对比、总线分类与特性、RAID磁盘阵列级别、流水线技术原理及Flynn系统分类法。内容涵盖硬件组成、数据校验、指令架构、存储技术等关键概念,通过表格对比和公式说明,为考生提供结构化的知识框架与备考重点。

数据知道的博客 5569

手把手教你学simulink(32.1)--汽车电动机管理场景示例:基于Simulink的发动机管理系统中的混合动力车辆能量管理优化

本项目旨在设计和实现一个用于混合动力车辆(Hybrid Electric Vehicle, HEV)的能量管理优化系统(Energy Management Optimization System, EMOS)。通过Simulink进行建模和仿真,确保系统的稳定性和性能。该系统采用了先进的控制策略,如模型预测控制(MPC)、模糊逻辑控制、自适应控制等,以优化燃油经济性、减少排放,并提高驾驶体验。

MHD0815的博客 186

MusePublic圣光艺苑企业应用:美术馆数字策展与教育内容生成方案

本文介绍了如何在星图GPU平台上自动化部署🏛️ MusePublic 圣光艺苑 | Atelier of Sacred Light镜像,实现美术馆数字策展与教育内容生成。该方案能快速生成高质量数字展品和教学材料,大幅降低创作成本和时间,适用于虚拟展览搭建和个性化艺术教育等场景。

weixin_35705784的博客 175

【深度学习新浪潮】Nano Banana(Gemini 2.5 Flash Image)技术解析与开发者实操指南

重新定义了 AI 图像生成的产业标准。它不仅是“平民化的视觉工厂”,更是推动内容生产从“创意试错”转向“精准制造”的关键工具。未来,随着视频生成能力的加入(谷歌计划支持“文字指令 - 动态场景 - 多平台适配”全流程),Nano Banana 有望进一步颠覆影视、广告等领域的创作范式。:批量生成多场景图,模特姿态自然,服装褶皱和材质细节高度一致,节省 90% 拍摄成本。模型的非正式代号,是一款革命性的 AI 图像生成与编辑工具,主打。:生成细节丰富的厨师特写,光影自然,皮肤纹理和刀具反光逼真。

专注:太空算力、AI infra、异构调度、大模型成本工程 891

(论文速读)SceneComposer:任何级别的语义图像合成

SceneComposer提出了一种创新的语义图像合成框架,支持从纯文本到精细分割图的任意精度级别输入。该框架通过精度编码的掩码金字塔和文本特征映射表示,实现了对语义、精度和组成信息的联合编码,并采用多尺度引导扩散模型进行图像生成。实验表明,SceneComposer在文本到图像和分割到图像任务上均优于现有方法,同时支持用户在不同创作阶段灵活调整控制精度。该研究通过收集新的测试数据集验证了方法在真实用户手绘布局上的有效性,为AI辅助创作提供了更符合实际工作流程的解决方案。

LJ1147517021的博客 834

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

具身智能相关名词解释(3)--步态与动作模仿 模糊调度框架/机器人任务框架

摘要: 本文系统梳理了足式机器人运动控制与任务调度的核心技术。运动控制层涵盖步态生成与动作模仿:步态技术分为基于物理模型(MPC+WBC)和强化学习(RL)两大流派,前者通过动力学模型实现稳定移动,后者通过仿真训练应对复杂环境;动作模仿则利用动捕数据、AMP对抗训练及扩散策略,实现生物动作到机器人执行的转化,并需解决全身动量耦合与仿真迁移(Sim-to-Real)挑战。任务调度层分为模糊调度框架(处理不确定性,如模糊逻辑规则动态优化AGV任务分配)和机器人调度框架(解决多机路径规划、任务分配与交通管制),二

2302_77159195的博客 409

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

智能体经济架构解析:从分布式协调到价值交换的实践指南

分布式系统通过去中心化的节点协作,实现了资源的高效利用与任务的并行处理,其核心原理在于共识机制、智能合约与异步通信等技术的结合。这种架构在提升系统鲁棒性与可扩展性的同时,为自动化经济协作奠定了基础。在工程实践中,LangChain等框架被广泛应用于构建具备感知、规划与执行能力的智能体(Agent),通过任务分解与工具调用完成复杂工作流。结合区块链技术实现的可验证性,使得智能体间的贡献度量与价值交换成为可能,从而在内容生成、供应链管理等场景中形成自主协作的经济闭环。本文以多智能体协作为例,深入探讨了其架构设计

weixin_30363509的博客 410

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

AI+Blender+UE5,一小时打造游戏级海盗洞穴完整工作流

AI绘画与三维游戏引擎的结合,正在重塑游戏资产的生产流程。其核心原理是:利用本地或在线AI文生图工具快速生成概念图与PBR贴图底图,通过Blender完成可控建模、UV整理与场景组装,再导入UE5借助Lumen光照系统实现游戏级渲染。这套工作流的技术价值在于,将传统流程中最耗时的概念设计、贴图搜索与风格探索压缩到分钟级,显著降低独立游戏与数字孪生风格化场景的前期验证成本。无论是关卡氛围预演、风格化概念验证,还是3D学习实践,都能从中受益。以海盗洞穴为演示场景,完整展示了从AI出图、Blender白模搭建到U

weixin_34416754的博客 376

Focus-Then-Contact——跟我之前给一工厂设计的插拔策略不谋而合:先ACT引导到目标区域附近,然后残差RL实施最终插入,且插入过程中视觉提供稠密奖励,必要时人工干预

本文介绍了一种名为Focus-Then-Contact(FTC)的轻量级人在回路强化学习框架,专为机器人接触密集型任务设计。该框架通过三个关键创新提升性能:(1)利用残差强化学习细化模仿学习得到的基础策略;(2)基于关键帧的可供性引导设计稠密奖励函数;(3)采用双腕部相机配置和人类干预机制。FTC在USB插拔等精细操作任务中展现出高效学习能力,解决了传统方法在真实世界中训练效率低、计算成本高的问题。该方法与作者此前独立开发的"ACT宏观导引+真机残差RL"电池包充电方案高度相似,验证了该

结构之法 算法之道 1462
上一篇: Stable Diffusion入门使用技巧及个人试用实例分享--生成稳定人物及姿势篇
下一篇: Stable Diffusion入门使用技巧及个人试用实例分享--SD提示词及ControlNet篇
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值