ubuntu安装Stable Video Diffusion(SVD)让图片动起来

深度学习踩坑经验沉淀【持续更新】 在深度学习炼丹过程中,总会遇到各种奇怪问题,这个时候总会在csdn和知乎平台找到答案,那每次遇到的问题是解决了,但没有记录起来,确实太可惜,因为未来某个时间或者某个人会遇到类似问题,所以在这片文章专项整理,pytorch、python、conda、pip等问题,希望能给大家更多帮助。 阅读详情

目录

写在前面

一、克隆或下载项目

二、下载预训练模型

三、创建环境

四、安装依赖

五、启动项目

六、解决报错

1.预训练模型下不来

2.TiffWriter.write() got an unexpected keyword argument ‘fps’

3.安装ffmpeg

4.No module named ‘scripts’

七、测试


写在前面

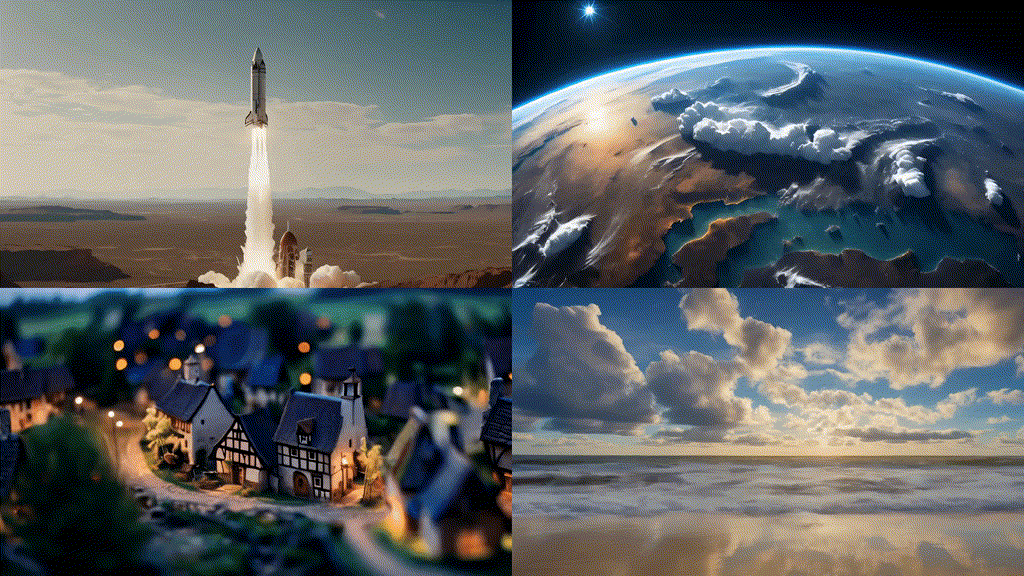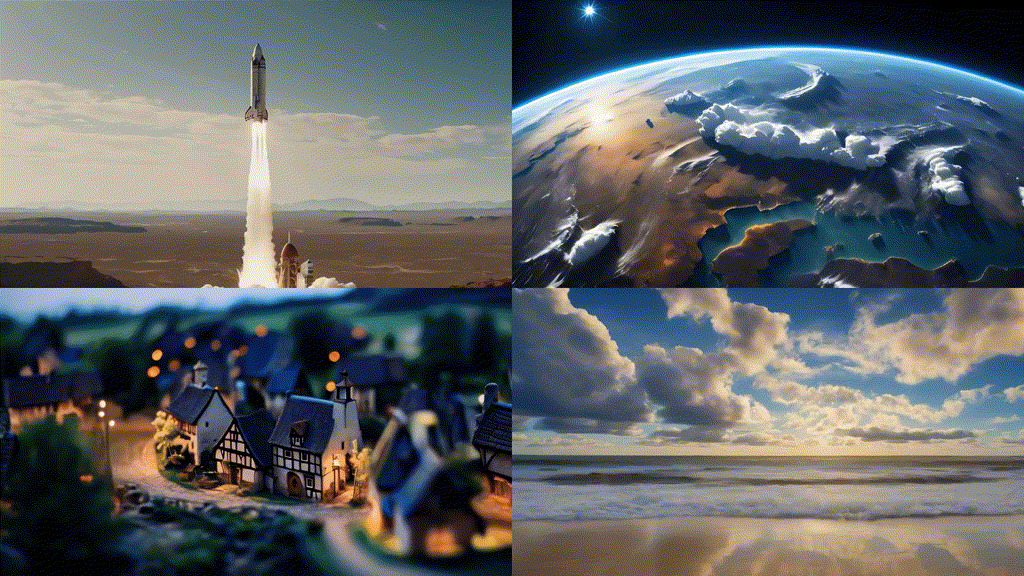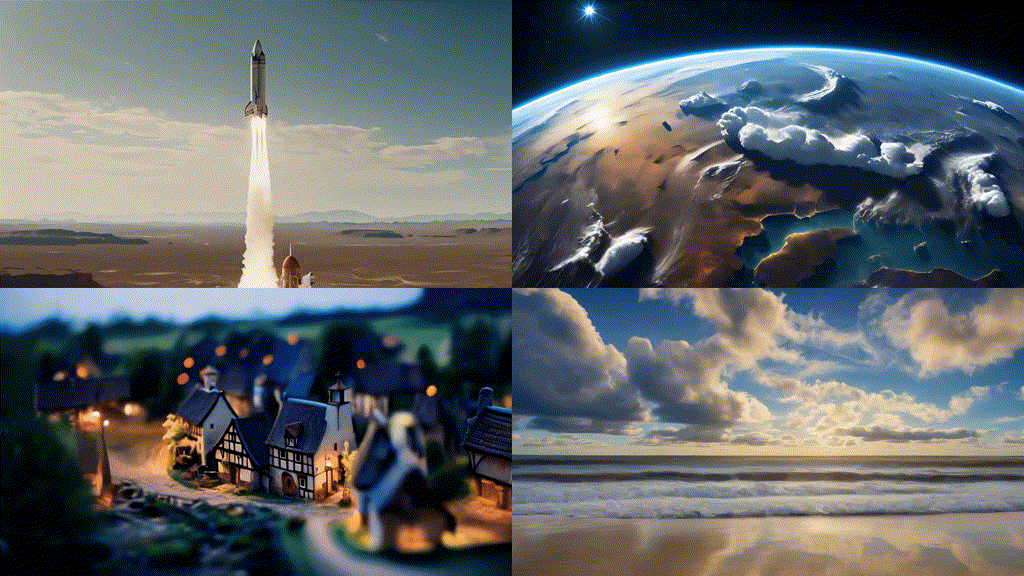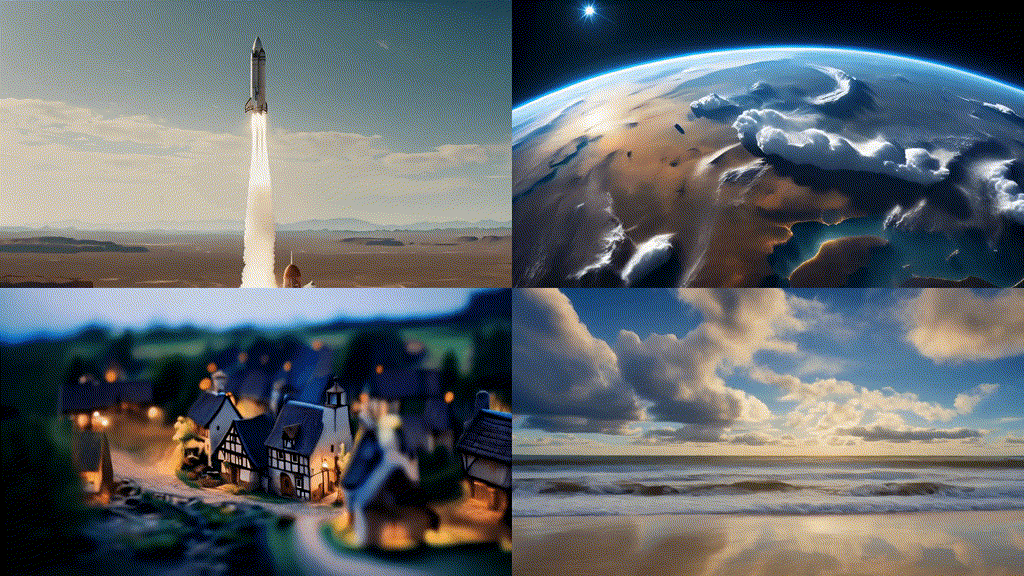
Stable Video Diffusion可以将图片变成几秒的视频,从名字就能看出来它使用了Stable Diffusion。现在这个项目还处在早期实验阶段,预训练模型也是效果感人,不过可以试着自己训练。这里先只介绍SVD的安装,目标是项目跑起来,能把一张图片变成3秒左右的视频,下面开始。
一、克隆或下载项目

比如项目被放在/mnt/generative-models-mian/目录中,项目地址如下:

https://github.com/Stability-AI/generative-models

二、下载预训练模型

可用的有如下四个:

https://huggingface.co/stabilityai/stable-video-diffusion-img2vid/blob/main/svd.safetensors
https://huggingface.co/stabilityai/stable-video-diffusion-img2vid/blob/main/svd_image_decoder.safetensors
https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt/blob/main/svd_xt.safetensors
https://huggingface.co/stabilityai/stable-video-diffusion-img2vid-xt/blob/main/svd_xt_image_decoder.safetensors

网盘地址:

https://pan.baidu.com/s/1vdBDgPl254FOxZP2LBsHGg?pwd=iyme

放在checkpoints/目录下:

三、创建环境

创建一个独立的环境,比如叫img2video:

conda create --name img2video python=3.10

四、安装依赖

conda activate img2video
cd /mnt/generative-models-main
pip3 install -r requirements/pt2.txt

如果因为网络原因安装clip报错,就需要删掉pt2.txt中的clip这一行。

手动下载CLIP项目,然后在CLIP中执行命令安装clip:

python setup.py install

五、启动项目

conda activate img2video
cd generative-models-main
streamlit run scripts/demo/video_sampling.py  --server.address  0.0.0.0  --server.port 7862

然后访问地址http://[ip]:7862/就可以访问项目了,接下来选一个模型并点击Load Model,就会加载模型了。

六、解决报错

如果没有报错,恭喜你可以跳过这步。常见报错有下面几个:

1.预训练模型下不来

如果因为网络问题模型下载不下来,报上面这个错,就需要我们手动下载模型了,模型文件有两个:

(1)ViT-L-14.pt

官方地址:https://openaipublic.azureedge.net/clip/models/b8cca3fd41ae0c99ba7e8951adf17d267cdb84cd88be6f7c2e0eca1737a03836/ViT-L-14.pt

网盘地址:https://pan.baidu.com/s/10bSIsPEpC2SFqSxH87unIg?pwd=jsv9

放在:/root/.cache/clip/ViT-L-14.pt

(2)open_clip_pytorch_model.bin

官方地址:https://huggingface.co/laion/CLIP-ViT-H-14-laion2B-s32B-b79K/blob/main/open_clip_pytorch_model.bin

网盘地址:https://pan.baidu.com/s/1_DDLVjbUnYxFTrrJaRQGCA?pwd=mqfl

放在:/root/.cache/huggingface/hub/models–laion–CLIP-ViT-H-14-laion2B-s32B-b79K/open_clip_pytorch_model.bin

如果还报上面的超时错误,就需要改改代码了。因为open_clip每次都会重新下载open_clip_pytorch_model.bin文件。根据报错,修改/root/anaconda3/envs/img2video/lib/python3.10/site-packages/open_clip/factory.py文件的create_model方法,把模型文件地址写死,虽然不优雅,但是能work:

if pretrained:
    checkpoint_path = ''
    pretrained_cfg = get_pretrained_cfg(model_name, pretrained)
    if pretrained_cfg:
        # TODO 解决模型下载不下来的问题
        # checkpoint_path = download_pretrained(pretrained_cfg, cache_dir=cache_dir)
        checkpoint_path = "/root/.cache/huggingface/hub/models--laion--CLIP-ViT-H-14-laion2B-s32B-b79K/open_clip_pytorch_model.bin"
        preprocess_cfg = merge_preprocess_dict(preprocess_cfg, pretrained_cfg)
    elif os.path.exists(pretrained):
        checkpoint_path = pretrained

2.TiffWriter.write() got an unexpected keyword argument ‘fps’

这是因为imageio版本问题:

pip install imageio==2.19.3

3.安装ffmpeg

报找不到imageio-ffmpeg

pip install imageio-ffmpeg==0.4.7

4.No module named ‘scripts’

报ModuleNotFoundError: No module named ‘scripts’,需要添加环境变量

RUN echo 'export PYTHONPATH=/mnt/generative-models-main:$PYTHONPATH' >>  /root/.bashrc
source /root/.bashrc

七、测试

如果看到这个页面就证明成功了,下面的报错不用过管它,这是因为没上传图片

上传图片后,调整参数,下面三个红框分别为视频的高、宽、要生成的总帧数和一次处理多少帧,如果显存小的话可以改小这些参数。点“sample”等待就可以看到结果了。

下面的报错其实也不用管,结果是outputs/demo/vid/svd/samples/000009.mp4文件。

关于AI绘画技术储备

学好 AI绘画 不论是就业还是做副业赚钱都不错,但要学会 AI绘画 还是要有一个学习规划。最后大家分享一份全套的 AI绘画 学习资料,给那些想学习 AI绘画 的小伙伴们一点帮助!

感兴趣的小伙伴,赠送全套AIGC学习资料和安装工具,包含AI绘画、AI人工智能等前沿科技教程,模型插件,具体看下方。

需要的可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

一、AIGC所有方向的学习路线

AIGC所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。
在这里插入图片描述

在这里插入图片描述

二、AIGC必备工具

工具都帮大家整理好了,安装就可直接上手!
在这里插入图片描述

三、最新AIGC学习笔记

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。
在这里插入图片描述
在这里插入图片描述

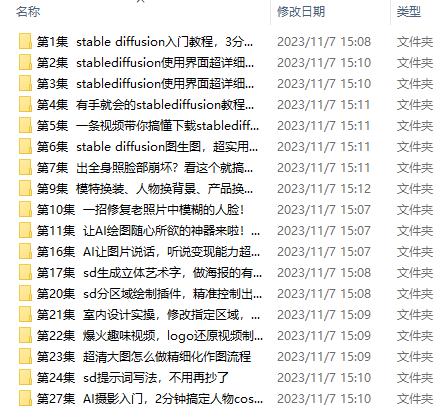
四、AIGC视频教程合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。
在这里插入图片描述

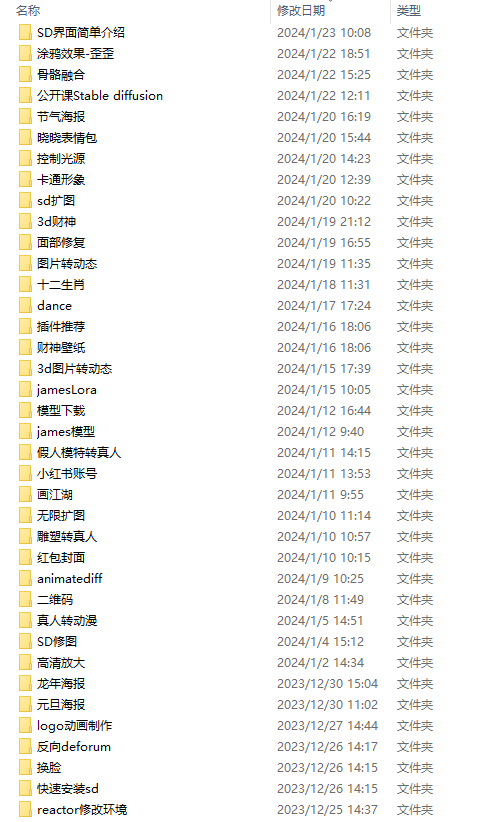
五、实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
在这里插入图片描述
这份完整版的学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

超详细Pytorch环境配置及CLIP应用实例   最近想体验一下OpenAI新发布的基于自然语言和图片的预训练模型-CLIP(不得不感叹一句,真是大力出奇迹啊),遂想搭建一个Pytorch环境,跑一跑实例。本以为几十页的论文是最大的障碍,没想到配置环境才是最令人崩溃的阶段。anaconda反复重装了几个来回,不过最后终于还是在关闭内存爆炸的Chrome的那一刻结束了配置,成功看见了那个True。由于网上很多教程都比较零散,在配置时难免耗费很多精力去搜索,所以在这次配置结束后,我想将这个过程完整地记录下来,方便以后配置也希望能帮助更多和我一样刚开始炼丹的 阅读详情

相关推荐

多模态——使用stable-video-diffusion将图片生成视频

近期,stabilityAI发布了一个新的项目,是将图片作为基础,生成一个相关的小视频,本文主要是体验一下stable-video-diffusion的使用,以及对其使用方法进行简单的介绍。

weixin_44826203的博客 1万+

ViT-L-14.pt下载load checkpoint from xxx

stable diffusion反推提示词出现此提示时,需安装以下模型至sd-webui-aki-v4.cache\clip\目录。

Nobita 4119

从零搭建AI视频生成流程:Stable Diffusion与SVD实战指南

扩散模型作为当前生成式AI的核心技术,通过在潜在空间中进行迭代去噪,实现了从随机噪声到高质量数据样本的转换。其原理基于对数据分布的学习与逆向扩散过程,在图像生成领域已取得突破性进展。这一技术的工程价值在于,它将复杂的生成任务分解为可优化、可控制的步骤,为视频生成这类高维时序数据的创建提供了可行的技术路径。在实际应用场景中,通过组合文生图与图生视频等模块化组件,开发者能够构建端到端的自动化内容创作流水线。本文聚焦于利用Stable Diffusion等开源模型,结合Stable Video Diffusion

weixin_30607659的博客 396

CLIP-as-service 0.8.0 版本发布:新增支持大型 ONNX 模型文件

CLIP-as-service 是一种用于编码图像和文本的低延迟、高可扩展性服务。它可以作为微服务轻松集成到神经搜索解决方案中。???? CLIP-as-service 0.8.0 现已正式发布!本次更新包含 3 个新增功能、1 个性能改进、1 个文档改进。????新功能新增支持大型 ONNX 模型文件 (#828)单个 ONNX 模型文件有2GB大小的限制,更大的 ONNX 模型将被拆分成许多的文件碎片保...

Jina AI 的博客 1833

本地AI视频生成:从Stable Video Diffusion到ComfyUI实战指南

AI视频生成技术基于扩散模型原理,通过逐步去噪过程从随机噪声生成连贯视频帧。这项技术的核心价值在于将专业级视频创作能力 democratize,大幅降低创意制作门槛。在工程实践中,本地部署方案通过Stable Video Diffusion等开源框架,结合ComfyUI可视化界面,实现了数据安全与成本控制的平衡。应用场景涵盖社交媒体内容制作、产品展示视频等需要批量生成和创意保护的领域。随着社区发展,当前基于Stable Video Diffusion和ComfyUI的解决方案已在生成质量和自定义程度方面达到

weixin_30791095的博客 337

从零实战:基于LoRA微调Stable Video Diffusion训练专属AI视频模型

模型微调(Fine-tuning)是让预训练大模型适应特定任务或领域的关键技术,其核心原理是通过在特定数据集上继续训练,调整模型参数以学习新数据的分布。在参数高效微调领域,LoRA(Low-Rank Adaptation)技术因其显著降低计算成本和显存需求的优势而备受关注。它通过引入可训练的低秩矩阵来近似模型权重更新,使得在单张消费级显卡上微调数十亿参数的大模型成为可能,极大提升了技术应用的可行性与性价比。这一技术对于需要定制化AI能力的场景,如生成特定艺术风格、统一品牌视觉或复刻特定角色的视频内容,具有重

weixin_34037173的博客 404

在Ubuntu上部署Stable Video Diffusion动画制作

Stable Diffusion团队推出的开源模型Stable Video Diffusion,支持生成约3秒的视频,分辨率为576×1024。通过测试视频展示了其令人瞩目的性能,SVD模型是一个生成图像到视频的扩散模型,通过对静止图像的条件化生成短视频。其特点主要包括:

BBM的博客 3786

DigitalOcean GPU Droplet 一键部署 Stable Diffusion WebUI 实操指南

Stable Diffusion 是基于扩散模型的开源文生图框架,其推理依赖 CUDA 加速与 PyTorch 生态的严格版本协同。AUTOMATIC1111 WebUI 作为最成熟的前端实现,以低门槛、高可扩展性成为个人与小团队首选,但本地部署常因驱动冲突、Python 环境混乱、xformers 编译失败等导致启动失败。云 GPU 实例通过预装 NVIDIA 驱动、标准化 Ubuntu 环境和确定性网络路径,显著降低部署复杂度。DigitalOcean A10 Droplet 凭借开箱即用的 CUDA

weixin_34269583的博客 693

ubuntu 系统部署 Stable Video Diffusion

Ubuntu系统本地部署和使用 Stable Video Diffusion(SVD)

maowenbei的博客 3145

从Runway获奖作品解析AI视频生成:本地部署SVD与ComfyUI实战指南

AI视频生成技术正从概念走向工程实践,其核心在于将扩散模型等生成式AI原理应用于时序数据合成。这项技术的价值在于能够以前所未有的效率和灵活性,将静态创意转化为动态叙事,极大地降低了高质量视频内容的创作门槛。其应用场景广泛覆盖了概念广告、产品演示、社交媒体内容和个人艺术创作等领域。本文以Runway大赛获奖作品为切入点,深入探讨了如何利用Stable Video Diffusion等主流模型,并结合ComfyUI节点式工作流,在本地环境中构建从图像生成、运动控制到多镜头合成的完整AI视频生成管道。文中详细拆解

weixin_34161029的博客 339

AD从原理图到PCB超详细教程

我在学习AD的时候,看了网上很多教程,但是东西很杂,有很多条理不清而且废话很多,所以相信大家学习的时候也是遇到一样的困难。我就特地写一篇帖子,整理了一下AD从画原理图开始一直到画完PCB文件的所有步骤,一方面是供大家参考学习,另一方面可以方便我自己学习记忆更加深刻。我用的版本是AD16中文版,大家用新的版本AD20或者AD22应该操作都是差不多的。

人生寂寞如雪 18万+

03 ComfyUI + SVD 系列(一):Ubuntu 24 + RTX 4090D 环境安装与启动验证

本文基于 Ubuntu 24 与 RTX 4090D,记录了 ComfyUI + SVD 图片生视频环境的安装与启动验证过程,包括 ComfyUI 安装、依赖与插件配置、svd_xt.safetensors 模型准备、ffmpeg 安装以及指定 GPU 启动等关键步骤。

weixin_43951955的博客 679

FCL碰撞检测库在Windows下的编译与配置(MinGW+CMake)

本文详细介绍了在Windows系统下使用MinGW和CMake编译配置FCL碰撞检测库的完整流程。内容涵盖MinGW-w64、CMake的安装与环境配置,关键依赖库Eigen和libccd的安装,以及FCL源码的编译、安装与实战测试。重点解析了CMake配置命令中的关键参数与常见错误解决方案,旨在帮助开发者高效完成FCL在Windows平台的部署,适用于机器人、游戏物理引擎等需要精确碰撞检测的开发场景。

sunny的博客 481

多模态实践指南:利用stable-video-diffusion实现静态图片动态化

本文详细介绍了如何利用Stable Video Diffusion(SVD)模型将静态图片动态化的完整实践指南。从环境配置、模型本地化部署、代码改造到显存优化,手把手教你实现图片生成视频。文章重点解析了核心流程与参数调校,并分享了效果分析与创意应用场景,为开发者和内容创作者提供了前沿的多模态AI技术实战方案。

weixin_29194817的博客 282

WinCC动态选择报警记录案例

本例中需要确认查询的时间段以及查询的关键字,然后通过一个按钮来执行报警数据查询脚本,并把查询出的结果加载到当前报警控件中。<本例中数据查询脚本的思路是根据选项组所选定的参数加载相应的归档变量到在线趋势控件,根据设定的查询时间范围设定控件时间轴的开始时间及结束时间。本文以 WinCC V8.0为例,介绍如何动态的查询WinCC报警记录,包括关键字查询/时间&关键字查询,如图1所示。<在WinCC变量管理中创建不同的变量组,并在变量组下创建相应的变量,如图2 所示(下图并非实际变量值)。

weixin_45072604的博客 2708

零承诺的启动之路:详解 SAP BTP 的 Pay-As-You-Go for SAP BTP(含案例与迁移策略)

SAP BTP的Pay-As-You-Go(PAYG)模式为零承诺的按需付费方案,适合PoC和小规模上线场景。它提供生产环境直接启用服务的能力,按月后付标准目录价,无预付和折扣。PAYG可与BTP企业协议(BTPEA/CPEA)混合使用,用量稳定后可平滑迁移至CPEA获取更好财务条款。关键优势在于灵活开启/关闭服务,支持通过SAP Discovery Center估算费用,并配合成本治理工具控制支出。该模式适用于创新项目初期,当业务规模可预测时再考虑转为承诺型消费模式。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 248

AI驱动视频转场:基于Stable Video Diffusion的本地化实践指南

视频转场是视频剪辑中的基础技术概念,用于实现不同场景间的平滑衔接,提升叙事流畅度。其原理在于通过视觉过渡引导观众视线,传统上依赖预定义特效或手动关键帧调整。随着AI技术的发展,特别是扩散模型的出现,视频生成与编辑进入了新阶段。扩散模型通过在潜在空间中进行插值计算,能够理解视频内容语义并推理合理运动轨迹,从而自动生成符合视觉逻辑的中间过渡序列。这项技术的核心价值在于将繁琐的手动操作自动化,大幅降低专业转场效果的制作门槛。在应用场景上,尤其适用于Vlog、短视频创作等领域,能够实现如空间转换、视角连贯变化等复杂

weixin_30851867的博客 320

Google Earth Engine(GEE)——使用归一化燃烧指数 (NBR) 绘制地表烧伤严重程度图

归一化燃烧指数(Normalized Burn Ratio, NBR)是一种遥感指标,用于评估野火或烧伤地面后的植被恢复情况。NBR能增强较大范围的火灾区域,如大于200公顷。它是通过比较远红外波段 (SWIR) 和近红外波段 (NIR) 的反射率来计算的。SWIR波段测量烧伤地面的反射率,NIR波段测量没有受到烧伤影响的植被的反射率。NBR的计算公式为:NBR =(NIR-SWIR)/(NIR + SWIR)。其中,NIR为近红外波段,SWIR为短波红外波段。

此星光明博客 3464

AI视频生成技术解析:从扩散模型原理到Stable Video Diffusion实战部署

扩散模型作为生成式AI的核心技术,通过‘加噪-去噪’过程学习数据分布,结合Transformer架构的时空注意力机制,实现了对视频序列的连贯生成。这项技术的工程价值在于为内容创作、数据增强和交互式应用提供了新的解决方案。在实际应用场景中,开发者常面临GPU显存管理和模型服务化等挑战。本文以Stable Video Diffusion为例,详细拆解了本地实验环境搭建、核心代码实现以及生产环境部署的最佳实践,帮助开发者从原理认知跨越到工程落地。

weixin_33938733的博客 535

「自然语言驱动生产力」17. 秒出端子图:DeepSeek+EPLAN实现机柜布线自动化——电气工程设计的效率革命

摘要:在电气工程设计领域,机柜布线与端子图绘制长期依赖人工操作,存在效率低、易出错等痛点。本文提出基于DeepSeek大模型与EPLAN软件的集成方案,通过自然语言指令驱动自动化设计流程。实验表明,该方案可将PLC柜端子图绘制从传统3小时压缩至2分钟,线号标注准确率达100%,BOM表实现实时导出。文中详细阐述了系统架构、IO配置解析算法、端子排自动生成逻辑及线缆优化策略,提供了完整的Python实现代码与污水处理厂鼓风机控制柜的实际应用案例,验证了自然语言驱动技术在电气工程设计中的实用价值。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 2045

视图库对接系列(GA-T 1400)一、简单介绍

GA/T 1400《公安视频图像信息应用系统》 是我们需要参考看看的相关文档,里面有对应的标准和介绍,没有这个文档的话可以加群找我要。群的话 我放在最下面了。我们先简单想几个问题, 也就是这个协议主要干什么用的,为什么要有, 能做什么。

qq_37716298的博客 4285

AI视频生成实战:从Stable Video Diffusion到电影人工作流构建

AI视频生成技术基于扩散模型和Transformer架构,通过文本或图像输入预测帧间变化,实现动态内容创作。其核心价值在于降低视频制作门槛,赋能个性化内容生产。在应用层面,该技术已从娱乐工具发展为专业创作平台,如PixVerse等竞赛推动社区协作。实践中,开发者常利用Stable Video Diffusion等开源模型构建本地化工作流,通过提示词工程和参数调优解决角色一致性等挑战。本文聚焦AI电影人项目原型,详解从环境配置、模型部署到多镜头合成的完整技术链路,为参与AI视频竞赛或集成生成能力提供工程指南。

weixin_34121304的博客 393

[最新]MapReduce综合应用案例 — 气象数据清洗

【代码】[最新]MapReduce综合应用案例 — 气象数据清洗。

M_inherit的博客 1014

云端部署ComfyUI与SVD:AI图生视频完整实战指南

扩散模型作为当前生成式AI的核心技术,通过学习数据分布并迭代去噪,实现了从文本到图像、乃至视频的创造性内容生成。其原理在于通过训练学习如何从随机噪声中逐步重建出符合目标分布的数据。这一技术价值在于极大地降低了高质量视觉内容创作的门槛,推动了创意产业和动态媒体制作的变革。在应用场景上,扩散模型已广泛用于艺术创作、广告设计、影视预览和社交媒体内容生产。本文聚焦于**Stable Video Diffusion (SVD)** 这一扩散模型在视频生成领域的实践,详细解析如何利用 **ComfyUI** 的可视化节

weixin_30279315的博客 345

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

AI视频生成物理错误检测:本地化测试方案与Stable Video Diffusion实践

在计算机视觉与生成式AI领域,视频合成技术正从静态图像生成迈向动态序列创建。其核心原理基于扩散模型等深度学习架构,通过去噪过程从噪声中逐步构建连贯帧序列。这项技术的核心价值在于能够自动化生成动态视觉内容,大幅提升影视、游戏、广告等行业的创意生产效率。然而,当前模型在生成长序列视频时,普遍面临时空一致性挑战,容易出现物体运动轨迹违反物理规律、光影闪烁、物体形变或凭空消失等“AI幻觉”问题。这些物理错误直接影响生成内容的可信度与实用性。本文聚焦于AI视频生成的可靠性评估,提供一套基于Stable Video D

weixin_30301449的博客 401

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

上一篇: Stable Diffusion的本地部署教程
下一篇: 手把手教你在本地电脑部署Stable Diffusion生成AI图像!无GPU也能跑图!
智泊AI官方
博客等级 码龄6年 8638粉丝 2667原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值