redis 高阶(六)主从复制

深入解析STM32F40x CAN控制器的配置与优化 本文深入解析STM32F40x CAN控制器的配置与优化,涵盖基础工作模式、波特率计算、筛选器配置及中断管理等关键技术。通过实战案例和代码示例,帮助开发者高效配置CAN通信,提升工业控制系统的稳定性和性能。 阅读详情

一.主从复制简介

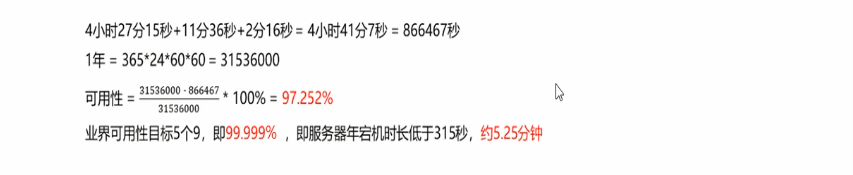
1.你的“Redis”是否高可用

1.1 单机redis的风险与问题

问题1.机器故障

  • 现象:硬盘故障、系统崩溃
  • 本质:数据丢失,很可能对业务造成灾难性打击
  • 结论:基本上会放弃使用redis.

问题2.容量瓶颈

  • 现象:内存不足,从16G升级到64G,从64G升级到128G,无限升级内存
  • 本质:穷,硬件条件跟不上
  • 结论:放弃使用redis

结论:
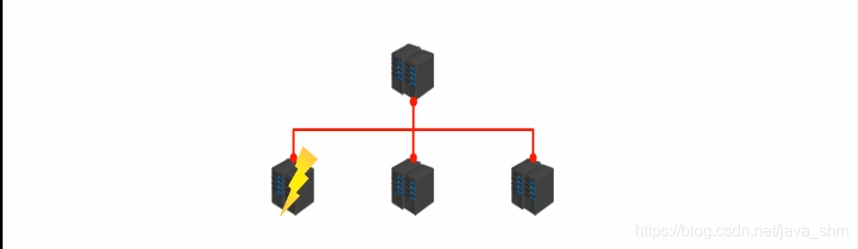
为了避免单点Redis服务器故障,准备多台服务器,互相连通。将数据复制多个副本保存在不同的服
务器上,连接在一起,并保证数据是同步的。即使有其中一台服务器宕机,其他服务器依然可以继续
提供服务,实现Redis的高可用,同时实现数据冗余备份。

1.2 多台服务器连接方案
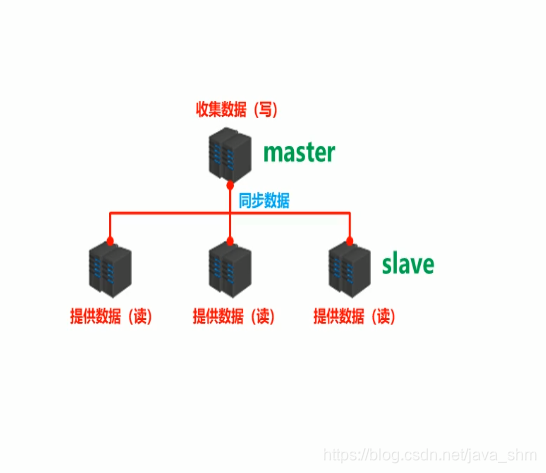
  • 提供数据方:master      主服务器,主节点,主库      主客户端
  • 接收数据方:slave         从服务器,从节点,从库      从客户端
  • 需要解决的问题:数据同步
  • 核心工作:master的数据复制到slave中

2.主从复制

主从复制即将master中的数据即时、有效的复制到slave中

特征:一个master可以拥有多个slave,一个slave只对应一个master

职责:
master:

  • 写数据
  • 执行写操作时,将出现变化的数据自动同步到slave
  • 读数据(可忽略)

slave:

  • 读数据
  • 写数据(禁止)

3.高可用集群

4.主从复制的作用

  • 读写分离:master写、slave读,提高服务器的读写负载能力
  • 负载均衡:基于主从结构,配合读写分离,由slave分担master负载,并根据需求的变化,改变slave的数量,通过多个从节点分担数据读取负载,大大提高Redis服务器并发量与数据吞吐量
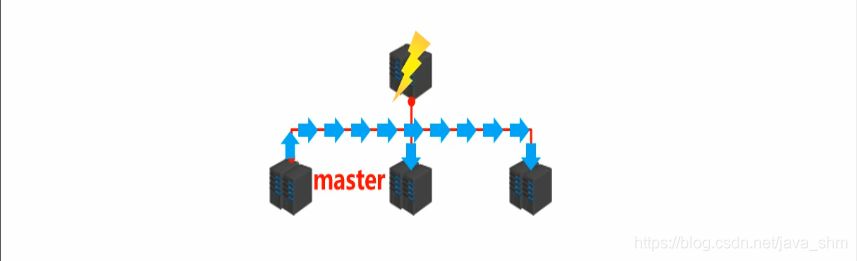
  • 故障恢复:当master出现问题时,由slave提供服务,实现快速的故障恢复
  • 数据冗余:实现数据热备份,是持久化之外的一种数据冗余方式
  • 高可用基石:基于主从复制,构建哨兵模式与集群,实现Redis的高可用方案

二.主从复制工作流程

1.总述

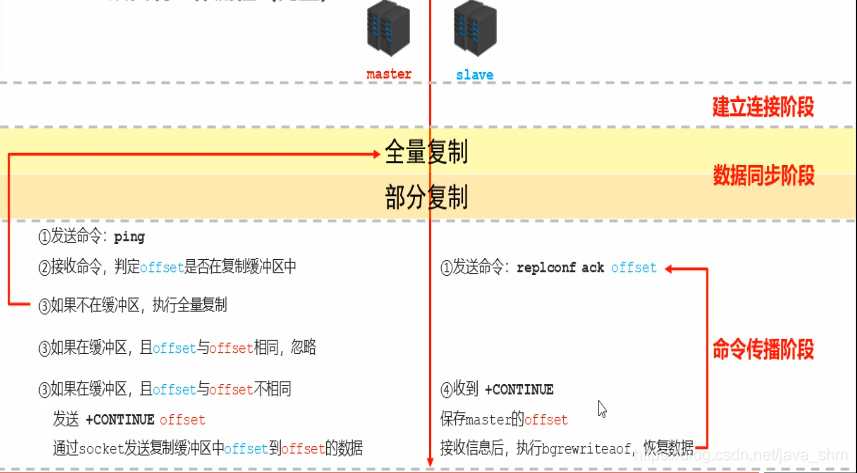
主从复制过程大体可以分为3个阶段

  • 建立连接阶段(即准备阶段)
  • 数据同步阶段
  • 命令传播阶段

2.阶段一:建立连接阶段

建立slave到master的连接,使master能够识别slave,并保存slave端口号

2.1 建立连接阶段工作流程
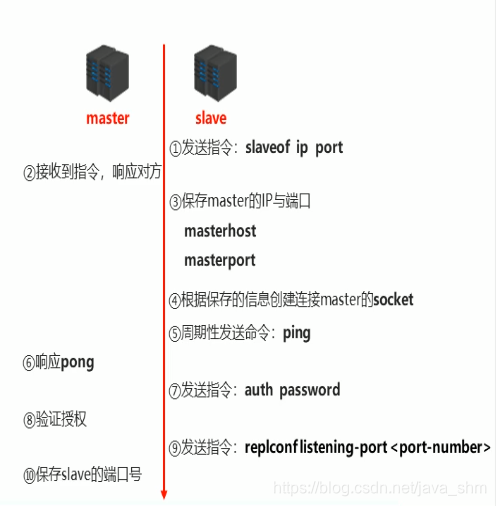
  • 步骤1:设置master的地址和端口,保存master信息
  • 步骤2:建立socket连接
  • 步骤3:发送ping命令(定时器任务)
  • 步骤4:身份验证
  • 步骤5:发送slave端口信息

至此,主从连接成功!

2.2 状态

  • slave:保存master的地址与端口
  • master:保存slave的端口
  • 总体:之间创建了连接的socket

2.3 主从连接(slave连接master)

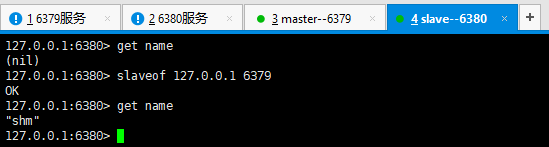
方式一:客户端发送命令

slaveof <masterip> <masterport>
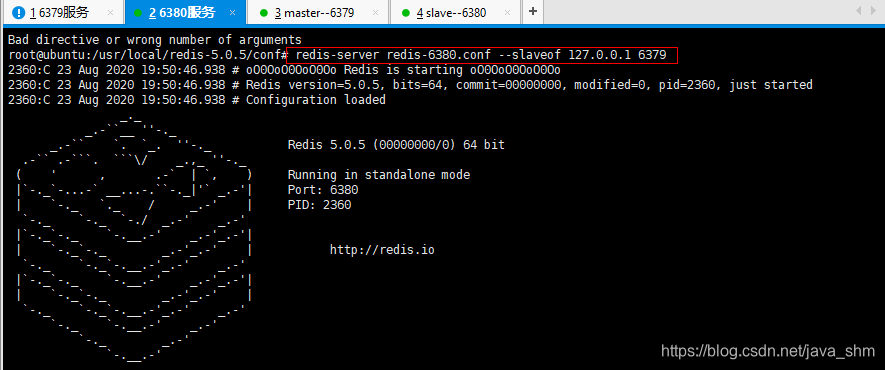
方式二:启动服务器参数

redis-server --slaveof <masterip> <masterport>
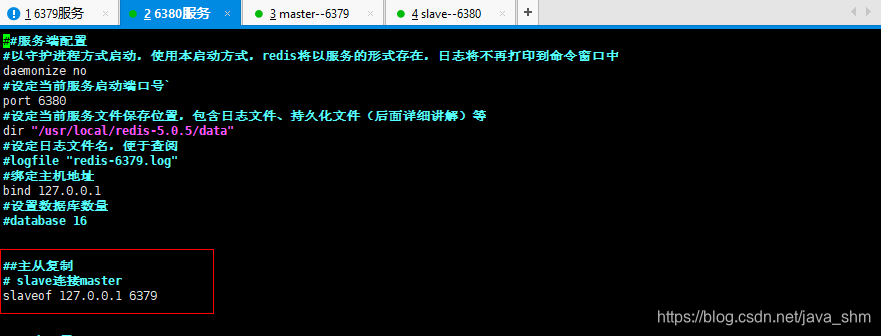
方式三:服务器配置

slaveof <masterip> <masterport>
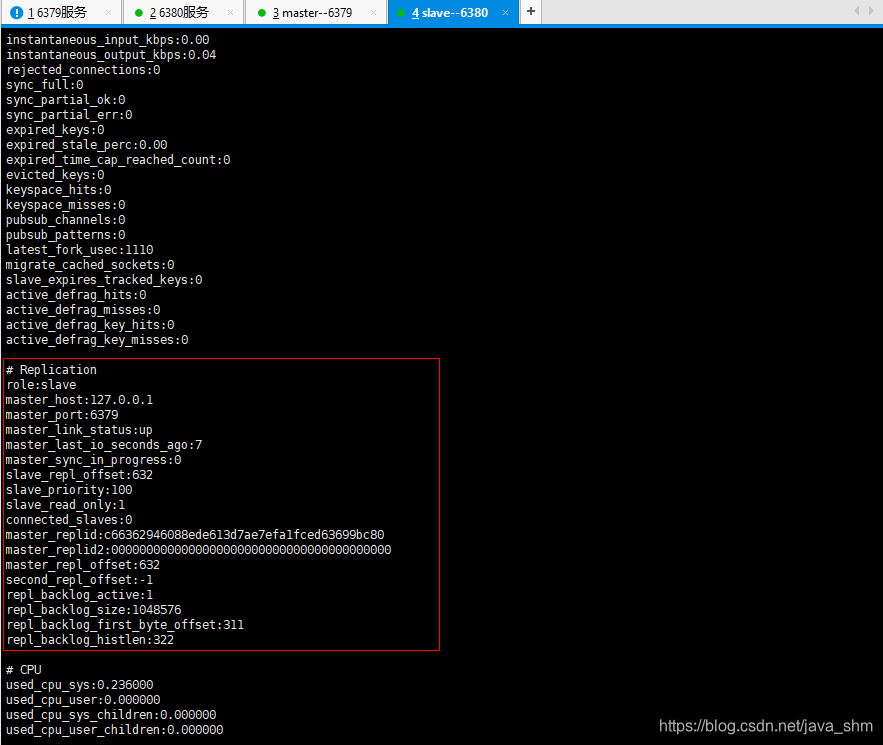
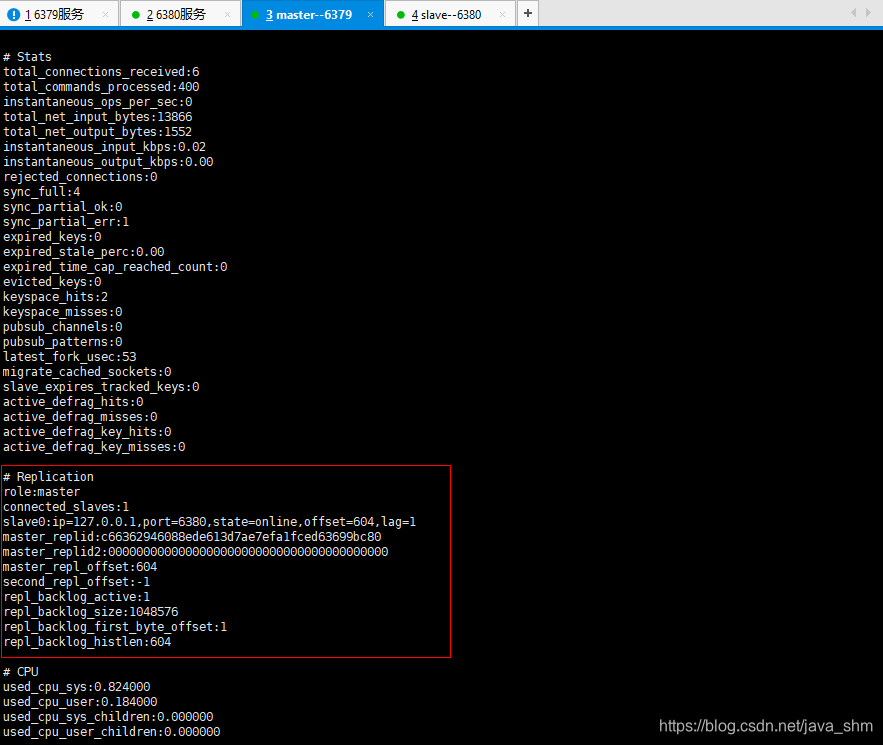
2.4 客服端信息

命令:info

slave系统信息
master系统信息  info命令
2.5 主从断开连接

 客户端发送命令

slaveof no one

说明:slave断开连接后,不会删除已有数据,只是不再接受master发送的数据

2.6 授权访问

master客户端发送命令设置密码

requirepass <password>

master配置文件设置密码

config set requirepass <password>
config get requirepass

slave客户端发送命令设置密码

auth <password>

slave配置文件设置密码

masterauth <password>

slave启动服务器设置密码

redis-server –a <password>

3.阶段二:数据同步阶段工作流程

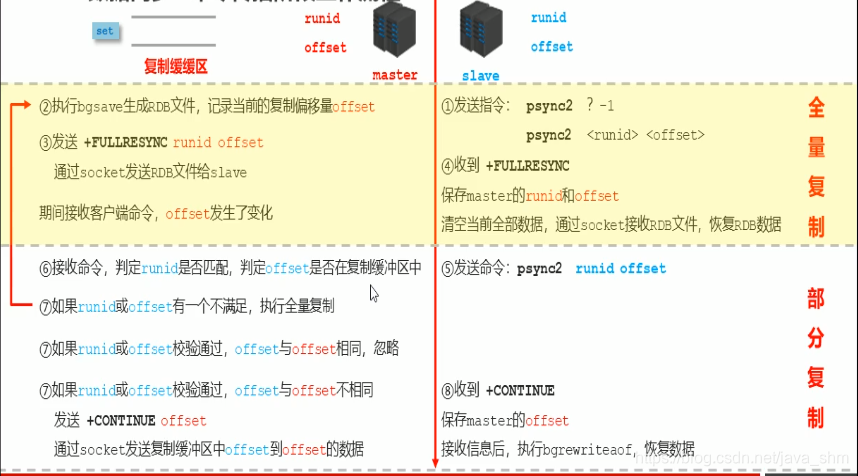
  • 在slave初次连接master后,复制master中的所有数据到slave
  • 将slave的数据库状态更新成master当前的数据库状态

3.1 工作流程
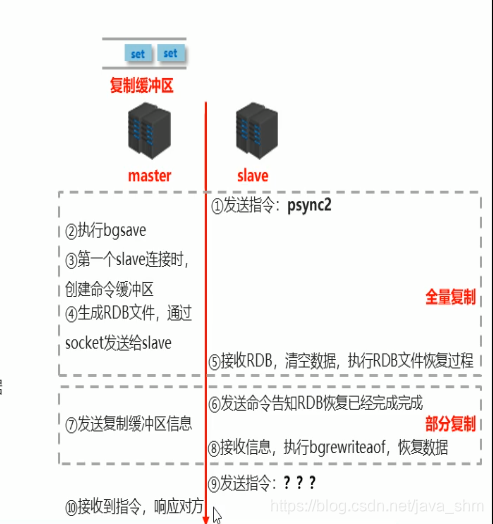
步骤1:请求同步数据
步骤2:创建RDB同步数据
步骤3:恢复RDB同步数据
步骤4:请求部分同步数据
步骤5:恢复部分同步数据
至此,数据同步工作完成!

3.2 状态

  • slave:具有master端全部数据,包含RDB过程接收的数据
  • master:保存slave当前数据同步的位置

总体:之间完成了数据克隆

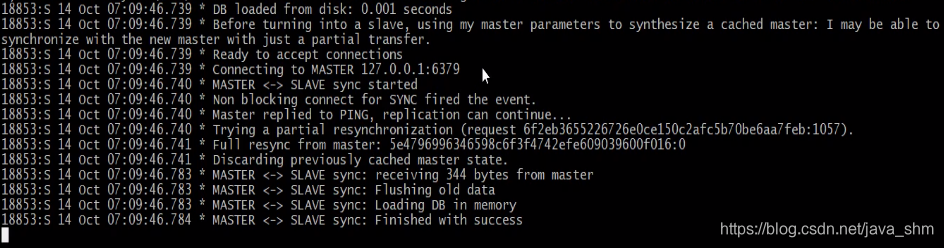
3.3 启动日志信息

6379服务器--master
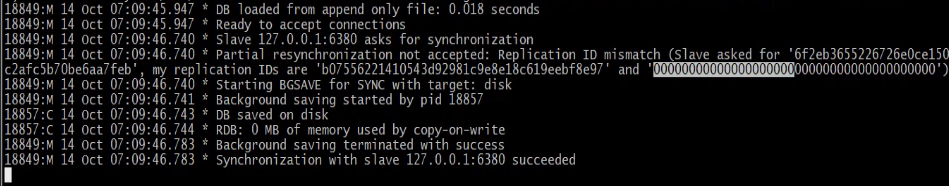
6380服务器--slave
3.4 数据同步阶段master说明

#复制缓冲区大小设定
repl-backlog-size 1mb
  • 如果master数据量巨大,数据同步阶段应避开流量高峰期,避免造成master阻塞,影响业务正常执行
  • 复制缓冲区大小设定不合理,会导致数据溢出。如进行全量复制周期太长,进行部分复制时发现数据已经存在丢失的情况,必须进行第二次全量复制,致使slave陷入死循环状态。
  • master单机内存占用主机内存的比例不应过大,建议使用50%-70%的内存,留下30%-50%的内存用于执行bgsave命令和创建复制缓冲区

3.5 数据同步阶段slave说明

#关闭此期间的对外服务
slave-serve-stale-data yes|no
  • 为避免slave进行全量复制、部分复制时服务器响应阻塞或数据不同步,建议关闭此期间的对外服务
  • 数据同步阶段,master发送给slave信息可以理解master是slave的一个客户端,主动向slave发送命令
  • 多个slave同时对master请求数据同步,master发送的RDB文件增多,会对带宽造成巨大冲击,如果master带宽不足,因此数据同步需要根据业务需求,适量错峰
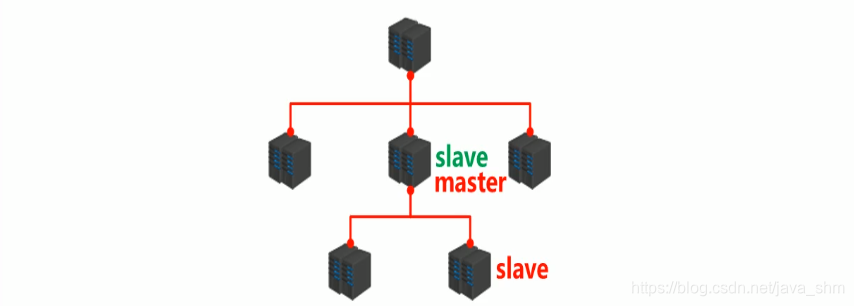
  • slave过多时,建议调整拓扑结构,由一主多从结构变为树状结构,中间的节点既是master,也是slave。注意使用树状结构时,由于层级深度,导致深度越高的slave与最顶层master间数据同步延迟较大,数据一致性变差,应谨慎选择

4.阶段三:命令传播阶段

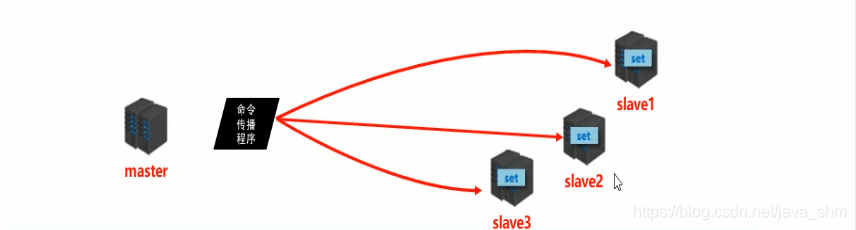
  • 当master数据库状态被修改后,导致主从服务器数据库状态不一致,此时需要让主从数据同步到一致的状态,同步的动作称为命令传播
  • master将接收到的数据变更命令发送给slave,slave接收命令后执行命令

4.1 命令传播阶段的部分复制

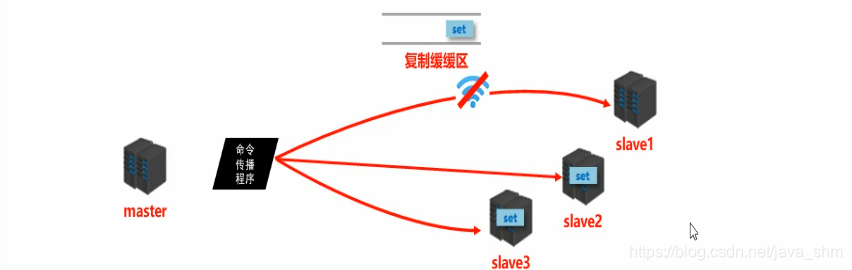
命令传播阶段出现了断网现象

  • 网络闪断闪连                  忽略 
  • 短时间网络中断               部分复制
  • 长时间网络中断               全量复制

部分复制的三个核心要素

  • 服务器的运行 id(run id)
  • 主服务器的复制积压缓冲区
  • 主从服务器的复制偏移量

4.2 服务器运行ID(runid)

  • 概念:服务器运行ID是每一台服务器每次运行的身份识别码,一台服务器多次运行可以生成多个运行id
  • 组成:运行id由40位字符组成,是一个随机的十六进制字符. 例如:fdc9ff13b9bbaab28db42b3d50f852bb5e3fcdce
  • 作用:运行id被用于在服务器间进行传输,识别身份如果想两次操作均对同一台服务器进行,必须每次操作携带对应的运行id,用于对方识别
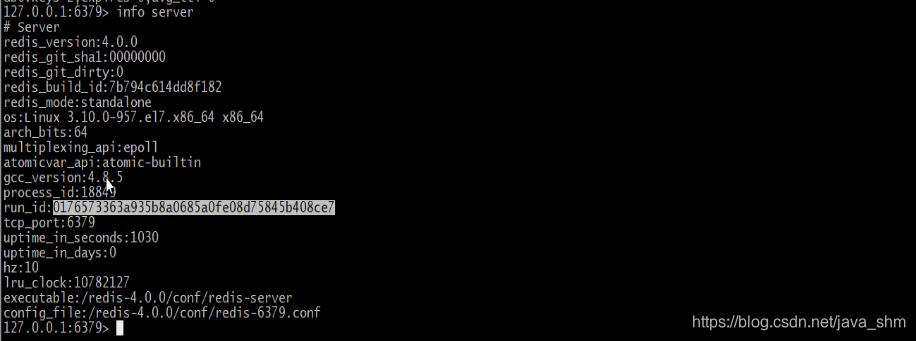
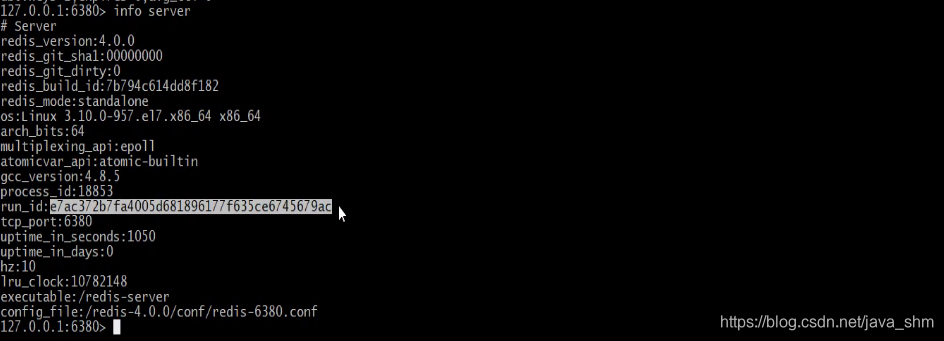
  • 实现方式:运行id在每台服务器启动时自动生成的,master在首次连接slave时,会将自己的运行ID发送给slave,slave保存此ID,通过info Server命令,可以查看节点的runid

master运行信息
slave运行信息
4.3 复制缓冲区
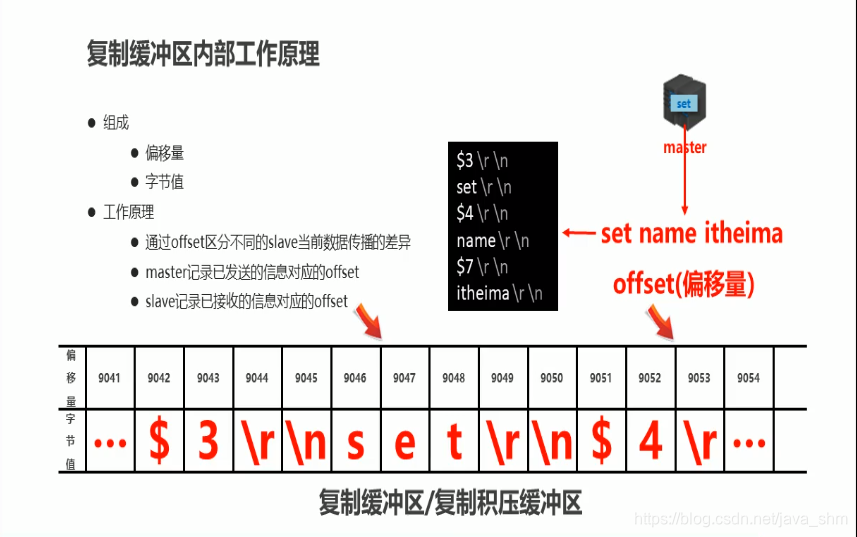
概念:复制缓冲区,又名复制积压缓冲区,是一个先进先出(FIFO)的队列,用于存储服务器执行过的命令,每次传播命令,master都会将传播的命令记录下来,并存储在复制缓冲区

复制缓冲区默认数据存储空间大小是1M,由于存储空间大小是固定的,当入队元素的数量大于队列长度时,最先入队的元素会被弹出,而新元素会被放入队列

由来:每台服务器启动时,如果开启有AOF或被连接成为master节点,即创建复制缓冲区

作用:用于保存master收到的所有指令(仅影响数据变更的指令,例如set,select)

数据来源:当master接收到主客户端的指令时,除了将指令执行,会将该指令存储到缓冲区中
4.4 主从服务器复制偏移量(offset)

概念:一个数字,描述复制缓冲区中的指令字节位置
分类:

  •  master复制偏移量:记录发送给所有slave的指令字节对应的位置(多个)
  •  slave复制偏移量:记录slave接收master发送过来的指令字节对应的位置(一个)

数据来源:

  • master端:发送一次记录一次
  • slave端:接收一次记录一次

作用:同步信息,比对master与slave的差异,当slave断线后,恢复数据使用

5 数据同步+命令传播阶段工作流程
6.心跳机制

进入命令传播阶段候,master与slave间需要进行信息交换,使用心跳机制进行维护,实现双方连接保持在线

master心跳:

  • 指令:PING
  • 周期:由repl-ping-slave-period决定,默认10秒
  • 作用:判断slave是否在线
  • 查询:INFO replication 获取slave最后一次连接时间间隔,lag项维持在0或1视为正常

slave心跳任务

  • 指令:REPLCONF ACK {offset}
  • 周期:1秒
  • 作用1:汇报slave自己的复制偏移量,获取最新的数据变更指令
  • 作用2:判断master是否在线

心跳阶段注意事项:

#slave数量少于2个,或者所有slave的延迟都大于等于10秒时,强制关闭master写功能,停止数据同步
min-slaves-to-write 2
min-slaves-max-lag 8
  • 当slave多数掉线,或延迟过高时,master为保障数据稳定性,将拒绝所有信息同步操作
  • slave数量由slave发送REPLCONF ACK命令做确认
  • slave延迟由slave发送REPLCONF ACK命令做确认


7.主从复制工作流程(完整)
三.主从复制常见问题

1.频繁的全量复制(1)

伴随着系统的运行,master的数据量会越来越大,一旦master重启,runid将发生变化,会导致全部slave的
全量复制操作

内部优化调整方案:
1) master内部创建master_replid变量,使用runid相同的策略生成,长度41位,并发送给所有slave
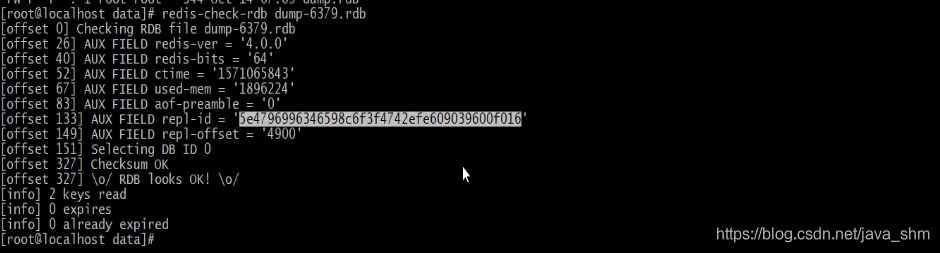
2) 在master关闭时执行命令 shutdown save,进行RDB持久化,将runid与offset保存到RDB文件中

  • repl-id repl-offset
  • 通过redis-check-rdb命令可以查看该信息

3) master重启后加载RDB文件,恢复数据
     重启后,将RDB文件中保存的repl-id与repl-offset加载到内存中

  • master_repl_id = repl master_repl_offset = repl-offset
  • 通过info命令可以查看该信息

作用:
本机保存上次runid,重启后恢复该值,使所有slave认为还是之前的master

2.频繁的全量复制(2)

  • 问题现象:网络环境不佳,出现网络中断,slave不提供服务
  • 问题原因:复制缓冲区过小,断网后slave的offset越界,触发全量复制
  • 最终结果:slave反复进行全量复制
  • 解决方案:修改复制缓冲区大小
#复制缓冲区大小
repl-backlog-size 1mb

建议设置如下:

  • 测算从master到slave的重连平均时长second
  • 获取master平均每秒产生写命令数据总量write_size_per_second
  • 最优复制缓冲区空间 = 2 * second * write_size_per_second

3.频繁的网络中断(1)

问题现象

  • master的CPU占用过高 或 slave频繁断开连接

问题原因

  • slave每1秒发送REPLCONF ACK命令到master
  • 当slave接到了慢查询时(keys * ,hgetall等),会大量占用CPU性能
  • master每1秒调用复制定时函数replicationCron(),比对slave发现长时间没有进行响应

最终结果

  • master各种资源(输出缓冲区、带宽、连接等)被严重占用

解决方案

  • 通过设置合理的超时时间,确认是否释放slave
#该参数定义了超时时间的阈值(默认60秒),超过该值,释放slave
repl-timeout 60

4.频繁的网络中断(2)

问题现象

  • slave与master连接断开

问题原因

  • master发送ping指令频度较低
  • master设定超时时间较短
  • ping指令在网络中存在丢包

解决方案

  • 提高ping指令发送的频度
#超时时间repl-time的时间至少是ping指令频度的5到10倍,否则slave很容易判定超时
repl-ping-slave-period

5. 数据不一致

问题现象

  • 多个slave获取相同数据不同步

问题原因

  • 网络信息不同步,数据发送有延迟

解决方案

  • 优化主从间的网络环境,通常放置在同一个机房部署,如使用阿里云等云服务器时要注意此现象
  • 监控主从节点延迟(通过offset)判断,如果slave延迟过大,暂时屏蔽程序对该slave的数据访问
#开启后仅响应info、slaveof等少数命令(慎用,除非对数据一致性要求很高
slave-serve-stale-data yes|no


申明:内容来自网络,仅供学习使用
参考:http://yun.itheima.com/course/611.html?stt
Android11车机系统海外项目资源包RRO方案优化 本文介绍了汽车设置应用如何通过Android RRO(运行时资源叠加)方案实现多车型差异化资源管理。针对不同车型(国内/海外、轿车/SUV)和配置(方向盘、轮毂等),采用产品变体(productFlavors)构建不同APK版本,并通过JSON配置文件动态启用对应资源包。系统根据车辆下线配置自动匹配适用的资源叠加包,解决了硬编码判断带来的维护问题。该方案实现了资源的高效复用,同时支持灵活配置多种车型组合,为汽车行业多车型共平台开发提供了可扩展的技术实现。 阅读详情

相关推荐

[c语言]用辗转相除法求最大公约数,递归和不递归两种

在c语言的学习中必然会遇到求两个数之间的最大公约数的题目,那么对于其他经典方法,最简便快捷的方式就是利用辗转相除法 辗转相除法又叫做欧几里得算法,目的是为了求两个正整数的最大公约数 定理:gcd(a,b) = gcd(b ,a%b) //在这里用(a,b)表示a和b的最大公约数证明:a可以表示成a = kb + r,则r = a %b 假设d是a,b的一个公约数,则有 d|a, d|b,而r = a - kb,因此d|r //这里的"|"的意思是 :d是b的因数 ,d是a的因数 因此d...

ZZRBlogger的博客 1万+

redis的主从复制

redis的复制是主节点以快照的形式发给从节点,这是自动完成的, 从主节点发送给从节点有两种机制, 1 将内存中的快照直接发送给从节点 同步完成 2 将快照先写到磁盘中,再从磁盘中慢慢传给从服务器 主机节点读写,而从节点只读 Redis-claster 集群,3.0之后,将多个节点构成一个集群,无中心节点的集群 ,这要求客户端有客户发现功能, 复制: 特点:   一个Master...

weixin_30764137的博客 99

反激系列-详细到每个容阻的原理之RCD吸收(1)

1、漏感尖峰电压会被RCD吸收,漏感能量一定,电容越大,电容充电的电压就越低,吸收能力就越强,MOS漏极的电压就越低。2、在漏感能力释放完之后(这个过程一般只有一个周期的3%时间),是要通过R1释放掉电容吸收的能量的,把电容的电压降下来方便下一次漏感尖峰来之前再进行吸收。3、电容容量和电阻需要合理搭配,容量足够即可,足够能吸收漏感尖峰电压,不至于超过MOS耐压。电阻需要足够小,小到在放电阶段把电容电压下降到MOS的电压平台。

Cuxiaoweiba的博客 3万+

Redis6 搭建主从集群架构

我们计划是在一台虚拟机里去部署三个Redis实例来模拟主从集群,那要想在一台虚拟机要准备三个实例,我们就必须得准备三个不同的配置文件和目录,让他们分别去运行,互相不干扰。其实主从的搭建非常的简单,就是你启动三个实例,我们因为是在同一个机器下,所以要改端口什么的,如果你是在不同机器,就不用去改端口之类的东西了,直接咔咔启动三台就行了,然后在从节点上执行命令就行了。要在同一台虚拟机开启3个实例,必须准备三份不同的配置文件和目录,配置文件所在目录也就是工作目录。主节点做写操作,从节点做读操作。

那就这样吧~ 1650

Rust 与 C/C++:Rust 比 C/C++ 更好还是只是“技能问题”?

对于许多嵌入式系统开发人员而言,的崛起似乎掀起了一股不小的浪潮,特别是在相较于传统的语言,Rust的“内存安全”优势让人眼前一亮。然而,是否可以将Rust作为C/C++的替代品?或者说,Rust是否真的比C/C++更好,抑或它只是一个“技能问题”呢?在嵌入式开发的领域,我观察到,尽管Rust在一些高性能、内存安全敏感的场景中受到了广泛推崇,但它在实际应用中的普及度,特别是在嵌入式领域,依然有限。今天,我会从多个角度探讨这个问题,并且分享一些对于Rust、C/C++以及嵌入式系统开发的个人见解。

qq_63315166的博客 1299

lammps 案例:高熵合金FeNiCrCoCu建模及拉伸模拟

高熵合金力学性能模拟包括拉伸、剪切、摩擦等模拟,本文以高熵合金FeNiCrCoCu为例介绍高熵合金建模及拉伸过程模拟。 FeNiCrCoCu原子数量比为1:1:1:1:1 高熵合金的拉伸与单晶拉伸过程类似,主要包含以下步骤: 1.建模 高熵合金含有原子类型较多,建模时,一般以含量最多的原子为主建立初始模型。 使用set type/ratio或者set type/fraction的方式按一定比例替换为其它合金原子。 如随机选择20%的原子1,将其转换为原子2: set type 1 type/ratio 2

lammps_jiayou的博客 6067

Redis6.X 主从配置

Redis主从复制 一主二从架构搭建

qq_41709084的博客 509

Xilinx平台SRIO介绍(一)RapidIO协议介绍

菜鸟到老鸟:会用工具; 老鸟到大佬:深入理解原理。 ——FPGA大叔·沃自己硕得

数字IC/FPGA杂货铺,找一找,或许有你想要的~ 1万+

Redis(六) 主从模式

主从模式配置

weixin_43189971的博客 589

PCL 中实现平面模型分割【2026最新版】

RANSAC分割平面。博客长期更新,最近一次更新时间为:2026年5月4日。

点云侠的博客 38万+

ShengBTE热导计算:利用ShengBTE计算热导显示NAN的原因是什么?算出的热导不随平均声子自由程变化

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值 。

**My Coding Family** 962

redis6主从复制及集群

redis主从复制和集群的搭建方式。

一条咸鱼的博客 1767

HotSpot G1 GC 的分区记账、SATB 并发标记与停顿目标调优解析

线上GC毛刺该调停顿目标、加大新生代还是换收集器?本文从HotSpot G1的设计出发,梳理分区与巨型对象、卡表与记忆集、写屏障与细化线程、停顿预测、SATB并发标记、自适应IHOP、混合回收规则及Full GC兜底,并注明JDK8至JDK27的版本差异。文中在JDK8与JDK17上实测:停顿目标从200ms降到20ms,伊甸区缩小四成、P99下降但仍超目标;巨型对象会反复触发又撤销并发标记;JDK17并行Full GC平均停顿约为JDK8的三成。最后给出日志解读、参数清单、调优流程与选型。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 170万+

Redis主从复制原理

一、为什么需要主从复制: 1、单台Redis节点的局限性: (1)单节点的Redis能够支撑QPS大概在5万左右,如果上千万的用户访问,Redis就承载不了,成为了高并发的瓶颈。 (2)内存上,单个Redis的内存不宜过大,内存过大会导致主从同步时全量同步时间过长,而且在实例重启恢复时也会消耗很长的数据加载时间,一般控制在10G以内即可。 (2)CPU 的利用率上,单个 Redis 实例只能利用单个核心,这单个核心在面临海量数据的存取和管理工作时压力会非常大。 四、Redis主从复..

张维鹏的博客 3万+

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Redis的主从复制

redis主从复制的介绍

m0_65558082的博客 2489

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Redis的主从复制原理

十八岁男孩爆肝Redis极品文章,必须三连奥里给爆赞

h123456789999999的博客 3728

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

Redis主从复制机制详解

1、什么是主从复制?2、为什么要使用主从复制?redis-server单点故障。单节点QPS有限。3、主从复制应用场景分析?读写分离场景,规避redis单机瓶颈故障切换,master出问题后还有slave节点可以使用。

lingbomanbu_lyl的博客 1919

你不知道的redis六-redis主从复制,因为该命令redis作者曾摊上事?

JVM,JAVA集合,JAVA多线程并发,JAVA基础,Spring原理,微服务,Netty与RPC,网络,日志,Zookeeper,Kafka,RabbitMQ,Hbase,MongoDB,Cassandra,设计模式,负载均衡,数据库,一致性哈希,JAVA算法,数据结构,加密算法,分布式缓存,Hadoop,Spark,Storm,YARN,机器学习,云计算…**,网络,日志,Zookeeper,Kafka,RabbitMQ,Hbase,

2401_83816794的博客 989

六、Redis 主从复制 Replicaof、哨兵 Sentinel

文章目录一、Replicaof 主从复制1. 配置主从复制:1). 命令行方式2). 配置方式(永久生效)2. 其它设置3. Slave持久化4. 无硬盘复制5. 增量复制二、Sentinel 哨兵1. 基本配置1). 配置 sentinel.conf2). 运行Sentinel2. 选举优先规则,选择优先级最高的 slave,(通过slave-priority)来配置3. 每个 Sentinel 都需要定期执行的任务4. 主观下线和客观下线:5. sentinel 选举规则 一、Replicaof 主从复

huanghuitan的博客 6811

Redis 主从复制

Redis 主从复制与哨兵模式的详细介绍与使用

Mwt258的博客 3269

redis主从复制

redis主从复制,是指将一台Redis服务器的数据,复制到其他的Redis服务器。前者称为主节点(master),后者称为从节点(slave)。数据的复制是单向的,只能由主节点到从节点。 Redis Replication是一种 master-slave 模式的复制机制,这种机制使得 slave 节点可以成为与 master 节点完全相同的副本,可以采用一主多从或者级联结构。

misakivv的博客 1241

深入理解Redis(六)----Redis主从复制

和Mysql主从复制的原因一样,Redis虽然读取写入的速度都特别快,但是也会产生读压力特别大的情况。为了分担读压力,Redis支持主从复制,Redis的主从结构可以采用一主多从或者级联结构,Redis主从复制可以根据是否是全量分为全量同步和增量同步。下图为级联结构。Redis全量复制一般发生在Slave初始化阶段,这时Slave需要将Master上的所有数据都复制一份。完成上面几个步骤后就完成了从服务器数据初始化的所有操作,从服务器此时可以接收来自用户的读请求。Redis增量复制是指增量复制的过程主要是。

pingguocu3的博客 1144

Docker部署Redis主从复制

Redis主从复制,是指将一台Redis服务器的数据,复制到其他的Redis服务器。前者称为主节点(master),后者称为从节点(slave),数据的复制是单向的,只能由主节点到从节点。 默认情况下,每台Redis服务器都是主节点;且一个主节点可以有多个从节点(或没有从节点),但一个从节点只能有一个主节点。docker部署redis,docker部署redis主从复制

2057

【Redis】Redis 主从复制

Redis 主从复制的流程及其原理。

在平淡的日子里寻找存在的价值 3144

(六)Redis主从复制以及哨兵模式

(1)配从库不配主,从库配置:slaveof 主库IP 主库端口(2)查看redis的配置信息:info replicationSentinel(哨兵)是用于监控Redis集群中Master状态的工具,是Redis高可用解决方案,哨兵可以监视一个或者多个redis master服务,以及这些master服务的所有从服务。某个master服务宕机后,会把这个master下的某个从服务升级为master来替代已宕机的master继续工作。

星星学霸的博客 1134

【redis】主从复制

Redis的单机模式仅部署单个实例,一旦节点宕机或网络故障,所有依赖Redis的服务将不可用,这就是所谓的单点故障问题。单节点需承担全部读写请求,并发量高时可能成为性能瓶颈。单节点受限于物理内存容量,无法突破内存物理上限存储海量数据。所有请求都怼到一个实例,磁盘IO、网络IO、带宽、CPU等资源都会成为瓶颈。注意:读写分离并不是Redis自带,需要客户端手动实现。

qq_35485206的博客 1050
上一篇: redis 高阶(五)高级数据类型
下一篇: redis 高阶(七)哨兵模式
夜未眠shm
博客等级 码龄14年 15粉丝 101原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值