VGG16模型原理讲解-手写代码解析VGG16模型

VGG网络模型详解以及代码实现 VGG网络模型详解以及代码实现一、背景1. VGG原理二、VGG网络模型详解及代码实现1. VGG网络模型详解2. 代码实现三、参考资料: 一、背景 VGGNet是在2014年由Karen Simonyan和Andrew Zisserman提出的,网络模型包括VGG-11、VGG-13、VGG-16以及VGG-19,其中VGG-16和VGG-19在分类和定位任务上效果最好,因此作者在2014年ImageNet Challenge上获得分类第二和定位第一的网络。 论文地址:VERY DEEP CONVOLUT 阅读详情

核心创新与影响

  1. 3×3卷积堆叠:2个3×3=5×5感受野,3个3×3=7×7,参数更少、深度更深、特征更抽象。计算成本。假设输入输出channel均为C,3个3x3参数个数为3x(3x3xCxC)=27xC²,一个7x7参数个数为7x7xCxC=49xC²,因此用3个3x3的卷积层等于一个7x7的卷积层但是节省近一半的参数计算量。
  2. 深层特征提取:从8层到16/19层,错误率显著下降,网络深度至关重要:16–19 层显著优于浅层(如 8 层 AlexNet)
  3. 简洁通用:模块化设计,易复现、易迁移,仅使用 3×3 卷积 + 2×2 最大池化,无复杂模块,‌易于理解、复现与修改‌
  4. 局限性:参数量大、训练慢、显存占用高;

原始论文PDF

论文地址:https://arxiv.org/pdf/1409.1556.pdf
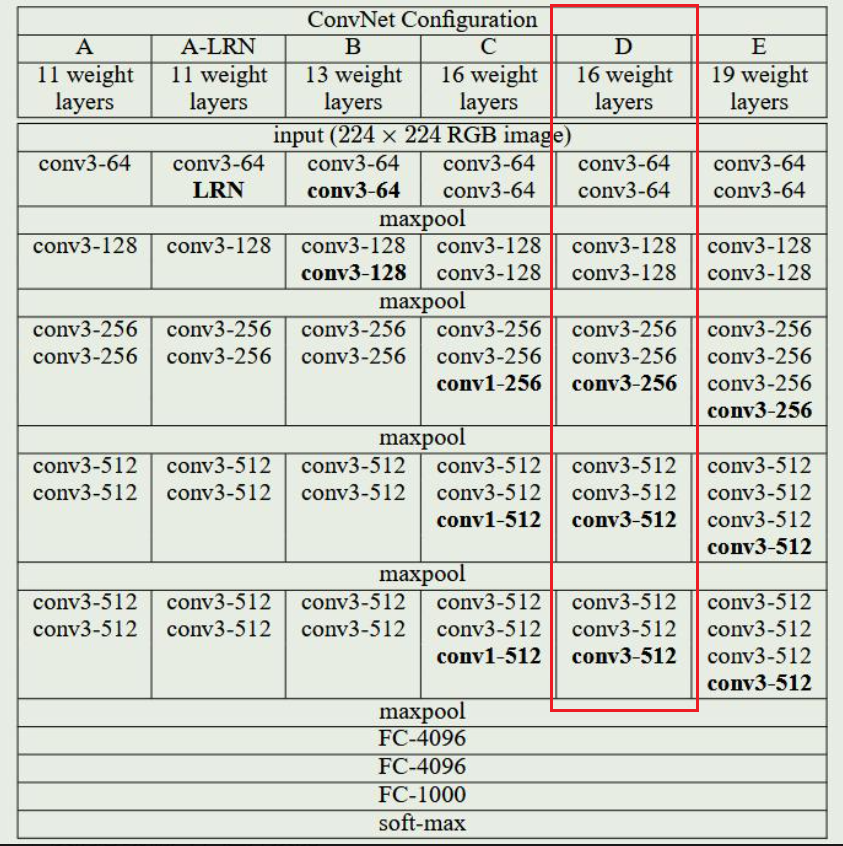
在这里插入图片描述

VGG16 模型结构(16层:13 conv + 3 FC)

输入:224×224 RGB 图像,

1)卷积块(5组,每组 Conv→ReLU→MaxPool)
  • Block1:2×Conv3×3,64 → ReLU → MaxPool2×2
    输出:224→112,通道64
  • Block2:2×Conv3×3,128 → ReLU → MaxPool2×2
    输出:112→56,通道128
  • Block3:3×Conv3×3,256 → ReLU → MaxPool2×2
    输出:56→28,通道256
  • Block4:3×Conv3×3,512 → ReLU → MaxPool2×2
    输出:28→14,通道512
  • Block5:3×Conv3×3,512 → ReLU → MaxPool2×2
    输出:14→7,通道512
2)全连接层(FC)
  • FC1:7×7×512 → 4096,ReLU,Dropout
  • FC2:4096 → 4096,ReLU,Dropout
  • FC3:4096 → 1000(ImageNet 类别),Softmax

参数计算
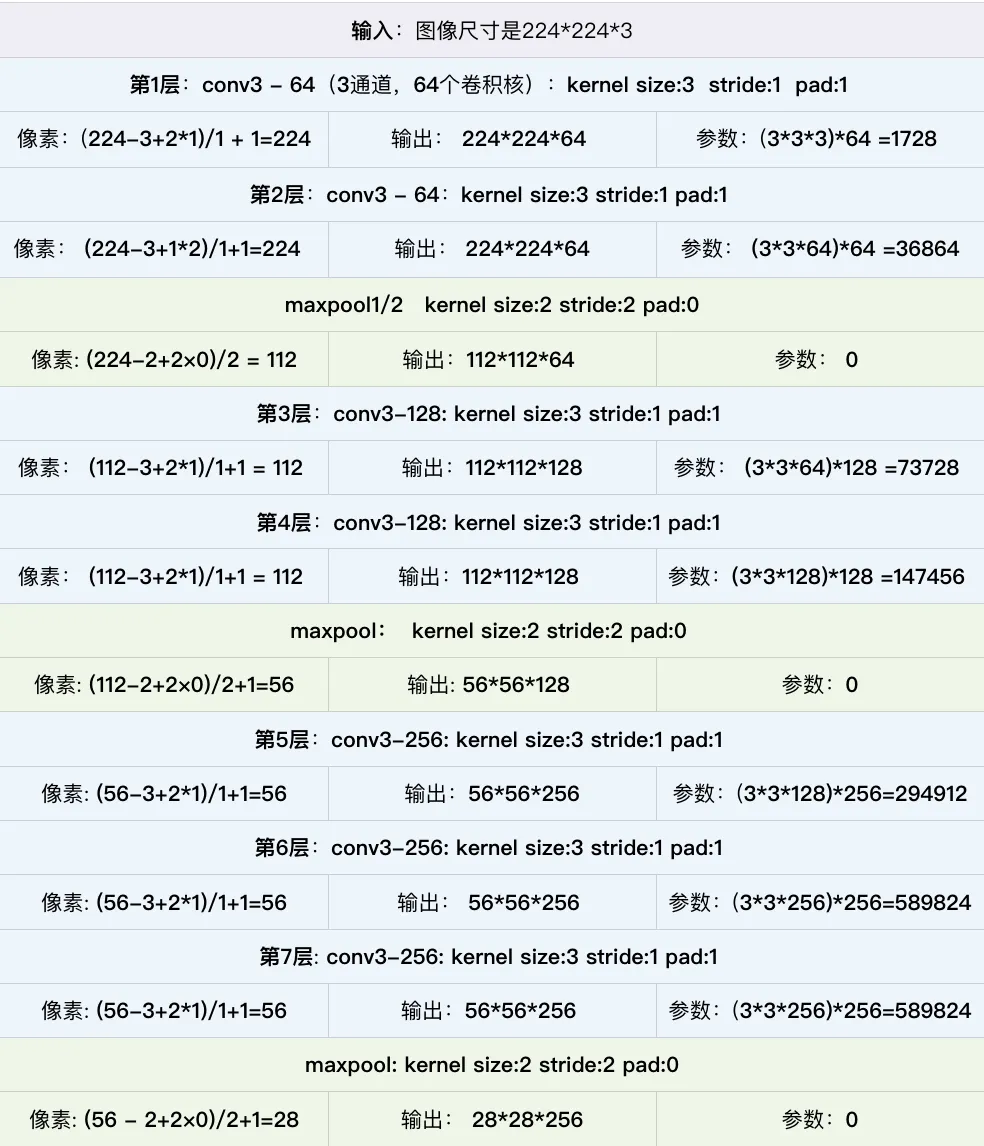
在这里插入图片描述

论文模型复现

使用 配置D(VGG16):13 conv(全 3×3)+3 FC,16 层(常用)

import torch
import torch.nn as nn
# 使用 配置D(VGG16):13 conv(全 3×3)+3 FC,16 层(常用)
class VGG16(nn.Module):
    def __init__(self, num_classes=1000):
        super().__init__()
        self.features = nn.Sequential(
            # Block1
            nn.Conv2d(in_channels=3, out_channels=64, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=64, out_channels=64, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
            # Block2
            nn.Conv2d(in_channels=64, out_channels=128, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=128, out_channels=128, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
            # Block3
            nn.Conv2d(in_channels=128, out_channels=256, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=256, out_channels=256, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=256, out_channels=256, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
            # Block4
            nn.Conv2d(in_channels=256, out_channels=512, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=512, out_channels=512, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=512, out_channels=512, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
            # Block5
            nn.Conv2d(in_channels=512, out_channels=512, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=512, out_channels=512, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(in_channels=512, out_channels=512, kernel_size=3, stride=1, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )
        self.classifier = nn.Sequential(
            nn.Linear(in_features=512*7*7, out_features=4096),
            nn.ReLU(inplace=True),
            nn.Dropout(),
            nn.Linear(in_channels=4096, out_features=4096),
            nn.ReLU(inplace=True),
            nn.Dropout(),
            nn.Linear(in_channels=4096, out_features=num_classes),
        )

    def forward(self, x):
        x = self.features(x)
        x = torch.flatten(x, 1)
        x = self.classifier(x)
        return x

# 测试
model = VGG16()
x = torch.randn(1, 3, 224, 224)
print(model(x).shape)  # torch.Size([1, 1000])

VGG16、MobileNet、ResNet50 神经网络学习小记录61——Tensorflow2 搭建常见分类网络平台(VGG16、MobileNet、ResNet50) 学习前言源码下载分类网络的常见形式分类网络介绍1、VGG16网络介绍2、MobilenetV1网络介绍3、ResNet50网络介绍a、什么是残差网络b、什么是ResNet50模型 分类网络的训练1、LOSS介绍2、利用分类网络进行训练a、数据集的准备b、数据集的处理c、开始网络训练 学习前言 tf2的分类代码也要做一下。 源码下载 https://g 阅读详情

相关推荐

pytorch实战3:基于pytorch复现VGG16

pytorch实战3:基于pytorch复现VGG16

weixin_46676835的博客 6067

深度学习-VGG16原理详解

1.网络结构 根据卷积核大小和卷积层数,VGG共有6中配置,分别为A,A-LRN,B,C,D,E,其中D和E两种最为常用,即i我们所说的VGG16和VGG19。看下图红色框所示。具体为: 1. 卷积-卷积-池化-卷积-卷积-池化-卷积-卷积-卷积-池化-卷积-卷积-卷积-池化-卷积-卷积-卷积-池化-全连接-全连接-全连接 。 2. 通道数分别为64,1258,512,512,512,4096,4...

weixin_43496706的博客 5万+

利用PyTorch实现VGG16

import torch import torch.nn as nn import torch.nn.functional as F class VGG16(nn.Module): def __init__(self): super(VGG16, self).__init__() # 3 * 224 * 224 ...

qq_41563738的博客 1万+

VGG16模型详解

VGG16作为深度学习发展历程中的重要里程碑,强调了通过增加网络深度和一致性设计来提取图像特征。它的成功启发了后续更复杂的网络架构和方法,并在图像分类等任务中取得了重要成就。通过研究和实践,我们可以更好地理解VGG16的原理,并将其应用于实际问题中。VGG16是一种深度卷积神经网络,由牛津大学的研究团队于2014年开发。

m0_62919535的博客 7895

Vgg16 + Unet 介绍

VGG-16: 这个数字16,就是指在这个网络中包含 16个卷积层和全连接层,随着网络的加深,图像的高度和宽度都在以一定的规律不断缩小,每次池化后刚好缩小一半,而通道数量在不断增加,而且刚好也是在每组卷积操作后增加一倍。也就是说,图像缩小的比例和通道数增加的比例是有规律的 专注于构建卷积层的简单网络: 首先用3×3,步幅为1的过滤器构建卷积层 padding参数为same卷积中的参数, ...

Turbo_Come的博客 1万+

Keras复现VGG16及实现花卉分类

VGG网络 VGG网络是2014年ILSVRC竞赛的第二名(第一名是GoogleNet,即后来的inception),由牛津大学的计算机视觉实验组提出。原始论文地址https://arxiv.org/abs/1409.1556 VGG的出现证明了网络深度的增加可以提升模型的效果,它由一系列的卷积、池化堆叠而成,在论文中作者搭建了不同深度的6种VGG模型,命名A-E,网络深度依次加深。通常VGG16...

qq_39987952的博客 3229

深入理解VGG16模型

一、简述 VGG卷积神经网络是牛津大学计算机视觉实验室参加2014年ILSVRC(ImageNet Large Scale Visual Recognition Challenge)比赛的网络结构,为了解决ImageNet中的1000类图像分类和定位问题。实验结果是VGGNet斩获了2014年ILSVRC分类第二,定位第一,分类第一是GoogleNet模型。 想要更好的理解和掌握VGG系列的模型,...

qq_34823656的博客 2万+

【keras】走近VGG16卷积神经网络

        VGG16是一个16层的卷积神经网络模型,输入数据的维度为224*224*3,即长宽均为224像素的RGB彩色图片,VGG16模型的权重由ImageNet训练而来。由于其具有简单实用的优点,因此,在图像分类和目标检测任务中得到了较为广泛的应用。 1.卷积神经网络的基本概念 1.1卷积         简单的将其理解为一种数学运算,具体的计算过程如下图所示:       ...

XYZ 1万+

VGG16和VGG19介绍

VGG16和VGG19介绍 转载自:https://www.jianshu.com/p/e0845ecaf7f7 image.png 《Very Deep Convolutional Networks for Large-Scale Image Recognition》 arXiv:[1409.1556] Very Deep Convolutional Networks for Lar...

荷叶田田 6万+

VGG16详细原理(含tensorflow版源码)

VGG16详细原理(含tensorflow版源码)

Code_and516的博客 5313

VGG16提取图片特征

import os import numpy as np import torch import torch.nn import torchvision.models as models from torch.autograd import Variable import torch.cuda import torchvision.transforms as transforms from PIL import Image TARGET_IMG_SIZE = 224 img_to_tensor = .

gxc19971128的博客 5574

基于pytorch的VGG16模型讲解及代码实现

VGG16是牛津大学视觉几何组2014年提出的经典CNN模型,在ImageNet竞赛中表现优异。其核心特点是采用3×3小卷积核堆叠替代大卷积核(参数更少但感受野相同),构建16层深度网络(13个卷积层+3个全连接层)。模型包含5个卷积块,每块通过最大池化减半特征图尺寸,通道数从64逐步增加到512。VGG16具有结构统一(全3×3卷积+相同填充)、层次化特征提取(从边缘到语义)和优异迁移学习能力等优势,Top-5准确率达92.7%。文中还提供了基于PyTorch的猫狗分类实现代码,展示了VGG16的实际应用

2402_88406652的博客 1844

深度解析VGG16架构及应用

VGG16是由牛津大学的视觉几何组(Visual Geometry Group)提出的一种深度卷积神经网络,它在2014年的ILSVRC(ImageNet Large Scale Visual Recognition Challenge)比赛中取得了显著的成绩。VGG16的核心是通过简单的重复使用3x3的卷积核和2x2的池化层来构建深度网络。由于其简单性与有效性,VGG16成为了计算机视觉领域的经典网络架构之一。

weixin_42388898的博客 1929

VGG-16网络原理与代码

VGG模型于2014年诞生于Visual Geometry Group 实验室,是ILSVRC 2014的亚军。应用广泛,可以作为如目标检测,实例分割等骨架。通常说的VGG是VGG-16(13层卷积+3层全链接)。接下来均已VGG-16D为例子。

weixin_44776307的博客 2529

VGG16模型:图像处理深度学习的象征

在深度学习的众多模型中,VGG16模型因其简单而强大的网络结构在图像处理领域赢得了广泛的关注。自2014年由Karen Simonyan和Andrew Zisserman提出以来,VGG16模型成为了学术界和工业界的基准,并在多个视觉识别挑战赛中取得了领先地位。VGG16模型的显著特点在于其序列化的重复使用卷积核大小为3x3的卷积层和2x2的池化层,从而构建了一个深层的网络结构。特征提取是机器学习中一个核心步骤,它涉及到从原始数据中提取有助于任务执行的有用信息。

weixin_42181686的博客 1888

Isaacgym使用操作指南

Isaac Gym 是一个强大的仿真工具,特别适合那些需要进行大规模并行仿真和训练的机器人和强化学习任务。通过 GPU 加速、深度学习集成和丰富的物理仿真能力,Isaac Gym 能够显著提高仿真和训练效率,是机器人学和 AI 研究中的一大利器。

Tony Wey的博客 1万+

VGG16模型代码实现

nn.Conv2d(in_channel,64,3,1,1),#输入通道数为in_channel,输出通道数为64,卷积核大小为3x3,步长为1,填充为1。nn.Linear(num_hidden,4096),#输入大小为num_hidden,输出大小为4096,表示第一个全连接层。#self.avgpool是自适应平均池化层,可以根据输入数据的大小自动调整池化核的大小,并在不改变特征图大小的情况下进行下采样操作。#output_size=(7,7)表示得到的池化结果大小为7x7。

m0_59161923的博客 1883

AGX Orin设计-外围电路设计之一

AGX ORIN是英伟达Jetson系列中算力规格最高端的模组,其高达200TOPS/275TOPS的算力可以为各类场景提供澎湃的算力支持,本篇文章针对AGX ORIN的常规外围电路设计做分析描述。

zhiyuchenkeji的博客 4488

TensorFlow中的VGG16 介绍以及 代码

VGG是由牛津大学的K. Simonyan和A. Zisserman在“用于大规模图像识别的超深度卷积网络”一文中提出的卷积神经网络模型。。该模型在ImageNet中实现了92.7%的前5个测试精度,这是属于1000个类的超过1400万张图像的数据集。 VGG16 之前一直没找到代码,今天找到了。 关于原理,之前看过,这里就不写了。一以后有hi时间再写。 这段代码是测试代码,人...

qq_40979622的博客 3265

RK3566/RK3588 NPU性能实测:用mobilenet模型快速验证你的开发板NPU是否正常工作

本文提供了RK3566/RK3588开发板NPU性能实测指南,通过MobileNet模型快速验证NPU是否正常工作。详细介绍了环境搭建、测试资源获取、编译运行及结果分析的全流程,帮助开发者高效验证神经网络加速器功能,为后续AI应用部署奠定基础。

weixin_28826521的博客 450

【RT-DETR有效改进】利用ASF-YOLO改进特征融合层(附代码 + 详细教程)

本文给大家带来的改进机制是ASF-YOLO(发布于2023.12月份的最新机制),其是特别设计用于细胞实例分割。这个模型通过结合空间和尺度特征,提高了在处理细胞图像时的准确性和速度。在实验中,ASF-YOLO在2018年数据科学竞赛数据集上取得了卓越的分割准确性和速度,达到了0.91的box mAP(平均精度),0.887的mask mAP,以及47.3FPS的推理速度,效果非常的好,这个结构本来是用于分割的,我将其移植到了目标检测的模型上,所以其可以适用于分割和目标检测。

Snu77的博客 2296

【深度学习】PyTorch实现VGG16模型及网络层数学原理

✅ 实现VGG16网络结构✅ 在CIFAR10数据集上训练分类模型。

zq563100792的博客 1542

Android CCodec (四) Output Buffer流程分析

Android 多媒体架构 Codec2 Output Buffer

给大佬递杯卡布奇诺的博客 3266
上一篇: Git 提交规范
下一篇: PyTorch :pad_sequence、pack_padded_sequence、pad_packed_sequence 序列填充与打包详解
王_teacher
博客等级 码龄9年 118粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值