


Windows环境下的安装
下载与安装
1.访问地址: https://zookeeper.apache.org/releases.html#download下载需要的ZK版本,下载到本地后解压。
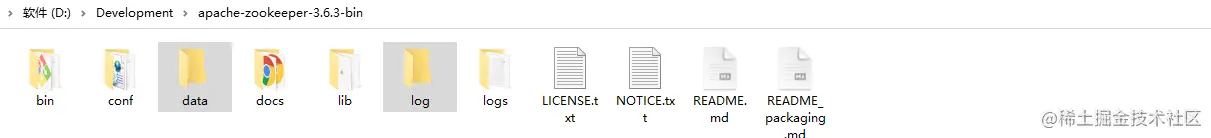
2.在解压目录下面新建一个空的 data 文件夹和 log 文件夹
配置
将 conf 目录下的 zoo_sample.cfg 文件,复制一份,重命名为 zoo.cfg
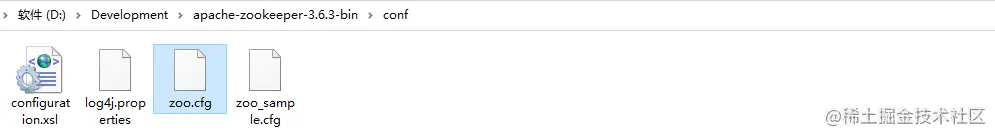
修改 zoo.cfg 配置文件,将 dataDir=/tmp/zookeeper 修改成 zookeeper 安装目录所在的 data 文件夹,再添加一条添加数据日志的配置
# The number of milliseconds of each tick
tickTime=2000
# The number of ticks that the initial
# synchronization phase can take
initLimit=10
# The number of ticks that can pass between
# sending a request and getting an acknowledgement
syncLimit=5
# the directory where the snapshot is stored.
# do not use /tmp for storage, /tmp here is just
# example sakes.
dataDir=D:\Development\apache-zookeeper-3.6.3-bin\data
dataLogDir=D:\Development\apache-zookeeper-3.6.3-bin\log
# the port at which the clients will connect
clientPort=2181
# the maximum number of client connections.
# increase this if you need to handle more clients
#maxClientCnxns=60
#
# Be sure to read the maintenance section of the
# administrator guide before turning on autopurge.
#
# http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance
#
# The number of snapshots to retain in dataDir
#autopurge.snapRetainCount=3
# Purge task interval in hours
# Set to "0" to disable auto purge feature
#autopurge.purgeInterval=1

## Metrics Providers
#
# https://prometheus.io Metrics Exporter
#metricsProvider.className=org.apache.zookeeper.metrics.prometheus.PrometheusMetricsProvider
#metricsProvider.httpPort=7000
#metricsProvider.exportJvmInfo=true
启动
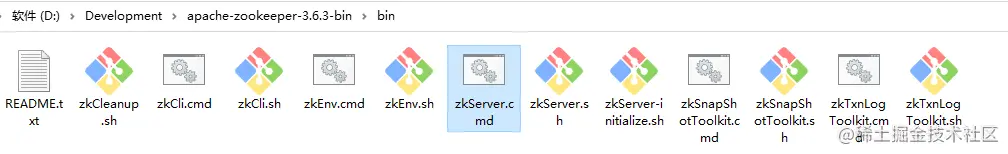
双击bin目录下的zkServer.cmd启动即可
zookeeper新版本中有个内嵌的管理控制台是通过jetty启动,会占用8080 端口
解决方法
1.修改端口
在zoo.cfg中增加admin.serverPort=没有被占用的端口号admin.serverPort=80882.修改启动脚本
在启动脚本中增加"-Dzookeeper.admin.enableServer=false""-Dzookeeper.admin.enableServer=false"Linux环境下的安装
下载与安装
访问地址: zookeeper.apache.org/releases.ht…
wget https://downloads.apache.org/zookeeper/zookeeper-3.7.0/apache-zookeeper-3.7.0-bin.tar.gz解压zookeeper
[root@administrator conf]# tar -zxvf apache-zookeeper-3.7.0-bin.tar.gz重命名
[root@administrator conf]# mv tar -zxvf apache-zookeeper-3.7.0-bin zookeeper移动zookeeper位置
[root@administrator conf]# cp zookeeper /usr/local/
配置
修改zoo_sample.cfg文件
[root@administrator conf]# cd /usr/local/zookeeper/conf
[root@administrator conf]# mv zoo_sample.cfg zoo.cfg
修改dataDir目录,改成真实输出目录
# The number of milliseconds of each tick
# 基本事件单元,以毫秒为单位。它用来控制心跳和超时,默认情况下最小的会话超时时间为两个心跳时间
tickTime=2000
# The number of ticks that the initial
# synchronization phase can take
# 用于限制follower跟随者服务器必须连接到leader领导者服务器的时限
# 多少个心跳时间内,允许其他server连接并初始化数据,如果ZooKeeper管理的数据较大,则应相应增大这个值
# 它以tickTime的倍数来表示。当超过设置倍数的tickTime时间,则连接失败
initLimit=10
# The number of ticks that can pass between
# sending a request and getting an acknowledgement
# leader与follower之间发送消息,请求和应答时间长度。
# 如果follower在设置的时间内不能与leader进行通信,那么此follower将被丢弃。
syncLimit=5
# the directory where the snapshot is stored.
# do not use /tmp for storage, /tmp here is just
# example sakes.
#dataDir=/tmp/zookeeper
#存储内存数据库快照的位置
dataDir=/usr/local/zookeeper/data
# the port at which the clients will connect
# 监听客户端连接的端口,默认是2181
clientPort=2181
# the maximum number of client connections.
# increase this if you need to handle more clients
#maxClientCnxns=60
#
# Be sure to read the maintenance section of the
# administrator guide before turning on autopurge.
#
# http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance
#
# The number of snapshots to retain in dataDir
#autopurge.snapRetainCount=3
# Purge task interval in hours
# Set to "0" to disable auto purge feature
#autopurge.purgeInterval=1

## Metrics Providers
#
# https://prometheus.io Metrics Exporter
#metricsProvider.className=org.apache.zookeeper.metrics.prometheus.PrometheusMetricsProvider
#metricsProvider.httpPort=7000
#metricsProvider.exportJvmInfo=true
创建data目录
[root@administrator conf]# cd /usr/local/zookeeper/
[root@administrator zookeeper]# mkdir data
启动
注意:zookeeper需要依赖jdk环境
[root@administrator bin]# cd /usr/local/zookeeper/bin
[root@administrator bin]# ./zkServer.sh start
/usr/bin/java
ZooKeeper JMX enabled by default
Using config: /usr/local/zookeeper/bin/../conf/zoo.cfg
Starting zookeeper ... STARTED
[root@administrator bin]#
查看启动状态
[root@administrator bin]# ./zkServer.sh status
/usr/bin/java
ZooKeeper JMX enabled by default
Using config: /usr/local/zookeeper/bin/../conf/zoo.cfg
Client port found: 2181. Client address: localhost. Client SSL: false.
Mode: standalone
停止
[root@administrator bin]# ./zkServer.sh stop测试
[root@administrator bin]# ./zkCli.sh -server 127.0.0.1:2181

[zk: 127.0.0.1:2181(CONNECTED) 8] ls
ls [-s] [-w] [-R] path
退出客户端
[zk: 127.0.0.1:2181(CONNECTED) 0] quit搭建Zookeeper集群环境
搭建Zookeeper集群至少需要三台服务器,且服务器之间系统时间保持一致,三台服务器中一个leader和两个follower
下载与安装
[root@node001 zookeeper]# wget https://downloads.apache.org/zookeeper/zookeeper-3.7.0/apache-zookeeper-3.7.0-bin.tar.gz解压并重命名
[root@node001 zookeeper]# tar -zxvf apache-zookeeper-3.7.0-bin.tar.gz

[root@node001 zookeeper]# mv apache-zookeeper-3.7.0-bin zookeeper
配置
创建data目录
[root@node001 zookeeper]# cd zookeeper

[root@node001 zookeeper]# mkdir data
创建myid文件,填写每个节点编号(node001 ==> 1),需唯一。
[root@node001 zookeeper]# cd data
[root@node001 zookeeper]# vim myid

1
配置zoo.cfg
[root@node001 zookeeper]# cd conf/

[root@node001 zookeeper]# mv zoo_sample.cfg zoo.cfg

[root@node001 zookeeper]# vim zoo.cfg
# The number of milliseconds of each tick
# 心跳时间
tickTime=2000
# The number of ticks that the initial
# synchronization phase can take
# 用于限制follower跟随者服务器必须连接到leader领导者服务器的时限
# 多少个心跳时间内,允许其他server连接并初始化数据,如果ZooKeeper管理的数据较大,则应相应增大这个值
initLimit=10
# The number of ticks that can pass between
# sending a request and getting an acknowledgement
# 集群中Leader与Follower之间的最大响应时间单位
# 多少个tickTime内,允许follower同步,如果follower落后太多,则会被丢弃。
syncLimit=5
# the directory where the snapshot is stored.
# do not use /tmp for storage, /tmp here is just
# example sakes.
# 修改数据存储路径
# 存储内存数据库快照的位置
dataDir=/usr/local/program/zookeeper/data
# the port at which the clients will connect
# 用于侦听客户端连接的端口
clientPort=2181
# the maximum number of client connections.
# increase this if you need to handle more clients
#maxClientCnxns=60
#
# Be sure to read the maintenance section of the
# administrator guide before turning on autopurge.
#
# http://zookeeper.apache.org/doc/current/zookeeperAdmin.html#sc_maintenance
#
# The number of snapshots to retain in dataDir
#autopurge.snapRetainCount=3
# Purge task interval in hours
# Set to "0" to disable auto purge feature
#autopurge.purgeInterval=1
## Metrics Providers
#
# https://prometheus.io Metrics Exporter
#metricsProvider.className=org.apache.zookeeper.metrics.prometheus.PrometheusMetricsProvider
#metricsProvider.httpPort=7000
#metricsProvider.exportJvmInfo=true
#3台服务器的地址
# server.A=B:C:D
# 添加集群配置
server.1=node001:2888:3888
server.2=node002:2888:3888
server.3=node003:2888:3888A :一个数字,表示是第几号服务器
B:服务器的地址
C:服务器Follower与集群中的Leader服务器交换信息的端口
D:万一集群中的Leader服务器挂了,需要一个端口来重新进行选举一个新的Leader,而这个端口就是用来执行选举时服务器相互通信的端口。分发到其他节点
scp -r zookeeper node002:/usr/local/program/zookeeper

scp -r zookeeper node003:/usr/local/program/zookeeper
修改分发Zookeeper机器的myid编号,分别为2,3
[root@node002 zookeeper]# vim data/myid
2

[root@node003 zookeeper]# vim data/myid
3
启动集群
[root@node001 zookeeper]# bin/zkServer.sh start
ZooKeeper JMX enabled by default
Using config: /usr/local/program/zookeeper/bin/../conf/zoo.cfg
Starting zookeeper ... STARTED

[root@node002 zookeeper]# bin/zkServer.sh start
ZooKeeper JMX enabled by default
Using config: /usr/local/program/zookeeper/bin/../conf/zoo.cfg
Starting zookeeper ... STARTED


[root@node003 zookeeper]# bin/zkServer.sh start
ZooKeeper JMX enabled by default
Using config: /usr/local/program/zookeeper/bin/../conf/zoo.cfg
Starting zookeeper ... STARTED
查看集群状态
[root@node001 zookeeper]# bin/zkServer.sh status
ZooKeeper JMX enabled by default
Using config: /usr/local/program/zookeeper/bin/../conf/zoo.cfg
Client port found: 2181. Client address: localhost. Client SSL: false.
Mode: leader

[root@node002 zookeeper]# bin/zkServer.sh status
ZooKeeper JMX enabled by default
Using config: /usr/local/program/zookeeper/bin/../conf/zoo.cfg
Client port found: 2181. Client address: localhost. Client SSL: false.
Mode: follower

[root@node003 zookeeper]# bin/zkServer.sh status
ZooKeeper JMX enabled by default
Using config: /usr/local/program/zookeeper/bin/../conf/zoo.cfg
Client port found: 2181. Client address: localhost. Client SSL: false.
Mode: follower
查看进程
[root@node001 hadoop]# jps
18946 QuorumPeerMain
19675 Jps

[root@node002 hadoop]# jps
21860 QuorumPeerMain
22095 Jps

[root@node003 hadoop]# jps
25607 Jps
25547 JournalNode
常用命令
ZK操作
| 命令 | 作用 |
|---|---|
| zkServer.sh start/stop | 启动/关闭服务 |
| zkCli.sh start/stop | 启动/关闭客户端 |
| zkServer.sh status | 查看状态(leader/follower) |
| bin/zkCli.sh | 连接本机zk |
| zkCli.sh -server node001:2181 | 连接其他zk服务器 |
| status /zk | 查看/zk节点的状态信息 |
节点ZNode的创建
| 命令 | 作用 |
|---|---|
| create /zk mydata | 创建znode节点,永久+不带序号 |
| create -e /zk mydata | 创建临时znode节点 |
| create -s /zk mydata | 创建顺序znode节点 |
| create -e -s /zk mydata | 创建临时的顺序znode节点 |
节点ZNode的查询
| 命令 | 作用 |
|---|---|
| ls /zk | 查看znode子节点列表 |
| ls /zk watch | 对一个节点的子节点变化事件注册了监听 |
| get /zk | 获取znode数据 |
| get /zk watch | 对一个节点的数据内容变化事件注册了监听 |
节点ZNode的修改与删除
| 命令 | 作用 |
|---|---|
| set /zk value | 设置znode数据 |
| delete /zk | 只能删除没有子znode的znode |
| rmr /zk | 删除znode的znode,递归删除 |
数据信息字段
znode数据信息字段的解释
cZxid = 0x1000fe0597c0002 节点创建的时候的zxid
# The zxid of the change that caused this znode to be created.

ctime = Fri Dec 02 16:41:50 PST 2022 节点创建的时间
# The time in milliseconds from epoch when this znode was created.

mZxid = 0x1000fe0597c0002 节点修改的时候的zxid,与子节点的修改无关
# The zxid of the change that last modified this znode.

mtime = Fri Dec 02 16:41:50 PST 2022 节点的修改的时间
# The time in milliseconds from epoch when this znode was last modified.

pZxid = 0x1000fe0597c0002 和子节点的创建/删除对应的zxid,和修改无关,和孙子节点无关
# The zxid of the change that last modified children of this znode.

cversion = 0 子节点的更新次数
# The number of changes to the children of this znode.

dataVersion = 0 节点数据的更新次数
# The number of changes to the data of this znode.

aclVersion = 0 节点(ACL)的更新次数
# The number of changes to the ACL of this znode.

ephemeralOwner = 0x0 如果该节点为ephemeral节点, ephemeralOwner值表示与该节点绑定的
session id. 如果该节点不是ephemeral节点, ephemeralOwner值为0
# The session id of the owner of this znode if the znode is an ephemeral node.
If it is not an ephemeral node, it will be zero.

dataLength = 6 节点数据的字节数
# The length of the data field of this znode.

numChildren = 0 子节点个数,不包含孙子节点
# The number of children of this znode. 963


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


