Kafka 消息丢失如何处理?

一文读懂kafka消息丢失问题和解决方案 今天分享一下kafka的消息丢失问题,kafka的消息丢失是一个很值得关注的问题,根据消息的重要性,消息丢失的严重性也会进行放大,如何从最大程度上保证消息不丢失,要从生产者,消费者,broker几个端来说。关于kafka的消息丢失问题和解决方案就说到这里,我们分别从生产者到broker,broker到磁盘以及消费者端进行说明,也引申出一些知识点,可能平时没有遇到消息丢失的情况,那是因为网络比较可靠,数据量可能不大,但是如果要真的实现高可用,高可靠,那么就需要对其进行设计。 阅读详情

今天给大家分享一个在面试中经常遇到的问题:Kafka 消息丢失该如何处理?

这个问题啊,看似简单,其实里面藏着很多“套路”。

来,咱们先讲一个面试的“真实”案例。
图片

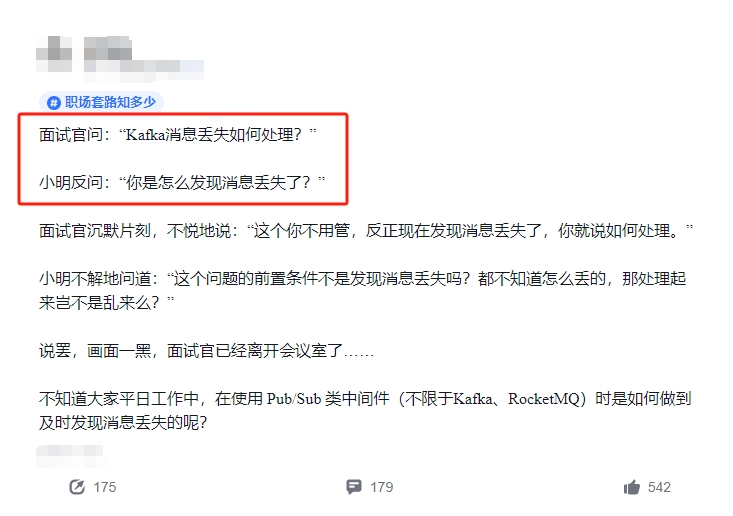
面试官问:“Kafka 消息丢失如何处理?”

小明一听,反问:“你是怎么发现消息丢失了?”

面试官顿时一愣,沉默了片刻后,可能有点不耐烦,说道:“这个你不用管,反正现在发现消息丢失了,你就说如何处理。”

小明一头雾水:“问题是都不知道怎么丢的,处理起来岂不是瞎搞吗?”

画面一黑,面试官离开了会议室,留小明一个人凌乱在风中……

👀 这段子虽然搞笑,但实际工作中,确实“消息丢失”这个事儿有点让人摸不着头脑。

大家有没有想过:消息丢失的定义到底是什么?其实,发现消息丢失的过程,才是处理问题的关键!
图片

在用 Pub/Sub 类中间件,比如 Kafka 或 RocketMQ 时,消息丢失可能有很多原因,包括生产者、消费者和网络传输等各个环节。

我们今天就结合实际工作中遇到的情况,聊聊到底怎么发现消息丢失,又该怎么处理。😎

首先,我们要搞清楚消息丢失的几种典型场景:

1.生产者消息发送失败:这个比较简单,如果生产者发消息时,网络抖动、服务宕机或 Kafka broker 挂了,那消息就丢了。

这时候生产者通常会重试,但是如果重试策略不当,还是可能丢消息。


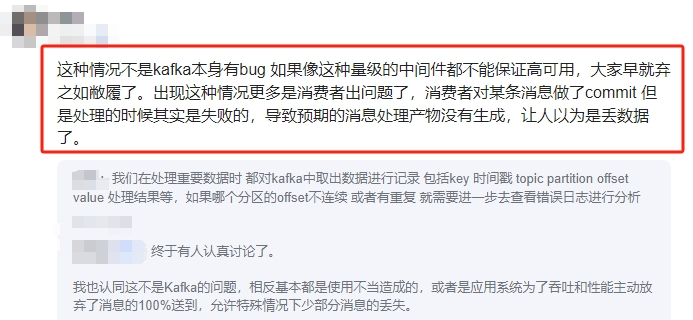
2.消费者消费消息失败:最常见的是消费者拉取了消息,但是业务处理失败,或者消费后没有提交 offset,导致消息“看似”消费了,实际根本没处理。

这种情况不算真正的消息丢失,但你业务数据不一致,这锅还是要 Kafka 来背。😂

3. 网络异常导致消息丢失:有时候消息发送成功了,但是因为网络问题,导致消费者没能拉到这些消息,这类情况更难排查。

OK,分析了几种可能性,接下来看看有哪些方法可以帮助我们及时发现这些问题。

1.监控和告警系统


监控是最基础的保障手段。一般来说,Kafka 提供了很多指标可以监控,比如生产端和消费端的吞吐量、消息积压(lag)情况、消费者组的 offset 等等。

通过这些监控指标,一旦消费端的消息积压开始异常增长,或者 offset 停滞不前,就说明很可能有消息丢失了。

很多公司会用 Prometheus + Grafana 来做监控和可视化,再配合告警系统(如 Alertmanager)实时提醒。

比如可以监控 `kafka_consumer_lag` 这个指标,一旦消息积压超过预设阈值,就触发告警。

# Prometheus 配置监控 Kafka 消费者积压
kafka_consumer_lag{consumer_group="your-consumer-group", topic="your-topic"} > 100

在工作中,这类告警往往是消息丢失的第一个信号,反应速度极快。

2.消息追踪机制

消息追踪就像在每个消息上打个“追踪码”,确保每条消息都能被追踪到。

具体做法是:生产者在发送每条消息时,生成一个唯一的 `message_id`,消费者在消费时同样记录消费的 `message_id`。

通过对比生产端和消费端的 ID,就可以发现有没有消息“掉队”了。

在实际应用中,通常会通过日志来记录这些 `message_id`,并定期检查对账,保证所有消息都正确处理了。

// 生产者发送消息时生成 message_id
String messageId = UUID.randomUUID().toString();
ProducerRecord<String, String> record = new ProducerRecord<>("your-topic", messageId, messageContent);
producer.send(record);

// 消费者消费消息时记录 message_id
public void consumeMessage(ConsumerRecord<String, String> record) {
    String messageId = record.key();  // 获取 message_id
    // 将 message_id 存储到日志或数据库中,用于后续追踪
    log.info("Consumed message with ID: {}", messageId);
}

3.消息确认机制

Kafka 本身有个很经典的机制,就是手动提交offset。消费者在处理完消息后,才提交消费位置的 offset。

如果消费失败了,不提交 offset,Kafka 就会重新分配这条消息,避免消息丢失。

很多时候,消息丢失的“锅”其实是消费者自己在消费时出了问题,明明没处理完却偷偷提交了 offset,让 Kafka 以为消息已经处理完毕了。

手动提交 offset 就能很好地避免这种情况。

public void consumeMessages() {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
    for (ConsumerRecord<String, String> record : records) {
        try {
            // 处理消息逻辑
            processMessage(record);
            // 成功处理后提交 offset
            consumer.commitSync();
        } catch (Exception e) {
            // 处理失败不提交 offset,Kafka 会重试
            log.error("Failed to process message, will retry.", e);
        }
    }
}

​​​​​​​

‍4.消息重试和补偿机制

为了解决偶发性的消费失败,很多公司会为 Kafka 消费端加一个重试机制。

当消息处理失败时,重新将消息放回队列,或者放到一个死信队列(Dead Letter Queue, DLQ)里,然后专门处理这些异常消息。

// 如果消息处理失败,将其放回死信队列
try {
    processMessage(record);
} catch (Exception e) {
    producer.send(new ProducerRecord<>("dlq-topic", record.key(), record.value()));
}

这个方式虽然不能彻底避免消息丢失,但能保证消息不会轻易丢失,特别是一些重要业务场景中,消息的可靠性至关重要。

5.多副本存储

Kafka 还有一个核心功能,就是多副本机制,即消息在多个 broker 上都有副本。这样即使某个 broker 挂了,其他副本也能提供消息。

通过设置 `replication.factor` 参数,我们可以指定 Kafka 每条消息的副本数,确保即使一台机器挂了,消息也不会丢失。

# Kafka Topic 多副本配置
replication.factor=3

最后,真正发现消息丢失了,怎么办呢?这里有一些基本的补救措施:

1.检查消费端日志:首先要确定消息到底有没有消费。如果消费端日志显示消费失败,重新处理即可。


2.重发消息:如果消费端确实没处理成功,可以将消息重新发送到 Kafka,或者从备份中恢复并重放消息。

3.处理丢失后的补偿:业务上可能会涉及补偿措施,比如通知相关人员手动处理,或者对丢失的数据进行回补。

总之,消息丢失不算是特别常见的问题,但一旦遇到,还是需要冷静排查问题源头。

Kafka 等 Pub/Sub 中间件本身已经有比较强大的机制来应对这些场景,只要结合业务需求,做好监控和容错机制,基本都能把问题压到最小。

深入解析Kafka消息丢失的原因与解决方案 Apache Kafka是一种高吞吐量、分布式的消息系统,广泛应用于实时数据流处理。然而,在某些情况下,Kafka可能会出现消息丢失的情况,这对于数据敏感的应用来说是不可接受的。本文将深入解析Kafka消息丢失的各种原因,包括生产者、broker和消费者配置问题,以及硬件故障等。同时,我们将提供详细的解决方案和最佳实践,帮助您确保Kafka消息的可靠传递,提升系统的稳定性和数据安全性。 阅读详情

相关推荐

kafka丢失消息,消息乱序(重试)常见处理

消息的完整性和系统的吞吐量是互斥的,为了确保消息不丢失就必然会损失系统的吞吐量producer:1、ack设置-12、设置副本同步成功的最小同步个数为副本数-13、加大重试次数4、同步发送5、对于单条数据过大,要设置可接收的单条数据的大小6、对于异步发送,通过回调函数来感知丢消息7、配置不允许非ISR集合中的副本当leader8、客户端缓冲区满了也可能会丢消息;或者异步情况下消息在客户端缓冲区还未...

qq_27388039的博客 6907

spring中kafka消息丢失问题(提供者、消费者)附解决方案

spring中kafka消息丢失(生产者、消费者)问题的解决

Dark_AK44的博客 4660

RabbitMQ,RocketMQ,Kafka 事务性,消息丢失和重复发送处理策略

分布式事务 什么是分布式事务 我们的服务器从单机发展到拥有多台机器的分布式系统,各个系统之前需要借助于网络进行通信,原有单机中相对可靠的方法调用以及进程间通信方式已经没有办法使用,同时网络环境也是不稳定的,造成了我们多个机器之间的数据同步问题,这就是典型的分布式事务问题。 在分布式事务中事务的参与者、支持事务的服务器、资源服务器以及事务管理器分别位于不同的分布式系统的不同节点之上。分布式事务就是要保证不同节点之间的数据一致性。 常见的分布式事务解决方案 1、2PC(二阶段提交)方案 - 强一致性 2、3PC

m0_65634190的博客 495

kafka消息丢失解决方案

生产阶段: 在这个阶段,从消息在 Producer 创建出来,经过网络传输发送到 Broker 端。 存储阶段: 在这个阶段,消息在 Broker 端存储,如果是集群,消息会在这个阶段被复制到其他的副本上。 消费阶段: 在这个阶段,Consumer 从 Broker 上拉取消息,经过网络传输发送到 Consumer 上。...

大道至简,持之以恒! 7005

RabbitMQ,RocketMQ,Kafka 事务性,消息丢失,消息顺序性和消息重复发送的处理策略

消息队列常见问题处理 分布式事务 什么是分布式事务 我们的服务器从单机发展到拥有多台机器的分布式系统,各个系统之前需要借助于网络进行通信,原有单机中相对可靠的方法调用以及进程间通信方式已经没有办法使用,同时网络环境也是不稳定的,造成了我们多个机器之间的数据同步问题,这就是典型的分布式事务问题。 在分布式事务中事务的参与者、支持事务的服务器、资源服务器以及事务管理器分别位于不同的分布式系统的不同节点之上。分布式事务就是要保证不同节点之间的数据一致性。 常见的分布式事务解决方案 1、2PC(二阶段提

JAVA88866的博客 336

ESP32-S3开发环境避坑指南:VS Code+ESP-IDF离线安装全流程(附国内镜像加速)

本文提供了一份详细的ESP32-S3开发环境离线安装指南,重点解决网络依赖问题。通过整合国内镜像加速,手把手教你完成VS Code、ESP-IDF框架、工具链及Python依赖的本地化部署,实现稳定、可重复的开发环境搭建,大幅提升IoT开发效率。

peach的博客 962

Kafka--消息丢失--原因/解决方案/零丢失的配置

Kafka--消息丢失--原因/解决方案/零丢失的配置

Hello World 1547

Cadence Allegro通过手工绘制板框的方法

Cadence Allegro通过手工绘制板框的方法 Cadence Allegro绘制板框有三个方法: 1、通过手工绘制板框; 2、通过向导绘制板框; 3、通过导入DXF文件导绘制板框; 本章将教会大家如何通过手工的方法绘制100mm的矩形板框。 方法步骤如下: 一、通过放置绘图工具2D线绘制; 1、运行Cadence Allegro软件,打开File菜单栏,选择New。 2、这时软件会弹出Ne...

LGCPCB的博客 2万+

Kafka 如何处理消息丢失?

通过合理配置 Kafka 的副本、确认机制、消费者偏移量管理等,能够有效避免消息丢失问题。Kafka 提供了强大的数据复制和持久化能力,使其在分布式系统中能够实现高可用和可靠的消息传递。对于生产环境中的 Kafka 集群,务必根据实际情况设置合理的副本数、日志保留策略以及消息确认机制,确保系统的稳定性与消息的可靠性。希望通过这篇文章,能够帮助开发者理解 Kafka 消息丢失的原因以及如何配置 Kafka 来避免这一问题。对于任何分布式系统,确保消息的可靠传递和持久化是基础,也是最为重要的设计目标之一。

一碗黄焖鸡三碗米饭的博客 882

LLM大模型基础知识【一】

大语言模型(LLM):是指在自然语言处理(Natural Language Processing,NLP)领域中的一类大模型,通常用于处理文本数据和理解自然语言。这类大模型的主要特点是它们在大规模语料库上进行了训练,以学习自然语言的各种语法、语义和语境规则。例如:GPT系列(OpenAI)、Bard(Google)、文心一言(百度)。视觉大模型:是指在计算机视觉(Computer Vision,CV)领域中使用的大模型,通常用于图像处理和分析。

lin_xi_xi的博客 2882

神经网络基础概念总结(小白入门自用)

神经网络人工神经网络多层感知机激活函数反向传播算法损失函数权值初始化正则化方法 人工神经网络 人工神经元:人工神经元是人工神经网络的基本单元。模拟生物神经元,人工神经元有1个或者多个输入(模拟多个树突或者多个神经元向该神经元传递神经冲动);对输入进行加权求和(模拟细胞体将神经信号进行积累和树突强度不同);对输入之和使用激活函数计算活性值(模拟细胞体产生兴奋或者抑制);输出活性值并传递到下一个人工神经元(模拟生物神经元通过轴突将神经冲动输入到下一个神经元)。 人工神经网络:大量的人工神经元以某种链接方式得来的

qq_42011158的博客 650

Kafka|处理 Kafka 消息丢失的有效措施

消息丢失是 Kafka 系统中一个严重的问题,可能会发生在生产者、Broker 或消费者任何方面。今天我们来讨论一些可能导致消息丢失的场景以及如何解决。

weixin_44435110的博客 1785

科研绘图系列:基因突变瀑布图统计以及可视化

科研绘图系列:基因突变瀑布图统计以及可视化

专注生信领域 1657

Kafka消息丢失处理方式,消息丢失与消费失败区别和分别的处理

Kafka 消息丢失的处理方式可以从生产者、Broker 和消费者三个角度来考虑,以确保消息的可靠传递。

weixin_44131922的博客 1270

使用 MATLAB/Simulink 构建一个基于FOC控制的PMSM矢量控制仿真模型

本教程详细介绍了基于MATLAB/Simulink的永磁同步电机(PMSM)磁场定向控制(FOC)系统建模与仿真方法。主要内容包括:PMSM电机模型参数设置、Clarke/Park变换模块设计、电流环PID控制器配置、SVPWM调制实现以及系统仿真参数优化。文章提供了模块化设计思路和具体参数设置示例,并给出了PID整定建议和进阶优化方向。通过该仿真模型,可深入理解PMSM矢量控制原理,掌握高性能电机控制系统的建模技巧,适用于伺服系统、电动汽车驱动等高端控制场景。教程还推荐了实时仿真和高级控制策略等扩展应用。

xiaoheshang_123的博客 530

AD(Altium Designer)器件封装——立创商城导出原理图和PCB完成器件封装操作指南

官网:www.SZLCSC.COM以芯片为例器件类——>芯片类——>对应芯片确定芯片——>数据手册1:原理图2:PCB3:打开操作流程选中原理图——>文件——>导出——>AD1: ✔2:导出AD文件操作流程选中PCB图——>文件——>导出——>AD1: ✔2:导出AD文件1:PCB图2:原理图操作流程文件——>打开操作流程选中文件——>打开操作流程项目文件——>添加新的...到工程——>Schematic Library新原理图库操作流程项目文件——>添加新的...到工程——>PCB Library新的PC

XU157303764的博客 5439

Kafka 业务架构及消息丢失处理方案

kafka业务架构及消息丢失数据处理: 1、producer生产者丢失消息; 2、kafka消息中间件自身丢失消息; 3、consumer 消费者丢失消息

勤于笔记,成于点滴。 2004

codex出现Reconnecting和stream disconnected before completion:stream closed before response.complete解决方案

本文主要介绍了在使用codex过程中出现Reconnecting和stream disconnected before completion: stream closed before response.completed的解决方案,希望能对使用codex的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 9万+

Kafka消息不丢失处理

kafka作为消息中间件,吞吐量大(至于为啥吞吐量大,本文不做介绍),所以大家用的多。涉及到异构数据库更换,以及数据预处理后的迁移,基本想到的都是通过kafka。

前方的路在刚开始 472

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

kafka-消息丢失处理方案

1)首先当 Producer 向 Broker 发送数据后,会进行 commit,如果 commit 成功,由于 Replica 副本机制的存在,则意味着消息不会丢失,但是 Producer 发送数据给 Broker 后,遇到网络问题而造成通信中断,那么 Producer 就无法准确判断该消息是否已经被提交(commit),这就可能造成 at least once 语义。既然 Consumer 拉取后消息最终是要提交 Offset, 那么这里就可能会丢数据的**!

mming520的博客 1856

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

RabbitMQ,RocketMQ,Kafka 事务性,消息丢失和消息重复发送的处理策略

消息队列常见问题处理 分布式事务 什么是分布式事务 我们的服务器从单机发展到拥有多台机器的分布式系统,各个系统之前需要借助于网络进行通信,原有单机中相对可靠的方法调用以及进程间通信方式已经没有办法使用,同时网络环境也是不稳定的,造成了我们多个机器之间的数据同步问题,这就是典型的分布式事务问题。 在分布式事务中事务的参与者、支持事务的服务器、资源服务器以及事务管理器分别位于不同的分布式系统的不同节点...

m0_62695120的博客 2105

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

遇到kafka消息丢失和重复消费问题该如何处理

前段时间在工作中实际遇到了kafka消费的问题,通过查找定位并解决了问题,做些分享。提示以下是本篇文章正文内容,下面案例可供参考第一次写。。。写得不咋地。。。。

laowang5421的博客 2435

Kafka消息丢失如何处理

3. 消息确认机制:使用中间件的消息确认机制,如Kafka的手动提交offset,确保消费者正确处理了消息后再提交offset。2. 消息追踪:在发送消息时,为每条消息生成一个唯一的ID,并在消费端记录消费的消息ID。6. 多副本策略:在中间件中配置多副本,如Kafka的多副本机制,可以保证即使某个副本出现故障,其他副本仍然可以提供消息服务,从而避免消息丢失。1. 监控告警:通过监控中间件的运行状态,如消费者消费速度、生产者生产速度、消息积压等指标,当这些指标出现异常时,可以及时发现消息丢失的情况。

一蓑烟雨任平生 884
上一篇: 异步请求提高吞吐量
下一篇: Stack Overflow 2023 年开发者调查报告!
架构文摘JGWZ
博客等级 码龄5年 8808粉丝 345原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值