LSTM 图解

图解长短期记忆网络(LSTM) 梯度消失和梯度爆炸。这意味着网络很难学习到长期依赖关系,即在序列中相隔较远的事件之间的关系。 阅读详情

长期依赖的问题

人门希望RNNs能够连接之前的信息到当前的任务中,例如,使用之前的图像帧信息去辅助理解当前的帧。如果RNNs可以做到这个,它们将会特别的有用,但是它们可以做到吗?这要视情况而定。
有时,我们仅仅需要使用当前的信息去执行当前的任务。例如, 一个语言模型试图根据之前的单词去预测下一个单词。如果我们试图去预测“the clouds are in the sky”,我们不需要更多的上下文信息–很明显下一个单词会是sky。在类似这种相关信息和需要它的场合并不太多的情景下,RNNs可以学习使用之前的信息。
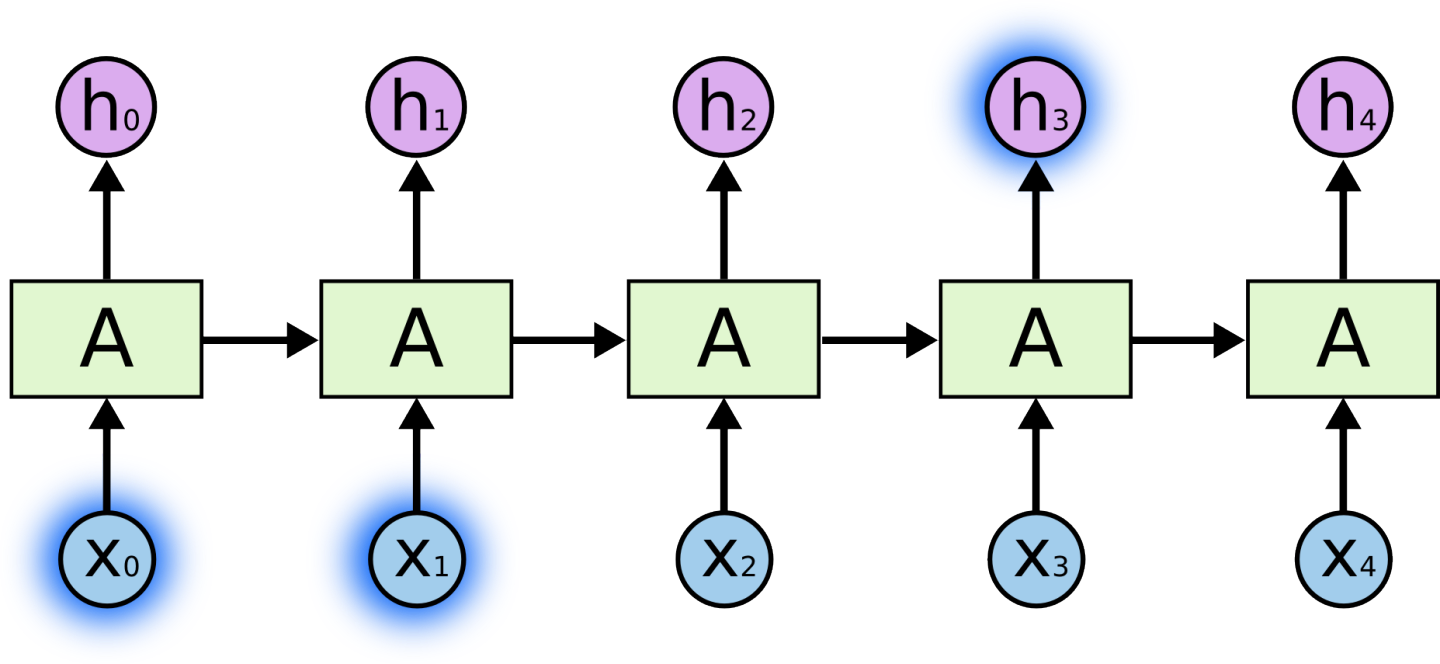
在这里插入图片描述

但是,也有很多场景需要使用更多的上下文。当我们去尝试预测“I grew up in France…I speak fluent French”的最后一个单词,最近的信息表明下一个单词应该是语言的名字,但是如果我们想缩小语言的范围,看到底是哪种语言,我们需要France这个在句子中比较靠前的上下文信息。相关信息和需要预测的点的间隔很大的情况是经常发生的。
不幸的事,随着间隔的增大,RNNs连接上下文信息开始力不从心了.
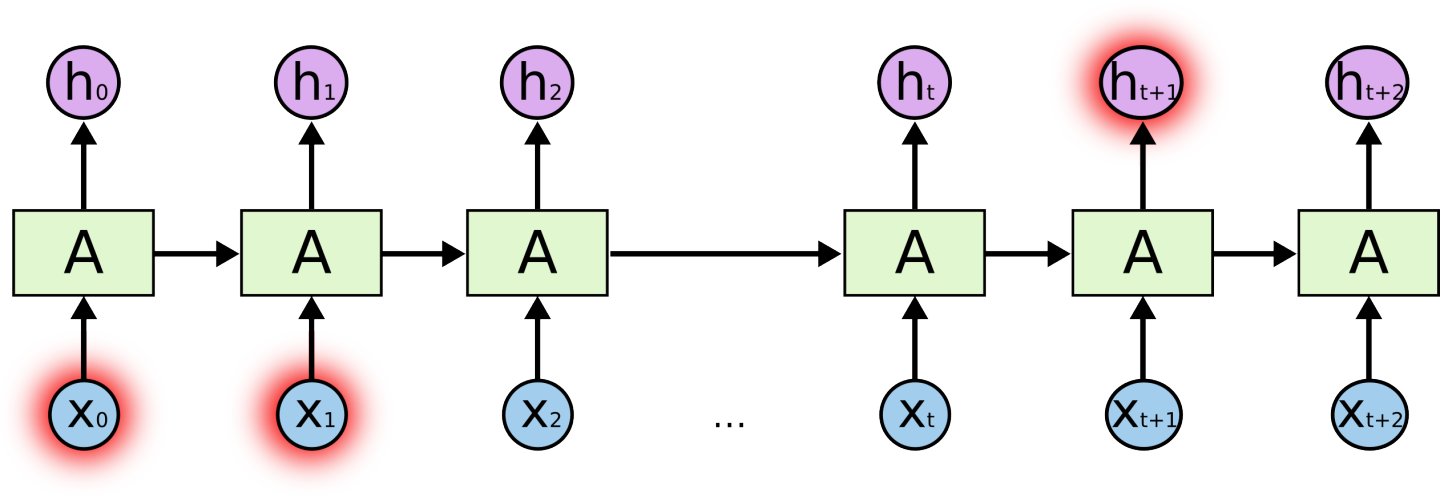
在这里插入图片描述

理论上RNNs完全有能力处理这种“长期依赖(Long-term dependencies)”问题。人们可以精心的选择参数去接着这类问题。令人沮丧的是,实践表明RNNs不能完美的学习“长期依赖(Long-term dependencies)”。Hochreiter(1991)和Bengio,et al,(1994)发现了一些为什么RNNs在这些问题上学习相当困难的根本原因。
谢天谢地,LSTMs没有这些问题。

LSTM 网络

长短期记忆网络–通畅叫做”LSTMs”–是一种特殊的RNNs, 它能够学习长期依赖。LSTM由Hochreiter&Schmidhuber(1997)引入,后来在很多人的努力下变得越来越精炼和流行。它们在大量的问题上有惊人的效果,现在被广泛的使用。
LSTMs被明确的设计用来解决长期依赖问题,记住长时间段的信息是他们的必备技能,不像RNNs那么费力去做还做不好。
所有的递归神经网络都有重复神经网络本身模型的链式形式。在标准的RNNs, 这个复制模块只有一个非常简单的结构,例如一个双极性(tanh)层。

在这里插入图片描述

LSTMs 也有这种链式结构,但是这个重复模块与上面提到的RNNs结构不同:LSTMs并不是只增加一个简单的神经网络层,而是四个,它们以一种特殊的形式交互。
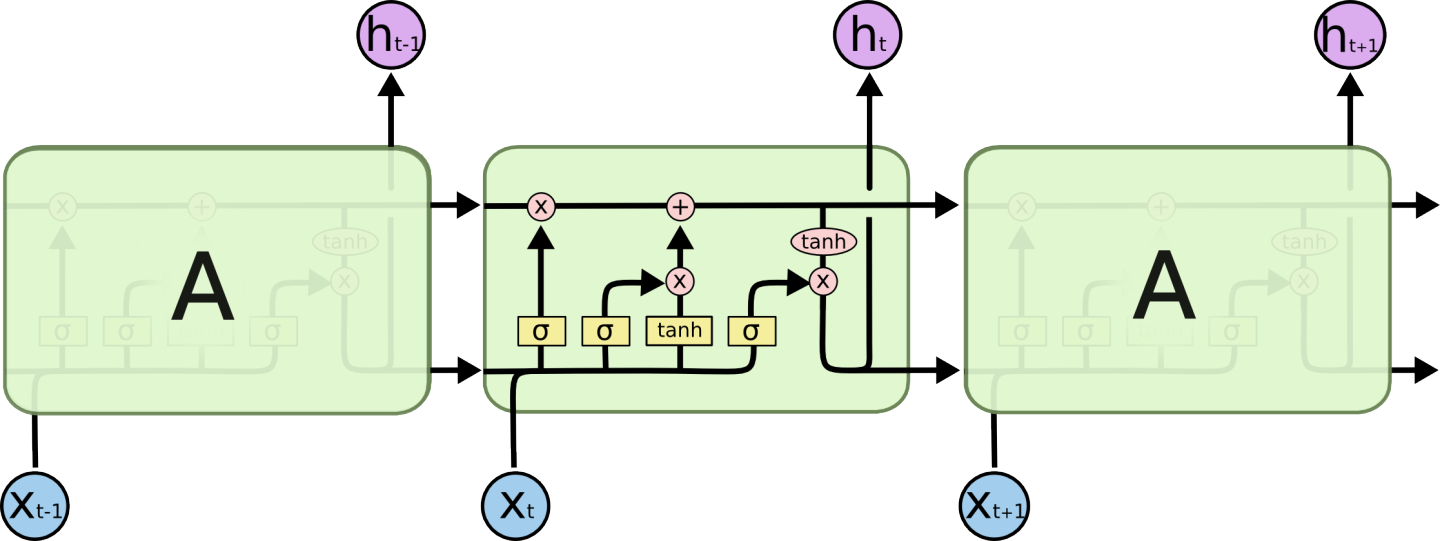
在这里插入图片描述

别担心中间到底发生了什么。我们接下来会一步一步的理解这个LSTM图。首先,我们要首先适应一下我们将会使用的符号表示方法。
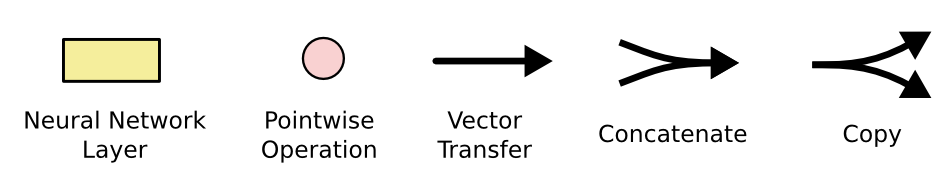
在这里插入图片描述

在上图中,每条线表示一个向量,从一个输出节点到其他节点的输入节点。这个粉红色圆圈表示逐点式操作,就像向量加法。黄色的盒子是学习好的神经网络的层。线条合表示联结,相反,线条分叉表示内容被复制到不同位置。

LSTMs背后的核心思想

LSTMs的核心之处就是它的神经元状态,如下图中所示,上面那条贯穿整个结构的水平线。
神经元状态就像是一个传送带。它的线性作用很小,贯穿整个链式结构。信息很容易在传送带上传播,状态却并不会改变。
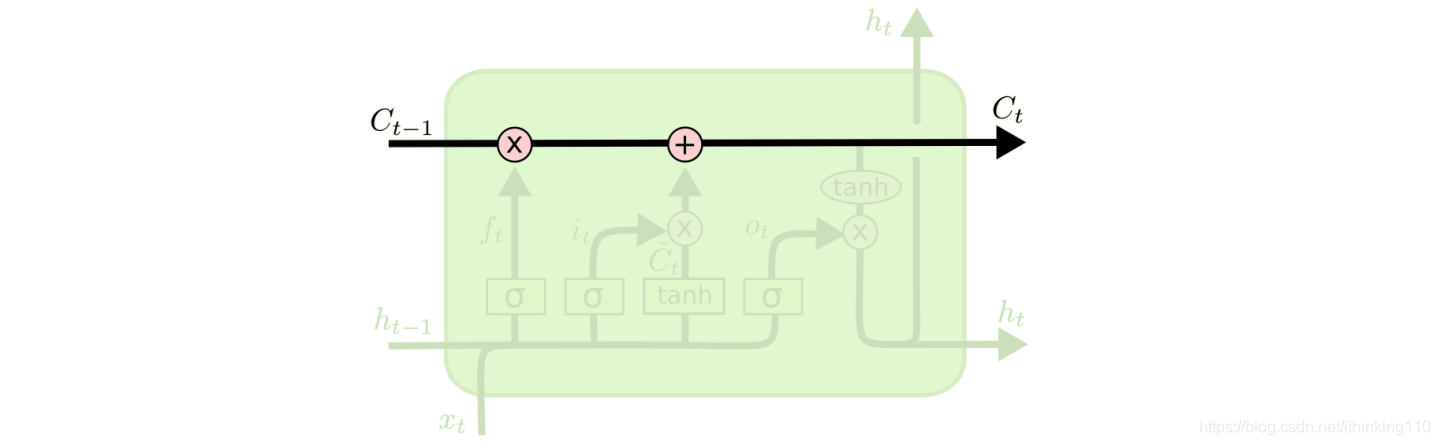
在这里插入图片描述

LSTM有能力删除或者增加神经元状态中的信息,这一机制是由被称为门限的结构精心管理的。
门限是一种让信息选择性通过的方式,它们是由Sigmoid神经网络层和逐点相乘器做成的。
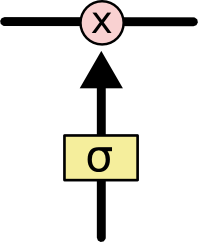
在这里插入图片描述

Sigmod层输出0~1之间的数字,描述了一个神经元有多少信息应该被通过。输出“0”意味着“全都不能通过”,输出“1”意味着“让所有都通过”。
一个LSTM有三个这样的门限,去保护和控制神经元状态。

一步一步的推导LSTM

LSTM的第一步就是决定什么信息应该被神经元遗忘。这是一个被称为“遗忘门层”的Sigmod层组成的。它输入 ht−1和xt,然后在Ct−1 的每个神经元状态输出0~1之间的数字。“1”表示“完全保留这个”,“0”表示“完全遗忘这个”。
让我们再次回到那个尝试去根据之前的词语去预测下一个单词的语言模型。在这个问题中,神经元状态或许包括当前主语中的性别信息,所以可以使用正确的代词。当我们看到一个新的主语,我们会去遗忘之前的性别信息。
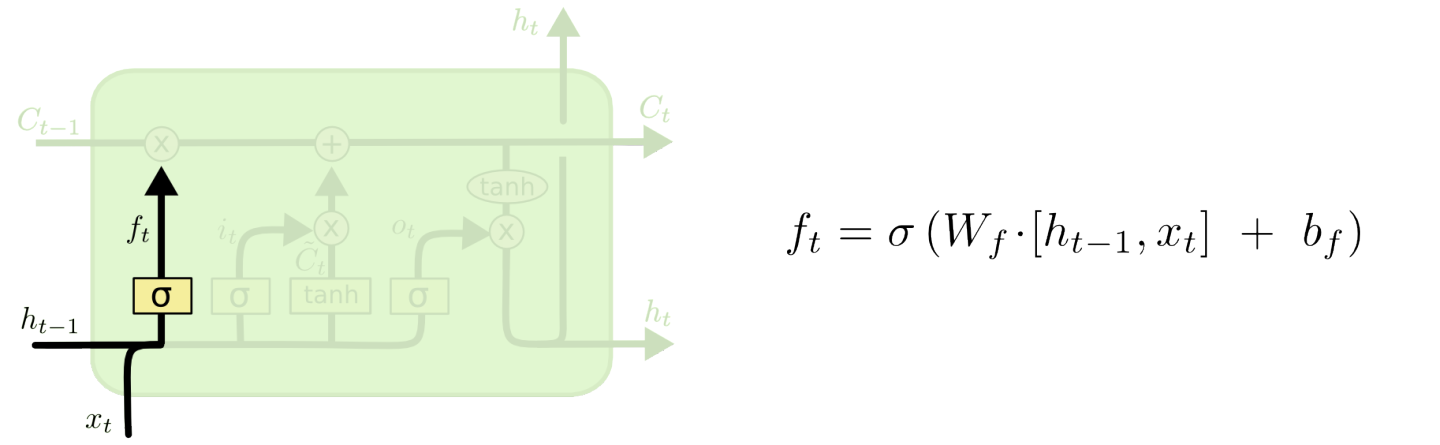
在这里插入图片描述
图中 【ht-1 ,xt】 表示 两个向量 连接起来 形成一个大向量
在这里插入图片描述

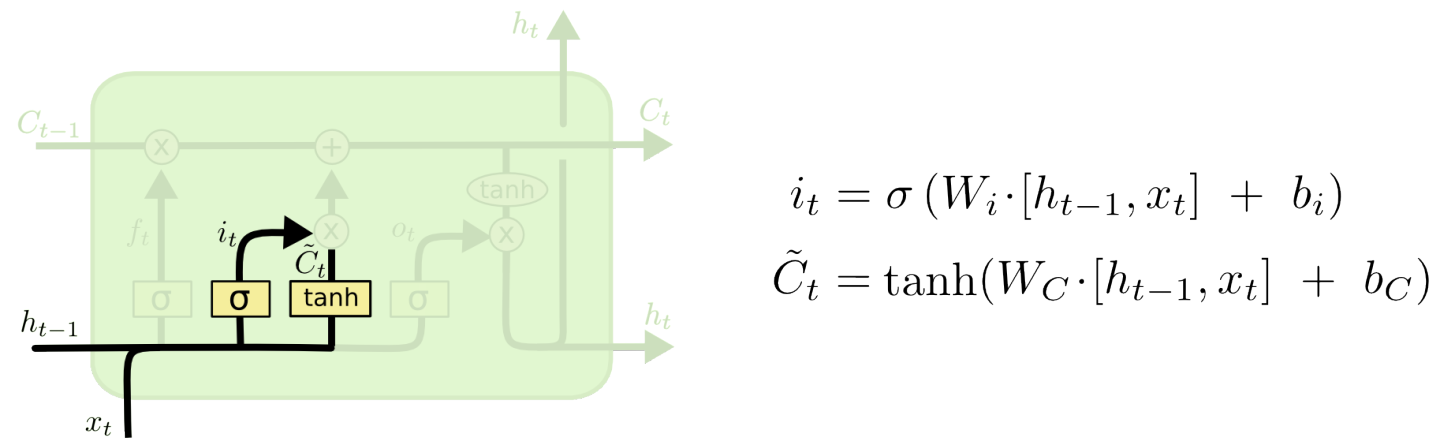
下一步就是决定我们要在神经元细胞中保存什么信息,这包括两个部分。首先,一个被称为“输入门层”的Sigmod层决定我们要更新的数值。然后,一个tanh层生成一个新的候选数值,Ct˜,它会被增加到神经元状态中。在下一步中中,我们会组合这两步去生成一个更新状态值。
在那个语言模型例子中,我们想给神经元状态增加新的主语的性别,替换我们将要遗忘的旧的主语。
在这里插入图片描述
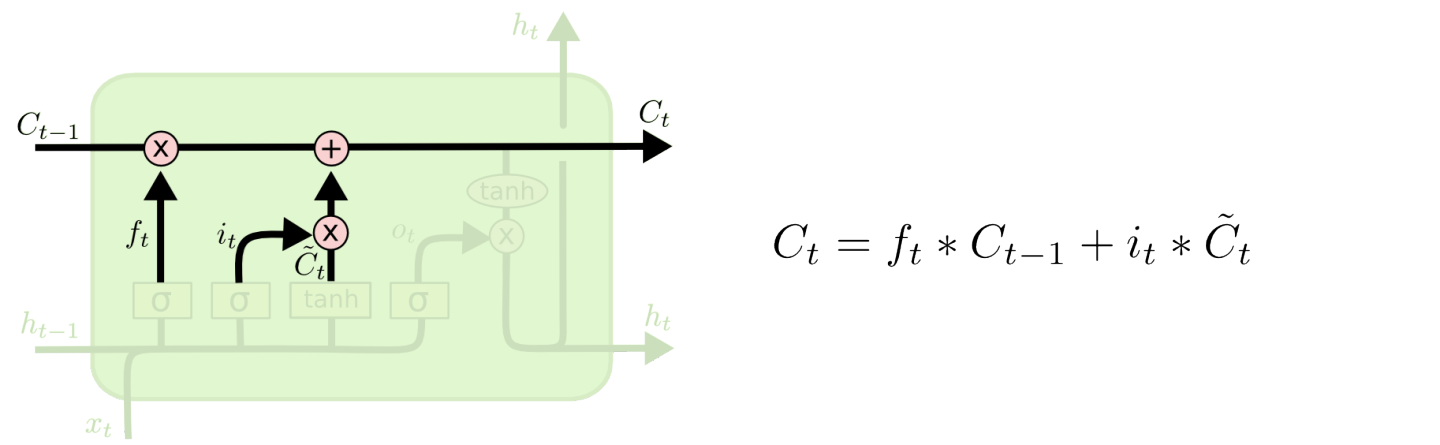
是时候去更新旧的神经元状态Ct−1到新的神经元状态Ct了。之前的步骤已经决定要做什么,下一步我们就去做。
我们给旧的状态乘以一个ft,遗忘掉我们之前决定要遗忘的信息,然后我们增加it∗Ct˜。这是新的候选值,是由我们想多大程度上更新每个状态的值来度量的。
在语言模型中,就像上面描述的,这是我们实际上要丢弃之前主语的性别信息,增加新的主语的性别信息的地方。
在这里插入图片描述
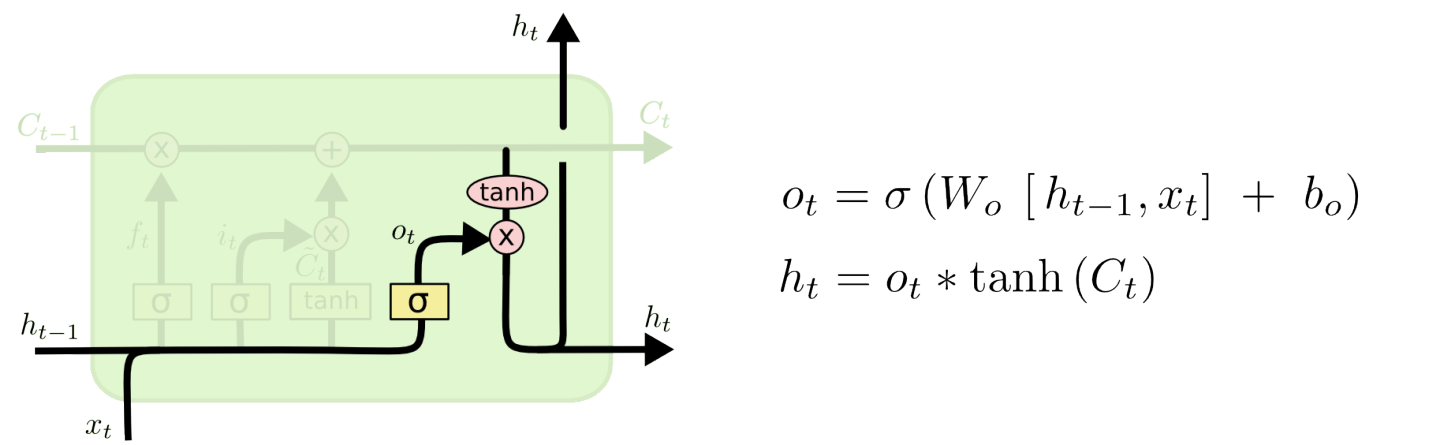
最后,我们要决定要输出什么。这个输出是建立在我们的神经元状态的基础上的,但是有一个滤波器。首先,我们使用Sigmod层决定哪一部分的神经元状态需要被输出;然后我们让神经元状态经过tanh(让输出值变为-1~1之间)层并且乘上Sigmod门限的输出,我们只输出我们想要输出的。
对于那个语言模型的例子,当我们看到一个主语的时候,或许我们想输出相关动词的信息,因为动词是紧跟在主语之后的。例如,它或许要输出主语是单数还是复数的,然后我们就知道主语联结的动词的语态了。
在这里插入图片描述

长短期记忆神经网络的变体

上面描述的都是常规的LSTM,但并不是所有的LSTMs都是上面这种模式。实际上,几乎每篇包含LSTMs模型的论文中,LSTMs都有一些差异,这些差异非常微小,但是它值得提及一下。
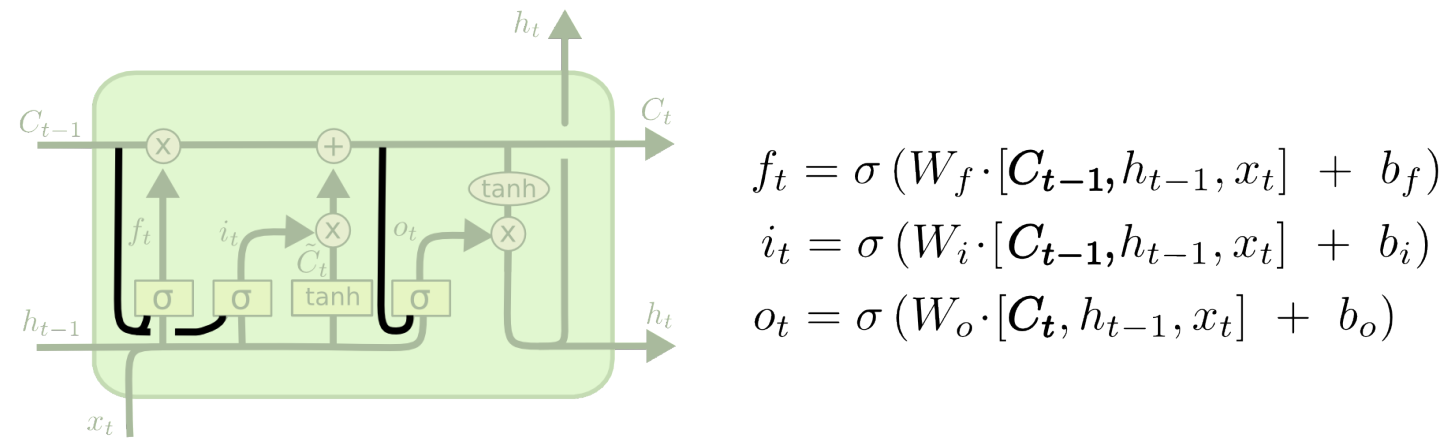
Gers & Schmidhuber(2000)引入了一个流行的LSTM变体,他增加了一个“窥视孔连接”。这意味着我们让门限层监视神经元状态。
在这里插入图片描述

上图中给每个门限增加了窥视孔,但是有些论文,只给一部分门限增加窥视孔,并不是全部都加上。
另外一个变体是使用组合遗忘和输入门。而不是分开决定哪些神经元需要遗忘信息,哪些需要增加新的信息,我们组合起来决定。我们只遗忘那些需要被放入新信息的状态,同样,我们只在旧的信息被遗忘之后才输入新的信息。
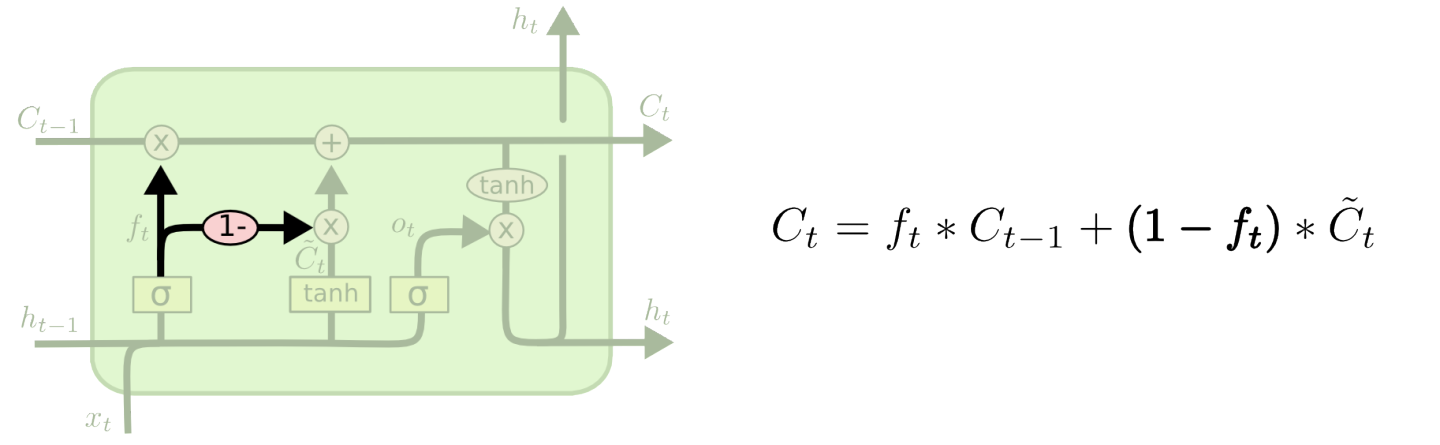
在这里插入图片描述

一个更神奇的LSTM变体是门递归单元(Gated Recurrent Unit, GRU),由Cho, et al(2014),它组合遗忘们和输入门为一个“更新门”,它合并了神经元状态和隐层状态,并且还做了一些其他改变。最终这个模型比标准的LSTM模型简单一些,并且变得越来越流行。
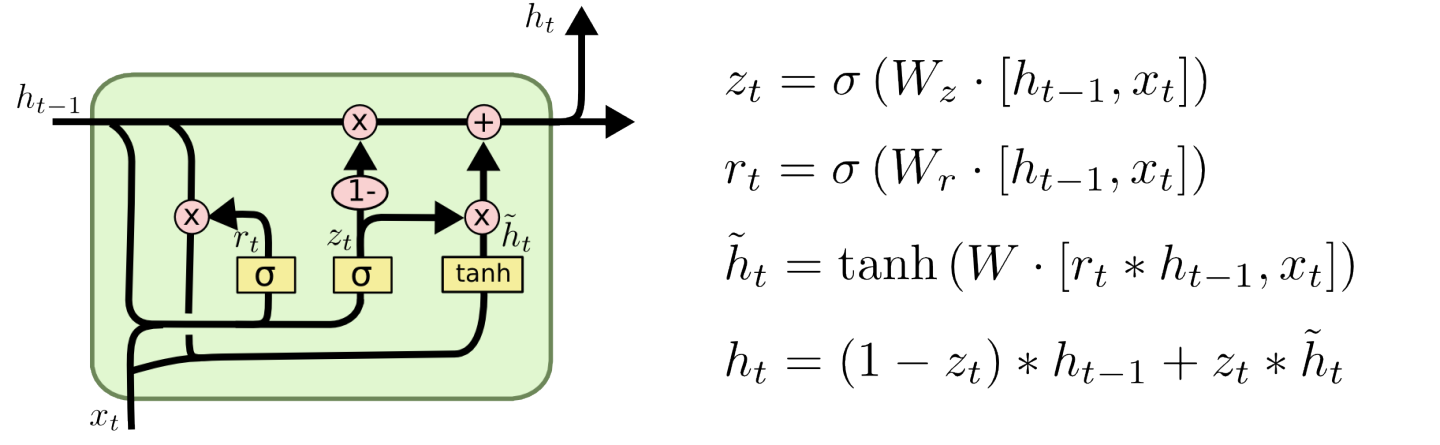
在这里插入图片描述

这里只介绍了几个最有名的LSTM的变体,还有更多变体没有介绍,就像Yao, et al.(2015)深度门递归神经网络(Depth Gated RNNs)。这里也有一些处理长期依赖问题问题的完全不同的方法,就像Koutnik, et al(2014)提出的时钟机递归神经网络(Clockwork RNNs)。
这些变体中哪个是最好的?这些差异重要吗?Greff, et al. (2015)做了一个流行LSTM变体的比较,他发现这都是一样的。Jozefowicz, et al. (2015)测试了一万多种RNN结构,发现一些RNN结构在某些特定任务中结果好于LSTMs。

结论

文章开头,我提到了人们使用RNNs取得了卓越的成果,本质上所有的这些结果都是使用LSTMs取得的。他们的确在多数任务上表现的更好。
写下来一系列等式以后,LSTM s看起来挺吓人的,然而,我们在文中一步一步的解释它以后它看起来可以理解了。LSTMs在我们能够用RNNs取得的结果中取得了更大的进步。我们不禁想问:是否有比LSTMs更好的模型?学者一致认为:“有的!这里有下一步,它就是“注意力”!”(Yes! There is a next step and it’s attention!,这里的”attention”翻译成“注意力”不知道是否合适”?)一个观点是让RNN的每一步都监视一个更大的信息集合,并从中挑选信息。例如:如果你使用 RNN去为一幅图像生成注释,它会从图像中挑选中挑选一部分去预测输出单词。实际上,Xu, et al. (2015) 确实是这样做的–如果你想去探索“注意力”,这或许是一个有趣的起点!这里还有一些使用“注意力”得到的有趣的结果,并且还有更多人在使用这个。
“注意力”并不是唯一的RNN研究热点。例如, 格点LSTMs(Grid LSTMs),Kalchbrenner, et al. (2015)看起来非常有前途。在生产环境中使用RNNs模型,就像Gregor, et al. (2015), Chung, et al. (2015)或者 Bayer & Osendorfer (2015)–也看起来很有趣。最近几年递归神经网络很流行,从趋势来看,未来还会更流行。

LSTM模型 (一)NN模型(neural network) 1.NN模型是复杂神经网络模型的基础计算单元,广泛使用于各种神经网络模型中,如下所示: 2.NN模型常见的激活函数主要有3种:sigmoid函数,tanh函数,以及ReLU(rectified linear unit)函数,分别如下: 3.NN模型若放在输出层,不同的任务使用不同的激活函数: (1)multi-class:使用 阅读详情

相关推荐

lstm结构图_人人都能看懂的LSTM介绍及反向传播算法推导(非常详细)

1.长短期记忆网络LSTMLSTM(Long short-term memory)通过刻意的设计来避免长期依赖问题,是一种特殊的RNN。长时间记住信息实际上是 LSTM 的默认行为,而不是需要努力学习的东西!所有递归神经网络都具有神经网络的链式重复模块。在标准的RNN中,这个重复模块具有非常简单的结构,例如只有单个tanh层,如下图所示。图1 RNN结构图LSTM具有同样的结构,但是重复的模块拥有...

weixin_39538877的博客 6957

lstm结构图_LSTM模型结构的可视化

目录: 1、传统的BP网络和CNN网络 2、LSTM网络 3、LSTM的输入结构 4、pytorch中的LSTM 4.1 pytorch中定义的LSTM模型 4.2 喂给LSTM的数据格式 4.3 LSTM的output格式 5、LSTM和其他网络组合最近在学习LSTM应用在时间序列的预测上,但是遇到一个很大的问题就是LSTM在传统BP网络上加上时间步后,其结构就很难理解了,同时其输入输出数据格式...

weixin_39529463的博客 8299

图解、手动模拟tensorflow的LSTM

LSTM结构在很多地方都有,我这里就不再赘述了。 只是稍微解释一下图中的变量,f, i, j , o (一般图中j都以表示,这里为了跟代码中的字母保持一致就改成j了) (注:点乘为矩阵乘法,星乘是两个矩阵相同位置的数字相乘。在tensorflow中,遗忘门会再加一个偏置量,默认为1.0) 上图是要实现的结构 上图是tensorflow lstm c...

kami0116的博客 503

【LSTM】深入浅出讲解长短时记忆神经网络(结构、原理)

1、LSTM的背景介绍 长短时记忆神经网络(Long Short-term Memory Networks,简称LSTM)是特殊的RNN,尤其适合顺序序列数据的处理,LSTM 由 Hochreiter & Schmidhuber (1997) 提出,并在近期被 Alex Graves 进行了改良和推广,LSTM明确旨在避免长期依赖性问题,成功地解决了原始循环神经网络的缺陷,成为当前最流行的RNN,在语音识别、图片描述、自然语言处理等许多领域中成功应用。 2、RNN的不足 图...

程序星空实验室 5万+

LSTM图解

•梯度消失:RNN梯度消失是因为激活函数tanh函数的倒数在0到1之间,反向传播时更新前面时刻的参数时,当参数W初始化为小于1的数,则多个(tanh函数’ * W)相乘,将导致求得的偏导极小(小于1的数连乘),从而导致梯度消失。当前时刻的单元状态 Ct 的计算:由上一次的单元状态 Ct-1 按元素乘以遗忘门 ft,再用当前输入的单元状态 Ct 按元素乘以输入门 it,再将两个积加和。由于遗忘门的控制,它可以保存很久很久之前的信息,由于输入门的控制,它又可以避免当前无关紧要的内容进入记忆。

xin__xiao的博客 1128

LSTM及GRU图解

lstm也是一种递归神经神经网络,那么要了解lstm之前先看看什么是RNN从上可以看出rnn有两个输入x1,h0;两个输出h1,y1.h1,x2作为下一时刻的输入,通过f函数,输出h2,y2;依次下去。。。。不管输入的序列有多长,只有一个f函数,那么自然减少了参数的数量;从上图也可看出为什么rnn可以作为时间序列的预测,下面是 深层的RNN,只是多了一层,然后下一层的输出是上衣一层的输入深层的RN...

颠沛的小丸子 6104

LSTM长短时记忆网络【数学+图解】

LSTM长短时记忆网络【数学+图解】

逐梦苍穹的博客 2687

第87步 时间序列建模实战:LSTM回归建模

第87步 时间序列建模实战:LSTM回归建模

Jet4505的博客 1960

图解LSTM——一文吃透LSTM

图解LSTM——一文吃透LSTM v0版(20210817):本版本将通过图解LSTM的方式,逐步剖析LSTM的内部结构,力求把LSTM的结构和公式刻在大家的脑海中。当前版本并不会对LSTM的有效机制原因和反向传播进行分析,重点在于LSTM的结构展现上,也不会牵扯别的太多,就一个目的,让大家看透“LSTM”。 一、理解第一步:宏观认识 LSTM能干什么? 简单说,就是将一串向量序列,转换为另一串含有更多特征信息的向量序列,也可以理解为embedding的一种方式。在实际应用中,输入的可以是一维的信号

YG的博客 2万+

Windows安装ros2(Jazzy版本+win10/win11)-1.配置windows终端

更高版本的terminal可能设置里更加丰富, 有默认以管理员身份启动的选项等,可自行配置。打开微软应用商店, 在其中搜索并下载 Terminal 即可(注意别挂梯子)下载并安装, 安装的位置自行替换,建议别放到系统盘中。点击任务栏中的搜索, 输入store。

weixin_48398592的博客 1454

解决Calibre中license的错误

本次解决了Calibre在Cadence 617 virtuoso版本中运行不了的错误,在遇到问题的时候,我也跟你们一样,首先是上网查询为什么运行不了呢?明明我安装了之后里面有Calibre的,我当时也是这样的疑惑,一点Calibre运行LVS的时候,一片空白,然后就出现了license的错误,后来点点点,看看看,搜搜搜,最终解决了这个问题。虚拟机是VMware16版本,cadence617,Calibre是2015版本。旨在记录遇到的实际问题。

yytu231的博客 1万+

RNN和LSTM图解

从网上看到一些对RNN和LSTM的讲解,说得实在不明白,我看了好久才理解一点。所以把自己的理解画成图总结了一下。都是从网上找的资料不一定权威,也不是专门搞这个的,只是入门的介绍,其他深入的问题也不会。权当做一个简介和入门吧。 神经网络 如果看神经网络的一个单层而且是全连接层的话,可以表示成下面这样。 其中W就是权重矩阵,,非常好理解。 循环神经网络(RNN) 首先,为什么要有这个循环神经网络呢?因...

bcwdlh的博客 957

Mac上MySQL出现secure-file-priv为null

在使用MySQL导入导出文件时出现了错误,原因是没有配置secure-file-priv。 我的MySQL版本是8.0.13,使用如下命令查看secure-file-priv。 结果发现secure-file-priv为空,此时需要为它配置一个文件夹。 解决方案: 1)到MySQL的安装目录中去,Mac中是的是 /usr/local/mysql/support-files,该目录下有一...

zhangvalue的博客 5883

Keras LSTM结构图解教程

Keras LSTM结构图解教程 项目介绍 该项目,Keras LSTM结构图解,由开发者Mohammad Fneish创建,旨在通过一张清晰的图表帮助理解Keras中递归神经网络(特别是LSTM)的结构和数据流动过程。它详细地展示了在处理序列数据时,LSTM层如何工作,强调了关键参数和内部机制。对于想要深入掌握Keras框架下LSTM模型构建的开发者来说,是一个宝贵的资源。此外,该图解不仅适用于...

gitblog_00986的博客 925

PPT| 公司网络安全意识培训 P73

近年来,随着互联网的不断发展,网络安全问题也日益凸显,各种网络安全事件层出不穷,对个人和企业的信息安全带来了巨大的威胁。针对这一现状,国家加强了对信息安全的保护,相继颁布了多项法律法规,其中最重要的就是网络安全法。本文将从网络安全法和其他相关法律入手,对信息安全的保护措施进行深入分析。 本人在四大咨询机构从事咨询工作多年,二十年一线数字化规划咨询经验,提供制造业数智化转型规划服务,顶层规划/企业架构/数据治理/数据安全解决方案资料干货. 该PPT共73页,原文获取及来源公众号:【智能制造数字化咨询】

waldensss的博客 1422

基础的pdf病毒木马

基础的pdf病毒木马 环境: 攻击机:Kali 目标操作系统:Windows 10或Windows 7 (关闭防火墙和安全软件) 目标软件:Adobe Reader 8.1.2 msf框架搜索:adobe-pdf 1.打开msfconsole 2.搜索 adobe_pdf模块 3.加载攻击模块并设置payload 4.运行生成pdf 5.将pdf拖入到win10 6.打开msf,加...

小小猪的博客 4623

图解LSTM和GRU

图解LSTM和GRU

qq_27273975的博客 183

9、双玩家博弈中的精确与近似纳什均衡及中国股市再融资偏好研究

本文研究了双玩家博弈中精确与近似纳什均衡的计算方法,提出通过线性松弛问题LR在多项式时间内求解正则双矩阵博弈的纳什均衡,并分析其在α-平滑博弈中的近似性能。同时,探讨了中国股市2001-2009年期间再融资偏好的动态变化,重点考察非流通股改革对再融资方式选择的影响。研究表明,改革前配股为主导,改革后公开发行(含定向增发)因溢价发行和低参与门槛成为主流,显著提升了资金募集效率和市场参与度。结合博弈论模型与实证分析,揭示了制度变革对企业融资行为的深远影响。

nn3456的博客 82

图解LSTM神经网络架构及其11种变体

元学习论文总结||小样本学习论文总结 2017-2019年计算机视觉顶会文章收录 AAAI2017-2019 CVPR2017-2019 ECCV2018 ICCV2017-2019 ICLR2017-2019 NIPS2017-2019 干货 | 图解LSTM神经网络架构及其11种变体(附论文) 2016-10-02机器之心 选自FastML 作者:Zygmunt Z. 机器...

VIEO 7975

14、脑肿瘤复发预测与转移瘤跟踪的自动化方法

本文介绍两种脑肿瘤相关自动化方法:一种用于预测胶质瘤切除术后的肿瘤复发位置,结合图像配准、静态模型和动态模拟模型,利用患者的DTI数据进行预测;另一种用于在纵向扫描中跟踪转移性脑肿瘤,通过联合求解配准参数估计和图像变化标记问题,提高肿瘤跟踪的准确性和效率。文章同时分析了两种方法的优势与挑战,并提出了未来研究方向,旨在为脑肿瘤的诊断和治疗提供更可靠的工具。

defi6farmer的博客 115

基于深度学习的番茄成熟度检测系统——YOLOv5、YOLOv8、YOLOv10及UI界面的实现

YOLO是一种快速且准确的目标检测模型,近年来,YOLOv5、YOLOv8和YOLOv10作为YOLO系列的重要版本,分别在速度、精度和效率上进行了优化。下面我们简要介绍这些模型。本文介绍了如何基于YOLOv5、YOLOv8和YOLOv10等深度学习模型,结合PyQt5设计一个番茄成熟度检测系统。通过训练模型、优化算法和设计用户友好的界面,我们能够构建一个高效且准确的番茄成熟度检测系统,广泛应用于农业自动化和智能化管理中。

YOLO 1002

LSTM和GRU的动态图解

编者按:关于LSTM,之前我们已经出过不少文章,其中最经典的一篇是chrisolah的《一文详解LSTM网络》,文中使用的可视化图片被大量博文引用,现在已经随处可见。但正如短视频取代纯文字阅读是时代的趋势,在科普文章中,用可视化取代文字,用动态图取代静态图,这也是如今使知识更易于被读者吸收的常规操作。 今天,论智给大家带来的是AI语音助理领域的机器学习工程师Michael Nguyen撰写的一篇...

王猛的专栏 1036

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

(转) 干货 | 图解LSTM神经网络架构及其11种变体(附论文)

干货 | 图解LSTM神经网络架构及其11种变体(附论文) 2016-10-02机器之心 选自FastML 作者:Zygmunt Z. 机器之心编译 参与:老红、李亚洲 就像雨季后非洲大草原许多野生溪流分化成的湖泊和水洼,深度学习已经分化成了各种不同的专门架构。 并且,每个架构都会有一个图解,这里将详细介绍它们。 神经网络在概念上很...

a1424262219的博客 5102

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

图解LSTM神经网络架构及其11种变体(附论文)

来源:机器之心 英文原文:Deep learning architecture diagrams 参与:老红、李亚洲 原文链接:图解LSTM神经网络架构及其11种变体(附论文) 本文经机器之心(微信公众号:almosthuman2014)授权转载,禁止二次转载 就像雨季后非洲大草原许多野生溪流分化成的湖泊和水洼,深度学习已经分化成了各种不同的专门架构。 并且,每个架构都

omnispace的博客 1万+

结合torch tutorial图解LSTM

结合torch tutorial图解LSTM tutorial链接:https://pytorch.org/docs/stable/nn.html?highlight=lstm#torch.nn.LSTM

qq_42667030的博客 259

LSTM原理图解

在解释LSTM原理前先来理解一下RNN的原理 RNN基本原理 原理简介 当我们处理与事件发生的时间轴有关系的问题时,比如自然语言处理,文本处理,文字的上下文是有一定的关联性的;时间序列数据,如连续几天的天气状况,当日的天气情况与过去的几天有某些联系;又比如语音识别,机器翻译等。在考虑这些和时间轴相关的问题时,传统的神经网络就无能为力了,因此就有了RNN(recurrent neural netwo...

weixin_44901453的博客 5885
上一篇: pytorch实现CNN图像分类
下一篇: pytorch rnn 实现手写字体识别
ithinking110
博客等级 码龄14年 54粉丝 52原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值