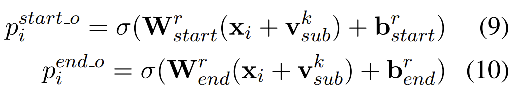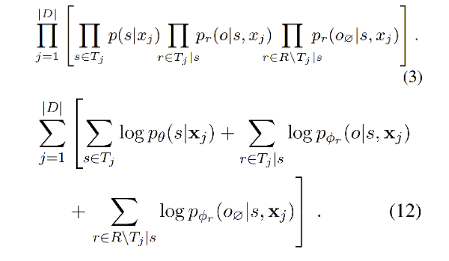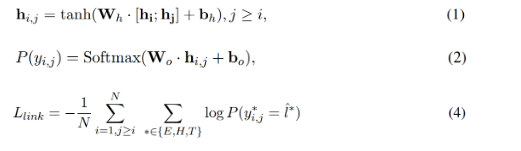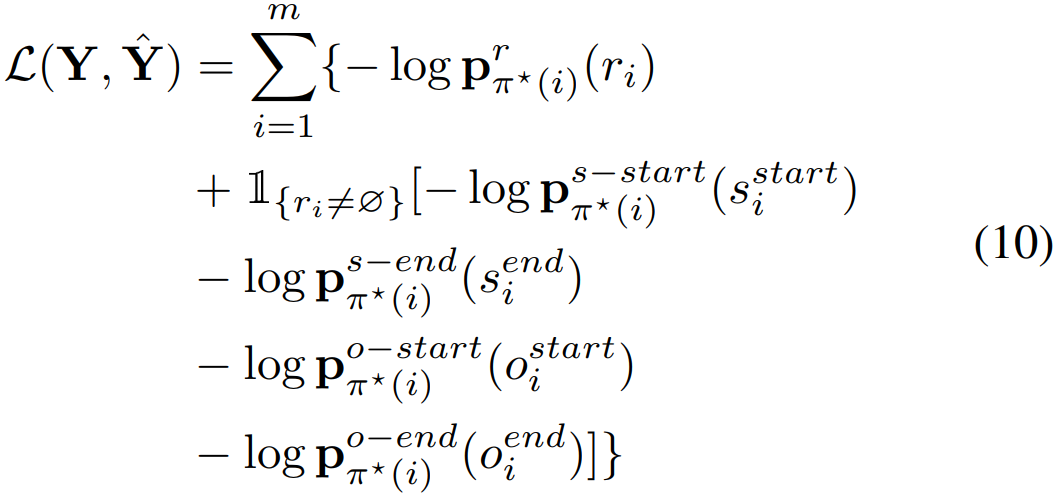SOTA集结,2020登顶关系抽取的3篇佳作

【学习笔记】行为识别SOTA方法比较 本博客主要针对四类行为识别算法中表现较优模型进行介绍,包括SlowFast、Video TimeSformer、Video Swin Transformer、VideoMAE和Intern Video。 阅读详情

                                                                            Fly-AI竞赛服务平台 flyai.com

在开始学习之前推荐大家可以多在      FlyAI竞赛服务平台多参加训练和竞赛,以此来提升自己的能力。FlyAI是为AI开发者提供数据竞赛并支持GPU离线训练的一站式服务平台。每周免费提供项目开源算法样例,支持算法能力变现以及快速的迭代算法模型。


2020实体关系联合抽取一片红海,各种SOTA方法你方唱罢我方登场,在一些数据集上也是不断刷出新高度,为信息抽取领域带来了新思路,推动了信息抽取领域的发展。本文梳理了实体关系联合抽取取得SOTA的三种方法,以做总结。


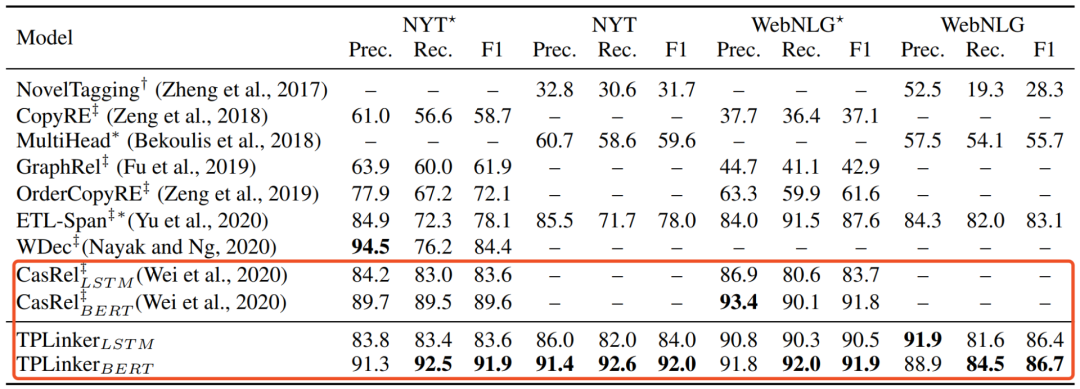
先总体对三种方法做个比较:*表示Exact Matching


以下将对上面提到的三篇文章依次进行详细解读。


CasRel

论文:A Novel Cascade Binary Tagging Framework for Relational Triple Extraction

地址:https://arxiv.org/abs/1909.03227


2019年的时候看到苏剑林在paperweekly上的一篇文章,阐述了其在参加百度SPO竞赛中所使用的方法,这篇论文可以认为是之前所提方法的延伸。


论文提出级联二分标记框架CasRel方法(a novel cascade binary tagging framework),与以往把关系看着离散标签不同,这里把关系看着是一个函数fr(sub)->obj,头实体sub是自变量,尾实体obj是因变量,先抽取出头实体,然后结合各关系类型,进一步抽取出对应的尾实体。该方法可以解决实体关系中的EPO/SEO实体重叠问题。结合模型框架图更好理解:


CasRel模型可以分两部分理解:

编码部分:采用Bert进行编码,输入subword embedding + position embedding

Cascade解码(级联解码):先对subject实体进行抽取(subject tagger),然后对每一种关系,进一步去抽取该关系下subject所对应的object实体(relation-specific object tagger)。


subject实体抽取:直接在Bert编码后进行span解码,得到实体的start和end位置,如图示,对每个token位置做二分类,判断是否为start位,或者是否为end位。注意:在解码的时候,start和end配对可以采用就近原则得到实体


特定关系下的object实体抽取:结合上图示,obj实体解码类似于sub的解码,需要注意两点:一是对每种关系都要做obj解码,二是obj的解码中引入了上一步中所得到的sub实体的信息Vsub,Vsub是对sub实体中各token向量求平均。当start_o和end_o经过二分判断都为0时,表示该关系下没有对应的obj实体,也即该sub为头实体时不存在这个关系的三元组。


优化目标及模型损失函数:目标是较大化三元组抽取概率,sub和obj的抽取都是采用span方式,可采用二分交叉熵计算loss。优化目标公式如下:


实验结果

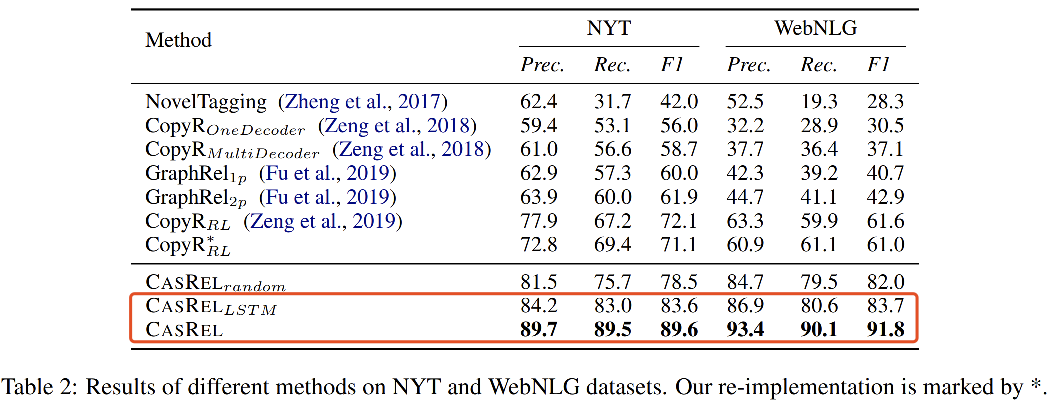
在NYT和WebNLG两个数据集上达到了SOTA,如下图所示,即使不使用Bert进行编码(使用LSTM)效果依然是十分显著的。实验同时对比了句子中不同三元组数目下的结果,以及Normal、EPO和SEO三种情况下的结果,实验显示CasRel方法在多三元组、EPO和SEO情况下效果提升更明显。


总结:

级联两个任务,两个任务独立解码,共享编码,这种模型架构也可以算到多任务学习的范畴,模型先抽取出sub实体,再在各个relation下去抽sub实体对应的obj实体,把relation看成函数,模型整体架构很清晰,特别是在relation纬度上做堆叠,打开了关系抽取的新思路。


TPLinker

论文:TPLinker: Single-stage Joint Extraction of Entities and Relations Through Token Pair Linking

地址:https://arxiv.org/abs/2010.13415


这篇文章提出TPLinker方法(Token Pair Linking)能够end2end对实体及实体关系三元组进行联合抽取,可解决实体关系抽取中的SEO、EPO、实体嵌套等问题。其设计了一种很巧妙的数据标注方式,被称为Handshaking tagging scheme,这种标注统一了实体及实体关系的信息,同时避免了以往其他方法中普遍存在的标签曝光偏差问题(exposure bias)(训练阶段标签使用ground true,推断阶段标签使用predict tag)。


Handshaking tagging scheme: 个人感觉文中所给图示(下图)其实不太好理解,从具体例子出发会更方便理解的。


为长度为n的句子,构造nxn的矩阵M,行、列分别对应着句子中的token,针对句子中的实体及实体关系设计三种标注方式:

entity head to entity tail (EH-to-ET): 对每个实体,将它的头token(行)对应的尾token(列)位置标记为1,反应在M的上三角上,如所给例子实体:New York City  ==> M(New, City) = 1,  De Blasio ==> M(De, Blasio) =1,上图中紫色背景。

subject head to object head (SH-to-OH):  对每个关系下的实体对,将首实体(sub)的头token(行)对应到尾实体(obj)的头token(列),如所给例子关系mayor实体对:(New York City, De Blasio) ==> M(New, De),上图中红色背景。

subject tail to object tail (ST-to-OT):   对每个关系下的实体对,将首实体(sub)的尾token(行)对应到尾实体(obj)的尾token(列),如所给例子关系mayor实体对:(New York City, De Blasio) ==> M(City, Blasio),上图中蓝色背景。


注意:EH-to-ET只会存在M的上三角,而SH-to-OH和ST-to-OT是上下三角都会存在的,为了节省存储资源,同时减少目标tag的稀疏性(还是很稀疏),将M的下三角映射到上三角上,值设置为2。(考虑上三角映射的位置上会不会不为0呢,是会存在这种可能的,但现实中概率很低,如triple (ABC, R, CDE)和(CDE, R, BC))


上面将三元组中的实体信息映射到矩阵上三角,然后将其展平为标记序列,可以得到序列的长度为n*(n+1)/2。如果有N中关系,则经过Handshaking tagging后,得到2N+1个标记序列。


解码方式:

先不用去看下面所给的解码图示,考虑上面讲到的Handshaking tagging作为模型的预测目标,实际上是2N+1个n*n的矩阵,矩阵的元素为句子各token对的关系,其值为0、1、2。其中一个矩阵标记了实体EH-to-ET,N个矩阵标记了SH-to-OH,N个矩阵标记了ST-to-OT。文章给出了一个解码的算法流程,不再贴出,简述过程如下:


解码EH-to-ET可以得到句子中所有的实体,用实体头token idx作为key,实体作为value,存入字典D中

对每种关系r,解码ST-to-OT得到token对存入集合E中,解码SH-to-OH得到token对并在D中关联其token idx的实体value

对上一步中得到的SH-to-OH token对的所有实体value对,在集合E中依次查询是否其尾token对在E中,进而可以得到三元组信息。


相关公式:

模型编码可以是LSTM也可以是Bert,Token Pair表示为公式(1),Handshaking Tagger可以看着是多分类,公式为(2),损失函数定义为公式(4):


实验结果:

同样在NYT和WebNLG两个数据集上进行实验,延续CasRel的实验结果,TPLinker方法达到了新的SOTA,同时通过进一步细化实验分析得到以下结论:


句子中triple数目大于5的时候,TPLinker方法优势更加明显

在实体关系标注中只标注实体尾token,和标注实体span相比,并没有简化问题

得益于解码的高效性,TPLinker推断性能相对于CasRel有极大提升


总结:

创新性地提出了Handshaking tagging方式,统一了实体与实体关系信息,使得模型能够一次解码得到三元组信息

能够解决实体关系中的实体重叠EPO、SEO问题,受益于EH-to-ET标记,模型同时能够解决嵌套实体问题

end2end得到实体及实体关系,避免了标签暴露偏差的问题


SPN4RE

论文:Joint Entity and Relation Extraction with Set Prediction Networks

地址:https://arxiv.org/abs/2011.01675


这篇文章出至中科院刘康老师团队,是目前NYT和WebNLG数据集上的SOTA。论文将实体关系联合抽取归纳为三种范式,分别为:

end2end抽取实体及关系(as table filling problem),编码层共享参数,解码层独立解码

转化为序列标注问题,需要设计复杂的tagging scheme,即每个tag需要同时表示实体及关系的信息(之前的方案无法应对嵌套、重叠实体)

转化为seq2seq问题,解码时生成三元组(多次生成可解决嵌套、重叠实体(autoregressive decoder and cross-entropy loss))

实际上,第一种也可以看着是多任务学习,第二种在TPLinker方法中已经比较好地解决了实体重叠和嵌套问题,论文认为所提出的SPN4RE属于seq2seq范畴,通读下来笔者窃以为也可将SPN4RE归为实体关系联合抽取中的多任务学习。


论文的初衷是在以往使用seq2seq解决实体关系三元组时,面临三元组生成顺序对结果产生影响,所以从生成顺序无关三元组、并行生成三元组集合出发提出新的模型SPN。


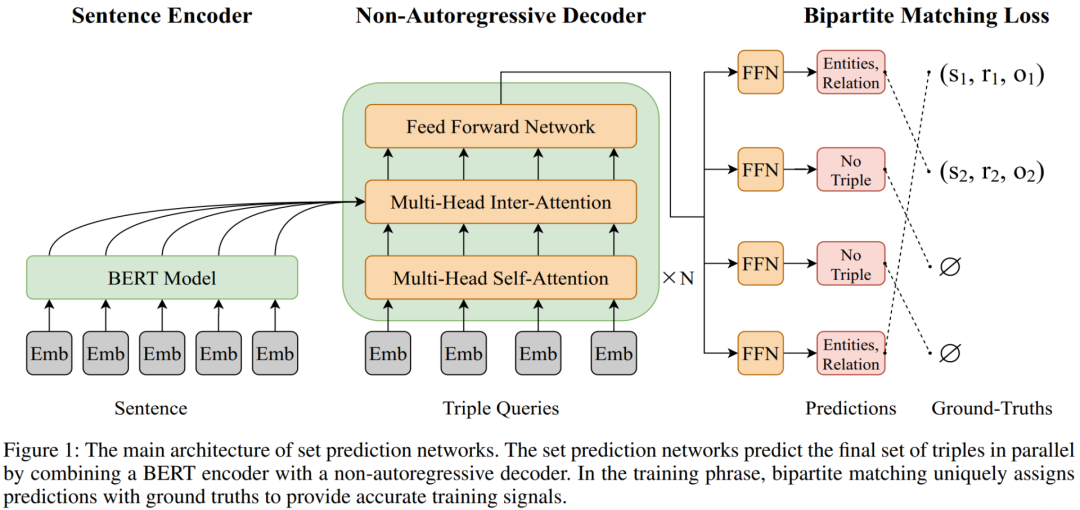
SPN(set prediction networks)包含了三个部分:

句子编码:采用预训练语言模型Bert,BPE编码输入

三元组集合生成:基于transformer的非自回归解码NAT(transformer-based non-autoregressive decoder)

并行产生三元组,产生三元组顺序无关,加速解码,NAT结构使用到了双向信息

NAT条件概率公式:j!=i说明第j个triple和其他triple也是有关系的,n为三元组个数,本文设置为常数m

基于集合的Loss设计:二部图匹配损失函数(bipartite matching loss function)


NAT结构解码:

输入m表示要解码的triple个数,N个transformer层,每层先是各triple间做self-attention,然后是和sentence的编码做inter-attention,输出解码向量为Hd,其为m*d纬度


关系预测:对每个hd过FFN经过softmax,预测「关系」,关系数量为总关系量+1(包含了null),公示如下:

关系首尾实体预测:类似与对sentence做span,融合了sentence编码和对应关系的编码,公式如下:


二部图匹配损失函数(Bipartite Matching Loss):在预测的三元组集合和ground true三元组集合间计算loss

两个集合的元素进行最优匹配:预测的集合大小为m,如果ground true集合小于m则补充null至大小为m。寻找最优匹配的过程,实际上相当于对m个人分配m个任务,第i个人做第j个任务的代价为Cij,寻找最优方式将这m个任务分配给m个人,使得总代价最小,这就是二部图匹配问题,可以利用匈牙利算法求解,时间复杂度为O(m^3)。本文定义代价函数如下:


损失函数定义:对最优匹配得到的m个三元组对计算loss,注意,如果「关系」为null,则关系中的头尾实体不参与loss计算,Loss函数定义如下:


实验结果:

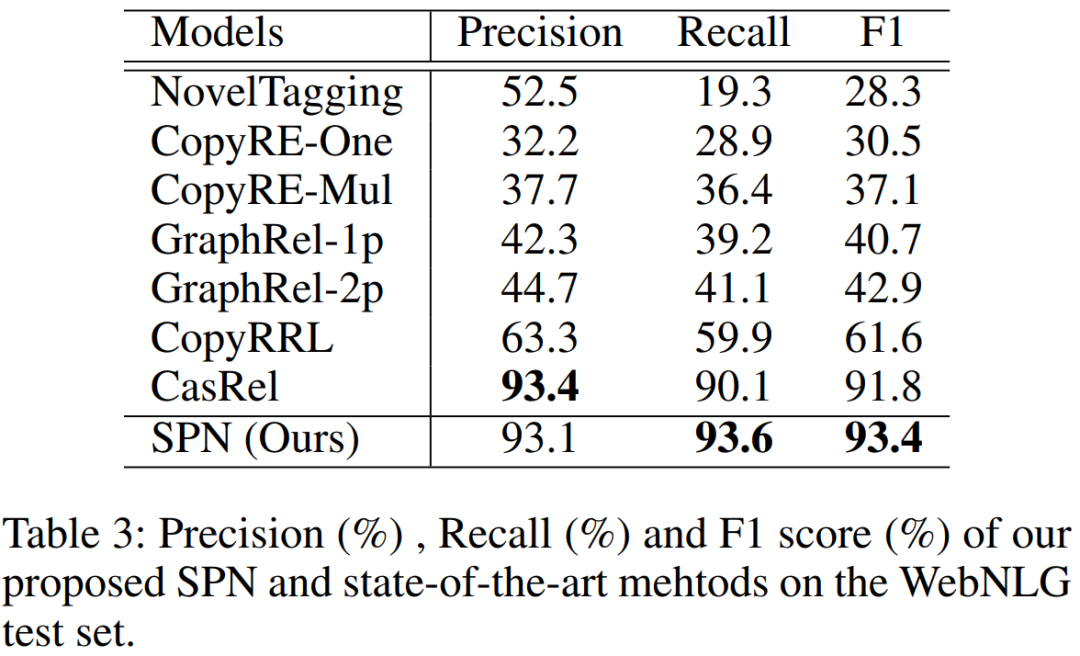
在NYT和WebNLG数据集上进行实验,结果如下图,提出并回答了以下四个问题:


联合抽取模型SPN的整体性能如何:对比CasRel F1在NYT上提升2.9%,在 WebNLG上提升1.6%(图略)

模型中每个设计对结果的影响:通过消融实验,对比了交叉熵loss和二部图匹配loss,以及非自回归解码层数对结果的影响,得到了NAT层数为3时最优,二部图匹配Loss优于交叉熵Loss(图略)

数据中存在不同数量的三元组对性能的影响:数据中三元组数量越多(信息越复杂),对比其他方法SPN的效果越显著(图略)

该方法在解决重叠模式问题上性能如何(EPO, SEO):和其他方法对比了Normal、SEO、EPO三种triple类型下效果,结论同上一条一致,在复杂问题上(SEO, EPO),相比与其他方法SPN效果显著(图略)


总结:

对NAT解码的结果做关系预测,可看着是分类问题,然后将解码结果进一步融合编码信息对句子做实体抽取,可看着实体span解码过程,所以笔者认为该方法也属于联合抽取中的多任务学习

采用二部图匹配,寻找最优三元组匹配的过程复杂度O(m^3),先匹配再计算Loss为集合纬度的Loss计算提供了参考。


以上对实体关系联合抽取三篇SOTA文章进行了分析解读,在实际的工作当中,我们也已经将CasRel方法进行落地实践,并取得了一定的效果。在实体抽取任务中,也可以借鉴TPLinker的标记方法,解决嵌套实体问题。SPN作为的SOTA,其所涉及的NAT解码和在集合纬度上的Loss计算也值得借鉴参考。


实体关系联合抽取方法综述(有监督) 阅读详情

相关推荐

【学习笔记】目标跟踪领域SOTA方法比较

本博客将针对在各多目标跟踪数据集上表现较优的算法模型进行介绍,包括TraDeS、FairMoT、SMILETrack、Bytetrack。

W9XM96的博客 3136

SOTA到底是什么算法

SOTA到底是什么算法? 最近在看论文时看到了SOTA模型,以为是个很牛逼的算法,找了半天原理SOTA是state of the art的缩写。 SOTA model:state-of-the-art model,并不是特指某个具体的模型,而是指在该项研究任务中,目前最好/最先进的模型。 SOTA result:state-of-the-art result,指的是在该项研究任务中,目前最好的模型的结果/性能/表现。 ...

weixin_42329982的博客 3万+

关系抽取(三)实体关系联合抽取:TPlinker

实体关系联合抽取TPLinker

满腹的小不甘 3109

2020_Joint Entity and Relation Extraction with Set Prediction Networks

Joint Entity and Relation Extraction with Set Prediction NetworksAbstractIntroductionMethodSentence EncoderNon-Autoregressive Decoder for Triple Set GenerationInput.Architecture.Bipartite Matching LossExperimentsConclusion 论文 Abstract 联合实体和关系抽取任务的目标是从一个句子

All in.的博客 1695

【NLP】文本摘要的SOTA模型及简单代码实现

文本摘要是将一段长文本缩减为一段简短的内容要点的过程。它可以帮助人们快速地了解一篇文章或一段文字的主要内容,节省时间和精力。文本摘要通常分为两种类型:提取式摘要和生成式摘要。提取式摘要使用文本中已有的句子或段落来生成摘要。这种方法通常涉及到对文本进行语言处理和关键词提取,然后从中选择最重要或最相关的内容。生成式摘要则是从头开始生成一段新的摘要内容,而不是仅仅从原文中提取已有的句子或段落。这种方法通常涉及到使用机器学习算法或深度学习模型对文本进行理解和总结,然后根据这些理解和总结来生成新的内容。

sikh_0529的博客 6424

c#窗体应用(.NET Framework)项目对Yaml文件进行写入与读取,Yaml数据转换成json

用到的技术与版本准备工作Yaml数据在C#中进行定义对Yaml文件的读取与写入代码的添加窗体控件控制操作写入数据到Yaml文件读取Yaml文件数据Yaml数据转换成json改进——对yaml文件读取时根据yaml文件中的键进行获取,对c#中怎么取名字无关yaml文件中多个数据读取遇到的问题总结的小点参考的文章在对Yaml文件进行读取前,先将Yaml文件中的数据结构在c#中进行定义,以便后面更好的读取。这里对这四个类型进行举例(这里为了想看看这四个类型到Yaml文件的格式是什么样子的)

永远年轻 1587

关系抽取信息抽取知识图谱

20210610 1.问宏当的问题 那种信息抽取效果最好 精度,泛化性 2.需要明确的问题 2.1 标注数据的多少 2.2 实体和关系的多少 2.3计划先半个月 出 demo wang shi yang: 数据量少 wang shi yang: 标注工作量大 wang shi yang: 1.三元组提取出来 wang shi yang: 2. 实体消歧义 wang shi yang: 实体统一 wang shi yang: 3.构建知识图谱 wang shi yang: 95% wang shi yang

kyle1314608的博客 1133

Windows 24H2升级后eNSP AR_40报错40?VirtualBox虚拟化修复指南

虚拟化技术通过Hypervisor在操作系统与硬件间建立抽象层,使虚拟机能够共享物理资源。其核心原理依赖CPU的VT-x/AMD-V指令集,而Windows 24H2对内核隔离与驱动签名的强化会直接占用或拦截这些虚拟化资源。在工程实践中,VirtualBox作为Type-2型Hypervisor,常因内存完整性开启或版本过旧导致虚拟网卡创建失败,进而引发设备启动中断。典型场景包括网络仿真实验、多系统测试环境搭建等。当eNSP的AR_40路由器依赖VirtualBox引擎时,24H2的安全策略变更便会触发错误

weixin_34375251的博客 216

SOTA机制详解

1.SOTA的定义 SOTA即软件在线升级(Software updates Over The Air),是指在不连接烧写器的情况下,通过CAN、UART或其它通讯方式,实现应用程序的更新。 在进行SOTA时,需要把旧的应用程序擦除,把新的应用程序写入。常规的实现方式需要分别开发BootLoader程序和APP程序,MCU上电先运行BootLoader,BootLoader根据情况选择是否跳转到APP和是否进行程序更新。具体来说有以下几种方式: 方案一:更新程序时,由APP接收更新数据并暂存于Flash,再

u014157109的博客 8769

利用arpspoof + sslStrip尝试进行arp欺骗

利用arpspoof + sslStrip尝试进行arp欺骗

qq_63575829的博客 355

产品竞争策略方法论:构建“差异化 + 结构化 + 系统化”的竞争优势

本文系统探讨了IoT产品竞争策略,指出当前企业普遍存在硬件能力强但商业竞争能力不足的问题。文章构建了五层竞争模型(产品层、体验层、服务层、数据层、生态层),提出五大核心竞争策略(成本领先、差异化竞争、聚焦竞争、生态竞争、数据驱动竞争),并详细阐述了差异化设计方法。通过行业案例分析(小米、苹果、特斯拉)和五步落地方法,强调从硬件竞争向系统优势转变的重要性。文章指出IoT竞争胜负关键在后半场的数据运营和服务延伸,建议企业通过构建差异化能力、完善服务体系、建立数据体系、逐步构建生态来避免价格战陷阱,实现从跟随到领

专注智能硬件软硬件产品经理成长与实战,分享从需求定义到量产落地的真实日记。涵盖IoT趋势洞察、研发协作经验、产品方法论与工具箱,用轻松有趣的“汪式”视角,陪伴产品经理成长、避坑与升级。 360

【论文阅读】Joint Entity and Relation Extraction with Set Prediction Networks

作者提供的代码链接404了,https://github.com/DianboWork/SPN4RE 目前在NYT和WebNLG上都是SOTA https://paperswithcode.com/task/relation-extraction 1.编码器 用bert 2.三元组非自回归解码器 PL代表句子可能包含的三元组个数,论文中统一设置为m个,m大于所有句子包含的三元组个数。 代表某个三元组Yi,不仅和给定的句子X有关系,而且与其他某个三元组Yj有关系。 使用transformer作为解码.

li_jiaoyang的博客 3516

面向RKNN平台的YOLOv11 Pose部署实战:模型转换、优化与端侧姿态估计推理

本文研究了YOLOv11 Pose模型在Rockchip RKNN平台上的部署方案。通过分析模型架构和关键技术,提出完整的转换流程,包括ONNX格式转换、检测头优化和量化配置。在RK3588硬件平台上实现了100 FPS的实时姿态检测,验证了该方案的可行性。研究主要贡献包括:1)提出YOLOv11 Pose到RKNN平台的完整转换方案;2)优化后处理算法;3)实现高效的边缘计算部署。实验结果表明,该方案能有效解决边缘设备计算资源受限的问题,为人机交互等应用场景提供了实用的技术方案。

m0_71589036的博客 613

【关于 实体-关系联合抽取 】 那些你不知道的事

【关于 实体-关系联合抽取 】 那些你不知道的事

2232

YOLO26涨点改进 | 独家创新,特殊场景检测篇 | TGRS 2025 | 引入FAENet特征自适应增强网络,专注于恶劣天气条件下的目标检测(低光场景、雾天场景、雨雪场景、复杂环境等)即插即用

🔥本文提出了一种名为FAENet的特征自适应增强网络,可有效提升YOLO26在恶劣天气条件下的目标检测性能。FAENet通过拉普拉斯金字塔分解思想,将输入特征分为低频和高频两部分进行针对性增强:低频分支强化全局轮廓,高频分支增强边缘纹理细节。该模块设计轻量、可端到端训练,在不改变原始图像分布的前提下,显著缓解雾霾、低照度等复杂环境造成的特征退化问题。实验表明,该方法在多个恶劣天气数据集上超越了当前最优检测器,同时保持了轻量级和高速度特性。

Ai缝合怪、助力小伙伴高效发论文 334

FOC 转子初始位置检测(图文详解)

什么是转子的初始位置? 其实转子的初始位置是不确定的,但是在电机启动的时候,我们需要得到电角度,这样才可以进行矢量控制;所以,这里将转子与A轴重合作为初始位置,此时电角度也恰好为零,具体如下图所示; ) 至于原理下面会详细分析,这样在转子到初始位置后,也可以得到准确的电角度,就可以实现磁场和转子的同步转动。 如何让转子运行到初始位置? 其实这是一个很简单的问题,在这里我将它放大了,简单地分析了一...

一名热爱技术的工程师的博客。分享技术干货,记录美好生活。永远相信美好的事情即将发生。 2万+

绝了!关系抽取新SOTA

作者|Nine整理 | NewBeeNLP关系抽取目前的算法大概可以分为以下几种:pipeline approach:先抽实体,再判关系,比如陈丹琦的《A Frustratingly Easy Approach for Joint Entity and Relation Extraction 》(后面称为PURE)Joint Entity and Realtion ...

Kaiyuan_sjtu的博客 4998

OTG原理讲解

摘要:USB OTG(On-The-Go)是USB 2.0的重要功能,允许设备在主机和从机间动态切换,实现设备间的直接通信。其核心机制是通过ID引脚电平判断角色:Micro-USB中接地为Host,悬空为Device;USB-C则通过CC引脚协商。电路设计需处理ID引脚连接和VBUS电源控制,MCU根据ID状态配置USB控制器模式。典型应用包括手机连接U盘、键盘等外设,极大扩展了移动设备的连接能力。

m0_49476241的博客 3222

【论文笔记】图像修复Learning Joint Spatial-Temporal Transformations for Video Inpainting

本文提出时空转换网络STTN(Spatial-Temporal Transformer Network)。具体来说,是通过自注意机制同时填补所有输入帧中的缺失区域,并提出通过时空对抗性损失来优化STTN。为了展示该模型的优越性,我们使用标准的静止掩模和更真实的运动物体掩模进行了定量和定性的评价。

xian0710830114的专栏 1万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

实体链接(entity link)初识

实体链接的初级理解

xuanyuanminzheng的博客 1万+

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

CVPR 2022 | 阿里提出单目深度估计新SOTA方法:NeW CRFs

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达作者:原力|已授权转载(源:知乎)编辑:CVerhttps://zhuanlan.zhihu.com/p/522214395单目深度估计是从单张RGB图预测场景深度,是一个很具有挑战性的任务。现在做这个任务的方法大都是设计越来越复杂的网络来简单粗暴地回归深度图,但我们采取了一个更具可解释性的路子,就...

阿木寺的博客 8493

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

计算机视觉中的物体检测与识别:SOTA方法与实践

1.背景介绍 计算机视觉是人工智能领域的一个重要分支,主要研究如何让计算机理解和处理人类世界中的视觉信息。物体检测和识别是计算机视觉中的两个核心任务,它们在许多应用中发挥着重要作用,例如自动驾驶、人脸识别、视频分析等。在本文中,我们将介绍一些最新的SOTA方法和实践,帮助读者更好地理解和应用这些技术。 2.核心概念与联系 在介绍具体的算法和实现之前,我们首先需要了解一些核心概念。 2.1物...

AI天才研究院 1686

知识图谱 | (5) 实体链接综述

原文地址 这个世界充斥着无数的结构化数据(wiki)和非结构化数据(web),然而,如何将两者有效地集成仍然是个非常困难的问题。 本文介绍实体链接(Entity Linking)这一技术方向,会先从最基础的概念讲起,然后对 EL 中的三个主要模块做一个清晰的梳理。在此基础上,选取三篇比较有代表性的论文,详述其中的核心方法和思想。 EL入门 1. 任务定义 实体链接,就是把文本中的 mention ...

sdu_hao的博客 4416

推荐文章:使用Set Prediction Networks实现联合实体和关系抽取

推荐文章:使用Set Prediction Networks实现联合实体和关系抽取 在信息提取领域,实体和关系的联合抽取是至关重要的一步,它有助于从非结构化文本中构建知识图谱,从而更好地理解和利用数据。今天,我们向您推荐一个令人印象深刻的开源项目——Joint Entity and Relation Extraction with Set Prediction Networks (SPN4RE),...

gitblog_00014的博客 715
上一篇: 总结-CNN中的目标多尺度处理
下一篇: 【NLP企业级赛事今日上线】一个雷达和摄像头融合的3D目标检测方法CenterFusion
iFlyAI
博客等级 码龄9年 238粉丝 134原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值