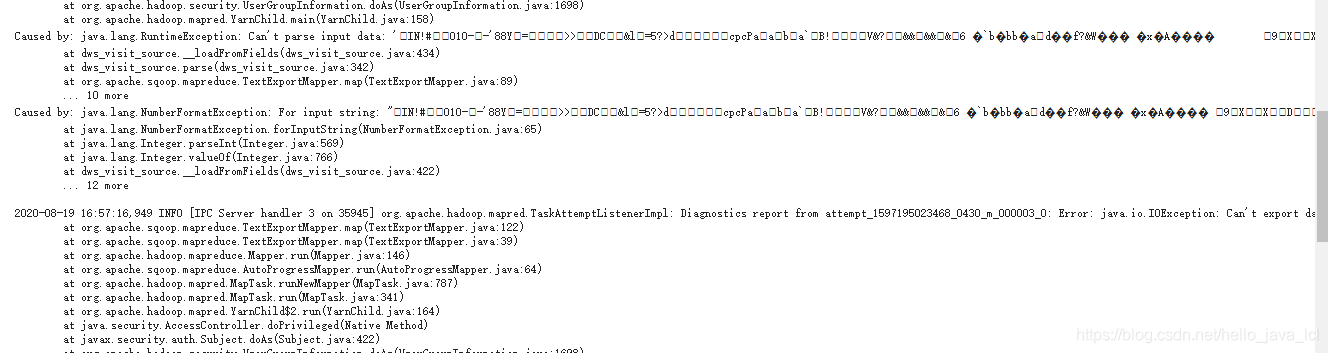
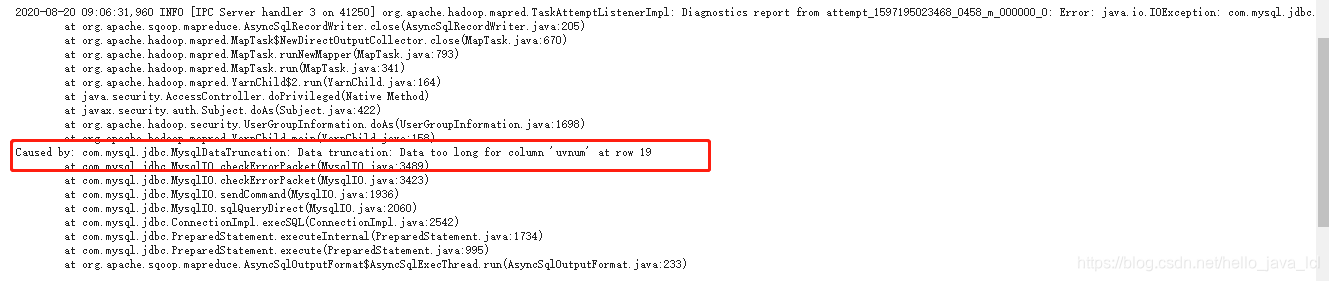
sqoop export 到mysql踩得巨坑。。

利用sqoop将数据从hive导入mysql时报错 ······最近跟着厦门大学实验室在做大数据项目的一个案例,在利用sqoop将数据从hive导入mysql时报错,改了三天,参考了无数的案例,改到人崩溃,终于successfully!真的是我见过最好看的successfully了!记录下报的最多的一个错误,希望能帮助大家,给大家一个参考。 导入数据代码 cd /usr/local/hadoop/sqoop ./bin/sqoop export --connect jdbc:mysql://localhost:3306/dblab --username r 阅读详情

首先把修正后的脚本放出来,然后在说说踩得那些坑!

可以直接下滑到中间从看特别注意开始看。

sqoop export 脚本:

/home/huser/sqoop-1.4.7/bin/sqoop export --connect "jdbc:mysql://localhost9:3306/analysisuseUnicode=true&characterEncoding=
utf-8" \
--username mysql \
--password Pass2020 \
--table tmp_dws_visit_source \
--columns days,visitSourceType,visitSource \
--input-fields-terminated-by '^A' \
--input-lines-terminated-by '\n' \
--input-null-string '\\N' \
--input-null-non-string '\\N' \
--export-dir "hdfs://hadooprt:9000/user/hive/warehouse/rt1.db/dws_visit_source/everyday=2020-08-06/" \
-m 1;

mysql创建表脚本:

#!/bin/bash
everyday="2020-08-06"
sql=$(cat << !EOF

use database;
drop table dws_visit_source;
create table if not exists dws_visit_source(
days string,
visitSourceType string,
visitSource string
)
partitioned by (everyday string)
row format delimited
fields terminated by '^A'
lines terminated by '\n'
stored as textfile;

insert into table dws_visit_source partition(everyday='$everyday1')
select everyday,visitSourceType,visitSource 
from cr_t_test08 where everyday='$everyday' group by visitSourceType,visitSource;

exit;

!EOF)
$HIVE_HOME/bin/hive -e "$sql"
exitCode=$?
if [ $exitCode -ne 0 ];then
         echo "[ERROR] hive execute failed!" >> tmplog.txt
         exit $exitCode
fi

mysql数据库字符设置:

 alter database analysis character set utf8 collate utf8_general_ci;

 ==============================================================

注意事项:

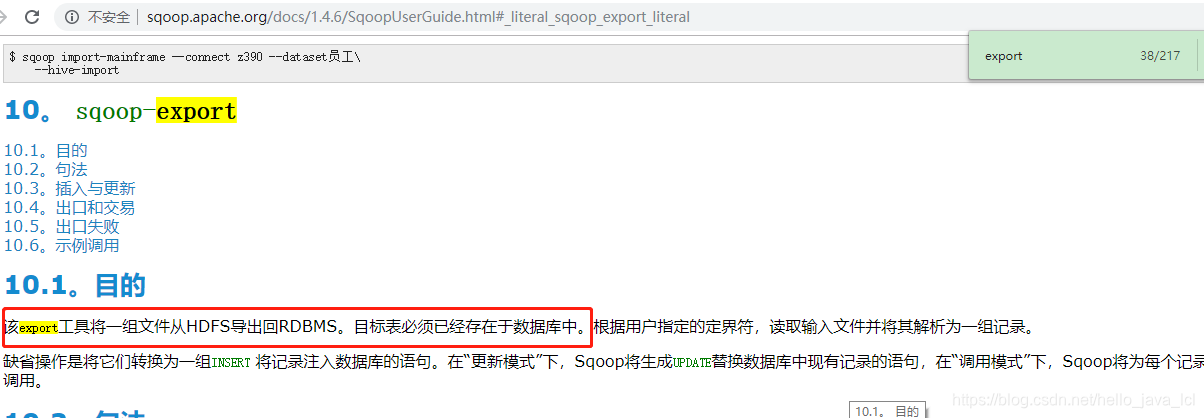
sqoop 导出hive到mysql,需要mysql中创建好表:
 

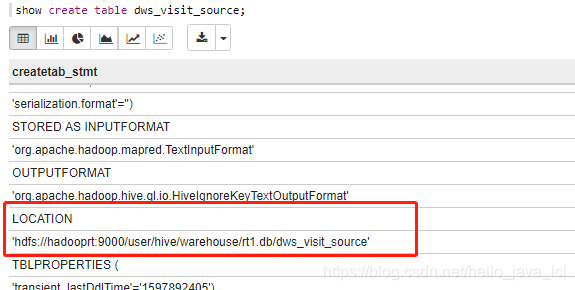
sqoop导出hive表,需要知道表在hdfs中的位置,指定的是hive表在文件中的路径:

--export-dir "hdfs://hadooprt:9000/user/hive/warehouse/rt1.db/dws_visit_source/everyday=2020-08-06/" \

查询hive表的存储位置:

show create table dws_visit_source;
 

======================================================================

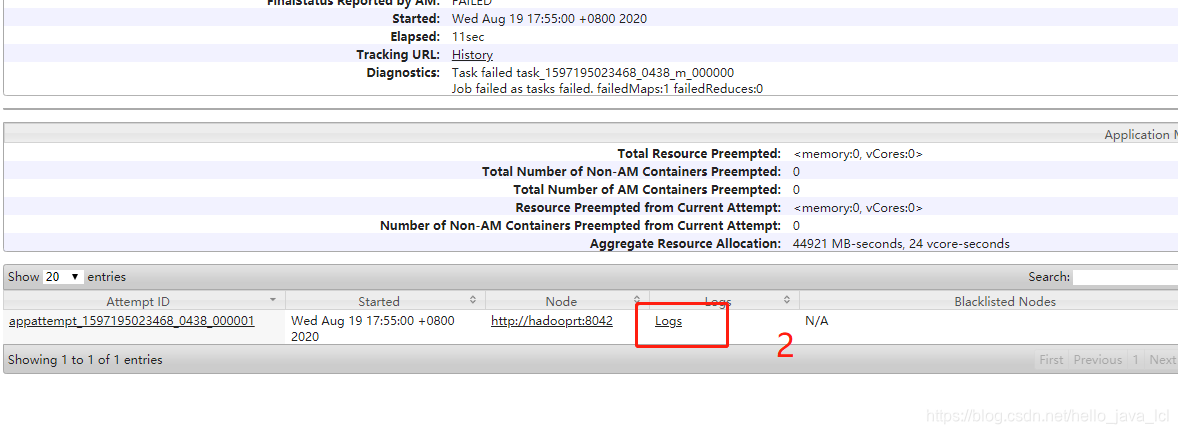
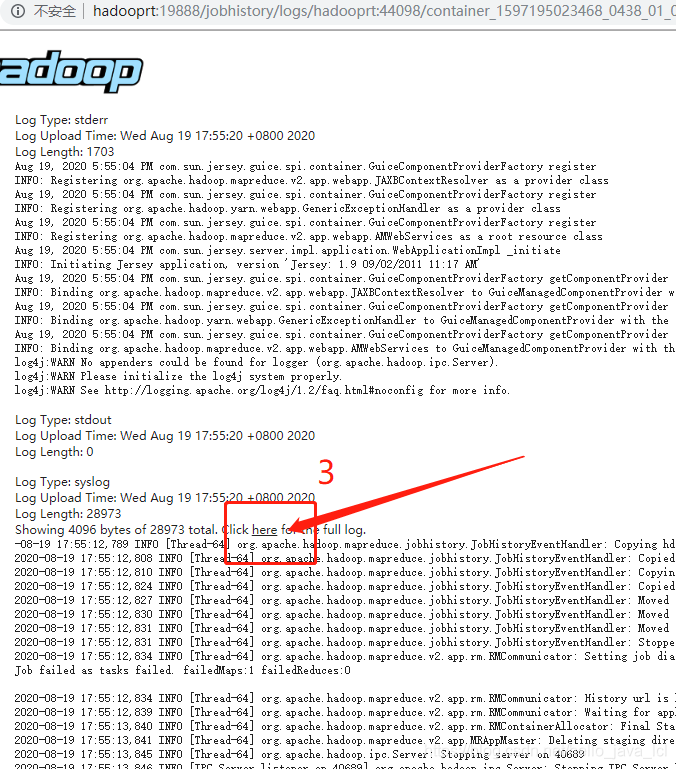
特别注意:如果用sqoop导出导入数据,需要把MapReduce History server启动起来,方便查看报错日志,启动命令:

$HADOOP_HOME/sbin/mr-jobhistory-deamon.sh start historyserver

查看网页:http://hadoop(主机名或IP地址):18088/cluster
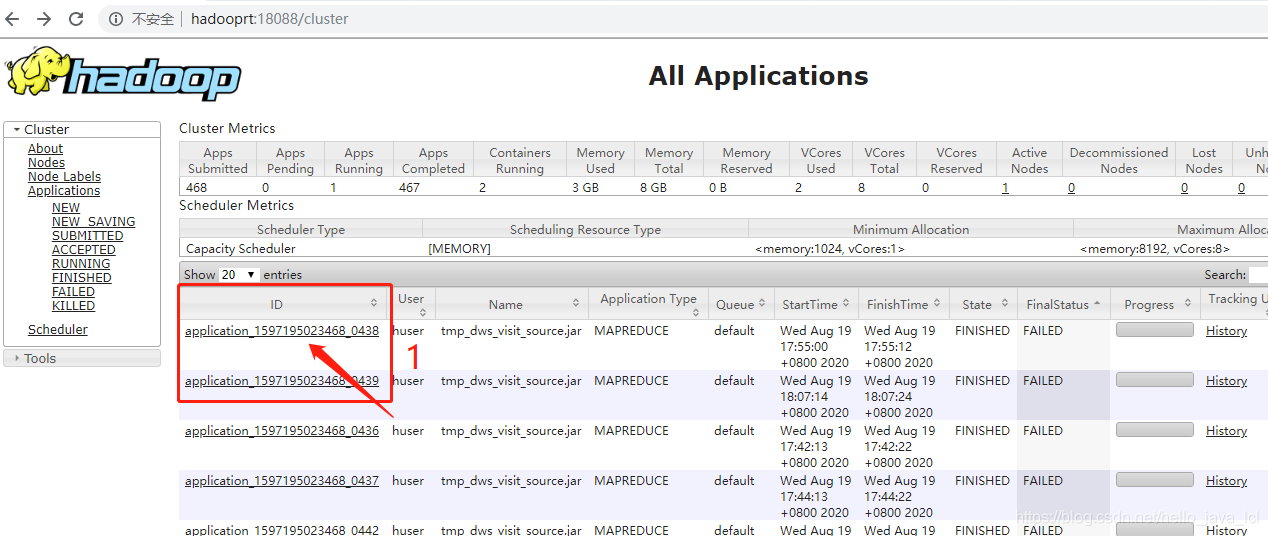
 

就可以查看详细日志了。 

=====================================================================

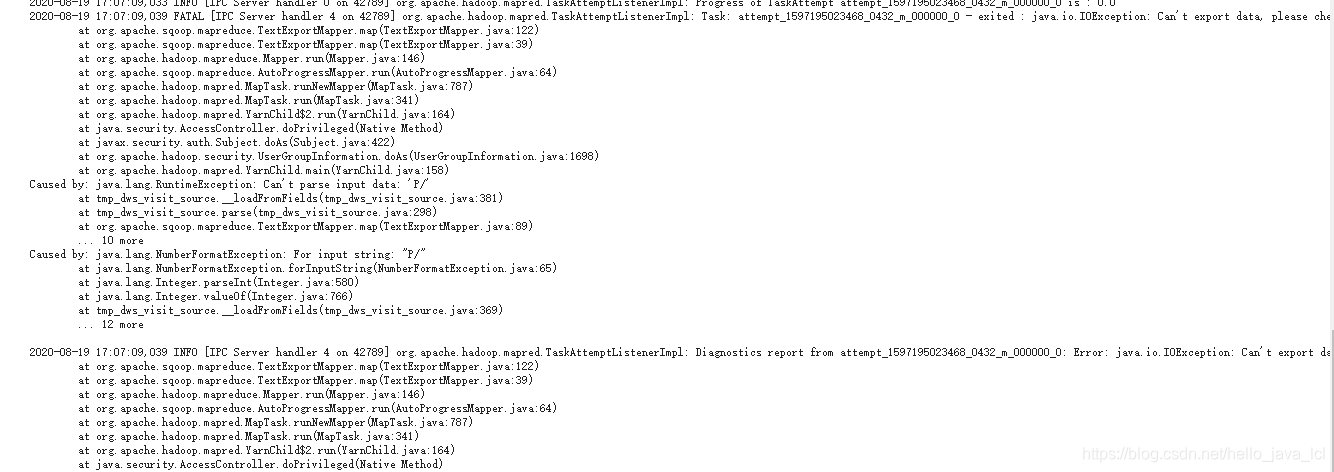
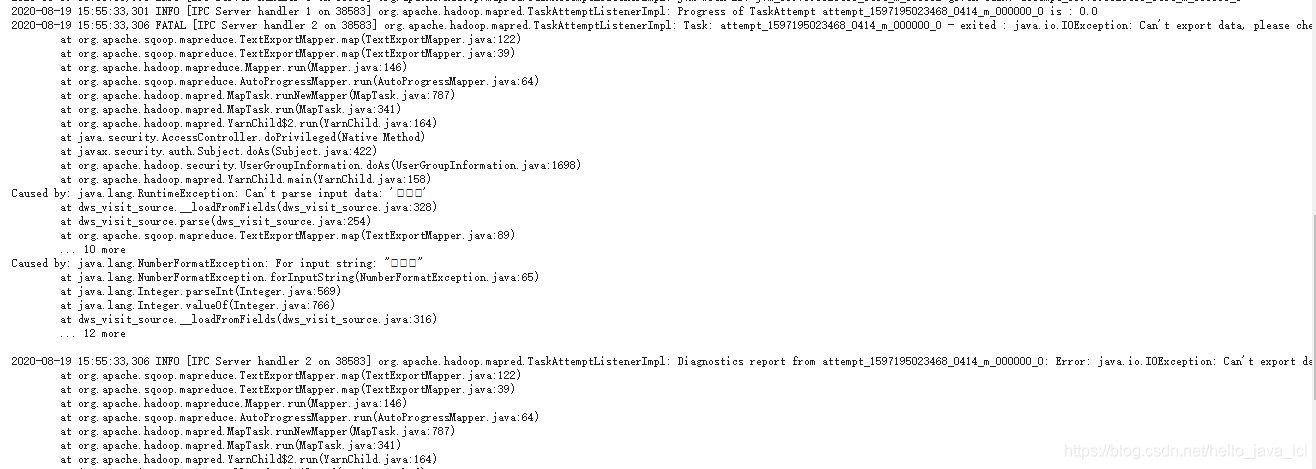
如果日志中有如下类似报错,需要查看几处地方:
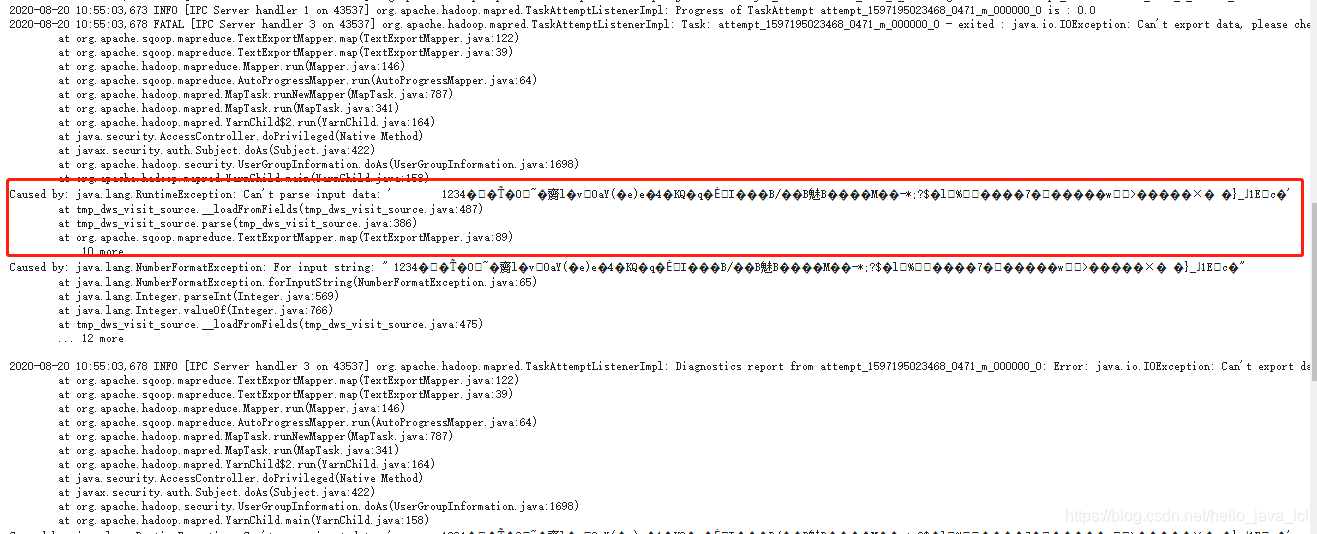
       

 检查位置:

最先检查的一点:hive的文件存储格式!

Sqoop  从hdfs 同步数据到mysql,hive 中的表 必须是textfile 。我就是这个问题,一开始设置的orc,导出找问题改改改,一天以后,发现的这个,然后成功导入数据╮(╯▽╰)╭

sqoop导出脚本中的--input-fields-terminated-by和创建hive表时的fields terminated by '^A'是不是一致的分隔符!
sqoop export 中是否设置了--input-null-string '\\N' \ 和 --input-null-non-string '\\N' \
sqoop export导出字段是否和mysql字段存在错位,如果有错位,可能报错数据转换异常或数据太长异常
如果导入数据了,但是mysql中中文乱码,加 useUnicode=true&characterEncoding=utf-8" \

注意 ^A 一定是手动 Ctrl+v+A 敲上去的,刚刚试验了,复制的都偶尔不好使。╮(╯▽╰)╭

create table if not exists dws_visit_source(
days string,
visitSourceType string,
visitSource string
)
partitioned by (everyday string)
row format delimited
fields terminated by '^A'
lines terminated by '\n'
stored as textfile;--注意,很重要


/home/huser/sqoop-1.4.7/bin/sqoop export --connect "jdbc:mysql://localhost:3306/analysis?useUnicode=true&characterEncoding=utf-8" \
--username mysql \
--password Pass2020 \
--table tmp_dws_visit_source \
--columns days,visitSourceType,visitSource \
--input-fields-terminated-by '^A' \
--input-lines-terminated-by '\n' \
--input-null-string '\\N' \
--input-null-non-string '\\N' \

--export-dir "hdfs://hadooprt:9000/user/hive/warehouse/rt1.db/dws_visit_source/everyday=2020-08-06/" \
-m 1;


 

Sqoop export columns 参数使用 0 使用场景 如果不使用 column 参数,就要默认Hive 表中的字段顺序和个数和MySQL表保持一致,如果字段顺序或个数不一致可以加 columns 参数进行导出控制。 hive中的表字段数目和目标mysql表字段数目可以不一致,加 columns 参数 hive中的表字段和目标mysql表字段名称顺序可以调整,加 columns 参数 1.Hive字段顺序和MySQL保持一致 (1)添加 id字段 (2)MySQL 中插入两条记录 (3)Hive表中添加一条记录 ..... 阅读详情

相关推荐

Win10安全模式下修改C盘权限的完整指南(附解决开始菜单失灵方案)

本文提供了一份在Win10安全模式下修复因C盘权限误改导致开始菜单失灵的完整指南。文章深入剖析了权限体系,特别是TrustedInstaller角色的重要性,并详细讲解了通过安全模式进入系统、使用ICACLS命令或图形界面精准重置C盘关键目录权限的步骤,最终恢复系统核心功能。

weixin_29250403的博客 234

如何完美解决Sqoop导入导出MySQL数据错位问题

Sqoop

Mirror_w的博客 4051

Obsidian + AI 自动知识管理:手把手教程

装完后,在命令面板(Ctrl+P)搜 "Generate Summary",AI 会在当前笔记末尾追加一段摘要。你一个月前写的、现在想快速回顾的笔记长篇笔记(三千字以上)开会记录这类信息密集的内容过度自动化。有人装上插件后,所有笔记都让 AI 打标签、写摘要、找关联。最后笔记库看起来整整齐齐,但全都是 AI 的链接,你自己完全没参与。这样做的后果是什么?你写过的笔记跟你没有"真实连接"。你还是记不住。你还是不知道自己的知识库里有什么。AI 推荐,你决策。

weixin_43571227的博客 748

使用sqoop将数据从Hive导入MySQL出现的问题

使用sqoop将数据从Hive导入MySQL出现无法连接的问题 前言 在搭建hadoop分布式集群时,将workers文件(hadoop 3.x)或者slaves文件(hadoop2.x)中的localhost删除,并添加了slave1节点,最终master节点只做为namenode节点使用,不作为datanode。作者使用的hadoop版本分别是hadoop3.1.3和hadoop2.7.1。 问题 我们先启动hadoop集群、以及MySQL服务 service mysql start start-all

kemomimi的博客 1660

AI Agent在智能投研中的实战:多智能体信息整合与策略生成

本文将带你从0到1完整搭建一套基于LangChain和AutoGen的多智能体AI投研系统首先,我们会一起梳理智能投研的核心痛点、金融数据的独特性,以及为什么传统AI Agent,尤其是多智能体协同架构,是破局的唯一最优解;RAG检索增强生成(但这次是金融领域定制化的,包括向量检索+时序数据检索+知识图谱检索的“三元检索增强”)、AutoGen多智能体协同框架。

软件工程实践的博客 381

多模态变体—ALIGN:高效的图像-文本学习

ALIGN 论文介绍了该模型的关键技术。无人工标注数据:使用互联网数据进行训练,不依赖人工清洗的数据集。高效的对比学习策略:采用大规模图像-文本配对数据,通过对比学习优化嵌入空间。支持零样本(zero-shot)学习:可以在没有专门训练的情况下执行多种任务,如分类、检索等。可扩展性强:ALIGN 采用高效的 CNN 或 Transformer 作为编码器,适用于大规模计算。

Azperk的博客 1218

sqoop支持mysql8_sqoop抽取mysql数据 遇到问题及解决方案

sqoop import --connect 'jdbc:mysql://127.0.0.1/dbname' --username 'username' --password 'userpass' --query "select product_id, price, sale_price, shop_id from product_base where creation_time > '20...

weixin_35682426的博客 1037

PCB工程师必看:别再搞错1078玻纤布的Dk了,手把手教你算等效介电常数

本文为PCB工程师提供了1078玻纤布等效介电常数(Dk)的详细计算指南,帮助解决高速设计中的信号完整性问题。通过解析玻纤布结构、混合介质理论和实战计算方法,指导工程师准确设置EDA工具参数,避免常见的Dk计算误区,提升设计精度和仿真准确性。

weixin_42546392的博客 399

大数据课程综合实验案例---课设问题汇总

大数据课设问题汇总

ELSA001的博客 2346

基于Simulink的加速度计振动分析:单自由度质量-弹簧-阻尼系统

摘要:基于Simulink的加速度计单自由度振动分析 本文研究了加速度计的单自由度(SDOF)质量-弹簧-阻尼系统模型,通过MATLAB/Simulink平台建立了完整的振动分析仿真系统。文章详细阐述了理论建模过程,推导了系统运动微分方程和传递函数,并提供了Simulink模型搭建的具体步骤和MATLAB实现代码。研究通过正弦扫频、随机振动和冲击响应三种典型输入信号,分析了系统的幅频特性、相频特性及时域响应,验证了加速度计的工作机理。仿真结果表明,该方法能有效模拟加速度计在不同激励条件下的动态特性,为传感器

AI的内部世界的博客 163

ANSYS Fluent:湍流模型理论与应用

雷诺平均方程(RANS,Reynolds-Averaged Navier-Stokes equations)是湍流建模中最常用的方法。它通过将Navier-Stokes方程中的瞬时速度分解为平均速度和脉动速度,然后对这些方程进行时间平均,从而简化了湍流的计算。RANS方法的关键在于湍流闭合问题的解决,即如何准确地表示脉动速度的统计量。雷诺应力模型(RSM)是一种更高级的湍流模型,它通过求解六个雷诺应力方程来描述湍流的各向异性。RSM模型能够更准确地预测复杂的湍流流动,如旋转流和分离流,但计算成本较高。

kkchenjj的博客 2947

踩坑——Sqoop报错ERROR tool.ExportTool: Error during export

@羲凡——只为了更好的活着 踩坑——Sqoop报错ERROR tool.ExportTool: Error during export 控制台打印的报错是 19/04/19 20:17:09 ERROR mapreduce.ExportJobBase: Export job failed! 19/04/19 20:17:09 ERROR tool.ExportTool: Error during ...

@羲凡—只为更好的活着 1万+

S/4HANA Private Cloud 与 On-Premise 的 Key User Custom Fields 运输与升级避坑指南

本文探讨了SAP S/4HANA Cloud Private Edition和On-Premise系统中Key User Custom Fields的管理要点。文章指出,Custom Fields涉及元数据生成、对象一致性、传输治理等完整链路,操作不当会导致字段丢失或升级失败。关键建议包括:使用ATO Fiori App管理扩展项与传输绑定,配置正确的job user权限,避免在多系统并行开发同一字段。特别强调升级时需执行CFD_REGENERATE_IN_ONPREMISE报表,并通过标准传输机制推进变更

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 196

Sqoop其一,理论、安装、使用、import和export简单示例

Sqoop的理论,安装,使用以及案例演示,希望对你有所帮助。

出发行进 1450

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Sqoop export 导出推数详解

前言 因为工作上用到sqoop从hive导出数据到关系型数据库,所以学习了下sqoop导出的具体功能,因除官网外(全英文,可能部分人不喜欢看英文),没有特别好的资料,在此整理总结下自己关注的一些东西。环境说明,sqoop 1.4.6,先按照导出到mysql进行总结。 命令参数 主要整理可能用到的参数,不包含所有参数,有需要可以自行去官方查看~~ eval 可使用SQL语句对关系数据库进行操作。后面...

Sin_Geek成长の迹 7166

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

sqoop的import命令和export命令

sqoop的import命令和export命令 一. import命令 数据从mysql导入到hdfs当中 前提:先在MySQL中创建到一个user表 create table user(id int primary key auto_increment,name varchar(20),addr varchar(200)); insert into user(id,name,addr) va...

qq_42604959的博客 542

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

【头歌】Sqoop数据导出 - 详解

【主要内容】Sqoop数据导出语法学习;HDFS数据导出至Mysql内;Hive数据导出至MySQL中。 【实践内容】Sqoop数据导出语法实践与详解。

梦想编程家博客 9253

sqoop的import与export及其脚本使用

sqoop的import与export及其脚本使用

龙子木的博客 1万+

小白篇(十二):sqoop export指令实操

我的原文地址: https://mp.weixin.qq.com/s?__biz=MzIxMzg5NzI4OQ==&tempkey=MTA4Nl9jOHJHZVlabjhMOWt4OEhMbndmR2lYX2ZNanlYQ1VrM2VjbFVDN2VhZS0xMDBUZXVHNVVPLVg0THRYSldVUXN6cnA2U2ZNejJoZ1NhOFB4MVRyS1ZXZDNQdXdDSEh0b085aGxuRmJMbnpFRUJ1RURwaEJ5VXJGZTZkTHduZlZkNU5YVnRMa

belialxing的专栏 3582

sqoop export导出数据到mysql(追加/更新)

准备数据: data.txt 1,zhangsan,18,2020-01-01 2,lisi,19,2020-02-02 3,wangwu,20,2020-03-03 4,zhaoliu,21,2020-04-04 5,tianqi,22,2020-05-05 6,luba,23,2020-06-06 7,sunjiu,24,2020-07-07 8,gaoshi,25,2020-08-08 9,xiaoshiyi,26,2020-09-09 10,wushier,27,2020-10-10 将数据放到h

qq_28603127的博客 7283

一个sqoop export案例中踩到的坑

案例分析:   需要将hdfs上的数据导出到mysql里的一张表里。   虚拟机集群的为:centos1-centos5 问题1: 在centos1上将hdfs上的数据导出到centos1上的mysql里: sqoop export   --connect jdbc:mysql://centos1:3306/test \   --username root \ ...

abc19890308的博客 1149

sqoop export mysql_使用 sqoop 将 hive 数据导出到 mysql (export)

EFdeMacBook-Pro:bin FengZhen$ sqoop export --connect jdbc:mysql://localhost:3306/sqooptest --username root --password 123qwe --table sqoop_test --export-dir /user/hive/external/sqoop_test --input-fiel...

weixin_39866419的博客 277

Sqoop的安装及使用Sqoop导入至mysql、hive、hbase

Sqoop的安装及常见使用1、Sqoop的安装2、Sqoop的使用1.Sqoop的常用命令2.命令对应参数解析2.1数据库连接参数2.2 import参数2.3 export参数2.4 Hive参数2.5 Job参数3、Sqoop常用操作1.hdfs导入到mysql2.mysql导入到hdfs全量导入列剪裁行裁剪+多个reducer增量导入|append增量导入|lastmodified3.mysql导入到hive中全量导入间接导入方式一方式二4.job 1、Sqoop的安装 解压sqoop安装包 tar

Wan的博客 1391

【SQOOP】sqoop import hive ,export mysql 实践及遇到的问题

sqoop version :Sqoop 1.4.6-cdh5.15.1 mysql cron_table 数据结构大家先记住一下后面会出现很多问题: 1、从mysql 导入数据到 hive 1.1 第一次是以英文 ','为field 分隔符,如果没有指定 --hive-table default.xxxx,默认为mysql的表名: cron_task sqoop impor...

Zsigner的博客 805
上一篇: hive的case when then和cast
下一篇: Shell中获取取今天、明天、昨天和多天前日期
lcl_bigdata
博客等级 码龄11年 268粉丝 67原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值