Spark Python 快速体验

python——spark使用 Spark使用Scala语言进行实现,能操作分布式数据集。Spark是在借鉴了MapReduce之上发展而来的,继承了其分布式并行计算的优点并改进了MapReduce明显的缺陷。Spark的适用场景:1. 复杂的批量处理(Batch Data Processing),偏重点在于处理海量数据的能力,至于处理速度可忍受,通常的时间可能是在数十分钟到数小时;2. 基于历史数据的交互式查询(Interactive Query),通常的时间在数十秒到数十分钟之间。 阅读详情

Spark是2015年最受热捧大数据开源平台,我们花一点时间来快速体验一下Spark。

Spark 技术栈
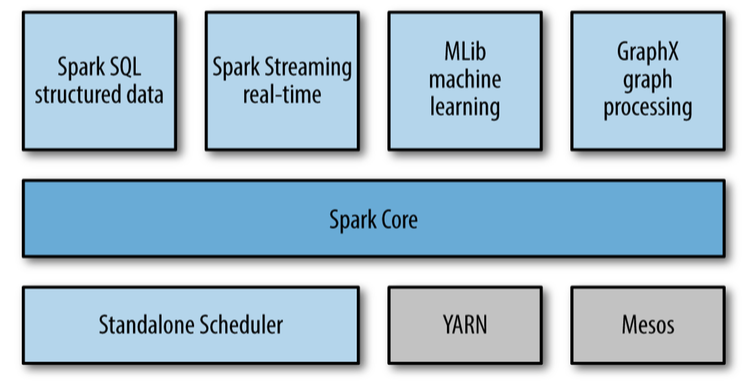
如上图所示,Spark的技术栈包括了这些模块:

  • 核心模块 :Spark Core

  • 集群管理 

    • Standalone Scheduler

    • YARN

    • Mesos

  • Spark SQL

  • Spark 流 Streaming

  • Spark 机器学习 MLLib

  • GraphX 图处理模块


安装和启动Spark

Spark Python Shell

> bin/pyspark

Spark Ipython Shell

> IPYTHON=1 ./bin/pyspark
> IPYTHON_OPTS="notebook" ./bin/pyspark

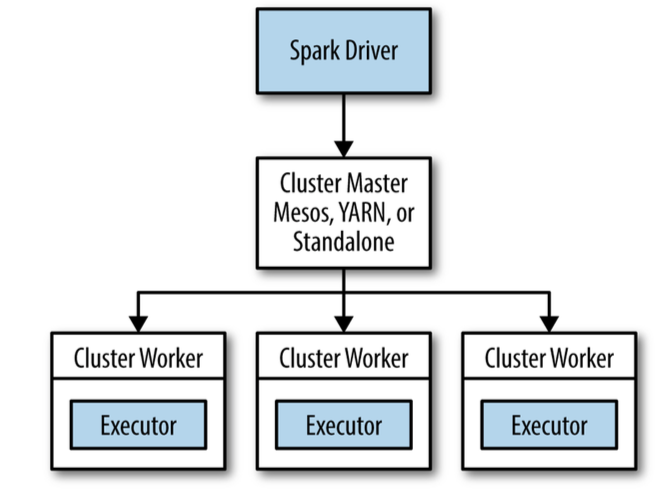
Spark 架构
初始化 Spark Context

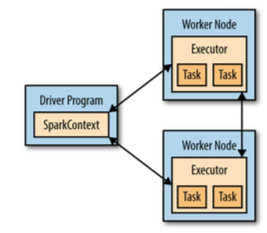
在使用Spark的功能之前首先要初始化Spark的context,Context包含了Spark的连接和配置信息。

Spark Context,Driver和Worker节点之间的关系如下图:
from pyspark import SparkConf, SparkContext
conf = SparkConf().setMaster("local").setAppName("My App")
sc = SparkContext(conf = conf)

创建 RDD

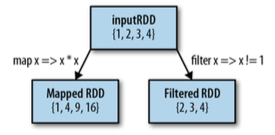
RDD是Spark的基本数据模型,所有的操作都是基于RDD。RDD是inmutable(不可改变)的。
lines = sc.textFile("README.md")
pythonLines = lines.filter(lambda line: "Python" in line) 
pythonLines.first()
pythonLines.count()

RDD 操作:

下面是一些对RDD的变形操作

RDD Transformation on {1,2,3,4}

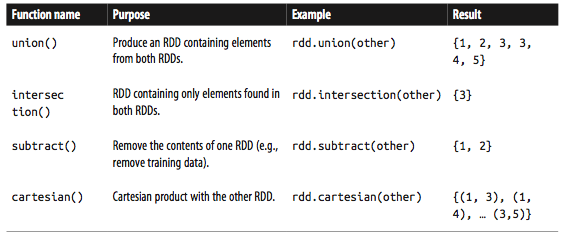
两个RDD之间的操作, Transformation on {1,2,3} and {3,4,5}
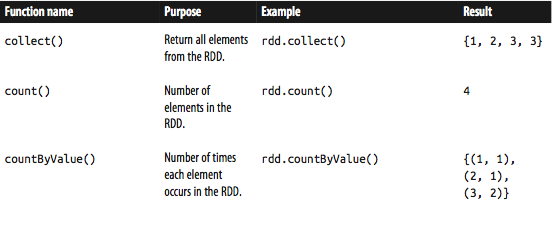
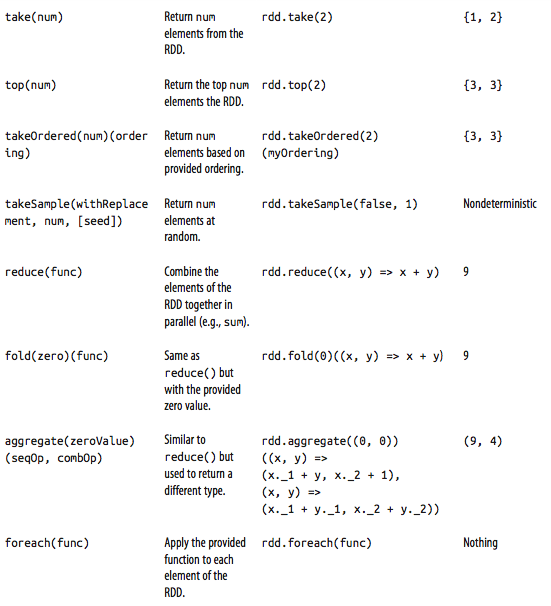
RDD actions on {1,2,3,3}
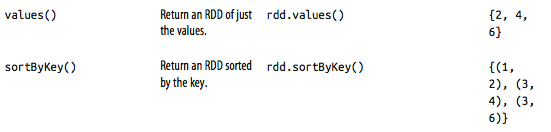
Transformation on pair RDD {(1,2),(3,4),(3,6)}

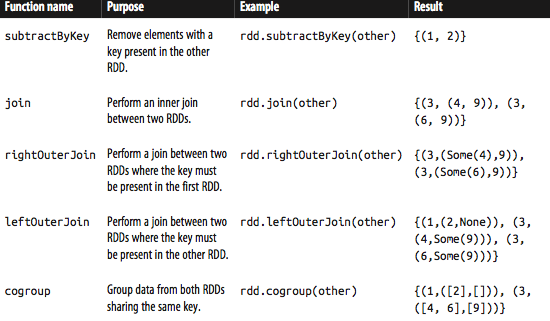
Transform on two pair RDDs {(1,2),(3,4),(3,6)}, {(3,9)}


Spark 流 stream

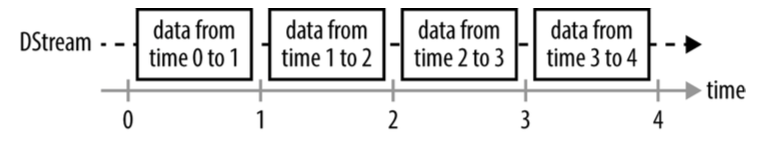
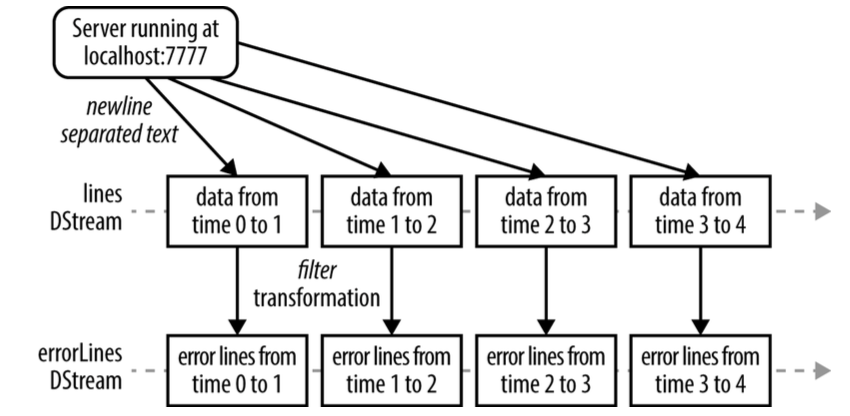
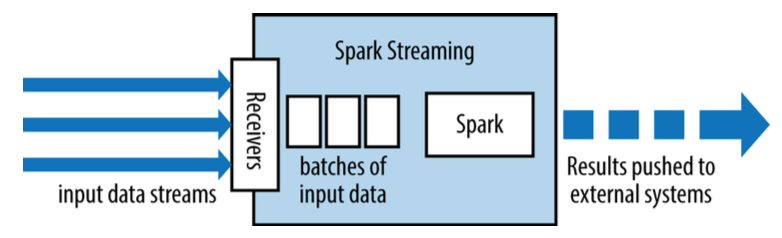
Spark流基于RDD,可以理解对小的时间片段上的RDD操作。


SparkSQL

Spark SQL可以用于操作和查询结构化和半结构化的数据。包括Hive,JSON, CSV等。

# Import Spark SQL
from pyspark.sql import HiveContext, Row
# Or if you can't include the hive requirements
from pyspark.sql import SQLContext, Row 
					
input = hiveCtx.jsonFile(inputFile)
# Register the input schema RDDinput.registerTempTable("tweets")
# Select tweets based on the retweetCount
topTweets = hiveCtx.sql("SELECT text, retweetCount FROM tweets ORDER BY retweetCount LIMIT 10")

Spark SQL支持JDBC

SparkML 

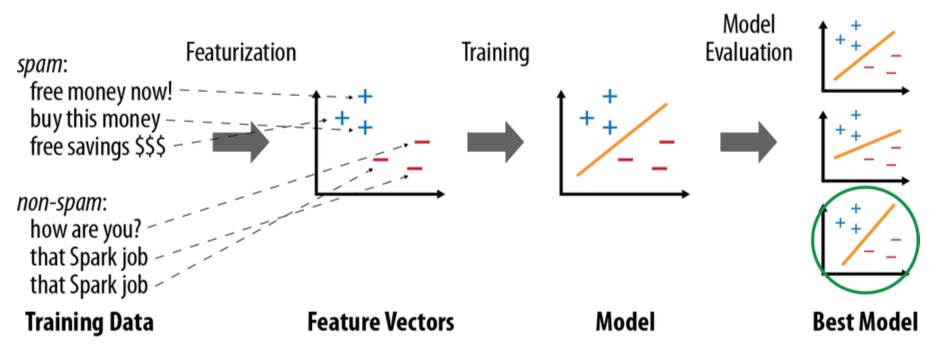
机器学习的基本流程如下:

    1. 获得数据

    2. 从数据中提取特征

    3. 对数据进行有监督的或者无监督的学习,训练机器学习的模型

    4. 对模型进行评估,找出最佳模型

由于Spark的架构特点,Spark支持的机器学习算法是哪些可以并行的算法。

from pyspark.mllib.regression import LabeledPoint
from pyspark.mllib.feature import HashingTF
from pyspark.mllib.classification import LogisticRegressionWithSGD
					
spam = sc.textFile("spam.txt")normal = sc.textFile("normal.txt")
				
# Create a HashingTF instance to map email text to vectors of 10,000 features.
				
tf = HashingTF(numFeatures = 10000)
# Each email is split into words, and each word is mapped to one feature.
spamFeatures = spam.map(lambda email: tf.transform(email.split(" ")))
normalFeatures = normal.map(lambda email: tf.transform(email.split(" ")))
				
# Create LabeledPoint datasets for positive (spam) and negative (normal) examples.
					
positiveExamples = spamFeatures.map(lambda features: LabeledPoint(1, features))
negativeExamples = normalFeatures.map(lambda features: LabeledPoint(0, features))
trainingData = positiveExamples.union(negativeExamples)
trainingData.cache() # Cache since Logistic Regression is an iterative algorithm.
			
# Run Logistic Regression using the SGD algorithm.
				
model = LogisticRegressionWithSGD.train(trainingData)
				
# Test on a positive example (spam) and a negative one (normal). We first apply
# the same HashingTF feature transformation to get vectors, then apply the model.
posTest = tf.transform("O M G GET cheap stuff by sending money to ...".split(" "))
negTest = tf.transform("Hi Dad, I started studying Spark the other ...".split(" "))
print "Prediction for positive test example: %g" % model.predict(posTest)
print "Prediction for negative test example: %g" % model.predict(negTest) 

使用Python开发spark spark 阅读详情

相关推荐

Win11 Docker 快速部署spark(快速部署pySpark 、使用Docker compose部署spark)

构建镜像完成后,还需要修改 docker-compose.yml 文件,使其从新的镜像 s1mplecc/spark-hadoop:3中启动容器集群,同时映射 Hadoop Web UI 端口。HDFS 上的文件被读取为 RDD,在内存上进行 Transformation 后写入 HDFS。由于设置了 ssh 免密通信,首先需要启动 ssh 服务,然后依次启动 HDFS 和 YARN 集群。:挂载本地目录 D:/Docker/spark/share 到容器目录 /opt/share;

weixin_52785140的博客 3561

Spark(Python版)——Spark概述

Spark 概述 运行速度快 容易使用 Spark本质上计算模式也是MapReduce,但是操作不局限于Map和Reduce两个操作,提供了更多的操作类型。而且Spark会存储在内存中,磁盘IO开销很小。 Spark 生态系统 大数据处理主要包括: 复杂的批量数据处理 基于历史数据的交互式查询 基于实时数据流的数据处理 过去我们需要同时部署三种不同的软件,如MapReduce、Impala、Storm 会存在如下问题: 不同场景之间输入输出数据无法做到无缝共享,通常需要进行数据格式的转换。 不同的软件

karry_zzj的博客 5729

anaconda配置spark_快速搭建你的Spark开发环境

公众号后台回复关键字:pyspark,获取本项目github地址链接。一,搭建本地pyspark单机练习环境以下过程本地单机版pyspark练习编程环境的配置方法。注意:仅配置练习环境无需安装hadoop,无需安装scala.1,安装Java8下载地址:https://www.oracle.com/technetwork/java/javase/downloads/jdk8-downlo...

weixin_35942678的博客 1174

Spark 学习-1 (python)

Spark学习-自用笔记

m0_55641196的博客 3303

mobaXterm连接vmWare虚拟机上的centOS7提示连接失败的解决方法

1.问题描述: mobaXterm安装后连接虚拟机vmWare上的centOS7发现连接不上,如下图所示: 2.解决方法 先是查了一下centOS的ip 开始错误的以为 virbr0: 后面的inet就是虚拟机的IP 实则不然(正确的ip是在ens33后面的inet中的ip,大佬们勿喷) 这个值需要配置一下的,具体配置过程如下: step1: 进入centOS下的/...

hss19214的博客 7891

避坑指南:为什么你的conda环境装不上Mamba?从CUDA到ABI的深度排查

本文深入解析conda环境中安装Mamba架构时常见的CUDA版本冲突、ABI不匹配等问题,提供从基础检查到深度排查的系统化解决方案。针对`causal-conv1d`和`mamba-ssm`安装失败场景,详细讲解PyTorch版本绑定、编译器工具链兼容性等关键技术要点,并给出预编译wheel选择、动态链接库配置等实用修复方案。

weixin_33738555的博客 346

分布式的计算框架之Spark(python第三方库视角学习PySpark)

Spark 主要有三个特点:首先,高级 API 剥离了对集群本身的关注,Spark 应用开发者可以专注于应用所要做的计算本身。其次,Spark 很快,支持交互式计算和复杂算法。最后,Spark 是一个通用引擎,可用它来完成各种各样的运算,包括 SQL 查询、文本处理、机器学习等,而在 Spark 出现之前,我们一般需要学习各种各样的引擎来分别处理这些需求。(来源百度百科)

伤心的辣条 2299

Python XML 转 JSON,XML 转字典

今天我们将学习如何在 Python 中将 XML 转换为 JSON 和 XML 转换为字典。我们可以使用 Python 的xmltodict模块来读取 XML 文件并将其转换为字典或 JSON 数据。我们还可以在大型 XML 文件上进行流式处理,并将其转换为字典。在进入编码部分之前,让我们首先了解为什么需要进行 XML 转换。

rubys_的专栏 2504

sparkpython效率_Spark Python 快速体验

Spark是2015年最受热捧大数据开源平台,我们花一点时间来快速体验一下Spark。Spark 技术栈如上图所示,Spark的技术栈包括了这些模块:核心模块 :Spark Core集群管理Standalone SchedulerYARNMesosSpark SQLSpark 流 StreamingSpark 机器学习 MLLibGraphX 图处理模块安装和启动SparkSpark Python...

weixin_39578457的博客 144

ESP32 DMX512与RDM协议栈开发指南

DMX512-A是专业灯光控制领域广泛采用的串行通信标准,基于RS-485物理层实现确定性单向数据传输;RDM(Remote Device Management)则在其基础上扩展双向、可寻址、可配置的智能管理能力,满足现代舞台设备远程固件升级、自动发现与参数配置需求。二者共用同一总线但时序与帧结构严格隔离,对硬件定时精度、中断响应延迟及电气隔离提出极高要求。在嵌入式实践中,ESP32凭借Wi-Fi/蓝牙连接能力与丰富外设资源,成为构建低成本智能DMX节点的理想平台。esp_dmx协议栈正是面向该场景的高性能

weixin_34945060的博客 316

RML2016.10a (CNN、LSTM、CNN-LSTM、CNN-LSTM-Multi-head-attention, TensorFlow)

RML2016.10a (CNN、LSTM、CNN-LSTM、CNN-LSTM-Multi-head-attention, TensorFlow) 包含所有数据和代码,支持一键运行(jupyter)

qq_40999533的博客 1485

开始spark之旅

比Hadoop更小巧的一个分布式计算框架,基于内存。很方便的在python中使用.刚刚开始用。在这里记录一下使用spark的旅程。 转载于:https://my.oschina.net/...

117

UNet 改进(39):结合残差连接与CBAM注意力机制的unet模型

本文提出了一种改进的UNet架构,通过融合残差连接和CBAM注意力机制来增强医学图像分割性能。该网络保留UNet的U形结构,但将基础模块替换为ResidualBlock和CBAM的组合:残差块通过快捷连接解决梯度消失问题,CBAM模块结合通道和空间注意力机制突出重要特征。整体架构采用编码器-解码器设计,包含5个下采样和上采样阶段,通过跳跃连接融合多尺度特征。实验表明,这种改进显著提升了原始UNet的性能,特别适用于需要精细边界的医学图像分割任务。

2401_82355416的博客 1040

基于Spark的共享单车数据存储系统

【2025最新】基于大数据+大屏可视化+Python+Django+Vue+MySQL的共享单车数据存储系统。

计算机学姐的博客 1369

Vue3 - Element Plus 表格组件 el-table “表格行数据中又嵌套了二维对象数组“,按平级循环渲染(嵌套数组视为同级行数据), 对嵌套的数组循环展示为表格,智能合并行或列详细教程

vue3,nuxt3,element-plus,table表格组件,el-table,vue3element表格组件,数据中有二维数组怎么遍历循环显示,表格数据带二级数组怎么循环渲染显示,表格数据中存在一个数组要怎么才能显示到表格,el-table表格合并详细教程示例,table表格如果对象里面还有对象数组那该怎么去渲染,平常都是数组中一个对象渲染成一行,每行中还有嵌套数组怎么办,每个行数据下还有一个数组怎么显示,怎么把表格相同的数据合并为一行,合并上下两行相同数据单元格,合并行或列如果遇到相同单元格就合

🏆 前端领域优质创作者 1万+

飞牛fnNAS搭建web版微信

摘要:本文介绍了一种通过Docker在飞牛NAS上部署微信客户端的方法,实现24小时同步微信聊天记录。具体步骤包括:1)激活飞牛NAS的Docker功能并配置镜像加速源;2)创建专用文件夹并下载docker-wechat镜像;3)设置容器参数并部署微信客户端;4)通过局域网或ZeroTier内网穿透实现远程访问。相比传统Windows/Linux方案,该方法资源占用更低,适合需要长期保存微信聊天记录的用户。

dgnankai的专栏 3343

大数据生态和Spark简介

Spark简介: Spark最初由美国加州大学伯克利分校(UC Berkeley)的AMP实验室于2009年开发,是基于内存计算的大数据并行计算框架,可用于构建大型的、低延迟的数据分析应用程序。2013年Spark加入Apache孵化器项 Spark的主要特点: 运行速度快:使用DAG执行引擎以支持循环数据流与内存计算 容易使用:支持使用Scala、Java、Python和R语言进行编程,可以通过Spark Shell进行交互式编程 通用性:Spark提供了完整而强大的技术栈,包括SQL查询、流

qq_52009317的博客 250

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

spark python入门教程_Spark编程快速入门

本教程基于Spark官网的快速入门教程改编而来,官方文档和中文翻译的传送门见最下方。(注意,实际情况可能因为版本不同等原因有所不同)如果对本文中的一些名词感到疑惑,可以看另外一篇入门文章:五分钟大数据:Spark入门关键字:使用 Spark Shell 进行交互式分析启动Spark提供了一个学习API的简单方式,就是Spark shell——同时也是一个强大数据交互式分析工具。基于scala和py...

weixin_39773158的博客 655

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

python——spark入门

本文中,我们将首先讨论如何在本地机器上或者EC2的集群上设置Spark进行简单分析。然后,我们在入门级水平探索Spark,了解Spark是什么以及它如何工作(希望可以激发更多探索)。最后两节我们开始通过命令行与Spark进行交互,然后演示如何用Python写Spark应用,并作为Spark作业提交到集群上。

m0_59485658的博客 4244

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

python 链接spark_[大数据之Spark]——快速入门

本篇文档是介绍如何快速使用spark,首先将会介绍下spark在shell中的交互api,然后展示下如何使用java,scala,python等语言编写应用。可以查看编程指南了解更多的内容。为了良好的阅读下面的文档,最好是结合实际的练习。首先需要下载spark,然后安装hdfs,可以下载任意版本的hdfs。Spark Shell 交互基本操作Spark Shell提供给用户一个简单的学习API的方...

weixin_29256771的博客 226

docker-spark完全指南:如何用Docker快速部署Apache Spark集群

Apache Spark作为强大的分布式计算框架,其部署过程往往让新手望而却步。而docker-spark项目通过Docker容器化技术,让复杂的Spark集群部署变得简单高效。本文将带你一步步完成从环境准备到集群运行的全过程,即使是Spark初学者也能轻松上手。 ## 📋 准备工作:Docker与Docker Compose安装 在开始部署前,请确保你的系统已安装以下工具: - Docke

gitblog_00908的博客 471

Scriptis与Linkis集成教程:如何快速连接Spark、Hive和Python计算引擎

Scriptis是基于Linkis开发的交互式数据分析工具,支持SQL、Pyspark、HiveQL等脚本开发,以及Spark、Hive任务提交和资源管理。本教程将详细介绍如何通过Linkis集成Spark、Hive和Python计算引擎,让你轻松上手数据处理与分析工作。 ## 一、准备工作:部署Linkis与Scriptis ### 1.1 环境要求 - 已部署Linkis(部署文档参考[L

gitblog_00091的博客 730

Spark实战(四)spark+python快速入门实战小例子(PySpark)

一、flume安装 (一)概述    Flume是一个分布式、可靠、和高可用的海量日志采集、聚合和传输的系统。Flume可以采集文件,socket数据包等各种形式源数据,又可以将采集到的数据输出到HDFS、hbase、hive、kafka等众多外部存储系统中,一般的采集需求,通过对flume的简单配置即可实现, Flume针对特殊场景也具备良好的自定义扩展能力,因此,flume可以适用于大部分的...

Arkham的专栏 1万+

python apache_Apache Spark:Python快速入门

python apache Spark概述 根据官方网站, “ Apache Spark是用于大规模数据处理的快速通用引擎” 最好与群集环境一起使用,在群集环境中,数据处理任务或作业被拆分为可以快速,高效地在多台计算机或节点上运行。 它声称运行程序的速度比Hadoop平台快100倍。 Spark使用一种称为RDD(弹性分布式数据集)的对象来处理和过滤数据。 RDD对象提供了各种有用的功能...

danpu0978的博客 149

linux下spark的python编辑_LINUX下快速安装Spark[原创]

Spark作为一种通用且高性能的计算框架,不仅在性能上相对于hadoop mapreduce有了很大的提升;在易用性上也运超hadoop, 不只提供了map/reduce计算接口,还提供了大量其他实用的接口,使得编写分布式程序更加迅速高效。Spark目前提供了Standalone/Yarn/Mesos几种安装模式,其中Standalone模式最为方便快捷。在这种模式下,Spark使用自由资源管理框...

weixin_39557813的博客 207

一二, Spark概述和快速入门

一, Spark概述 1.1 什么是Spark Spark是一种基于内存的快速,通用,可扩展的大数据分析计算引擎; 1.2 Spark && Hadoop SPark Hadoop 1.Scala开发, 快速通用,扩展的大数据分析引擎 1. Java开发, 在分布式服务器集群上存储海量数据并运行分布式分析应用的开源框架 2. Spark Core 提供了Spark最基础,核心的内容 2. HDFS基于GFS理论, 分布式存储数据 3. SpaekSQL 是Spar

菜菜的大数据开发の路 1528
上一篇: Spark 机器学习实践 :Iris数据集的分类
下一篇: 在云上的机器学习
刚是程序员
博客等级 码龄9年 47粉丝 41原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值