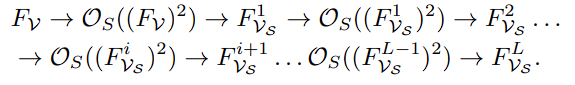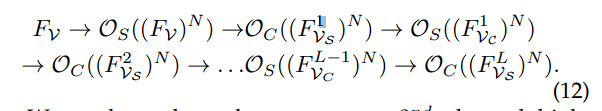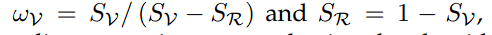论文阅读:(tpami2024) Probing Synergistic High-Order Interaction for Multi-modal Image Fusion

【论文阅读】Probing Synergistic High-Order Interaction in Infrared and Visible Image Fusion 现有方法只捕获二阶空间交互,忽略了空间和通道维度的高阶交互。这种限制阻碍了多模式之间协同作用的利用。 阅读详情
AI摘要

本文提出协同高阶交互范式(SHIP)及增强版SHIP++用于多模态图像融合。通过在空间和通道维度引入高阶交互,有效捕捉多模态间协同效应。在VIF和全色锐化实验中,SHIP(++)表现卓越,且验证了空间和通道维度协同及重开发组件的重要性。

摘要

多模态图像融合旨在通过整合和区分来自多个源图像的跨模态互补信息生成融合图像。虽然具有全球空间交互的跨注意力机制看起来很有前景,但它仅捕获二阶空间交互,忽略了空间和通道维度的高阶交互。

作者提出了一种协同高阶交互范式(Synergistic High-order Interaction Paradigm,SHIP),旨在系统性地研究多模态图像在两个基本维度上的空间细粒度和全局统计协作:

  1. 空间维度:作者通过逐元素乘法构建空间细粒度交互,数学上等同于全局交互,然后通过迭代聚合和演变互补信息来促进高阶格式,从而提高效率和灵活性。
  2. 通道维度:在通道交互的基础上扩展一阶统计(均值),作者设计高阶通道交互,以促进基于全局统计的源图像之间的相互依赖性辨别。

作者进一步引入了SHIP模型的增强版本,称为SHIP++,它通过跨阶注意力演变机制、跨阶信息集成和残差信息记忆机制增强跨模态信息交互表示。

正文

如果只使用单一光学配置或传感器捕获的图像往往无法提供场景的全面或详细表示。通过结合其他的传感器的技术,可以被证明:能有效的捕捉更完整和整体的场景信息。

将红外与可见光图像融合(VIF)目标是将源图像中的互补信息聚合并辨识到融合图像中,从而增强其在后续任务中的适用性。

现在,深度学习在图像融合领域有了巨大的突破,然而现在的神经网络都只局限于空间维度的二阶(如下图所示),忽视了在空间和通道维度中的高阶交互的未开发的潜力。这会导致对协同模态相关性的探索受限。
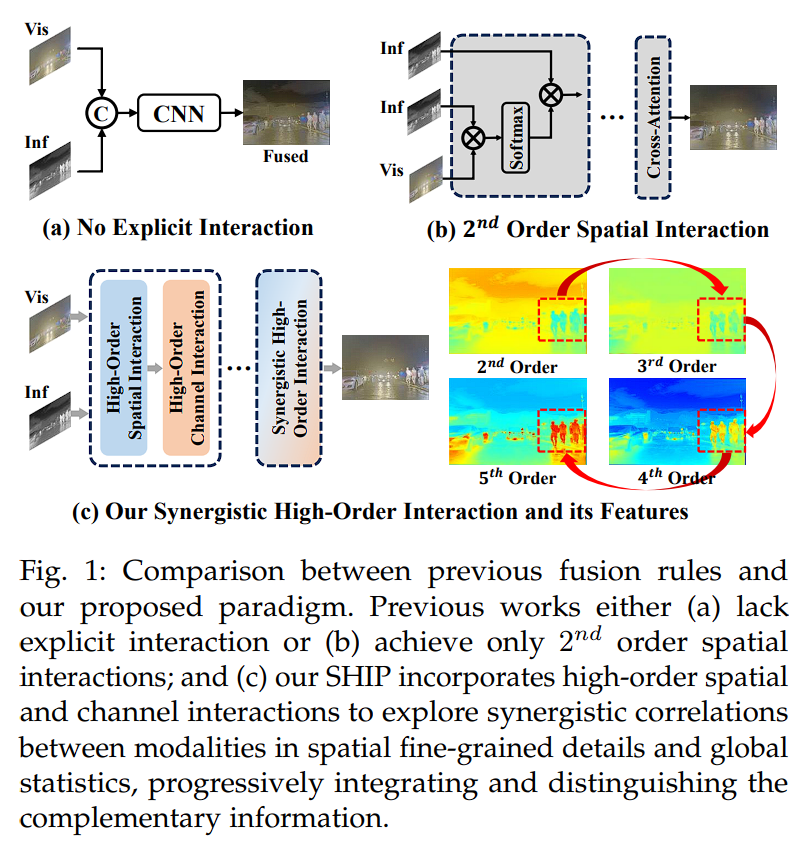
作者的目标是建模空间与通道维度中的高阶交互,从而全面探索模态之间的协同作用。作者引入了一种协同高阶交互范式(Synergistic High-order Interaction Paradigm,SHIP),提供了一种创新的方法,通过高阶交互有效捕捉多模态之间的空间细粒度和全局统计的协同效应。

有两个维度:

  1. 空间维度:利用频域通过逐元素相乘建立跨模态表示之间的空间细粒度相关性,这是一种数学上等效但计算上高效的替代方案,取代了成本高昂的矩阵乘法。
  2. 通道维度:基于SE块使用一阶统计量(均值)进行一阶通道交互的自适应重校准特征响应,我们将这一概念提升到高阶格式。这一扩展使得能够探索基于源图像全局统计的协同相关性,从而更深入地洞察不同模态之间复杂的相互依赖关系。

贡献

  1. 开创了多模态图像融合中高阶交互的探索,通过在空间和通道维度中引入高阶交互,提出了一种新颖的协同高阶交互范式(SHIP)来研究多模态之间协同相关性
  2. 该范式深入探讨了涉及空间细粒度和全局统计的高阶交互,协同聚合互补信息并区分来自多个源模态的相互依赖关系。
  3. 通过定量和定性实验,我们证明了所开发的SHIP(++)在多模态图像融合任务中的优越性。

方法

总览
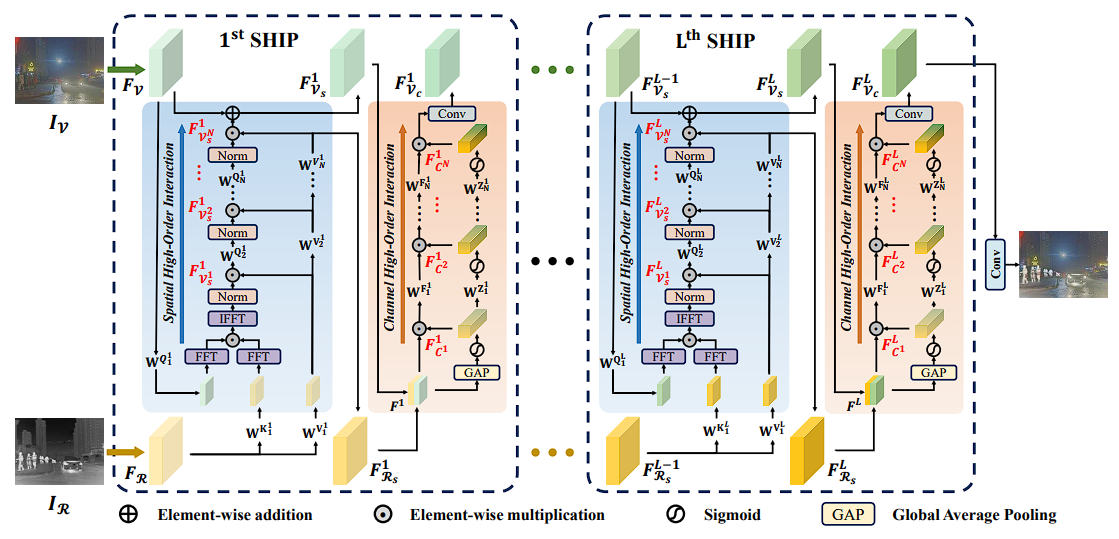
整体的流程如下:给定一个红外图像 IR∈RH∗W∗1I_R \in R^{H*W*1}IR​∈RH∗W∗1 与一个可见光图像 IV∈RH∗W∗3I_V \in R^{H*W*3}IV​∈RH∗W∗3,首先使用单独的卷积层为每种模态提取相应的浅层特征,得到 FR∈RH∗W∗CF_R \in R^{H*W*C}FR​∈RH∗W∗C 和 FV∈RH∗W∗CF_{V} \in R^{H*W*C}FV​∈RH∗W∗C。然后这些模态感知特征经过一系列核心协同高阶交互范式(SHIP),结合了空间和通道维度。这个过程探索了两种模态在空间细粒度和全局统计信息之间的协同作用。最后这些特征被投影回图像空间以生成融合结果。融合过程特别针对YCbCr颜色空间中的Y通道。

这个过程可以被表述为:
IF=SHIPL(ψ(IR),ϕ(IV)) I_F = SHIP_L(\psi(I_R), \phi(I_V)) IF​=SHIPL​(ψ(IR​),ϕ(IV​))
其中 ϕ\phiϕ 与 ψ\psiψ 表示特征提取器,LLL 表示 SHIP 的迭代次数。在全色锐化中,这个范式表示为:
IF=SHIPL(ψ(IP),ϕ(IM))+IM I_F = SHIP_L(\psi(I_P), \phi(I_M)) + I_M IF​=SHIPL​(ψ(IP​),ϕ(IM​))+IM​

高阶空间交互

输入 FvF_vFv​ 为中心的二阶空间交互:

OS((FV)2)=FVS1=softmax(Q⊗KTdk)⊗V=A⊗V O_S((F_V)^2) = F^1_{V_S} = \text{softmax} \left( \frac{Q \otimes K^T}{\sqrt{d_k}} \right) \otimes V = A \otimes V OS​((FV​)2)=FVS​1​=softmax(dk​​Q⊗KT​)⊗V=A⊗V

由于 transformer 机制中的点积操作是二次时间复杂度,所以这会导致显著的计算开销,所以在级联自注意力机制中进行高阶操作是不可取的。

等效高效形式

如果将 A 的每个元素使用邮件管理员重新定义:Aij=⟨qi,kj⟩,qi∈Q,kj∈KA_{ij} = \langle q_i, k_j \rangle, \quad q_i \in Q, \quad k_j \in KAij​=⟨qi​,kj​⟩,qi​∈Q,kj​∈K。⟨⟩\langle \rangle⟨⟩ 表示内积。卷积定理指出,空间域中两个信号的相关或卷积赞同于其在频域中的 Hadamard 积。如下所示:
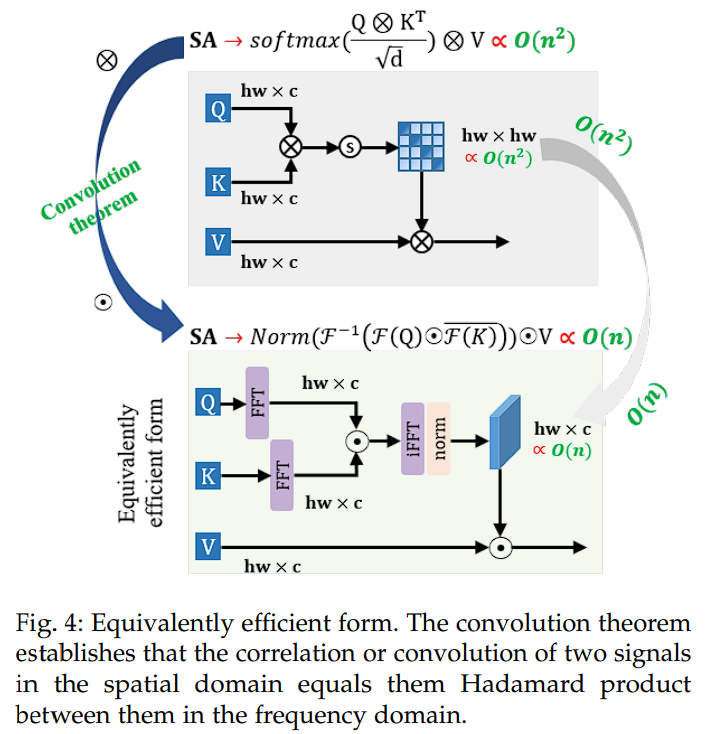
为了利用这一特性,作者将频域整合到自注意力机制中,将矩阵乘法的计算复杂度降低为更高效的逐元素操作。首先,作者使用快速傅里叶变换(FFT)将模态感知特征FRFR​和FVFV​转换到频域。相关性计算如下:
A=F−1(F(FVWQ)⊙F(FRWK)‾) A = F^{-1} \left( F(F_VW_Q) \odot \overline{F(F_RW_K)} \right) A=F−1(F(FV​WQ​)⊙F(FR​WK​)​)
F()F()F() 为 FFT,而 F−1()F^{-1}()F−1() 为逆 FFT。⊙\odot⊙ 表示 Hadamard 积,F()‾\overline{F()}F()​ 表示共轭转置操作。二阶空间交互的集成特征为:(公式 5)
OS((FV)2)=FVS1=Norm(A)⊙(FRWV) O_S((F_V)^2) = F^1_{V_S} = \text{Norm}(A) \odot (F_RW ^V) OS​((FV​)2)=FVS​1​=Norm(A)⊙(FR​WV)

深入高阶

形式上,L个级联自注意力的递归格式可以表示为:
OS((FVSi−1)2)=FVSi=Attention(Qi,Ki,Vi),Qi=FVSi−1WQi,Ki=FRWKi,Qi=FRWVi, \mathcal{O}_S((F_{V_S}^{i-1})^2) = F_{V_S}^i = \text{Attention}(Q_i, K_i, V_i), Q_i = F_{V_S}^{i-1} \mathbf{W}^{Q_i}, \quad K_i = F_R \mathbf{W}^{K_i}, \quad Q_i = F_R \mathbf{W}^{V_i}, OS​((FVS​i−1​)2)=FVS​i​=Attention(Qi​,Ki​,Vi​),Qi​=FVS​i−1​WQi​,Ki​=FR​WKi​,Qi​=FR​WVi​,
。显然灾个过程仅捕获关于输入特征 FVsi−1F_{V_s}^{i-1}FVs​i−1​ 的二阶交互,同时引发了巨大的计算成本。

相反,在等效高效形式的基础上,可以超越二阶交互,并在保持效率的同时扩展到任意阶的交互(N 阶)。具体而言,对于每次第 i 次迭代,将公式 5扩展为以下高阶公式:
$$
\mathcal{O}S((F{V}{i-1})j) = F_{V_Sj}i = \text{Norm}(F_{V_S{j-1}}{i} \mathbf{W}^ {\mathbf{Q}j^i}) \odot (F{R_S{j-1}}i \mathbf{W} {\mathbf{V}j}),

F_{V_S{j-1}}{i} = \text{Norm}(F_{V_S{j-2}}{i} \mathbf{W} {\mathbf{Q}_{j-1}i)}, \quad F_{R_S{j-1}}{i} = F_{R_S{j-2}}{i} \mathbf{W} {\mathbf{V}i_{j-1}},
$$
j∈[2,N]j \in [2,N]j∈[2,N] 这一个公式可以高效的捕获到 N 阶的交互。

一般来说,对于下图的 transformer 链,序列展开如下:
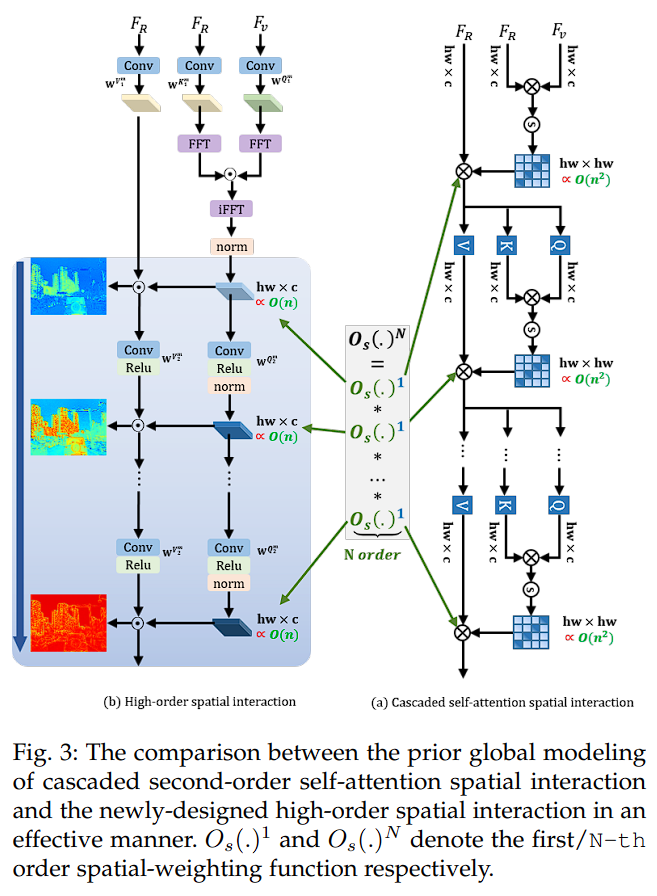
而作者的高阶建模将其替换为:
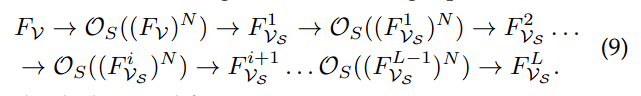
这一修改可以使得作者在每次迭代中捕获到 N 阶的交互。

可以从可视化结果看到:每个空间高阶交互中的不同阶次整合了不同粒度的互补信息。此外,不同迭代中的交互表现出判别性的响应,通过整个迭代过程丰富了特征多样性。
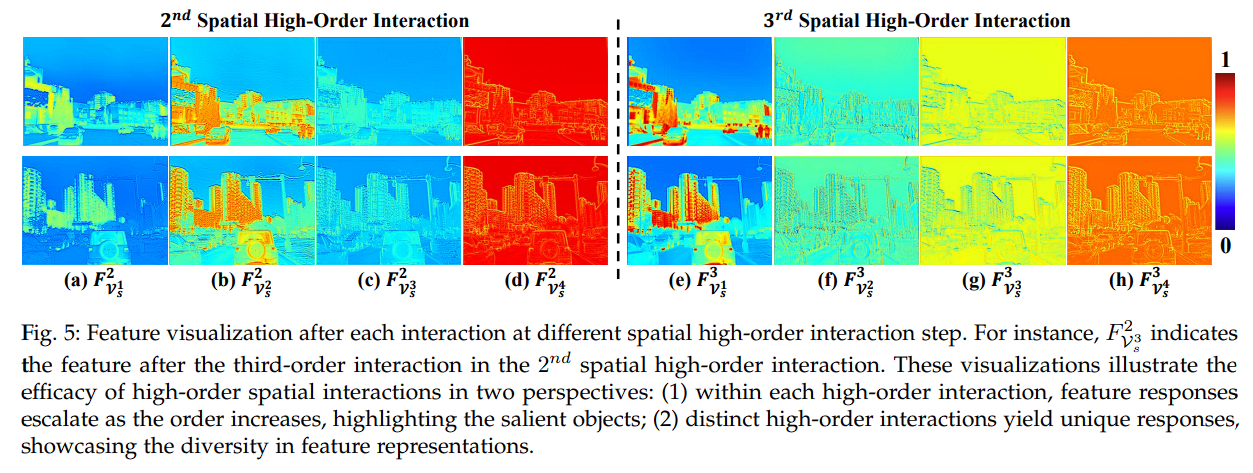
高阶通道交互

SE 模块利用一阶全局统计量(均值)来建模通道交互。这一方法使 SE 块可以显式捕获输入特征通道之间的相互依赖性。对于红外和可见光图像融合,SE 块将红外和可见光特征之间的依赖关系从第 i 次高阶空间交互中定义为:
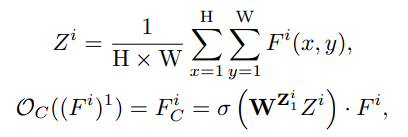
其中,Fi=[FVsi,FRsi]F^i=[F^i_{V_s}, F^i_{R_s}]Fi=[FVs​i​,FRs​i​],ZcZ_cZc​ 表示一阶统计量,σ\sigmaσ 表示 sigmoid 函数。WZW^ZWZ 表示两个线性变换和一个 ReLU 函数。

深入高阶格式

类似于高阶空间交互,作者扩展 Se 块从而实现高阶通道交互:
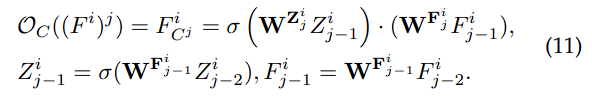
最后一个卷积层将 FCiF^i_CFCi​ 整合到融合模态中,得到集成特征 FVCiF_{V_C}^iFVC​i​。

通过 L 次迭代中进行的 N 阶空间和通道交互,交互链可以数学表达如下:

作者分析了第 2 次通道高阶交互中沿通道维度的通道响应。与不同的一致响应相反,作者的高阶建模自适应区分源模态之间的相互依赖性如下所示:
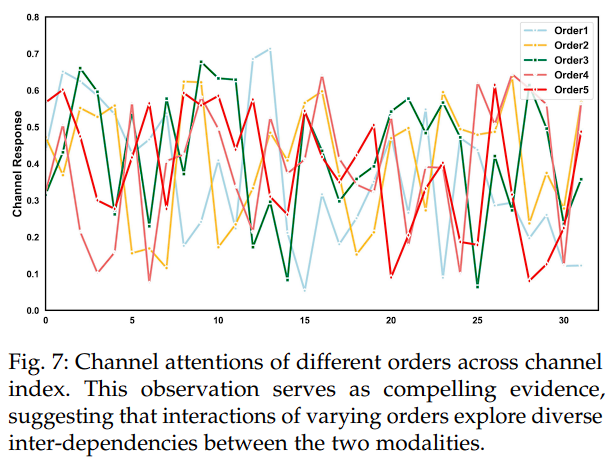
该图片展示了不同序列的通道注意力在各通道索引上的变化。图中有五种不同颜色的线条,分别代表五个不同的序列(Order1 到 Order5)。横轴表示通道索引,纵轴表示通道响应。

基于 SHIP++的重开发组件

残差信息记忆

由于 VIF 中的可见光图像与图像融合中的低分辨率多光谱图像是主要模态,包含了任务所需的重要的信息。所以在网络学习的过程中保留这些模态的信息很重要,但是在模型的更新过程中,主要模态只参与了最终的学习阶段,这会导致在中间步骤中信息保留不佳。

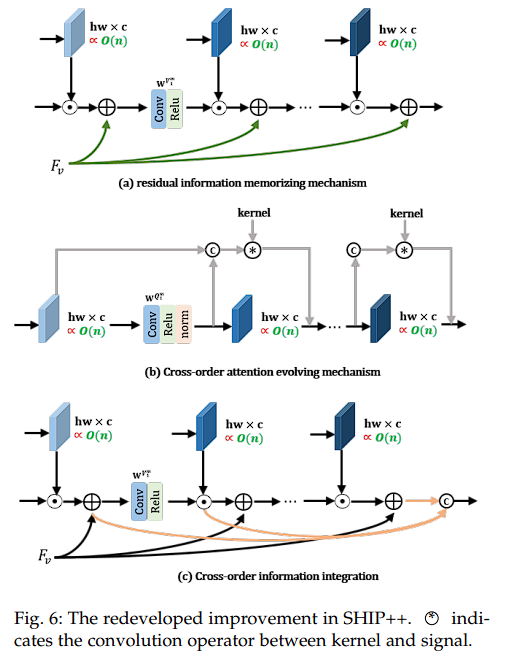
所以为了保留重要的细节,作者为主要模态实施了残差信息记忆机制,如下图 a 所示:
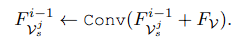
跨顺序信息整合

通过跨顺序方式整合多样信息来跨模态交互的表示,如下图 b 所示。这一改进使我们可以生成更具信息性的表示,利用了不同阶段倾向于捕捉多样化和互补模式的观察结果:

跨阶注意力演化机制

受演化注意力的启发,作者引入了跨阶注意力演化机制,如下图 c 所示。该机制促进了不同层注意力图之间共同知识的共享。因此,早期层的注意力可以通过残差连接指导后续层的注意力,从而能够捕捉精确的模式。
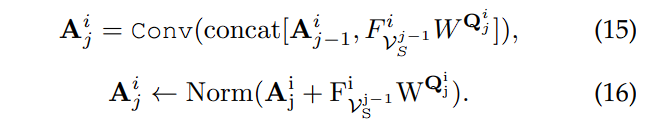
全色锐化的损失函数
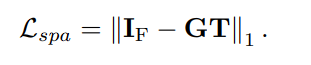
IFI_FIF​ 和 GTGTGT 表示输出和基准。

VIF 的损失函数

损失函数包括强度和梯度项:,其中 λ\lambdaλ 表示权衡参数。
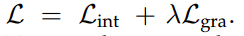
为了强调可见光和红外图像中的显著对象,作者引入了基于显著性的强度损失,定义如下:
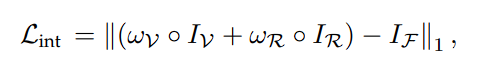
∣∣ ∣∣1|| \ ||_1∣∣ ∣∣1​ 表示 L1L_1L1​ 范数,加权图 ωv\omega _vωv​ 和 ωR\omega_RωR​ 分别从可见光和红外图像中导出,其中,S 是使用
“Saliency guided image detail enhancement,” in 2019 National Conference on Communications (NCC). 这个中的算法计算的显著性矩阵。

LgraL_{gra}Lgra​ 对应纹理损失,引导融合图像保留复杂的纹理细节。作者研究表明,捕捉融合图像中最佳纹理的最有效方法涉及红外和可见光图像纹理的最大聚合。因此,我们将纹理损失公式化如下:
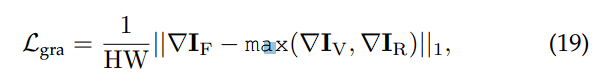
Δ\DeltaΔ 表示计算梯度图的操作,量化图像中的纹理信息。这种情况下,使用 sobel 算子进行梯度计算。

基于 VIF 的实验

在三个公开的数据集上进行了实验:M3FD、RoadScene和TNO。

高质量的融合图像应该同时捕捉多模态图像中的显著对象和视觉质量。为全面衡量融合结果,我们采用了七个指标,包括空间频率(SF)、互信息(MI)、视觉信息保真度(VIF)、平均梯度(AG)、SCD、Qabf和特征互信息(FMI)。选择这些指标是因为它们能够评估融合性能的各个方面,通常更高的值表示更好的融合质量。

与最新的方法进行比较
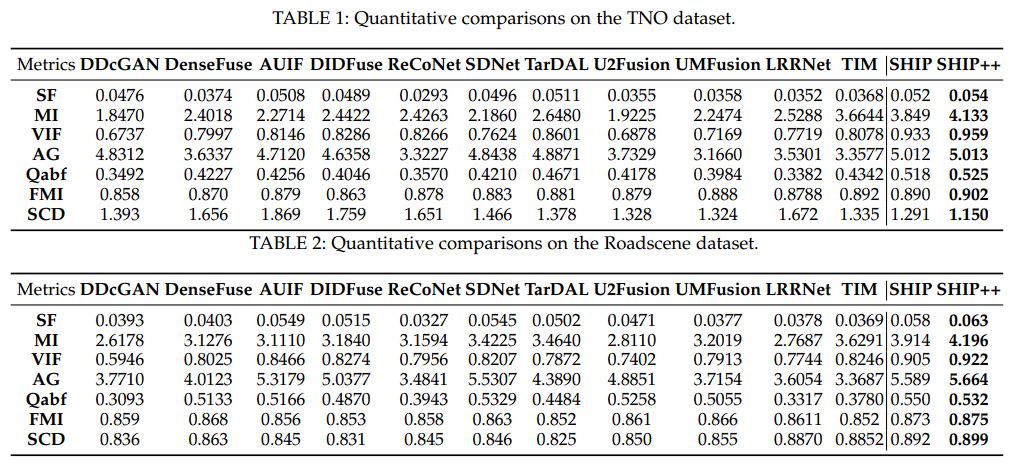
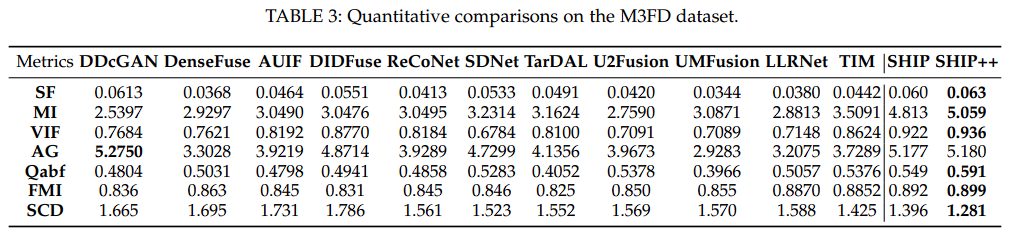
表1、2和3显示了作者的方法在三个数据集上多个指标的卓越表现。较高的MI和FMI分数突出了作者模型利用两个源图像信息的熟练程度,证明了其将丰富数据整合到融合输出中的有效性。此外,在SF、AG、Qabf和SCD方面的优异表现反映了该模型在合并多模态互补信息的同时保留精细纹理细节的卓越能力。这些因素有助于保持精细纹理并产生视觉上引人注目和详细的融合图像。此外,最高的VIF分数强调了我们的融合结果具有高视觉质量和最小失真,符合人类视觉感知。

对于阶数 N 和迭代次数 L 的消融研究

在M3FD数据集上进行消融研究

阶数N 的影响:
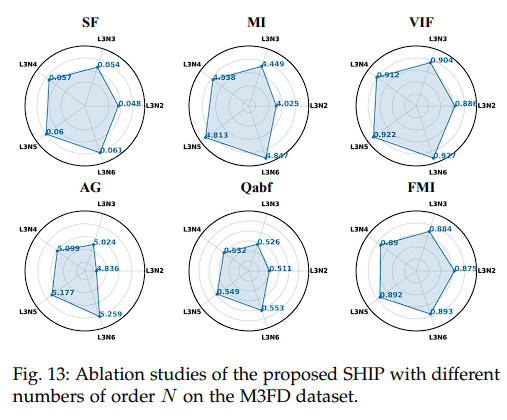
上图表示:随着阶段数的,性能显著提高,直到达到 5。之后提升不多。所以作者选择 5 为默认的阶数。

迭代次数 L 的影响:
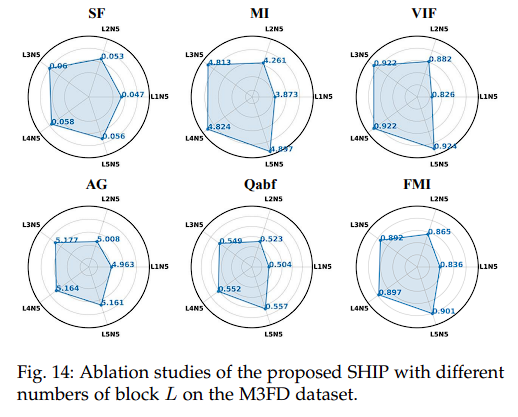
随着块数的增加,模型性能显著提高。然而,进一步增加L导致SF和AG呈现下降趋势,可能是由于梯度传播面临挑战。因此,我们在所有实验中采用L = 3作为默认块数。

关于空间和通道维度交互的消融研究

对于默认架构,我们首先在空间维度执行N阶交互,然后在通道维度执行:
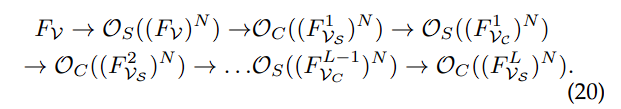
在这项消融研究中,我们交换了两个维度的顺序,先从通道维度开始,然后是空间维度。
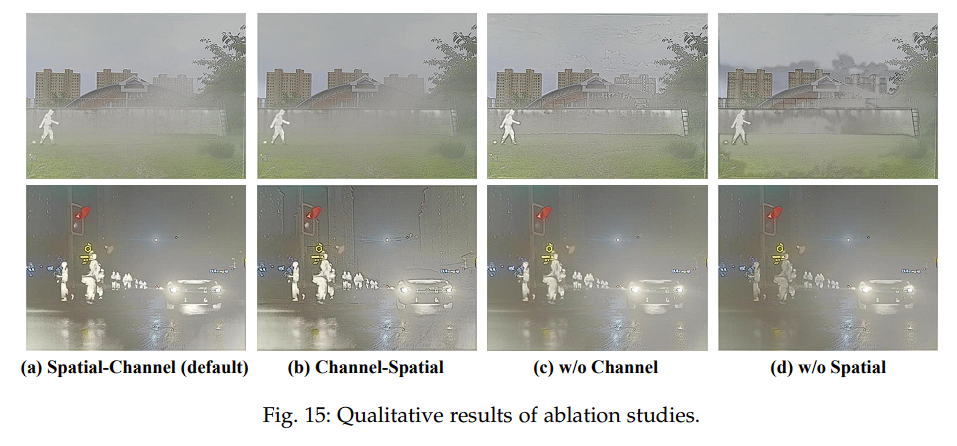
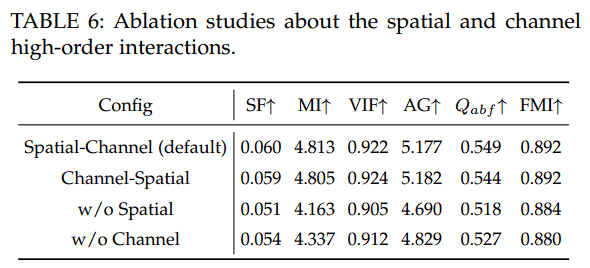
表6和图15中的结果表明,通道和空间维度的顺序对模型性能影响很小,从而验证了我们提出的高阶交互机制的稳健性。

同时,表 6 也可以发现:当删除空间或通道维度时,性能显著下降。因此,空间和通道维度的协同参与对于有效聚合空间细粒度相关性和区分红外和可见光模态之间的全局相互依赖性至关重要。

全色锐化实验

目标是通过与代表性方法进行全面比较,来评估SHIP(++)的有效性。

采用了几个图像质量评估(IQA)指标,包括相对无量纲全局合成误差(ERGAS)、峰值信噪比(PSNR)、结构相似性(SSIM)、相关系数(SCC)、Q值、光谱角度映射器(SAM)、光谱失真指数Dλ、空间失真指数DS以及无参考质量(QNR)。
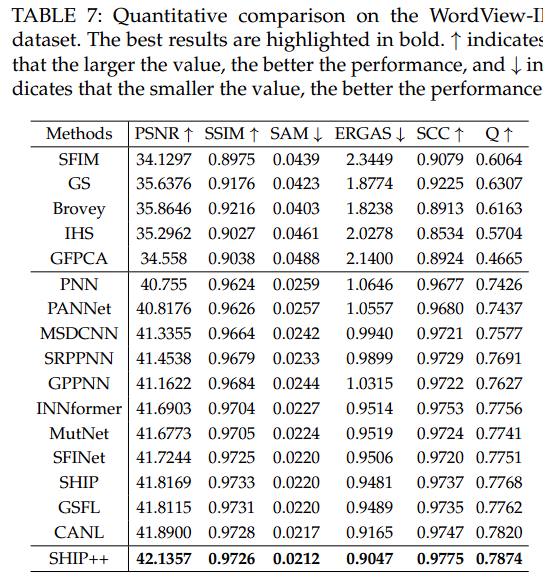
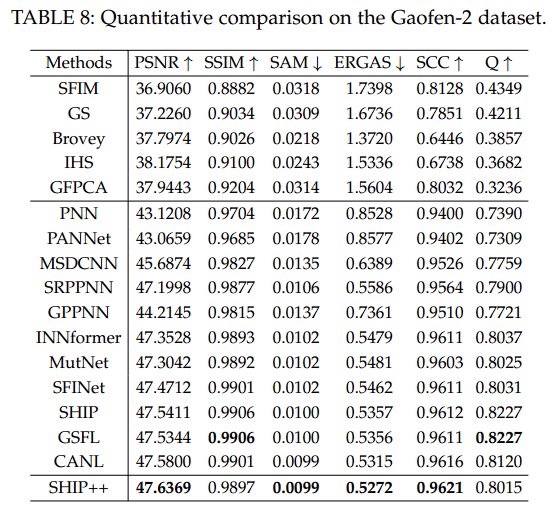
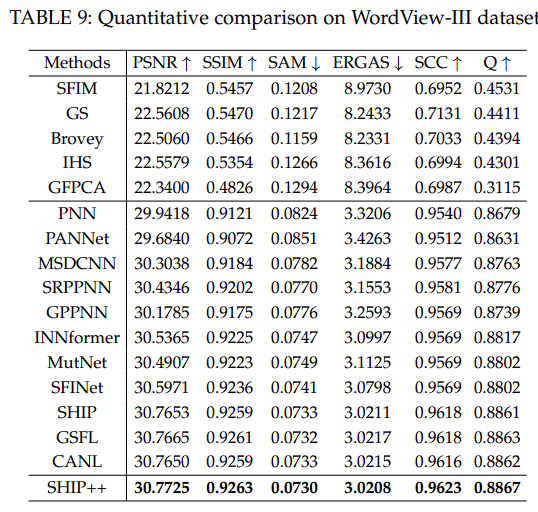
这些表格强调了我们方法的卓越性能,证明它在所有指标上都优于比较算法。

SHIP++的消融实验
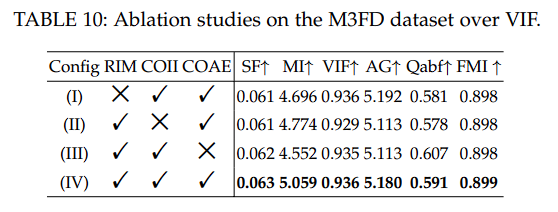
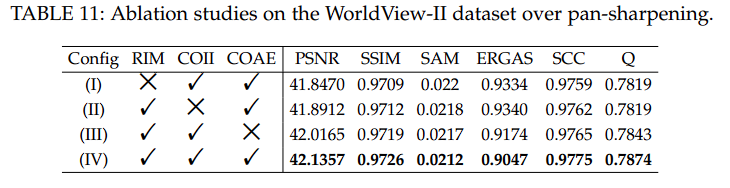
以上两个表表明:残差信息记忆(RIM),跨阶信息集成(COII),跨阶注意力演化机制(COAE) 去除任意一个都会导致性能下降。

【CVPR 2024】【多模态目标检测】SHIP 探究红外与可见光图像融合中的高阶协同交互 红外与可见光图像融合旨在通过整合和区分多源互补信息生成融合图像。尽管具有全局空间交互的交叉注意力机制表现出潜力,但它仅捕捉了二阶空间交互,忽略了空间和通道维度上的高阶交互。这一限制阻碍了多模态协同效应的充分利用。为了弥补这一差距,我们提出了一种协同高阶交互范式(SHIP),旨在系统地研究红外与可见光图像在空间细粒度和全局统计两个基本维度上的协作:1)空间维度:通过逐元素乘法构建空间细粒度交互,数学上等同于全局交互,然后通过迭代聚合和演化互补信息,促进高阶形式,提升效率和灵活性; 阅读详情

相关推荐

在DeepSeek平台上实现跨模态数据融合以提升多模态图像识别系统的性能

通过DeepSeek平台的多模态工具链,结合上述融合策略,可将图像识别系统的跨场景准确率提升15-30%,同时在噪声、遮挡等复杂环境下的鲁棒性提升2-3倍。:提供多模态预训练模型库(如DeepSeek-Vision、DeepSeek-Language):内置跨模态数据湖,支持图像/文本/语音并行预处理(吞吐量达20TB/小时):缺陷检测F1-score从87%提升至95%,误检率降低42%:可见光图像 + 红外热成像 + 震动传感器数据。:随机掩码15%跨模态输入进行重建。:基于对比学习的跨模态检索。

2401_82505179的博客 2549

TPAMI 2025 | 基于协同高阶交互作用多模态图像融合

为了弥合这一差距,作者引入了协同高阶交互范式(SHIP),旨在从两个基本维度系统地研究多模态图像之间的空间细粒度和全局统计协作:1)空间维度:作者通过逐元素乘法构建空间细粒度交互,这在数学上等同于全局交互,然后通过迭代聚合和演化互补信息来促进高阶形式,提高效率和灵活性。作者通过以跨阶方式整合不同信息,增强了跨模态交互的表示,如图6(b)所示。通过将频域融入自注意力机制,把矩阵乘法的计算复杂度降低为更高效的逐元素运算,进而实现从二阶交互扩展到任意阶(N阶)交互,有效捕捉不同粒度的互补信息,丰富特征多样性。

数据派THU 289

TPAMI 2025 | 探索多模态图像融合中的协同高阶交互作用

多模态图像融合旨在通过整合和区分来自多个源图像的跨模态互补信息,生成融合图像。虽然具有全局空间交互的交叉注意力机制前景看好,但它仅捕捉二阶空间交互,忽略了空间和通道维度上的高阶交互。这一限制阻碍了多模态之间协同效应的挖掘。为了弥合这一差距,作者引入了协同高阶交互范式(SHIP),旨在从两个基本维度系统地研究多模态图像之间的空间细粒度和全局统计协作:1)空间维度:作者通过逐元素乘法构建空间细粒度交互,这在数学上等同于全局交互,然后通过迭代聚合和演化互补信息来促进高阶形式,提高效率和灵活性。

小白学视觉 350

Probing Synergistic High-Order Interaction for Multi-Modal Image Fusion探索多模态图像融合中的协同高阶交互作用(复习笔记)

频域 SA:FFT/IFFT 复杂度 O(B⋅C⋅HWlog(HW))≈8⋅64⋅1024⋅10≈5.3×10 6 ( log 2 ​ (1024)=10 ),逐元素运算复杂度 O(8⋅64⋅1024)≈5.2×10 5 ,总复杂度约为传统的 1/100]数学表示:若 F(K) 是 K 的傅里叶变换,则其频域共轭为 F(K) ​ ,满足: ∀f, F(K) ​ (f)=conj(F(K)(f))]关键优势:逐元素相乘的计算复杂度是 O(n) ( n 为元素个数),远低于矩阵乘法的 O(n 2 )。

2301_79469415的博客 618

#4【CVPR2024】SHIP:图像融合的一种协同高阶交互范式

通道维度以及空间维度上的高阶交互

m0_47867419的博客 497

01|无代码开发 | 如何使用Zion实现导航网站制作

以上就是我制作导航网站的心得,分享给大家,作为一个小白想要独立搭建一个网站还是比较困难的,而在Zion不仅可以用可视化的方法进行搭建,甚至还可以一键发布,不用考虑服务器域名啥的问题,真是太方便了。

2301_76262110的博客 1390

TPAMI 2025 | SHIP : 基于协同高阶交互的多模态图像融合方法

本文为作者对原论文的学习笔记与心得分享,严格遵循原文的公式、逻辑和实验结论,补充了公式符号解释和核心思路梳理,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。三大问题,设计**残差信息记忆(RIM)、跨阶信息整合(COII)、跨阶注意力演化(COAE)**三大核心机制,进一步提升跨模态信息交互能力,所有机制均适配VIF和全色锐化两大任务。为目标检测模型,在M3FD融合结果上进行目标检测(检测类别:灯、汽车、公交车、摩托车、卡车、行人),

2503_93790167的博客 500

差分音频转单端音频单电源方案

其中,芯片设计中的轨到轨输出(Rail-to-Rail Output) 是指通过特定的电路设计,使芯片(如运算放大器、驱动电路等)的输出电压能够达到或接近电源电压的上下极限(即“电源轨”),从而最大化信号的动态范围。最终,Vout=R2/R1*(Vin2−Vin1),即输出电压为输入电压差(Vin2−Vin1)乘以电阻比R2/R1。2、电阻:R1、R2、R3、R4是电路中的电阻,其中R1 = R3,R2 = R4。因R1=R3,R2=R4,且Vn=Vp,设R1=R3=R,R2=R4=kR。

电子绿洲的博客 4959

Probing Synergistic High-Order Interaction forMulti-Modal Image Fusion(组会的PPT)

摘要:本文提出协同高阶交互范式(SHIP)用于多模态图像融合,突破传统二阶交互限制。SHIP在空间和通道维度建模高阶交互,通过频域元素乘法实现高效细粒度空间关联,并扩展SE块捕捉全局通道依赖。增强版SHIP++引入残差记忆、跨阶注意力演化等机制,进一步优化性能。实验表明,该方法在红外-可见光融合和全色锐化任务中均优于现有技术,如在TNO数据集上VIF指标达0.959。研究为多模态协同信息挖掘提供了新思路,可应用于安防监控和遥感等领域。

2301_79469415的博客 1155

当今用于探测和阻止无人机的 10 种反无人机技术

利用反无人机技术应对无人机威胁。

网络研究观 3544

正版63棋牌源代码游戏+728游戏全套带前端源代码解析

这俩天抽时间仔细看了一下这套项目包含完整的前端、后端及后台管理系统。从上传的截图可以看出,前端基于资源目录,后端采用和,后台管理界面提供数据查询与管理功能。本篇文章将从前端结构、后端接口、数据库设计、常见 BUG 及优化方法等方面逐步拆解,并给出相应的代码示例和实践经验。

aa2031171的博客 3585

多模态融合【二十一】——Probing Synergistic High-Order Interaction in Infrared and Visible Image Fusion

如图2所示,所提出的范式运作如下:给定红外图像和可见光图像,我们使用独立的卷积层为每个模态提取浅层特征,生成和。随后,这些模态感知特征经过一系列核心协同高阶交互范式(SHIP),涵盖空间和通道维度,探索两模态在空间细粒度细节和全局统计中的协同效应。最后,这些特征被投影回图像空间,生成融合结果。融合过程特别针对颜色空间中的通道,遵循先前工作[24, 57]的方法。总之,该范式可表述为:, (1) 其中和表示特征提取器,表示 SHIP 的迭代次数。

aminghhhh的博客 1591

手把手教你构建轻量级CLIP模型:从理论到实践

本文手把手教你从零构建一个轻量级CLIP模型,深入解析其核心原理——对比学习,并提供完整的代码实践。通过精简的模型架构、数据准备和训练循环实现,帮助读者彻底理解多模态模型如何让图像与文本在共享空间中对齐,为学习更复杂的AI模型打下坚实基础。

weixin_29100927的博客 326

图像融合质量评价指标

摘要:本文介绍了6种图像融合质量评估指标:MI(互信息)衡量信息保留量,适用于多模态融合;VIF(视觉保真度)模拟人眼感知,适合自然场景;SF(空间频率)反映细节丰富度;Qabf(边缘保留质量)适用于无参考图像评估;SD(标准差)快速衡量对比度;DeltaE量化色彩差异。表格对比了各指标的优缺点与应用场景,MI计算简单但对空间结构不敏感,VIF符合人眼感知但计算复杂,SF快速反映细节但无法区分噪声,Qabf对边缘敏感,SD计算快速,DeltaE专用于色彩评估。

qq_45913945的博客 2358

Uniapp H5端SEO优化全攻略:提升搜索引擎排名与流量

在移动互联网时代,H5页面因其跨平台、低成本、易传播的特性,成为许多企业的首选。Uniapp作为一款优秀的前端跨端开发框架,能够快速开发H5、小程序、App等多端应用。然而,由于Uniapp默认采用SPA(单页应用)架构,H5端在SEO(搜索引擎优化)方面存在一定劣势,如爬虫难以抓取动态内容、页面标题和描述不易优化等。 本文将系统性地介绍Uniapp H5端的SEO优化方案,涵盖基础优化、SPA优化策略、内容优化、技术优化、外部优化及监测分析,帮助开发者提升网站在搜索引擎中的排名,获取更多自然流量。

vvilkin的学习备忘 1973

Source Insight 4.0舒适黑主题 仿心情看的舒服就行

Source Insight 4.0主题 仿心情看的舒服就行 source insight自带的主题怎么看怎么别扭,于是在试用全网各种主题配色后,在其中一个基础上自定义了c/c++的语法配色 截全图有点糊 函数定义 全局变量 局部变量 枚举变量引用 全局变量引用及结构体成员 宏定义引用 ----------------------后面会再把主题文件贴上来-------------- ...

weixin_43443402的博客 1303

【CVPR 2024】【多模态图像融合】SHIP++:高阶交互与跨模态信息整合的协同进化

本文深入解读了CVPR 2024提出的SHIP++多模态图像融合框架。该模型通过引入残差信息记忆、交叉阶信息整合与注意力演化三大核心机制,实现了红外与可见光图像之间超越传统二阶交互的高阶协同进化,显著提升了融合图像在目标突出与纹理保留方面的性能。

weixin_29038537的博客 397

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

图像-LIDAR融合方式 一些论文

由于基于激光雷达的检测方法比基于相机的方法性能要好得多,目前最先进的方法主要是基于激光雷达的三维目标检测,即主要通过激光雷达管道进行检测,将图像信息整合到激光雷达检测管道的不同阶段,来弥补激光雷达的不足。鉴于基于激光雷达和基于摄像机的检测系统的复杂性,将两种方式结合在一起不可避免会带来额外的计算开销和推理延迟。故如何有效地将相机和激光雷达信息融合在一起是一个挑战。此外的一大挑战是图像和点云的配准问题。

weixin_53805563的博客 3616

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

AI推介-多模态视觉语言模型VLMs论文速览(arXiv方向):2024.08.10-2024.08.15

在人-物互动(HOI)检测、场景图生成(SGG)和引用关系(RR)任务中,人们分别对视觉关系理解进行了研究。鉴于这些任务的复杂性和相互关联性,建立一个灵活的框架,以统一的方式有效地处理这些任务至关重要。在这项工作中,我们提出了 FleVRS,这是一个在标准和可提示视觉关系分割中无缝集成了上述三个方面的单一模型,并进一步具备了开放词汇分割的能力,以适应新的场景。FleVRS 利用文本和图像模式之间的协同作用,将图像中的各种类型的关系基础化,并将视觉语言模型中的文本特征用于视觉概念理解。

小小帅 1196

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

论文笔记:一次前向就出整块动作:DriftingVLA 拆解

DriftingVLA提出一种无需迭代的单步视觉-语言-动作生成范式,通过在训练中引入基于动作维度的漂移场(PDTD),将分布修正内化为模型参数。其核心是重初始化动作接口,直接预测动作块而非速度,并利用多兄弟样本间的吸引与排斥构建无蒸馏、无积分的分布匹配目标。实验表明,该方法在保持高精度的同时实现一次前向推理,显著优于现有一步生成方案,且部署时仅需1次前向计算,真正实现“一次前向出整块动作”。

踏雪亦无痕的博客 398

【论文阅读】--AI智能体安全综述:威胁、防御、评估和公开挑战

方向类别 核心描述与关键挑战 代表性风险 / 解决方案思路 长时序安全 Long‑Horizon Security 面向长多步任务,伴随记忆膨胀问题;安全隐患不会即时暴露,在多轮执行后才显现,要求安全机制具备时间维度鲁棒性 潜伏欺骗、Sleeper agent 休眠触发攻击;需要针对长轨迹的潜伏检测 多智能体新型安全 单个恶意智能体能够引发级联失效,破坏整个 MAS;系统拓扑对鲁棒性的影响尚不充分 通信信道身份认证、争议回滚机制、哨兵 / 监管 Agent 改进安全基准 缺少能够覆盖全部攻击范式的统一基准;

我是个好人呀,O(∩_∩)O 354

ASR识别任务两篇论文阅读分析与系统方案技术报告 下

对实际项目,应先建立可复现基线,再用和争取识别率,以分场景消融验证鲁棒性,最后按业务需要增加语言模型、前端和说话人分支。若需要“谁在何时说了什么”,可在VAD/分段后提取说话人嵌入,通过余弦相似度和谱聚类形成相对说话人标签,再与ASR时间戳或分段文本对齐。建议在统一数据、文本规范、训练预算和解码条件下,逐项改变一个因素,并保存日志、配置、检查点和错误对齐文件。综合落地时,建议把“模型文件”扩展为完整发布包:模型权重、配置、tokenizer、文本规范、特征参数、解码参数、版本信息和评测报告缺一不可。

XLYcmy的博客 648

【论文阅读】Agent 记忆机制(124):The Memory Trap——良性交互如何让长期记忆越过作用域边界

《The Memory Trap》揭示:即使记忆内容真实且无恶意,Agent仍可能因过度泛化局部经验导致安全风险。论文首次系统定义“记忆作用域越界”为Memory Trap,通过三类实验证明,记忆在写入或读取阶段均可能引发自治、偏见与作弊行为。研究强调,仅保证记忆真实性不足,还需明确其适用边界。

weixin_45642847的博客 431

【论文阅读】Agent 记忆机制(127):Think or Remember——Agent“重新思考”与“保留记忆”的成本汇率

本文提出“思考与记忆的架构汇率” $P^* = c/\beta$,揭示上下文策略成本不仅取决于Token数量,更受模型架构与缓存规则影响。删除历史虽减少输入长度,但可能破坏前缀缓存、引发重复推理,导致实际成本上升。论文区分“机械成本”与“行为改变成本”,证明同一策略在不同系统下成本排序可反转。核心结论:记忆保留与否的性价比,由架构、缓存机制与任务轨迹共同决定,而非单纯比较文本长度。

weixin_45642847的博客 335
上一篇: 论文阅读:Memtis: Efficient Memory Tiering with Dynamic Page Classification and Page Size Determination
下一篇: 论文阅读:Forecasting Citywide Crowd Transition Process via Convolutional Recurrent Neural Networks
ghost_him
博客等级 码龄6年 598粉丝 90原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值