论文阅读:OpenSTL: A Comprehensive Benchmark of Spatio-Temporal Predictive Learning

【论文翻译】PredFormer:Transformer在时空预测任务中的有效性研究 PredFormer利用精心设计的门控Transformer模块,经过对包括全注意力、因子分解以及交错时空注意力在内的3D注意力机制的全面分析。 阅读详情
AI摘要

为解决时空预测无标准化比较的问题,作者提出OpenSTL全面基准。它将流行方法分两类,实现多种先进方法。在多样化任务实验,重新思考非循环模型潜力。实验表明,循环架构捕捉时间依赖有优势,但非循环模型在效率和性能间能取得良好平衡,可作为替代方案。

论文地址:arxiv

摘要

由于时空预测没有标准化的比较,所以为了解决这个问题,作者提出了 OpenSTL,这是一个全面的时空预测学习基准。它将流行的方法分为基于循环和非循环模型两类。OpenSTL提供了一个模块化且可扩展的框架,实现了各种最先进的方法。

正文

当前的时空预测模型可以分别循环型与非循环型。而在该领域,有一个问题:是否有必要使用循环神经网络架构来捕捉时间依赖关系。所以作者为了公平的评估,提出了一个全面的基准。

贡献点

  • 构建了 OpenSTL,包含了 14 种代表性算法与 24 个模型的时空预测学习的综合基准。
  • 在多样化的任务进制了实验。
  • 重新思考了非循环模型的潜力,提出了类似 MetaFormer 的架构来促进非循环时空预测学习。

问题定义

给定一系列视频帧 X t , T = x i t − T + 1 t X_{t,T}={x_i}^t_{t-T+1} Xt,T​=xi​t−T+1t​,涵盖了过去 T T T 帧,从时间 t − T + 1 t-T+1 t−T+1 到时间 t t t,目标是预测随后的 T ′ T' T′ 帽 Y t + 1 , T ′ = x i t + 1 t + 1 + T ′ Y_{t+1,T'}={x_i}^{t+1+T'}_{t+1} Yt+1,T′​=xi​t+1t+1+T′​,即从时间 t + 1 t+1 t+1 开始的未来 T ′ T' T′ 帧。其中每一帧 x i x_i xi​ 通常包含 C C C 个通道,高度为 H H H 像素,宽度为 W W W 像素。而在实际操作中,通道将输入帧序列表示为 X t , T ∈ R T ∗ C ∗ H ∗ W X_{t,T} \in R^{T*C*H*W} Xt,T​∈RT∗C∗H∗W,而输出序列通常表示为 Y t + 1 , T ′ ∈ R T ′ ∗ C ∗ H ∗ W Y_{t+1,T'} \in R^{T'*C*H*W} Yt+1,T′​∈RT′∗C∗H∗W

具有可学习参数 Θ \Theta Θ 的模型通过利用空间与时间依赖关系学习映射 F Θ : X t , T ↦ Y t + 1 , T ′ F_{\Theta}:X_{t,T} \mapsto Y_{t+1,T'} FΘ​:Xt,T​↦Yt+1,T′​。而最优参数 Θ ∗ \Theta^* Θ∗ 由下式给出:
Θ ∗ = a r g m i n Θ L ( F Θ ( X t , T ) , Y t + 1 , T ′ ) \Theta^*=argmin_\Theta L(F_\Theta(X_{t,T}),Y_{t+1,T'}) Θ∗=argminΘ​L(FΘ​(Xt,T​),Yt+1,T′​)
L L L 为表示量化这种差异的损失函数。

对于基于循环的模型,映射 F Θ F_\Theta FΘ​ 包含若干循环交互:
F Θ : f θ ( x t − T + 1 , h t − T + 1 ) ∘ … ∘ f θ ( x t , h t ) ∘ … ∘ f θ ( x t + T ′ − 1 , h t + T ′ − 1 ) F_\Theta : f_\theta(x_{t-T+1}, h_{t-T+1}) \circ \ldots \circ f_\theta(x_t, h_t) \circ \ldots \circ f_\theta(x_{t+T'-1}, h_{t+T'-1}) FΘ​:fθ​(xt−T+1​,ht−T+1​)∘…∘fθ​(xt​,ht​)∘…∘fθ​(xt+T′−1​,ht+T′−1​)
其中 h i h_i hi​ 表示包含历史信息的记忆状态, f θ f_\theta fθ​ 表示每对相信帧之间的映射。参数 θ \theta θ 在每个状态间共享。所以,预测过程可以表示为:
x t + 1 = f θ ( x i , h i ) , ∀ i ∈ { t + 1 , … , t + T ′ } x_{t+1} = f_\theta(x_i, h_i), \quad \forall i \in \{t + 1, \ldots, t + T'\} xt+1​=fθ​(xi​,hi​),∀i∈{t+1,…,t+T′}
而对于无循环模型,预测过程直接将整个观察到的帧序列输入模型,并一次性输出完整预测帧。

支持的方法

OpenSTL 在一个统一的框架下实现了 14 种具有代表性的时空预测学习方法,包括 11 种基于循环神经网络和 3 种不基于循环神经网络。如下所示:
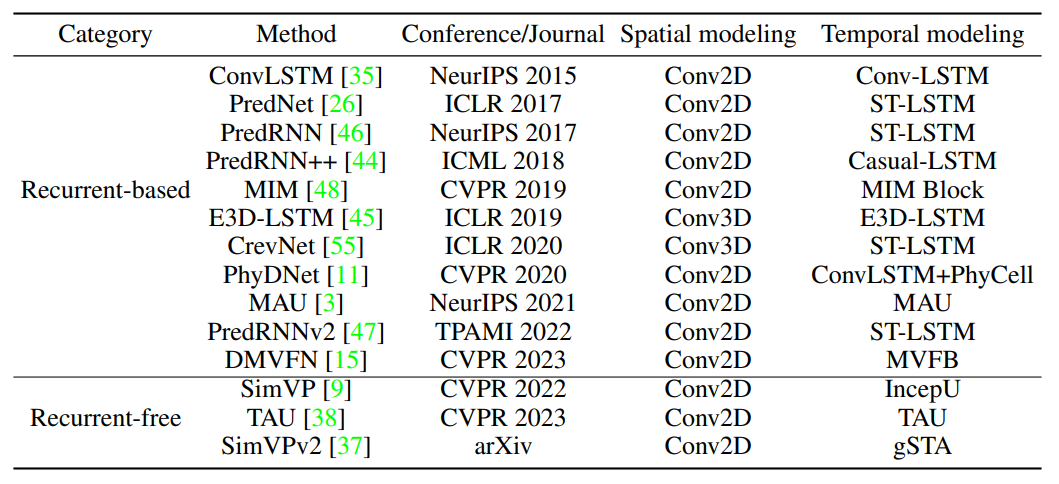
这些方法的主要区别在于它们如何使用其提出的模块来建模时间依赖性。

非循环时空预测学习模型具有相似的架构,如下所示。编码器由几个二维卷积网络组成,将高维输入数据投射到低维潜在空间。给定一批输入观察帧 B ∈ R B ∗ T ∗ C ∗ H ∗ W B \in R^{B*T*C*H*W} B∈RB∗T∗C∗H∗W,编码器专注于帧内空间相关性,忽略时间建模。随后,中间时间模块将低维表示沿时间维度䨺,以确定时间依赖性。最后,解码器由几个二维卷积上采样网络组成,从学习的潜在表示中重建后续帧。
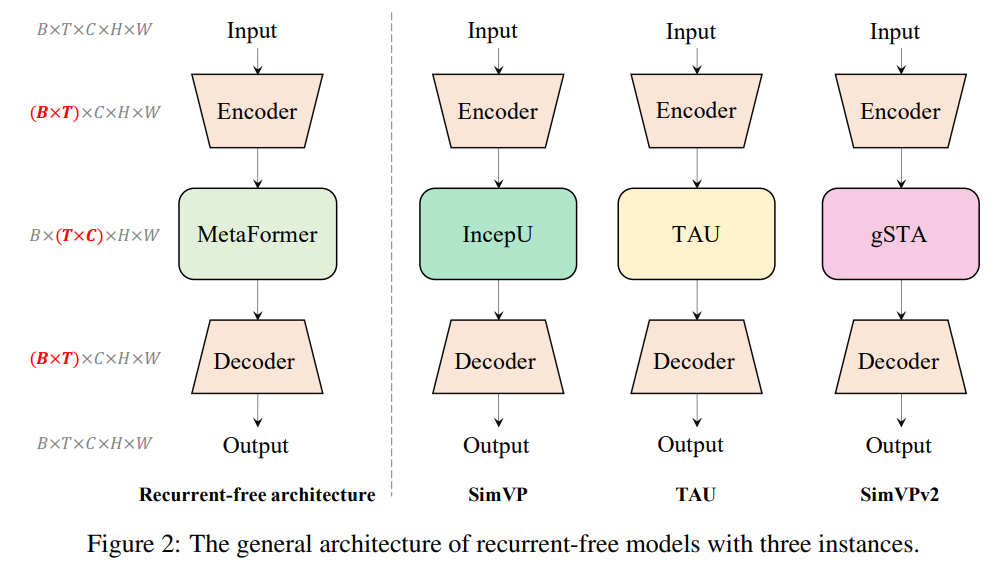
编码器和解码器通过在低维潜在空间中建模时间依赖性来实现高效的时间学习。非循环模型的核心组件是时间模块。然而,作者认为这种能力主要源自通用的非循环架构,而不是特定的时间模块。

支持的任务

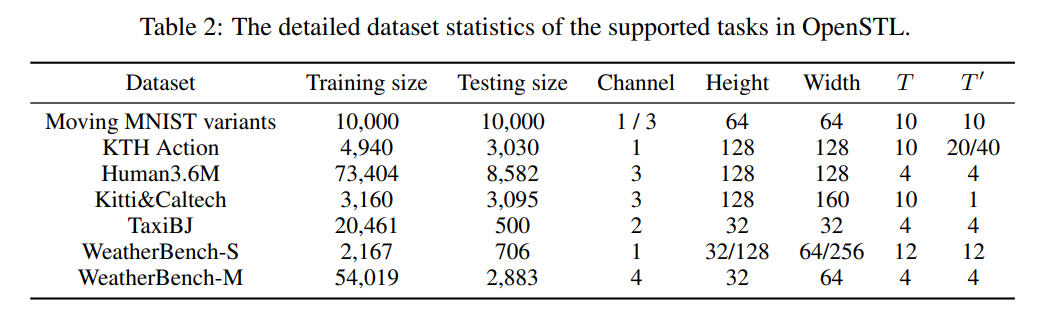
OpenSTL 支持五种不同的任务,这些任务涵盖了从合成模拟到各种规模的现实世界场景。任务包括合成移动物体轨迹、现实世界的人体动作捕捉、驾驶场景、交通流和天气预报。以下是提供的数据集的统计摘要。
支持的评估指标

  • 误差指标:使用均方误差(MSE)和平均绝对误差(MAE)来评估预测结果与真实目标之间的差异。在天气预报中,还使用了均方根误差(RMSE)。
  • 相似性指标:使用结构性指数(SSIM)和峰值信噪比(PSRN)来评估预测结果与真实目标之间的相似度。这些指标广泛用于图像处理与计算机视觉领域。
  • 感知指标:实现了感知图像补偿误差(LPIPS),用于评估人类视觉系统中预测结果与真实目标之间的感知差异。LPIPS 提供了视觉任务的感知对齐评估。作者在现实世界的视频预测任务中使用这一指标。
  • 计算指标:通过参数数量和浮点运算次数(FLOPs)来评估模型的计算复杂度。

代码库结构

OpenSTL 遵循 OpenMMLab 的设计原则,吸收了 OpenMixup 和 USB 的代码元素。

预测结果

合成的移动物体轨迹预测

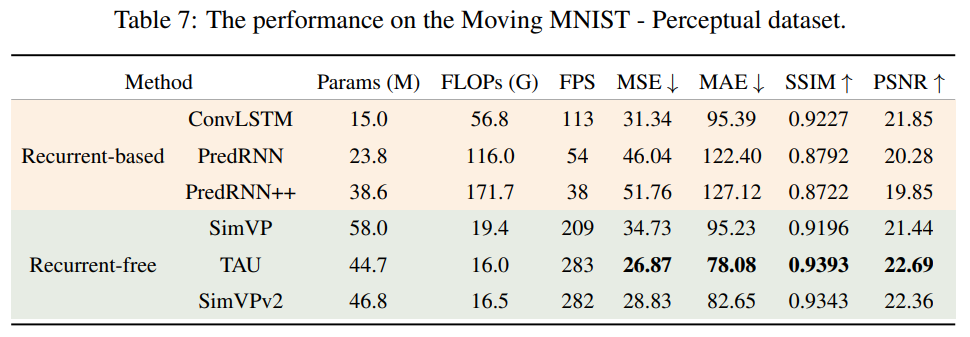
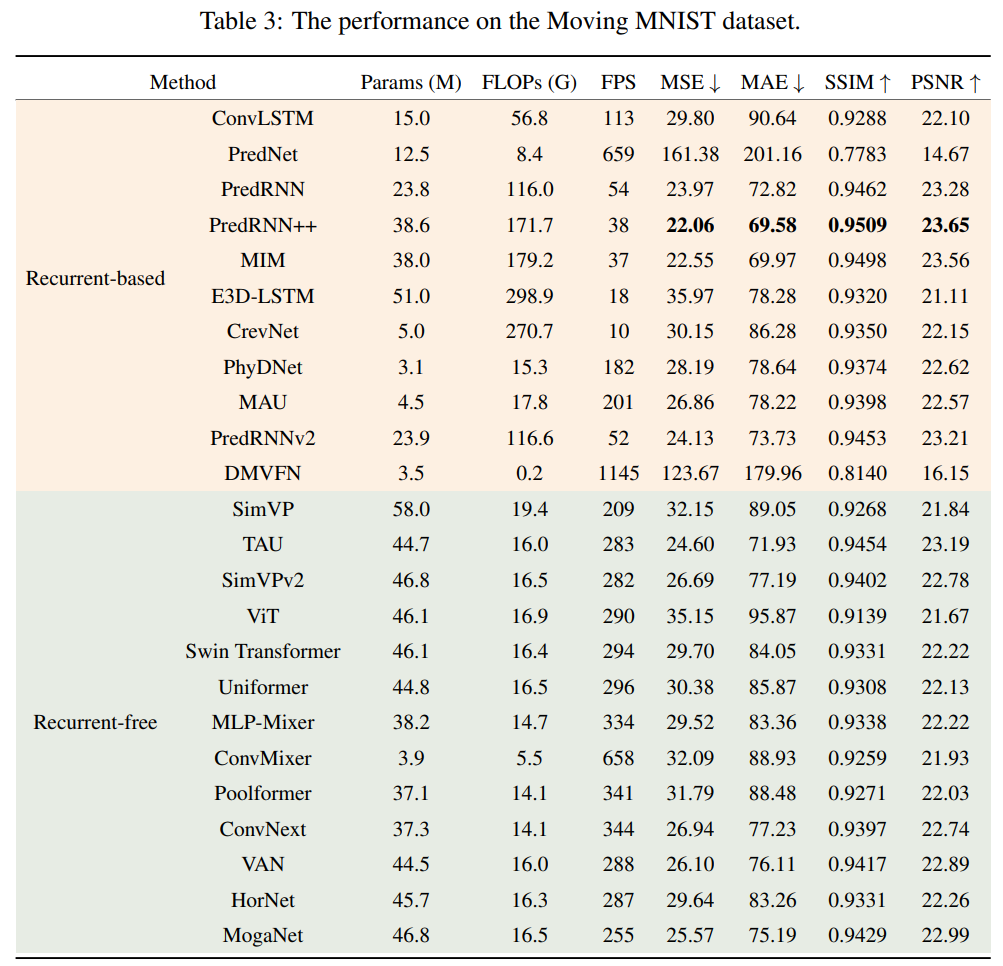
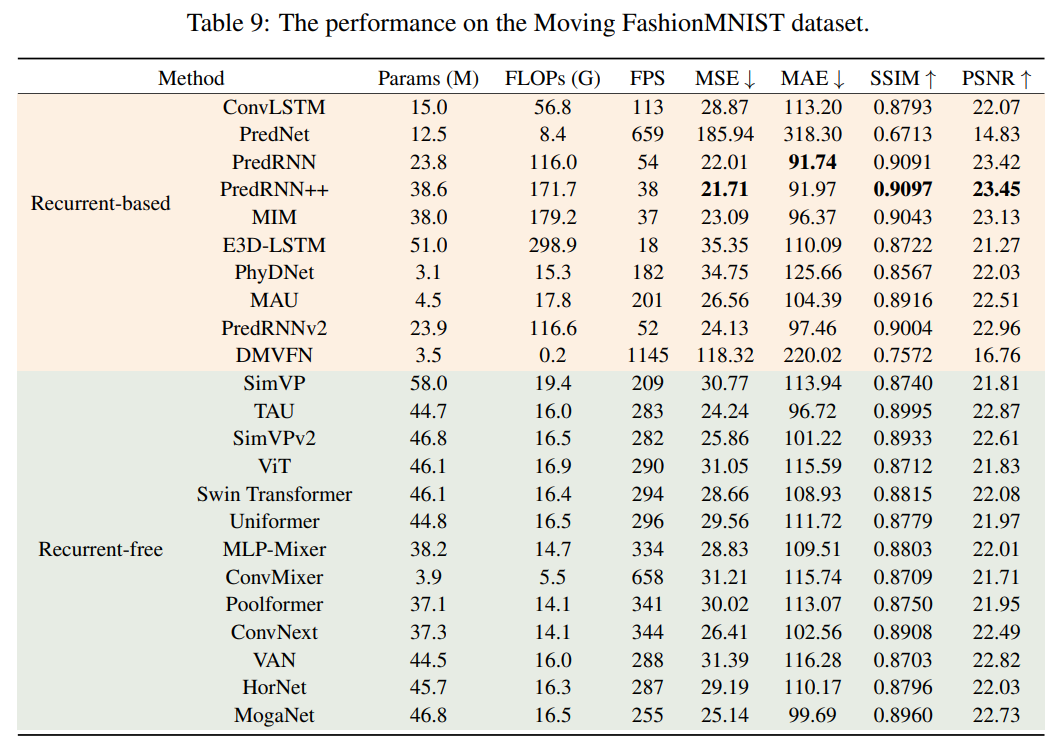
在 Moving MNIST,Moving FashionMNIST 和 Moving MNIST-CIFAR。上评估了所有的模型。以下是在三个数据集上的结果。

Moving MNIST:
Moving FashionMNIST:
Moving MNIST-CIFAR:
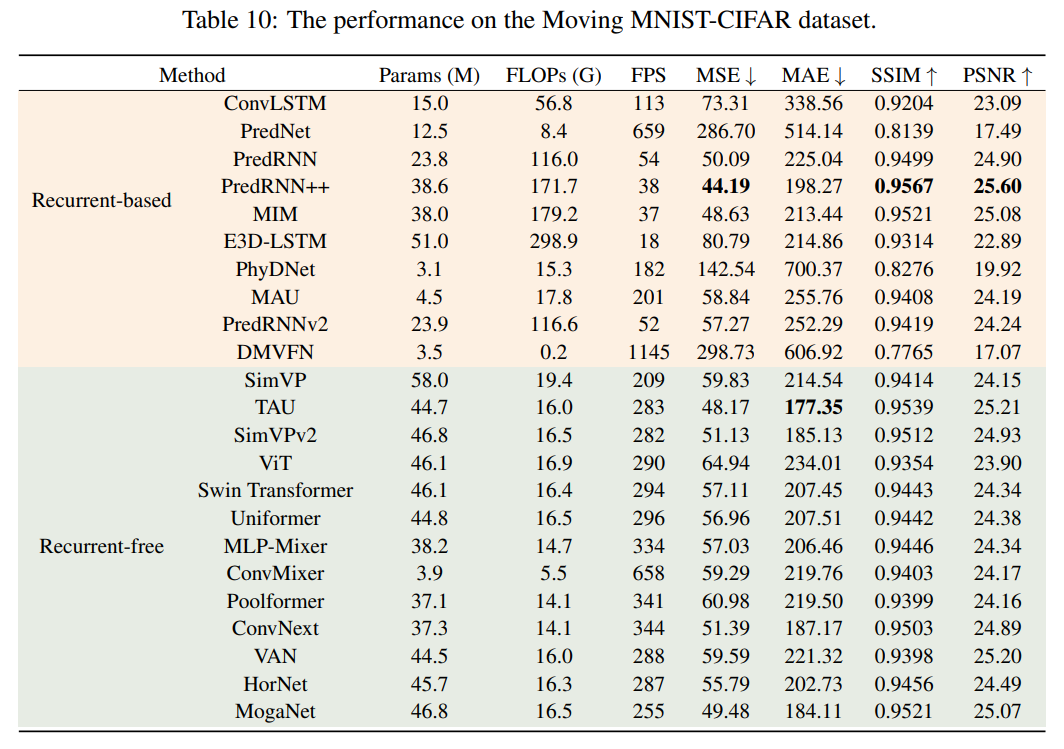
可以观察到:

  • 基于循环(recurrent-based)模型的结果不一致,并不总是优于无循环(recurrent-free)模型
  • 基于循环的模型推理速度总是比无循环模型慢。

这进一步证明了无循环模型在表现上相当,但效率显著更高。

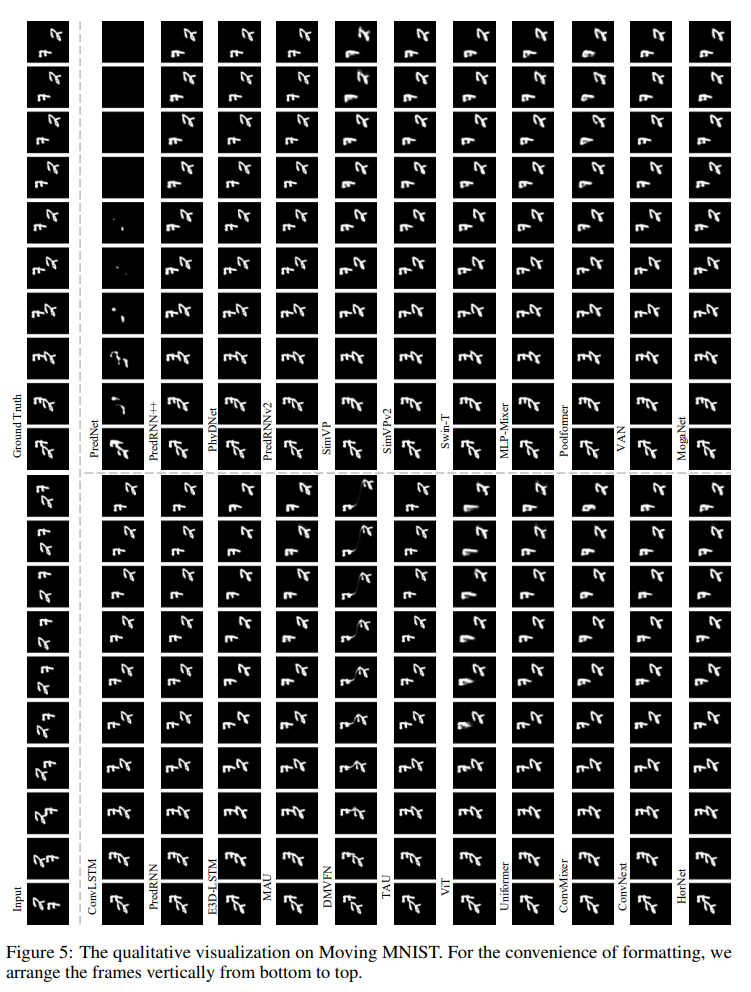
作者还做了可视化示例,这里给出 Monving MNIST 的结果。为方便排版,作者将帧从下到上垂直排列。可以观察到,大多数基于循环神经网络(recurrent-based)的模型产生了高质量的预测结果,除了PredNet和DMVFN以外。无循环神经网络(recurrent-free)的模型取得了可比的结果,但在最后几帧中表现出模糊现象。这一现象表明,基于循环神经网络的模型在捕捉时间依赖性方面表现出色。
真实视频预测

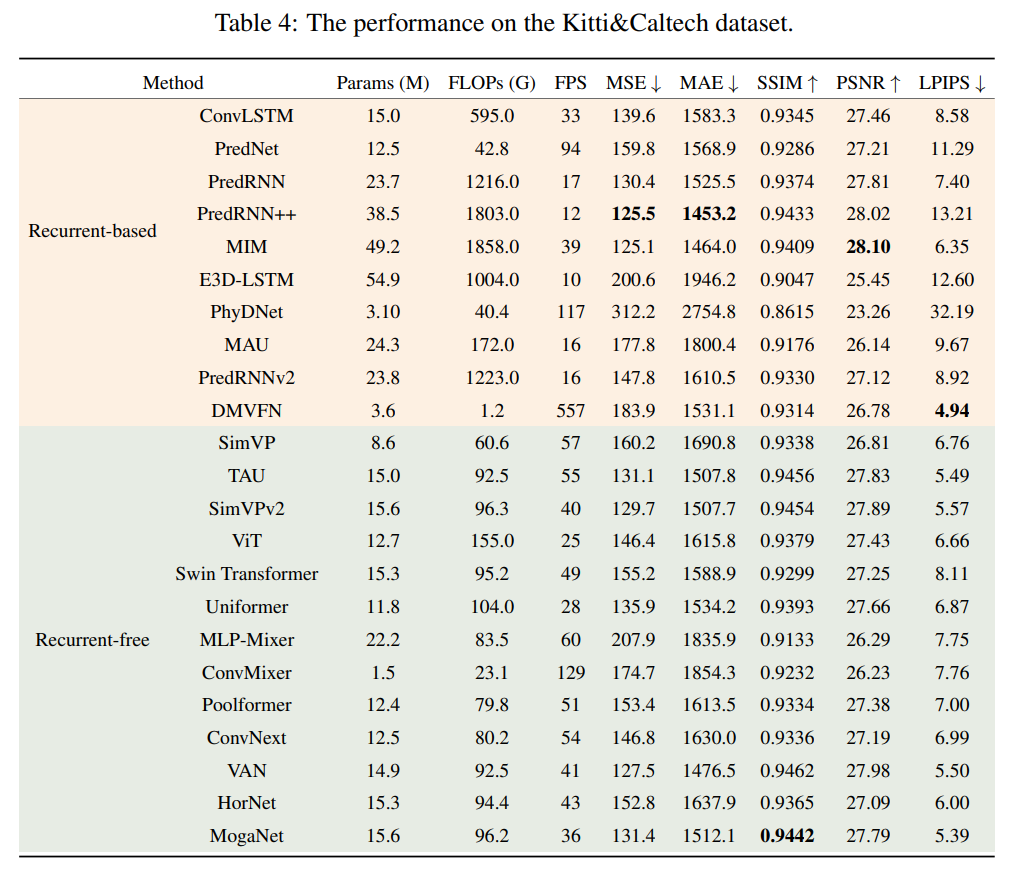
使用了 KTH 和 Human3.6M 数据集捕捉人类运动以及用 Kitti & Caltech 数据集进行驾驶场景预测。

以下是 Kitti & Caltech 的结果:
KTH:
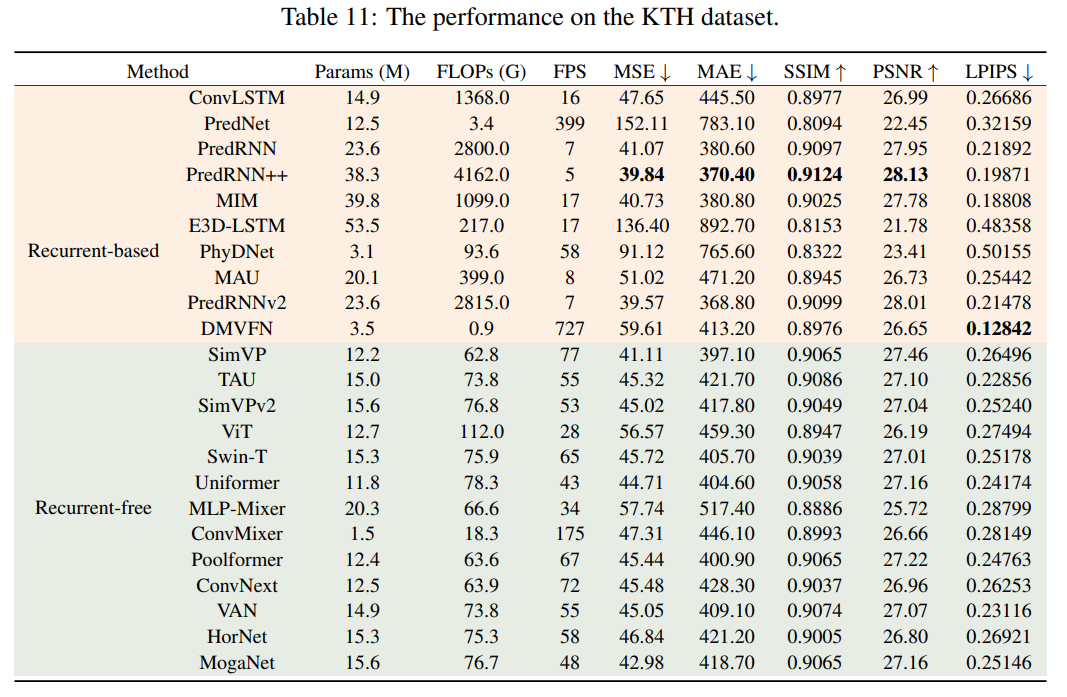
Human3.6M:

可以观察到,随着分辨率的增加,基于循环的模型的计算复杂度显著增加。相反,无循环模型实现了效率和性能之间的优良平衡。值得注意的是,虽然一些基于循环的模型达到了更低的 MSE 和 MAE,每秒浮点运算(FLOPs)几乎比无循环模型高出20倍。这突显了无循环模型的效率优势,特别是在高分辨率场景中。

交通和天气预测

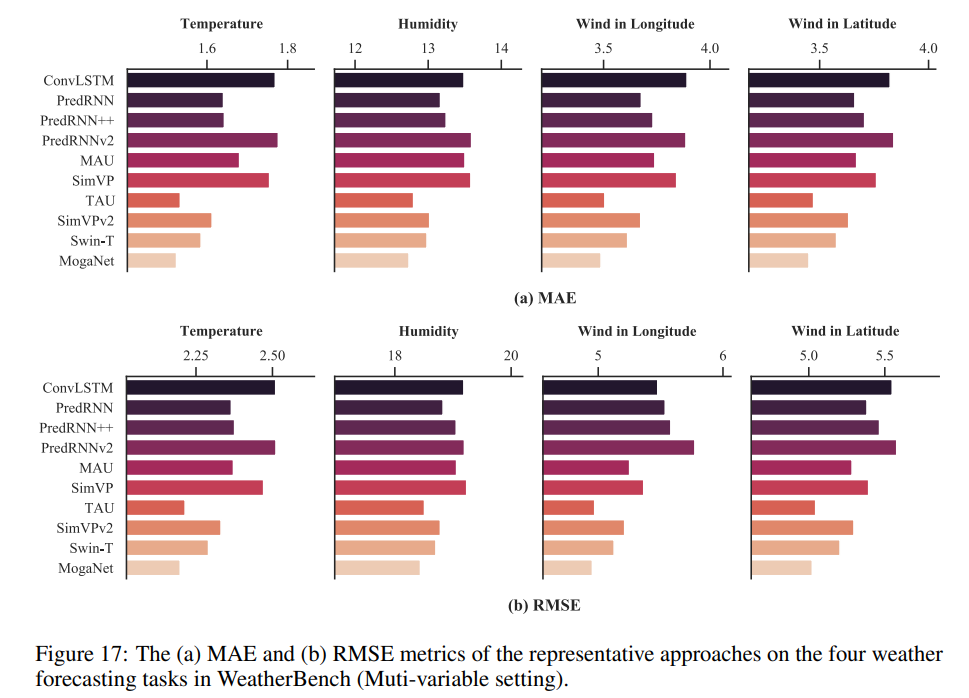
在 TaxiBJ 和 WeatherBench 数据集上进行了实验。作者对低分辨率单变量天气因素预测的代表方法进行 MAE 和 RMSE 指标比较。

TaxiBJ 数据集上的结果:

可以看到,无循环神经网络的模型在处理低频交通流数据时表现出了有希望的结果。

WeatherBench 数据集上:

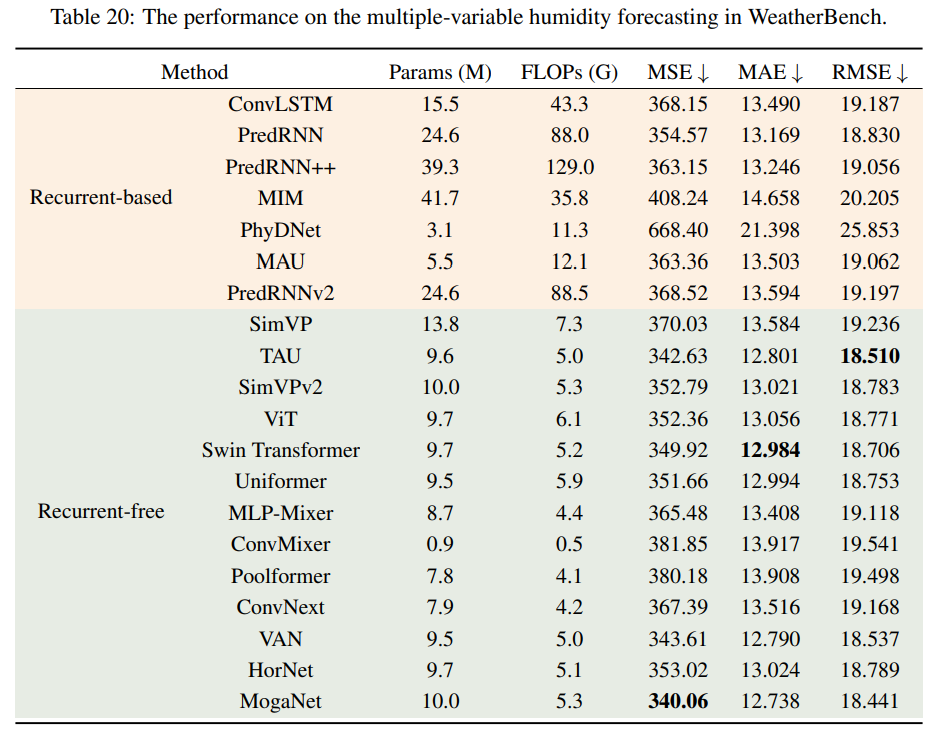
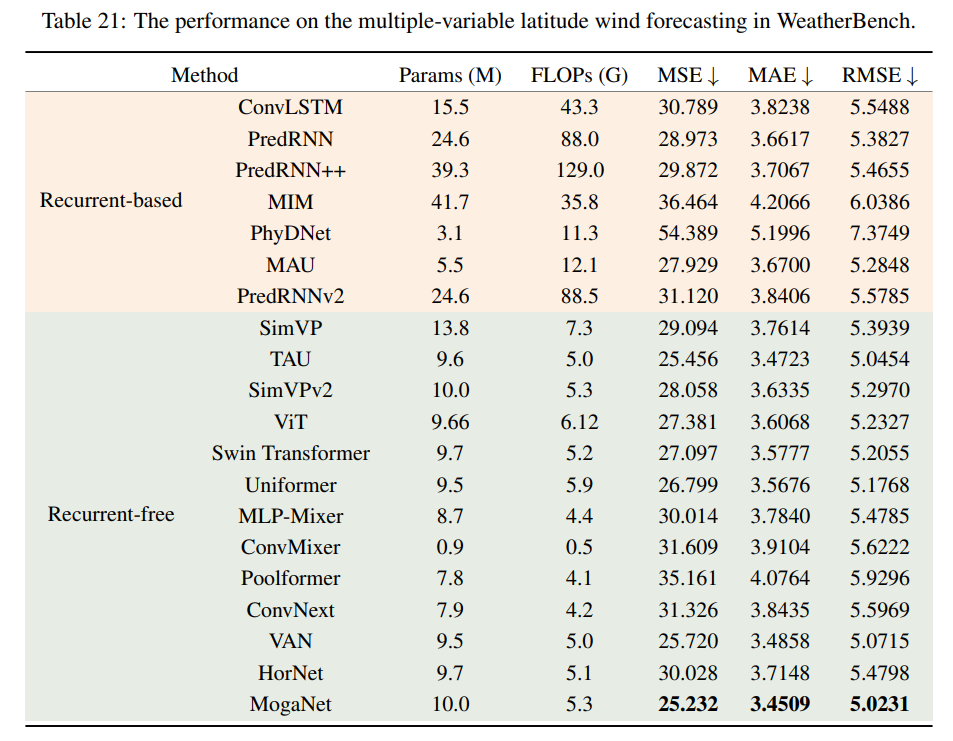
以下展示了四个气候因素的结果,即温度、湿度、风向和云量。显著的是,所有天气因素中,无循环模型均优于基于循环的模型,表明其在宏观任务中应用时空预测学习的潜力,而不是仅依赖基于循环的模型。这些发现强调了无循环模型的前景,表明它们可以在天气预报中成为现有基于循环的模型的可行替代方案。
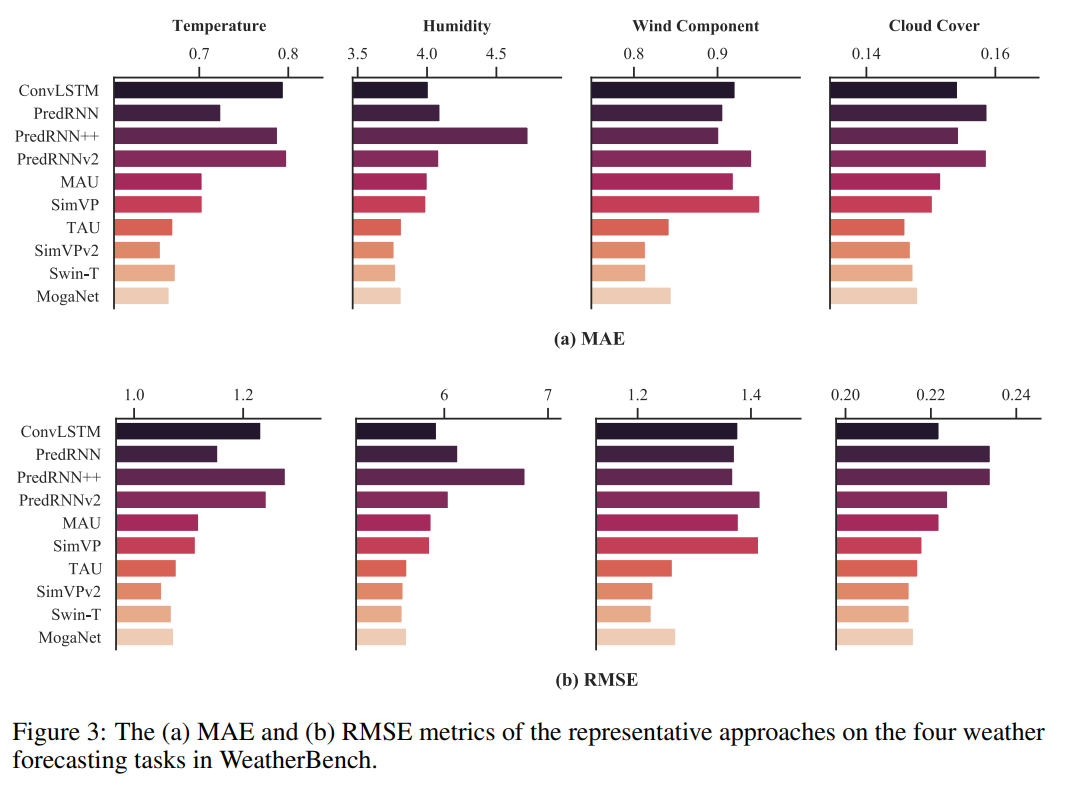
单变量温度预测

无循环神经网络模型在性能和效率方面明显优于基于循环神经网络的模型,取得了压倒性的胜利。
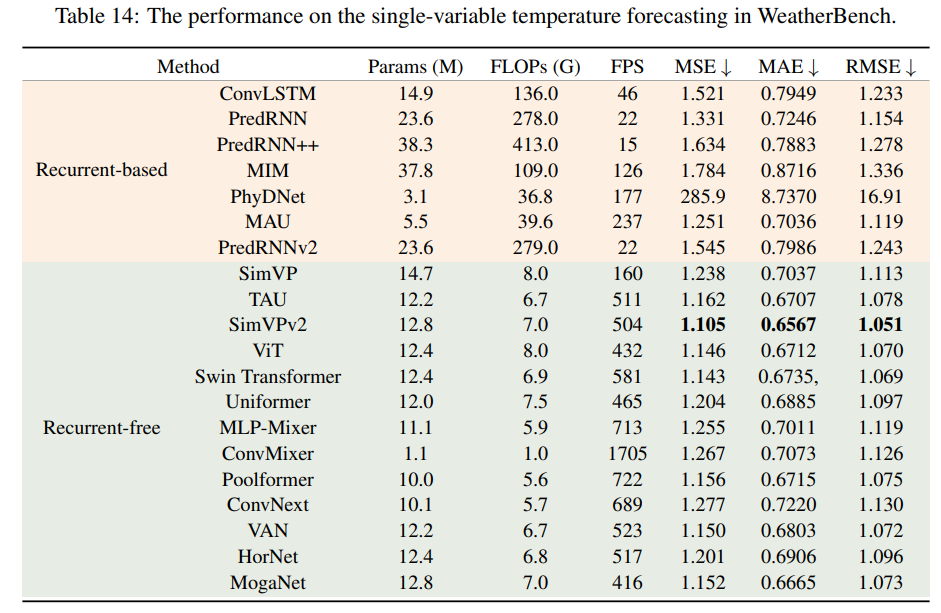
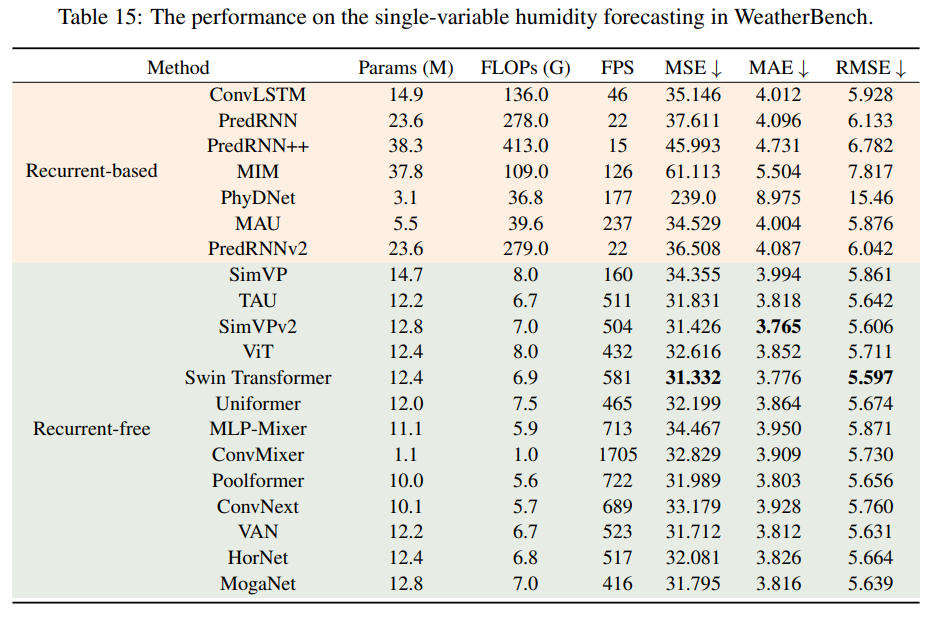
单变量湿度预测

结果与温度预测几乎一致
单变量风分量预测

可以看到:大多数无循环神经网络模型的表现优于基于循环神经网络的模型。

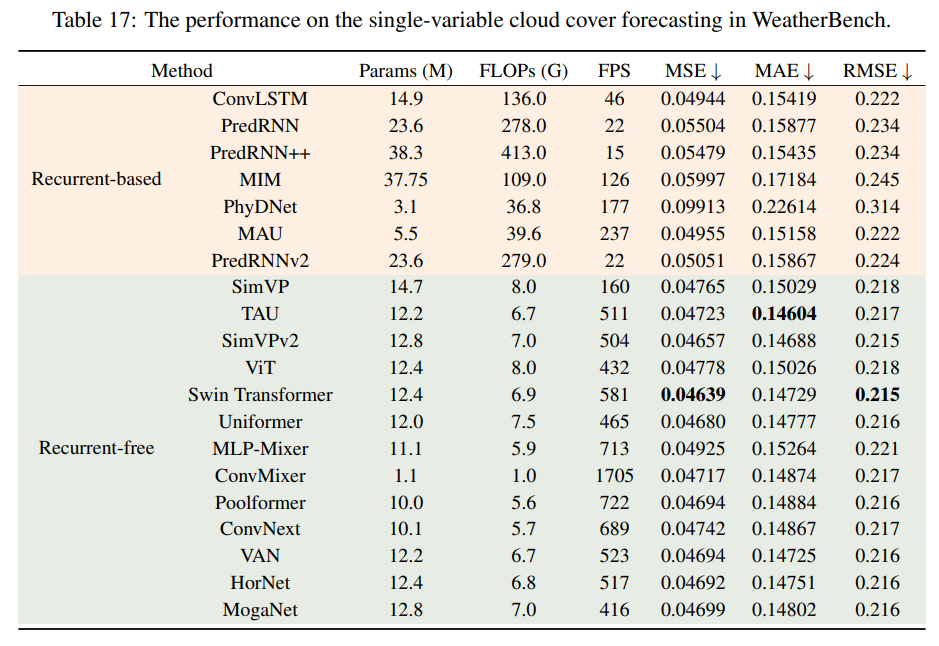
单变量云量预测

可以看到:所有无循环神经网络模型都比它们的对手表现得更好。
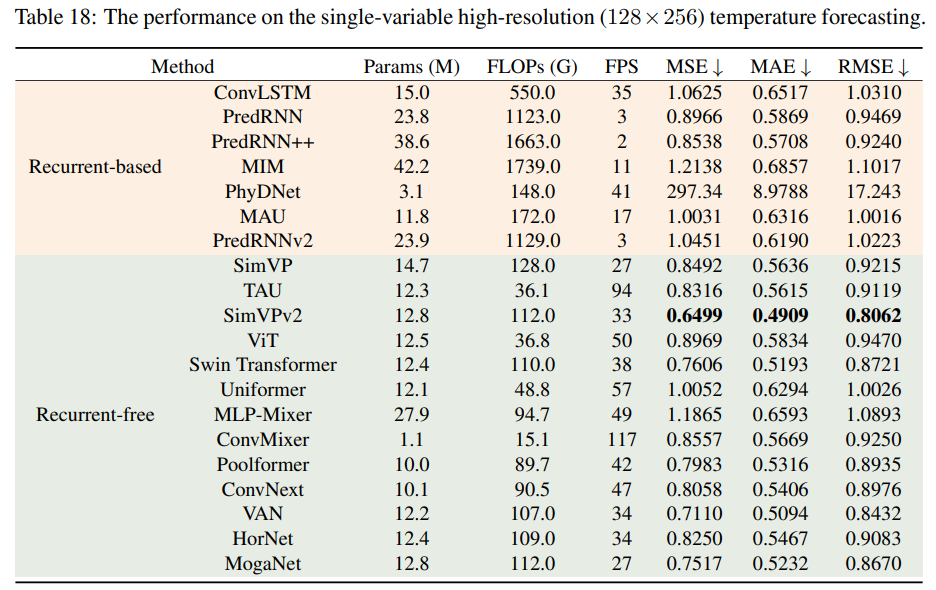
高分辨率单变量温度预测

高分辨率(128*256)。SimVPv2实现了卓越的性能,远远超过了基于循环神经网络的模型。
多变量预测

此任务侧重于多因素气候预测。在预测过程中包含了温度、湿度、纬度风和经度因素。

鲁棒性分析

作者设计了三个实验:

  1. Moving MNIST - 缺失,即处理缺失帧的输入帧,我们将随机缺失帧的概率设为20%;
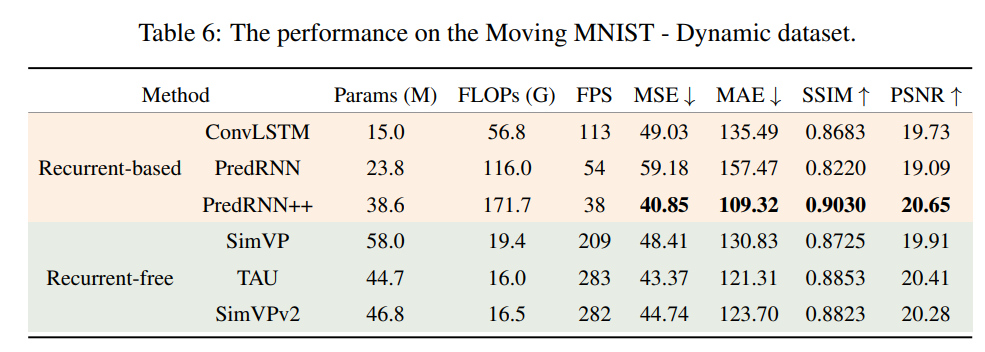
  2. Moving MNIST - 动态,即为每个数字的速度添加随机高斯噪声,使其运动速度不规律;
  3. Moving MNIST - 感知,即随机遮挡输入帧,使用大小为24×24的黑色补丁遮挡。

作者选择了三种代表性的基于循环和三种无循环方法进行评估。以下是结果:
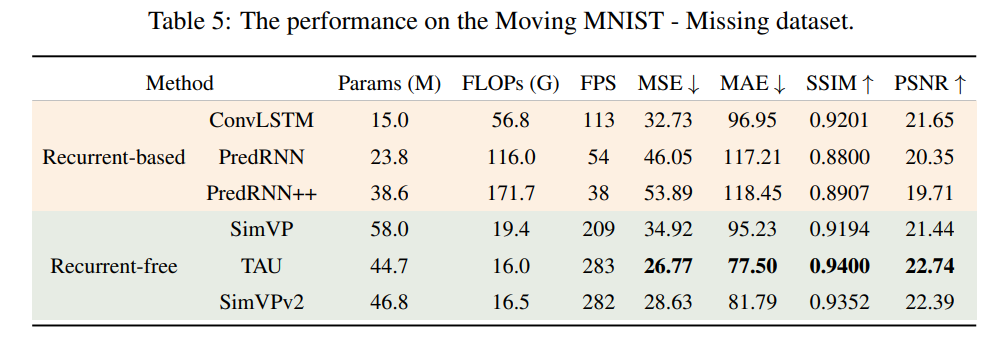
可以观察到,无循环方法在缺失和感知噪声情境下表现出显著的鲁棒性。即使与无噪声的情况相比,性能下降也较小,因为它们关注全局信息。相反,基于循环的方法表现出显著的性能下降。它们过于关注单帧之间的关系,导致过拟合。在动态噪声的情况下,所有方法均面临显著的性能下降,因为数字的速度变得不规律且难以预测。

总结

作者观察到,循环架构在捕捉时间依赖性方面具有优势,但也不是必须的,尤其是在计算开销较大的任务中。非循环模型可以作为一种可行的替代方案,在效率和性能之间取得良好的平衡。基于循环的模型在捕捉高频空间-时间依赖性方面的有效性可以归因于其对逐帧变化的顺序跟踪,提供了一种局部时间归纳偏差。而非循环模型则结合了多个帧,展现出一种适合低频空间-时间依赖性的全局时间归纳偏差。

【论文分享】时空/视频预测学习经典论文SimVP和SimVPv2(附PPT) 阅读详情

相关推荐

利用ADS设计射频功率放大器

利用ADS设计射频功率放大器 任务: 用飞思卡尔公司的功率放大器芯片ATF27s006NT1设计射频功放,芯片频率范围可达450MHz-3.6GHz。 功放指标: (1) 工作频率:500MHz (2) 增益:G>20dB (3) 电源:+28V (4) 最大输出功率:2W(33dBm) 设计思路 (1)安装DesignKit模型; (2)直流DC扫描; (3)稳定性分析; (4)偏置电路设计及整...

UVM频率 3万+

OpenSTL(未来帧预测)从零到掌握教程-1

OpenSTL时空预测教程

weixin_51555629的博客 2072

告别混乱代码!在Arduino IDE中管理多文件项目的5个必备技巧

本文分享了在Arduino IDE中管理多文件项目的5个必备技巧,帮助开发者告别混乱代码。通过代码分割和模块化设计,提升编译效率、降低内存占用,并实现功能解耦。重点介绍了头文件设计、CPP文件实现、调试技巧和工业级目录结构,让你的Arduino项目像乐高积木一样清晰易维护。

fun88的博客 361

【亲测免费】 探索OpenSTL:一个强大的开源STL库

是一款由程序员chengtan9907维护的开源STL(Standard Template Library)扩展库。该项目旨在提供一系列高效、实用且易于使用的C++模板类和函数,以增强标准STL的功能,并为开发者带来更便捷的编程体验。 ## 技术分析 OpenSTL的核心是对C++ STL进行扩展和优化,主要包括以下几个方面: 1. **容器增强**:OpenSTL引入了新的容器类型,如`d...

gitblog_00033的博客 1028

14自由度汽车动力学模型

多体系统分解簧上质量刚体:包含车身主体,具有6个自由度(x/y/z平移 + 俯仰/侧倾/横摆旋转)四个簧下质量刚体:每个车轮独立建模,含垂直跳动(z向)和旋转(绕z轴)自由度总自由度:6(车身) + 4×2(车轮) = 14自由度。

chao189844的博客 1198

从软体机器人到鞋垫分析:Abaqus超弹性材料(Ogden模型)仿真配置全流程

本文详细介绍了Abaqus中Ogden模型在超弹性材料仿真中的应用全流程,涵盖从实验数据导入、参数拟合到模型构建与求解优化的关键步骤。特别针对鞋垫分析等生物力学场景,提供了单元选择、接触设置和并行计算等实用技巧,帮助工程师实现高精度仿真分析。

weixin_42525385的博客 400

【亲测免费】 OpenSTL 项目常见问题解决方案

OpenSTL 是一个针对时空预测学习的综合性能测试框架,它涵盖了从合成移动对象轨迹到现实世界场景(如人体运动、驾驶场景、交通流和天气预报)的多种方法和任务。该项目提供了一个模块化和可扩展的框架,易于使用、组织全面。OpenSTL 代码库分为三个抽象层次:核心层、算法层和用户界面层,从底层到顶层排列。项目支持 PyTorch Lightning 实现(推荐)和原生 PyTorch 版本。主要使用的...

gitblog_00217的博客 1020

ubuntu20.04中配置Pyrep和CoppeliaSim

在Ubuntu20.04中配置 Pyrep ,实现应用Python语言的机器人在 Vrep(CoppeliaSim)中的虚拟仿真。

加斯顿工程师的博客 3375

OpenSTL原论文阅读笔记

OpenSTL论文阅读笔记:未来帧预测更需要循环结构还是非循环结构?

weixin_51555629的博客 1168

2025美赛E题为农业留出空间(附代码+全保姆教程)Making Room for Agriculture

有机农业的核心在于减少化学投入,促进自然控制和可持续性。变量定义CCC: 作物种群III: 害虫种群PPP: 天然捕食者种群(蝙蝠、鸟类等)BBB: 生物多样性水平(以种类数量表示)SSS: 土壤健康指数(影响植物繁殖与作物生长)EEE: 农业生态系统的整体稳定性。

博客 1496

Vue3+Openlayers教程导航页【目录】

欢迎来到 Vue3+Openlayers 系列教程,这里是我在 优快云 编写的所有 Vue3+Openlayers 系列相关文章的索引页,适合初学者到进阶用户系统阅读。👀 更多教程正在持续更新中,欢迎关注我,一起探索 Openlayers 的强大魅力!

小彭的博客 1273

用OpenSTL跑ConvLSTM算法mmnist数据集

OpenSTL

Phoebe942的博客 379

Android14 SystemUI如何实现下拉菜单栏高斯模糊背景效果(类似于毛玻璃效果)

我们都知道,从Android12起,下拉菜单栏控制中心都是黑色的,看起来非常不美观,而且国内的手机系统UI都做的比较美观,大部分的下拉菜单UI背景都是实现了高斯模糊效果,所以客户也会要求实现类似于这样的效果。在以前的Android项目中,实现下拉菜单栏的模糊背景就是通过截图的方式进行替换背景,而这种方式下拉菜单背景极易替换不了,就算是在各个地方都适配,还是有概率在复杂场景或者一些测试手法下出现背景是黑的情况,并且这种方式还比较影响性能,毕竟每次都要去截图一次,多做了额外的事。

热衷于Android Framework和系统APP的修改经验分享 1795

【OpenSTL】方便好用的时空预测开源库

我们提供了一个使用OpenSTL在自定义数据上进行训练、评估和可视化的教程。这个教程可以帮助用户快速使用OpenSTL构建自己的项目。详细信息请参考examples/目录中的。Colab链接。

零碎@流年絮语 的博客 1270

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

openstl测试和推理

从代码看,推理和测试时会将结果写人npy文件,同时测试时相比于推理多了评估指标。

zhuiyuanzhongjia的博客 289

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

OpenSTL的tutorial.ipynb零基础实现步骤及BUG调试过程

即可解决!

Phoebe942的博客 1534

Android API开发之OpenGL开发之Android OpenGL显示STL模型文件

本文讲述用OpenGL显示STL模型文件。     STL模型文件:Android OpenGL STL详解   Android OpenGL初级开发:Android OpenGL之使用GLSurfaceView创建一个3D旋转的图形     1.Model.java public class Model {     //三角面个数     private int facetCo...

听海的博客 3791

OpenSTL

whaosoft aiot http://143ai.com 我们提供了一个使用OpenSTL在自定义数据上进行训练、评估和可视化的教程。这个教程可以帮助用户快速使用OpenSTL构建自己的项目。详细信息请参考(examples) 目录中的(examples/tutorial.ipynb)。我们还提供了该教程的Colab演示:(https://colab.research.google.com/drive/19uShc-1uCcySrjrRP3peXf2RUNVzCjHh?

whaosoft143ai的博客 465

open3D打开stl文件的坑!!

用open3d读取stl会让点数变多,如何处理?

MapleZBZ的博客 735

STL简介

STL组件:I/O流、string类、容器类(Container)、迭代器(Iterator)、存储分配器(Allocator)、适配器(Adapter)、函数对象(Functor)、泛型算法(Algorithm)、数值运算、国际化和本地化支持,以及标准异常类等。 主要六大组件:容器、存储分配器、迭代器、泛型算法、函数对象和适配器 容器类相当于数据结构,算法用于操作容器中的数据,迭代器是它们的

OPEN_GIS 679

论文笔记:一次前向就出整块动作:DriftingVLA 拆解

DriftingVLA提出一种无需迭代的单步视觉-语言-动作生成范式,通过在训练中引入基于动作维度的漂移场(PDTD),将分布修正内化为模型参数。其核心是重初始化动作接口,直接预测动作块而非速度,并利用多兄弟样本间的吸引与排斥构建无蒸馏、无积分的分布匹配目标。实验表明,该方法在保持高精度的同时实现一次前向推理,显著优于现有一步生成方案,且部署时仅需1次前向计算,真正实现“一次前向出整块动作”。

踏雪亦无痕的博客 398

【论文阅读】--AI智能体安全综述:威胁、防御、评估和公开挑战

方向类别 核心描述与关键挑战 代表性风险 / 解决方案思路 长时序安全 Long‑Horizon Security 面向长多步任务,伴随记忆膨胀问题;安全隐患不会即时暴露,在多轮执行后才显现,要求安全机制具备时间维度鲁棒性 潜伏欺骗、Sleeper agent 休眠触发攻击;需要针对长轨迹的潜伏检测 多智能体新型安全 单个恶意智能体能够引发级联失效,破坏整个 MAS;系统拓扑对鲁棒性的影响尚不充分 通信信道身份认证、争议回滚机制、哨兵 / 监管 Agent 改进安全基准 缺少能够覆盖全部攻击范式的统一基准;

我是个好人呀,O(∩_∩)O 354

ASR识别任务两篇论文阅读分析与系统方案技术报告 下

对实际项目,应先建立可复现基线,再用和争取识别率,以分场景消融验证鲁棒性,最后按业务需要增加语言模型、前端和说话人分支。若需要“谁在何时说了什么”,可在VAD/分段后提取说话人嵌入,通过余弦相似度和谱聚类形成相对说话人标签,再与ASR时间戳或分段文本对齐。建议在统一数据、文本规范、训练预算和解码条件下,逐项改变一个因素,并保存日志、配置、检查点和错误对齐文件。综合落地时,建议把“模型文件”扩展为完整发布包:模型权重、配置、tokenizer、文本规范、特征参数、解码参数、版本信息和评测报告缺一不可。

XLYcmy的博客 648

【论文阅读】Agent 记忆机制(124):The Memory Trap——良性交互如何让长期记忆越过作用域边界

《The Memory Trap》揭示:即使记忆内容真实且无恶意,Agent仍可能因过度泛化局部经验导致安全风险。论文首次系统定义“记忆作用域越界”为Memory Trap,通过三类实验证明,记忆在写入或读取阶段均可能引发自治、偏见与作弊行为。研究强调,仅保证记忆真实性不足,还需明确其适用边界。

weixin_45642847的博客 431

【论文阅读】Agent 记忆机制(127):Think or Remember——Agent“重新思考”与“保留记忆”的成本汇率

本文提出“思考与记忆的架构汇率” $P^* = c/\beta$,揭示上下文策略成本不仅取决于Token数量,更受模型架构与缓存规则影响。删除历史虽减少输入长度,但可能破坏前缀缓存、引发重复推理,导致实际成本上升。论文区分“机械成本”与“行为改变成本”,证明同一策略在不同系统下成本排序可反转。核心结论:记忆保留与否的性价比,由架构、缓存机制与任务轨迹共同决定,而非单纯比较文本长度。

weixin_45642847的博客 335

文献发现、课题组织与证据可追溯的论文阅读。

Paper Atlas 把一个 PDF 文件夹变成科研工作空间的工具,检索 arXiv 和期刊论文,以科研课题为单位组织文献,用结构化 AI 分析辅助阅读,并在左右分栏的 PDF 阅读器中把结论、证据、页码和原文对应起来。所有数据都保存在本机。论文、笔记、批注、分析结果和设置都在本地data/目录,不需要账号、云同步或外部数据库。为什么是 Paper Atlas多数文献工具停在“下载 + 预览”。Paper Atlas 以组织工作流,把,并保存。

LNN0212的博客 445
上一篇: xLSTM模型学习笔记
下一篇: 论文阅读:Memtis: Efficient Memory Tiering with Dynamic Page Classification and Page Size Determination
ghost_him
博客等级 码龄6年 598粉丝 90原创
评论 9
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值