
xLSTM模型学习笔记

xLSTM:拳打Transformer,脚踢Mamba?! ​记得在《重新审视神经网络》这篇文章中提及,任何人都可以构建自己心目中的神经网络。在Transformers、Mamba、KAN之后,长短期记忆 (LSTM) 架构的发明者Sepp Hochreiter和他在NXAI的团队推出了一种称为扩展LSTM (xLSTM) 的新变体。 阅读详情
AI摘要

本文回顾了 LSTM 及其缺点,介绍了其改进版本。sLSTM 改进注意力机制,通过更改激活函数等提升性能;mLSTM 改进内存处理,增加记忆单元并引入键值对概念,可并行处理;xLSTM 基于 Cover 定理,结合前两者优势,逻辑结构明确、效率高,适用于不同场景。

笔记来源:bilibili

LSTM 回顾

原始的 LSTM 是为了解决 RNN 时序反向传播中梯度消失和爆炸问题而提出的。
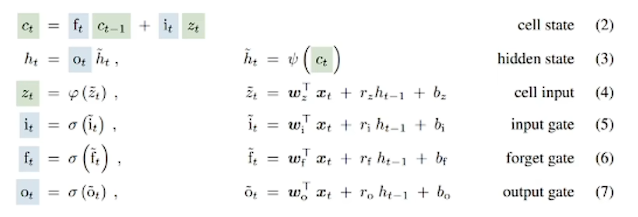
其所谓的门控机制,其实就是一种时序上的注意力机制,相当于把不同时间进行"掺和",是对时序信息的一种选择性控制。从这个视角看,它与 Transformer 和 mamba 都异曲同工之妙。核心思想都是选择性控制信息流动,更好地处理时序数据或序列信息。门控机制通过固定的结构和参数来控制信息流,而注意力机制通过动态计算权重来控制信息流。因此,门控机制可以看作是一种特定形式的时序注意力机制,对不同时间步的信息进行选择性控制和"掺和"。可以认为是一种约束版或者简化版的注意力机制。

其缺点

LSTM 有三个主要局限性:

  1. 在处理长序列时效率低
  2. 记忆容易有限
  3. 不可以并行处理数据

而 transformer 借助网格模块堆叠,参数规模扩充和 GPU 并行处理拼算力,在一定的程序上解决了以上的问题,所以 transformer 实现了赶超。

初级版:sLSTM 改进注意力机制
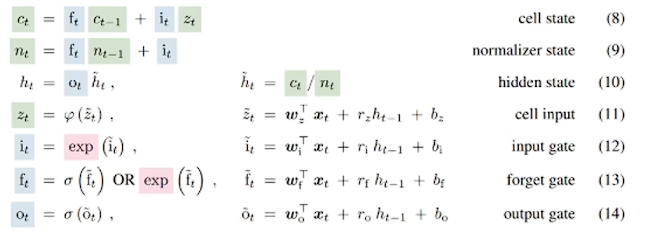
改进的点:

  1. 输入门和遗忘门的激活函数从 sigmoid 改成了指数函数(红色部分)
  2. 引入了一个归一化状态 n t n_t nt​,相应的隐层 h t h_t ht​ 的计算方式亦了,改成了 c t / n t c_t/n_t ct​/nt​(公式 10)
  3. 引入了一个额外状态 m t m_t mt​ 来进一步稳定门控

改进的原因如下:

  1. 指数函数相比于 sigmoid 函数,具有更大的输出范围和更大的梯度,可以减轻梯度消失的问题,使得梯度在反向传播过程中不会迅速减小,从而使得模型在训练时能够更有效地更新权重。
  2. 指数函数的增长速度比 sigmoid 函数快,对输入变化更加敏感,因此,可以更迅速地强烈的调整输入和遗忘门的输出,使得模型能够更快地捕捉到输入信息的变化,更加选择性地记住或忘记信息,从而提高模型的记忆和遗忘能力。
  3. 强烈的选择性可以让模型能够更准确地保留重要信息和丢弃不重要的。在特定任务(如长序列的最近邻搜索或稀有事件预测)中表现得尤为显著,能够显著提升模型的性能。

引入归一化和状态 m t m_t mt​ 都是为了稳定,因为指数激活函数可能导致数值过大而溢出,前者相当于搞了一个大分母。后者通过下面的公式进行:
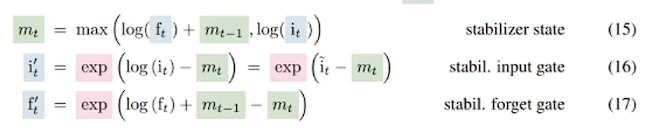
第一个式子中,使用了 log 的作用就是防止输入门和遗忘门都不要太猛。然后根据 m t m_t mt​ 来调整输入了门与遗忘门,这样就实现了对输入门与遗忘门的调节。

在原论文中,还证明了在瘦身传播中使用 f t ′ f'_t ft′​ 和 i t ′ i'_t it′​ 替换 f t f_t ft​ 和 i t i_t it​ 不会改变整个网络的输出,也不会改变参数损失的导数。

增加了这些公式相当于增加了新的记忆单元,它们之间通过连接从长短期记忆状态,借助门控(阀门)i, f, 0 进行记忆混合。门控就是选择,也是一种时序注意力机制的体现。

中级版:mLSTM 改进内存处理

解决了敏感度,某种程序上也是长序列处理效率问题,为了增强 LSTM 的存储能力,文章将 LSTM 的记忆单元从一个标量 c 增加到矩阵 C。而且在这里引入了 transformer 键值对的概念,更新规则如下:
C t = C t − 1 + v t k t T C_t=C_{t-1}+v_tk_t^T Ct​=Ct−1​+vt​ktT​
在将输入投影到键和值之前,mLSTM 进行层归一化,使得均值为零。同时,将协方差更新规则,也就是优化器整合到 LSTM 架构中,遗忘门对应于衰减率,输入门对应于学习率,而输出门则缩放检索到的向量,最终形成了下面的迭代公式:
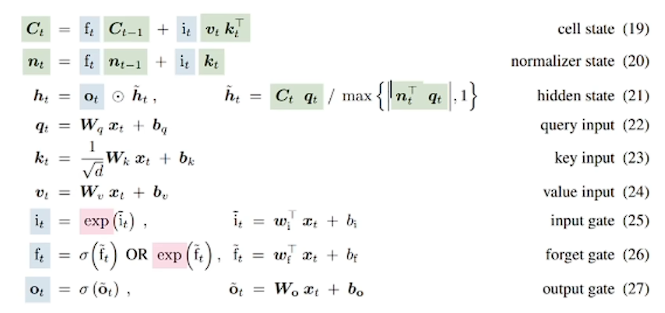
与之前的 sLSTM 对比,最大的区别之一就是状态和权重参数都变成了矩阵的形式,对应的运算变成了向量矩阵简洁和哈达玛积。区别之二是增加了 q t q_t qt​, k t k_t kt​, v t v_t vt​ 这种键值对的计算公式,优化了自注意力机制,多了好几个权重矩阵增强了模型表达能力。其他的公式基本没变。相当于,记忆单元没变,只是每个单元扩容了记忆的容量。

此外,这种框架可以使用多头模型,头与头之间没有记忆混合,因此可以充分并行,可以提升并行能力。

高级版:xLSTM 大模型

Cover 定理

Cover 定理:它及衍生的高维空间中非线性映射理论是现代大模型设计的重要理论依据之一。尤其是在深度学习和大规模神经网络的设计中,直到了关键的作用。

大模型中,激活函数通过非线性变换将数据映射到高维空间,使得模型可以捕捉复杂的模式和特征,增强模型的表达能力。深度网络在权重矩阵和激活函数共同作用,将输入数据逐步映射到越来越高的维度。这使得在低维空间难以分离的模式在高维空间国变得线性可分。Transformer 模型就是通过多头注意力机制在高维空间中进行并行处理,使得不同位置的特征可以相互影响和结合,从而提高了模型的性能。

Cover 定理为这些设计提供了理论支持,解释了为什么通过高维空间国的非线性映射可以提高模型的性能。

核心模块和工作原理

它做了以下的事:

  1. 非线性总结(压缩信息):通过残差块在高维空间中对历史信息进行非线性总结,使得不同的历史或上下文信息更容易分离。
  2. 线性映射回原始空间:完成高维空间中的处理后,再将数据线性映射回原始空间。这一过程利用了高维空间中的优势,使得模型可以更好地分离和记忆历史信息。

而具体的长维,其结构如下:
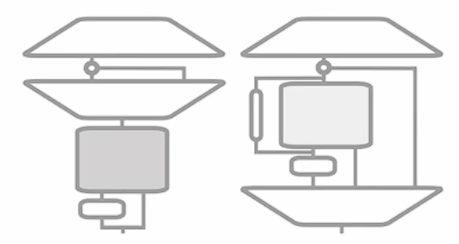
左侧可以看成 sLSTM,右侧则可以看成:mLSTM。其输入方向为,从下往上输入。

左边是先在原始空间中总结信息(sLSTM),然后映射到高维空间,再返回原始空间。可以看到,有一个倒梯形矩阵用于升维,处理后再降维。而右边是先映射到高维空间,总结信息后再返回原始空间。输入直接上投影,再使用 mLSTM 处理,然后再降维。

关于为啥,左边使用 sLSTM,而右边使用 mLSTM:高维空间中的记忆容量更大,所以使用矩阵化记忆单元的 mLSTM 更合适,而在低维空间处理 sLSTM 更合适。

以下是两个模块的详细设计:
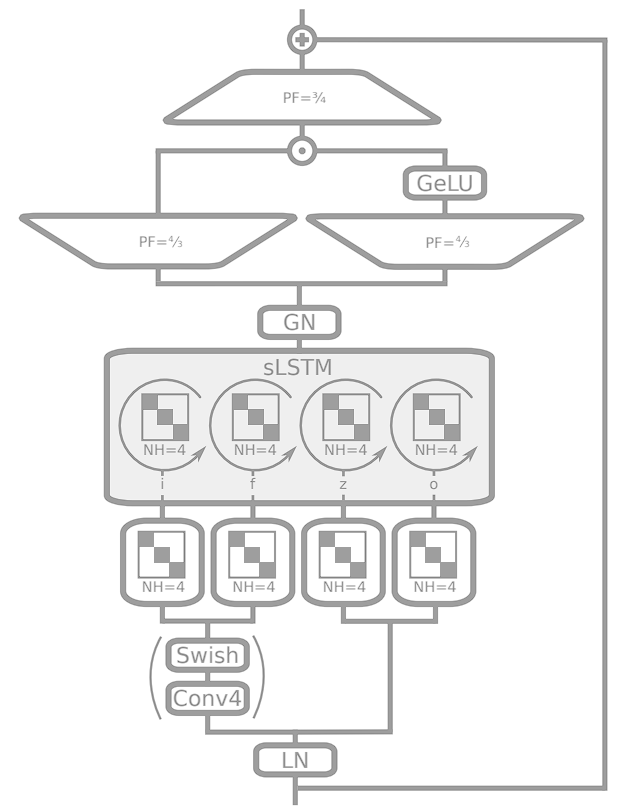
  • PF=3/4 和 PF=4/3:投影因子,用于将输入维度缩小或扩大为原来的 PF 倍。
  • GN:组归一化。在每一组内进行归一化,有助于加速训练和提高模型稳定性,特别是在小批量(batch)训练时。
  • Swish:一种平滑的非线性激活函数,可以帮助模型学习到更复杂的模式。
  • Conv 4: 卷积层,卷积核大小为 4,提取局部特征。
  • LN:层归一化,帮助稳定和加速训练过程。
  • NH=4:表示有 4 个头。此外,将输入块,使用块对角线结构进行线性变换,有助于捕捉局部相关性。
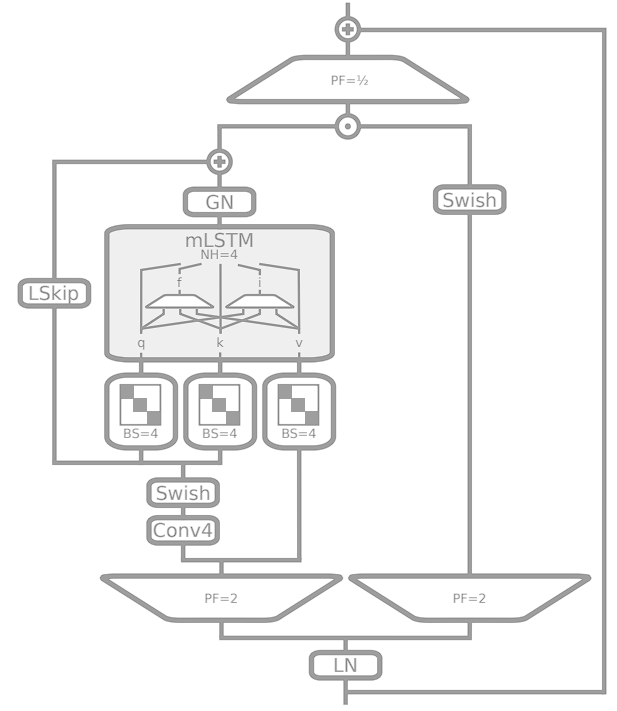
  • PF=1/2 和 PF=2:投影因子。前者将输入维度缩小一半,后者将输入维度扩大 2 倍。
  • LSkip:类似于残差连接,可以帮助梯度更好地传递,防止梯度消失和爆炸。这里相当于有两种跳线残差。
  • q,k,v:从输入中生成,用于计算注意力权重和进行信息检索。
  • BS=4:块大小为 4 的块对角投影矩阵。

整体上都是充分利用了残差堆叠结构,层归一化技术等稳定网络,通过升降维度实现空间变换,激活函数非线性变换,然后利用 LSTM 进行记忆混合,或者说时序上的选择性自力机制计算,采用多头和块对角模式实现并行处理。

与 Transformer 的对比

有了这两种基本构建模块,通过堆叠增加模型的深度,可以逐层提取更高层次的特征。最终,整个堆叠结构作为一个端到端的模型进行训练。

同时,Transformer 能干的,xLSTM 也可以干,但是 xLSTM 有更加明确的逻辑结构,有数据公式的严密推导,效率更高。

与 Transformer 不同,xLSTM 在计算复杂度与内存复杂序上随着序列长度呈再发关系。由于 xLSTM 有记忆压缩性,很适合在工业应用和边缘设备上实现。

适用的场景

  • sLSTM(无法并行化):需要高精度和复杂特征提取的任务,计算资源充足且不需要并行化的应用,对延迟敏感但不受并行化限制的场景。
  • mLSTM(可以并行化):图像识别,视频处理等需要高效并行计算的任务,计算资源有限且需要高效利用内存的应用;需要在工业环境或边缘设备上部署的任务。

小结
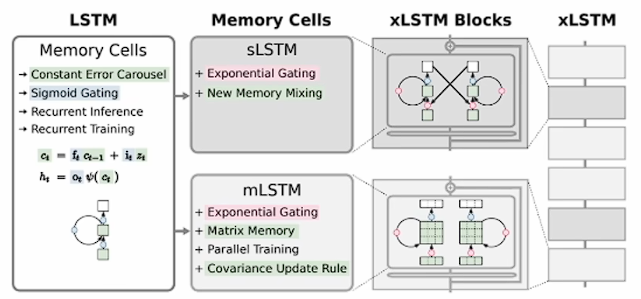
xLSTM 的原理:借助指数门控混合记忆和新内存结构,LSTM 增强为 sLSTM 和 mLSTM。二者的结合构成了 xLSTM,进一步堆叠可以实现大模型化。

xLSTM的核心思想,算法实现和代码实现,与LSTM的不同,为什么xLSTM更加适合大语言模型 xLSTM(Extended LSTM)是LSTM的扩展版本,旨在解决传统LSTM在长序列建模、梯度传播、并行计算等方面的局限性,使其更适合大规模语言模型(LLM)的需求。• LSTM的记忆单元是标量,xLSTM的mLSTM扩展为矩阵,支持并行处理(类似Transformer的KV Cache)。• xLSTM改用指数激活函数,增强门控动态性,并通过归一化(如LayerNorm)稳定训练。• xLSTM 通过指数门控、矩阵记忆和残差连接,解决了LSTM的并行性、记忆容量和梯度问题。矩阵记忆(mLSTM) 阅读详情

相关推荐

(11)时间序列预测之xLstm

引入了指数门(红色)以及归一化和稳定化其整体结构如下(未涉及稳定化)所示:对更新门和遗忘门进行稳定化处理:同时,还支持以下结构记忆混合(Memory Mixing):sLSTM允许通过循环连接(recurrent connections)进行记忆混合,这在原始的LSTM中是不可能的。这种新的记忆混合技术允许sLSTM在不同的内存单元之间共享信息。多头部结构(Multi-Head Structure):sLSTM可以具有多个头部,每个头部都有自己的记忆混合,但头部之间没有跨头的记忆混合。

m0_62113015的博客 2717

xLSTM

xLSTM——新型递归神经网络架构,旨在解决传统LSTM的局限性,并提高其在语言建模等任务中的性能。

yanhuo23的博客 6760

XLSTM+informer时间序列预测模型

XLSTM是lstm原班人马在2024年5月发布的模型,本文将xlstm和informer进行相应的结合进行时间序列的预测。源码在最后。

lxh1244607107的博客 3031

xLSTM——解析扩展长短期记忆的网络算法与应用

二十多年来,创举架构在许多深度学习突破和实际应用中发挥了重要作用。从生成自然语言到为语音识别系统提供动力,LSTM 一直是人工智能革命背后的驱动力。然而,即使是 LSTM 的创建者也认识到它们固有的局限性,导致它们无法充分发挥潜力。无法修改存储的信息、内存容量有限以及缺乏并行化等缺点为 Transformer 和其他模型的兴起铺平了道路,以超越 LSTM 来完成更复杂的语言任务。但在最近的一项进展中,Hochreiter 和他的团队引入了一个新的变体,称为解决这些长期存在的问题。

知来者逆的博客 4195

【论文阅读】xLSTM: Extended Long Short-Term Memory

论文提出了xLSTM,一种扩展的长短期记忆网络,旨在解决传统LSTM的局限性,并在大规模参数下进行语言建模。xLSTM引入了指数门控和适当的归一化与稳定技术,修改了LSTM记忆结构,包括标量记忆的sLSTM和完全可并行化的具有矩阵记忆和协方差更新规则的mLSTM。通过将这些LSTM变体集成到残差块中,构建了xLSTM架构,这些架构在性能和扩展性方面与最先进的Transformers和状态空间模型相媲美。

kanon的博客 3176

abaqus 6.13安装(ubuntu 16.04LTS)

1。从iso将文件拷贝出来 2。chmod 777 -R ./* 给文件权限 3。sudo /home/xx/A/setup 4。安装licenseserver 5。拷贝lic,log文件 6。打开license sudo ./lmgrd -c path 7. 27011@xx or 27011@localhost ...

a1099313374的博客 1950

P-sLSTM(AAAI 2025)学习笔记

本文用于记录本人学习时序序列预测,包括模型为度分析,实验复现等

404 Not Found 2178

13个GNS3 3.0.5 appliances设备模板镜像合集:IOSv/L2,IOU L2/L3,以及IOS-XE

13个GNS3 appliances设备模板:IOSv/L2,IOU L2/L3,以及IOS-XE合集

haierccc的博客 1076

深入解析xLSTM:LSTM架构的演进及PyTorch代码实现详解

xLSTM的新闻大家可能前几天都已经看过了,原作者提出更强的xLSTM,可以将LSTM扩展到数十亿参数规模,我们今天就来将其与原始的lstm进行一个详细的对比,然后再使用Pytorch实现一个简单的xLSTM。xLSTM 是对传统 LSTM 的一种扩展,它通过引入新的门控机制和记忆结构来改进 LSTM,旨在提高 LSTM 在处理大规模数据时的表现和扩展性。以下是 xLSTM 相对于原始 LSTM 的几个主要区别:总的来说,xLSTM 的设计目标是解决传统 LSTM 在处理大规模数据和长序列时面临的限制,如并

deephub 2万+

ENVI 5.3与IDL 8.5安装指南:从下载到激活的完整流程

本文提供了一份详细的ENVI 5.3与IDL 8.5安装教程,涵盖从获取安装包、运行主程序、安装许可证到关键文件替换的完整流程。指南重点解决了激活过程中的常见问题,并分享了个人实践经验,旨在帮助用户,特别是遥感图像处理初学者,一次性顺利完成软件部署,为后续的科研与开发工作奠定基础。

weixin_29213827的博客 549

Unity 2022.3.3 LTS + Visual Studio 2022:手把手教你复刻《吸血鬼幸存者》核心战斗(附完整项目源码)

本文详细介绍了如何使用Unity 2022.3.3 LTS和Visual Studio 2022从零构建《吸血鬼幸存者》式战斗系统。通过图文开发教程,涵盖对象池优化、ECS架构雏形、2D物理碰撞控制等关键技术,帮助开发者高效复刻这款热门游戏的自动攻击与海量刷怪机制。

weixin_30721077的博客 459

XLSTM+transformer时间序列预测代码

xlstm+transformer时间序列预测代码_哔哩哔哩_bilibili。

lxh1244607107的博客 2305

DDR4内存PCB设计实战:8层板Fly-by拓扑信号完整性优化

本文深入探讨了DDR4内存条在8层PCB板上采用Fly-by拓扑时的信号完整性优化实战。文章详细解析了层叠规划、阻抗控制、电源分割、等长布线及串扰抑制等关键设计要点,并强调了仿真验证的重要性,为硬件工程师提供了从理论到实践的完整设计指南与自查清单。

weixin_29296241的博客 340

xLSTM: Extended Long Short-Term Memory

图8在展示了不同语言模型在不同模型大小下的验证集困惑度(Perplexity)与参数数量的关系,这是对模型缩放行为(Scaling Laws)的分析。图中比较了几种xLSTM变体,包括只有sLSTM的架构(xLSTM[0:1]),只有mLSTM的架构(xLSTM[1:0]),以及两者结合的架构(xLSTM[1:1])。表3展示了不同语言模型在SlimPajama数据集上的性能比较,特别是在不同模型大小下的验证集困惑度(Perplexity)和下游任务(Downstream Tasks)的性能。

北风吹过的秋 2530

[xboard-real6410]39 real6410中的BL1和BL2实验及流程分析

文章目录uboot控制uboot 流程uboot加载kernel uboot控制 uboot 流程 uboot加载kernel

鹰之翔 298

Unreal Engine开发:多人联机与网络同步_延迟补偿与预测

通过延迟补偿和预测技术,我们可以显著减少网络延迟对多人在线动作游戏的影响,提升玩家的体验。延迟补偿主要在服务器端实现,通过回溯时间点来更准确地处理输入和事件。预测技术主要在客户端实现,通过预先计算玩家的动作结果来减少延迟感。结合这两种技术,可以实现更平滑、更公平的多人游戏体验。

chenlz2007的博客 1191

xLSTM-----含完整代码

xLSTM是近期比较热门的模型,其是基于LSTM的改进模型,主要改进点体现在指数门控、记忆结构、并行化能力以及残差堆叠架构上。主要阵地在公众号,会优先更新公众号,欢迎通过下面二维码扫码关注。

wdid945的博客 8230

Open3D 可视化(1)——简单可视化【2026最新版】

简单可视化,博客长期更新,本文最新更新时间为:2026年5月10日。

点云侠的博客 5687

使用xlstm预测股票

✨ 前言 ✨ 💥本专栏旨在为初学者和希望深化理解的技术从业人员提供一个系统的深度学习知识平台。深度学习是机器学习的重要分支,近年来在计算机视觉、自然语言处理、语音识别等领域取得了显著成就。通过本专栏,读者将能够掌握深度学习的基本概念、算法、技术及其应用。💥 💥项目环境:💥 python: 3.8.18 torch 2.0.1 torchvision 0.15.2 torchviz

m0_70299075的博客 2043

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

xLSTM —— LSTM 焕发新生的创新之作(附代码)

xLSTM 是对传统 LSTM 模型的一个重要扩展,结合了指数门控、矩阵记忆和残差堆叠架构,使得其在长序列建模方面具有显著的优势。xLSTM 的出现,不仅让 LSTM 在与 Transformer 等模型的竞争中焕发新生,也为未来的 AI 应用提供了新的思路。随着模型规模的进一步扩展,xLSTM 有望在自然语言处理、时间序列分析等领域发挥更大的作用,为深度学习技术的进步贡献力量。

爱猫的小学森 3997

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

xLSTMTime : 基于 xLSTM 的长期时间序列预测

近年来,基于变换器的模型在多变量长期时间序列预测(LTSF)中获得了显著关注,尽管面临高计算需求、捕捉时间动态的困难以及管理长期依赖关系等挑战,但仍显示出显著进展。LTSF-Linear 的出现,以其简单的线性架构,显著优于基于变换器的模型,促使人们重新评估变换器在时间序列预测中的实用性。对此,本文提出了一种近期架构的改编,称为扩展 LSTM(xLSTM),用于 LTSF。xLSTM 结合了指数门控和具有更高容量的修订内存结构,具有良好的 LTSF 潜力。

数智笔记 1966

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

xLSTM技术介绍

各位朋友大家好呀,欢迎大家来到每日前沿技术分享专栏,每日进步一点点,积跬步,才能致千里。见证从量变到质变的成长。今天要分享的是xLSTM技术,看看它到底是怎么让LSTM重获新生的。LSTM自 20 世纪 90 年代诞生以来,就凭借其处理序列数据的强大能力,然而,随着时代的发展和技术的进步,数据量如同滚雪球一般越来越大,任务也越来越复杂。在这样的大环境下,传统的 LSTM 模型也开始有些力不从心了。它在处理长序列和大规模数据场景时,无论是处理能力还是效率方面,都出现了一些局限性。这时候,

古月居 1981

xLSTM-Mixer: 混合多变量时间序列预测

本文提出了一种名为xLSTM-Mixer的新型多变量时间序列预测模型,该模型结合了线性预测和xLSTM模块,通过时间、联合和视图混合来捕捉复杂的时间依赖关系和变量间关系。

m0_59235699的博客 2019

如何使用——XLSTM+transformer新模型序列时间序列预测 XLSTM结合transformer进行特征提取 用slstm或mlstm提取融合?单/多变量输入,适合功率预测,风电光伏预测等

如何使用——XLSTM+transformer新模型序列时间序列预测 XLSTM结合transformer进行特征提取 用slstm或mlstm提取融合?单/多变量输入,适合功率预测,风电光伏预测等

2401_88440984的博客 1788

xLSTM项目常见问题解决方案

xLSTM是一个基于扩展长短期记忆(LSTM)网络架构的深度学习项目。该项目旨在通过引入指数门控、适当的归一化和稳定化技术以及新的矩阵记忆,克服传统LSTM的局限性,并在语言建模任务中展现出优于Transformer或状态空间模型的性能。xLSTM项目的主要编程语言是Python,依赖于PyTorch深度学习框架。 #### 2. 新手在使用xLSTM项目时需要特别注意的3个问题及详细解决步骤 ...

gitblog_01205的博客 1176
上一篇: Mamba模型学习笔记
下一篇: 论文阅读:OpenSTL: A Comprehensive Benchmark of Spatio-Temporal Predictive Learning
ghost_him
博客等级 码龄6年 598粉丝 90原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值