


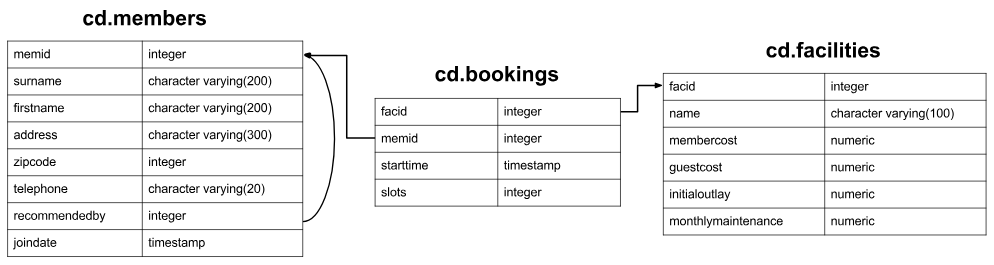
⭐️⭐️⭐️⭐️⭐️
完整数据详见 练习数据·免费
⭐️⭐️⭐️⭐️⭐️
三十、统计设施数量
题目
这是我们第一次接触聚合函数,先从简单的开始。我们想知道一共有多少个设施——只需要算出总数就行。
预期结果
| count |
|---|
| 9 |
【答案与解析】
select count(*) from cd.facilities;
聚合函数的用法其实挺直观的!上面的 SQL 语句从 facilities 表中查询所有数据,然后统计结果集中的行数。count 函数有几种常见的用法:
- COUNT(*) 直接返回行数
- COUNT(address) 统计结果集中 address 字段非空的记录数
- COUNT(DISTINCT address) 统计 facilities 表中有多少个不同的地址
聚合函数的基本原理是:它接收一列数据,对这些数据进行某种计算,最后输出一个标量值(也就是单个值)。除了 COUNT,还有很多其他聚合函数,比如 MAX、MIN、SUM、AVG 等。看名字大概就能猜到它们是干啥的 😃
很多人对聚合函数感到困惑的地方在于类似下面的查询:
select facid, count(*) from cd.facilities
你试试运行这条语句,会发现它报错了。这是因为 count(*) 想把整个 facilities 表聚合成一个值,但问题是表里有很多不同的 facid,Postgres 不知道该把 count 的结果跟哪个 facid 配对。
那如果你想查出每个 facid 以及对应的计数,该怎么办呢?可以把聚合部分写成子查询,像这样:
select facid,
	(select count(*) from cd.facilities)
	from cd.facilities
当子查询返回的是一个标量值时,Postgres 会自动把这个值重复填充到 cd.facilities 表的每一行中。
三十一、统计高价设施数量
题目
统计对客人收费在 10 及以上的设施数量。
预期结果
| count |
|---|
| 6 |
【答案与解析】
select count(*) from cd.facilities where guestcost >= 10;
这道题只是在前一题的基础上做了点小改动:我们需要把便宜的设施过滤掉。用 WHERE 子句就能轻松搞定。这样一来,聚合函数就只会看到那些收费较高的设施了。
三十二、统计每个会员的推荐人数
题目
统计每个会员推荐了多少人。按会员 ID 排序。
预期结果
| recommendedby | count |
|---|---|
| 1 | 5 |
| 2 | 3 |
| 3 | 1 |
| 4 | 2 |
| 5 | 1 |
| 6 | 1 |
| 9 | 2 |
| 11 | 1 |
| 13 | 2 |
| 15 | 1 |
| 16 | 1 |
| 20 | 1 |
| 30 | 1 |
【答案与解析】
select recommendedby, count(*)
	from cd.members
	where recommendedby is not null
	group by recommendedby
order by recommendedby;
之前我们见过,聚合函数是作用在一列数据上,然后把它们聚合成一个标量值。这很有用,但我们经常会发现,自己想要的不是单个聚合结果:比如说,我可能不想知道俱乐部这个月总共赚了多少钱,而是想知道每个设施分别赚了多少钱,或者哪些时间段最赚钱。
为了支持这种需求,SQL 提供了 GROUP BY 子句。它的作用是把数据分成若干组,然后对每组分别运行聚合函数。当你指定了 GROUP BY,数据库会为指定列中的每个不同值生成一个聚合结果。在这个例子里,我们的意思是"对于 recommendedby 的每个不同值,统计它出现了多少次"。
三十三、列出每个设施的总预订时段数
题目
列出每个设施的总预订时段数。目前只需要生成一个包含设施 ID 和时段数的输出表,按设施 ID 排序。
预期结果
| facid | Total Slots |
|---|---|
| 0 | 1320 |
| 1 | 1278 |
| 2 | 1209 |
| 3 | 830 |
| 4 | 1404 |
| 5 | 228 |
| 6 | 1104 |
| 7 | 908 |
| 8 | 911 |
【答案与解析】
select facid, sum(slots) as "Total Slots"
	from cd.bookings
	group by facid
order by facid;
除了引入了 SUM 聚合函数之外,这道题没什么特别需要说明的。对于每个不同的设施 ID,SUM 函数会把 slots 列中的所有值加起来。
三十四、列出指定月份每个设施的总预订时段数
题目
列出 2012 年 9 月每个设施的总预订时段数。生成一个包含设施 ID 和时段数的输出表,按时段数排序。
预期结果
| facid | Total Slots |
|---|---|
| 5 | 122 |
| 3 | 422 |
| 7 | 426 |
| 8 | 471 |
| 6 | 540 |
| 2 | 570 |
| 1 | 588 |
| 0 | 591 |
| 4 | 648 |
【答案与解析】
select facid, sum(slots) as "Total Slots"
	from cd.bookings
	where
		starttime >= '2012-09-01'
		and starttime < '2012-10-01'
	group by facid
order by sum(slots);
这道题只是在前一题的基础上做了点小改动。记住,聚合是在 WHERE 子句执行之后才进行的:所以我们用 WHERE 来限制要聚合的数据范围,这样聚合函数就只会看到一个月的数据了。
三十五、列出每个月每个设施的总预订时段数
题目
列出 2012 年每个月每个设施的总预订时段数。生成一个包含设施 ID、月份和时段数的输出表,按设施 ID 和月份排序。
预期结果
| facid | month | Total Slots |
|---|---|---|
| 0 | 7 | 270 |
| 0 | 8 | 459 |
| 0 | 9 | 591 |
| 1 | 7 | 207 |
| 1 | 8 | 483 |
| 1 | 9 | 588 |
| 2 | 7 | 180 |
| 2 | 8 | 459 |
| 2 | 9 | 570 |
| 3 | 7 | 104 |
| 3 | 8 | 304 |
| 3 | 9 | 422 |
| 4 | 7 | 264 |
| 4 | 8 | 492 |
| 4 | 9 | 648 |
| 5 | 7 | 24 |
| 5 | 8 | 82 |
| 5 | 9 | 122 |
| 6 | 7 | 164 |
| 6 | 8 | 400 |
| 6 | 9 | 540 |
| 7 | 7 | 156 |
| 7 | 8 | 326 |
| 7 | 9 | 426 |
| 8 | 7 | 117 |
| 8 | 8 | 322 |
| 8 | 9 | 471 |
【答案与解析】
select facid, extract(month from starttime) as month, sum(slots) as "Total Slots"
	from cd.bookings
	where extract(year from starttime) = 2012
	group by facid, month
order by facid, month;
这道题新引入的主要功能是 EXTRACT 函数。EXTRACT 可以从时间戳中提取出各个组成部分,比如日、月、年等。我们按照这个函数的输出进行分组,就能得到每月的统计值。如果需要区分不同年份的相同月份,可以使用 DATE_TRUNC 函数,它能把日期截断到指定的粒度。另外值得一提的是,这是我们第一次真正用到按多列分组的功能。
关于这个答案,有一点需要注意:在 WHERE 子句中使用 EXTRACT 函数可能会在大表上导致严重的性能问题。如果 timestamp 列上有普通索引,Postgres 无法利用索引来加速查询,只能全表扫描。你有以下几种解决方案:
- 考虑在 timestamp 列上创建表达式索引。有了合适的索引,Postgres 就能用索引来加速包含函数调用的 WHERE 子句。
- 修改查询,虽然写得稍微啰嗦一点,但使用更标准的比较方式,例如:
select facid, extract(month from starttime) as month, sum(slots) as "Total Slots"
	from cd.bookings
	where
		starttime >= '2012-01-01'
		and starttime < '2013-01-01'
	group by facid, month
order by facid, month;
对于这种标准比较,Postgres 无需额外帮助就能使用索引。
三十六、统计至少预订过一次的会员数量
题目
统计至少预订过一次的会员(包括访客)总数。
预期结果
| count |
|---|
| 30 |
【答案与解析】
select count(distinct memid) from cd.bookings
你第一反应可能是用子查询,像这样:
select count(*) from
	(select distinct memid from cd.bookings) as mems
这样确实能正常工作,但我们可以借助 COUNT DISTINCT 稍微简化一下。它的作用正如你所料,统计指定列中不同值的数量。
三十七、列出预订时段超过 1000 的设施
题目
列出预订时段总数超过 1000 的设施。生成一个包含设施 ID 和时段数的输出表,按设施 ID 排序。
预期结果
| facid | Total Slots |
|---|---|
| 0 | 1320 |
| 1 | 1278 |
| 2 | 1209 |
| 4 | 1404 |
| 6 | 1104 |
【答案与解析】
select facid, sum(slots) as "Total Slots"
        from cd.bookings
        group by facid
        having sum(slots) > 1000
        order by facid
原来 SQL 中有一个专门用来过滤聚合函数输出的关键字,这就是 HAVING。
HAVING 的行为很容易和 WHERE 混淆。最好的理解方式是:在包含聚合函数的查询中,WHERE 用来过滤进入聚合函数的数据,而 HAVING 用来过滤聚合函数输出的数据。你可以多试试,体会一下它们的区别!
三十八、计算每个设施的总收入
题目
列出每个设施及其总收入。输出表应包含设施名称和收入,按收入排序。记住,访客和会员的收费是不一样的!
预期结果
| name | revenue |
|---|---|
| Table Tennis | 180 |
| Snooker Table | 240 |
| Pool Table | 270 |
| Badminton Court | 1906.5 |
| Squash Court | 13468.0 |
| Tennis Court 1 | 13860 |
| Tennis Court 2 | 14310 |
| Massage Room 2 | 15810 |
| Massage Room 1 | 72540 |
【答案与解析】
select facs.name, sum(slots * case
			when memid = 0 then facs.guestcost
			else facs.membercost
		end) as revenue
	from cd.bookings bks
	inner join cd.facilities facs
		on bks.facid = facs.facid
	group by facs.name
order by revenue;
这道题唯一的复杂之处在于访客(会员 ID 为 0)的收费和其他人不一样。我们用 case 语句来计算每次预订的费用,然后按设施分组,把每次预订的费用加起来。
三十九、找出总收入低于 1000 的设施
题目
列出总收入低于 1000 的设施。输出表应包含设施名称和收入,按收入排序。记住,访客和会员的收费是不一样的!
预期结果
| name | revenue |
|---|---|
| Table Tennis | 180 |
| Snooker Table | 240 |
| Pool Table | 270 |
【答案与解析】
select name, revenue from (
	select facs.name, sum(case
				when memid = 0 then slots * facs.guestcost
				else slots * membercost
			end) as revenue
		from cd.bookings bks
		inner join cd.facilities facs
			on bks.facid = facs.facid
		group by facs.name
	) as agg where revenue < 1000
order by revenue;
你可能尝试过用我们在前面练习中介绍的 HAVING 关键字,写出类似下面的查询:
select facs.name, sum(case
		when memid = 0 then slots * facs.guestcost
		else slots * membercost
	end) as revenue
	from cd.bookings bks
	inner join cd.facilities facs
		on bks.facid = facs.facid
	group by facs.name
	having revenue < 1000
order by revenue;
可惜这样行不通!你会收到类似这样的错误:ERROR: column “revenue” does not exist。和 SQL Server、MySQL 等其他关系型数据库不同,Postgres 不支持在 HAVING 子句中使用列别名。所以要让这个查询正常工作,你得写成下面这样:
select facs.name, sum(case
		when memid = 0 then slots * facs.guestcost
		else slots * membercost
	end) as revenue
	from cd.bookings bks
	inner join cd.facilities facs
		on bks.facid = facs.facid
	group by facs.name
	having sum(case
		when memid = 0 then slots * facs.guestcost
		else slots * membercost
	end) < 1000
order by revenue;
像这样重复大量的计算代码显得很 messy,所以我们推荐的解决方案是把主查询体包装成子查询,然后用 WHERE 子句从中筛选。一般来说,对于简单的查询,我建议用 HAVING,因为它更清晰。而对于复杂的情况,这种子查询的方式往往更好用。
四十、输出预订时段数最多的设施 ID
题目
输出预订时段数最多的设施 ID。如果要挑战一下,试着写一个不用 LIMIT 子句的版本。这个版本可能会看起来很复杂!
预期结果
| facid | Total Slots |
|---|---|
| 4 | 1404 |
【答案与解析】
select facid, sum(slots) as "Total Slots"
	from cd.bookings
	group by facid
order by sum(slots) desc
LIMIT 1;
我们先从最简单的方法开始:生成一个包含设施 ID 和总预订时段数的列表,按总时段数降序排序,然后只取第一条结果。
不过需要注意的是,这种方法有个明显的缺陷:如果出现平局(多个设施的时段数相同),我们仍然只能得到一个结果!要想得到所有符合条件的结果,我们可以尝试用 MAX 聚合函数,像这样:
select facid, max(totalslots) from (
	select facid, sum(slots) as totalslots
		from cd.bookings
		group by facid
	) as sub group by facid
这个查询的意图是获取最高的 totalslots 值及其对应的 facid。可惜这样行不通!如果有多个 facid 的时段数相同,Postgres 就无法确定应该把哪个 facid 和 MAX 函数输出的单个(标量)值配对。所以 Postgres 会提示你 facid 应该放在 GROUP BY 子句中,但这不会产生我们想要的结果。
让我们先尝试写一个能正常工作的查询:
select facid, sum(slots) as totalslots
	from cd.bookings
	group by facid
	having sum(slots) = (select max(sum2.totalslots) from
		(select sum(slots) as totalslots
		from cd.bookings
		group by facid
		) as sum2);
这个查询先生成设施 ID 和对应的时段数列表,然后用 HAVING 子句计算出最大的 totalslots 值。我们的逻辑基本上是:“生成 facid 及其预订时段数的列表,然后过滤掉那些时段数不等于最大值的结果。”
虽然 HAVING 很有用,但我们的查询写得有点丑。为了改进它,我们再引入一个新概念:公用表表达式(CTE)。CTE 可以让你在查询中内联定义一个数据库视图。在像这种需要重复代码的场景中,它特别有用。
CTE 的声明形式是 WITH CTE名称 as (SQL表达式)。你可以看到我们用 CTE 重写了上面的查询:
with sum as (select facid, sum(slots) as totalslots
	from cd.bookings
	group by facid
)
select facid, totalslots
	from sum
	where totalslots = (select max(totalslots) from sum);
可以看到,我们把重复的 cd.bookings 查询提取到了一个 CTE 中,让整个查询变得更易读了!
等等,还没完。其实还可以用窗口函数来解决这个问题。我们后面再讲窗口函数,但对于这类问题,确实有更好的解决方案。
一道练习题讲了这么多内容。如果现在不能完全理解也不用太担心——我们会在后面的练习中继续用到这些概念。

 2495


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


