集成方法 Bagging原理

1.Bagging方法思路

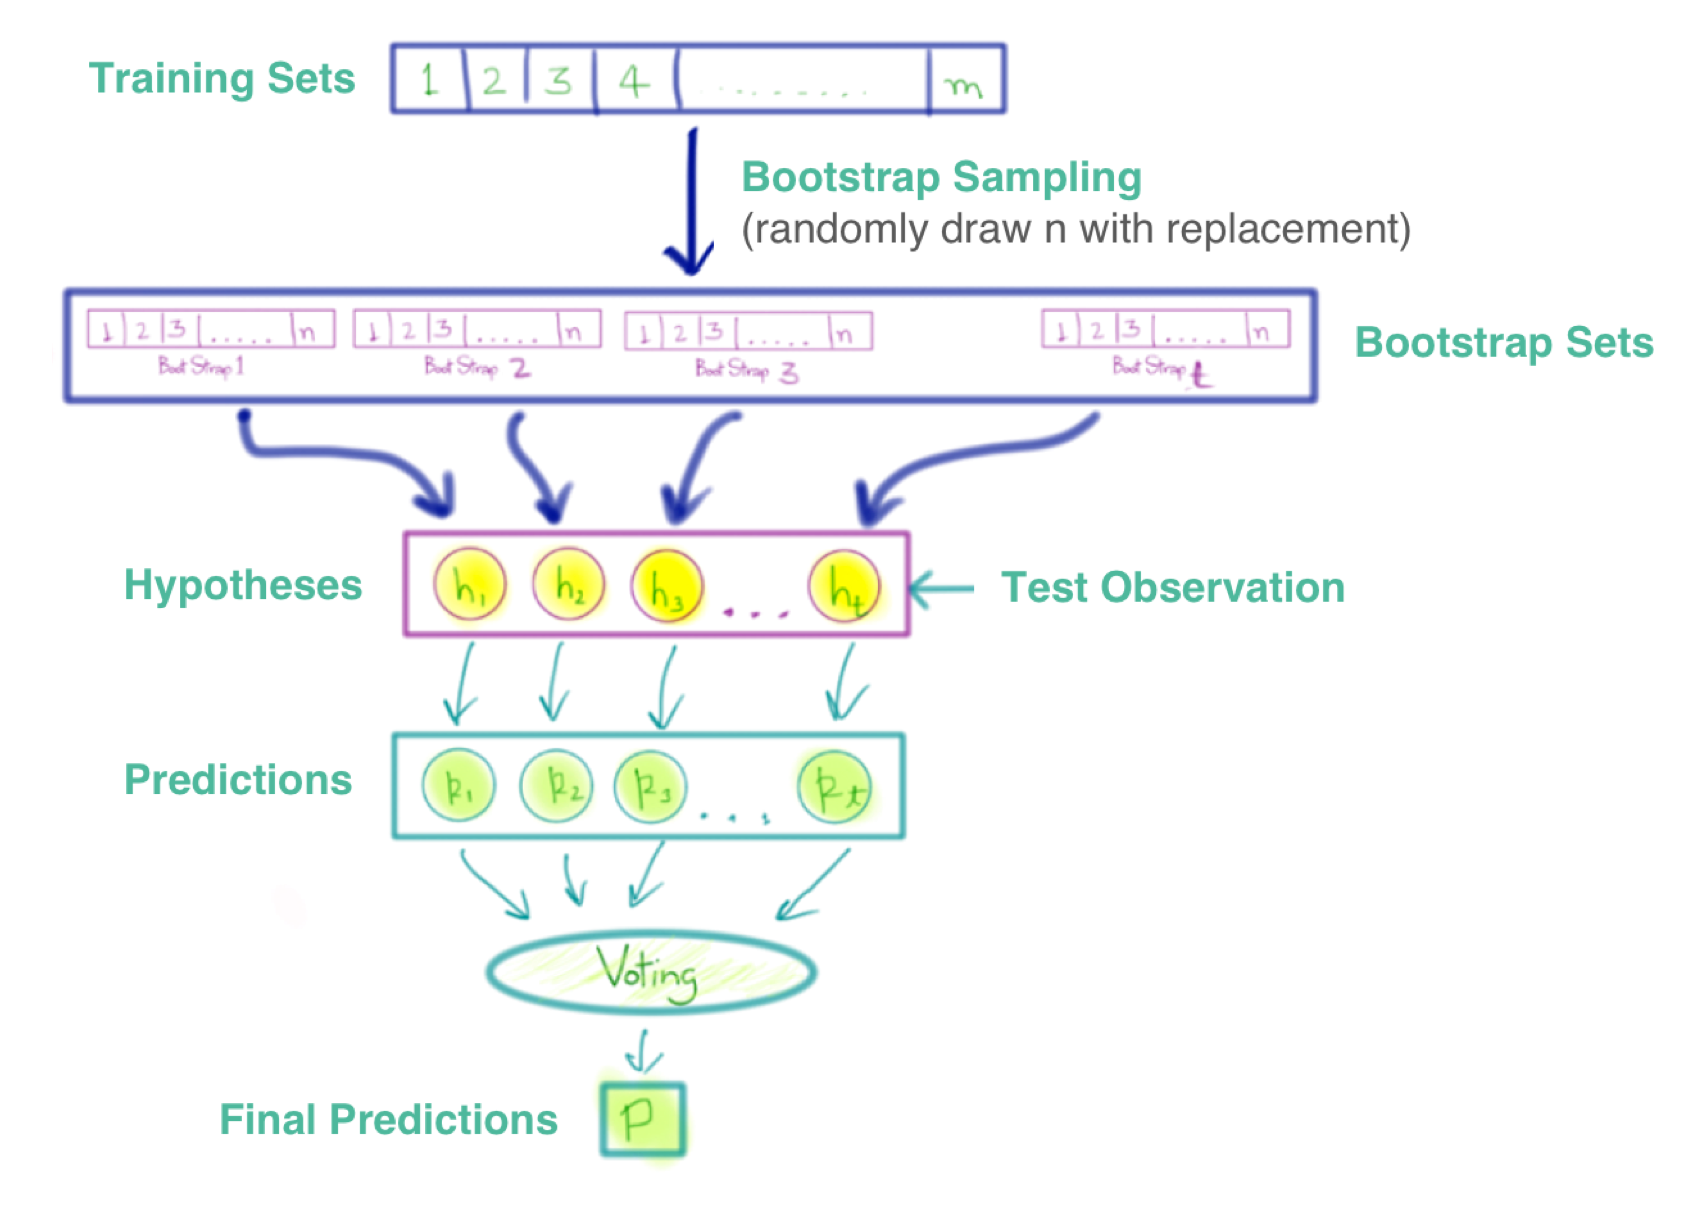
Bagging独立的、并行的生成多个基本分类器,然后通过投票方式决定分类的类别

Bagging使用了自助法确定每个基本分类器的训练数据集,初始样本集中63.2%的数据会被采样到

从Training Sets中每次取1个,放回,再取1个,放回,重复直到取到n个组成Boot Strap1

同理生成 Boot Strap2、Boot Strap3、……、Boot Strap t,组成Bootstrap Sets,Bootstrap Sets中的数据占Training Sets的63.2%

然后由这些Boot Strap生成不同的基本分类器h1、h2、……、ht

使用这些基本分类器对剩余36.8%的数据预测,然后投票决定分类结果
 

Bagging方法常用的算法是Random Forest

2.Random Forest算法

随机森林 = Bagging + 完全生长的CART决策树

算法思想

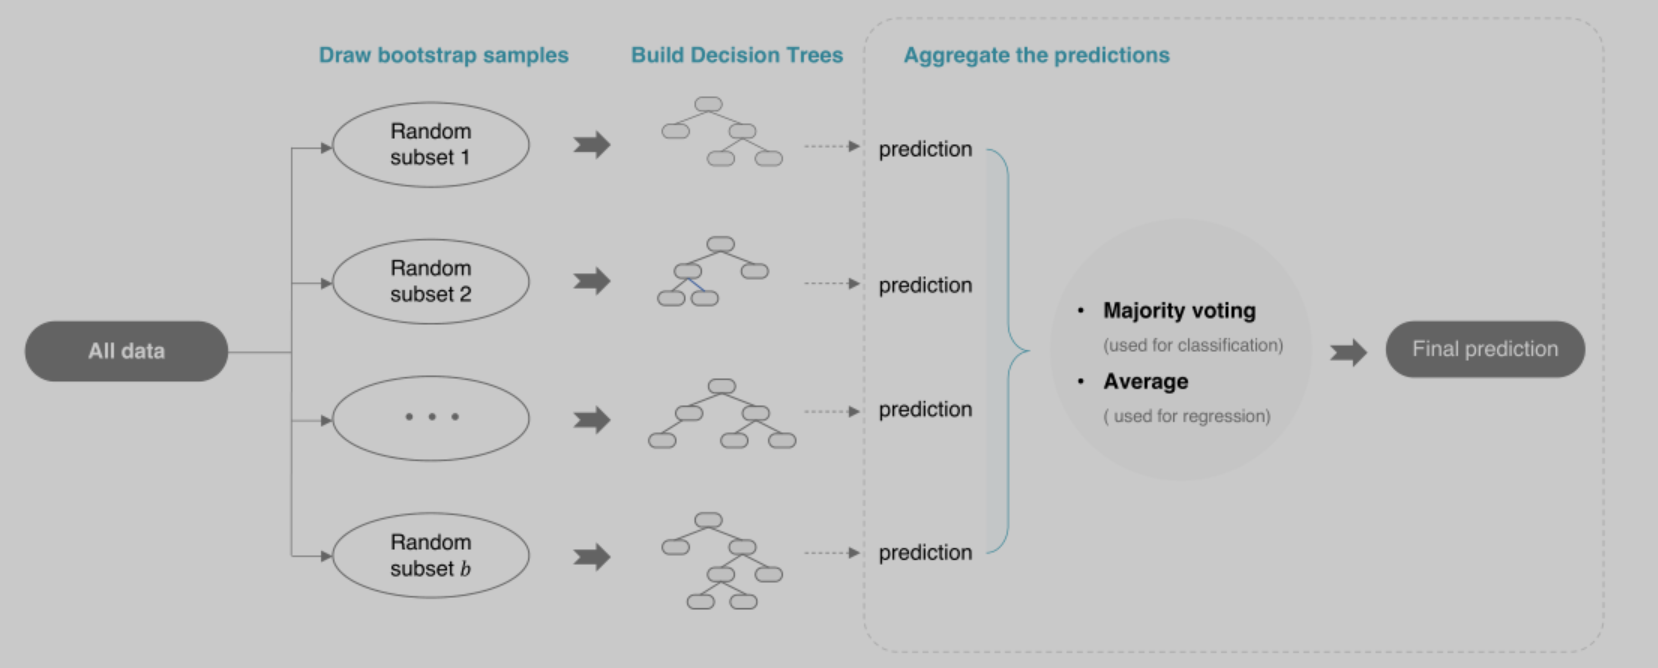
1)使用自助法进行采样,生成n个训练集

2)利用n个训练集,训练n个决策树,决策树不进行剪枝

  • 从d个属性中随机选择k个属性
  • 从k个属性里选出最优特征,生成二叉树

参数k控制了随机性的引入程度: 若令k=d,则决策树的构建与传统决策树相同;若令k=1,则是随机选择一个属性用于划分;一般情况下,推荐值$k=log_2d$

3)n个决策树分别进行预测,然后投票决定最终结果
 

3.Random Forest的优点

1)RF很少过拟合

2)RF中的决策树是平行生成的,速度快

3)RF对异常值不敏感,能处理缺失数据,并且不会丢失精度

4)RF在分类问题有很高的精度

4.Random Forest的缺点

1)集成大量的决策树可以提高RF的性能,但是会使算法变慢

2)RF在回归问题表现不好

它并不能给出一个连续的输出。当进行回归时,RF不能够做出超越训练集数据范围的预测,这可能导致在某些特定噪声的数据进行建模时出现过度拟合。(PS:随机森林已经被证明在某些噪音较大的分类或者回归问题上会过拟合)


转载于:https://www.cnblogs.com/vshen999/p/10299145.html

机器学习笔记(五)Bagging集成学习算法随机森林原理和实践 一、前言 在前一篇文章《决策树原理和实践》中,我们介绍了决策树的相关原理和使用API,决策树在建模过程中需要剪枝等操作,而如果数据预处理不当或者剪枝不合理,又会造成过拟合等结果,或者建立的模型只在某个方面表现比较好。此时,我们会考虑建立单棵树模型可能会存在走上“歧途”的现象,那么是不是可以通过建立多棵树模型一起来判断结果呢?答案当然是可以的,具体怎么建立呢?如果使用相同的数据集和算法,那么建立的模型结果大概率也是相同的,就失去了意义。接下来的几篇文章我们将介绍集成学习算法(Ensemble learnin 阅读详情

相关推荐

Bagging集成方法原理与实战:降低模型方差的自助聚合技术

Bagging(自助聚合)是一种基础而强大的集成学习方法,核心在于通过Bootstrap有放回抽样构建多个独立子模型,并以投票或平均方式聚合预测结果,从而显著降低高方差模型(如决策树、KNN)的泛化波动。其本质是利用统计冗余抑制过拟合,不改变基模型偏差,专精于提升稳定性与鲁棒性。技术价值体现在天然并行、无需验证集(OOB评估)、对噪声和小样本友好,且易于解释特征重要性。广泛应用于销量预测、房价回归、风控评分等对结果稳定性要求高的工程场景。本文深入剖析Bagging的数学原理、Scikit-learn实现要点

weixin_33437929的博客 228

机器学习(中)-bagging套袋法原理+思路+案例

一、bagging套袋法的原理分析 Bagging(套袋法)的核心在于自助采样(bootstrap)/随机采样这一概念,即从数据集中进行有放回采样,也就是说,同样的一个样本可能被多次进行采样。 举例说明: 估计全国所有人口年龄的平均值:可在全国所有人口中随机抽取不同的集合(这些集合可能存在交集),计算每个集合的平均值,然后将所有平均值的均值作为估计值。 Bagging的基本流程: 首先随机取出一个样本放入采样集合中,再把这个样本放回初始数据集,重复K次采样,最终可获得一个大小为K的样本集合。 同样的方法,也

qq_45396577的博客 5726

Bagging集成方法原理与实战:降低模型方差的稳定之道

集成学习(Ensemble Methods)是一类通过组合多个基模型提升整体性能的核心技术,其核心目标是平衡偏差与方差。Bagging(Bootstrap Aggregating)作为最经典的集成范式,专精于降低高方差模型(如决策树)的泛化波动,而非改善偏差。它基于有放回抽样(Bootstrap)构建多样性训练子集,再通过投票(分类)或平均(回归)聚合预测,天然具备袋外(OOB)自评估能力,显著提升鲁棒性与稳定性。该方法广泛应用于风控建模、信用评分、反欺诈等对结果一致性要求严苛的工业场景,也是理解随机森林与

weixin_29159613的博客 329

集成学习:Bagging

装袋是一种有效的集成学习策略,通过对样本的随机抽样和独立训练多个基学习器,它能够有效降低过拟合和增加模型的泛化能力。随机森林作为装袋的一种典型应用,已经成为许多机器学习任务中的标准算法。通过理解和应用装袋方法,数据科学家和工程师能够构建更为强大的预测模型。

Wei_sx的博客 1599

8.5 集成学习方法:Bagging、Boosting、Stacking原理与实现

本文系统介绍了三种主流集成学习方法:Bagging、Boosting和Stacking。Bagging通过自助采样构建多样性模型并行集成,有效降低方差,以随机森林为代表;Boosting通过序贯调整样本权重逐步修正偏差,包括AdaBoost和梯度提升树;Stacking则通过元学习器组合基学习器的预测结果。三种方法各具特点,Bagging降低方差,Boosting减少偏差,Stacking学习最优组合策略,共同提升了模型的泛化性能。集成学习已成为机器学习工具箱中的核心组件。

技术工作者 720

Bagging原理与工程实践:降低模型方差的稳定集成方法

Bagging(自助聚合)是一种基础而强大的集成学习技术,核心在于通过Bootstrap重采样构建多个独立基模型,并以平均或投票方式融合预测结果,从而系统性降低高方差模型(如决策树、KNN)的预测波动性。其原理根植于统计学中的方差分解理论:当各子模型误差不相关时,集成后的期望方差可降至单模型的1/n。相比Stacking或加权融合,Bagging以零额外超参、强鲁棒性和线性推理开销,成为生产环境中模型稳定性加固的首选方案。广泛应用于金融风控、设备故障预警、CTR预估等对预测一致性要求严苛的工业场景。

weixin_29170327的博客 280

集成学习——bagging原理及分析

bagging原理   与投票法不同的是,Bagging不仅仅集成模型最后的预测结果,同时采用一定策略来影响基模型训练,保证基模型可以服从一定的假设。在上一章中我们提到,希望各个模型之间具有较大的差异性,而在实际操作中的模型却往往是同质的,因此一个简单的思路是通过不同的采样增加模型的差异性。   Bagging的核心在于自助采样(bootstrap)这一概念,即有放回的从数据集中进行采样,也就是说,同样的一个样本可能被多次进行采样。一个自助采样的小例子是我们希望估计全国所有人口年龄的平均值,那么我们可以在全

面包猎人 1727

集成学习方法解析:Bagging与Boosting原理与实践

集成学习(Ensemble Learning)是机器学习中提升模型性能的核心技术,通过组合多个基学习器实现更优的预测效果。其核心原理包括降低方差(如Bagging方法)、减小偏差(如Boosting方法)以及扩展假设空间。在工程实践中,随机森林(Random Forest)作为Bagging的典型代表,通过特征随机性进一步提升模型鲁棒性;而XGBoost等Boosting算法则采用错题本式的渐进优化策略。这些技术在结构化数据处理、高维特征建模等场景展现显著优势,成为Kaggle竞赛和工业级应用的标配解决方案

weixin_36213081的博客 331

数据变换增强Bagging集成方法:原理与实践

集成学习通过组合多个基模型提升预测稳定性,其中Bagging作为经典方法依赖数据扰动生成多样性。传统Bagging面临数据偏差继承和特征空间扰动不足的挑战,而引入数据变换技术(如PCA降维、分位数变换等)能有效增强模型差异性。这种改进方法在金融风控、工业预测等场景中表现优异,通过特征空间的系统性变换(线性/非线性/混合变换)打破数据固有模式,提升模型对复杂关系和分布偏移的适应能力。实践表明,结合数据变换的Bagging集成可使模型稳定性提升40%,特别适合处理高维特征和非线性关系显著的数据场景。关键技术涉及

weixin_42531579的博客 306

Bagging算法

集成学习有两个流派,一个是boosting派系,它的特点是各个弱学习器之间有依赖关系。另一种是bagging流派,它的特点是各个弱学习器之间没有依赖关系,可以并行拟合。 Bagging算法(英语:Bootstrap aggregating,引导聚集算法),又称装袋算法,是机器学习领域的一种团体学习算法。最初由Leo Breiman于1996年提出。Bagging算法可与其他分类、回归算法结合,提高...

qq_41870157的博客 2万+

bagging算法

Bagging的策略: 从样本集中用Bootstrap采样选出n个样本 在所有属性上 对这n个样本建立分类器(CART or SVM or ) 重复以上两步m次 i e build m个分类器(CART or SVM or ) 将数据放在这m个分类器上跑 最后vote看到底分到哪一类

【机器学习之集成学习算法-01】| 基于重抽样自举法的集成学习方法:Bagging袋装法和Random Forests随机森林算法原理及PM2.5浓度回归预测实例分析

集成学习是一种机器学习技术,其核心思想是通过结合多个基本模型的预测结果来提高整体性能。常见的集成学习方法包括bagging、boosting和stacking。

一伦明悦的博客 2556

定时器(PWM输出)触发ADC采样(DMA)——STM32CubeMX

已知 Tclk 为 84MHz , 我们需要 Tout 为 200ms 即 200000us , 不妨先让PSC为 839, 带入上述公式可得 ARR = 19999. 这样算出来之后ARR和PSC都在0~65535的范围, 则可以使用这组参数。例如,如果时钟频率为1MHz,并且PSC设置为1000,则实际的定时频率将为1kHz。当重装载值(Period 或 ARR)设置为 500 时,意味着定时器需要计数 500 个时钟周期才会触发中断。例如,如果时钟频率为1MHz,则Tclk为1微秒。

2301_77123899的博客 1万+

数据变换增强的Bagging集成方法:原理与实践

集成学习通过组合多个基学习器提升模型性能,其中Bagging通过自助采样创造数据多样性降低方差。但在处理复杂特征关系时,传统Bagging的样本扰动存在局限。本文提出在特征空间引入数据变换多样性,为每个基学习器配置不同的预处理流程(如PCA降维、多项式扩展等),通过特征工程与模型集成的协同作用提升预测效果。该方法在金融风控等高维结构化数据场景表现突出,实验显示较常规Bagging提升15-23%准确率。关键技术实现涉及sklearn Pipeline构建、动态样本分配和内存优化,适用于存在多重共线性或非线性

weixin_29867767的博客 157

LaMAR数据集下载和使用流程

LaMAR数据集

qq_51745206的博客 976

社交导航中的未来感知框架NavThinker解析

社交导航是机器人技术中的关键挑战,要求机器人在动态人类环境中安全移动并遵守社会规范。传统方法存在短视问题,仅基于当前观测做出反应,忽视了动作与行人运动间的双向耦合关系。NavThinker框架创新性地引入未来感知概念,通过动作条件世界模型主动预测场景演变,实现预测-规划端到端耦合。该技术采用Depth Anything V2的patch特征空间,保留几何细节并支持多模态预测,在Social-HM3D数据集上使行人轨迹预测误差降低31.5%。未来特征融合和社交奖励塑形机制进一步提升了导航成功率,适用于密集人群

weixin_30141859的博客 234

集成学习(一)Bagging

Bagging又称为“装袋法”,它是所有集成学习方法当中最为著名、最为简单、也最为有效的操作之一。在Bagging集成当中,我们并行建立多个弱评估器(通常是决策树,也可以是其他非线性算法),并综合多个弱评估器的结果进行输出。当集成算法目标是回归任务时,集成算法的输出结果是弱评估器输出的结果的平均值,当集成算法的目标是分类任务时,集成算法的输出结果是弱评估器输出的结果少数服从多数。由于bagging就是将多个模型进行集成,比较简单,所以,本文一、为什么Bagging算法的效果比单个评估器更好?

sinat_41942180的博客 1928

Windows下Maven环境变量配置避坑指南:解决‘mvn‘不被识别问题

本文详细解析了Windows系统中配置Maven环境变量时常见的'mvn'不被识别问题,特别是当系统提示“无法将‘mvn’项识别为cmdlet、函数、脚本文件或可运行程序的名称”时的解决方案。文章从问题根源入手,提供了清晰的配置步骤、深入的排查方法以及针对PowerShell的特殊处理,旨在帮助开发者彻底解决环境变量配置难题,确保Maven命令正常使用。

weixin_28826961的博客 390

集成学习(上):Bagging集成方法

在机器学习的世界里,没有哪个模型是完美无缺的。就像古希腊神话中的"盲人摸象",单个模型往往只能捕捉到数据特征的某个侧面。但当我们把多个模型的智慧集合起来,就能像拼图一样还原出完整的真相,接下来我们就来介绍一种“拼图”算法——集成学习。集成学习是一种机器学习技术,它通过组合多个模型(通常称为“弱学习器”或“基础模型”)的预测结果,构建出更强、更准确的学习算法。这种方法的主要思想是利用群体智慧的概念——即整体性能优于单个个体。

以为在机器学习领域与人工智能领域深耕多年的老牛 2105

盘点那些好用的SAP FIORI App(二) -上传凭证Upload Journal Entry

SAP FICO运维问题及解决方案分享

lijinbao171022的博客 1545

别再手动算临界转速了!用ANSYS Workbench 2023 R2快速搞定转子坎贝尔图(附完整APDL命令流)

本文详细介绍了如何利用ANSYS Workbench 2023 R2快速生成转子坎贝尔图,实现全自动临界转速分析。通过对比传统手动计算与Workbench自动化流程的效率差异,展示了其在旋转机械设计中的革命性优势,包括大幅缩短分析周期、提升精度至98.7%。文章还提供了完整的APDL命令流和实战案例,帮助工程师快速掌握这一高效工具。

weixin_42699679的博客 475

集成学习Bagging和Boosting算法总结

一、集成学习综述 集成方法或元算法是对其他算法进行组合的一种方式,下面的博客中主要关注的是AdaBoost元算法。将不同的分类器组合起来,而这种组合结果被称为集成方法/元算法。使用集成算法时会有很多的形式,如: 不同算法的集成 同一种算法在不同设置下的集成 数据集不同部分分配给不同分类器之后的集成 AdaBoost算法优缺点 优点:泛化错误率低,易编码,可以应用在大部分分类器...

CurryCoder的个人博客 1697

Xshell 连接 VMware虚拟机操作 截图和使用

vmwareVMware总部位于美国加州帕洛阿尔托(Palo Alto),是全球云基础架构和移动商务解决方案厂商,提供基于VMware的解决方案,企业通过数据中心改造和公有云整合业务,借助企业安全转型维系客户信任,实现任意云端和设备上运行、管理、连接及保护任意应用Xshell(安全终端模拟软件)Xshell [1]是一个强大的安全终端模拟软件,它支持SSH1, SSH2, 以及Microsoft Windows 平台的TELNET 协议。

小 tom的博客 804

机器学习集成算法:一文理解 Bagging 算法以及运用策略

Bagging 又称为“装袋法”,它是所有集成学习方法当中最为著名、最为简单、也最为有效的操作之一。在 Bagging 集成当中,我们并行建立多个弱评估器(通常是决策树,也可以是其他非线性算法) ,并综合多个弱评估器的结果进行输出。其规则是当集成算法目标是回归任务时,集成算法的输出结果是弱评估器输出的结果的平均值,当集成算法的目标是分类任务时,集成算法的输出结果是弱评估器输出的结果少数服从多数。

小阳的博客 2098

CondaHTTPError: HTTP 404 not found for url https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs解决方案

本文主要介绍了CondaHTTPError: HTTP 404 not found for url https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main解决方案,希望能对使用xx的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 17万+

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

【集成学习】Bagging算法详解及代码实现

Bagging全称叫做,通过训练多个相同类型的基学习器,并将他们的预测结果进行集成,从而提高模型整体性能的集成学习方法。Bagging的核心思想是通过并行训练多个基学习器,每个基学习器在训练集的不同子集上进行训练,最终通过这些基学习器的预测结果进行平均(回归任务)或投票(分类任务)得到最终预测结果。训练n个模型,每个模型在不同训练子集上独立训练所有基学习器的预测结果进行平均(回归任务)或投票(分类任务)得到最终决策。采用bootstrap。

码农努力学习 3414

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

上一篇: 集成方法 Boosting原理
下一篇: 朴素贝叶斯原理
dihe3772
博客等级 码龄11年 0粉丝 0原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值