万卡集群训练任务挂了?别慌,这本秘籍帮你解决!

重磅!AI应用架构师打造企业算力调度方案的独家秘籍 企业级AI算力调度的核心不是“用更先进的工具”,而是**“贴合AI任务的特性”**——从资源池化到任务感知,从调度策略到弹性优化,每一步都要围绕“AI任务的需求”设计。本文分享的独家秘籍先“池化”资源:把分散的算力整合成一个可调度的池;再“感知”状态:收集资源和任务的特征,让调度器“懂AI”;最后“智能”调度:用策略和预测实现“最优分配”,而不是“随机分配”。如果你能按照本文的思路落地,一定能解决企业的算力痛点,让AI应用“跑”得更快、更省、更稳。 阅读详情

摘要

大规模AI集群运行过程中频繁因为各类硬件、软件故障导致训练任务中断,如何快速发现故障、缩短故障恢复时间MTTR成为提高AI集群可用度的重点方向。本文汇总了昇腾断点续训特性提供的故障检测、故障恢复能力以及面临的问题和挑战。

1、背景介绍

大规模AI集群运行过程中频繁因为各类硬件、软件故障导致训练任务中断,如何快速发现故障、缩短故障恢复时间MTTR成为提高AI集群可用度的重点方向。本文汇总了昇腾断点续训特性提供的故障检测、故障恢复能力以及面临的问题和挑战,欢迎大家讨论。

2、解决方案

2.1)故障检测

及时、准确的故障检测能力是训练任务故障快速恢复的前提,如下图所示,目前提供的AI集群故障检测能力包括:

① NPU芯片故障监控

通过MindX Ascend Device-Plugin组件监控NPU芯片故障以及NPU直出的ROCE网口故障,其中NPU芯片故障包含了由NPU驱动提供的100+故障码(类似XID),ROCE网口故障包括网口Link状态、网络联通性检测结果。

② 计算节点&操作系统故障监控

通过MindX NodeD组件监控计算节点状态,目前针对服务器宕机、OS挂死类的故障提供了心跳检测机制,同时从服务器BMC获取整机硬件包括CPU、内存、硬盘、电源等部件的故障信息作为补充。

③ HCCS网络故障监控(A3产品)

HCCS网络分为L1/L2两层组网,其中L1-HCCS打通了从计算节点主机侧进行故障监控的能力,由Device-Plugin负责获取L1-HCCS故障信息,同时L1/L2-HCCS均提供了标准的北向管理能力,对接NCE网管,再统一被CCAE纳管。

④ 网络故障监控

NPU ROCE网络(参数面)、业务面网络、存储面网络的交换机设备故障监控由NCE负责,再统一被CCAE纳管。

⑤ 存储故障监控

存储设备故障监控通过DM直接被CCAE纳管。
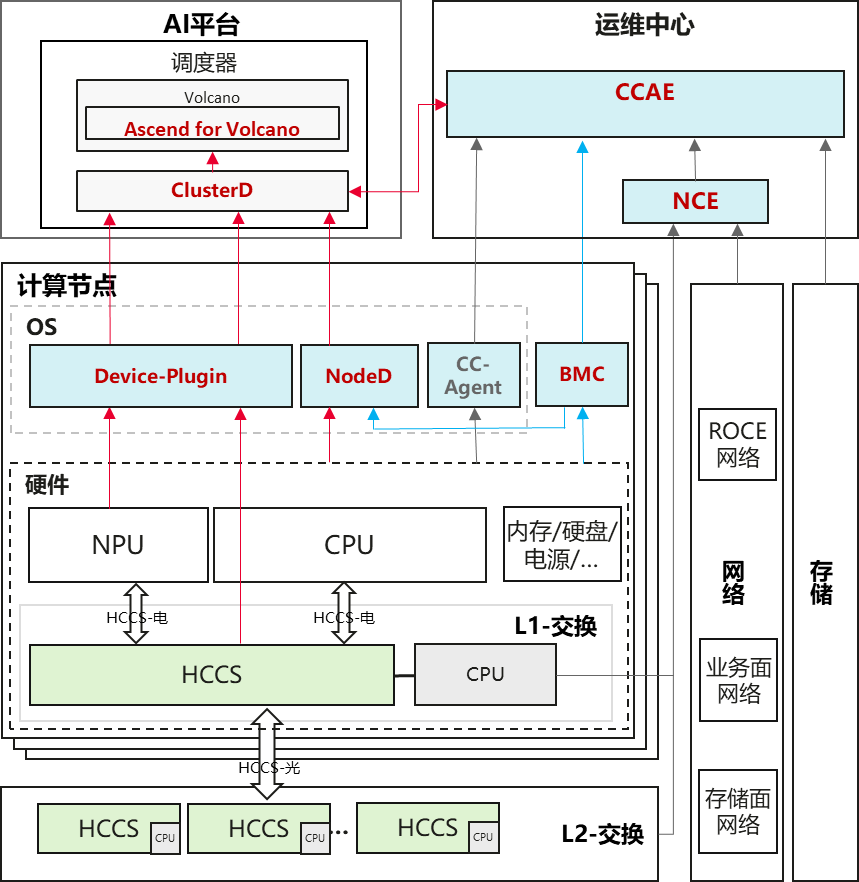
通过Device-Plugin、NodeD、BMC、CCAE、NCE监控到的故障信息统一汇聚到MindX ClusterD组件,由ClusterD根据不同故障信息综合识别故障点以及受影响的资源,生成故障恢复策略,通知AI平台调度器执行故障恢复操作。(注:当前CCAE通知故障信息给ClusterD的通道暂未提供)

2.2)故障恢复

基于故障检测的结果如何快速恢复训练任务?断点续训特性提供了如下图所示的分层分级快速恢复能力:

① 作业级快速恢复

销毁所有的Pod、训练进程,隔离故障节点并重新调度训练资源,整个训练任务作业重新拉起。

② Pod级快速恢复

仅销毁故障节点对应的Pod、调度到新的节点上重建,重启所有训练进程,相比于作业级快速恢复会减少部分资源调度、Pod创建的时间。

③ 进程级快速恢复

针对故障节点可以原地恢复的场景,保留所有Pod,重启所有训练进程,进一步减少Pod创建耗时。

④ 进程级重调度恢复

仅销毁故障节点对应的Pod、调度到新的节点上重建;正常节点清理NPU训练状态、但保留训练进程、等待新节点加入;各节点重建集合通信,利用Ranktable免协商建链;正常节点通过参数面网络将临终CKPT传递到备用节点上,完成参数状态恢复后继续训练。

相比于进程级快速恢复,该层能力仅重调度故障进程,减少了大量进程间不同步的等待耗时,同时利用了新的HCCL建链方案大大降低了建链耗时,且通过NPU卡间的参数面高速网络P2P传递CKPT信息,避免了CKPT保存和加载的耗时。

⑤ 进程级在线恢复

针对NPU HBM UCE故障,通过业务面CANN软件、框架软件、MindX软件配合实现HBM故障地址在线修复,故障节点对应的训练进程不退出,重新执行当前训练Step(临终CKPT),无需回滚到周期CKPT恢复,训练任务秒级恢复。

⑥ 算子级在线恢复

针对A3产品NPU HCCS网络、A2/A3产品NPU ROCE参数面网络提供HCCL算子重试能力,容忍更长时间的网络异常,训练任务不中断。
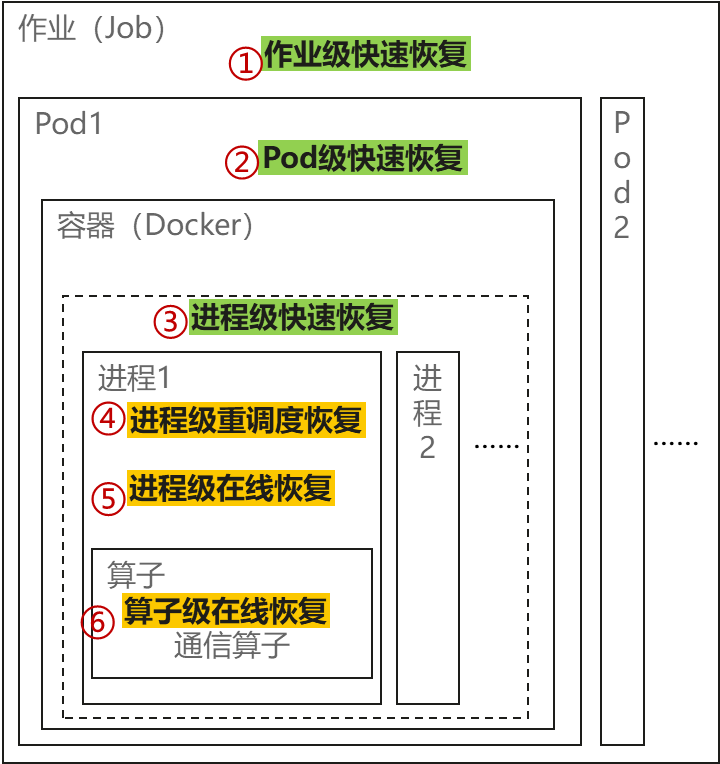
上述不同恢复能力通过状态机控制,可以逐层兜底,尽可能确保训练任务快速恢复。

3、问题和讨论

断点续训的故障检测和恢复能力并不是一蹴而就的,是基于技术成熟度和现网应用效果不断持续演进的结果,不同层级容错能力涉及的关键技术点也可以相互组合使用,整体来看可以通过“恢复时间、适用故障场景、易用性(企业集成使用的难易程度)、资源依赖”4个维度衡量竞争力和客户价值,如下表所示。

特性名称

说明

恢复时间

适用故障场景

资源依赖程度

易用性

适用CKPT

人工恢复

人工拉起,训练任务重调度

小时级别

全,全局性故障 | NPU其他故障

| 节点/框/局部网络故障

高,冗余节点恢复

低

周期性CKPT

①作业级快速恢复

训练任务重调度

十到几十分钟级别

中,原地恢复 | 冗余节点恢复

低

周期性CKPT | 临终CKPT

②Pod级快速恢复

故障容器重调度

小于十分钟

中,NPU其他故障 | 节点/框/局部网络故障

③进程级快速恢复

所有进程重试

小于十分钟

④进程级重调度恢复

故障进程重试

小于五分钟

中

⑤进程级在线恢复

故障进程不退出

分钟级

不全,NPU HBM UCE故障

低,原地恢复

临终CKPT

⑥算子级在线恢复

故障进程不退出

分钟级

不全,通信算子故障

低,原地恢复

高

不依赖CKPT

面向未来十万卡以及更大规模集群的训练任务,断点续训需要持续改进,目前识别和规划的改进方向如下:

  1. 硬件CPU/NPU静默故障检测&容错,提高断点续训故障模式覆盖率,尽可能避免人工介入恢复;
  2. 慢节点慢网络等亚健康故障检测&容错,通过CCAE、BMC等组件提供亚健康诊断能力,触发断点续训;
  3. 软件故障快速诊断&容错,通过报错日志或者配合故障诊断功能快速识别可以恢复的故障模式,触发断点续训;
  4. 故障恢复时间的进一步压缩,包括容器镜像快照恢复、热备/温备快速无感切换等。

AI训练集群工程化:从19天神话看超大规模算力基础设施构建 分布式计算与高性能计算(HPC)是支撑现代人工智能发展的核心技术基石。其核心原理在于通过高速网络互联大量计算节点,协同处理单一复杂任务,从而突破单机算力与内存限制。在AI大模型训练场景中,这一技术价值尤为凸显,它直接决定了模型迭代速度与研发成本。当前,构建高效AI训练集群已成为企业技术竞争的关键,涉及计算、网络、存储与软件栈的深度协同优化。其中,**NVLink/NVSwitch** 互联技术通过打破GPU间通信瓶颈,为千亿参数模型训练提供了物理基础;而 **InfiniBand** 低延迟网络则构成了集群 阅读详情

相关推荐

NVIDIA Base Command Manager:免费AI集群管理工具详解

集群管理是AI和高性能计算(HPC)中的关键技术,尤其在GPU加速环境中更为重要。NVIDIA Base Command Manager(BCM)是一款专为加速计算设计的全栈式集群管理平台,通过深度集成NVIDIA硬件加速器管理能力,显著提升GPU资源利用率。其核心原理包括控制器-代理架构和实时数据采集,支持混合部署场景,适用于教育科研和企业生产环境。BCM不仅能优化GPU显存分配和NVLink带宽,还提供故障预测和能耗管理等高级功能。对于AI模型训练和分布式计算任务,BCM的跨平台统一管理和性能调优能力尤

weixin_32287387的博客 290

SimAI 深度学习集群模拟器:从入门到精通

欢迎来到 SimAI 的世界!这是一个专为深度学习集群设计的强大模拟器,能够帮助你准确预测和分析大规模AI训练任务中的性能瓶颈。无论你是系统架构师、AI工程师还是研究人员,SimAI 都能为你提供宝贵的性能洞察。 ## 🚀 五分钟快速上手 想要立即体验 SimAI 的魅力吗?让我们从最基础的步骤开始: **环境准备与项目获取** ```bash git clone https://gitc

gitblog_00799的博客 324

重磅揭秘!AI应用架构师的企业算力调度方案创新秘籍

物理层:将分散在各个数据中心、部门的GPU服务器、NPU服务器集中起来,通过网络(比如InfiniBand、RoCE)连接成一个统一的资源池;逻辑层:用编排系统(比如Kubernetes+Volcano)将物理资源抽象成“逻辑资源”(比如“GPU实例”、“算力切片”),支持按需分配;接口层:提供统一的API接口,让各个团队通过接口申请资源,无需关心资源的物理位置。举个例子:某企业原来有3个部门,每个部门有50张GPU,总共150张。

2501_92132293的博客 595

IT运维转大模型,6个月实现薪资翻倍,零基础也能年薪50万!非常详细收藏这一篇就够了

2025年是运维人员转型大模型领域的关键机遇期。薪资对比显示,大模型运维岗位年薪(40-80万)远超传统运维(15-25万)。运维经验中的集群管理、监控系统等技能可直接迁移至大模型训练平台搭建、GPU优化等场景。企业招聘需求表明,K8s等分布式系统经验比算法推导能力更重要。转型需避开三大误区:不必重学算法、无需转算法岗、非科班同样具备竞争力。运维人员应重点衔接四大技能:从服务器监控转向模型训练监控、分布式系统调优、自动化流水线构建及故障排查能力。

m0_59162248的博客 1101

17.6 华为ModelArts实战:3倍推理加速+显存直降80%,国产AI平台逆袭秘籍!

摘要: 华为ModelArts作为昇腾计算体系核心AI开发平台,通过三大技术优势实现国产化突破:昇腾芯片深度优化、全流程国产适配和端边云协同训练。平台提供昇腾专用开发环境、分布式训练引擎和四级显存优化方案,支持ChatGLM-6B等大模型高效训练。实战案例显示,通过混合精度训练、LoRA微调和模型量化技术,在昇腾910B上实现3倍推理加速,显存占用降低80%,从14GB降至4.3GB,显著提升国产AI平台性能表现。

yonggeit的博客 1万+

两路半桥LLC谐振变换器软开关Simulink仿真(模拟谐振参数不同、分裂电容)

内容概要:本文介绍了“两路半桥LLC谐振变换器软开关Simulink仿真”资源包,重点在于基于Simulink平台对两路半桥LLC谐振变换器进行高精度建模与动态仿真,特别考虑了谐振参数不一致及分裂电容等非理想工况对系统性能的影响。该仿真模型不仅涵盖了主电路拓扑、软开关实现机制与谐振网络设计,还深入分析了不同参数配置下系统的启动特性、稳态效率、动态响应及软开关条件的满足情况。通过参数扫描与对比仿真,帮助用户掌握LLC变换器的关键设计要素与优化方法,具备较强的工程指导价值和科研教学意义。; 适合人群:电力电子、电气工程及其自动化等相关专业的高校师生,以及从事高频开关电源、新能源变换器、车载充电机等领域的研发工程师和技术人员。; 使用场景及目标:① 掌握两路并联半桥LLC谐振变换器的建模与仿真方法;② 理解软开关技术在提升变换器效率与降低EMI方面的关键作用;③ 分析谐振参数偏差与分裂电容结构对系统均流特性、增益曲线及软开关范围的影响;④ 支持科研项目中的拓扑验证、控制策略开发与故障工况分析; 阅读建议:建议结合Simulink仿真模型与配套说明文档进行学习,重点关注谐振腔参数设置、驱动时序设计及软开关波形观测;可通过调整谐振电感、电容值或引入参数失配,观察系统行为变化,深入理解LLC变换器的稳定边界与优化设计原则。

高性能计算集群中AI作业调度优化策略

想象一下,你手里有一台能够处理上万个GPU的超级计算机,但是AI训练任务就像是排队买奶茶的顾客——有的要大杯,有的要小杯,有的还要定制。如何让这些"顾客"排队不打架,资源利用率还能达到最优?这就是我们今天要聊的话题。 高性能计算集群(HPC)在AI时代扮演着越来越重要的角色。但是,传统的作业调度策略在面对AI工作负载时,就像是用筷子吃西餐——能用,但总觉得不太对劲。

TechVision大咖圈聚合全球科技大咖,洞察AI、云计算、大数据等前沿趋势,为企业决策者提供智见未来的转型路径。 1240

手把手教你绕过Incapsula reese84防护:从JS反混淆到动态Token生成全流程

本文深入解析了以Incapsula reese84为代表的现代Web客户端挑战防护机制,详细介绍了从JS反混淆、算法逆向到动态Token生成的全流程实战方法。文章系统阐述了如何通过模拟浏览器指纹、移植关键算法或嵌入JS引擎来构建自动化应对策略,并提供了稳健的令牌管理与系统架构设计思路,帮助开发者在合规前提下提升自动化工具的适应性。

jenkins8butler的博客 518

PhysicsNeMo分布式训练秘籍:从单GPU到多节点集群的完整指南

PhysicsNeMo是一个开源深度学习框架,专为使用最先进的Physics-ML方法构建、训练和微调深度学习模型而设计。本指南将帮助你从单GPU环境无缝过渡到多节点集群的分布式训练,充分发挥Physics-ML模型的计算潜力。 ## 为什么选择分布式训练? 在处理复杂的物理模拟和大规模数据集时,单GPU往往难以满足计算需求。分布式训练通过将任务分配到多个GPU和节点,不仅能显著缩短训练时间,

gitblog_00658的博客 1045

针对so层不固定位置的动态加密,怎么解决?(面试题)

Android逆向之破解某应用加密算法(动态调试so和hook so代码):so 代码动态解密后才执行,我们可以在解密完成后获取解密后的代码或数据。Android逆向之旅—动态方式破解apk进阶篇(IDA调试so源码)如果你有更具体的加密场景,欢迎提供更多信息,我可以给出更详细的方案!某些 so 在运行时生成密钥,解密后再用。某APP密码加密算法分析。

SXXYNHHXX的博客 928

Steam游戏服务器攻防全景解读——如何构建游戏级抗DDoS防御体系?

当检测到TCP/UDP混合攻击时,应触发预设的熔断策略:优先保障游戏大厅服务的UDP 27015端口,临时限制匹配系统的TCP连接数。针对Steam游戏服务器特有的UDP 4380端口,需配置协议合规性检查规则:限制数据包长度不超过128字节,强制校验请求来源IP的真实性。Steam游戏服务器的防护需要平衡安全性与玩家体验,通过协议深度解析、智能流量调度和服务端加固的三维防御体系,可构建游戏行业专属的抗DDoS护城河。答:采用弹性防护方案,基础防护带宽保持50Gbps,遭遇攻击时自动扩展至T级清洗能力。

2501_91486804的博客 1456

IT运维转行大模型应用开发指南:零基础转型拿下50万年薪,我用6个月实现薪资翻倍!

2025年是运维人员转型大模型领域的关键机遇期,薪资差距显著(大模型运维年薪40-80万)。运维经验在分布式训练、监控告警等场景具有直接迁移价值,企业更看重工程化能力而非算法理论。转型需聚焦四大技能衔接:监控系统升级、训练流水线构建、日志分析优化和RDMA网络调优。建议6个月分三阶段学习:PyTorch基础→分布式实战→作品集打造,重点掌握K8s+Docker+Prometheus技术栈。面试时可突出运维经验对大模型工程痛点的解决能力,并参与Kubeflow等开源项目积累实战经验。(149字)

2401_84494441的博客 1661

VSCode玩转ESP-ADF音频开发:从环境搭建到成功播放MP3的避坑全流程

本文详细介绍了如何在VSCode环境下使用ESP-ADF框架进行ESP32音频开发,从环境搭建到成功播放MP3的全流程。重点解析了`IDF_PATH`和`ADF_PATH`的配置问题,以及如何解决`xTaskCreateRestrictedPinnedToCore`等常见编译错误,帮助开发者快速上手ESP-ADF音频开发。

weixin_42520909的博客 339

多机NPU集群通信配置核心解析 JSON拓扑文件解析与自动校验实战

本文深入解析了CANN算子库中多机通信配置的核心组件,聚焦其如何解析与校验定义NPU集群拓扑的JSON文件。文章将详解与device_ids的关键映射规则,揭示其底层设计哲学。更为重要的是,我们将提供一套可立即上手的Python自动生成与校验脚本,并通过Mermaid流程图直观展示其工作流程。结合笔者多年的一线实战经验,本文还将分享企业级应用中的性能调优技巧和典型故障排查指南,助您彻底掌握大规模NPU集群的配置管理。所处理的JSON配置文件,虽然看似简单,却是连接物理NPU集群与分布式训练框架的“生命线”

weixin_45255454的博客 769

rk3568 点亮双LVDS 屏

承接文章《rk3568点亮LCD(lvds)》中仅仅只能使用亮单LVDS;经过厂商的努力,陆续发布新补丁。目前支持双lvds显示,缺憾是需要自己额外移植相关补丁。受限于通信频率和VOP编码能力,支持最大分辨仍然是1920x1080、60fps。

weixin_35723192的博客 3008

9.9华为OD机试真题 新系统 - 受限任务分配 (Java/Py/C/C++/Js/Go)

华为OD机试真题 新系统【受限任务分配】,提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解,以及在线OJ模拟做题。华为OD机试真题 【受限任务分配】多语言题解。

qq_45776114的博客 739

IT运维转行大模型:6个月实现薪资翻倍,零基础也能拿下50万年薪!非常详细收藏我这一篇就够了

##### 1. **行业薪资对比暴击(2024年数据)** * 传统运维工程师:15-25万/年(BOSS直聘数据) * 大模型运维工程师:40-80万/年(猎聘最新报告) * AI训练平台工程师:50万+期权(头部AI公司开价)

2401_84204207的博客 1575

OD图 arcgis曲线制作插件 od图曲线 路径图曲线制作插件 航线图曲线制作插件

在ArcGIS 10.2 中导入节点数据,打开插件,选择输入起始节点和目标节点的节点文件Point,以Name字段(地名)为连接线的起始字段和目标字段,(Input Table File)选择连接关系表格SDLine.csv,(Origin Column 和 Destination Column)为起始节点和目标节点,(Output Path)为输出路径,应选择.gdb数据库路径,否则容易报错,(Chord Coefficient)为连线的曲率,数值越大,曲率越高。运行环境:ArcGIS10.2。...

JData_Engineer的博客 2670

Open-AutoGLM部署实战(千卡级优化秘籍)

掌握千卡级大模型高效部署方案,本文深入解析open Open-AutoGLM 部署全流程,覆盖分布式训练、显存优化与推理加速核心技术,适用于大规模AI场景。提供可复用的配置策略与性能调优技巧,助力高效落地大模型应用,值得收藏。

PixelShoal的博客 661

【EB-02】TC397 Tresos 最小工程配置

主要设置McalLibPublishedInformation 参数,会根据ResourceM配置的芯片自动加载。可以看到再工程目录中生成了output文件夹,里面由这些模块生成的头文件,编译脚本和epc文件。如果选择生成swcd,可以生成xxx_Bswmd.arxml给别的工具使用。如果没有Error和Problems就可以点击生成代码。点击工程校验看看工程是否由错误。

libuping2023的博客 328

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

DeepEP分布式训练通信优化:从原理到实战的性能提升秘籍

DeepEP是一个高效的专家并行通信库,专为分布式训练场景设计,能够显著提升大规模模型训练时的通信效率与整体性能。本文将深入解析DeepEP的核心优化原理,提供从环境配置到性能调优的完整实战指南,帮助开发者轻松掌握这一高性能通信解决方案。 ## 为什么分布式训练需要通信优化? 在大规模深度学习模型训练中,专家并行(Expert Parallelism)已成为提升模型容量的关键技术。然而传统通信

gitblog_00761的博客 667

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

每2秒吃透一道高数大题!华为终于揭秘准万亿MoE昇腾训练系统全流程

而在RL后训练阶段,于Pangu Ultra MoE昇腾CloudMatrix 384超节点集群的后训练中,采用训练推理混合并行策略(训练:PP16/VPP2/EP32/TP8,推理:PP1/EP64/TP1),并结合异步RL算法与训练框架系统的协同创新,实现了每超节点35K Tokens/s的高吞吐能力。对于同步型Host-Bound问题,不仅有效消除了同步操作引发的Host资源瓶颈,在无法完全规避同步的场景下,还通过优化鲲鹏处理器的算子下发与调度策略,显著降低了同步后的Host-Bound开销。

量子位 1161

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

AI算力战争:混合云架构与GPU集群优化实战

在人工智能领域,算力资源已成为核心竞争要素。混合云架构通过结合公有云的弹性与私有云的性能,有效解决了AI训练中的算力瓶颈问题。其技术原理在于动态分配热备层、核心层和冷存层资源,显著降低推理成本。以OpenAI为例,采用NVIDIA DGX SuperPOD架构的自建超算集群,配合Azure和AWS的云服务,实现了高达80%的成本优化。这种架构特别适合大规模语言模型训练场景,但需要解决跨云数据传输和网络拓扑优化等挑战。通过禁用ECMP路由、调优NCCL参数等技术手段,可提升千卡GPU集群的训练效率。当前AI算

axfcjwkbi259888707的博客 332

verl高效训练秘籍:提升吞吐量的实用技巧

本文介绍了如何在星图GPU平台上自动化部署verl镜像,高效开展大语言模型强化学习后训练。该镜像专为PPO、GRPO等算法优化,支持千卡级集群高吞吐训练,典型应用于LLM对齐优化与智能体策略微调,显著降低训练成本并提升迭代效率。

weixin_42589700的博客 112

DeepSeek 出圈了!!! 生成式 AI 工具的成功秘籍

火了,出圈了!!!相信最近这段时间,大家都已经听过了 DeepSeek 的大名。无论是社交媒体上的刷屏,还是技术圈的热烈讨论,DeepSeek 都成为了当之无愧的“顶流”。上线仅仅半个月,DeepSeek 在 APP 端的新增下载量就超越了 ChatGPT ,并将百万级的领先优势持续至今。很多小伙伴就会问了:『为啥 DeepSeek 这么火?』『 生成式 AI 是怎么做到效果这么好的?咋出圈的?。

Foolforuuu的博客 1297

AI 时代职场逆袭秘籍:从传统编程到夯拉大模型,成为热门岗位的佼佼者!非常详细建议收藏

大模型岗位全景分析:从底层研发到应用落地的职业路径 摘要:大模型领域岗位可划分为5个梯队:1)核心研发梯队(预训练/Infra工程师),技术壁垒高,决定模型性能上限;2)模型优化梯队(架构创新/对齐/多模态),负责模型能力精修;3)应用开发梯队(Agent/行业方案),市场需求最大;4)支撑岗位(数据/安全/评估),保障模型运行;5)Prompt工程,门槛低但天花板明显。当前国内大模型人才缺口超40万,传统程序员可通过系统学习实现职业升级,建议聚焦实战能力培养,避免停留在概念层面。行业正处于黄金发展期,掌握

2401_84204413的博客 1144
上一篇: RLHF-PPO 昇腾训推共卡方案案例总结(下)
鲲鹏昇腾开发者社区
博客等级 码龄1年 26粉丝 8原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值