PyTorch示例——MLP图像分类-手写数字

pytorch 实现MLP(多层感知机) pytorch 实现多层感知机,主要使用torch.nn.Linear(in_features,out_features),因为torch.nn.Linear是全连接的层,就代表MLP的全连接层 本文实例MNIST数据,输入层28×28=784个节点,2个隐含层,隐含层各100个,输出层10个节点 开发平台,windows 平台,python 3.8.5,torch版本1.8.1+cpu #minist 用MLP实现,MLP也是使用pytorch实现的 import torchvision impo 阅读详情

版本信息

  • PyTorch: 1.12.1
  • Python: 3.7.13

导包

import torch
from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision.transforms import ToTensor, Normalize, Compose

数据集 MNIST

  • 探索一下数据
explore_data = datasets.MNIST(
    root="./data",
    train=True,
    download=True
)
# 取第0张图片
explore_data[0]
  • 输出信息
(<PIL.Image.Image image mode=L size=28x28 at 0x7F9E30058FD0>, 5)
  • 图像展示
explore_data[0][0]

image.png

  • 标签
explore_data[0][1]
5
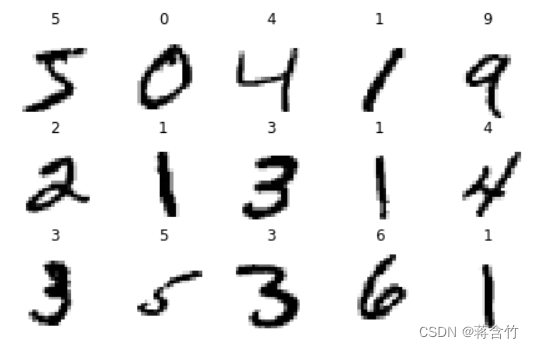
  • 多遍历几张图片看看(下面这个方法在PyTorch的图像数据中都很通用)
import matplotlib.pyplot as plt

def show_images(n_rows, n_cols, x_data):
    assert n_rows * n_cols < len(x_data)
    
    plt.figure(figsize=(n_cols * 1.5, n_rows * 1.5))
    for row in range(n_rows):
        for col in range(n_cols):
            index = row * n_cols + col
            plt.subplot(n_rows, n_cols, index + 1)
            plt.imshow(x_data[index][0], cmap="binary", interpolation="nearest")  # 图像
            plt.axis("off")
            plt.title(x_data[index][1])  # 标签
    plt.show()

show_images(3, 5, explore_data)

手写数据图片

  • 正式处理数据
transform_funcs = Compose([
    ToTensor(),
    Normalize((0.1307, ), (0.3081, ))  # 标准化,手写数字数据集的通用参数
])

train_data = datasets.MNIST(
    root="./data",
    train=True,
    download=True,
    transform=transform_funcs
)
test_data = datasets.MNIST(
    root="./data",
    train=False,
    download=True,
    transform=transform_funcs
)

print(train_data.data.shape)
print(test_data.data.shape)
  • 输出信息
torch.Size([60000, 28, 28])
torch.Size([10000, 28, 28])

构建模型 MLP

class MLPModel(nn.Module):
    
  def __init__(self):
    super(MLPModel, self).__init__()
    self.flatten = nn.Flatten()  # 将二维图像展开为一维
    self.linear1 = nn.Linear(28 * 28, 512)
    self.relu = nn.ReLU()
    self.linear2 = nn.Linear(512, 256)
    self.linear3 = nn.Linear(256, 10)
    
  def forward(self, x):
    out = self.flatten(x)
    out = self.linear1(out)
    out = self.relu(out)
    out = self.linear2(out)
    out = self.relu(out)
    out = self.linear3(out)
    return out

开始训练

# 参数配置
epoch_num = 10
batch_size = 64
learning_rate = 0.0005

device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

# 数据加载器
train_loader = DataLoader(train_data, batch_size=batch_size, shuffle=True)

# 模型、损失函数、优化器
model = MLPModel().to(device)
# 交叉熵损失的计算包含了softmax,模型中不需要做softmax
loss = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)


# 训练
loss_list = []
for epoch in range(epoch_num):
    for i, (X_train, y_train) in enumerate(train_loader):
        X_train = X_train.to(device)
        pred = model(X_train)
        y_train = y_train.to(device)
        l = loss(pred, y_train)
        
        optimizer.zero_grad()
        l.backward()
        optimizer.step()
        
        if (i + 1) % 100 == 0:
            print(f"Train... [epoch {epoch + 1}/{epoch_num}, step {i + 1}/{len(train_loader)}]\t[loss {l.item()}]")
    
    loss_list.append(l.item())
Train... [epoch 1/10, step 100/938]	[loss 0.3897044062614441]
Train... [epoch 1/10, step 200/938]	[loss 0.4615764319896698]
Train... [epoch 1/10, step 300/938]	[loss 0.09734677523374557]
Train... [epoch 1/10, step 400/938]	[loss 0.07513687759637833]
Train... [epoch 1/10, step 500/938]	[loss 0.14482976496219635]
Train... [epoch 1/10, step 600/938]	[loss 0.13744832575321198]
Train... [epoch 1/10, step 700/938]	[loss 0.05915261059999466]
Train... [epoch 1/10, step 800/938]	[loss 0.15903039276599884]
Train... [epoch 1/10, step 900/938]	[loss 0.08145355433225632]
Train... [epoch 2/10, step 100/938]	[loss 0.09195274114608765]
Train... [epoch 2/10, step 200/938]	[loss 0.021573053672909737]
Train... [epoch 2/10, step 300/938]	[loss 0.12080539762973785]
Train... [epoch 2/10, step 400/938]	[loss 0.04143274948000908]
Train... [epoch 2/10, step 500/938]	[loss 0.06194964796304703]
Train... [epoch 2/10, step 600/938]	[loss 0.00492143863812089]
Train... [epoch 2/10, step 700/938]	[loss 0.03946655988693237]
Train... [epoch 2/10, step 800/938]	[loss 0.06333575397729874]
Train... [epoch 2/10, step 900/938]	[loss 0.1421077400445938]
......
Train... [epoch 10/10, step 100/938]	[loss 0.0019266537856310606]
Train... [epoch 10/10, step 200/938]	[loss 0.010688461363315582]
Train... [epoch 10/10, step 300/938]	[loss 0.006648594979196787]
Train... [epoch 10/10, step 400/938]	[loss 0.009121301583945751]
Train... [epoch 10/10, step 500/938]	[loss 0.0005547187756747007]
Train... [epoch 10/10, step 600/938]	[loss 0.04679783061146736]
Train... [epoch 10/10, step 700/938]	[loss 0.002314511453732848]
Train... [epoch 10/10, step 800/938]	[loss 0.02470582351088524]
Train... [epoch 10/10, step 900/938]	[loss 0.010127813555300236]

绘制训练曲线

import matplotlib.pyplot as plt

plt.plot(range(epoch_num), loss_list)
plt.xlabel("epoch")
plt.ylabel("loss")
plt.show()

image.png

测试

test_loader = DataLoader(test_data, batch_size=batch_size, shuffle=True)
with torch.no_grad():
    correct = 0
    total = 0
    for X_test, y_test in test_loader:
        X_test = X_test.to(device)
        y_test = y_test.to(device)
        output = model(X_test)
        _, pred = torch.max(output, 1)
        total += y_test.size(0)  # 总数
        correct += (pred == y_test).sum().item()  # 预测对的数量

    print(f'total = {total}, acurrcy = {100 * correct / total}%')
total = 10000, acurrcy = 97.75%
pytorch学习笔记——5.2Pytorch中MLP分类模型 在MLP分类器的分析过程中,可以分为数据预处理和网络训练以及可视化部分,其中数据预处理部分会针对数据是否进行标准化处理进行单独分类,主要是用于分析数据标准化对于MLP网络训练的重要性。 阅读详情

相关推荐

实践指南:PyTorch实现MNIST手写数字分类的MLP与CNN模型对比

本文详细对比了使用PyTorch实现MNIST手写数字分类的MLP与CNN模型,从数据集准备、模型构建到训练过程与性能分析。通过实验数据展示CNN在准确率上的优势(测试集98.83% vs MLP的97.79%),同时提供工程实践建议如数据增强和学习率调度,帮助开发者根据需求选择合适模型。

weixin_32285357的博客 231

PyTorch入门之【MLP】

笔记

辉小歌的博客 2367

别再用Keras了!用PyTorch从零搭建MLP识别手写数字(附完整代码与GPU加速技巧)

本文详细介绍了如何从Keras迁移到PyTorch,从零搭建MLP模型实现手写数字识别任务。通过对比PyTorch与Keras的差异,提供完整的代码实现和GPU加速技巧,帮助开发者掌握更灵活的深度学习框架使用方式,提升模型训练效率和性能优化能力。

weixin_30632089的博客 370

【深度学习入门系列】 pytorch实现多层感知机(MLP)(内含分类、回归任务实例)

先明确了BP、BP神经网络、MLP的概念,讨论了三者的区别和联系。 之后用pytorch搭建多层感知机神经网络,这部分主要针对新手小白,以实战为主。内含2023年美赛春季赛Y题改变回归实例和一个反骗保欺诈分类实例。

如果没有躺赢的命,那就站起来奔跑,你的努力一定会对得起这一路的颠沛流离。 1万+

Pytorch实现MLP(基于PyTorch实现)

本专栏整理了《图神经网络代码实战》,内包含了不同图神经网络的相关代码实现(PyG以及自实现),理论与实践相结合,如GCN、GAT、GraphSAGE等经典图网络,每一个代码实例都附带有完整的代码。

优快云 精品推荐 1万+

深度学习入门必看-手写数字识别

前言 目前深度学习框架paddlepaddle、tensorflow、pytorch比较,结合网上大神的总结,pytorch更好学,社区也大,教程较多,莫名其妙的错误比较少。它基于动态图,可以按照正常人的思路玩,API较稳定。 paddlepaddle的话同时支持动态图和静态图,但是社区还在建设中,版本迭代更新快。不过可以嫖百度的云计算服务,值得一试。而且配套的预训练模型和可视化等等开发工具也在上线中,蛮好用的。 tensorflow是出了名新手劝退框架,因为文档比较反萌新,版本兼容性较差(我曾在嫉妒

Python,数据分析,机器学习,深度学习 1万+

MNIST手写数字识别——基于PyTorch的MLP模型的Python代码

本文基于PyTorch框架,采用使用PyTorch的nn.Module模块定义多层感知机(MLP)模型实现MNIST手写数字识别,在GPU上运行,实现高达98%的测试准确率,并完整展示从数据加载到模型部署的全流程。

qq_74303061的博客 842

基于Python与PyTorch的手写数字识别实战项目

手写数字识别是深度学习与计算机视觉领域中最基础且经典的图像分类任务之一,广泛应用于邮政系统、银行票据处理、电子表单识别等领域。该项目不仅具备极高的教学价值,还能够帮助初学者系统掌握数据预处理、模型构建、训练优化及性能评估等关键流程。我们将以MNIST数据集为基础,使用PyTorch框架实现一个完整的识别系统。通过本章的概述,读者将对手写数字识别的整体流程形成清晰认知,为后续章节的深入实践打下坚实基础。# 定义图像转换:将图像归一化到 [-1, 1] 区间])# 加载训练集# 加载测试集。

weixin_42298778的博客 992

机器学习详解(5):MLP代码详解之MNIST手写数字识别

本文详细讲解了如何使用PyTorch构建多层感知器(MLP)模型,在经典的MNIST数据集上实现手写数字分类。文章从数据加载、预处理到模型搭建、训练和验证,逐步展示了完整的深度学习项目流程,同时结合代码深入解析关键技术点,如张量操作、激活函数、损失函数和优化器。

主要分享嵌入式软件、人工智能部分知识 2283

欧姆龙多PLC串行链接模式的应用

欧姆龙多PLC串行链接模式的应用 一、如何将两台CP1H进行串行PLC连接(PLC串行链接) 主机侧设定 从机侧设定 二、 如何实现编程通信 主机侧的【PC连接模式】为【全部】的时候 ① 主机会把自己的地址从3100开始,按照【链接字】设定的字数个数发送到每个从机的3100开始进行存储。 ② 从机会把自己的地址从31n0开始,按照主机侧参数【链接字】设定的字数个数发送到主机的31n0开始进行存储。 注:(n为从机的地址号,若从机号不连续,则该编号的地址将不被定义..

u014202847的博客 3087

usb gadget uvc driver的code分析

uvc的linux driver分为host侧和gadget侧两个driver。host侧的driver在v4l2框架下,而设备侧的driver在usb/gadget文件夹下。gadget侧的uvc driver,利用v4l2框架去注册video_device,向应用层提供调用接口。同时,它完成v4l2 video buffer拷贝到usb request下的buffer下,然后利用uvc实现的协

lintwins的专栏 1万+

PyTorch实战-手写数字识别-MLP模型

PyTorch实战-手写数字识别-MLP模型

深度安全实验室 767

【车载以太网】ATU(Address Translation Unit / Address Table Unit)

【车载以太网】ATU(Address Translation Unit / Address Table Unit)

天赐好车的博客 152

pytorch应用(入门4)MLP实现MNIST手写数字分类

前面一章我们简要介绍了神经网络的一些基本知识,同时也是示范了如何用神经网络构建一个复杂的非线性二分类器,更多的情况神经网络适合使用在更加复杂的情况,比如图像分类的问题,下面我们用深度学习的入门级数据集 MNIST 手写体分类来说明一下更深层神经网络的优良表现。这里其实最有用的是看最后的画图是怎么画的。

优快云_YJX的博客 2701

华为OD机试 新系统 双机位C卷 往年真题 机考题库(持续收录中)以及算法考点详解(Python/JS/C/C++)

刷的越多,抽中的概率越大,每一题都有详细的答题思路、详细的代码注释发现新题目,随时更新。

学Java,找哪吒 5万+

华为OD机考双机位C卷 - 手机App防沉迷系统(Java & Python& JS & C/C++ & GO )

华为OD机考双机位C卷 - 手机App防沉迷系统(OD上机考试双机位C卷)。提供在线OJ刷题。Java、C++、Python、GO语言、C语言、JavaScript题解,并提供完整思路讲解。

算法大师! 2062

MLP识别MNIST手写数字数据集源代码

MLP识别MNIST手写数字数据集源代码 去发现同类优质开源项目:https://gitcode.com/ 此仓库包含了使用多层感知器(MLP)识别MNIST手写数字数据集的Pytorch完整源代码。该代码实践了机器学习中多层感知器的基本应用,通过Pytorch框架对MNIST数据集进行模型训练、验证及测试,最终实现对手写数字的准确识别。 简介 多层感知器(MLP)是一种前馈人工神经网络,广泛用于...

gitblog_06720的博客 434

管理类联考——逻辑——真题篇——按知识分类——综合推理

29、某部门抽检了肉制品、白酒、乳制品、干果、蔬菜、水产品、饮料等﹖类商品共521种样品,发现其中合格样品515种,不合格样品6种。已知: (1)蔬菜、白酒中有2种不合格样品。 (2)肉制品、白酒、蔬菜、水产品中有5种不合格样品。 (3)蔬菜、乳制品、干果中有3种不合格样品。 根据上述信息,可以得出以下哪项? A. 乳制品中没有不合格样品。 B. 肉制品中没有不合格样品。 C. 蔬菜中没有不合格样品。 D. 白酒中没有不合格样品。 E. 水产品中没有不合格样品。 31~32题基于以下题干: 某中学举行田径运

stqer的博客 2022

什么是MLP?

MLP 是一种经典的神经网络模型,适用于多种任务。虽然随着深度学习的发展,更多复杂的模型(如 CNN、RNN、Transformer)逐渐取代了 MLP 在某些领域的地位,但 MLP 仍是学习和研究神经网络的基础。在实际应用中,结合具体场景选择合适的模型是关键。

m0_68989328的博客 7514

【用unity实现100个游戏之15】开发一个类保卫萝卜的Unity2D塔防游戏1(附项目源码)

当今,塔防游戏已经成为游戏市场上备受欢迎的一类游戏类型。《保卫萝卜》作为其中的经典之作,深受玩家喜爱。本项目旨在基于《保卫萝卜》的玩法和特点,开发一个Unity2D塔防游戏,让玩家可以在游戏中体验到精彩的策略对抗与刺激的关卡挑战。本项目将通过Unity引擎进行开发,利用2D游戏开发相关技术,包括但不限于精灵动画、碰撞检测、UI界面设计等。我们将实现萝卜作为关键角色的防守任务,并设计各种怪物和防御塔,使得游戏具有多样的战术策略和游戏乐趣。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 4924

深度解构事务码 SQF:Support Query Framework 与 ABAP 静态分析实战

某制造企业在年度审计前,需要确认自定义发票过账程序 ZFI_INV* 系列是否存在硬编码公司代码与未捕获异常。技术团队在字段填入ZFI_INV*后,勾选与规则,执行扫描。SQF 生成的 ALV 报告列出 42 个警告,其中 17 条与抛出 CX_SY_NO_HANDLER 相关,8 条涉及动态 SQL 注入风险。结果导出至 Excel 供开发整改,并在 ATC 阶段验证修复。此过程较手工逐个执行 Code Inspector 节省超 80 % 时间。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 217

PyTorch 实战:手写数字识别(MNIST)从入门到精通

手写数字识别是入门 PyTorch 的绝佳案例 —— 数据集简单规整,能快速掌握 “数据处理→模型搭建→训练优化→结果评估” 的完整流程。从全连接网络到 CNN 的性能飞跃,也能直观理解 “空间特征提取” 的重要性。掌握这套逻辑后,可轻松迁移到其他图像分类任务(如昆虫识别、商品分类)。核心是记住 “数据决定上限,模型与策略决定下限”,在小数据集上,合理的预处理、简洁的模型结构、有效的防过拟合技巧,比复杂网络更重要。

HK0807的博客 1298

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

PyTorch实战:手把手教你完成MNIST手写数字识别任务

图像分类是深度学习中最经典的任务之一,而MNIST手写数字识别则是入门的最佳起点。本文将带你使用PyTorch从零构建一个简单的图像分类模型,通过卷积神经网络(CNN)和LeNet模型完成端到端的分类任务。无论你是深度学习新手,还是希望复习CNN基础的开发者,这篇文章都会为你提供清晰的步骤和代码示例。学习目标是通过实战理解CNN的核心结构,掌握PyTorch模型训练流程。关键词:PyTorch、图像分类、CNN、LeNet、MNIST图像分类是指将图片分配到特定类别,比如识别手写数字“0-9”。

吴师兄大模型的博客 2577

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Pytorch基本练习MLP-MNIST

训练MLP对MNIST手写数字数据库中的图像进行分类。训练分为几步:1.加载和可视化数据 2.定义神经网络 3.训练模型 4.评估已训练模型在测试数据集上的性能! 模块导入 # import libraries import torch import numpy as np from torchvision import datasets import torchvision.transfo...

qq_36795658的博客 1558

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

深度学习案例分享 | 手写数字识别 - PyTorch 实现

深度学习实战案例分享

m0_60001307的博客 2022

MXNet Gluon 手写数字识别实战:从 MLP 到 LeNet 的 MNIST 分类教程

本文基于 Apache MXNet 官方 Gluon 教程(对应仓库文件 [docs/python_docs/python/tutorials/packages/gluon/image/mnist.md](https://link.gitcode.com/i/35fab107b26dd08727bdfc099fdf6c10)),以经典的 MNIST 手写数字分类任务为主线,系统讲解如何使用 MXN

gitblog_00715的博客 603
上一篇: ChunJun源码分析——JDBC轮询增量更新
下一篇: ChunJun源码分析——脏数据插件
蒋含竹
博客等级 码龄10年 437粉丝 196原创
评论 13
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值