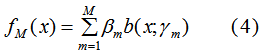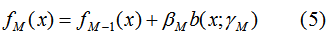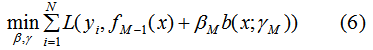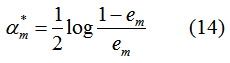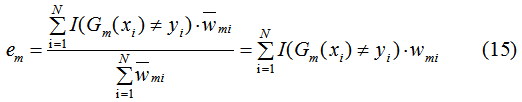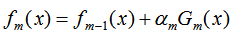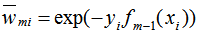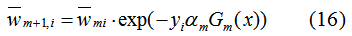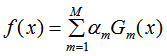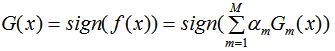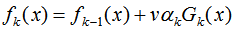比较全面的Adaboost算法总结(二)

AdaBoost模型原理及模型参数 集成学习模型的常见算法有Bagging算法和Boosting算法两种。随机森林模型是Bagging算法的典型代表,AdaBoost模型和GBDT模型则是Boosting算法的典型代表。 AdaBoost算法(Adaptive Boosting)以一种高度自适应的方式按顺序训练弱学习器。针对分类问题:AdaBoost算法根据前一次的分类效果调整数据的权重,在上一个弱学习器中分类错误的样本的权重会在下一个弱学习器中增加,分类正确的样本的权重则相应减少,并且在每一轮迭代时会向模型加入一个新的弱学习器。不断重复调整 阅读详情

推荐阅读:比较全面的Adaboost算法总结(一)


目录

1. Boosting算法基本原理

2. Boosting算法的权重理解

3. AdaBoost的算法流程

4. AdaBoost算法的训练误差分析

5. AdaBoost算法的解释

6. AdaBoost算法的过拟合问题讨论

7. AdaBoost算法的正则化

8. 总结


本文详细总结了AdaBoost算法的相关理论,第一篇文章相当于是入门AdaBoost算法,本文是第二篇文章,该文详细推导了AdaBoost算法的参数求解过程以及讨论了模型的过拟合问题。

AdaBoost算法的解释

AdaBoost算法是一种迭代算法,样本权重和学习器权重根据一定的公式进行更新,第一篇文章给出了更新公式,但是并没有解释原因,本节用前向分布算法去推导样本权重和学习器权重的更新公式。

1. 前向分布算法

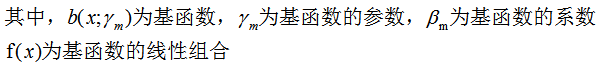
考虑加法模型:
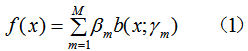
640?wx_fmt=png

640?wx_fmt=png

给定训练数据和损失函数L(y,f(x))的条件下,构建最优加法模型f(x)的问题等价于损失函数最小化:
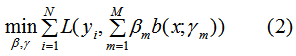
640?wx_fmt=png

我们利用前向分布算法来求解(2)式的最优参数,前向分布算法的核心是从前向后,每一步计算一个基函数及其系数,逐步逼近优化目标函数式(2),那么就可以简化优化的复杂度。

算法思路如下:

M-1个基函数的加法模型:
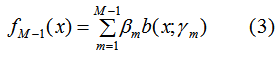
640?wx_fmt=png

M个基函数的加法模型:

640?wx_fmt=png

由(3)(4)得:

640?wx_fmt=png

因此,极小化M个基函数的损失函数等价于:

640?wx_fmt=png

前向分布算法的思想是从前向后计算,当我们已知640?wx_fmt=png的值时,可通过(6)式递归来计算第 i 个基函数640?wx_fmt=png及其系数640?wx_fmt=png,i = 1,2,...M。


结论:通过前向分布算法来求解加法模型的参数。


2. AdaBoost损失函数最小化

AdaBoost算法的强分类器是一系列弱分类器的线性组合:
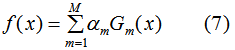
640?wx_fmt=png

其中f(x)为强分类器,共M个弱分类器640?wx_fmt=png,640?wx_fmt=png是对应的弱分类器权重。

由(7)式易知,f(x)是一个加法模型。

AdaBoost的损失函数L(y,f(x))为指数函数:
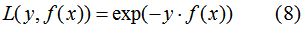
640?wx_fmt=png

利用前向分布算法最小化(8)式,可得到每一轮的弱学习器和弱学习器权值。第m轮的弱学习器和权值求解过程:
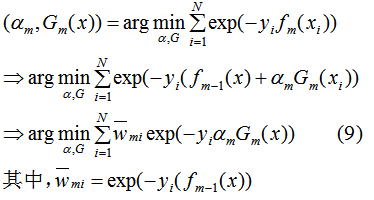
640?wx_fmt=png

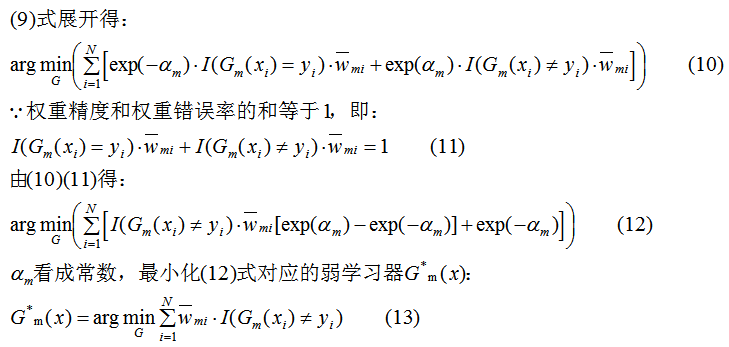
首先根据(9)式来求解弱学习器,权值α看作常数:

640?wx_fmt=png

求解弱学习器640?wx_fmt=png后,(9)式对α求导并使导数为0,得:


640?wx_fmt=png

其中,α是弱学习器权值,e为分类误差率:

640?wx_fmt=png

因为AdaBoost是加法迭代模型:

640?wx_fmt=png

以及640?wx_fmt=png,得:

640?wx_fmt=png


结论:式(14)(15)(16)与第一篇文章介绍AdaBoost算法的权重更新完全一致,即AdaBoost算法的权重更新与AdaBoost损失函数最优化是等价的,每次更新都是模型最优化的结果,(13)式的含义是每一轮弱学习器是最小化训练集权值误差率的结果。一句话,AdaBoost的参数更新和弱学习器模型构建都是模型最优化的结果。

AdaBoost算法的过拟合问题讨论

1. 何时该讨论过拟合问题

模型的泛化误差可分解为偏差、方差与噪声之和。当模型的拟合能力不够强时,泛化误差由偏差主导;当模型的拟合能力足够强时,泛化误差由方差主导。因此,当模型的训练程度足够深时,我们才考虑模型的过拟合问题。

2. 问题的提出

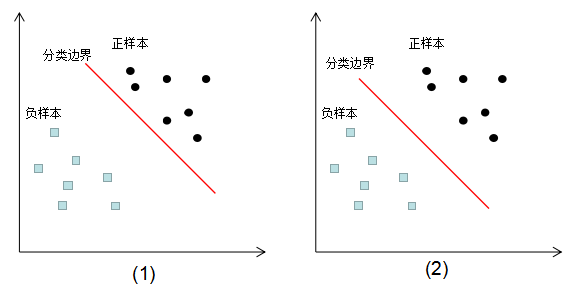
如下图为同一份训练数据的不同模型分类情况:
640?wx_fmt=png

图(1)(2)的训练误差都为0,那么这两种分类模型的泛化能力孰优孰劣?在回答这个问题,我想首先介绍下边界理论(Margin Theory)。

3. 边界理论

周志华教授在《集成学习方法基础与算法》证明了:
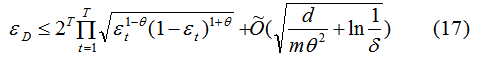
640?wx_fmt=png

其中,640?wx_fmt=png为泛化误差率,640?wx_fmt=png为边界阈值。

由上式可知,泛化误差收敛于某个上界,训练集的边界(Margin)越大,泛化误差越小,防止模型处于过拟合情况。如下图:
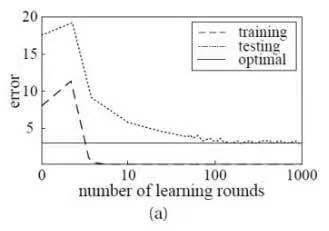
640?wx_fmt=png

结论:增加集成学习的弱学习器数目,边界变大,泛化误差减小。


4. 不同模型的边界评估

1) 线性分类模型的边界评估

用边界理论回答第一小节的问题

线性分类模型的边界定义为所有样本点到分类边界距离的最小值,第一小节的图(b)的边界值较大,因此图(b)的泛化能力较好。

2) logistic分类模型的边界评估

logistic分类模型的边界定义为所有输入样本特征绝对值的最小值,由下图可知,模型b边界大于模型a边界,因此,模型b的泛化能力强于模型a 。
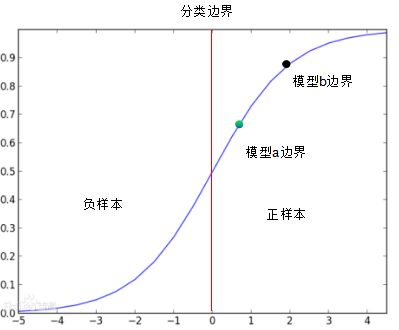
640?wx_fmt=png

3)AdaBoost分类模型边界评估

AdaBoost的强分类器:

640?wx_fmt=png

640?wx_fmt=png

AdaBoost的边界定义为f(x)的绝对值,边界越大,泛化误差越好。

当训练程度足够深时,弱学习器数目增加,f(x)绝对值增加,则泛化能力增强。


结论:AdaBoost算法随着弱学习器数目的增加,边界变大,泛化能力增强。

AdaBoost算法的正则化

为了防止AdaBoost过拟合,我们通常也会加入正则化项。AdaBoost的正则化项可以理解为学习率(learning rate)。

AdaBoost的弱学习器迭代:
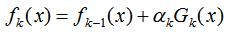
640?wx_fmt=png

加入正则化项:

640?wx_fmt=png

v的取值范围为:0 < v < 1。因此,要达到同样的训练集效果,加入正则化项的弱学习器迭代次数增加,由上节可知,迭代次数增加可以提高模型的泛化能力。

总结

AdaBoost的核心思想在于样本权重的更新和弱分类器权值的生成,样本权重的更新保证了前面的弱分类器重点处理普遍情况,后续的分类器重点处理疑难杂症。最终,弱分类器加权组合保证了前面的弱分类器会有更大的权重,这其实有先抓总体,再抓特例的分而治之思想。


关于AdaBoost算法的过拟合问题,上两节描述当弱学习器迭代数增加时,泛化能力增强。AdaBoost算法不容易出现过拟合问题,但不是绝对的,模型可能会处于过拟合的情况:

(1)弱学习器的复杂度很大,因此选择较小复杂度模型可以避免过拟合问题,如选择决策树桩。adaboost + 决策树 = 提升树模型。

(2)训练数据含有较大的噪声,随着迭代次数的增加,可能出现过拟合情况。

希望这两篇文章能够打开你深入理解AdaBoost算法的大门smiley_0.png。

参考

比较全面的AdaBoost算法总结(一)

【干货】集成学习原理总结

李航《统计学习方法》

周志华 《机器学习》

http://blog.sina.com.cn/s/blog_6ae183910101chcg.html

https://www.zhihu.com/question/41047671
640?wx_fmt=other

Adaboost处理多分类问题(参数调优,解决数据不平衡问题) adaboost多分类问题,以及参数调优方法,解决数据不平衡问题。 阅读详情

相关推荐

AdaBoost算法及其应用

1.集成方法集成方法是将不同的分类器组合在一起将测试数据集进行分类的方法,可以是不同算法的集成或是同一算法在不同设置下的集成,也可以将数据集不同部分分配给不同分类器的集成。集成方法主要包括bagging和boosting两种方法,而AdaBoost算法是基于boosting思想的机器学习算法。2.boosting介绍boosting所使用的多个分类器类型都是一致的,根据被已有1分类器错分的那些数据...

taichitaichi的博客 4863

详解AdaBoost算法

1)基学习器(base_estimator):AdaBoost算法中使用的弱学习器,常用的有决策树桩(Decision Tree Stumps)。2)迭代次数(n_estimators):弱学习器的数量,即算法迭代的次数。3)学习率(learning_rate):在每次迭代中,弱学习器权重的缩放因子。4)算法类型(algorithm):AdaBoost有两种实现,SAMME和SAMME.R。SAMME.R需要弱学习器支持概率预测。

2301_77444219的博客 772

机器学习之集成学习(二)AdaBoost算法

一、boosting算法的基本原理         集成学习器根据个体学习器的生成是否存在依赖关系,可以分为两类:个体学习器间存在强依赖关系,必须串行生成,代表算法是boosting系列算法;个体学习器之间不存在强依赖关系,可以并行生成,代表算法是bagging和随机森林系列算法。在boosting系列算法中,AdaBoost是最著名的算法之一。AdaBoost既可以用作分类,也可以用作回归。

ivy_reny的专栏 5252

AdaBoost算法

AdaBoost算法 集成算法通常有两种方式,分别是投票选举(bagging)和再学习(boosting)。 bagging的方式在做投票选举的时候可以并行计算,多个弱分类器单元的决策是相互独立的,不存在依赖性。 boosting是每次训练的时候都对上一次训练进行改进提升,在训练过程中弱分类器单元之间存在依赖性,当引入第K个分类器的时候,实际上是对前K-1个分类器的优化。 AdaBoost即为自适...

厚积薄发 1091

机器学习实战之AdaBoost元算法(二)AdaBoost算法

转载请注明作者和出处:https://blog.youkuaiyun.com/weixin_45814668 知乎:https://www.zhihu.com/people/qiongjian0427 Git:https://github.com/qiongjian/Machine-learning/ 运行环境:anaconda—jupyter notebook Python版本: Python3.x 更多精彩内容,尽在微信公众号,欢迎您的关注: 目录1 基于单层决策树构建弱分类器2 完整AdaBoost算法的实现3

weixin_45814668的博客 878

白话机器学习算法理论+实战之AdaBoost算法

1. 写在前面 如果想从事数据挖掘和数据分析的工作,掌握常用的机器学习算法是非常有必要的,比如我之前写过的一篇十大机器学习算法的小总结,在这简单的先捋一捋, 常见的机器学习算法: 监督学习算法:逻辑回归,线性回归,决策树,朴素贝叶斯,K近邻,支持向量机,集成算法Adaboost等 无监督算法:聚类,降维,关联规则, PageRank等 为了详细的理解这些,曾经看过西瓜书,统计学习方法,机器学习...

Miracle8070 4862

adaboost算法原理及sklearn中使用办法_learning rate=0

scikit-learn中Adaboost类库比较直接,就是AdaBoostClassifier和AdaBoostRegressor两个,从名字就可以看出AdaBoostClassifier用于分类,AdaBoostRegressor用于回归。AdaBoostClassifier使用了两种Adaboost分类算法的实现,SAMME和SAMME.R。而AdaBoostRegressor则使用了我们原理篇里讲到的Adaboost回归算法的实现,即Adaboost.R2。

2401_85013892的博客 671

合宙Air780EP速连OneNET:AT+MQTT应用指南

本文详细讲解了合宙Air780EP使用AT指令通过MQTT接入OneNET的过程。

2401_82812461的博客 1390

浅谈 Adaboost 算法

菜鸟最近开始学习machine learning。发现adaboost 挺有趣,就把自己的一些思考写下来。 主要参考了http://stblog.baidu-tech.com/?p=19,其实说抄也不为过,但是我添加了一些我认为有意思的东西,所以我还是把它贴出来了,呵呵。 一 Boosting 算法的起源 boost 算法系列的起源来自于PAC Learnability(PAC 可学习性)。

haidao2009的专栏 19万+

三. zemax光学设计流程+案例

文章目录zemax 基本操作:1. 建立光学基本模型2. 像质评价3. 优化(重点)4. 公差分析简单镜头设计 zemax 基本操作: 1. 建立光学基本模型 2. 像质评价 3. 优化(重点) 对系统设定的约束条件或目标值 统称为操作数。 操作数: 光学特性参数(焦距EFFL,近轴放大率PMAG,入瞳位置EMPP) 像差参数(球差SPHA,彗差COMA,像散ASTI) 边界条件(中心厚度值CTVA,边缘厚度值ETAV) 优化的主要步骤: 设置评价函数和优化操作数 一般小像差系统采用波像差 构建

Taiiiii的博客 8059

用limma包进行多组差异表达分析

写在前面:最近在使用limma包进行差异表达分析,参考了网上许多教程都觉得说的云里雾里,很不清楚。经过我自己一段时间非常痛苦的钻研,弄明白了,解决了我的实际需求。于是决定将我的分析经验写下来,分享给需要的人。 首先加载前期预处理好的表达矩阵。(我的原始表达矩阵文件已附在文后,大家有需要可以下载实践) setwd("E://Rworkplace") data<-read.table...

weixin_40640700的博客 4万+

Adaboost算法实现二

终于把这个Adaboost算法的源码看完了,基本了解了算法。对于一些地方还是存在疑问,不知道为啥要这样处理,如相似性度量。           测试了好几个例子,感觉Adaboost对样本分类的效果还不错,但是对于预测,正确率也就70%-80%,不是很高,感觉应该是比较低的了,应该有改进的措施,还没来得及看。           用主程序中的一段代码对adaboost算法做下自己的总结。

lskyne的专栏 4536

计算蛋白质结构中氨基酸之间的方向和方位

方向 (Direction):通过相邻氨基酸的 CαCα​ 原子坐标差值,得到方向向量,描述两个氨基酸之间的几何方向。方位 (Orientation):可以通过二面角(如 Psi)来表示相邻氨基酸之间的旋转关系,或者通过局部坐标系(基于 NN、CαCα​、CC 原子)描述残基的空间取向。这些计算是研究蛋白质结构动力学、折叠过程、以及相互作用的基础,尤其是在使用机器学习和深度学习模型进行蛋白质结构预测时,这些几何信息有助于更好地捕捉残基之间的空间关系。

qq_27390023的博客 1681

AdaBoost算法实例详解

AdaBoost算法其实很精炼,算法流程也好理解,但是看了算法的解释版本之后,什么前向分布算法,什么指数损失函数之后有点迷糊了。抛开这些理论性的推导不谈(其实是因为能力有限),通过例子直观的了解AdaBoost算法的计算过程。 简要叙述一下AdaBoost算法的主要过程: AdaBoost为每个数据样本分配权重,权重符合概率分布,初始权重符合均匀分布,串行训练M个模型,依据每轮训练的模型的错误率(被误分类样本的权重之和)确定当前模型在最终模型中的权重,以及更新训练样本的权重,误分类样本权重升高,分类正确

胖胖大海的博客 2万+

常用的数据结构以及常用的算法

常用的数据结构以及常用的算法 常用数据结构 数据结构是计算机存储、组织数据的方式。 数据结构是指相互之间存在一种或多种特定关系的数据元素的集合。 通常情况下,精心选择的数据结构可以带来更高的运行或者存储效率。 数据结构往往同高效的检索算法和索引技术有关。 一、线性表 线性结构: 最常用、最简单的一种数据结构。 线性表: 典型的线性结构。基本特点是线性表中的 数据元素有序且有限。结构中: ① 存在一个唯一的被称为“第一个”的数据元素; ② 存在一个唯一的被称为“最后一个”的数据元素; ③ 除第一个元素外,每

qq_47605698的博客 1455

MATLAB仿真实战:双有源桥(DAB)变换器的扩展移相调制(EPS)全流程解析

本文提供了一份详细的MATLAB/Simulink仿真实战指南,手把手解析双有源桥(DAB)变换器在扩展移相调制(EPS)下的全流程建模。内容涵盖从核心原理、主功率电路搭建、EPS驱动信号生成,到仿真运行、波形分析及模型优化的完整步骤,旨在帮助工程师和研究者快速掌握DAB变换器的仿真与性能验证方法。

o4p5q6r7s的博客 505

AdaBoost算法超详细讲解

AdaBoost算法超详细讲解

wzk4869的博客 4万+

SECS/GEM EAP 设备自动化功能原理和设计方案

半导体SECS GEMEAP实现了对生产线上机台的实时监控,是工厂自动化不可缺少的控制系统。EAP系统与FAB中的机台紧密相关,系统的设计与开发必须与生产线的机台实际生产流程相一致,才能达到控制机台生产的目的。 EAP SECS/GEM是MES与设备的桥梁,EAP通过SECS国际标准协议与机台进行数据传输。SECS是半导体设备(半导体行业称设备为机台)必须遵循的一种国际通信协议。EAP就是通过SECS与设备通信、传输数据、发送指令控制设备按照预先定义........

semisecs 17万+

python实现AdaBoost算法

★ AdaBoost的理解: 对于二分类而言,我们通过一个阈值threshVal将数据集划分为两种分类(正类和负类),而这个阈值就是我们所说的分割线,只不过它总是平行于坐标轴(因为我们取的基分类器是单层决策树): 对于上述数据集,一个基分类器即可将其分类,但是对于大多数训练集而言,一个基分类器是不足够的,比如: 在图3中,我们找...

weixin_42051109的博客 1万+

华为MetaERP国资委语境下的 DRP(全域数字化资源管理平台/Digitalized Resource-management Platform)与传统 ERP(以 SAP、Oracle 为代表)的

【摘要】国资委推动的DRP(全域数字化资源管理平台)正在重构央国企数智化转型路径,其本质是通过"ERP管交易+DRP管管控"的双层架构实现升维替代。与传统ERP相比,DRP具有三大突破:采用国产分布式数据库实现全级次穿透监管、构建数据中台打破信息孤岛、以实时分析替代事后报表。当前政策明确2026-2030年分阶段建设目标,这将重塑产业格局——倒逼传统ERP厂商转型,为云原生/AI/信创企业创造新机遇。需注意DRP并非简单替代ERP,而是通过治理模式变革实现"交易系统做薄、管控中

金牌架构师 291

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

AdaBoost算法详解

AdaBoost adaboost算法的核心思想是:对于所有的样本我们先初始化一个权重,在算法的一开始,每个样本的权重是一样的,即每个样本被选到的概率相同。然后我们选择一个特征,只用这一个特征进行分类,得到一个弱分类器(通常,这个弱分类器的效果会比较差,会有很多的样本被识别错误)。接下来,我们对样本的权重进行重新分配,对于那些被识别错误的样本,我们给它更高的权重,对于那些识别正确的样本,我们给与更低的权重。然后在此基础上,我们再选择另外的一个特征(这个特征应该对那些之前被识别错误的样本有较好区分作用),得到

星辰的博客 1万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

AdaBoost算法讲解以及MATLAB实现

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录一、算法描述二、算法步骤是什么?三、数据集说明(可以自己增加数据集)四、算法实现MATLAB1.主函数2.找到误差率最小的弱函数3.分别计算弱分类函数,并计算其误差率六、结果演示 一、算法描述 AdaBoost,是英文"Adaptive Boosting"(自适应增强)的缩写,由Yoav Freund和Robert Schapire在1995年提出。它的自适应在于:前一个基本分类器分错的样本会得到加强,加权后的全体样本再次被用来训

weixin_41146894的博客 3395

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

提升方法AdaBoost算法

提升方法是一种常用的统计学习方法,应用广泛且有效。在分类问题中,通过改变训练样本的权重,学习多个分类器,并将这些分类器线性组合,提高分类的性能。

qq_47190374的博客 1428

【机器学习】Boosting算法-AdaBoost算法

一、AdaBoost理论随机森林与AdaBoost算法的比较AdaBoost算法AdaBoost模型训练误差分析从广义加法模型推导出AdaBoost训练算法,从而给出AdaBoost算法在理论上的解释各种AdaBoost算法对比标准AdaBoost算法只能用于二分类问题,它的改进型可以用于多分类问题,典型的实现由AdaBoost.MHsuanfa ,多类Logit型AdaBoost二、示例代码2...

cxyhjl的博客 1984
上一篇: 清晰易懂的Numpy入门教程
下一篇: 一文让你完全入门EM算法
机器学习算法那些事
博客等级 码龄9年 1633粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值