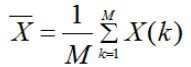机器学习模型性能评估(一):错误率与精度

分类机器学习模型的评估方法及性能度量 当我们创建一个机器学习模型,然后通过该模型输出结果,那我们会不会直接使用这个结果呢? 如果你的答案是:会使用,那你对这个结果完全认可吗? 如果你的答案是否定的,那你对这个结果有哪些疑问呢? 本文从模型评估的方法和性能的度量两个方面来解答以上的疑问,本篇文章主要讨论分类学习模型的评估与性能度量。 模型的评估方法 我们创建的机器学习模型都要通过训练数据来训练模型,为了检测学习模型是否符合我们的要求,就... 阅读详情

机器学习是对给定的原始数据集构建最优学习模型,上篇文章讲到《机器学习模型评估方法》,通过模型评估方法将原始数据集划分训练集和测试集,训练集又可细分为训练集和验证集。机器学习的整个流程包括训练集和验证集构建最优模型,最优模型评估测试集的测试误差,通过测试误差来评价学习方法的泛化能力,泛化能力是评价机器学习模型性能的金标准(如图),即泛化能力强,对应的学习模型好。
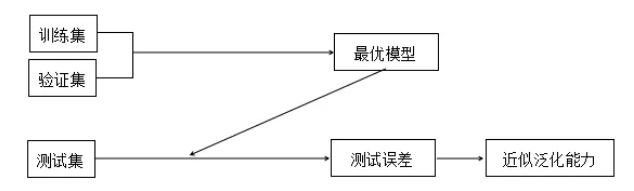
                                       

                                                                             图1  机器学习流程

测试误差评价学习模型的泛化能力具有一定的局限性,抽样的测试数据集具有随机性,不同的测试集表现出不同测试误差,即评价模型的泛化能力也有所不同。
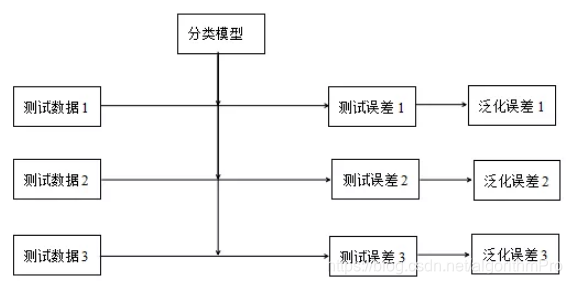
                                            

                                                                图2 测试数据集对泛化能力的影响


本文介绍了评价机器学习模型性能的四种方法:

(1)错误率与精度,错误率与精度是评价学习模型泛化能力的最常用的方法;

(2)从查准率和查全率的角度来评价学习模型泛化能力的优劣,并引用了P-R曲线和度量参数F1;

(3)ROC(Receiver Opreating Characteristic,受试者工作特征)曲线则评价“一般情况下”学习模型的泛化能力,并引用了度量参数AUC(Area Under Curve,曲线下的面积);

(4)P-R曲线和ROC曲线认为学习器对不同类的分类错误产生的代价损失相同,则实际情况可能是不同类的分类错误产生的代价损失不相同,即非均衡代价,因此。从非均衡代价的角度去分析模型性能的优劣,并引用了代价曲线和期望总体代价。由于周老师编写的《机器学习》对代价曲线和期望总体代价描述的比较简练,因此,本文会详细去解释这两者的含义。


在介绍这四种方法前,需要理解期望和均值的概念,本文会首先引出期望和均值的概念,然后介绍评价机器学习模型性能的四种方法,最后对本文进行总结。


                                                                                 1、期望和均值


期望和均值这两个概念,相信在看我这篇文章的童鞋都不陌生,最近在自学贝叶斯概率的时候发现自己并没有充分理解期望和均值的概念,且这篇文章很多知识点要涉及到期望和均值的思想,因此,本节简单介绍了期望和均值的定义。

假设某一离散变量X的取值范围来自于集合A,A={X1,X2,X3,X4,...XN},对集合A进行可放回抽样M次(参考上节),产生容量为M的抽样数据集S,数据集S的离散变量X的取值为:{X(1),X(2),X(3),...X(M)},X(K)表示第K次可放回抽样的值。

变量X期望E(X):
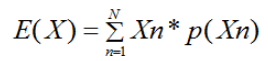
 

由上式可知,期望是累加变量所有可能的取值与对应该值出现概率的乘积。

抽样数据集S的变量X的均值:


均值是所有抽样数据变量的求和平均。

实际工作项目中,我们获取的数据都是抽样数据,只能够通过抽样数据来计算均值,期望是计算不出来的,若知道某一个变量的真实分布,马上就能知道该变量的期望,那么训练数据也没有什么存在的意义了。机器学习的一个重要内容就是通过已知的抽样数据集去估计总体的分布。

辛钦大数定理:
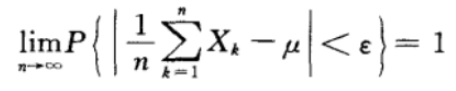
 

辛钦大数定理:若抽样数据的样本量足够大,那么变量均值等于期望。

                                                                                   2、模型性能评估方法


模型性能评估即评估模型的泛化能力,本节介绍四种性能评估方法,分别为错误率与精度评估方法、P-R曲线评估法,ROC曲线评估法以及代价曲线评估法,根据实际应用的侧重点选择性能评估方法。


2.1 错误率与精度

错误率与精度常用于分类任务,错误率是测试样本中分类错误的样本数占总样本数的比例,精度是测试样本中分类正确的样本数占总样本数的比例。

假设数据集D,模型f:

分类错误率:
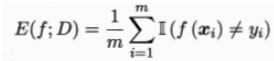
 

精度:
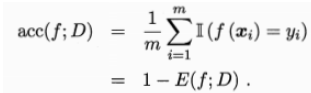
 

更一般地,若对于数据分布D和概率密度函数p(∙),错误率与精度可分别描述为:
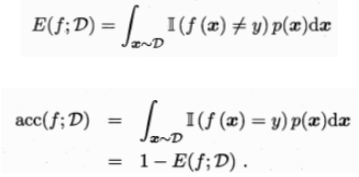


若测试数据集的精度高或错误率小,则模型的泛化能力强;反之,则泛化能力弱。

用测试数据集的精度来表示模型的泛化能力在正负样本比例相差较大的时候就不适用了。

如:
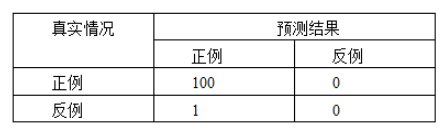
 

上表的混淆矩阵可知:

测试数据集正样本和负样本的比例是100:1,把所有样本都检测为正样本,准确率99%,但不能说明模型的泛化能力强,因为不能反映模型对负样本的检测能力。运用精度来表示测试数据集的泛化能力,测试数据集的正负样本比例应该均衡(1:1)。

未完。。。。。。
                                                

宇树机器人G1二次开发:导览、起始点、目的地与完整示例 通过宇树G1 SDK的导航接口,开发者可以高效地实现机器人的自主移动功能。连接 -> 设置目标点 -> 发送命令 -> 监控状态。本文提供的完整示例涵盖了从环境搭建到代码实现的全部步骤,并解释了起始点、目的地等关键概念。开发者可以在此基础上,结合多目标点巡逻、动态避障(需高级配置)等功能,构建更复杂的机器人应用。建议读者先在小范围、熟悉的平坦环境中测试,成功后再逐步扩展到更复杂的场景。 阅读详情

相关推荐

子网划分详解

还不会子网划分?看这篇就够了,保姆级教程

m0_47584619的博客 6096

机器学习笔记(一) 一些概念

机器学习笔记(一) 一些概念 1.认识数据 数据集 由数据对象组成,一个对象代表一个实体 数据对象(样本/实例)用属性描述 属性:表示数据对象一个特征的字段 又称特征/维度 特征向量:描述一个对象的一组属性 离散属性和连续属性 2.将经验数据划分为 训练集:学习/归纳模型 测试集:评估模型 3.目标 最小的数据误差 训练集上预测值与误差值达到最小 min||????−????(????)|| 最大的训练精度 最好的泛化能力 在新样本上有良好的预测效果 分类器的泛化能力通常用泛化精度衡量 4.泛化精度:模型

weixin_43808299的博客 320

SAP采购申请详述;以及采购计划协议/交货计划行

SAP采购申请详述;以及采购计划协议/交货计划行

saplakes的博客 4344

机器学习需要面对的两大问题:泛化性和可信性

在机器学习中,过度拟合(Overfitting)是一个常见的问题,它指的是模型过度适应训练数据,导致在新数据上表现不佳。因此,解决过度拟合问题的关键在于控制模型的复杂性,使用正则化技术、交叉验证等方法来确保模型在未知数据上的表现。而在可信性方面,除了可解释性模型和解释技术,还有一些标准和认证体系,如可信AI标准、透明AI认证等,旨在确保机器学习模型的可信性。解决这些问题需要结合理论和实践,借助新的算法、技术和标准,以确保机器学习的应用能够在未知数据上表现出色,同时还能够被人们理解和信任。

Nightowls__的博客 613

论文必备 - YOLOv8训练前一键扩充数据集,支持9种扩充方法,支持图像和标签同步扩充

在网络模型训练前,大量的数据集是必备的。而对于一些特殊场景中的特殊目标,大量的数据集往往难以获取,无法满足模型训练的基本需求。本文提供了,脚本可一键运行,。

Limiiiing的博客 771

海康VisionMaster与西门子PLC1200进行S7通信

通信是连通算法平台和外部设备的重要渠道,在海康VisionMaster算法平台中既支持外部数据的读入也支持数据的写出,当通信构建起来以后既可以把软件处理结果发送给外界,又可以通过外界发送字符来触发相机拍照或者软件运行。 本文以西门子PLC1200作为外部设备为例,讲解海康VisionMaster与西门子PLC1200进行S7通信。......

haier123888的博客 1万+

【流程挖掘的四个质量维度】简单度、拟合度、精确度和泛化度介绍

判定一个流程挖掘结果的质量并不容易,需要从不同的维度来描述,主要包括四个质量维度:拟合度(fitness)、简洁度(simplicity)、精确度(precision)和泛化度(generalization),下面我们先简单地介绍这四个质量维度,然后再逐渐展开描述。 1.背景 2 四个质量维度 2.1 简单度(simplicity) 简单度(simplicity):简单性维度评估流程模型对人的理解有多简单。因此,该维度与观察到的行为没有直接关系,但可以单独考虑过程模型。由于使用不同的流程模型.

qq_40420514的博客 3049

手眼标定----眼在手上(eye-in-hand)

@TOC 标定之前你可以先拿个怡宝盖子进行测试。 第一步:打开halcon,采集,然后生成代码,显示十字架 第二步:把怡宝盖子放在十字架中心位置,在图像处理,找到怡宝盖子 第三步:找到怡宝盖子然后进行九点标定(眼在外帖子有讲),移动机器手然后分别拍9次照片,记录怡宝盖子坐标和当前机器坐标。这里移动到中心位置的时候记录一下单独记录一下坐标,等下要用。 顺序 第四步:拍完后利用vector_to_hom_mat2d算子求出矩阵,然后在利用write_tuple (HomMat2D, ‘路径’)进行保存。这里

苏州程序大白的博客 4282

《机器学习(周志华)》Chapter2 模型评估与选择

    这一章几乎把整个机器学习的工作流程都介绍了一遍,能让读者了解到如何一步步的搭建一个机器学习项目。下面先把整个流程大致的梳理一遍:一、评估方法:我们在拿到数据之后首先要处理的就是将数据划分为训练集和测试集,西瓜书提供了三种方法,分别是:留出法、交叉验证法和自助法。1、留出法:将数据集划分为两个互斥的集合,将70%划分为训练集,30%划分为测试集。如果我们希望评估的是整个训练集的模型性能,而留...

周博的博客 713

光谱数据预处理综合

除了化学信息,光谱还包含其他不相关或不需要的信息,如电噪声,基质背景,杂散光,散射效应等。在用化学计量学方法建立校准模型时,利用预处理方法消除光谱数据中的无关信息和噪声是非常必要的。

qq_44204759的博客 5192

自监督学习原理与代码实战案例讲解

自监督学习原理与代码实战案例讲解 作者:禅与计算机程序设计艺术 1. 背景介绍 1.1 自监督学习的起源与发展 1.1.1 监督学习的局限性

AI天才研究院 624

【AI工程论文解读】05-通过Ease.ML/CI实现机器学习模型的持续集成(下)

持续集成是一种软件开发实践,即团队开发成员经常集成他们的工作,通常每个成员每天至少集成一次,也就意味着每天可能会发生多次集成。每次集成都通过自动化的构建(包括编译,发布,自动化测试)来验证,从而尽快地发现集成错误。许多团队发现这个过程可以大大减少集成的问题,让团队能够更快的开发内聚的软件。在上一篇《》文中,我们介绍了ease.ml/ci的系统设计和基本实现,本篇将主要分享基于ease.ml/ci进行的优化和实验。

Kenji_Shinji的博客 695

Xilinx系FPGA学习笔记(三)Vivado的仿真及ILA使用

接着学习vivado的使用方法。

贾saisai的博客 2547

模型评估与选择(一)

模型评估与选择(一) 以下源于对西瓜书《机器学习》的模型评估的总结,有较多的抄袭。 1、经验误差与过拟合 学习器在训练集上的误差称为经验误差,在新样本上的误差称为泛化误差。 当学习器把训练样本学得“太好”的时候,很可能已经把训练样本自身的一些特点当作了所有潜在样本都会具有的一般性质,这样会导致泛化性能下降,这种现象称为过拟合,以过拟合相对的是欠拟合,这是指对训练样本的一般...

火鸡哥 547

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

机器学习 - 模型选择与评估学习笔记

最近在看周志华的《机器学习》,整理了一些学习笔记。模型选择与评估的知识偏向理论,该回去复习概率论了QWQ 一、名词解释 训练误差/经验误差trainning error/empirical error  学习器在训练集上的误差。 泛化误差generalizationerror  学习器在新样本上的误差。 测试误差testingerror  学习器在测试集上的误差。 过拟

Euthanazia的博客 480

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

机器学习02——模型评估与选择(过拟合与欠拟合、K折交叉验证、均方误差、混淆矩阵)

本文介绍了机器学习模型评估的核心概念与方法。首先阐述了误差类型(训练、测试、泛化误差)及过拟合(模型过度学习训练集特性)与欠拟合(模型未充分学习规律)的区别与解决方法。其次详述了四种数据集划分策略:留出法、k折交叉验证、留一法和自助法,比较了其优缺点及适用场景。最后探讨了性能度量指标,包括回归任务的均方误差,分类任务的错误率、查准率、查全率、F1分数等,强调需根据任务需求选择合适的评估标准。模型评估需平衡训练误差与泛化能力,通过合理划分数据集和选择性能度量来全面评价模型效果。

weixin_41782172的博客 1135

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

[私人笔记]西瓜书/机器学习

《机器学习》大概是非常火的一本书了,之前随便翻看了几页,感觉讲的不是特别深,就是走马观花的样子吧。今次决定挨着看一遍,记下一些key word或者是一些中英名词对照,扩充一下知识树。chap1chap2NP问题 多项式时间 留出法(hold-out) 分层采样(stratified sampling)——保留类别比例的采样方式。 自助采样(bootstrapping sampling)36.

bojackhosreman的博客 311

机器学习(周志华)学习笔记(一)

学习教材: 机器学习(周志华) 学习内容: 一、绪论 1.1 基本术语 数据集: 示例:关于一个事件或对象的描述。(Xi) 特征向量: 样本的维数:用于描述一个样本的属性个数。 标记:关于示例结果的信息。(Yi) 样例:标记信息的示例。 聚类:将训练集分成若干组。 泛化能力:学得模型适用于新样本得能力。 分类任务与回归任务的区别:分类任务用于预测离散值,回归任务用于预测连续值。 监督学习和无监督学习的区别:训练数据是否拥有标记信息。其中分类和回归是监督学习的代表,聚类是无监督学

coral_55u的博客 1721

机器学习的一般流程

机器学习的一般流程一、数据采集与标注二、数据清洗三、特征选择/构造四、模型选择五、模型训练与测试六、模型的性能评估与优化 一、数据采集与标注 二、数据清洗 三、特征选择/构造 四、模型选择 五、模型训练与测试 六、模型的性能评估与优化 ...

qq_50675813的博客 2155

零基础入门AI:归纳演绎、假设空间、归纳偏好、NFL、过拟合与欠拟合、模型评估选择、超参数、性能度量、混淆矩阵、P-R曲线和F1

y = f(x)其中,x 是机器看到的东西,y 是希望机器给出的答案,f 是机器学到的判断方法。例如:x:西瓜的颜色、根蒂和敲击声音。y:它是不是好瓜。f:根据这些特征判断好瓜的规则。

见字如面,祝您早安,午安,晚安 417

西瓜书第二章笔记-评估方法

机器学习西瓜书第二章-评估方法

Misaka_____的博客 315

周志华《机器学习》第二章 模型评估与选择 笔记及习题解答

第二章 模型评估与选择 笔记笔记经验误差与泛化误差过拟合评估法留出法交叉验证法留一法自助法性能度量 笔记 经验误差与泛化误差   学习器在训练集上的误差称为“训练误差”或“经验误差”,在新样本上的误差称为“泛化误差” 过拟合   学习器把训练样本自身特点当做所有潜在样本都会具有一样的性质,导致泛化能力下降,这种现象叫做过拟合 评估法 留出法   用“分层抽样法”将数据集D划分为两个集合:训练集SS...

qq_32735511的博客 3554

机器学习入门笔记(一):模型性能评价与选择

文章目录一.训练误差与测试误差1.1基本概念1.2训练误差1.3泛化误差(测试误差)1.4过拟合二.模型评估方法2.1 留出法(hold-out)2.2正则化2.3 交叉验证2.4 自助法 一.训练误差与测试误差 1.1基本概念 在分类任务中,通常把错分的样本数占样本总数的比例称为错误率(error rate)。比如m个样本有a个预测错了,错误率就是 E = a/m;与错误率相对的 1 - a/m 称为精度(accuracy),或者说正确率,数值上 精度 = 1 - 错误率。 更一般地,我们通常会把学习器的

逐梦er的博客 1万+

【机器学习基础】机器学习的模型评估(评估方法及性能度量原理及主要公式)

机器学习模型评估是机器学习领域中的一个重要研究方向,其研究背景在于随着大数据时代的到来,人们面临着越来越多的数据分析和处理任务,而机器学习作为一种高效的数据处理技术,在很多领域都得到了广泛应用。然而,机器学习模型的效果评估是机器学习应用过程中一个非常关键的问题,因此机器学习模型评估的研究具有非常重要的意义。

z135733的博客 2万+

机器学习学习笔记(1)——错误率、精度、准确率、召回率、F1度量

本文是我在阅读西瓜书的时候的一些学习笔记和少许理解,更多的我个人觉得算是抛砖引玉吧,如果有误,请麻烦纠正。 顺带说一句,自从看了《西瓜书》,再也不愁出去买到烂瓜了。 本文内容是机器学习算法的性能度量,西瓜书上对性能度量的定义是:衡量模型泛化能力的评价标准。简单来说就是我们要怎样评价这个算法的优劣。 目录一、混淆矩阵二、错误率与精度1. 错误率2. 精度三、准确率、召回率与F1度量1. 准确率2. 召回率3. F1度量四、参考 一、混淆矩阵 混淆矩阵也称误差矩阵,是表示精度评价的一种标准格式,用n行n.

LiQZ的博客 1万+

【分类问题中模型的性能度量(一)】错误率、精度、查准率、查全率、F1详细讲解

本文主要介绍了分类问题模型的一些常用性能度量,概念梳理清晰,并且介绍了自己的记忆技巧帮助大家记忆。

好想成为大佬啊的博客 7891
上一篇: 机器学习模型评估方法
下一篇: 机器学习模型性能评估(二):P-R曲线和ROC曲线
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值