


本文详细介绍了检索增强生成(RAG)的工作原理,并使用Python和ollama从零构建了一个完整的RAG系统。通过嵌入模型、向量数据库和聊天机器人的实现,读者可以掌握RAG系统的核心组成部分和实现方法。文章还探讨了RAG系统的改进空间和Graph RAG、Hybrid RAG等不同类型,为读者提供了从理论到实践的全面指导。
1、什么是RAG
我们先从一个没有使用 RAG 的简单聊天机器人说起:
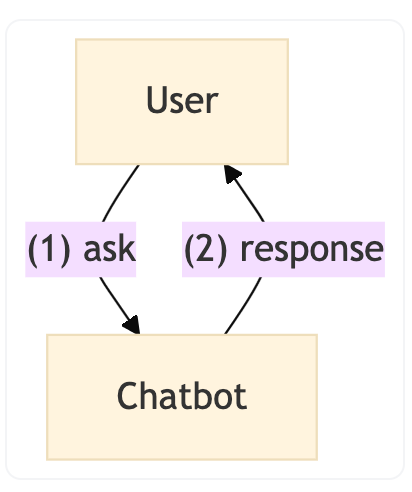
这个聊天机器人可以根据训练数据回答常见问题,但它无法访问最新的信息或特定领域的知识。
举个现实例子:你问 ChatGPT——“我妈妈叫什么名字?”
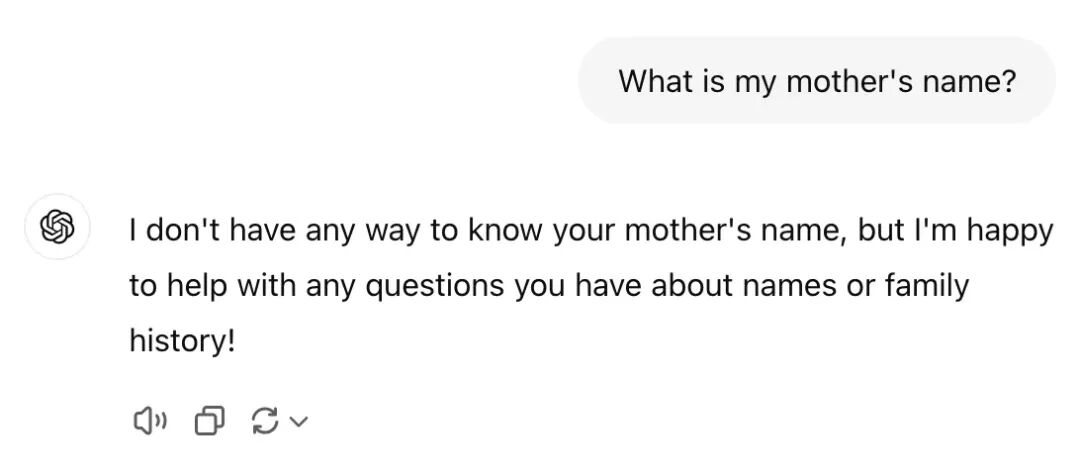
它当然回答不了,因为它无法访问外部信息,比如你的家庭成员资料。
要解决这个问题,我们需要给模型补充外部知识。比如在这个例子里,我们可以提供一份“家庭成员名单”作为外部知识来源。
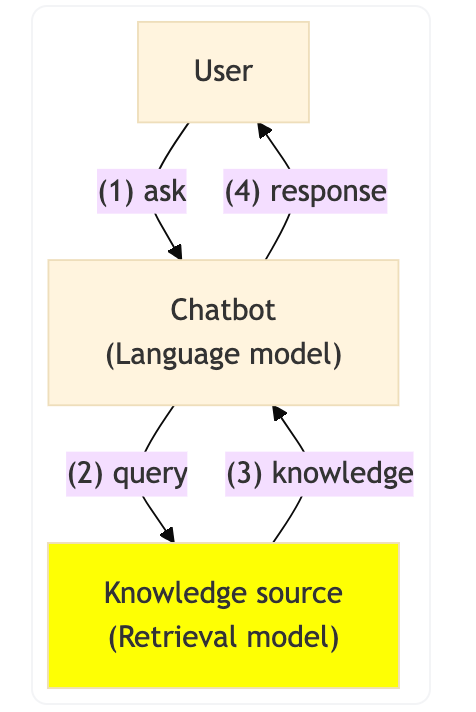
RAG 系统的两个核心组成部分:
- 检索模型(Retrieval Model):从外部知识源(例如数据库、搜索引擎或知识库)中找出与问题最相关的信息。
- 生成模型(Language Model):在检索到的信息基础上,生成最终的自然语言回答。
RAG 的实现方式有多种,比如 Graph RAG、Hybrid RAG、Hierarchical RAG 等,我们会在文章结尾简单介绍。
2、构建一个极简的RAG系统
下面我们来搭建一个简单的 RAG 系统,它能从预定义的数据集中检索信息,并基于检索结果生成回答。这个系统包括三个主要部分:
- Embedding 模型:一种预训练语言模型,用来把输入文本转换成向量,即能表示语义的数值形式。这些向量可以用来在数据集中查找相似内容。
- 向量数据库:用来存储知识及其对应的向量。常见的向量数据库包括 Qdrant、Pinecone、pgvector 等,但这里我们将从零实现一个简单的内存版数据库。
- 聊天机器人:根据检索结果生成回答的语言模型,可以是 Llama、Gemma 或 GPT 等。
索引阶段
构建 RAG 系统的第一步是索引。在这个阶段,我们需要把数据集(或文档)拆分成更小的片段(chunks),并为每个片段计算一个向量表示,方便后续快速检索。
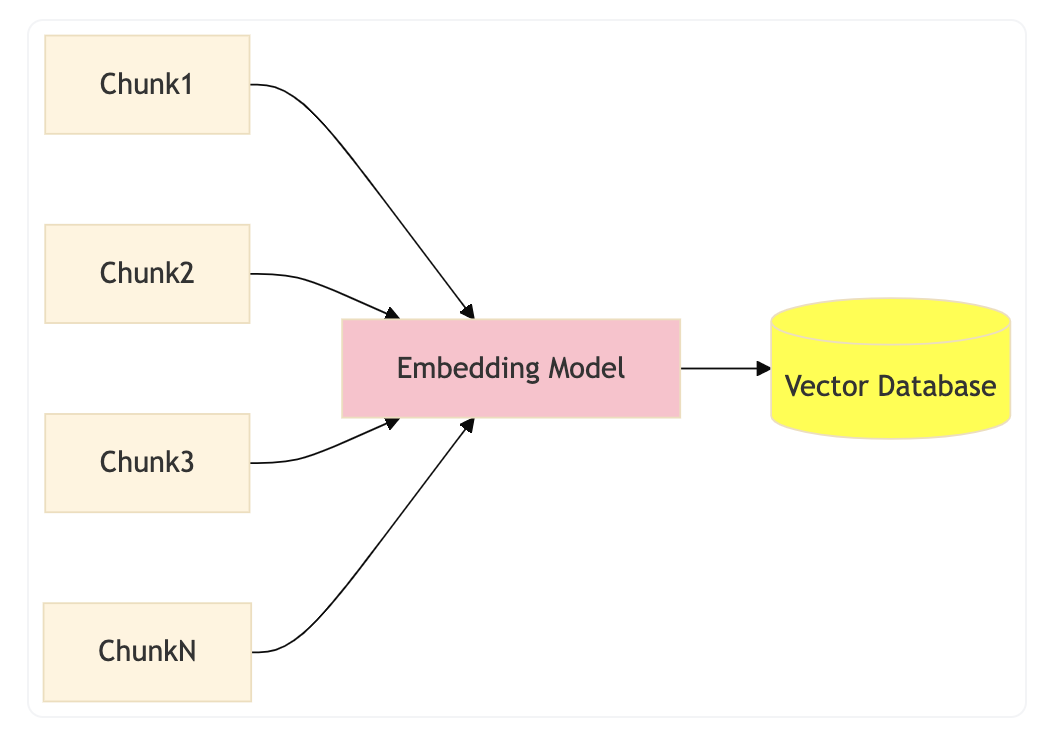
不同应用场景下,片段大小会有所不同:
- 文档检索系统中,一个片段可以是一段文字或一句话;
- 对话系统中,一个片段可以是一轮对话。
索引完成后,每个片段和它对应的向量都会被存入向量数据库中。下图展示了索引阶段后,数据库中数据的大致结构示例:
| 文本片段 | 向量表示 |
|---|---|
| 意大利和法国生产了全球超过40%的葡萄酒 | [0.1, 0.04, -0.34, 0.21, …] |
| 印度的泰姬陵完全由大理石建成 | [-0.12, 0.03, 0.9, -0.1, …] |
| 全球90%的淡水储备在南极洲 | [-0.02, 0.6, -0.54, 0.03, …] |
| … | … |
这些向量表示之后可以用来根据用户的查询检索相关信息。
你可以把它想象成 SQL 语句里的 WHERE 条件,但不同的是,这里不是精确匹配文本,而是根据向量之间的语义相似度来查找最相关的片段。
为了比较两个向量的相似度,我们可以使用余弦相似度(cosine similarity)、欧几里得距离(Euclidean distance) 或其他距离度量方法。
在这个示例中,我们将使用余弦相似度。下面是向量 A 和向量 B 之间的余弦相似度公式:
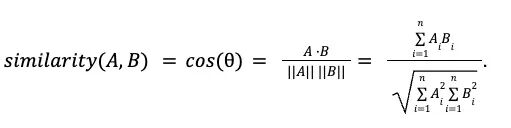
如果你对上面的公式还不太熟悉,也不用担心——我们会在下一节中亲手实现它。
检索阶段
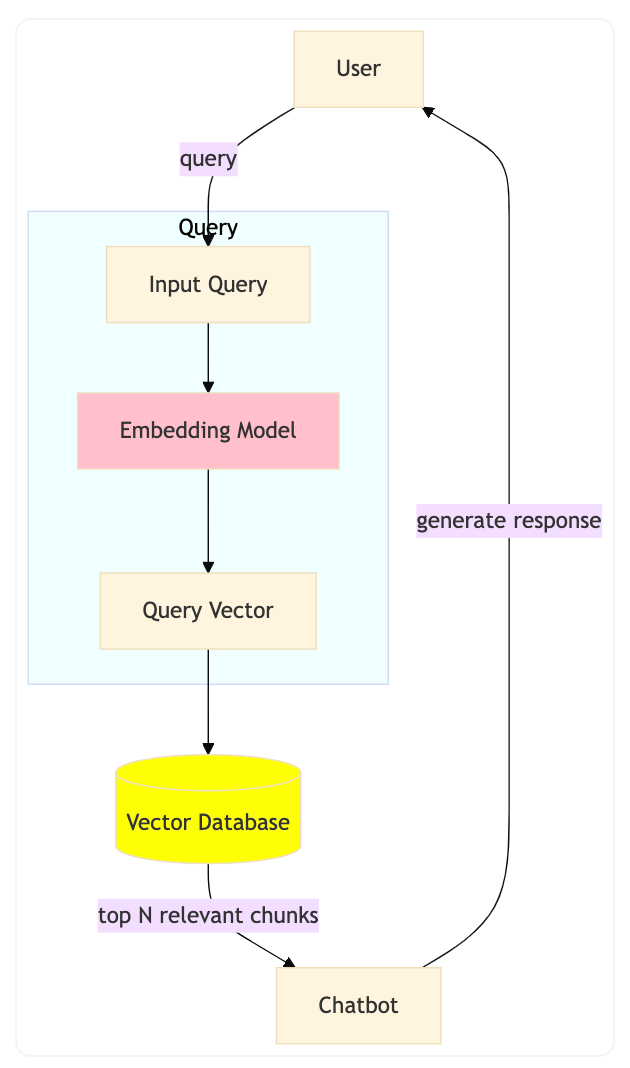
如下图所示,当用户Input Query 时,系统会先将这个查询转换成一个 Query Vector,然后将其与向量数据库中的所有向量进行比较,以找到最相关的文本片段(chunks)。
Vector Database 返回的结果会包含与查询最相关的前 N 个片段,接下来 Chatbot 会基于这些片段生成最终的回答。
开始写代码吧
在这个示例中,我们将用 Python 实现一个简单版本的 RAG 系统。
为了运行模型,我们会使用 ollama —— 一款命令行工具,可以直接运行来自 Hugging Face 的模型。
使用 ollama,你不需要连接服务器或云服务,就能在自己的电脑上本地运行模型。
我们将使用以下两个模型:
-
Embedding 模型:
hf.co/CompendiumLabs/bge-base-en-v1.5-gguf -
语言模型(Language Model):
hf.co/bartowski/Llama-3.2-1B-Instruct-GGUF
至于数据集,我们会用一份关于 cat 的简单事实列表。在索引阶段,每一条事实都会被当作一个独立的文本片段。
下载 ollama 和模型
首先,从官方网站 ollama.com 安装 ollama。
安装完成后,打开终端,运行以下命令来下载所需的模型:
ollama pull hf.co/CompendiumLabs/bge-base-en-v1.5-gguf
ollama pull hf.co/bartowski/Llama-3.2-1B-Instruct-GGUF
如果你看到下面这个输出结果,那说明你的安装成功了:
pulling manifest
...
verifying sha256 digest
writing manifest
success
在继续之前,为了在 Python 中使用 ollama,我们还需要安装 ollama 的 Python 包:
pip install ollama
加载数据集
接下来,创建一个 Python 脚本,并将数据集加载到内存中。这个数据集包含了一系列关于 cat 的事实,每条事实将在索引阶段作为一个片段使用。
你可以从这里下载示例数据集。下面是一个加载数据集的示例代码:
dataset = []
with open('cat-facts.txt', 'r') as file:
dataset = file.readlines()
print(f'Loaded {len(dataset)} entries')
实现向量数据库
现在,我们来实现向量数据库。
我们将使用 ollama 的 embedding 模型,将每个片段转换为向量表示,然后将片段及其对应的向量存入到一个列表中。
下面是一个计算给定文本向量表示的示例函数:
import ollama
EMBEDDING_MODEL = 'hf.co/CompendiumLabs/bge-base-en-v1.5-gguf'
LANGUAGE_MODEL = 'hf.co/bartowski/Llama-3.2-1B-Instruct-GGUF'
# Each element in the VECTOR_DB will be a tuple (chunk, embedding)
# The embedding is a list of floats, for example: [0.1, 0.04, -0.34, 0.21, ...]
VECTOR_DB = []
def add_chunk_to_database(chunk):
embedding = ollama.embed(model=EMBEDDING_MODEL, input=chunk)['embeddings'][0]
VECTOR_DB.append((chunk, embedding))
在这个示例中,为了简单起见,我们将数据集中的每一行都视为一个片段。
for i, chunk in enumerate(dataset):
add_chunk_to_database(chunk)
print(f'Added chunk {i+1}/{len(dataset)} to the database')
实现检索函数
接下来,我们来实现检索函数。该函数接收一个查询,并根据余弦相似度返回与查询最相关的前 N 个片段。
可以理解为:两个向量的余弦相似度越高,它们在向量空间中就越接近,也就意味着它们在语义上越相似。
下面是一个计算两个向量余弦相似度的示例函数:
def cosine_similarity(a, b):
dot_product = sum([x * y for x, y in zip(a, b)])
norm_a = sum([x ** 2 for x in a]) ** 0.5
norm_b = sum([x ** 2 for x in b]) ** 0.5
return dot_product / (norm_a * norm_b)
现在,我们来实现检索函数:
def retrieve(query, top_n=3):
query_embedding = ollama.embed(model=EMBEDDING_MODEL, input=query)['embeddings'][0]
# temporary list to store (chunk, similarity) pairs
similarities = []
for chunk, embedding in VECTOR_DB:
similarity = cosine_similarity(query_embedding, embedding)
similarities.append((chunk, similarity))
# sort by similarity in descending order, because higher similarity means more relevant chunks
similarities.sort(key=lambda x: x[1], reverse=True)
# finally, return the top N most relevant chunks
return similarities[:top_n]
生成阶段
在这一阶段,聊天机器人将根据上一步检索到的知识生成回答。具体做法是:将相关片段加入到提示语(prompt)中,然后将提示语作为聊天机器人的输入。
例如,可以这样构建一个提示语:
input_query = input('Ask me a question: ')
retrieved_knowledge = retrieve(input_query)
print('Retrieved knowledge:')
for chunk, similarity in retrieved_knowledge:
print(f' - (similarity: {similarity:.2f}) {chunk}')
instruction_prompt = f'''You are a helpful chatbot.
Use only the following pieces of context to answer the question. Don't make up any new information:
{'\n'.join([f' - {chunk}' for chunk, similarity in retrieved_knowledge])}
'''
然后,我们使用 ollama 来生成回答。在这个示例中,我们将把 instruction_prompt 作为系统消息使用:
stream = ollama.chat(
model=LANGUAGE_MODEL,
messages=[
{'role': 'system', 'content': instruction_prompt},
{'role': 'user', 'content': input_query},
],
stream=True,
)
# print the response from the chatbot in real-time
print('Chatbot response:')
for chunk in stream:
print(chunk['message']['content'], end='', flush=True)
整合全部步骤
完整代码可以在此文件(https://huggingface.co/ngxson/demo_simple_rag_py/blob/main/demo.py)中找到。
运行代码的方法:将其保存为 demo.py 文件,然后执行以下命令:
python demo.py
现在,你可以向聊天机器人提问,它会根据从数据集中检索到的知识生成回答。
Ask me a question: tell me about cat speed
Retrieved chunks: ...
Chatbot response:
According to the given context, cats can travel at approximately 31 mph (49 km) over a short distance. This is their top speed.
改进空间
到目前为止,我们已经用一个小数据集实现了一个简单的 RAG 系统,但它仍然存在不少局限:
-
无法处理多主题问题:当问题同时涉及多个主题时,系统往往给不出理想答案。这是因为当前的系统只根据“查询与片段的相似度”检索信息,而没有考虑查询的上下文。一个改进思路是——让聊天机器人根据用户输入生成自己的查询语句,再用这个生成的查询去检索知识;或者使用多个查询来获取更全面的信息。
-
检索结果排序不够精准:当前返回的是余弦相似度最高的前 N 个片段,但这不一定是最优结果,尤其当每个片段信息量很大时。改进方式是使用重排序模型,在初步检索结果的基础上再次根据相关性进行排序。
-
数据库可扩展性不足: 我们现在的数据库是基于内存的,当数据量变大时就难以扩展。可以改用更高效的向量数据库,比如 Qdrant、Pinecone、pgvector 等。
-
分片策略过于简单: 目前我们是以“句子”为一个片段。对于更复杂的任务,可能需要使用更精细的分块技术来拆分数据集,甚至在入库前对每个片段进行预处理(如去噪、摘要、关键词提取等)。
-
语言模型规模有限: 示例中使用的语言模型只有 10 亿参数(1B),对于更复杂的任务,可能需要使用更大的模型来生成更高质量的回答。
其他类型的 RAG
在实际应用中,RAG 的实现方式多种多样。以下是几种常见类型:
-
Graph RAG(图结构 RAG):将知识源表示为图结构,节点代表实体,边表示实体之间的关系。模型可以在图中“漫游”以检索相关信息。目前这一方向的研究非常活跃,可以参考相关的 Graph RAG 论文合集。
-
Hybrid RAG(混合 RAG):结合知识图谱(Knowledge Graph, KG)与向量数据库技术,以提升问答系统的表现。
-
Modular RAG(模块化 RAG):这种 RAG 超越了传统的“检索—生成”两步流程,引入了路由、调度和融合机制,从而形成一个灵活可重组的框架。它支持多种 RAG 模式(线性、条件、分支、循环等),能更好地应对复杂、知识密集型任务。
3、总结
RAG 的出现,让大模型能够更好地利用外部知识,显著提升了其准确性和实用性。
通过从零实现一个简单的 RAG 系统,我们理解了 embedding(向量表示) 、retrieval(检索) 和 generation(生成) 的核心概念。
尽管这个实现还很基础,但它展现了支撑实际生产环境中高级 RAG 系统的底层原理。
未来,RAG 的改进空间仍然广阔:从优化向量数据库的性能,到探索 Graph RAG、Hybrid RAG 等新架构,这一领域仍在快速演进中。RAG 将继续作为连接语言模型和外部知识的关键技术,帮助 AI 在保持生成能力的同时,变得更聪明、更可靠。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


大模型入门到实战全套学习大礼包
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

2、大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
3、AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

5、大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

适用人群

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 352


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


