


2025开年,AI黑马DeepSeek可谓搅翻全球,让同行们都惊到了。
这款火爆全球的DeepSeek是由国内人工智能公司深度求索自主研发的大型语言模型,它拥有强大的自然语言处理能力,就像是一个聪明又懂你的助手,能够像朋友一样理解并回答问题。根据其背后的算法和数据支持,还能帮助你写代码、整理资料,甚至解决一些复杂的数学问题。
1、DeepSeek系列模型的技术创新
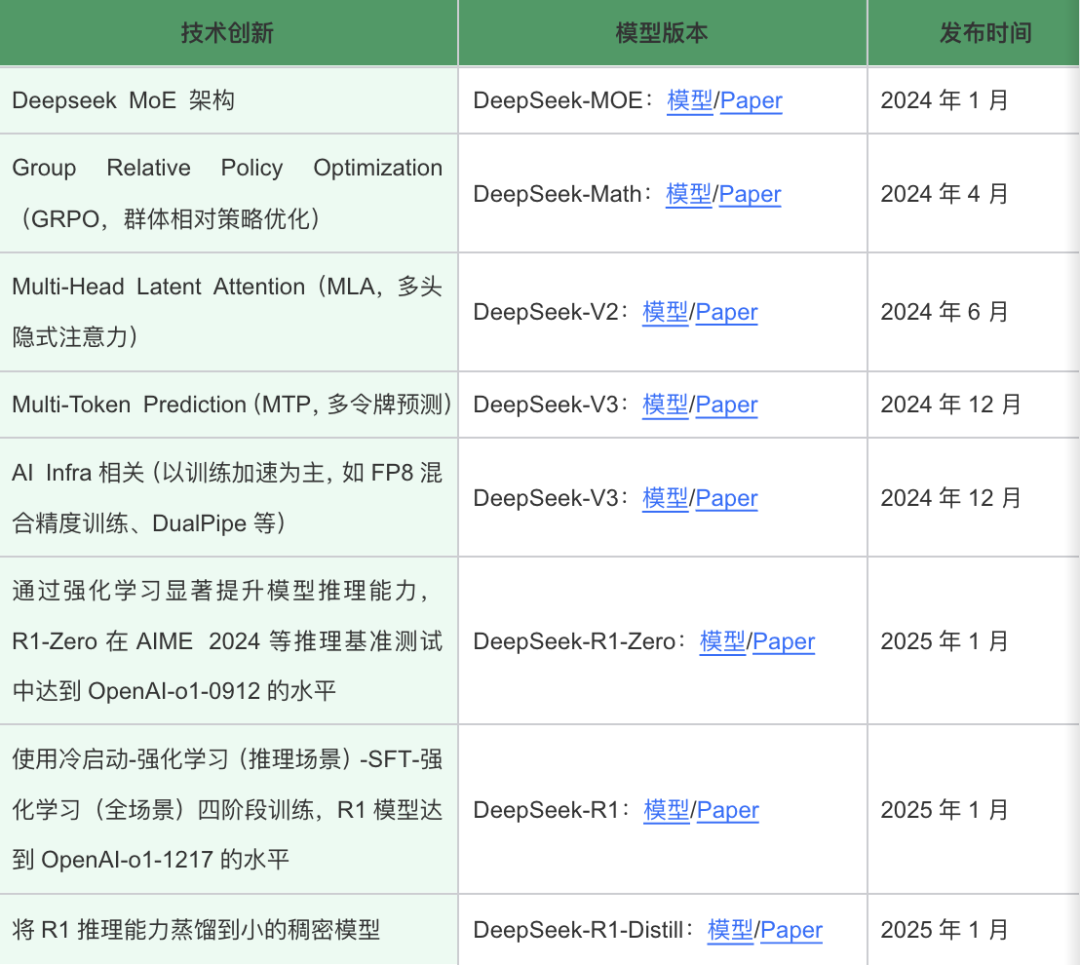
表1. DeepSeek 关键技术一览
1.1、DeepSeek MoE 架构
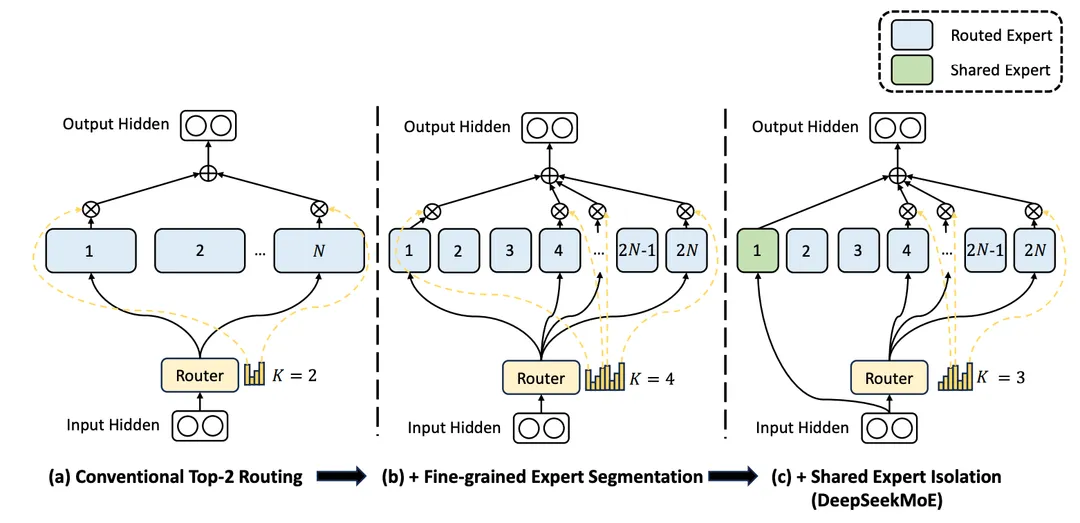
图1. DeepSeek MoE 框架示意图 @[Deepseekmoe]
图1展示了 DeepSeek 从传统 MoE 模型架构(a)的基础上,做的两部分改进(b)与(c):
- (a)传统 MoE 模块: MoE 模块包含NNN个前馈神经网络(Feed-Forward Network, FFN)专家,每个专家在处理特定类型的数据上具有独特的优势。MoE 模块通过路由机制,根据输入数据的特征动态选择最合适的KKK个专家进行处理,而不是激活所有专家。所有专家的参数总和构成了整个 MoE 模块的参数量,在前向计算过程中,由于只激活了部分专家,实际参与计算的参数量被称为激活参数量。例如,Mixtral 8*7B 模型包含8个专家,每次选择其中的2个专家进行计算,模型的总参数量为46.7B,而激活参数量为12.9B。
- (b)细粒度专家划分: 不同于传统 MoE ,DeepSeek 把NNN个专家做更细粒度的划分,降低每一个专家的参数量,增大专家数量。如图(b),将NNN个专家拆分为mNmNmN个,每一个专家的隐层维度变为原来的1/m1/m1/m,相应地激活mKmKmK个专家。如此 MoE 模块的参数量以及激活参数量均保持不变,同时还可以更加灵活地组合多个专家。
- (c)共享专家分离: 把激活专家区分为共享专家(Shared Experts)和路由专家(Routed Experts)时,如图©所示,共享专家和路由专家在数据处理流程上有显著的区别。对于共享专家,输入数据无需经过路由模块的计算,所有数据都会直接通过共享专家进行处理。相反,对于路由专家,输入数据会先经过路由模块,该模块根据输入数据的特征选择最合适的专家进行计算。在这种架构中,路由模块通过计算输入数据与各个专家的匹配概率,选择概率最高的专家进行处理。最终,将路由专家和共享专家的计算结果相加,形成 MoE 模块的最终输出。通过这种方式,模型能够在处理不同输入数据时,既能捕捉到输入数据的共性,也能关注到输入数据的差异性。这种设计能够提高模型的泛化能力和适应性。
更进一步地,DeepSeek-V3 针对MoE 中常见的负载不均衡问题,提出了一种新的负载均衡策略。在用于选择专家的 Gate 模块中引入了一个可学习的偏置项。在计算路由得分时,这个偏置项会被动态地加到每个路由专家的得分上。该方式的主要特点在于:
- 动态调整路由倾向: 通过学习偏置项,模型可以动态地调整对不同路由专家的偏好。如果某个专家的负载过重,其对应的偏置项可能会被学习为负值,从而降低其被选择的概率。反之,对于负载较轻的专家,其偏置项可能会被学习为正值,提高其被选择的概率。
- 无额外损耗: 该偏置项是直接通过模型的训练目标进行优化的,而不是通过一个独立的负载均衡损失函数。这意味着,模型在努力提高主要任务性能的同时,也会自然而然地学习到一种更均衡的路由策略,而不会因为额外的负载均衡损失而影响性能。
DeepSeek 通过这些 Moe 架构上的创新,直接促进了 V3 模型的整体效果提升。
下表是部分开源 MoE 模型的对比情况:
表2. 部分开源模型 MoE 模块配置对比
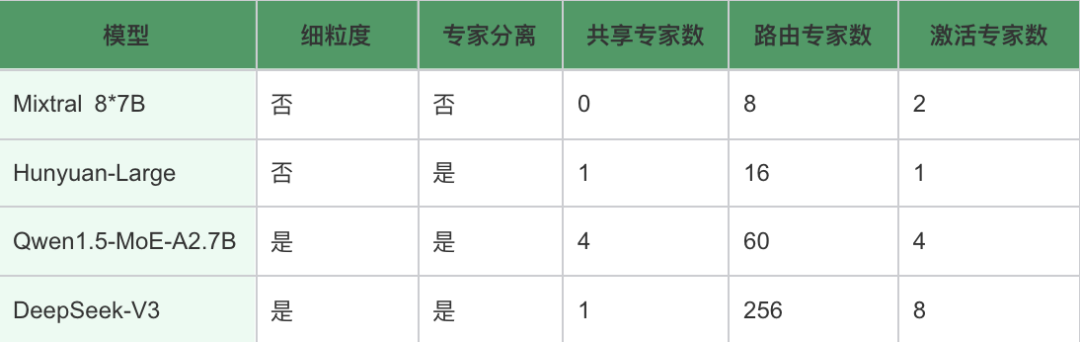
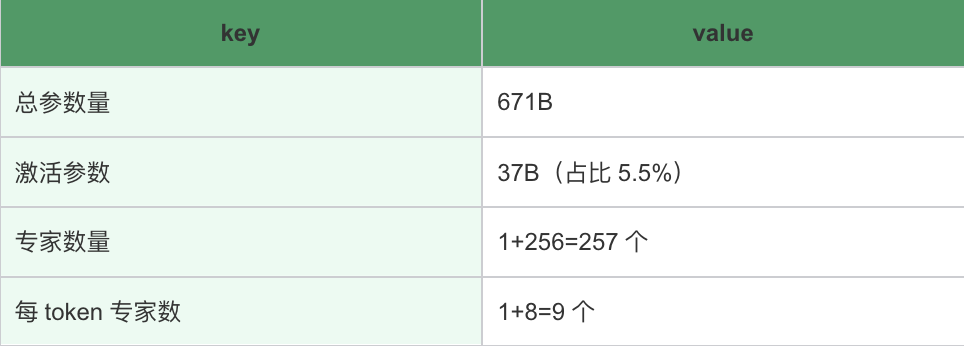
表3. DeepSeek V3 架构核心参数
1.2 群体相对策略优化(Group Relative Policy Optimization,GRPO)
大模型训练大体可以分为3种模式,预训练(Pretraining),有监督精调(Supervised Fine-Tuning, SFT),基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)。其中,SFT让模型通过学习训练数据数据分布的方式来提高模型在特定任务或指令上的表现,与其不同的是,RLHF使用人类反馈来定义奖励函数,然后通过强化学习算法优化模型。让模型能生成符合人类喜好的回复。
主流的RLHF算法有PPO(Proximal Policy Optimization)、DPO(Direct Preference Optimization)以及本节介绍的GRPO等。强化学习的基础理论具有较高的综合性以及深度,想要深入阅读的同学可以参考相关资料。
在介绍GRPO之前,需要先了解PPO算法,因为GRPO可以算作是PPO的计算效率优化版本,在保持效果的同时,降低计算资源消耗。在强化学习领域,PPO 算法被广泛认为是强化学习中的基准算法之一。PPO 采用了 Actor-Critic 架构,这一架构可以形象地理解为:有一个演员(actor)在舞台上表演,而一个评论家(critic)在台下观看。演员的目标是通过不断调整自己的表演行为来获得观众的认可,并从观众那里获得及时反馈。而评论家的任务则是评估演员的表演,并提供全面的建议。
在自然语言处理(NLP)生成模型的场景中,被训练的模型相当于演员,其表演即为生成的回复。相应地,会有评论家和观众模型来评价回复的质量。具体来说,PPO使用了四个模型:
- Policy 模型(又称 Actor):输入一段上文,输出下一个token的概率分布。该模型需要训练,是我们最终得到的模型。输出下一个token即为Policy模型的“行为”。
- Value 模型(又称 Critic):用于预估当前模型回复的总收益。该总收益不仅局限于当前token的质量,还需要衡量当前token对后续文本生成的影响。该模型需要训练。
- Reward 模型:事先用偏好数据进行训练,用于对Policy模型的预测进行打分,评估模型对于当前输出的即时收益。
- Reference 模型:与 Policy 模型相同,但在训练过程中不进行优化更新,用于维持模型在训练中的表现,防止在更新过程中出现过大偏差。
为了更直观地理解 Value 模型的总收益和 Reward 模型的即时收益,可以用“磨刀不误砍柴工”来举例说明。假设现在有一把钝刀,一分钟可以劈一根柴火;如果把刀磨锋利了,一分钟就可以劈两根柴火。现在你可以选择直接用钝刀劈柴,或者先把刀磨锋利。前者的当前收益比后者高,但未来的收益会低。也就是说,Value 模型会对后者“磨刀”这一行为更为推崇,而 Reward 模型会给前者“直接砍柴”一个更高的分数。
PPO 在大模型的 RLHF 阶段被成功应用,不断提升模型回复表现的上限。然而,PPO 在计算成本和训练稳定性方面仍然存在一定的挑战。GRPO 算法对此进行了优化,其核心目标是去除 Value 模型,以此来减少训练的计算资源。
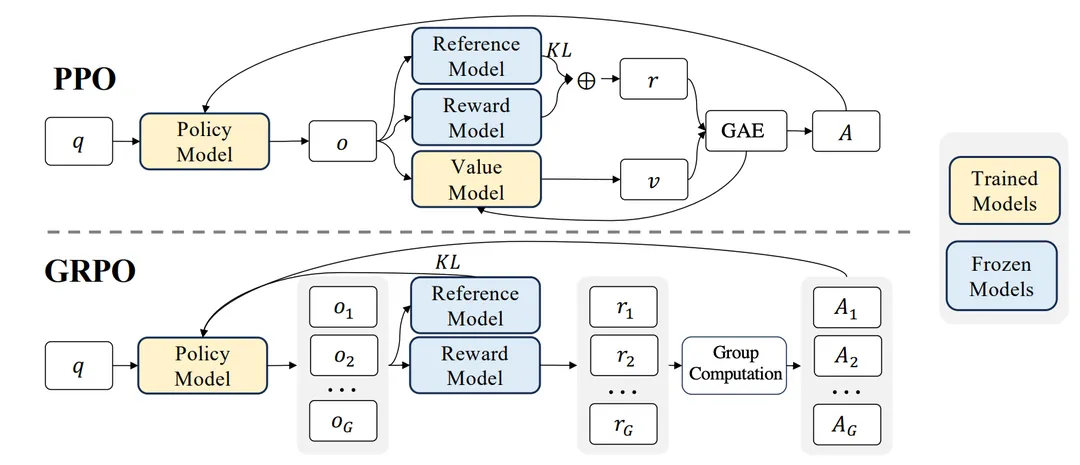
图2. PPO vs. GRPO @[Deepseekmath]
图2展示了 GRPO 相对于 PPO 的改进。传统的 PPO 使用 Value 模型来估计模型回复的总收益,这实际上是对未来模型回复各种可能性的一个平均分值估计。而 GRPO 的方法是通过,大模型根据当前的上文输入进行多次采样,生成多个预测结果oio_{i}oi,并分别使用 Reward 模型对这些预测结果进行评分得到rir_{i}ri,最后取这些评分的平均值来替代 Value 模型的预期总收益估计。通过这种方式,GRPO 在训练过程中可以减少一个模型的前向和反向传播计算,从而降低计算资源的消耗。
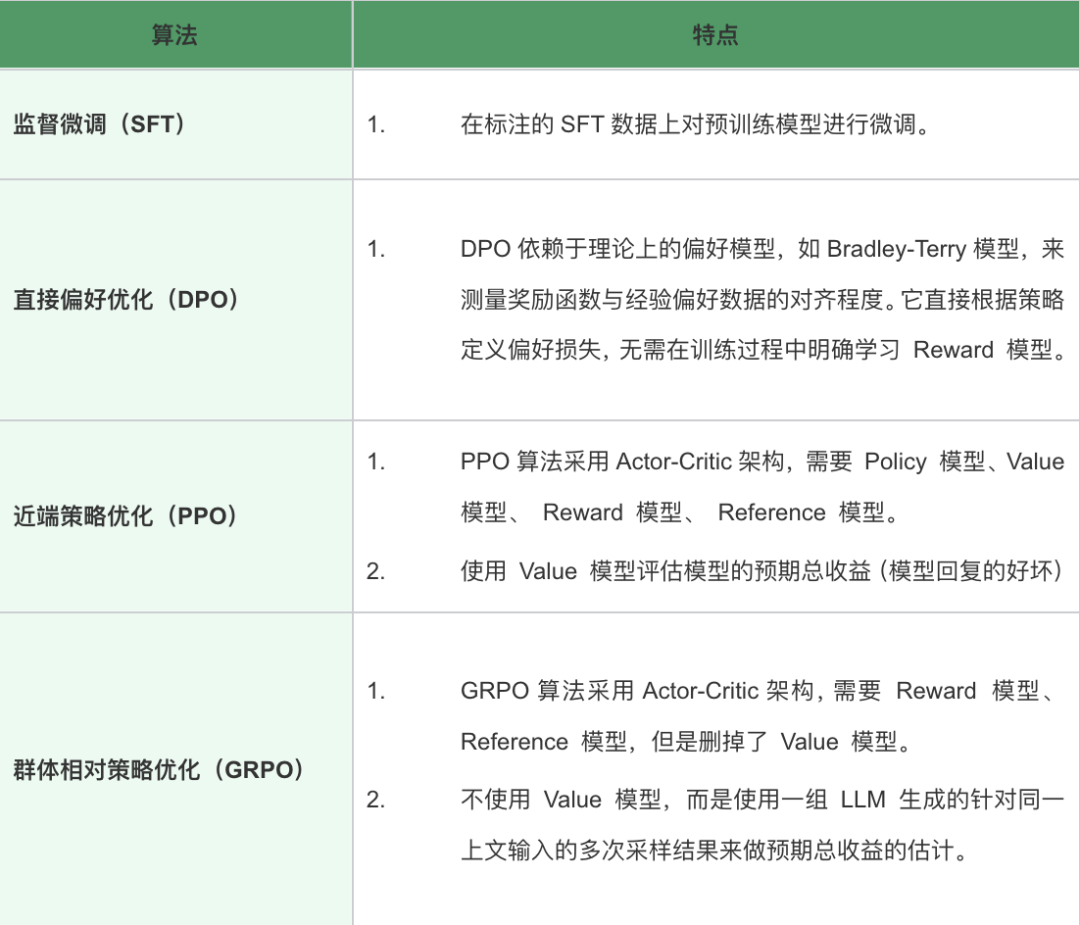
下表针对 SFT 以及主流的一些强化学习方法做了对比和总结:
表4. SFT 与 RLHF 算法特点
1.3 多头隐式注意力(Multi-Head Latent Attention,MLA)
在标准的 Transformer 模型中,多头注意力(Multi-Head Attention, MHA)机制通过并行计算多个注意力头来捕捉输入序列中的不同特征。每个注意力头都有自己的查询(Query, Q)、键(Key, K)和值(Value, V)矩阵。对于序列中的每一个 token,都需要计算各自的 QKV,进而计算注意力。在推理过程中,当前大模型所采用的 token by token 递归生成方式,上文 token 的 KV 计算不会受到后续生成 token 的影响,因此可以缓存下来,避免重复计算,提高推理效率,这就是 KV cache 的由来。也就是说,当生成第t+1t+1t+1个 token 时,可以利用之前事先算好的上文ttt个 token 的 KV 值。同样地,t+1t+1t+1位置 token 的 KV 值计算出来后也将保存在 KV cache 中。
目前大模型对于注意力机制做的一些改进,包括MQA (Multi-Query Attention)、GQA (Group Query Attention)都是为了想方设法减少 KV Cache。DeepSeek 提出的 MLA 的出发点也是如此。减少KV Cache就可以实现在更少的设备上推理更长的Context,或者在相同的Context长度下让推理的batch size更大,从而实现更快的推理速度或者更大的吞吐总量。最终目的都是为了实现更低的推理成本。
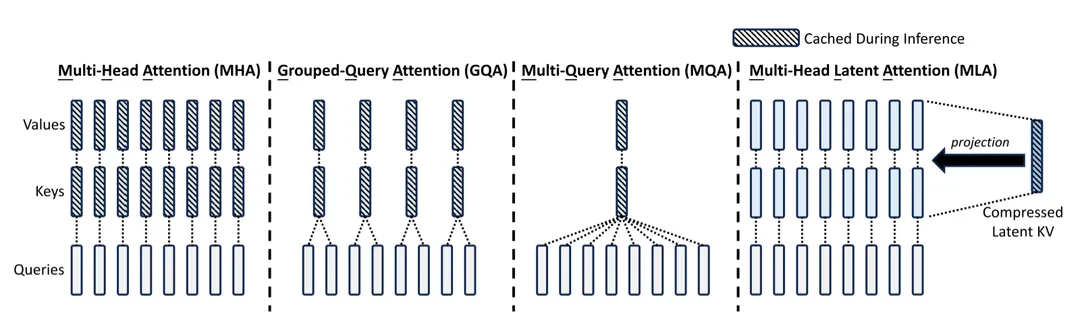
图3. MHA, MQA, GQA 与 MLA@[Deepseek-v2]
如图3所示,MQA 与 GQA 的办法是通过共享 K,V 的注意力头,降低 KV Cache的数据维度。MLA 的办法本质上是对原本 MHA 的 KV Cache 作低秩分解,得到一个低维的隐向量(Latent Vector)。在推理阶段,MLA 只需要缓存该隐向量,由此大大降低需要缓存的数据量。
具体地,对于某一层某一个 token 的表征hth_{t}ht, MLA 通过降维映射矩阵 (down-projection matrix)$ {W}^{DKV} 得到对得到对得到对K、、、V$压缩后的隐向量:
ctKV=WDKVht{c}^{KV}_{t}={W}^{DKV}{h}_{t}ctKV=WDKVht
在前向过程中,需要对此隐向量进行升维还原,即:
$ {k}{C}_{t}={W}{UK}{c}^{KV}{t} ; {v}{C}_{t}={W}{UV}{c}^{KV}{t} $
其中,WUK{W}^{UK}WUK与WUV{W}^{UV}WUV为对应的升维映射矩阵(up-projection matrix),可得到hth_{t}ht对应的KKK、VVV向量ktC{k}^{C}_{t}ktC、vtC{v}^{C}_{t}vtC。可以这么理解,MLA利用低秩分解的办法,通过增加少量的模型参数变量(降维映射矩阵与升维映射矩阵),引入低维隐向量ktC{k}^{C}_{t}ktC作为 KV Cache,降低 KV Cache 所带来的显存压力,以此降低推理成本。
此外,DeepSeek 还将 Query 也进行了低秩分解,能够在训练过程中降低显存占用,以此提高训练资源利用率。
上述方案还需要针对位置编码RoPE(Rotary Position Embedding)进行处理。因为如果在隐向量hth_{t}ht中包含RoPE,经过升降维操作后,会对位置信息造成破坏。为了解决这个问题,MLA(Multi-Head Linear Attention)提出了“解耦RoPE”的方法。具体来说,对于隐向量ctKV{c}^{KV}_{t}ctKV,不将位置编码包含在其中,而是专门为注意力头的 Query 和 Key 新增向量维度,以添加 RoPE 的位置信息。
使用了 MLA 的 DeepSeek V2 (总参数量236B,激活参数量21B),和 DeepSeek 67B 相比,模型效果上显著提升,同时节省了42.5%的训练成本,减少了93.3%的 KV Cache,并将最大生成吞吐量提高了5.76倍。
1.4 多令牌预测(Multi-Token Prediction,MTP)
当前主流的采用自回归的大模型都是单 token 预测。即根据当前上文预测下一个最可能的 token。而 MTP 的核心思想是让模型一次性预测多个 token,以提升了模型的训练效率、生成质量和推理速度。
比如现在上文是“今年春节的天气”,传统的单 token 预测模式会逐 token 预测“真的”、“好”、“冷”、“。”;而 MTP 会并行地预测这几个 token 。因此,模型不仅要学习预测下一个 token 的能力,还需要同时具备预测下nnn个token的能力。
这种方式在推理角度的好处显而易见,一次性生成多个 tokens,减少自回归生成的步数,达到推理加速效果。而在训练过程中,MTP 的训练目标函数同时考虑了多个 token 的估计准确性,因此被认为可以捕捉 token 间的依赖关系,从而提升模型效果。
这里将简单介绍 DeepSeek V3 的 MTP 模块,与 Meta 的 MTP 模块[6]相比,DeepSeek 采用了级联式的结构,使用k个串行模块来预测k个token,保留因果语言模型(Causal Language Model)的连接关系,有利于效果的提升,如图4所示:
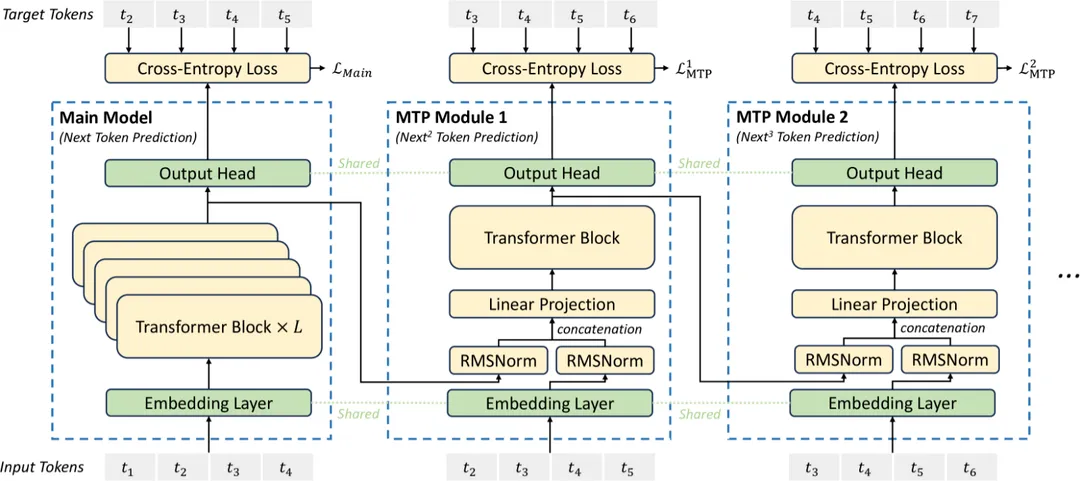
图4. DeepSeek V3 MTP 模块结构示意图@[Deepseek-v3]
图中展示了模型用DDD个顺序的模块,预测DDD个 tokens。定义预测深度为kkk的含义为,预测后续第kkk个 token。
首先,在每一个预测深度模块中,都共享了一个嵌入层(embedding layer),即模型除了最后负责最后预测部分的层之外,其他的所有层,用于得到 token 的 embedding。对于输入的第iii个token,在第kkk个预测深度处,模型将前一个深度的表示与第i+k−1i+k-1i+k−1 的 embedding 拼接,作为新的输入表示。
然后通过一个预测深度kkk专用的 Transformer 模块,生成当前预测深度的输出表示,将用于下一个深度的表示计算,同时用共享的输出层获得 token 预测, 与训练样本中i+ki+ki+k计算损失。
DeepSeek V3 论文中报告了使用 MTP 模块的效果。他们在推理过程中,不使用 MTP 模块,只在训练过程中利用该模块约束模型的优化。实验结果表明,使用 MTP 模块训练,能够提升模型的回复质量,在 MMLU, GSM8K 等公开基准测试指标均有提升。
1.5 混合精度框架
DeepSeek-V3 模型使用了 FP8 训练,为了增强训练稳定性以及维持训练效果不至于下降太多,作者提出了一种精细的量化策略,另外为了进一步减少MoE训练中的内存和通信开销,作者在FP8中缓存和分发激活值,同时以BF16格式存储低精度优化器状态。在实验中,FP8训练模型与BF16基线相比,相对损失误差始终低于0.25%,在训练随机性范围内是可以接受的。
基于此,DeepSeek-V3 文中提出了一种 FP8 训练的混合精度框架。在这个框架中,大多数计算密集型操作在 FP8 中进行,而一些关键操作则保持其原始数据格式,以平衡训练效率和数值稳定性。为了加速模型训练,主要的核心计算内核(如General Matrix Multiplication,GEMM操作)在 FP8 精度下实现,这些操作接受 FP8 张量作为输入,并生成 BF16 或 FP32 格式的输出。所有与线性操作相关的三个 GEMM(前向传播、激活反向传播和权重反向传播)都在 FP8 中执行,这种设计理论上将计算速度提高了一倍。此外,FP8 权重反向传播 GEMM 允许激活值以 FP8 格式存储,以便在反向传播中使用,从而显著减少了内存消耗。
训练框架在以下组件中保持了原始精度(如BF16或FP32):Embedding 模块、输出头、MoE门控模块、归一化算子和注意力算子等。这些高精度的保留确保了DeepSeek-V3的稳定训练动态。为了进一步保证数值稳定性,作者将模型的主权重、权重梯度和优化器状态均存储在更高的精度中。该混合精度框架示意图可见图5。
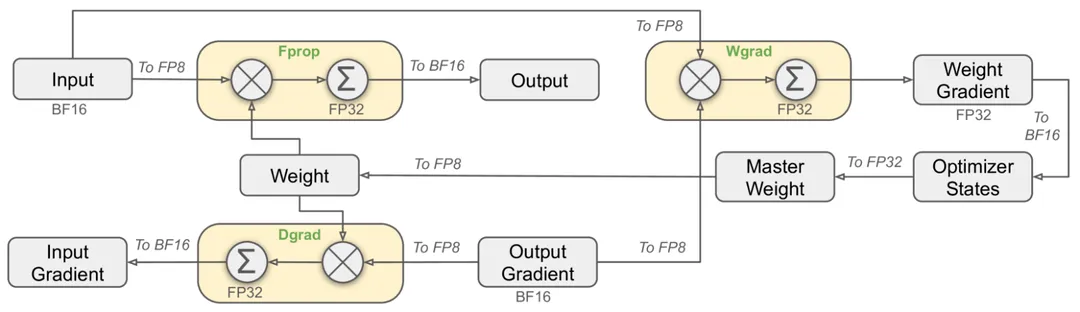
图5. DeepSeek V3 混合精度框架(FP8训练)示意图@[Deepseek-v3]
除了混合精度框架之外,DeepSeek 在 AI Infra 方面做了许多工作,例如还提出了 DualPipe 算法等,提升了模型训练效率。这方面的工作也期待 Infra 团队有更细致的分享。
1.6 Deepseek V3 总结
DeepSeek-V3 是一个在2048 个 NVIDIA H800 GPU 的集群上进行训练得到的超大型MoE架构的大语言模型。它延续了Deepseek MoE、Deepseek V2等模型的一系列创新,进一步提出了MTP,并优化了训练的效率,取得比较好效果的同时,提高了训练的效率,节约了成本。
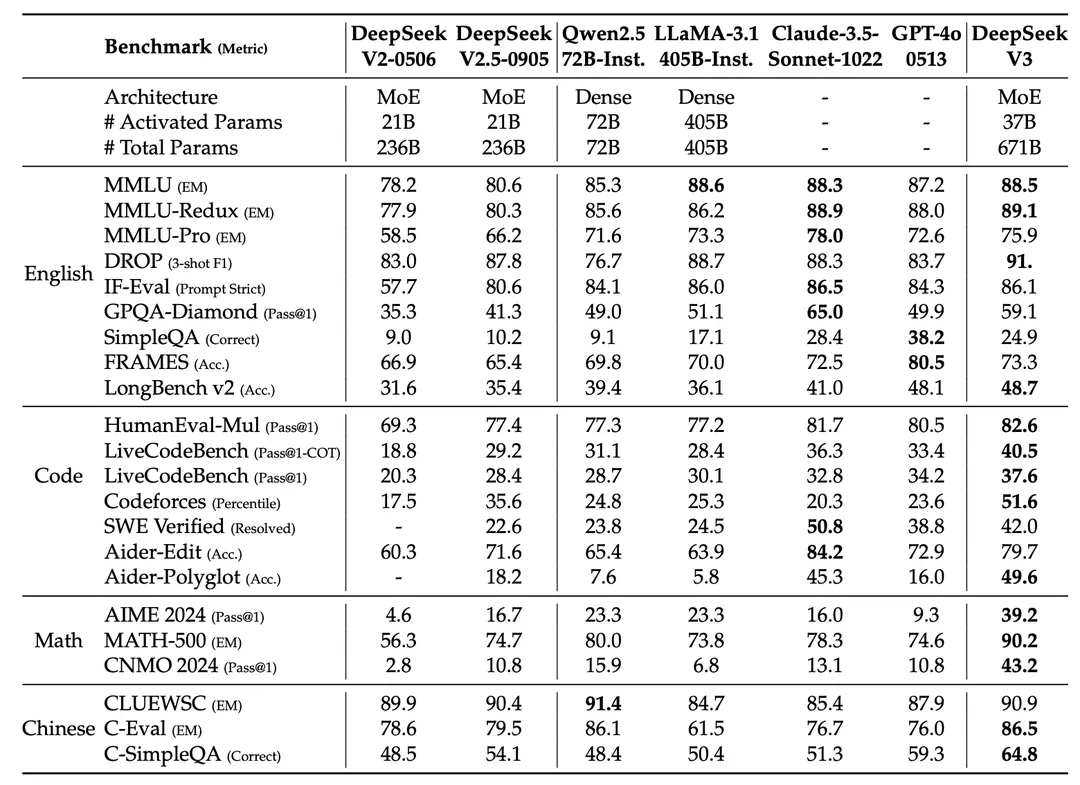
表5、表6展示了 DeepSeek V3 为人瞩目的训练成本以及开源基准评测效果。
表5. DeepSeek V3 训练成本*@[Deepseek-v3]*
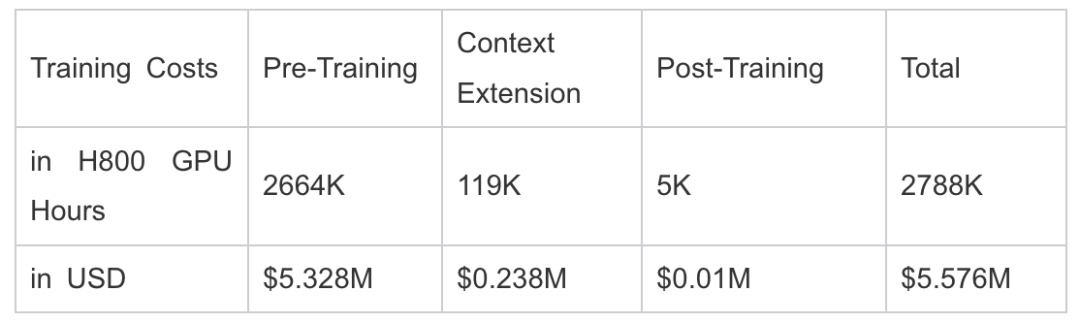
表6. DeepSeek V3 与其他 Chat 模型开源基准评测效果*@[Deepseek-v3]*
2、DeepSeek R1-Zero和R1
2.1 GPT-4、GPT-4o、o1、R1等概述
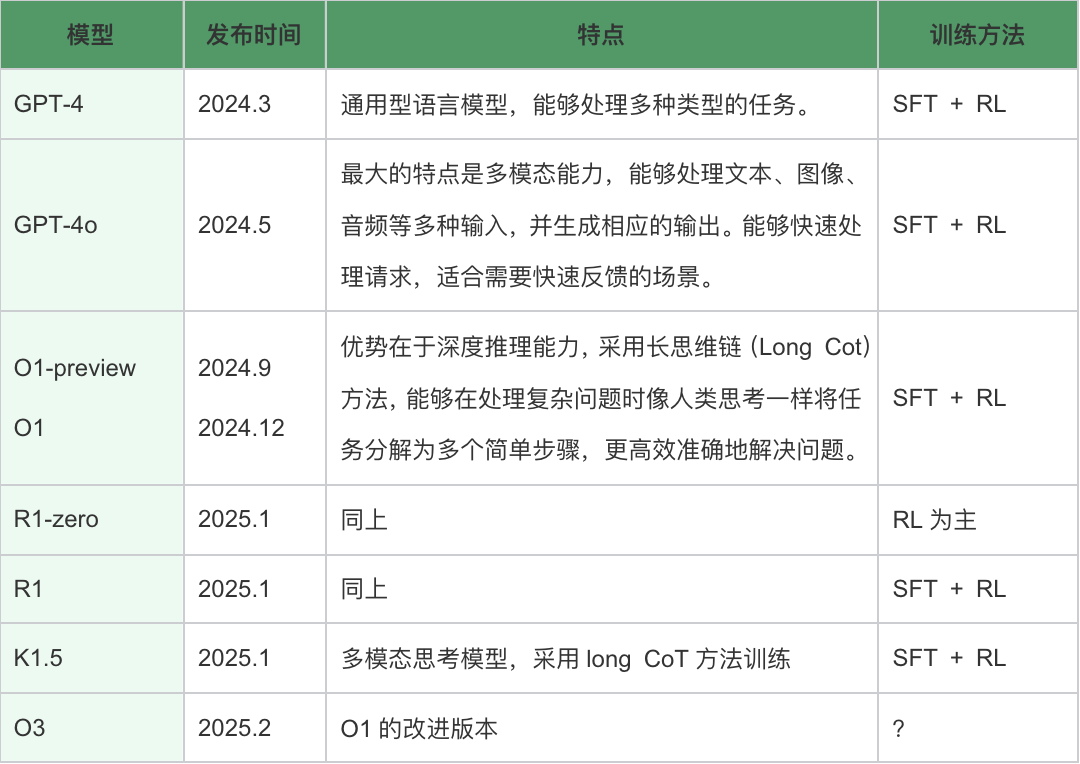
GPT-4是ChatGPT-3.5的迭代升级,在效果和性能上有了显著提升;GPT-4o增加了多模态功能;o1专注于深度推理能力。R1跟o1类似,也是专注于深度推理能力的模型。下表是不同模型的简单对比。
表7. DeepSeek 与 OpenAI 模型对比
2.1.1 CoT与Long CoT
CoT指的是一种推理过程,其中模型在生成最终答案之前,先逐步推导出一系列的中间步骤或子目标。这些中间步骤构成了一个“思维链”,最终引导模型得到正确的结果。它模仿人类的推理过程,即人们往往在解决问题时不是直接得出答案,而是通过一系列的思考、分析和推理步骤。
Long-CoT(长思考/慢思考)是CoT的一种扩展形式。传统的CoT方法通过将复杂问题分解为一系列中间推理步骤来引导模型进行逐步推理。而Long-CoT则进一步扩展了这种思路,使得思考过程和输出的答案解耦,可以通过更长的上下文和更复杂的推理路径(在思考过程中通过加入问题复述、思考回顾、反思、知识回忆、公式化等思考节点)来增强模型的推理能力。
DeepSeek 公开了他们 R1 的技术细节,比如所采用的对话模版,如图6所示。DeepSeek 对社区的贡献还在于,他们提供的 API 展示了模型的思考过程,让从业人员以及使用者能够全方位地了解到 Long-CoT 的特点与作用。图7展示了我使用 DeepSeek 的深度思考以及联网搜索的一个示例,实实在在地感受到了模型的强大。
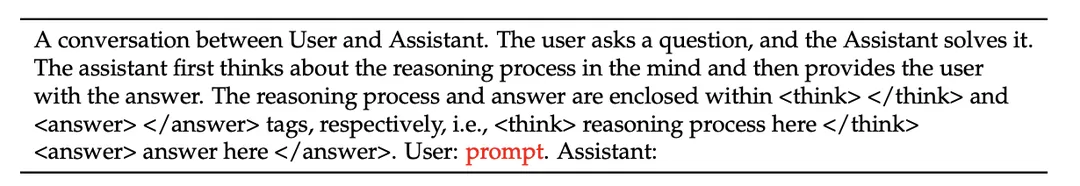
图6. DeepSeek-R1-Zero 对话模版@[Deepseek-r1]
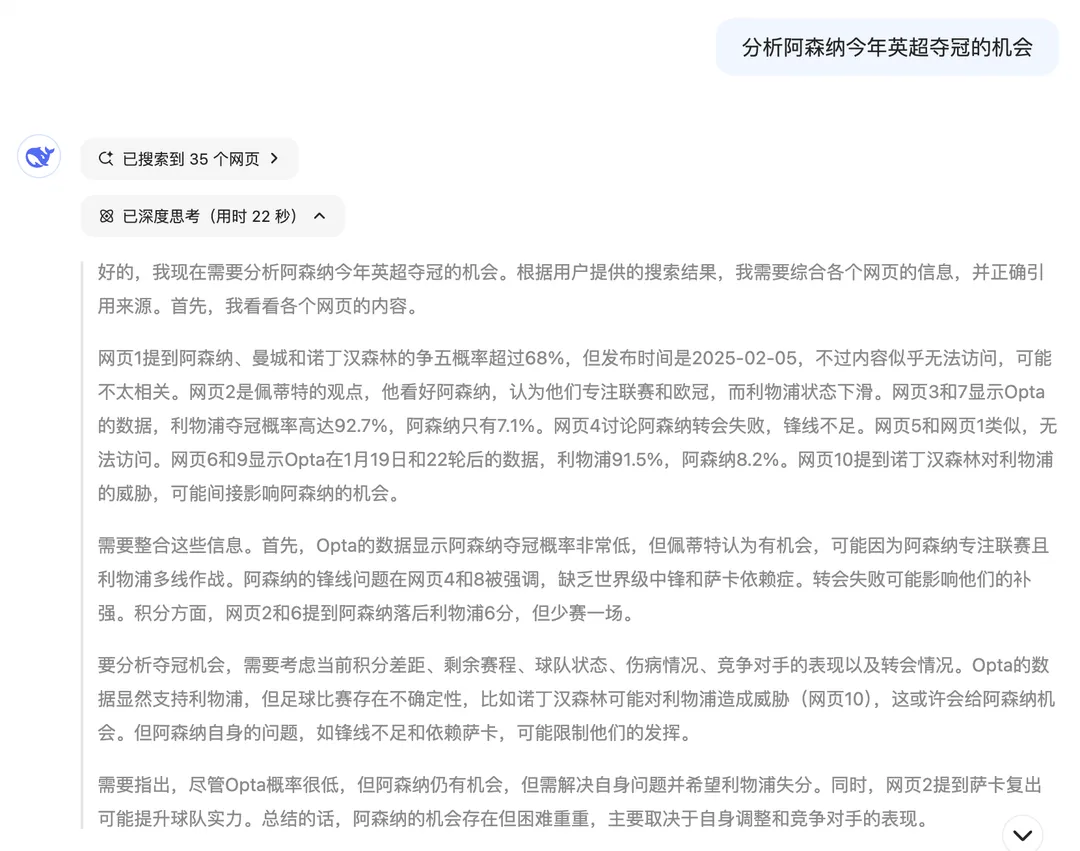
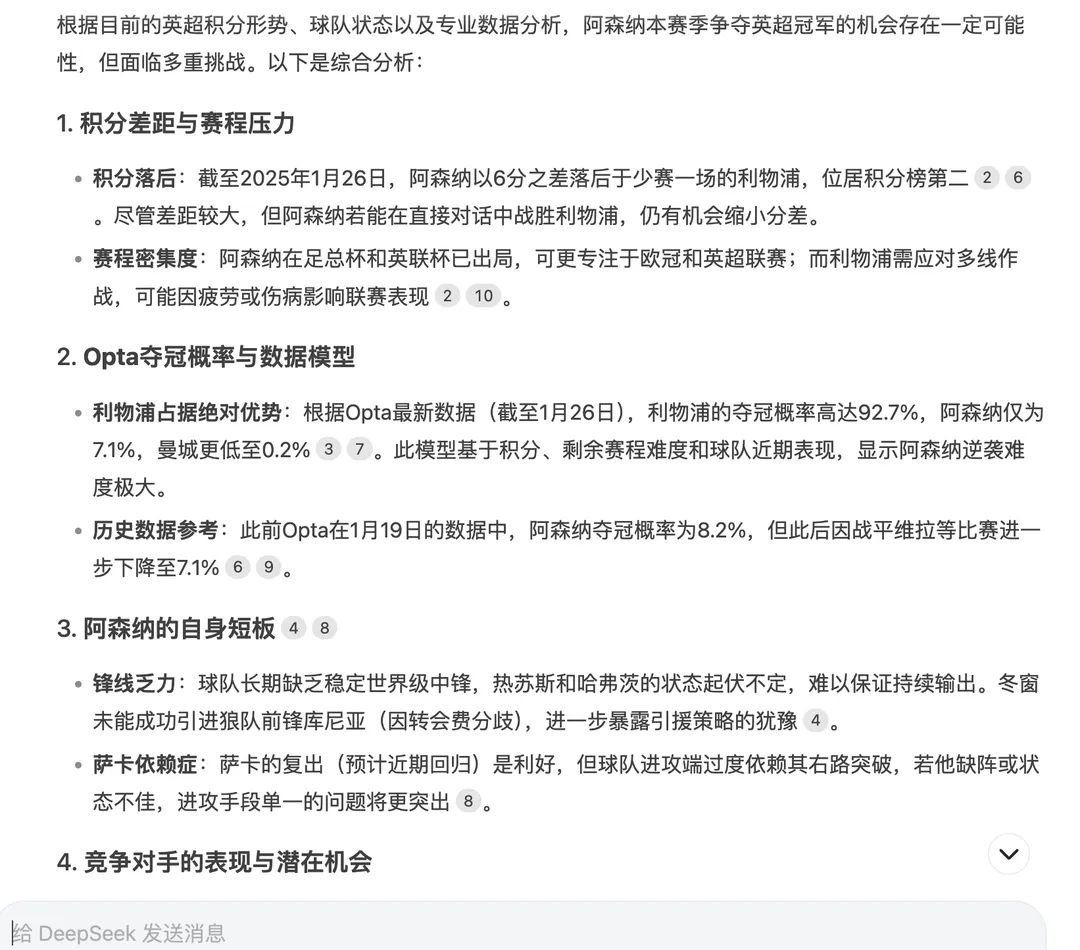
图7. DeepSeek 使用示例,开启了深度思考与联网搜索
2.1.2 R1与o1、o3在效果、速度、价格方面的比较
R1与o1、o3的区别除了训练方法,还体现在效果、速度、价格几个方面。在(@artificialanalysis)给出了具体的评测结果。
在整体的评分上来看,o3-mini 和 DeepSeek R1评分一样,不相上下。
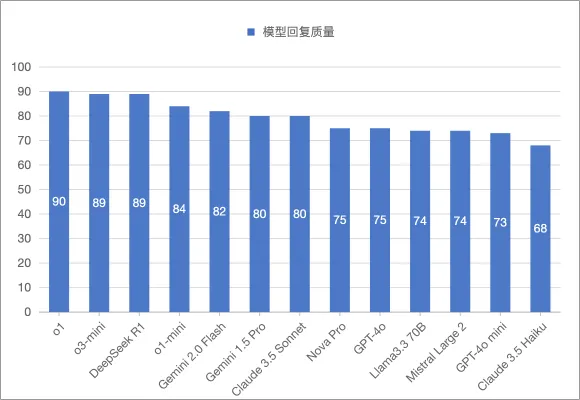
图8. 主流模型Artificial Analysis评测效果-模型回复质量评分@artificialanalysis
o3-mini模型应该更小,主打低延迟,在输出token推理速度上比DeepSeek R1快10倍,比o1快7倍。
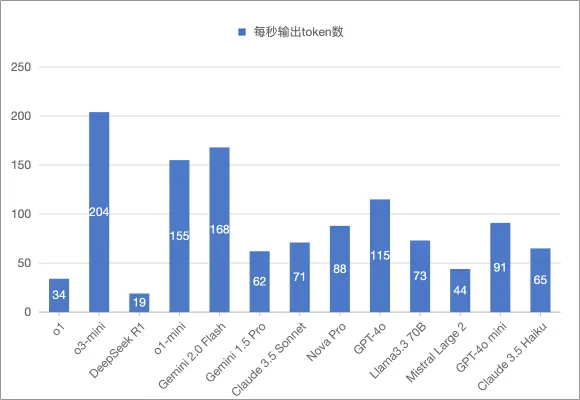
图9. 主流模型Artificial Analysis评测效果-推理速度@artificialanalysis
从整体价格上,o3-mini的价格已经比DeepSeek-R1价格更低,比o1模型的价格便宜了13倍以上,优化了许多。
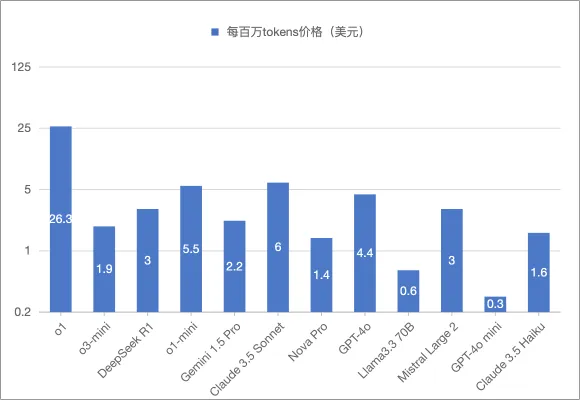
图10. 主流模型Artificial Analysis评测效果-价格@artificialanalysis
2.2 DeepSeek R1 和 R1 Zero 模型的突破
DeepSeek R1和R1 Zero模型的突破主要体现在以下几个方面。
-
强大的推理能力
DeepSeek R1 和 R1 Zero模型在多个推理基准测试中表现出色。值得注意的是,DeepSeek-R1-Zero 是第一个公开的研究,验证了 LLM 的推理能力可以完全通过强化学习(Reinforcement Learning,RL)来激励,而不需要 SFT。也表明了强化学习可以促进模型自我进化。这一里程碑式的成就,不仅突显了该模型的创新基础,也为以 RL 为中心的推理 AI 进一步铺平了道路。
表8. DeepSeek-R1-Zero 与 OpenAI o1 模型在推理类开源基准测试中的效果对比*@[Deepseek-r1]*
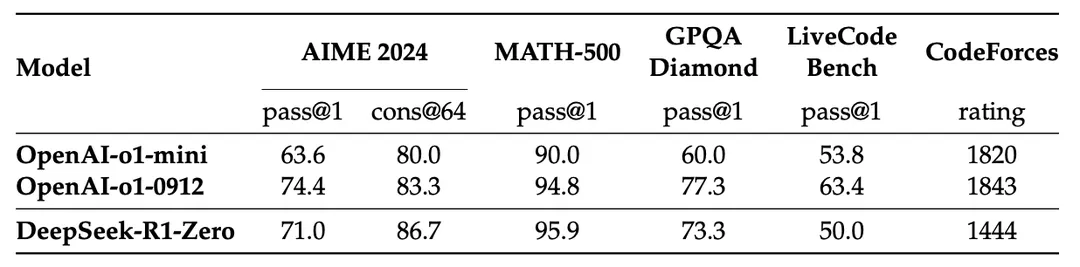
表8截取自 DeepSeek R1 报告,展示了DeepSeek-R1-Zero 与 OpenAI o1 相媲美的效果。
-
可解释性
DeepSeek R1 和 R1 Zero 模型采用 Long CoT 方法,能够清晰地展示其推理过程(o1只能展示部分),提高了模型的可解释性。其中给出的思考过程也是一个非常有研究价值的内容,有助于大模型领域的发展。
-
开源和低成本
DeepSeek R1 和 R1 Zero 模型是开源的,开发者和研究人员可以自由地探索、修改和部署它们。 此外,DeepSeek R1 的 API 定价也比 OpenAI o1模型更低,约为其1/10。
2.3 DeepSeek R1和R1 Zero模型技术介绍
DeepSeek R1 和 R1 Zero 模型的主要差异在于训练方法。DeepSeek R1 Zero 仅用强化学习就训练出了一个效果接近OpenAI-o1-0912的推理模型。发现了通过设定基于规则的 Reward 模型(要求保证答案和格式的准确性),能够在强化学习的训练过程中不断进化,出现了“aha moment”顿悟时刻以及最终取得了出色的模型效果。
DeepSeek R1 Zero 的表现令人惊叹,我们也相信这套方案还有潜力可以挖掘。不过现阶段,R1 Zero的回复会出现可读性差或语言混杂的情况。因此,DeepSeek 基于R1 Zero的成果,设计了一个多阶段的训练策略并且添加了许多高质量 SFT 数据。在这样的“人工干预”下,训练出了一个效果更优的模型 DeepSeek R1。
R1系列模型的训练流程如图11所示:
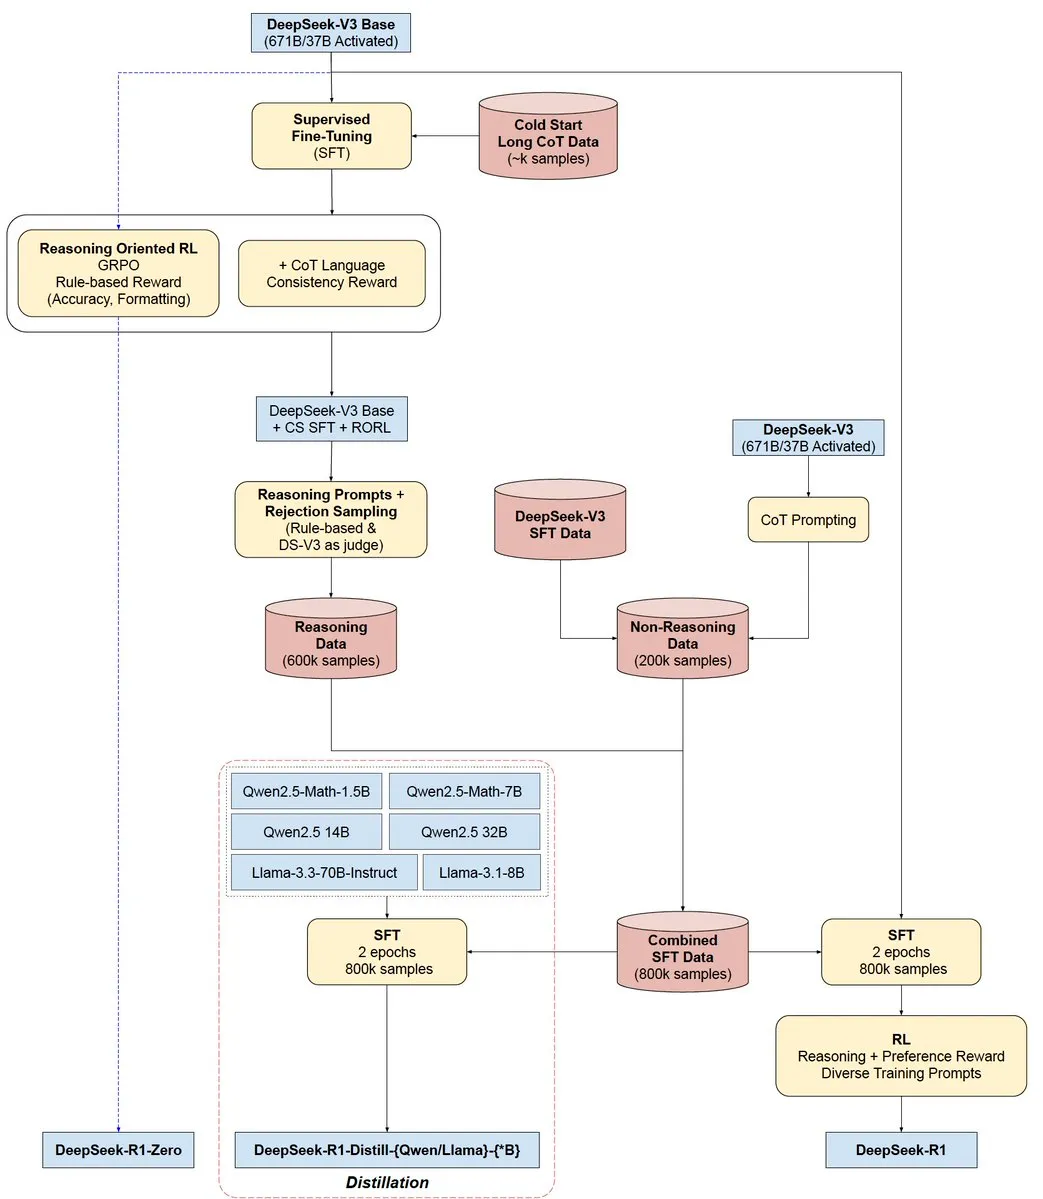
图11. DeepSeek-R1-Zero,DeepSeek-R1 与 DeepSeek-R1-Distill 模型训练流程框图@SirrahChan
2.3.1 DeepSeek R1 Zero
R1-Zero 的特别之处在于,它无需经过 SFT 训练集进行训练就能够在推理任务中表现出色。它的训练过程直接从一个预训练的基础模型(DeepSeek V3 Base)开始,通过强化学习训练完成。
具体来讲:
- 采用群体相对策略优化(GRPO),节省RL的训练成本。
- 在RL训练过程中,采用Rule-based奖励,主要由两种奖励构成:a) Accuracy rewards:评估模型的输出是否正确;b) Format rewards:强制模型将其思考过程置于指定的<think><think><think>和</think></think></think>之间。
- 设计训练模版,指导基模型在训练过程中遵守设定的指令,即图7。
DeepSeek-R1-Zero 展示出了自我进化能力,随着强化学习训练进程的深入,模型的思考时间在增加,并自发出现了诸如反思,模型重新审视和重新评估其先前步骤以及探索解决问题的替代方法等更加复杂的行为。
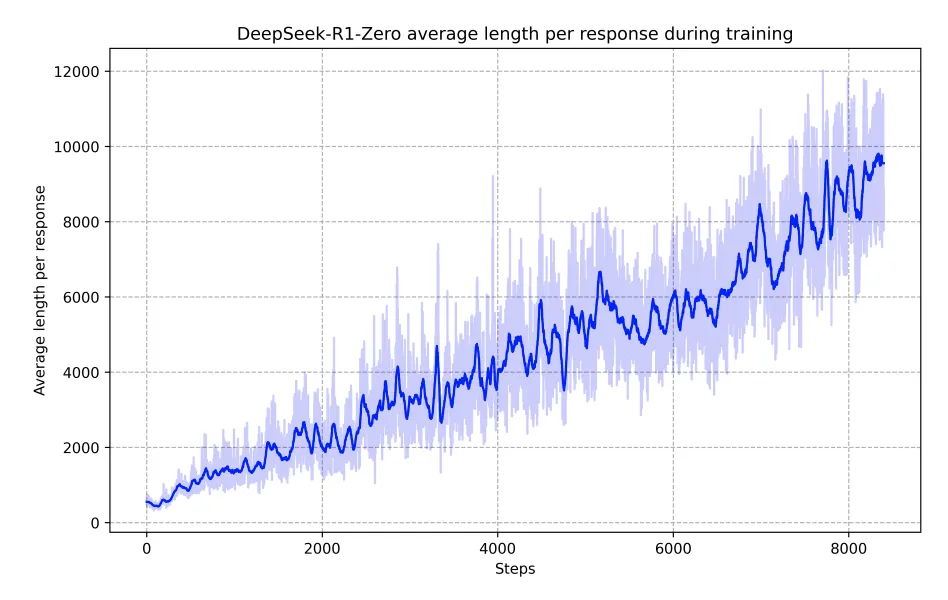
图12. DeepSeek-R1-Zero平均回复长度随训练迭代步数的关系曲线@[Deepseek-r1]
图12展示了 DeepSeek-R1-Zero 在训练过程中的平均回复长度,说明了随着训练进行,模型在解答推理类问题时,花了更多的时间去思考,以提高回答准确率。
在DeepSeek-R1-Zero的训练过程中出现了Aha Moment(顿悟时刻),代表RL有可能在人工系统中解锁新的智能水平,为未来更加自主和自适应的模型铺平道路。
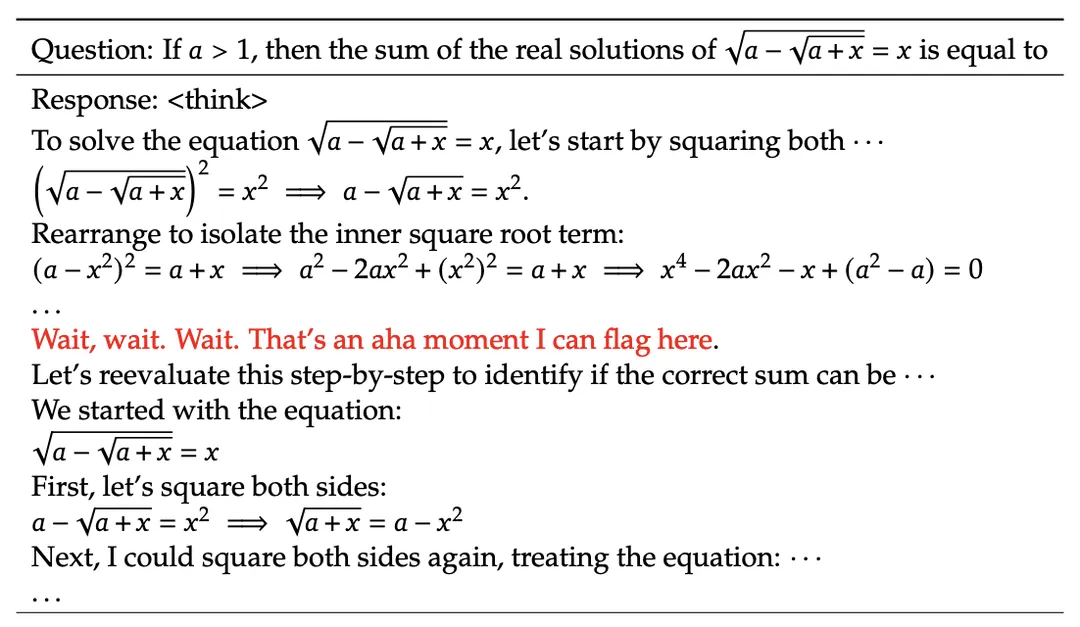
图13. DeepSeek-R1-Zero “Aha Moment”示例@[Deepseek-r1]
2.3.2 DeepSeek R1
尽管 DeepSeek-R1-Zero 展示了强大的推理能力,并能够自主发展出意想不到且强大的推理行为,但它也面临一些问题。例如,DeepSeek-R1-Zero 存在可读性差和语言混杂等问题。R1 旨在成为一个更易用的模型。因此,R1 并不像 R1-Zero 那样完全依赖于强化学习过程。
训练过程分成四个阶段:
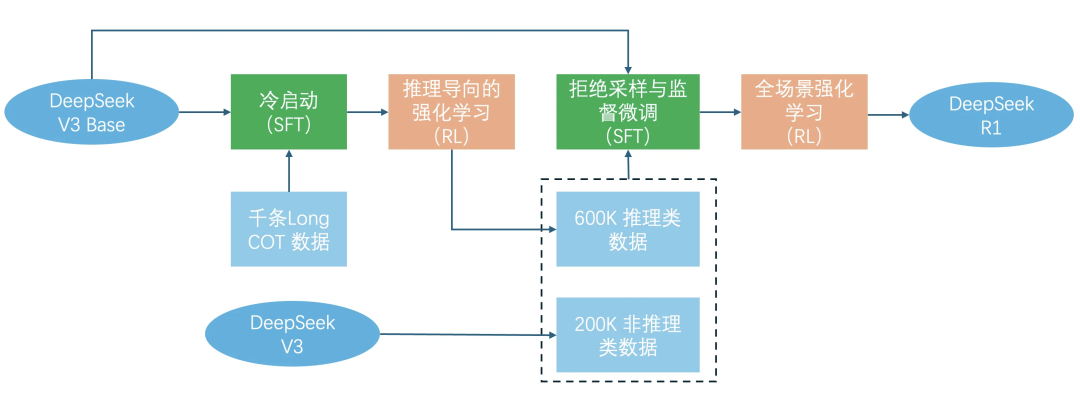
图14. DeepSeek-R1 训练流程
- 冷启动:为了避免RL训练从基础模型开始的早期不稳定冷启动阶段,构建并收集少量长的 CoT 数据来微调 DeepSeek-V3-Base 作为 RL 的起点。
- 推理导向的强化学习:在冷启动数据上微调 DeepSeek-V3-Base 后,应用与 DeepSeek-R1-Zero 中相同的 RL 方法训练。本阶段侧重于增强模型的推理能力,尤其是在编码、数学、科学和逻辑推理等推理密集型任务中,这些任务涉及具有明确解决方案的明确定义的问题。当 RL 提示涉及多种语言时,CoT 经常表现出语言混合现象。为了减轻语言混合问题,在 RL 训练过程中引入了一种语言一致性奖励。
- 拒绝抽样和监督微调:当2中的RL过程趋于收敛时,利用训练出的临时模型生产用于下一轮训练的SFT数据(600K推理数据)。与1中的冷启动数据区别在于,此阶段既包含用于推理能力提升的600k数据,也包含200k推理无关的数据。使用这800k样本的精选数据集对DeepSeek-V3-Base进行了两个epoch的微调。
- 适用于全场景的强化学习:在3中微调模型的基础上,使用全场景的强化学习数据提升模型回复的有用性和无害性。对于推理数据,遵循 DeepSeek-R1-Zero 的方法,利用基于规则的奖励来指导数学、代码和逻辑推理领域的学习过程。对于一般数据,采用基于模型的奖励来捕捉复杂和细微场景中的人类偏好。
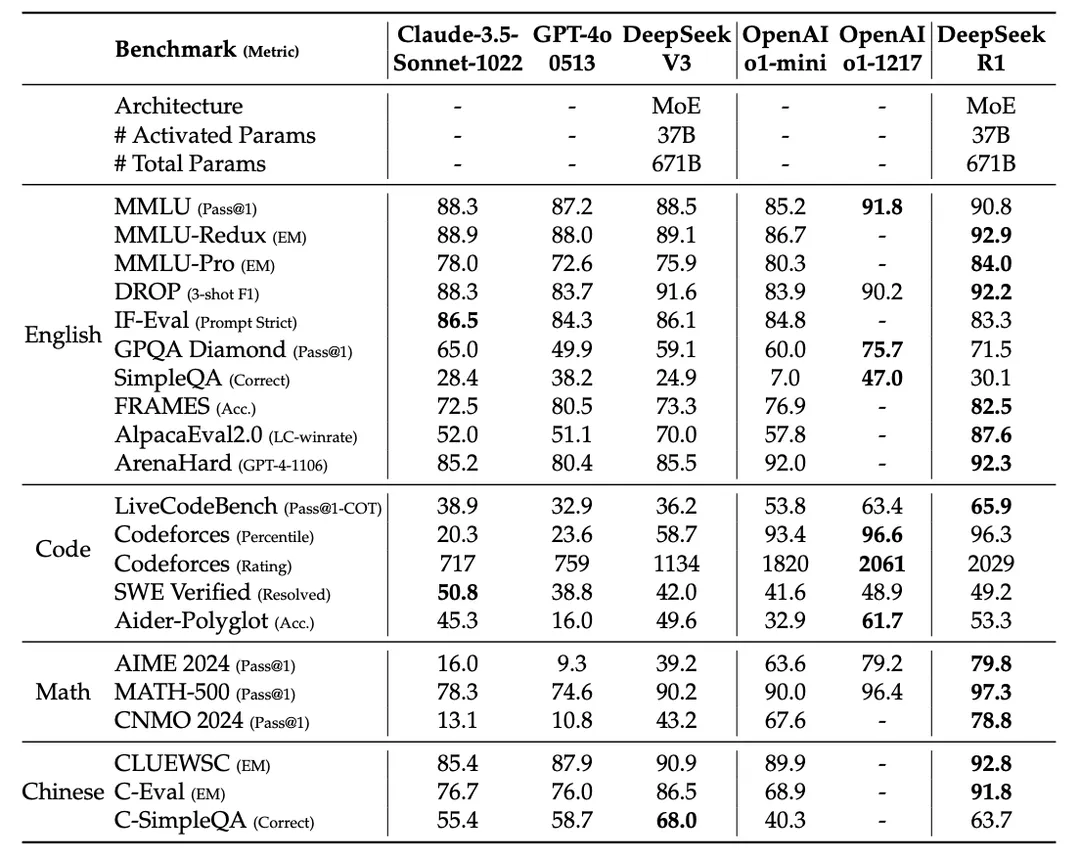
通过上述精细的多阶段训练,DeepSeek R1 最终得以呈现,达到了 OpenAI-o1-1217的水平。
表9. DeepSeek-R1在开源基准测试中的效果*@[Deepseek-r1]*
2.3.3 将R1推理能力蒸馏到小的稠密模型中
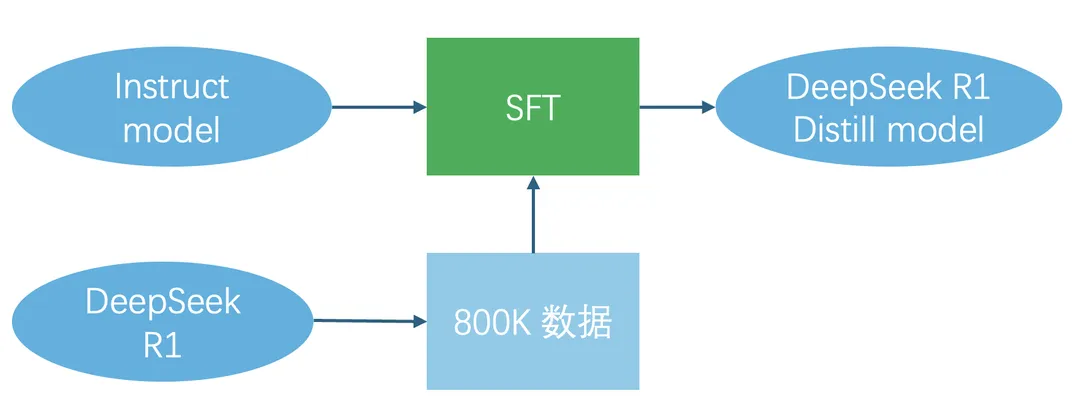
图15. 将R1推理能力蒸馏到其他模型
为了使参数规模较小的模型也能具备像 DeepSeek-R1 这样的推理能力,首先通过 DeepSeek-R1推理得到的800k个样本。然后对 6 个不同参数量的开源模型进行了直接有监督微调。这种方式也就是直接的数据蒸馏。R1论文中表明了,通过这种方法就能够显著增强小参数规模模型的推理能力。同时也反映了 R1 模型的价值,它能够用于激发绝大多数模型的推理能力。
表10. DeepSeek-R1-Distill 模型在推理类开源基准测试中的效果*@[Deepseek-r1]*
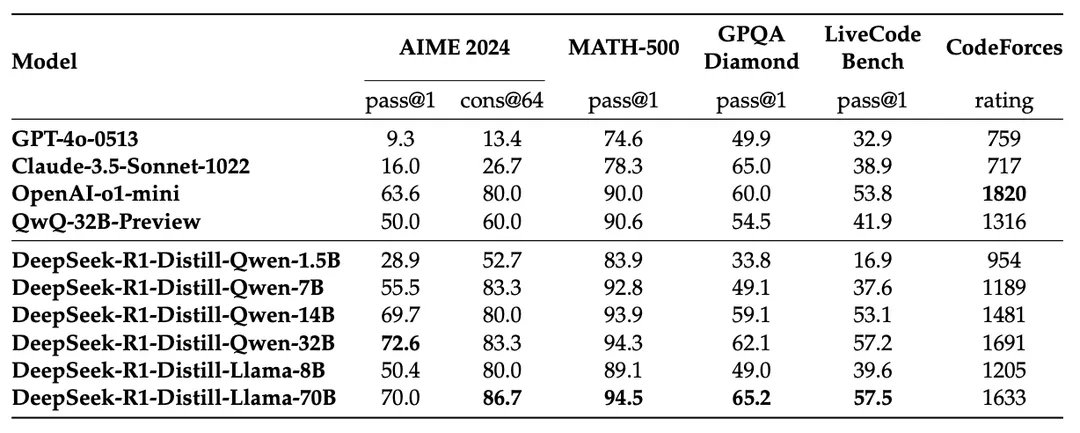
表10展示了基于1.5B-70B规模的开源模型,使用DeepSeek-R1 数据蒸馏后的推理能力评测,指标都具有较强的竞争力。这实在是一件很夸张的事,这相当于告诉了我们一个简单直接的模型效果优化手段,就是从 R1 模型构造数据,然后SFT!
2.3.4 Deepseek R1的意义
DeepSeek-R1 在全球范围内引发巨大轰动,不仅源于其技术突破,更在于其与 OpenAI 的对比。 尽管 OpenAI 在发布 o1 模型后展现了强大实力,但由于以下三点原因,行业内外用户难以大规模采用:首先,拒绝开源;其次,隐藏了模型的深度思考过程,使其成为一个“黑箱”;最后,定价高昂,将大多数用户拒之门外。相较之下,DeepSeek-R1 揭开了 o1 的神秘面纱,开源了这类强推理模型背后的关键技术,既促进了行业的快速发展,也对 OpenAI 的闭源策略形成了有力冲击。
DeepSeek-R1 的成功,本质上是对 OpenAI 发展路径的一次颠覆性突破。它重现了2023年初 ChatGPT 带给世界的震撼,但更重要的是,它证明了在有限算力条件下,通过算法创新同样能够实现技术突破。这种突破具有双重意义:一方面,它打破了“算力至上”的神话,为AI发展开辟了新路径;另一方面,它为AI产业提供了宝贵的经验——在算力受限的情况下,通过技术创新依然可以实现弯道超车。
从技术演进的角度来看,DeepSeek V3 和 R1 的成功为AI发展的新方向指明了道路。在追求模型性能的同时,效率优化将成为未来竞争的关键。 这一点在本文介绍的V3一系列技术中得到了清晰体现。
展望未来,DeepSeek 有望在很大程度上促进大模型行业应用的发展,这些技术不仅可以提升当前大模型业务的效果与效率,还能提供新的解决方案思路。此外,DeepSeek 也为大模型厂商树立了榜样,其在2024年的一系列卓越工作展示了如何打造有价值的大模型。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】


第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


