图解-使用【变异系数】赋予权重,并比较效果

权重计算方法三:变异系数法(Coefficient of Variation) 1.原理简介 2.步骤详解 2.1 原始数据收集 2.2 指标数据正向化 2.3 数据标准化(消除量纲) 2.4 计算变异系数 2.5 计算权重及得分 3.案例分析 3.1 获取原始数据 3.2 指标正向化 3.3 数据标准化 3.4 计算变异系数 3.5 计算权重 4.完整代码(Java) 4.1 方法类CoV.java 4.2 主类CoVmain.java 1.原理简介 变异系数法是根据统计学方法计算得出系统各指标变化程度的... 阅读详情

概念

变异系数

  • Coefficient of Variation
  • 计算公式: 变 异 系 数 = 标 准 差 / 平 均 值 变异系数=标准差/平均值 变异系数=标准差/平均值
  • 比较 两组 量纲不同的数据 的 离散程度,不能用标准差,可考虑变异系数
    不适用场景:数据下限小于0(导致平均值近0)
    变异系数越大,离散程度越大

变异系数权重法

  • 通过变异系数来赋权
  • 计算方法: 权 重 i = 变 异 系 数 i / 全 部 变 异 系 数 的 和 权重_i=变异系数_i / 全部变异系数的和 权重i​=变异系数i​/全部变异系数的和
  • 离散程度较大的列会获得较高的权重参数
  • 使用变异系数计得的权重值会随着数据的变化而变化
  • 该方法应用场景不多,通常不建议使用
    什么场景考虑使用?没有标签 且 缺乏业务经验 时

Min-Max标准化

  • 计算方法: 新 数 据 = ( 原 数 据 − 最 小 值 ) / ( 最 大 值 − 最 小 值 ) 新数据 = ( 原数据 - 最小值 ) / ( 最大值 - 最小值 ) 新数据=(原数据−最小值)/(最大值−最小值)
  • 效果:
    1、数据映射到[0,1]
    2、消除量纲差异
    3、放大差距
  • 场景:
    老师给学生评分(主观评分,如:文明分、品德分…)时,分数的区间是[0,100],即使有些学生很顽劣,也不会低于80分,结果所有学生的分数在80~100,优劣学生之间相差不到20%;使用Min-Max标准化或许可以还原出学生之间真实差距

Python代码实现+效果可视化
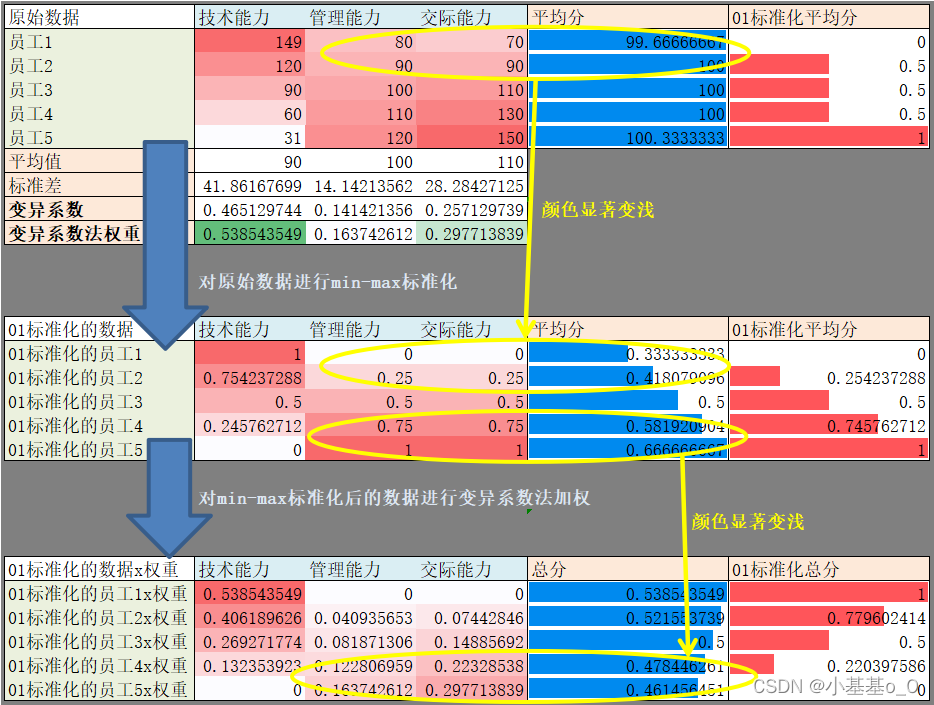
原始数据(第1个表)
平均分 可理解为 全部特征的权重相等
5个员工平均分差别不大
员工1最弱逼,员工5最流弊,员工234相等
对平均分进行min-max标准化后,员工1的弱逼程度被放大
技术能力的变异系数最大,权重最高
MinMax标准化后的数据的平均分(第2个表)
员工4>3>2(不再相等)
对min-max标准化后的数据进行变异系数法加权(第3个表)
员工1反而变得最流弊,员工5反而变得最弱比
from pandas import DataFrame, Series
from sklearn.preprocessing import minmax_scale
from numpy import ndarray

# 原始数据
df: DataFrame = DataFrame({
    '员工编号': ['员工1', '员工2', '员工3', '员工4', '员工5'],
    '技术能力': [149, 120, 90, 60, 31],
    '管理能力': [80, 90, 100, 110, 120],
    '交际能力': [70, 90, 110, 130, 150],
})
print(df)

# 变异系数
coefficient_of_variation: Series = df.std() / df.mean()
print(coefficient_of_variation)

# 权重
weight: Series = coefficient_of_variation / sum(coefficient_of_variation)
print(weight)

# 对原始数据进行Min-Max标准化
mm: ndarray = minmax_scale(df[df.columns[1:]])
print(mm)

# Min-Max标准化后的数据与权重进行矩阵乘法,计算出总分
score: Series = mm.dot(weight)
print(score)

# 对总分进行MinMax标准化
df['MinMax标准化的总分']: Series = minmax_scale(score)
print(df['MinMax标准化的总分'])
【数据综合评价方法盘点】从原理到实践(九)变异系数法 变异系数法是一种根据指标的变异程度来确定权重的客观赋权方法。变异系数反映了数据的离散程度与均值的相对关系,变异系数越大,说明该指标在不同样本之间的相对变化程度越大,提供的信息也就越多,在综合评价中应赋予更高的权重;反之,变异系数越小,权重越低。 阅读详情

相关推荐

统计学中的变异及其Python实现

在统计学中,变异是指对数据的分散程度的度量,常用的统计量称为标准差和方差。另外,变异系数是一种用来比较不同变量或不同尺度下变异度量的方法,更加直观和具有可比性。本文将介绍如何利用Python计算变异和变异系数,并且给出相应的代码实现。同样地,利用Python计算变异系数也非常简单,只需要用上面计算标准差的代码,并将结果代入公式即可。由于变异系数是以百分比的形式呈现的,所以最后乘了个100。在使用Python计算变异和变异系数前,我们需要导入相关的包。表示样本中的每一个数据,

与其临渊羡鱼,不如退而结网 460

权重的计算(变异系数法)

变异系数法计算权重

m0_67790374的博客 5983

【信息科学与工程学】计算机科学与自动化-——第十五篇云计算 11 算法篇

在百万级虚拟机、百万级租户的超大规模云环境中,核心算法挑战包括:挑战维度具体问题算法需求技术复杂度规模性​百万级对象并发管理分布式算法、分区算法极高(NP-hard问题)多租户​租户间隔离与资源共享公平性算法、隔离算法高(多目标优化)动态性​资源需求实时变化自适应算法、在线算法高(实时决策)异构性​硬件/负载/需求差异分类算法、匹配算法中高(多维度优化)经济性​资源利用率与成本平衡优化算法、博弈论算法高(多目标博弈)以下是按领域分类的详细算法列表:算法名称数学建模表达核心思想时间复杂度适用场景推理步骤首次适

weixin_49199313的博客 1405

客观赋权法——变异系数法

一、变异系数法的概念 变异系数法是根据统计学方法计算得出系统各指标变化程度的方法,是一种客观赋权法。 根据该方法变化差异较大的指标权重较大,变化差异较小的指标权重较小,从而根据指标的统计学规律确定其重要程度。 变异系数法是一种较为客观的方法,能够客观的反应指标数据的变化信息,该方法能够比较客观的求出各指标的权重。 根据各评价指标当前值与目标值的变异程度来对各指标进行赋权,当各指标现有值与目标值差距较大时,说明该指标较难实现目标值,应该赋予较大的权重,反之则应该赋予较小的权重。 二、变异系数法的步骤 (1)原

积一时之步,臻千里之遥程 2万+

优惠券管理

(请设计一个优惠券兑换码生成方案,可以支持20亿以上的唯一兑换码,兑换码长度不超过10,只能包含字母数字,并且要保证生成和校验算法的高效)最后把签名值的后14位、新鲜值(4位)、自增序列(32位)拼接,得到一个50位二进制数,然后与一个较大的质数做异或运算加以混淆,再基于Base32或Base64转码,即可的对兑换码。现在,就剩下防止爆刷了。自增id从1增加到Integer的最大值,可以达到40亿以上个数字,而占用的字节仅仅4个字节,也就是32个bit位,距离50个bit位的限制还有很大的剩余,符合要求!

qq_36312661的博客 2206

hspice2016安装教程

试装系统:win10 64bit 安装包路径和安装路径最好都不要出现中文,一般选择默认安装在C盘。 1.解压安装包压缩文件。 2.以管理员身份运行hspice_vL-2016.03-2_win.exe。 3.点击“Next”。 4.选择“I accept”,然后点击“Next”。 5.点击“Next”。 6.一般默认安装路径即可,然后点击“Next”。 7.点击“Next”. 8.点击“Next”。 9.正...

谢谢关注“小鱼教你模数电”,各平台同号 1万+

强化学习驱动的自适应模型选择与融合方法

在监督学习部署中,模型性能受数据漂移、分布变化和系统约束影响显著,传统交叉验证与静态融合难以应对动态业务环境。强化学习(RL)通过建模状态(State)、动作(Action)与奖励(Reward),实现模型选择与融合的在线决策与持续优化,其核心价值在于将模型管理从‘一次性离线选型’升级为‘实时感知—试错学习—策略进化’的闭环过程。该技术广泛应用于风控、推荐、实时预测等数据演化频繁、稳定性要求高的工业场景,尤其适合需兼顾指标提升、服务延迟与切换成本的MLOps系统。本文聚焦RL在模型选择中的落地实践,涵盖状态

weixin_34242331的博客 339

RK3568 解决MIPI屏幕开机只显示uboot logo的问题

之前写过一篇文章介绍了RK3568驱动MIPI屏幕的方法,这次产品迭代,硬件改版,选型的新的屏幕了。所以再次开启调试屏幕的过程。本以为会和上次一样会轻车熟路,事情总是事与愿违,同样的路,遇到新的坑。

fhqlongteng的博客 5427

2023级教技班刘祺大数据与学习分析课堂笔记

大数据时代数据分析:用适当的统计分析方法对收集来的大量数据进行分析,提取有用信息和形成结论而对数据加以详细研究和概括总结的过程。数据挖掘:从大量的数据中通过算法搜索隐藏于其中信息的过程,是数据库知识发现中的一个步骤。数据仓库:为企业的决策制定,提供所有类型数据支持的战略集合。它是单个数据存储,出于数据分析和决策支持目的而创建。为需要业务智能的企业,提供业务流程改进、成本质量控制等方面的指导。

G202667的博客 576

基于若依的ruoyi-nbcio-plus支持VForm3表单字段数据保存到数据库的一种方法——全网首创(一)

基于若依的ruoyi-nbcio-plus支持VForm3表单字段数据保存到数据库的一种方法——全网首创(一)

宁波阿成的博客 663

从 RAP OData 到可交付的 SAP Fiori 应用:部署与授权全链路实战笔记

摘要:本文探讨了RAP开发中常见的交付误区,指出开发者预览(FEAP)并非可部署应用,强调从服务发布到业务应用落地的完整链路。文章详细对比了不同部署路径(ABAP/BTP),解析权限管理关键点(SAP_BR_DEVELOPER的临时性),并提供了标准授权组合方案(IAM+业务目录+角色)。通过"发运跟踪"案例,展示了从开发验证到生产部署的全流程,特别提醒注意开发环境与生产环境的权限差异,避免"开发机正常、生产机403"的典型问题。(149字)

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1402

数据分析与数据挖掘

本文系统介绍了数据分析与挖掘的关键概念及技术流程。首先区分了数据分析(验证假设)与数据挖掘(发现模式)的差异,指出数据挖掘是数据分析工作流的重要环节。随后详细阐述了数据预处理的三大核心内容:数据质量评估(完整性、一致性等)、数据清洗技术(缺失值处理、噪声消除等)以及特征工程(特征选择/构建/提取)。文章还概述了常用分析方法(分类/关联/聚类/回归)和可视化工具Matplotlib,最后列举了多个实战案例(泰坦尼克分析、房价预测等)。全文构建了从理论到实践的完整知识框架,为数据分析工作提供了系统性指导。

YOU_AND_LIFE的博客 636

深度解析:LPDDR5 采样 Mask 背后的秘密 —— 从 Jitter 到 BER 全面剖析

在 LPDDR5 中,CK/DQS 信号相当于“指挥棒”,而数据(DQ)要在时钟节拍里被准确采样。Crosspoint Mask 区域横轴:时间 (Time)纵轴:电压 (Vref)👉 只要采样点落在这个区域内,数据就是正确的。否则就会出错。BERPBERPMask 就像高速公路的收费站口,如果车(采样点🚗)在车道内,顺利通过;一旦跑偏,就撞护栏。LPDDR5 的速率极高,UI 非常短,Mask 区域成为核心指标各种 Jitter、Noise 会不断压缩 Mask。

weixin_43199439的博客 354

电力概率预测从零实现:分位数回归与不确定性建模

时序预测在能源系统中已从单一数值输出演进为对不确定性分布的建模需求。概率预测并非简单扩展,其核心在于用可解释机制刻画数据的尖峰厚尾特性、异质不确定性及物理约束。分位数回归因其不依赖分布假设、天然支持业务导向优化(如Q90覆盖)、易于单调性控制等优势,成为电力生产预测的优选范式。相比高斯参数化或黑箱深度模型,它更契合光伏/风电出力受天文气象强约束、突变频繁、信噪比低等特点。本文聚焦从零手写概率MLP,覆盖数据清洗、sin/cos时间编码、RobustScaler归一化、可微分单调输出、加权分位数损失及Plat

weixin_30274627的博客 448

从原理到落地:监控 SAP OData bgRFC 队列的全景实践指南

摘要(150字) 本文系统讲解SAP Gateway/Backend场景中bgRFC队列的监控方法。内容涵盖:1)监控必要性——确保异步可靠传输,及时识别失败消息;2)两种服务质量(EO/EOIO)对监控策略的影响;3)通过事务码SBGRFCMON和SPRO路径访问监控界面;4)关键授权S_BGRFC的配置要求;5)详细操作指南包括筛选条件和动作选项;6)标准巡检脚本;7)三个典型案例(认证错误、顺序阻塞、调度压力)的诊断与修复方案。全文提供完整的监控方法论和实战指导。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 291

mybaits-plus通用CRUD详解及代码案例

文章目录mybaitsplus通用CRUD插入操作方法定义测试用例mybaitsplus主键生成策略设置自增主键设置输入主键:UUID:ID_WORKER_STR:ID_WORKER:更新操作根据id更新方法定义:方法步骤根据条件更新方法定义:更新步骤:根据条件更新(可以更新NULL)删除操作根据id删除方法定义:删除步骤:根据 entity 条件删除方法定义:删除步骤:根据ID 批量删除方法定义:删除步骤:查询操作根据id查询方法定义:查询步骤:根据id批量查询方法定义:查询步骤:根据 entity 条件

流楚丶格念的博客 3407

三种客观赋权法——熵权法、变异系数法、CRITIC

变异系数法、熵权法与CRITIC

m0_59989429的博客 3万+

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

变异系数+标准差率+一种改进的Critic权重计算方法

一种改进的Critic权重计算方法 标准差率 变异系数又称“标准差率”,是衡量资料中各观测值变异程度的另一个统计量。 当进行两个或多个资料变异程度的比较时,如果度量单位与平均数相同, 可以直接利用标准差来比较。如果单位和(或)平均数不同时,比较其变异程度就不能采用标准差, 而需采用标准差与平均数的比值(相对值)来比较。 公式表示为:变异系数=σ/μ 英文为用CV(Coefficient of Variance)。

weixin_44981864的博客 1774

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

离散系数的计算公式_统计学的Python实现-016:变异系数

统计学解释变异系数:变异系数(coefficient of variation),又称离散系数,是一个衡量数据离散程度的、没有量纲的统计量。其值为标准差与平均值之比。变异系数的计算公式为:代码实现import numpydef coefficient_of_variation(data): mean=numpy.mean(data) #计算平均值 std=numpy.std(data,ddof=0...

weixin_31151281的博客 4936

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

计算机变异指标可以,变异系数公式_在EXCEL中怎样计算样本标准差和变异系数

一份excel的统计表模板,包含统计频数、最大值、最...一、公式详解1、统计频数:=Count(A:A)统计A列所有数值个数2、最大值:=Max(A:A)3、最小值:=Min(A:A)4、平均值:=Average(A:A)5、标准差:=STDEV.S(A:A)6、变异系数=标准差/平均值=STDEV.S(A:A)/average(A:A)7、修正系数:三、附件变异系数怎么算公式如下:扩展资料变异...

weixin_33600376的博客 6750

Python综合评价模型(七)变异系数法

变异系数法是根据评价指标的变异程度来分配权重,评价指标的变异程度越大,所赋权重就越大,并以此对评价对象进行综合评价的方法

Yif18的博客 1913

变异系数法(CVM)

变异系数法是一种极具客观性的方法,能够切实地反映指标数据的变化信息,较为客观地求出各指标的权重。此方法依据各评价指标当前值与目标值的变异程度进行赋权。当各指标现有值与目标值差距较大时,意味着该指标较难实现目标值,应赋予较大权重;反之,则应赋予较小权重。

25届计算机保研er。竞赛数模方面获得美赛国一,东三省省一;算法方面获得百度之星省二,蓝桥杯省三 3094

数学建模:变异系数法

指标赋权算法:变异系数法实现步骤分析与matlab模板代码

ylh的博客 1659

【建模算法】变异系数法(Python实现)

变异系数法是根据统计学方法计算得出系统各指标变化程度的方法,是直接利用各项指标所包含的信息,通过计算得到指标的权重,因此是一种客观赋权的方法。变异系数法根据各评价指标当前值与目标值的变异程度来对各指标进行赋权,若某项指标的数值差异较大,能明确区分开各被评价对象,说明该指标的分辨信息丰富,因而应给该指标以较大的权重;反之,若各个被评价对象在某项指标上的数值差异较小,那么这项指标区分各评价对象的能力较弱,因而应给该指标较小的权重。...

baidu的专栏 3856

变异系数

变异系数(Coefficient of variation) 目录 [隐藏] 1 什么是变异系数2 变异系数的计算 [编辑] 什么是变异系数   变异系数又称“标准差率”,是衡量资料中各观测值变异程度的另一个统计量。当进行两个或多个资料变异程度的比较时,如果度量单位与平均数相同,可以直接利用标准差来比较。如果单位和(或

xiaolang85的专栏 3万+
上一篇: Python二进制方式切分文件并还原
下一篇: 大数据(9e)Flink时间语义WaterMark
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
