图解Python数据标准化+效果比较

数据标准化(Normalization)常用的6种方法python实现 数据标准化可以加快模型的收敛速度,提高模型的精度。 阅读详情

1、概述

名称计算方法映射到
[0,1]
消除
量纲
差距
缩放
负数情况
可用?
min-max标准化 新 数 据 = ( 原 数 据 − 最 小 值 ) / ( 最 大 值 − 最 小 值 ) 新数据 = ( 原数据 - 最小值 ) / ( 最大值 - 最小值 ) 新数据=(原数据−最小值)/(最大值−最小值)✅✅放大✅
z-score标准化 新 数 据 = ( 原 数 据 − 均 值 ) / 标 准 差 新数据 = ( 原数据 - 均值 ) / 标准差 新数据=(原数据−均值)/标准差❌✅✅
中位数变零 新 数 据 = 原 数 据 − 中 位 数 新数据 = 原数据 - 中位数 新数据=原数据−中位数❌❌✅
众数变零 新 数 据 = 原 数 据 − 众 数 新数据 = 原数据 - 众数 新数据=原数据−众数❌❌✅
max标准化 新 数 据 = 原 数 据 / 最 大 值 新数据 = 原数据 / 最大值 新数据=原数据/最大值✅✅放大❌
上限标准化 新 数 据 = 原 数 据 / 区 间 上 限 新数据 = 原数据 / 区间上限 新数据=原数据/区间上限✅✅不变❌
绝对值 新 数 据 = 原 数 据 的 绝 对 值 新数据 = 原数据的绝对值 新数据=原数据的绝对值❌❌✅
转成单位向量 新 数 据 = 原 数 据 / 向 量 的 模 新数据 = 原数据 / 向量的模 新数据=原数据/向量的模✅缩小✅

2、sklearn实现

from sklearn.preprocessing import MinMaxScaler, StandardScaler
X = [[0.0, 1, 2],
     [0.4, 1, 2],
     [0.6, 9, 2],
     [0.8, 9, 2]]
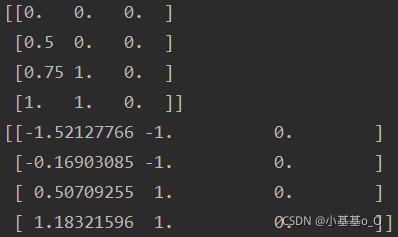
print(MinMaxScaler().fit_transform(X))
print(StandardScaler().fit_transform(X))

结果打印
from pandas import DataFrame


def min_max(df: DataFrame, columns: list):
    """
    输入DataFrame和需要标准化的列名的列表
    返回标准化后的DataFrame
    """
    from sklearn.preprocessing import MinMaxScaler
    df[columns] = MinMaxScaler().fit_transform(df[columns])
    return df


if __name__ == '__main__':
    from numpy import nan
    _df = DataFrame({
        'name': ['A', 'B', 'C', 'D'],
        'a': [.0, .4, .6, .8],
        'b': [1, 1, nan, 9],
        'c': [2, 2, nan, 2],
    })
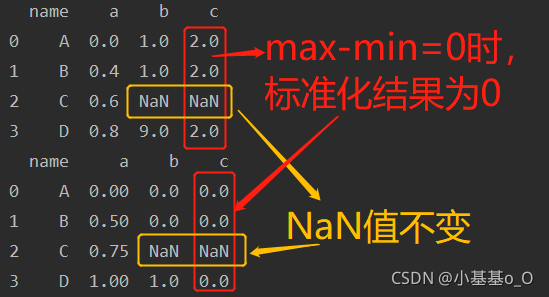
    print(_df)
    print(min_max(_df, _df.columns[1:]))

结果打印
3、代码+效果

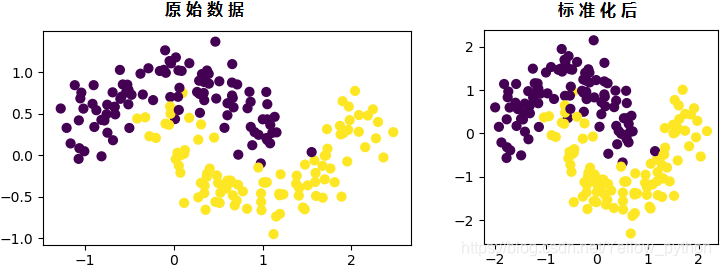
z-score标准化
import matplotlib.pyplot as mp
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import make_moons

X, y = make_moons(200, noise=0.20)  # 创建随机样本集
X_standard = StandardScaler().fit_transform(X)  # z-score 标准化

mp.subplot(1, 2, 1)
mp.scatter(X[:, 0], X[:, 1], s=40, c=y)
mp.subplot(1, 2, 2)
mp.scatter(X_standard[:, 0], X_standard[:, 1], s=40, c=y)
mp.show()

Min-max标准化

import pandas as pd, matplotlib.pyplot as mp
# 造数据
df = pd.DataFrame({'name': list('ABCD'), 'value': [102, 100, 110, 101]})
# 0-1标准化
df['0-1'] = 0 if ((df['value'].max() - df['value'].min()) == 0) else (
        (df['value'] - df['value'].min())
        /
        (df['value'].max() - df['value'].min())
)
# 可视化
mp.figure(num='Title', facecolor='lightgray', figsize=(6, 3))
# 左图:处理前
mp.subplot(1, 2, 1)
mp.title('origin', fontsize=12)
mp.bar(df['name'], df['value'], 0.2, color='dodgerblue', label='value')
mp.legend()
# 右图:【零一标准化】处理后
mp.subplot(1, 2, 2)
mp.title('0-1 standardization', fontsize=12)
mp.bar(df['name'], df['0-1'], 0.2, color='orangered', label='0-1')
mp.legend()
# 展示
mp.tight_layout()  # 防止重叠
mp.show()

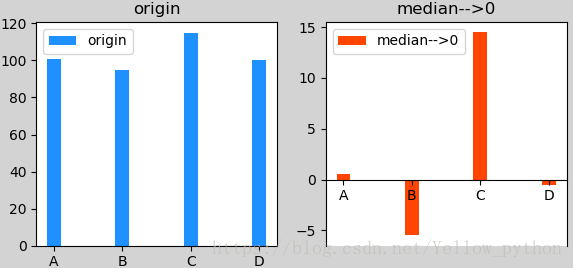
中位数变0
import pandas as pd, matplotlib.pyplot as mp
df = pd.DataFrame({'name': list('ABCD'), 'value': [101, 95, 115, 100]})
# 中位数变0
df['median-->0'] = ((df['value'] - df['value'].median()))
# 可视化
mp.figure(num='Title', facecolor='lightgray', figsize=(6, 3))
# 左图:处理前
mp.subplot(1, 2, 1)
mp.title('origin')
mp.bar(df['name'], df['value'], 0.2, color='dodgerblue', label='origin')
mp.legend()
# 右图:【中位数变0】处理后
mp.subplot(1, 2, 2)
mp.title('median-->0')
ax = mp.gca()  # 获取当前坐标轴对象
ax.spines['bottom'].set_position(('data', 0))  # 将底边框置于数据坐标原点
mp.bar(df['name'], df['median-->0'], 0.2, color='orangered', label='median-->0')
mp.legend()
# 展示
mp.tight_layout()  # 防止重叠
mp.show()

转单位向量

向量的模

from numpy import linalg  # Linear Algebra
a = [3, 4]
linalg.norm(a)  # 5.0
linalg.norm(a, ord=1)  # 7.0

单位向量

import numpy as np
a = np.array([[2, 2, 2, 2], [3, 4, 0, 0]])
b = np.linalg.norm(a, axis=1).reshape(-1, 1)
c = np.divide(a, b)  # a / b
print(b, c, sep='\n')
[[4.]
 [5.]]
[[0.5 0.5 0.5 0.5]
 [0.6 0.8 0.  0. ]]

医学图解数字化:合规构建个人可检索知识库的实践指南 在医学教育与临床实践中,高效的知识管理是提升学习与工作效率的关键。知识管理的核心原理在于将信息转化为结构化、可关联、易检索的资产。通过数字化技术,特别是OCR(光学字符识别)技术,可以将原本静态的图片或纸质文档中的文字信息转化为可搜索和处理的数字文本,这极大地释放了信息的潜在价值。其技术价值在于打破了信息孤岛,实现了知识的快速定位与深度关联,从而支持更高效的学习、复习与决策。这一方法在个人知识体系构建、专业备考与临床参考等场景中尤为实用。本文以《妇科阴部手术图解》等专业医学资源为例,具体阐述了如何在严格遵守 阅读详情

相关推荐

数据科学图像搜索:用视觉锚点高效获取概念图解与学习资源

数据科学知识高度依赖可视化表达,如决策树分裂图、混淆矩阵热力图、Transformer架构剖面图等,这些‘视觉锚点’承载着远超文字的信息密度和认知效率。其底层原理在于人类大脑处理图像速度是文字的6万倍,且图表遵循通用‘视觉语法’(如ROC曲线下面积对应AUC)。技术价值体现在绕过抽象描述直击实现本质,显著提升概念理解效率与教学准确性。典型应用场景包括新手突破理解瓶颈、工程师快速定位算法可视化实现、讲师高效筛选高质量教学素材。本文聚焦Google图片搜索在数据科学领域的深度应用,揭示如何将模糊需求转化为可检索

441

python 中数组标准化函数StandardScaler

Python中StandardScaler from sklearn.preprocessing import StandardScaler sc = StandardScaler() x = sc.fit_transform(x) 一: 数组x标准化公式 为数组,为数组x的平均值,为数组x的标准差,则标准化的公式为: import numpy as np from sklearn.preprocessing import StandardScaler sc = StandardScaler().

qaz57301的博客 7719

从美军标准到民用开源:深入浅出图解GIQE模型,教你用Python估算影像NIIRS值

本文深入解析了从美军标准到民用开源的GIQE模型,详细介绍了如何利用Python估算影像NIIRS值。通过图解关键参数和实战案例,帮助读者掌握遥感影像质量评估的核心技术,提升影像分析的标准化和效率。

weixin_31968639的博客 275

一文讲透Python机器学习特征工程中的特征标准化

在Python中,可通过scikit-learn模块中的StandardScaler()函数实现对特征的标准化处理。StandardScaler()函数处理的数据对象同样是每一列,也就是每一维特征。StandardScaler()函数通过去除平均值和缩放到单位方差来标准化特征,将样本特征值转换为标准正态分布,因此该方法也被称为Z-score方法,也是默认的数据标准化处理方法。

m0_72274883的博客 2895

Python数据处理:使用Pandas进行数据标准化

数据标准化是数据预处理中常用的一项任务,它将数据转换为具有相同范围和均值的标准分布。假设我们有一个名为"data"的DataFrame,其中包含了需要进行标准化的数值型特征列。通过标准化,我们可以将具有不同范围和均值的特征转换为具有相同尺度的标准正态分布,从而提高数据分析和建模的准确性和可靠性。就是经过标准化后的DataFrame对象,其中的每个特征列都具有相同的均值和标准差。接下来,我们将标准化后的数据重新转换为DataFrame对象,并命名新的特征列。接下来,我们可以使用Pandas的。

2301_79365003的博客 1213

Python实现数据标准化(完整源码)

如果输入数据是多维数组,方法会分别计算每一列(即每个指标)的最大值和最小值,并对每个元素进行同样的处理,保证每个指标具有相同的权重。数据标准化,也叫归一化(Normalization),是将数据按照特定规则进行转换,使得数据具有统一的量纲,便于不同指标之间的比较。总结一下,数据标准化是机器学习和数据分析中很重要的一步,Python提供了多种实现方式,本文介绍了一种基于numpy库的方法,并给出了相应的源代码,希望对读者有所帮助。Python实现数据标准化(完整源码)

与其临渊羡鱼,不如退而结网 981

图解-使用【变异系数】赋予权重,并比较效果

变异系数 Coefficient of Variation 用于比较多组数据的离散程度 比较 两组 量纲不同的数据 的 离散程度,不能用标准差,可考虑变异系数 不适用场景:数据下限小于0(导致平均值等于0) 变异系数权重法 使用变异系数计得的权重值会随着数据的变化而变化,可认为是一种无监督学习

ArYe 3226

从编解码芯片看Tesla T4的隐藏实力:双NVDEC如何实现70路1080P解码?

本文深入剖析了英伟达Tesla T4显卡的隐藏实力,重点解读其独特的双NVDEC硬件解码器设计如何突破性能瓶颈。通过分析Turing架构、对比HEVC/H.264解码差异,并结合驱动与SDK优化,揭示了实现高达70路1080P视频流并发解码的原理与实战配置,为云游戏、直播转码等高并发场景提供高效解决方案。

weixin_29209801的博客 489

100天掌握机器学习实战:中文图解与Scikit-Learn完整指南

你是否曾对机器学习感到困惑,不知从何开始?面对复杂的算法和数学公式,是否觉得难以入门?今天,我要为你介绍一个终极解决方案——机器学习100天中文版项目。这个精心设计的100天学习计划,通过中文图解和Scikit-Learn实战代码,让你在三个月内系统掌握机器学习核心技能,从数据预处理到高级算法应用,一步步解锁AI世界的奥秘。 ## 🎯 为什么机器学习入门如此困难? 许多初学者在接触机器学习时

gitblog_00637的博客 848

Chapter2、HDR流水线

HDR内容的获取(不同曝光时间的图片合成) 相机响应函数 HDR视频

qq_55621259的博客 2597

MATLAB实战:手把手教你用三频四步相移法搞定结构光三维重建(附完整代码)

本文详细介绍了如何使用MATLAB实现三频四步相移法进行高精度结构光三维重建。通过光栅图像预处理、相位计算、多频外差与相位解包裹等步骤,结合完整代码示例,帮助读者掌握从二维图像到三维点云的关键技术。该方法在工业检测和逆向工程中具有抗干扰能力强、高分辨率和鲁棒性等优势。

weixin_29201933的博客 340

Python层次聚类实战:从树状图解读到业务分群落地

层次聚类是一种揭示数据内在结构关系的无监督学习方法,其核心在于构建反映样本亲疏关系的层级化簇结构。它通过距离度量(如欧氏距离、余弦相似度)量化相似性,依托连接准则(如平均链接、Ward法)定义簇间合并逻辑,并以树状图完整记录每一次合并的代价。这种可追溯、可解释的建模过程,使其在客户分群、基因表达分析、日志异常归因等需深度理解数据演化路径的场景中具备不可替代的技术价值。相比K-Means等扁平聚类,层次聚类不预设簇数,而是支持动态剪枝与多粒度洞察,尤其适合探索性分析与业务驱动的决策验证。本文聚焦凝聚式层次聚类

conghuang7343的博客 516

发那科机器人编程软件fanuc roboguide授权补丁_工业机器人离线编程与应用:ROBOGUIDE V8.3版本的工程文件创建...

欢迎关注我们ROBOGUIDE是发那科机器人公司提供的一个离线编程工具,可模拟现实中的机器人和周边设备的布局,通过虚拟TP示教来模拟机器人的运动轨迹,同时可以验证方案的可行性和准确的周期时间。ROBOGUIDE是一款核心应用软件,具体的还包括搬运、弧焊、喷涂等其他模块。以最新的8.3版本为例进行讲解,对于未注册的版本将有30天的免费使用期限。开始菜单击开始菜单中的HandingPRO启动程序,第一...

weixin_39791446的博客 2925

你也能看懂的python算法书,python算法详解电子版

这本《趣学Python编程》中有各种小游戏小程序的实战内容通俗易懂到仿佛在看漫画!让你瞬间对python充满学习的兴趣!在游戏娱乐中学习python是不是想想都觉得很开心呢?那就跟着柠檬一起来看吧!(文末送福利,限领50份)本书是一本轻松、快速掌握Python编程的入门读物。全书分为3部分,共18章python中turtle画小鸟。

chatgpt001的博客 1003

在 Windows 上使用 Anaconda 创建 配置 YOLOv8虚拟环境,并更改 pip 源以及以 可编辑模式 安装ultralytics

前往 NVIDIA cuDNN 下载页面,下载与您安装的 CUDA 版本匹配的 cuDNN 版本。:根据您的系统和 CUDA 版本,选择适当的 whl 文件。如下12.7,表示最高可装12.7版本CUDA,与上图中的支持的最高cuda版本一致。,无需重新安装,从而大幅提升开发效率,适用于项目开发、调试或依赖本地未发布的版本时使用,但需确保当前目录包含。:访问 NVIDIA 官方网站,下载与您的显卡和操作系统兼容的 CUDA 版本。首先,确保NVIDIA 显卡支持 CUDA,并安装相应版本的驱动程序。

weixin_44115575的博客 1893

保姆级教程:在PyCharm里用Continue插件一键接入DeepSeek API(含乱码修复)

本文详细介绍了如何在PyCharm中通过Continue插件无缝集成DeepSeek API,提供从环境准备到高级配置的全流程指南,包括解决常见的乱码问题。通过本教程,开发者可以轻松实现AI编程助手的高效调用,提升代码编写和调试效率。

weixin_30275415的博客 850

python中认识数据分析

📋 数据分析完整流程一个标准的 Python 数据分析项目遵循以下 6 个核心阶段数据获取CSV · API · 数据库数据清洗缺失值 · 异常值探索分析EDA · 统计描述数据可视化图表 · 仪表盘建模分析ML · 统计模型报告输出结论 · 洞察。

belong_my_offer的博客 5474

【AI智能体】Codex 插件从使用到项目开发实战操作详解

Codex 插件从使用到项目开发实战操作详解

congge 7648

DBSCAN聚类算法 — 理论 + 图解 + 代码

前期回顾 K-Means算法 — 算法原理、质心计算、距离度量、聚类效果评价及优缺点 一、前言 二、DBSCAN聚类算法 三、参数选择 四、DBSCAN算法迭代可视化展示 五、常用的评估方法:轮廓系数 六、用Python实现DBSCAN聚类算法 一、前言 DBSCAN(Density-Based Spatial Clustering of Applications with Noise,具有噪声的基于密度的聚类方法)是一种基于密度的空间聚类算法。 该算法将具有足够密度的区域划分为簇,并在具有噪声的空间.

zhf的博客 2803

scratch绘制旋转彩球 2023年9月电子学会图形化编程scratch编程等级考试四级真题和答案解析

​ scratch绘制旋转彩球 2023年9月电子学会图形化编程Scratch等级考试四级真题 一、题目要求 1、准备工作 (1)删除小猫角色,从角色库选择Ball角色; (2)默认空白背景。 ​

青少年编程学习指导 1369

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

算法技能突破指南:从数据结构小白到编程高手的实战路径

你是否曾面对复杂的算法问题感到无从下手?是否在编程面试中因为数据结构问题而错失良机?今天,我将为你揭示一个系统化的算法能力提升方案,帮助你从基础到精通,轻松掌握算法与数据结构的核心技能。 ## 挑战:算法学习的三大困境 许多开发者在算法学习过程中都会遇到相似的困境:知识点零散缺乏系统性、理论难以转化为实践能力、面对实际问题时思维混乱。传统的刷题方式往往让人陷入"做了就忘、忘了再做"的恶性循环。

gitblog_00862的博客 727

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Python实战:5分钟搞定凝聚型层次聚类(附完整代码与树状图解析)

本文提供了一份Python实战指南,教你快速掌握凝聚型层次聚类。通过Scipy库,只需几行代码即可完成从数据生成、距离计算、链接方法选择到生成树状图的全过程。文章详细解析了如何解读树状图以确定最佳簇数,并提供了完整的代码示例和可视化结果,帮助数据分析师高效实现数据分群。

milk5的博客 800

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

算法实战应用案例精讲-特征工程| 图解机器学习

首先我们来了解一下『特征工程』。事实上大家在ShowMeAI的实战系列文章 Python机器学习综合项目-电商销量预估[2] 和 Python机器学习综合项目-电商销量预估(进阶)[3] 中已经看到了我们做了特征工程的处理。如果我们对特征工程(feature engineering)做一个定义,那它指的是:利用领域知识和现有数据,创造出新的特征,用于机器学习算法;可以手动或自动。在业界有一个很流行的说法:据与特征工程决定了模型的上限,改进算法只不过是逼近这个上限而已。

qq_36130719的博客 944

python入门—进阶—爬虫—算法,很好的四本书籍附学习教程

python入门—进阶—爬虫—算法,很好的四本书籍附学习教程

隔壁王叔的博客 771

一文讲透Python机器学习决策树算法的基本概念与原理

决策树算法是一种有监督、非参数、简单、高效的机器学习算法。决策树算法借助树的分支结构构建模型。如果是用于分类问题,则决策树为分类树;如果是用于回归问题,则决策树为回归树。

m0_72274883的博客 1262

从‘相关性最大化’出发:用大白话图解偏最小二乘(PLS)的核心原理与Python代码

本文通过生动的比喻和Python代码示例,深入浅出地解析了偏最小二乘(PLS)的核心原理与应用。从数据投影的直观理解到协方差矩阵的数学构建,再到Python实现的关键步骤,帮助读者掌握这一处理高维数据的强大工具,特别适合需要分析两组变量间关系的场景。

weixin_30650039的博客 394
上一篇: 社群经济
下一篇: Python相似度计算【大总结】
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值