机器学习那些事儿 | 基础知识(一)

【AI】用iOS的ML(机器学习)创建自己的AI App 在机器学习中,一切都始于模型,这是进行预测或识别的系统。教计算机学习涉及使用训练数据的机器学习算法进行学习。从训练中生成的输出通常称为机器学习模型。有不同类型的机器学习模型来解决同一个问题(例如对象识别),但使用不同的算法。是其中一些机器学习算法。 阅读详情

AI派在读学生小姐姐Beyonce

Java实战项目练习群

长按识别下方二维码,按需求添加

扫码添加Beyonce小姐姐

扫码关注

进Java学习大礼包

机器学习那些事儿 | 基础知识(一)

1. 常用基本术语

  • 分类(classification):预测结果为「离散值」。

  • 回归(regression):预测结果为「连续值」。

  • 聚类(clustering):将训练集分为若干个「簇」(cluster),这些自动生成的簇可能对应一些潜在的概念划分。而这些概念我们事先是不知道的,学习过程中使用的训练样本不包含标记信息。

  • 二分类(binary classification):只涉及「两个类别」的分类任务。即:正类(positive class)和负类(negative class)。

  • 监督学习(supervised learning):训练数据含有标记信息。比如:「分类」、「回归」。

  • 无监督学习(unsupervised learning):训练数据不含有标记信息。比如:「聚类」。

  • 泛化(generalization)能力:机器学习得到的模型适用于新样本的能力。

  • 归纳偏好(inductive bias):机器学习算法在学习的过程中对某种类型假设的偏好。

2.模型评估常用术语

  • 错误率(error rate):如果在个样本中有个样本分类错误,则错误率。

  • 精度(accuracy):。

  • 误差(error):学习器的实际预测输出与样本的真实输出之间的差异。

  • 训练误差(training error)/经验误差(empirical error):学习器在「训练集」上的误差。

  • 测试误差(testing error):学习器在「测试集」上的误差。

  • 泛化误差(generalization error):学习器在「新样本」上的误差。

  • 过拟合(overfitting):学习器学得“太好了”,导致泛化能力下降。

  • 欠拟合(underfitting):训练样本的一般性质尚未学好。

3.训练集和测试集划分方法

3.1留出法(hold-out)

直接将数据集划分为两个「互斥」集合,其中一个作为训练集,另外一个作为测试集,即:。

「留出法的注意点:」

  • 训练/测试集的划分要尽可能保持「数据分布」的「一致性」(一般训练集占比为2/3~4/5);

  • 「单次」使用留出法得到的估计结果不够可靠,一般采用采用若干次「随机划分」、「重复进行」实验评估后「取均值」作为最终结果。

3.2交叉验证法(cross validation)

首先,将数据集划分为个大小相似的「互斥」子集,即:。然后,每次用个子集的并集作为训练集,余下的那个子集作为测试集。

这样就可以获得组训练集/测试集,从而进行次训练和测试,最终返回这个个测试结果的「均值」。10折交叉验证示意图如图所示。
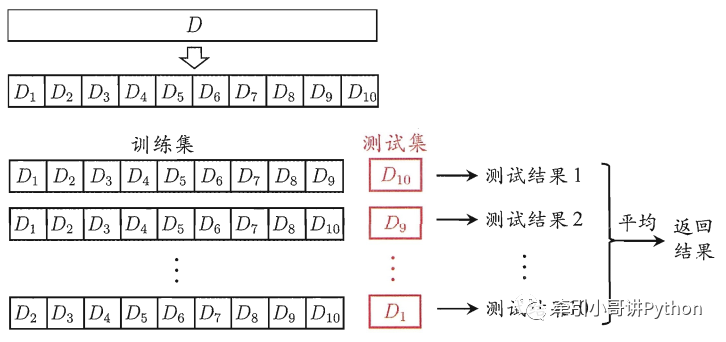
(图片来自《机器学习》-周志华)

「交叉验证法的注意点:」

  • 为了减小因样本划分带入的差别,折交叉验证通常要随机使用不同的划分「重复次」,最终评估结果是这次折交叉验证结果的「均值」;

  • 假定数据集中包含样本,若令,则得到交叉验证法的特例:「留一法」(Leave-One-Out, LOO)。留一法不受样本随机划分方式的影响。但是数据量大时的计算成本较高。

3.3自助法(bootstrapping)

给定包含个样本的数据集,我们对它进行采样产生数据集:每次随机从中挑选-一个样本,将其拷贝放入,然后再将该样本放回初始数据集中,使得该样本在下次采样时仍有可能被采到;这个过程重复执行次后,我们就得到了包含个样本的数据集,这就是自助采样的结果.

样本在次采样中始终不被采到的概率是,取极限得到

即通过自助采样,初始训练集中约有36.8%的样本未出现在采样数据集中。

「自助法的注意点:」

  • 自助法在数据集「较小」,「难以划分」训练/测试集时很有用;

  • 自助法产生的数据集改变了初始数据集的分布,「引入估计偏差」;

  • 初始数「据量足够时」,留出法和交叉验证法更常用。

参考文献:《机器学习》——周志华

❞

文末福利

各位猿们,还在为记不住API发愁吗,哈哈哈,最近发现了国外大师整理了一份Python代码速查表和Pycharm快捷键sheet,火爆国外,这里分享给大家。

这个是一份Python代码速查表

下面的宝藏图片是2张(windows && Mac)高清的PyCharm快捷键一览图

怎样获取呢?可以添加我们的AI派团队的Beyonce小姐姐

一定要备注【高清图】哦

????????????????????

➕我们的Beyonce小姐姐微信要记得备注【高清图】哦

来都来了,喜欢的话就请分享、点赞、在看三连再走吧~~~

人工智能(AI)与机器学习(ML):塑造未来的技术引擎 人工智能是一种模拟、延伸和扩展人类智能的理论、方法、技术及应用系统。它旨在让计算机能够像人类一样思考、学习,并能在各种环境下自主地做出决策。AI的发展经历了从最初的符号主义、连接主义到如今的深度学习等多个阶段,每一次的突破都极大地推动了科技的进步。尽管AI与ML技术取得了巨大的进步,但它们仍然面临着诸多挑战。首先,数据的获取和标注是一个巨大的问题。高质量的标注数据是机器学习模型训练的关键,但数据的获取和标注往往需要耗费大量的人力和时间。其次,模型的泛化能力也是一个需要解决的问题。 阅读详情

相关推荐

用 ML.NET 开发智能应用:让 .NET 程序员轻松掌握机器学习

ML.NET是一个由微软开发的开源跨平台机器学习框架,专为 .NET 开发者设计,允许他们在不离开 C# 或 F# 编程语言的情况下,进行机器学习建模和应用。通过 ML.NET,开发者无需学习 Python 或深度学习框架的复杂操作,就能在其现有的 .NET 应用中集成强大的机器学习功能。ML.NET 支持各种机器学习任务,包括分类、回归、聚类、推荐、异常检测、自然语言处理等。无论是开发企业级应用、Web 应用,还是桌面应用,ML.NET 都能为你的项目带来智能化提升。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 3836

2.数据集划分与性能度量

一、 经验误差与过拟合 错误率:把分类错误的样本数占样本总数的比例,如果m个样本中有a个样本分类错误,则错误率E = a/m 精度:1- a/m 训练误差(经验误差):学习器在训练集上的误差 泛化误差:在新样本上的误差 过拟合:对训练样本某些特点学的太过,导致泛化性能下降 欠拟合:对训练样本的一般性质尚未学好 二、 数据集划分 1. 留出法 留出法直接将数据集D划分为两个互斥的集合,其中一个作为训练集S,另一个作为测试集T。 常见做法为:1/5 ~ 1/3 样本作为测试集 训练/测试集的划分要尽可能保

qz的博客 876

Spark 2.0 机器学习 ML 库:常见的机器学习模型(Scala 版)

一、前言 机器学习中,人为地设计算法,需要一定的知识积淀。 而使用别人设计好的机器学习库如 Spark 2.0 ML,那是基本不需要什么基础的,开箱即用。 首先,看一个简单、完整、规范的案例,无疑是最好的方式。 之前的文章(内含短小精悍的案例): Spark 2.0 机器学习 ML 库:特征提取、转化、选取(Scala 版) Spark 2.0 机器学习 ML 库:机器学...

IT小村 1万+

数据集的划分会影响模型的准确率

相同的网络、相同的参数(学习率、epoch),如果数据集随机划分为1:1,每次训练的结果都会不一样 如下图,迭代100次,学习率均相同 第一次 第二次 可以发现两次训练的结果还是有差异的,甚至在一些训练时模型直接崩溃,正确率始终在30%左右徘徊; ...

zxs0222的博客 5397

在 Azure ML 上用 .NET 跑机器学习

.NET ML 你在用了吗?

Kinfey 4408

人工智能AI 与 机器学习ML 的关键区别

人工智能(AI)是指计算机系统能够执行通常需要人类智能才能完成的任务。包括理解自然语言、识别图像、解决复杂问题和做出决策。AI的目标是创建能够模仿或超越人类智能的系统。弱人工智能(弱AI):也称为窄AI,专注于特定任务。例如,语音助手(如Siri和Alexa)和推荐系统(如Netflix和Amazon的推荐算法)。强人工智能(强AI):也称为通用AI,具有执行任何人类智能任务的能力。目前,强AI仍处于理论阶段,尚未实现。机器学习(ML)是人工智能的一个子领域。

王教主的博客 5944

深入理解机器学习——数据集的划分与模型评估方法

通常我们把分类错误的样本数占样本总数的比例称为错误率(Error Rate),即如果在mmm个样本中有aaa个样本分类错误,则错误率E=amE=\frac{a}{m}E=ma​相应的,Accuracy=1−am\text{Accuracy}=1-\frac{a}{m}Accuracy=1−ma​称为准确率(Accuracy),即“精度=1-错误率”。更一般地,我们把学习器的实际预测输出与样本的真实输出之间的差异称为误差(Error),学习器在训练集上的误差称为训练误差(Training Error)/经验误

冯·诺依曼 1万+

初学者入门机器学习 (ML)的推荐教程

了解基本的机器学习概念并不难。有大量免费的在线博客文章、视频和编码教程可以引导您了解基础知识——从介绍性内容到常见应用程序,再到算法和应用技能。这篇文章总结了一些用于介绍 ML 的最佳免费选项。它按逻辑顺序排列,每个概念都建立在上一个概念的基础上。

u010542847的博客 4626

金融行业数据库场景下,SmartX 超融合表现如何|性能验证与落地实践

数据库场景支持能力得到充分验证。

SmartX 超融合 918

机器学习ML.NET

是用于 .NET 的跨平台开源机器学习 (ML) 框架。ML.NET 允许开发人员在其 .NET 应用程序中轻松构建、训练、部署和使用自定义模型,而无需开发机器学习模型的专业知识或使用 Python 或 R 等其他编程语言的经验。该框架提供从文件和数据库加载数据,支持数据转换,并包含许多 ML 算法。借助 ML.NET,您可以针对(如分类、预测和异常检测)训练模型。您还可以在 ML.NET 中使用 TensorFlow 和 ONNX 模型,这使得框架更具可扩展性,并扩展了支持的方案数量。

A_nanda的博客 5526

Fluent实战——残差震荡分析与收敛优化策略

本文深入探讨了Fluent仿真中残差震荡的成因与优化策略。残差震荡是流场物理或数值问题的关键信号,文章系统分析了网格质量、边界条件、物理模型非定常性及求解设置四大主因,并提供了库朗数与松弛因子的调参心法,以及针对超音速流、共轭传热等典型场景的实战优化方案,旨在帮助用户有效提升计算收敛性与结果可靠性。

w1x2y3的博客 313

【数据挖掘】分类器模型性能评估讲解及iris数据集评估实战(超详细 附源码)

【数据挖掘】分类器模型性能评估讲解及iris数据集评估实战(超详细 附源码)

showswoller的博客 1214

Dify DSL文件分享 Dify讨论群 大模型token资源等(持续收集更新)

基于LLMOps平台-Dify的一站式学习平台。包含不限于:Dify案例、DSL文件分享、模型接入、Dify交流讨论等各类资源分享。

同名公众号:dify实验室 3717

AI/ML 基础知识与常用术语全解析

AI/ML入门:基础知识与常用术语全解析,超全的哟~

Pocker_Spades_A的博客 7175

Java Web 图书管理系统的制作指南

实现对图书信息的增删改查(CRUD)操作。支持用户登录与权限管理。图书借阅与归还功能。系统管理员可以管理用户信息和图书库存。

Xiaoxin的博客 1629

CCC数字钥匙3.0标准解读(16)

介绍通信过程最重要部分:身份认证和加密.介绍需要身份认证的过程和需要加密的数据及过程.

weixin_41738640的博客 1535

ML.NET 机器学习实用指南(一)

机器学习(ML)在许多行业中得到广泛应用,如科学、医疗保健和研究,其受欢迎程度仍在不断增长。2018 年 3 月,微软推出了 ML.NET,以帮助.NET 爱好者与机器学习(ML)进行工作。通过这本书,你将探索如何使用 C#代码构建 ML.NET 应用程序,并使用各种 ML 模型。本书首先为你概述了机器学习和使用的 ML 算法类型,同时介绍了 ML.NET 是什么以及为什么需要它来构建 ML 应用程序。然后,你将探索 ML.NET 框架、其组件和 API。本书将作为一本实用指南,帮助你使用 ML.NET 库

龙哥盟 2998

Power Automate Desktop实战:一键自动登录Chrome网站

本文详细介绍了如何使用Power Automate Desktop实现Chrome网站的一键自动登录,提升工作效率。从环境准备、基础配置到高级技巧与异常处理,全面解析自动化登录流程的构建与优化,特别适合需要频繁登录多个系统的用户。

weixin_29231725的博客 468

Unity 机器学习(ML-Agents) 基础

Unity 机器学习 ML-Agents 基础Unity 官方示例下载ML-Agents 部分Python 下载AnacondaAnaconda 虚拟环境构建 ML-Agents安装 ML-Agents Python 包安装 ML-Agents 包ML-Agents 入门指南Unity Hub 部分虚拟环境 训练虚拟环境 训练运行:虚拟环境 开始训练:虚拟环境 观察训练进度:虚拟环境 停止训练虚拟环境 恢复训练虚拟环境 训练模型ML-Agents 打造新的学习环境ML-Agents 资产导入 Unity 官

Maddie_Mo的博客 1万+

Python爬虫实战:5分钟搞定Boss直聘数据抓取(附完整代理IP配置)

本文详细介绍了如何使用Python爬虫高效抓取Boss直聘的招聘数据,包括环境配置、反爬策略、数据采集与存储、数据分析等完整流程。通过实战案例,帮助开发者快速掌握招聘市场数据抓取技术,为职业决策提供数据支持。

weixin_30832143的博客 349

SAP特殊库存全解析:供应商寄售、客户寄售、分包与项目库存说明

客户寄售库存(Customer Consignment)是企业将物料存放于客户处,客户实际领用后才确认销售收入。这种模式能缩短交货周期、提高客户满意度,但需严格跟踪寄售库存的数量与状态。

我小时候很黑的博客 822

ML.NET库学习004:ML.NET基础知识复盘

仔细思索,觉得是没有ML.NET的知识基础,直接上手看代码,先应该整体了解一下概念,再去看代码。

North_D的博客 1474

Python3实现基于ARIMA模型来预测茅台股票价格趋势

ARIMA(Autoregressive Integrated Moving Average)模型是一种广泛使用的时间序列分析方法,它可以用于对未来的数据进行预测。ARIMA模型由自回归模型(AR模型)、差分整合模型(I模型)和移动平均模型(MA模型)组成,因此也被称为ARIMA(p,d,q)模型。其中,p表示自回归阶数,d表示差分阶数,q表示移动平均阶数。具体来说,ARIMA模型可以通过以下步骤进行建模:数据预处理:对时间序列进行平稳性检验,如果不满足平稳性,则进行差分操作。

m0_64336780的博客 2万+

系列ML.Net 学习篇【一】——初识机器学习

微软官方的目的就是,让你无需离开 .NET 生态系统,便可以使用 C# 或 F# 创建自定义 ML 模型。并让你可以轻松地将机器学习集成到 Web、移动、桌面、游戏和物联网应用中。 所以如果你刚好有Python训练好的模型,而正在烦恼怎么应用到.NET平台上时,那么刚好可以使用ML.NET,使用你的模型,它基本兼容市面上所有常见的数据格式,ML.NET支持TensorFlow和ONNX模型。

网尘的技术专栏 6365

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

AIDE ML — 机器学习工程代理

AIDE 算法是一个树搜索代理,能够自主地编写、调试和测试代码,直到用户定义的指标达到最大值。由 LLM 驱动的代理,能够编写、评估和改进机器学习代码。知道还有其他引用或衍生自 AIDE 的公共项目吗?提示:使用完全本地化的模型时,性能可能会有所下降。使用侧边栏粘贴您的 API 密钥,上传数据,设置。用户界面显示实时日志、解决方案树和最佳代码。使用的Python 包的形式发布,并包含。智能体使用数据集,并用通俗易懂的英语描述。完全本地化(代码+评估器——无外部调用)替换新的搜索启发式方法、评估器。

具身机器人和通用AI 3917

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

上一篇: 在数据可视化这一块,我们可能真比不上几百年前的科学家
下一篇: 卧槽!微信头像可以带圣诞帽啦!
Wang_AI
博客等级 码龄12年 996粉丝 162原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值