数据挖掘从入门到放弃(一):线性回归和逻辑回归

回归分析(线性回归、逻辑回归)详解与 Python 实现 文章目录1. 回归分析概述1.1 基本概念 1. 回归分析概述 1.1 基本概念   回归分析是处理多变量间相关关系的一种数学方法。相关关系不同于函数关系,函数关系反应变量间严格依存性,简单说就是一个自变量对应一个因变量。而相关分析中,对自变量的每一个取值,因变量可以有多个数值与之对应。在统计上,研究相关关系可以运用回归分析和相关分析。   当自变量为非随机变量而因变量为随机变量时,它们的关系分析... 阅读详情

“ 数据挖掘算法基于线性代数、概率论、信息论推导,深入进去还是很有意思的,能够理解数学家、统计学家、计算机学家的智慧,这个专栏从比较简单的常用算法入手,后续研究基于TensorFlow的高级算法,最好能够参与到人脸识别和NLP的实际项目中,做出来一定的效果。”

一、理解线性回归模型

首先讲回归模型,回归模型研究的是因变量(目标)和自变量(预测器)之间的关系,因变量可以是连续也可以离散,如果是离散的就是分类问题。思考房价预测模型,我们可以根据房子的大小、户型、位置、南北通透等自变量预测出房子的售价,这是最简单的回归模型,在初中里面回归表达式一般这样写,其中x是自变量,y是因变量,w是特征矩阵,b是偏置。

在机器学习推导里面引入线性代数的思想,将假设我们用一个表达式来描述放假预测模型,x代表一个房子的特征集,它是一个n×1的列向量,总共有m个特征集,θ是一个n×1的列向量,是我们想要求得未知数。


我们采用误差最小的策略,比如有预测表达式:y工资=Θ1*学历+Θ2*工作经验+Θ3*技术能力+.......+Θn*x+基本工资,预测的y值和实际值y_存有差距,策略函数就是使得m个特征集的(真实值y-预测值)的平方和最小。(差值可能是负数,所以采用平方和);


按照对于正规方程的求法,我们对θ 求偏导:
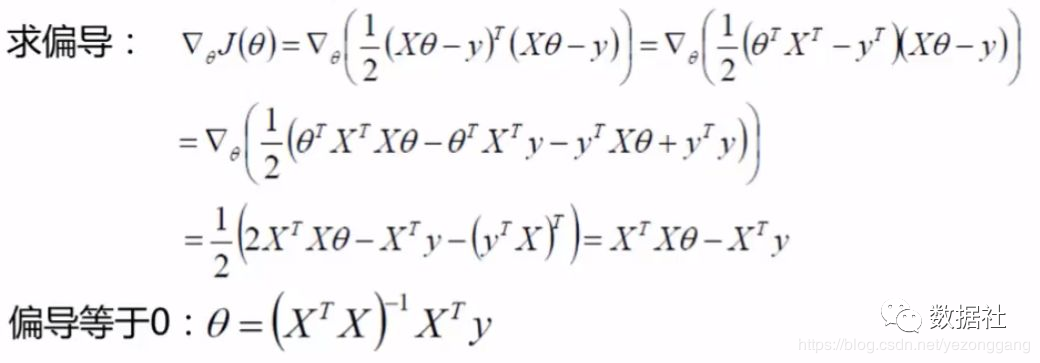


也就是,给定特征矩阵X和因变量y,即可以求使误差率最小的θ值,满足后续的回归模型。了解线性代数的童靴可以看出来问题,在θ的表达式中有求逆运算,需要保证矩阵可逆,这一般是无法保证的,这样就会造成θ无解,策略失效;


二、计算机的做法:梯度下降

常规的方程需要大量的矩阵运算,尤其是矩阵的逆运算,在矩阵很大的情况下,会大大增加计算复杂性。,且正规方程法对矩阵求偏导有一定的局限性(无法保证矩阵可逆),下面介绍梯度下降法,也就是计算机的解决方法,每次走一小步,保证这一小步是最有效的一步,可以想象自己正在下山,你不知道目的地(全局最小值)在哪,但是你能够保证自己每次走的都是最陡峭的一步;
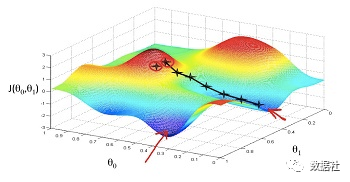
我们的策略仍然保持不变,就是使得m个特征集的(真实值y-预测值)的平方和最小:

梯度下降法实现:赋予初始θ 值,并根据公式逐步更新θ 使得J(θ) 不断减少,最终至收敛,对应的参数θ 即为解。为了推导方便,首先研究只有一个训练样本时,如何计算推导公式。
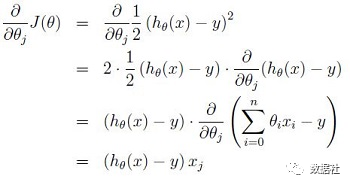
θ 的每个分量更新公式为:


推广到m个训练数据,参数更新公式为:


三、逻辑回归模型

逻辑回归与线性回归同属广义线性模型,逻辑回归是以线性回归为理论支持,是一个二分类模型,也可以推广多到分类问题,通过Sigmoid函数引入了非线性因素,因此可以轻松处理0/1分类问题,首先介绍一下Sigmoid函数:

sigmoid函数图像是一个S曲线,取值在[0, 1]之间,在远离0的地方函数的值会很快接近0或者1,sigmoid函数的求导特性是:
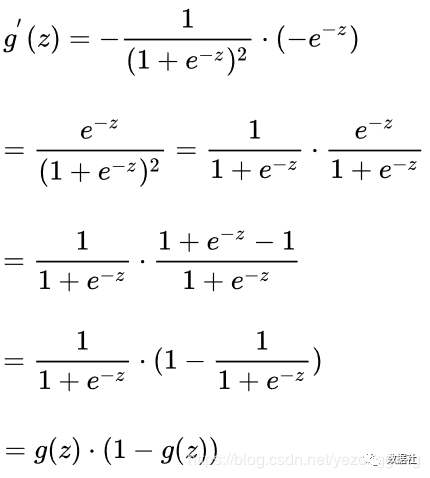

逻辑回归的预测函数是下图,只是在特征到结果的映射中加入了一层函数映射,先把特征线性求和,然后使用函数g(z)将最为假设函数来预测。g(z)可以将连续值映射到0到1之间:

通过求似然函数,两边取log后,对θ求偏导:
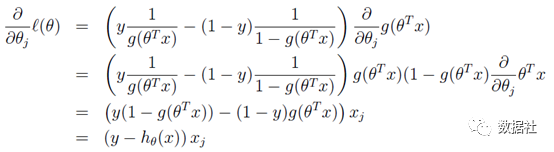

    这样我们就得到了梯度上升每次迭代的更新方向,那么θ的迭代表达式为:
   

发现同线性回归模型是同一个表达式,这并不仅仅是巧合,两者存在深层的联系;


四、回归模型使用

数据是2014年5月至2015年5月美国King County的房屋销售价格以及房屋的基本信息。数据分为训练数据和测试数据,分别保存在kc_train.csv和kc_test.csv两个文件中,其中训练数据主要包括10000条记录,14个字段:销售日期,销售价格,卧室数,浴室数,房屋面积,停车面积,楼层数,房屋评分,建筑面积,地下室面积,建筑年份,修复年份,纬度,经度。

数据集地址:https://github.com/yezonggang/house_price,按照流程完成模型建立:

import pandas as pd
from pandas import DataFrame
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
import seaborn as sns
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LinearRegression
# 数据读取
baseUrl="C:\\Users\\71781\\Desktop\\2020\\ML-20200422\\houre_price\\"
house_df=pd.read_csv(baseUrl+'train.csv' )
test_df=pd.read_csv(baseUrl+'test.csv')
house_df.head()


# 删除无关变量
house_df=house_df.drop(['saleTime','year','repairYear','latitude','longitude','buildingSize'],axis=1)
test_df=test_df.drop(['saleTime','year','repairYear','latitude','longitude','buildingSize'],axis=1)


# 模型建立
X_price=house_df.drop(['price'],axis=1)
# X_price.head()
Y_price=house_df['price']
Y_price.head()


LR_reg=LinearRegression()
LR_reg.fit(X_price, Y_price)
Y_pred = LR_reg.predict(test_df)
LR_reg.score(X_price, Y_price)


# 可以选择进行特征缩放
#new_house=house_df.drop(['price'],axis=1)
#from sklearn.preprocessing import MinMaxScaler
#minmax_scaler=MinMaxScaler().fit(new_house)   #进行内部拟合,内部参数会发生变化
#scaler_housing=pd.DataFrame(minmax_scaler.transform(new_house),columns=new_house.columns)


#mm=MinMaxScaler()
#mm.fit(test_df)
#scaler_t=mm.transform(test_df)
#scaler_t=pd.DataFrame(scaler_t,columns=test_df.columns)

文末福利

各位猿们,还在为记不住API发愁吗,哈哈哈,最近发现了国外大师整理了一份Python代码速查表和Pycharm快捷键sheet,火爆国外,这里分享给大家。

这个是一份Python代码速查表

下面的宝藏图片是2张(windows && Mac)高清的PyCharm快捷键一览图

怎样获取呢?可以添加我们的AI派团队的程序媛姐姐

一定要备注【高清图】哦

????????????????????

➕我们的程序媛小姐姐微信要记得备注【高清图】哦

来都来了,喜欢的话就请分享、点赞、在看三连再走吧~~~

数据挖掘作业一:线性回归、逻辑回归和支持向量机 中山大学软件工程数据挖掘第一次作业 github地址:https://github.com/linjiafengyang/DataMining 线性回归 某班主任为了了解本班同学的数学和其他科目考试成绩间关系,在某次阶段性测试中,他在全班学生中随机抽取1个容量为5的样本进行分析。该样本中5位同学的数学和其他科目成绩对应如下表: 利用以上数据,建立m与其他变量的多元线性回归方程。 ... 阅读详情

相关推荐

python 数据挖掘算法

1、首先简述数据挖掘的过程 第一步:数据选择 可以通过业务原始数据、公开的数据集、也可通过爬虫的方式获取。 第二步: 数据预处理 数据极可能有噪音,不完整等缺陷,需要对数据进行数据标准化,方法有min-max 标准化,z-score 标准化,修正的标准z-score。 第三步:特征值数据转换 将数据提取特征使这些数据符合特定数据挖掘算法的分析模型。数据模型有很多,等下详细讲解。 第四步:模型训练 选择好的数据挖掘算法...

lipeitong333的博客 1万+

零基础掌握数据挖掘之经典线性回归模型

从事数据分析或挖掘的童靴,最先接触到的预测模型肯定是线性回归和Logistic回归二分类模型。掌握好线性回归模型的原理及实现是继续深入学习机器学习及深度学习的基石。本课程会为大家详细讲解相关内容。详情参见课程大纲目录。

线性回归与逻辑回归的区别

在机器学习和数据挖掘领域,回归分析是一种重要的统计方法,用于建立自变量与因变量之间的关系。线性回归和逻辑回归是两种常见的回归分析方法,但它们适用于不同的场景。线性回归通常用于预测连续型变量,而逻辑回归则主要用于分类问题,预测离散型的类别。

qq_29715355的博客 1114

Python 数据处理数据挖掘(五):线性回归

声明本文为学习笔记,侵权删。一、相关系数r r类似于直线斜率k,r>0,则表示正相关,r

qq_46380784的博客 3459

线性回归、逻辑回归、RNN、CNN、KNN、SVM算法总结

常见的监督学习:线性回归、决策树、朴素贝叶斯分类、最小二乘法、逻辑回归、支持向量机、集成方法 常见的无监督学习:聚类算法、主成分分析、奇异值分解、独立成分分析。 常用的分类器包括SVM、KNN、贝叶斯、线性回归、逻辑回归、决策树、随机森林、xgboost、GBDT、boosting、神经网络NN。 常见的降维方法包括TF-IDF、主题模型LDA、主成分分析PCA等等 常用的回归技术:线性回归、多项...

BigDataEngineer的博客 1万+

线性回归和逻辑回归损失函数推导

线性回归和逻辑回归损失函数推导 @(数据挖掘) 线性回归和逻辑回归损失函数推导 一、线性回归最小二乘loss推导 二、logistics回归加sigmoid原因以及交叉熵损失函数推导 一、线性回归最小二乘loss推导 我们都知道线性回归是机器学习中最简单,使用范围也很广的一个算法,经典且使用。而它的损失函数最小二乘损失,大家也很熟悉,但是为什么要用最小二乘loss呢?正...

AndrewHR的博客 7370

数据挖掘——逻辑回归

《数据挖掘》国防科技大学 数据挖掘之逻辑回归 回归问题 Regression 回归分析是研究一个或多个自变量与一个因变量之间是否存在某种线性关系或非线性关系的一种统计学方法。 线性回归 多项式回归 逻辑回归 决策树回归 线性回归 一元线性回归:y = a + bx 线性关系刻画(点到直线的距离) 点到直线的距离公式(垂直距离) 点到直线的纵向距离(竖直距离) 最小二乘法 逻辑回归 参数估计 正则化 w在数值上越小与能抵抗数据的扰动。 优化 优化求解 梯度下降法 梯度的本意是一个向量

Lilo_的博客 768

数据挖掘算法和实践(一):线性回归和逻辑回归(house_price数据集)

数据挖掘算法基于线性代数、概率论、信息论推导,深入进去还是很有意思的,能够理解数学家、统计学家、计算机学家的智慧,这个专栏从比较简单的常用算法入手,后续将研究基于TensorFlow的高级算法,最好能够参与到人脸识别和NLP的实际项目中,做出来一定的效果,希望能坚持。 一、理解线性回归模型 首先讲回归模型,回归模型研究的是因变量(目标)和自变量(预测器)之间的关系,因变量可以是连续也可以离散,...

叶子叶来 6634

数据挖掘从入门到放弃:线性回归和逻辑回归

公众号后台回复“图书“,了解更多号主新书内容作者:yzq来源:数据社“数据挖掘算法基于线性代数、概率论、信息论推导,深入进去还是很有意思的,能够理解数学家、统计学家、计算机学家的智慧,...

数据森麟 407

RapidMiner工具应用:线性回归与逻辑回归实战解析

在当今数字化时代,数据挖掘和数据分析是企业获取竞争优势的重要途径。数据挖掘利用机器学习、统计学和人工智能技术从大量的数据中识别模式和建立预测模型。数据分析则是对数据进行深入审查,以揭示其中的趋势、模式和关联,支持商业决策。快速数据挖掘和数据分析要求在最短的时间内,通过合理有效的分析方法,从数据中提取出有价值的信息。为了达成这一目标,本章将介绍数据挖掘和数据分析的基础知识,包括数据挖掘过程的关键步骤以及分析方法的选取。

weixin_42510201的博客 1217

数据挖掘线性回归算法简介.pdf

数据挖掘线性回归算法简介.pdf

数据挖掘—— 线性回归

R平方的替代方案称为调整后的R平方,它会惩罚模型的复杂性(控制过度拟合),但它通常会使复杂性不足。R平方是解释的方差的比例,意味着由模型解释的观察数据中的方差比例,或者在空模型上的误差减少。可以看到蓝线解释了数据中的一些方差(R平方= 0.54),绿线解释了更多的方差(R平方= 0.64),红线更符合训练数据( R平方= 0.66)。正确答案是高偏差/低差异。Statsmodels计算我们的模型系数的95%置信区间,其解释如下:如果抽取该样本的人口被抽样100次,那么大约95个置信区间将包含“真实”系数。

2301_78602152的博客 2412

S4 HANA 1809+折旧过账(AFAB/AFABN)凭证行数据存储逻辑变迁:从BSEG到ACDOCA的深度解析

本文深度解析了S4 HANA 1809+版本中折旧过账(AFAB/AFABN)凭证行数据存储逻辑的变迁,从传统的BSEG表迁移到ACDOCA表。文章详细探讨了这一变更的技术背景、官方设计意图及实际影响,包括数据存储量减小和系统性能提升等优势。同时提供了升级项目的应对策略和最佳实践建议,帮助用户顺利过渡到新的数据存储模型。

weixin_28731223的博客 294

线性回归csv数据集_数据挖掘从入门到放弃(一):线性回归和逻辑回归

“数据挖掘算法基于线性代数、概率论、信息论推导,深入进去还是很有意思的,能够理解数学家、统计学家、计算机学家的智慧,这个专栏从比较简单的常用算法入手,后续研究基于TensorFlow的高级算法,最好能够参与到人脸识别和NLP的实际项目中,做出来一定的效果。”一、理解线性回归模型首先讲回归模型,回归模型研究的是因变量(目标)和自变量(预测器)之间的关系,因变量可以是连续也可以离散,如果是...

weixin_39517546的博客 1273

1991-2020年气候背景数据集

2011 年,国家气象信息中心对 1951-2010 年 2400 余个地面站气温、气压、降水、湿度、日照等 19 大要素项的定时观测资料和日极值资料中由数字化过程中引起的系统性问题(例如数字化遗漏、整段拷贝等问题)进行质量检测、质量控制和错误数据的更正,形成较高质量的地面基础资料集。1991-2020年中国地面气候值数据集提供了中国2438个站点的气温、降水、气压、风向风速、相对湿度、水汽压、云、天气现象、能见度、蒸发、积雪、地温、冻土、日照共14个要素的气候背景信息。数据时间:30年平均。

地球资源数据云的官方博客 1599

数字IC后端手把手实战教程 | Innovus verify_drc VIA1 DRC Violation解析及脚本自动化修复方案

数字IC后端实战项目案例之Innovus verify_drc DRC Violation脚本自动化修复方案

weixin_37584728的博客 4056

【机器学习】线性回归和逻辑回归的关系以及LinearRegression、LogisticRegression两种类的基本概念

线性回归用于估计两个或多个变量之间的定量关系,目的是预测连续型变量,如房价、股票价格等逻辑回归是一种广义的线性回归分析模型,主要用于解决分类问题,特别是二元分类问题。它通过sigmoid函数将线性回归的输出映射到0和1之间,表示某个事件发生的概率

ya的博客 1848

辛普森悖论:识别数据聚合偏误与混杂变量的实战指南

辛普森悖论是一种典型的聚合偏误现象,源于未控制的混杂变量导致分组分配不均,使整体统计结果与各子群真实效应方向相反。其本质不是数据错误,而是因果推断框架在忽略结构异质性时的失效。该悖论在医疗临床试验、AB测试、商业归因等高频场景中隐蔽性强、触发门槛低,常造成决策反转。掌握分层分析方法、Cochran-Mantel-Haenszel检验及双Y轴可视化技术,可有效识别并破解误导性汇总结论。本文聚焦辛普森悖论与数据误导两大核心问题,提供从诊断、验证到汇报的全流程工程化应对方案。

weixin_28520495的博客 508

数据挖掘之逻辑回归

逻辑回归作为一种简单而强大的分类算法,常被用作数据挖掘项目的起点。在具备线性分界的分类任务中,它不仅计算高效,而且结果易于解释。然而,在面对更复杂的非线性数据时,可以结合其他高级模型如决策树、随机森林或神经网络,进一步提升性能。无论如何,逻辑回归以其独特的优势,在数据挖掘领域占据了不可或缺的位置,为解决各类实际问题提供了有力支持。

dundunmm的博客 916

基于 YOLOv26 的遥感图像目标检测系统:从原理到模型

本文介绍了基于YOLOv26的遥感图像目标检测系统。YOLOv26凭借端到端设计、轻量化架构和小目标优化能力,有效解决了遥感图像中多尺度目标、复杂背景、小目标检测等挑战。系统采用CSPDarknet骨干网络和FPN+PAN特征融合模块,通过MuSGD优化器和改进损失函数提升训练效果。文章详细阐述了数据预处理、模型训练流程和优化技巧,包括Tile推理和混合精度训练。系统支持多种部署方式,在CPU上推理速度提升43%,能实现高精度、实时性的遥感目标检测,适用于城市规划、农业监测等场景。

一键难忘的博客 571

11、频率响应与伯德图详解

本文详细介绍了电子电路分析中的频率响应与伯德图,涵盖分贝的定义与计算、带宽与3dB点、放大器反馈机制、倍频程与十倍频程概念,并系统讲解了基于实数和复数零极点的伯德图构建方法。通过具体示例分析了传递函数的渐近近似、幅度与相位响应,并结合MATLAB工具展示了伯德图的绘制过程。文章旨在帮助读者深入理解电路在不同频率下的行为特性,为电路设计与优化提供理论支持。

white的博客 173

数据挖掘:Spark MLlib和Mllib

1.背景介绍 数据挖掘是指从大量数据中发现有价值的信息和规律,以解决实际问题。随着数据的增长,传统的数据挖掘技术已经无法满足需求。为了解决这个问题,Apache Spark项目提供了一个名为MLlib的机器学习库,可以用于大规模数据挖掘。 MLlib是Spark的一个子项目,专门为大规模机器学习提供支持。它提供了许多常用的机器学习算法,如梯度下降、随机梯度下降、支持向量机、决策树、K-均值聚类...

AI天才研究院 1092

AutoSAR配置与实践(实践篇)11.1 如何通过IPDU分组控制报文收发

注意这个新增的action其实是一个用户回调函数,在函数中进行配置字的判断,即可完成用户条件的判断(TRUE/FALSE),注意用户条件是用户封装的函数,用于输入给后续的逻辑判断和rule。进行PDU的拆分后,根据配置字可以选择PDU是否使能了。PDU组拆分后可分为常规PDU组和可配PDU组(新增),诊断一方面按原有逻辑控制常规PDU组,另一方面控制新的可配PDU组。举例说明,诊断场景:使能,配置字满足,则用户条件为TURE,表示期望使能可配PDU组(诊断禁止服务场景类似方式,在此不再列举)。

nihaoljq2010的博客 834

机器学习 之线性回归、逻辑回归、 SVM支持向量机、随机森林

机器学习 之线性回归、逻辑回归、 SVM支持向量机、随机森林

水w的博客 6709

(持续更新中!)详解【计算机类&面试真题】军队文职考试 ——第一期(真题+解析)| TCP、UDP的区别;程序局部性;ICMP协议及主要功能;重定位所需的计算机硬件

在当今信息化时代,军队中对于计算机专业人才的需求与日俱增。因此,了解面试和复试中常见的问题和要求对于准备应聘者来说至关重要。本文将围绕面试的准备要点、常见问题以及面试技巧进行探讨,并提供一些建议和经验。通过了解面试和复试的准备要点、常见问题以及技巧,读者将能够提升应对能力和成功率。本文为准备军队文职面试和计划考研复试的读者提供了有价值的参考和指导。通过阅读本篇博客,读者将能够获得关于军队文职计算机类面试和计算机考研复试的全面了解,提升自身的应对能力和成功率。

追光者♂:记录、分享、总结、提升,现象级专栏《Python从入门到人工智能》作者,无惧黑暗,坚信曙光 1690

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

上一篇: 算法刷题宝典.pdf
下一篇: 手绘 10 张图,把 CSRF 跨域攻击、JWT 跨域认证说得明明白白的
Wang_AI
博客等级 码龄12年 997粉丝 162原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值