具身智能:原理、算法与系统 第19章 技能学习与运动原语

机械臂示教轨迹参数化方法 DMP, Dynamic Movement Primitive (一) 一般的DMP是按照单个维度进行拟合的,如果涉及到位姿表示的方向问题,我们需要查看更多的文章,拟合的时候也需要多个维度同时拟合以满足方向的表达满足的约束条件,如四元数的范数为1。多条DMP轨迹拼接DMP架构的小改进,DMP的时间信号,Canonical System的设计,forcing term的建模方式和高斯混合模型中核函数的选择等DMP的速度曲线的拟合和调整多条示教轨迹情况下怎么处理等。...... 阅读详情

目录

第19章 技能学习与运动原语

19.1 动态运动原语(DMP)

19.1.1 DMP的数学形式

19.1.2 形状吸引子与目标吸引子

19.1.3 DMP的学习与调制

19.1.4 DMP的扩展与应用

19.2 概率运动原语(ProMP)

19.2.1 轨迹分布表示

19.2.2 条件概率与风格变化

19.2.3 ProMP的强化学习

19.2.4 与其他原语的比较

19.3 隐式策略表示

19.3.1 神经网络策略

19.3.2 扩散策略(Diffusion Policy)

19.3.3 流匹配与生成模型

19.3.4 隐式行为克隆

19.4 技能组合与重用

19.4.1 技能库构建

19.4.2 技能序列学习与自动机

19.4.3 技能转移与适应

19.4.4 终身技能积累


第19章 技能学习与运动原语

19.1 动态运动原语(DMP)

动态运动原语(Dynamic Movement Primitives, DMP)是一种用于表示和学习机器人运动的标准化框架,通过非线性动态系统编码目标导向的运动轨迹。DMP的核心优势在于其稳定性保证、对目标点和速度的适应性,以及便于从示范中学习。

19.1.1 DMP的数学形式

DMP由一组非线性微分方程定义,包含变换系统(transformation system)与正则系统(canonical system)两个耦合部分。变换系统描述系统的运动动力学,正则系统提供时间依赖的相位变量。

对于单自由度系统,变换系统表示为:
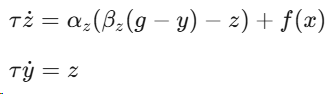
正则系统提供单调递减的相位变量 x :

\tau\dot{x} = -\alpha_x x

其中 \alpha_x为衰减系数。相位变量 x 从1指数衰减至0,替代显式时间依赖,使系统对时间扰动具有鲁棒性。

非线性强迫项 f(x) 由基函数的线性组合构成:
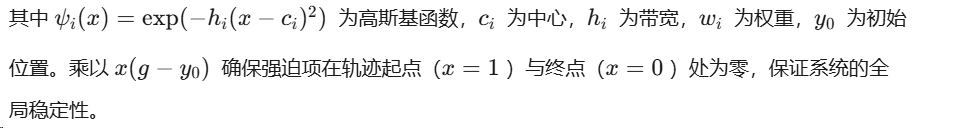
f(x) = \frac{\sum_{i=1}^N \psi_i(x)w_i}{\sum_{i=1}^N \psi_i(x)}x(g-y_0)

19.1.2 形状吸引子与目标吸引子

DMP包含两个吸引子机制:形状吸引子(shape attractor)与目标吸引子(goal attractor)。目标吸引子由线性动态系统的收敛特性保证,确保系统最终到达目标位置 g 。形状吸引子通过非线性强迫项f(x)编码期望的轨迹形状。

目标吸引子的稳定性由特征方程分析:当 \alpha_z > 0 且 \beta_z > 0时,线性系统矩阵的特征值实部为负,保证渐近稳定性。即使存在外部扰动,系统仍能收敛至目标点。

形状吸引子通过基函数权重 wi​ 编码任意复杂的轨迹形状。权重学习通常采用局部加权回归(Locally Weighted Regression, LWR),最小化示范轨迹与DMP生成轨迹之间的误差:

\min_{w_i} \sum_{t}(y_{\text{demo}}(t)-y_{\text{DMP}}(t))^2

每个基函数的权重独立学习,实现局部泛化:修改轨迹某段的形状不会影响其他段。

对于周期性运动(如行走、跑步),DMP扩展为节律形式,使用相位振荡器替代衰减正则系统:
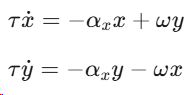
其中 ω 为振荡频率,(x,y) 在极限环上运动,产生周期性相位变量。

19.1.3 DMP的学习与调制

DMP的学习过程从示范轨迹中提取权重参数。给定示教轨迹 \{y_{\text{demo}}(t), \dot{y}_{\text{demo}}(t), \ddot{y}_{\text{demo}}(t)\}_{t=0}^T ,首先计算期望的强迫项:

f_{\text{target}}(x) = \tau^2\ddot{y}_{\text{demo}} - \alpha_z(\beta_z(g-y_{\text{demo}})-\tau\dot{y}_{\text{demo}})

然后通过线性回归求解权重 wi​ 。这种学习方法保证DMP能够精确复现示范轨迹。

DMP的调制能力体现在多个方面:目标点调制通过改变 g 实现,系统自动生成到达新目标的轨迹;速度调制通过调整 τ 实现,加速或减速运动而不改变形状;空间调制通过仿射变换(旋转、缩放)实现,适应不同的任务配置。

耦合项(Coupling Term)扩展DMP以响应外部信号。例如,在避障场景中,添加排斥势场耦合项:

C_t = \sum_{j} \eta \exp(-\gamma \|y-o_j\|)\frac{y-o_j}{\|y-o_j\|}

其中o_j为障碍物位置,η 与 γ 为增益参数。耦合项插入变换系统的速度方程,使轨迹实时偏离障碍物。

19.1.4 DMP的扩展与应用

DMP的扩展包括多自由度协调、时间耦合与层次化组合。多自由度DMP通过共享正则系统实现同步,所有自由度使用相同的相位变量 x ,确保各关节运动的时序协调。

时间耦合(Temporal Coupling)允许DMP根据外部事件调整执行速度。通过监测与目标的距离或感知信号,动态调整时间缩放因子 τ ,实现反应式运动调整。

层次化DMP组合多个原语形成复杂行为。高层DMP生成子目标序列,低层DMP执行具体运动。这种层次结构支持任务分解与复用,如行走DMP调用迈步DMP,迈步DMP调用关节轨迹DMP。
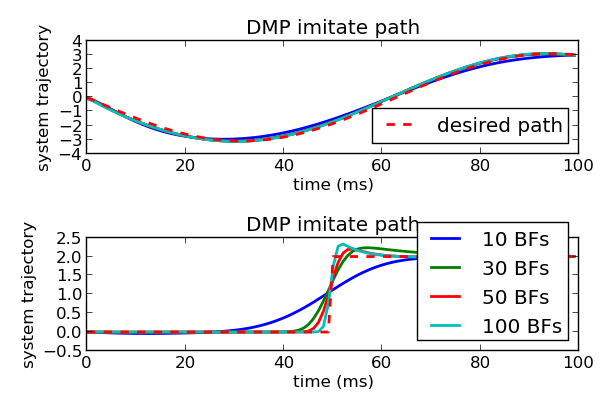
DMP Trajectory Learning

图19.1:DMP轨迹学习与基函数数量影响。上图显示DMP对期望路径的拟合能力,下图展示不同数量基函数(10-100个)对轨迹形状表达能力的影响。更多基函数支持更复杂的形状,但也增加计算负担与过拟合风险。

DMP在机器人操作、行走、抓取等任务中广泛应用。其优势在于数学形式简洁、稳定性保证明确、便于学习与调制。局限性包括难以处理硬约束(如关节限位)、对高维系统的扩展性有限,以及缺乏概率不确定性表示。

19.2 概率运动原语(ProMP)

概率运动原语(Probabilistic Movement Primitives, ProMP)是DMP的概率扩展,将确定性轨迹表示为概率分布,支持不确定性量化、风格变化与强化学习。

19.2.1 轨迹分布表示

ProMP将轨迹建模为时间相关的随机过程,通过权重空间的概率分布诱导轨迹分布。假设权重 w 服从高斯分布:
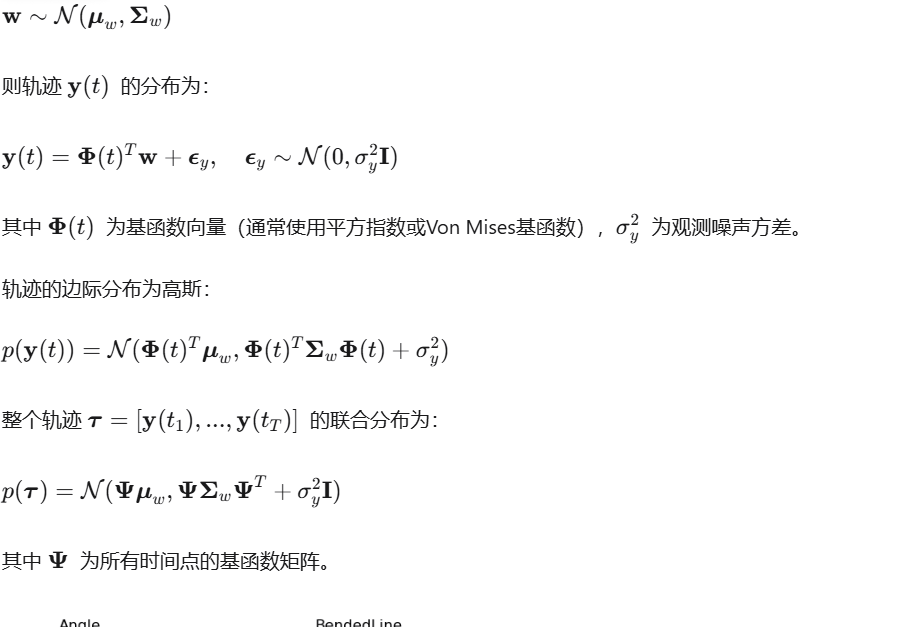
ProMP Trajectory Distribution

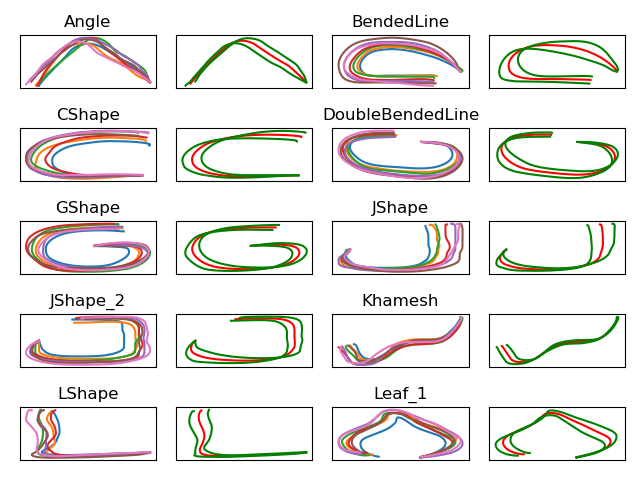
图19.2:ProMP在LASA数据集上的轨迹分布。每种形状显示多条示范轨迹(灰色)与学习的概率分布(绿色为均值,红色为方差)。ProMP捕捉轨迹的变异性,支持在约束下的概率推理。

ProMP的学习通过最大似然估计或贝叶斯推断实现。给定示范轨迹集\{\boldsymbol{\tau}_i\}_{i=1}^M​ ,权重后验为:

p(\mathbf{w}|\{\boldsymbol{\tau}_i\}) \propto p(\mathbf{w})\prod_{i=1}^M p(\boldsymbol{\tau}_i|\mathbf{w})

高斯先验与共轭似然导致高斯后验,解析更新均值与协方差。

19.2.2 条件概率与风格变化

ProMP的条件概率分布支持在部分观测或约束下的轨迹推理。给定经由点(via-point)约束
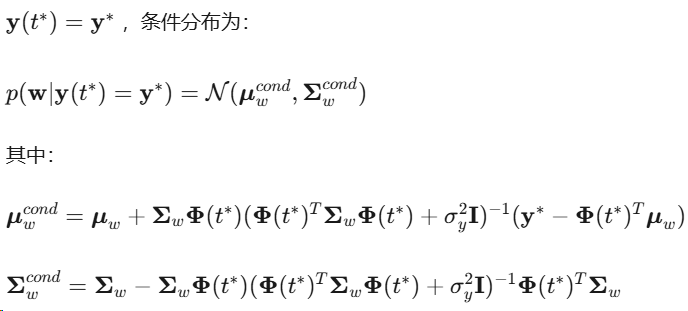
条件分布调整均值以通过约束点,同时减小方差反映增加的确定性。

风格变化(Style Variation)通过隐变量模型实现。假设存在风格参数 s (如运动幅度、速度),影响权重分布:

p(\mathbf{w}|\mathbf{s}) = \mathcal{N}(\boldsymbol{\mu}_w(\mathbf{s}), \boldsymbol{\Sigma}_w(\mathbf{s}))

通过从示范中分离风格与内容,ProMP能够生成风格一致的新轨迹。风格参数可通过最大似然或变分推断学习。

19.2.3 ProMP的强化学习
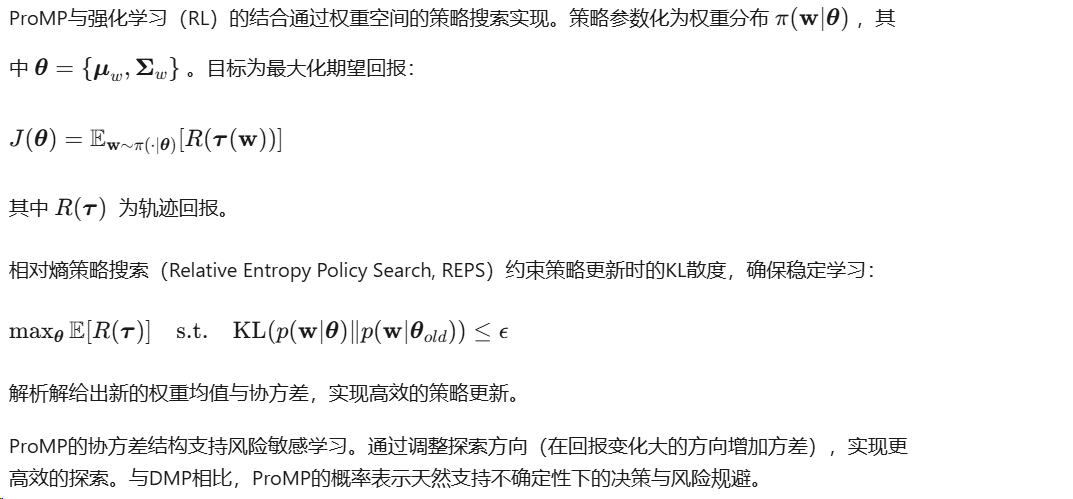
19.2.4 与其他原语的比较

ProMP与DMP的主要区别在于概率表示。DMP提供确定性轨迹,稳定性由动态系统保证;ProMP提供轨迹分布,支持不确定性推理与约束满足。DMP的非线性强迫项能够表达复杂形状,但学习需要回归;ProMP的线性权重模型简化学习,但形状表达能力受限于基函数选择。

与隐马尔可夫模型(HMM)相比,ProMP专注于连续轨迹生成,而HMM擅长离散状态转换。ProMP与HMM的结合(如HSMM)同时捕捉时间结构与状态转换,适用于分段运动学习。

PRIMP(Probabilistically-Informed Motion Primitives)扩展ProMP到工作空间(而非关节空间),支持机器人无关的技能表示与迁移。通过学习末端执行器轨迹的6D位姿分布(位置+方向),PRIMP能够在不同机器人之间传递技能,通过工作空间密度适应目标机器人的运动学特性。

19.3 隐式策略表示

隐式策略表示通过能量函数或评分函数定义策略,而非显式的条件分布。这种表示支持多模态动作分布、组合泛化与高维动作空间的学习。

19.3.1 神经网络策略
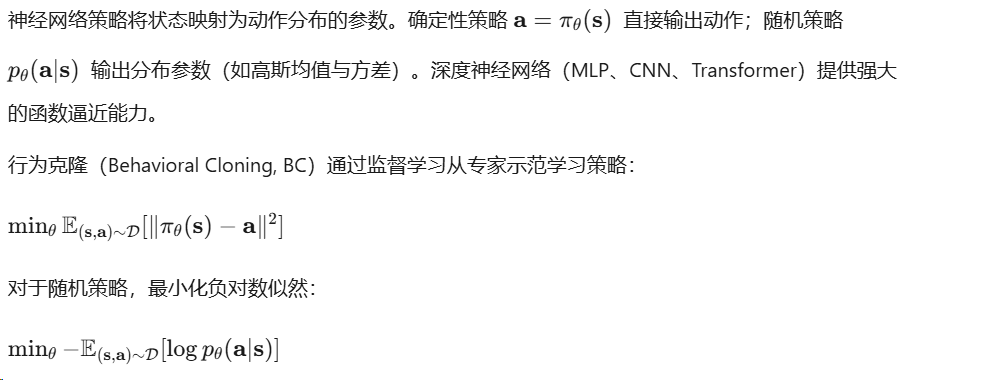
Behavioral Cloning Neural Network

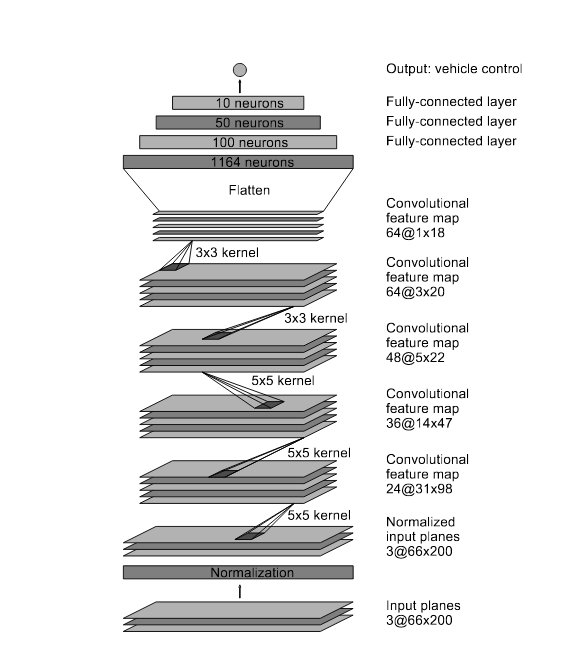
图19.3:行为克隆的神经网络架构。输入图像经过卷积层提取特征,与状态信息拼接后通过全连接层输出动作。这种端到端学习直接从感知映射到控制,但面临分布偏移与复合误差问题。

神经网络策略的局限性包括:难以表达多模态分布(混合高斯假设模态数固定),对分布外状态泛化能力差,以及缺乏对动作约束的显式处理。

19.3.2 扩散策略(Diffusion Policy)

扩散策略(Diffusion Policy, DP)将策略表示为去噪扩散概率模型(DDPM),通过迭代去噪从随机噪声生成动作。这种表示能够表达任意复杂的、多模态的动作分布。

前向扩散过程逐步添加高斯噪声:
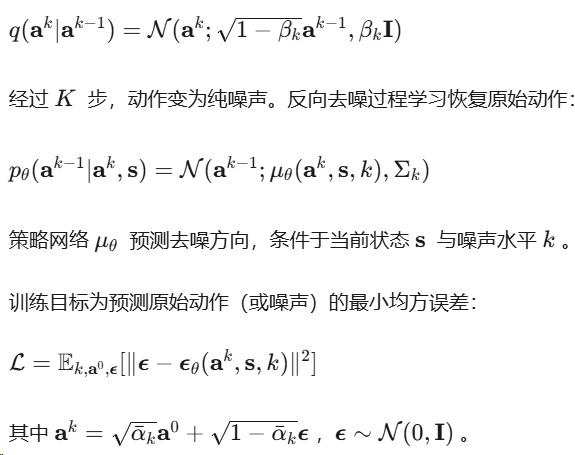
扩散策略的优势包括:表达多模态分布(如绕过障碍物的左右两条路径),训练稳定性(去噪目标比直接回归更容易学习),以及动作序列的一致性(通过预测动作块而非单步动作)。DP3(3D Diffusion Policy)将点云表示与扩散策略结合,在3D操作任务中实现 state-of-the-art 性能。

19.3.3 流匹配与生成模型

流匹配(Flow Matching, FM)是替代扩散模型的生成方法,直接学习概率路径的向量场,实现更高效的采样。与扩散的随机微分方程(SDE)不同,流匹配使用常微分方程(ODE):
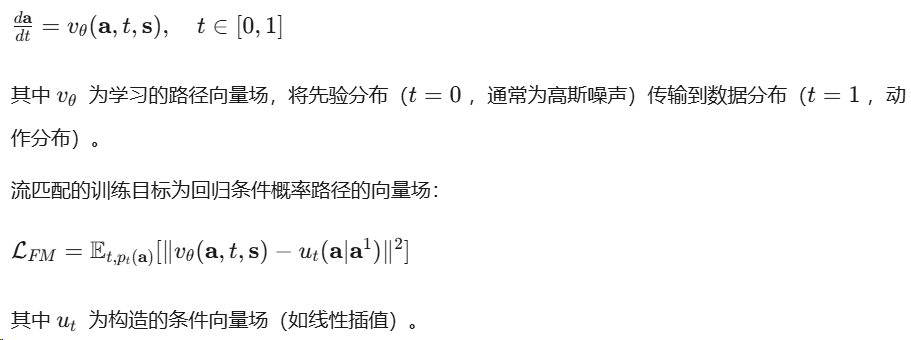
流匹配的优势在于:确定性采样(ODE积分无需随机性),更快的推理(更少的函数评估),以及更好的数值稳定性。MP1(MeanFlow Policy)将流匹配应用于机器人策略学习,实现单步推理,显著加速动作生成。

19.3.4 隐式行为克隆
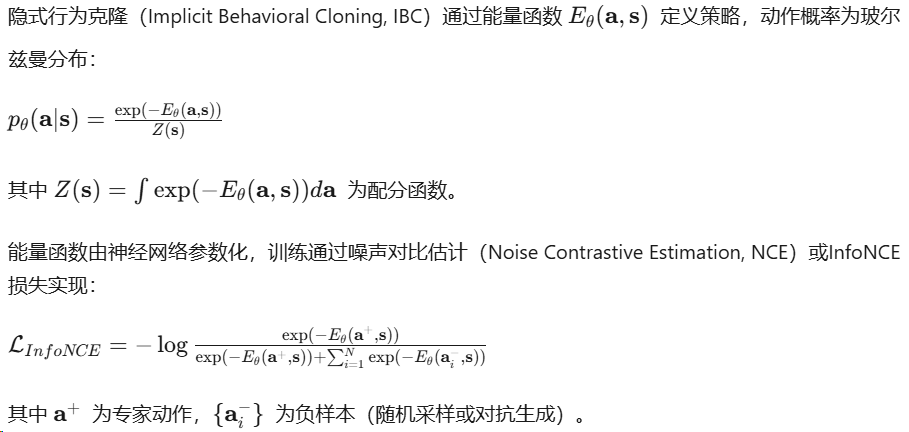
Implicit Policy Energy Based Model

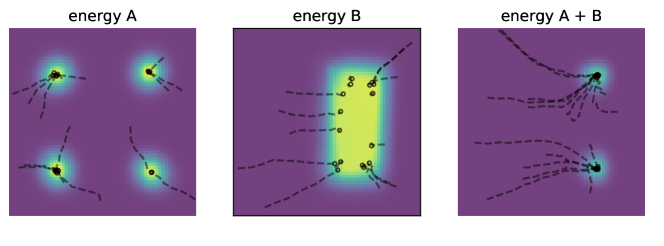
图19.4:隐式策略的能量函数表示。能量A与能量B定义不同的动作偏好,能量A+B通过乘积组合(对应能量相加)实现策略的组合。这种组合性支持零样本的任务组合与泛化。

推理时通过Langevin动力学或梯度下降采样动作:

\mathbf{a}_{k+1} = \mathbf{a}_k - \alpha \nabla_\mathbf{a} E_\theta(\mathbf{a}_k, \mathbf{s}) + \sqrt{2\alpha}\boldsymbol{\epsilon}

隐式策略的优势包括:组合性(能量相加对应分布乘积),对多模态分布的自然表达,以及通过能量景观的形状编码约束。局限性在于推理需要迭代优化,计算成本高于显式前向传播。

19.4 技能组合与重用

技能组合与重用是实现机器人终身学习的关键,使智能体能够积累技能库、组合现有技能解决新任务,并在相似任务间迁移知识。

19.4.1 技能库构建

技能库(Skill Library)是机器人可复用行为的结构化集合。每个技能包含:动作原语(如DMP、ProMP或神经网络策略),前置条件(技能适用的状态),后置条件(执行后的状态变化),以及成功概率。

技能发现(Skill Discovery)从未标注的交互数据中识别可复用的行为模式。无监督方法基于状态空间的分割(如聚类、图分割)或变化点检测识别技能边界。LOTUS(Learning from Observations via Unsupervised Skill Discovery)通过变分推断学习离散技能表示,同时优化技能分解与策略学习。
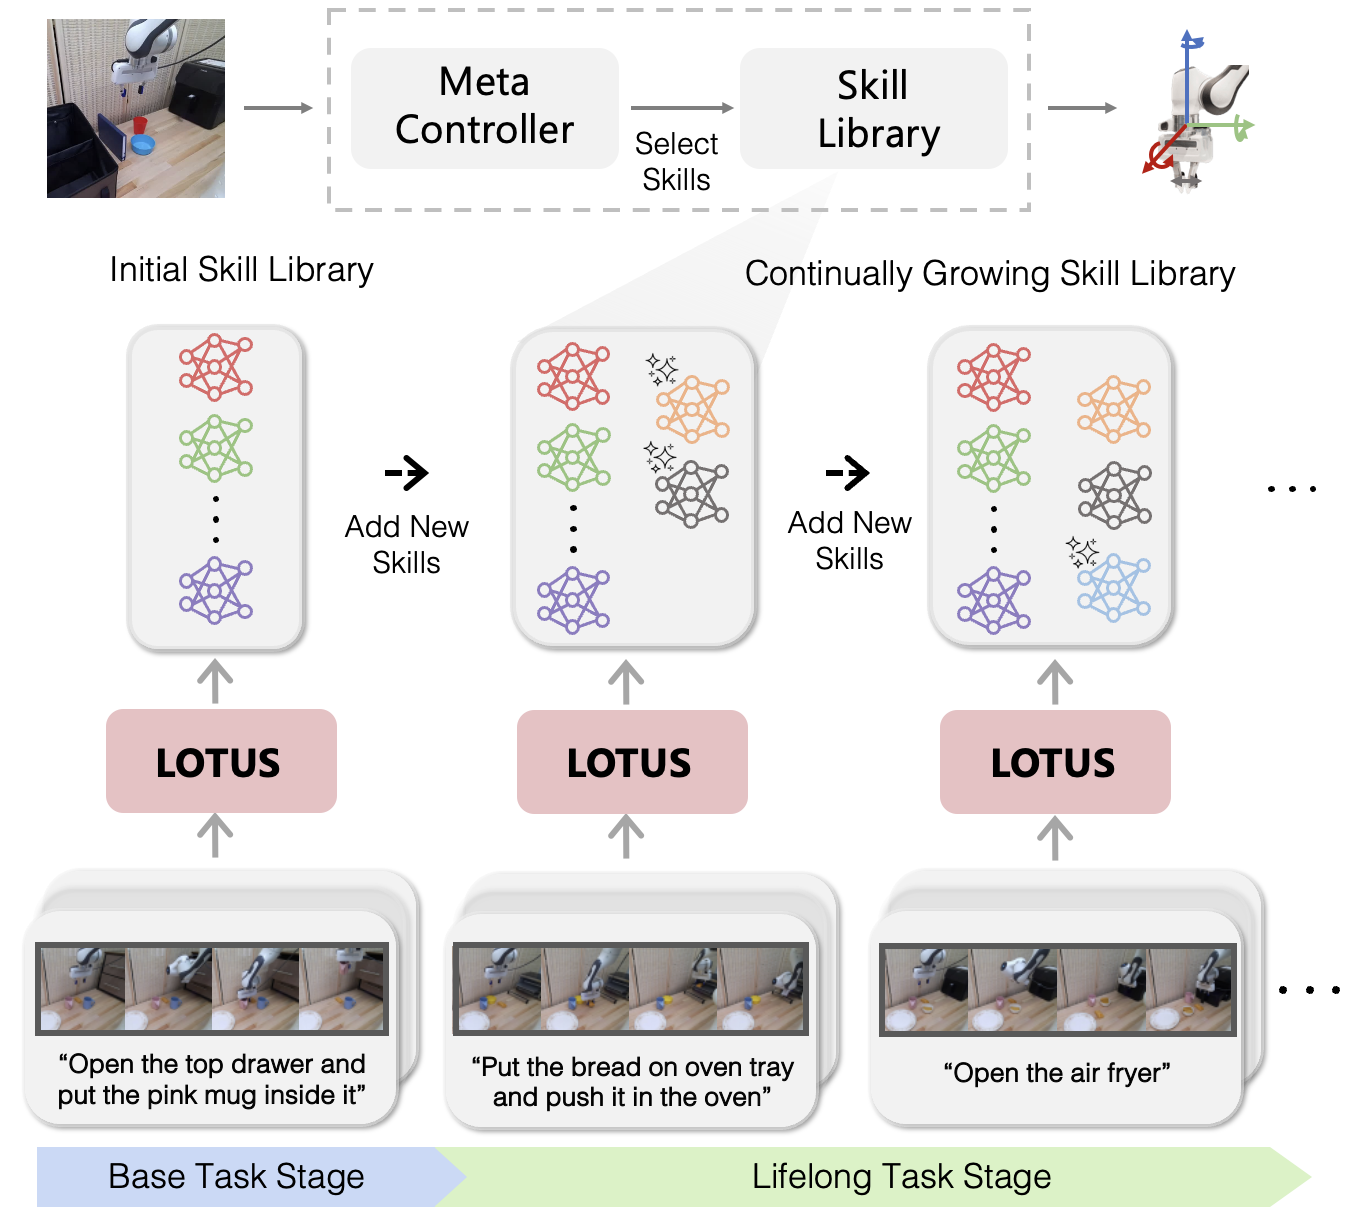
Skill Library Learning

图19.5:LOTUS终身技能学习框架。初始技能库通过无监督发现从示教数据中提取。面对新任务时,元控制器选择相关技能组合,必要时添加新技能。技能库持续增长,支持不断扩展的任务范围。

技能库的组织影响检索效率。基于语义的索引(如自然语言描述、视觉特征)支持根据任务描述检索相关技能。层次化组织(从原子技能到复合技能)支持不同抽象层次的规划。

19.4.2 技能序列学习与自动机

复杂任务需要按特定顺序执行多个技能。技能序列学习识别技能间的依赖关系与合法转换。有限状态自动机(Finite State Machine, FSM)显式编码技能转换规则,每个状态对应一个技能,转换条件基于状态观测。

隐马尔可夫模型(HMM)与半马尔可夫模型(HSMM) probabilistically 建模技能序列,从示范中学习转换概率与持续时间。HSMM显式建模技能持续时间,适用于非均匀时间尺度的技能。

选项框架(Options Framework)将技能形式化为时间扩展的动作,包含:启动集(技能适用的状态),内部策略(技能执行期间的控制),与终止条件(技能结束的判断)。选项框架与标准RL框架兼容,支持在技能空间而非原始动作空间进行规划。

19.4.3 技能转移与适应

技能转移(Skill Transfer)将在源任务或源机器人学到的技能应用于目标任务或目标机器人。基于原语的转移利用DMP/ProMP的调制能力:改变目标点、速度或形状以适应新情境。基于模型的转移学习源任务与目标任务间的映射(如状态空间对齐、动作空间重定向)。

领域随机化(Domain Randomization)在训练时随机化模拟参数(摩擦、质量、几何),学习对参数变化鲁棒的技能,实现从模拟到真实的零样本转移。元学习(Meta-Learning)学习"如何快速学习新技能",在遇到新任务时通过少量适应步骤调整策略。

技能适应(Skill Adaptation)在线调整技能参数以应对环境变化。贝叶斯适应更新技能后验分布,强化学习调整技能策略,阻抗控制调整交互刚度。适应的速度与范围取决于技能表示的选择:显式参数(如DMP权重)易于快速调整,隐式表示(如神经网络)需要更多数据但支持更大变化。

19.4.4 终身技能积累

终身学习(Lifelong Learning)要求机器人在不断学习新技能的同时保持旧技能,避免灾难性遗忘(Catastrophic Forgetting)。弹性权重巩固(Elastic Weight Consolidation, EWC)识别对旧任务重要的网络参数,在学习新任务时施加惩罚保护这些参数。
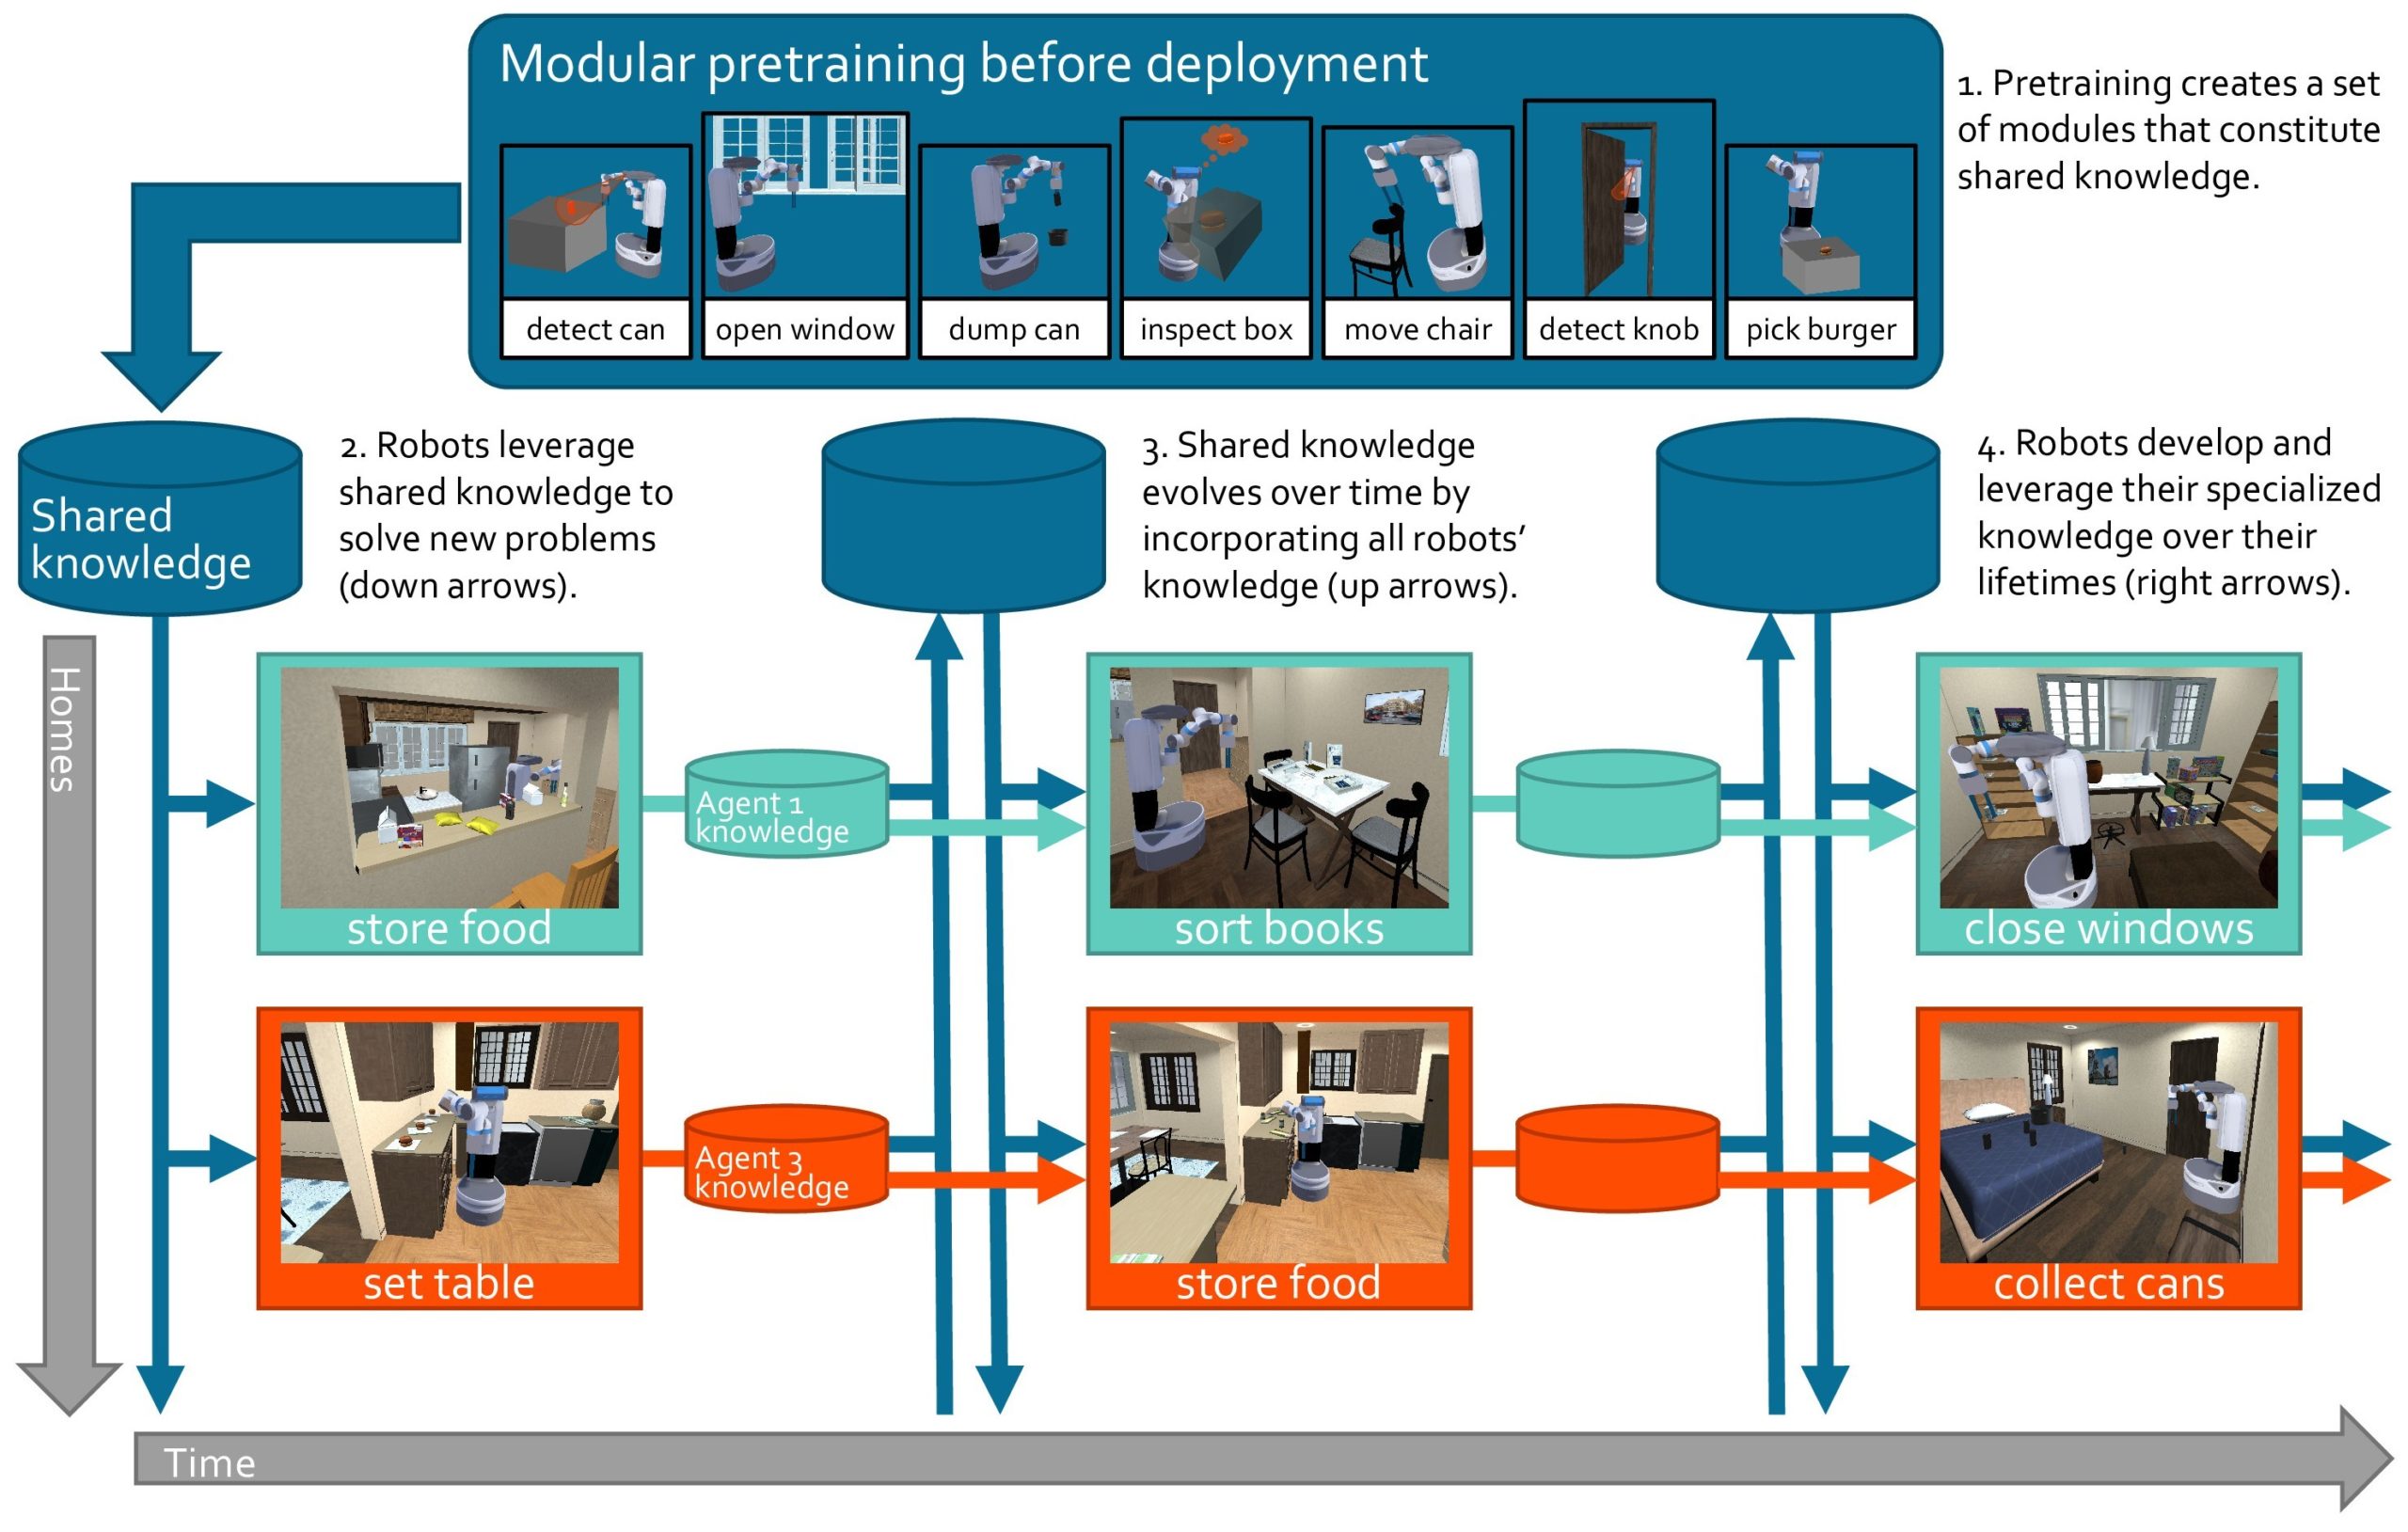
Lifelong Robot Learning

图19.6:模块化终身学习架构。技能库以模块化形式存储,新技能通过元学习快速添加。技能选择基于任务相似性,执行时组合相关技能。模块化设计隔离技能间的干扰,支持持续积累而不遗忘。

模块化架构将技能存储为独立模块(如专家混合Mixture of Experts),新技能添加新专家而非修改共享参数。稀疏激活确保只有相关专家参与推理,减少计算成本与技能间干扰。稀疏扩散策略(Sparse Diffusion Policy, SDP)采用MoE架构,在保持性能的同时实现高效的多任务与持续学习。

技能积累还涉及技能间的知识迁移与组合。组合性(Compositionality)允许从有限原子技能生成无限复合技能。层次化技能学习发现技能间的抽象关系,支持跨领域迁移。元认知(Metacognition)使机器人能够评估自身技能库的覆盖范围,识别知识缺口并主动寻求相关学习经验。


本章小结

技能学习与运动原语为具身智能系统提供了从示范中学习、表示与复用行为的能力。动态运动原语通过非线性动态系统编码稳定的目标导向运动;概率运动原语引入不确定性表示,支持约束推理与强化学习;隐式策略表示通过扩散模型与能量函数表达复杂的多模态分布;技能组合与重用实现了终身学习与持续适应。这些技术的融合正推动机器人从单一任务执行者向通用智能体演进,能够在开放环境中不断积累知识、适应变化并解决新颖挑战。

参数化曲线(四):动态运动基元 阅读详情

相关推荐

matlab非参数代码-robInfLib-matlab:内核化运动原语(KMP)

matlab非参数代码 robInfLib-matlab Robot Inference Library (robInfLib) provides various demos of using Kernelized Movement Primitives, which is maintained by Dr. Yanlong Huang (University of Leeds) Part of the codes are provided by Dr. João Silvério, Dr. Fares J. Abu-Dakka and Dr. Sylvain Calinon, which have been acknowledged in the corresponding files. 演示插图 内核化运动原语 I (demo_KMP01.m, ref. [1]) **使用 GMM/GMR 的模型字母“G”** **使用 KMP(均值)进行轨迹适应** 内核运动原语 II (demo_KMP02.m, ref. [2]) **使用 GMM/GMR 的模型字母“B”** **使用 K

Dynamic Movement Primitives与UR5机械臂仿真

Dynamic Movement Primitives (DMP),中文译名为动态运动基元、动态运动原语等,最初是由南加州大学的Stefan Schaal教授团队在2002年提出来的,是一...

博士的沙漏的专栏 2625

ist的matlab代码-pydmps:pydmps

ist的matlab代码pydmps 动态运动原语(DMP)是Stefan Schaal实验室的一种轨迹控制/计划方法。 早在2002年,它们就在本文中提出(),然后在2013年由Auke Ijspeert在本文中进行了更新()。 这项工作的动机是希望找到一种表示复杂电动机动作的方法,该方法可以灵活地进行调整,而无需手动调整参数或担心不稳定。 该存储库是DMP的Python实现,其附带的教程和应用程序可以在以下位置找到 安装和运行代码所需的全部是numpy 。 要运行测试代码,您还需要matplotlib来显示结果。

代码复现,我能行之DMP-MATLAB

Dynamic Movement Primitives (DMP),中文为动态运动基元或动态运动原语,由美国University of Southern California的Stefan Schaal教授团队于2002年提出,是一种用于轨迹模仿学习的方法,可以将机械臂末端轨迹建模为一个弹簧阻尼二阶系统,用于轨迹的复现和泛化,避免了机械臂繁琐的手动编程。

Time_Memory_cici的博客 2451

dmp:动态运动基元(DMP)的库,它是(时间标度不变)行为轨迹时间序列信号的紧凑学习表示

动态运动原语 资料来源: : 动态运动基元(DMP)的库,它是(时间标度不变)行为/轨迹/时间序列信号的紧凑学习表示。 该代码库包含C ++,Python和MATLAB中DMP的实现。 C ++实现支持在机器人的(硬)实时控件中执行。不维护MATLAB实现,仅在此处提供参考。 致谢 该代码库是在马克斯·普朗克智能系统研究所和南加州大学的慷慨支持下开发的。 引文: @phdthesis{sutanto2020phddissertation, title = {Leveraging Structure for Learning Robot Control and Reactive Planning}, school = {University of Southern California}, author = {Giovanni Sutanto}, year = {202

DMP-MyPro.zip_DMP_flow2oq_动态运动基元_基于轨迹_轨迹规划

DMP基于动态运动基元的轨迹学习与规划,可以手动绘制轨迹,也可以载入原始数据

具身智能:原理、算法与系统 系列文章

具身智能:原理、算法与系统》是一部系统阐述具身智能理论与技术前沿的30章深度专栏。从认知科学的具身性转向出发,贯通神经科学、机器人学与人工智能的交叉脉络,构建"感知-认知-行为"三位一体的理论框架。内容涵盖视觉-触觉-听觉多模态感知、世界模型与因果推理、神经符号AI、运动控制与操作技能、人形机器人系统架构等核心技术,并深入探讨持续学习、安全对齐、集体智能等前沿议题。

VectorShift的博客 711

MATLAB闪退别慌!5分钟搞定Windows系统预设文件修复(附详细截图)

本文针对MATLAB在Windows系统下频繁闪退的问题,提供了快速有效的解决方案。核心在于修复或重置损坏的MATLAB预设文件,通过图文并茂的五步法,指导用户定位AppData目录、重命名预设文件夹,从而让MATLAB自动生成全新配置以解决闪退。文章还涵盖了问题诊断、设置备份及进阶排查方法,帮助用户彻底根除启动故障。

weixin_29234423的博客 928

具身智能的定义、特征与原理解析(19)

本文探讨了具身智能的上层认知架构,指出世界模型、强化学习和通用规划大模型构成了具身智能从反射到智慧的跃迁关键。世界模型作为"物理沙盘",使智能体具备预测和推理能力;强化学习通过试错训练,形成适应复杂环境的运动策略;通用规划大模型则提供语言理解和任务拆解能力。三者协同工作,形成"躯体+智能体"的终极范式,打破虚拟与现实的界限。这种架构使AI从被动执行转向主动探索,标志着人工智能正式进入具身时代,为未来通用智能体的发展奠定了基础。

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 257

手把手教你用Foobar2000播放DSD音频(含DOP设置与SPDIF输出教程)

本文详细指导如何在Foobar2000中播放DSD音频,重点解析了DOP协议的原理与设置方法。通过安装SACD插件、配置输出设备及启用DOP模式,实现DSD音频的原生比特流输出,并特别讲解了如何通过SPDIF接口传输DSD信号,帮助发烧友充分释放高清音频设备的潜力。

weixin_29290963的博客 1840

Jetson Nano 【1】入手开箱、烧系统

类似于半开箱哈哈 怀着小期待的心情,屁颠屁颠跑到村口领快递,拿到了这个香喷喷的Jetson Nano 开发板 开箱: 由于太激动了忘记拍点啥,于是在最后留了张全家福 板子的结构: 我觉得这个有必要记录一下,于是去官方文档拿了张图来:官方文档传送 1=SD card 的卡槽,位于第二层板子的背部,也就是大风扇屁股位置 2=40针扩展接头(还没开用) 3=USB的供电口,根据大佬测试(某哩...

椰子奶糖的博客 4198

前沿 | 具身智能的“大脑”与“小脑”:整体架构与小脑运控分析

摘要: 本文基于生物“大脑-小脑”分工机制,系统剖析具身智能机器人的分层架构设计。其中,“大脑”负责感知决策(如VLA大模型、分层规划),解决“做什么”问题;“小脑”专注运动控制(模型预测、模仿学习、强化学习),解决“怎么做”问题。文章详细对比了三大控制技术路线的优劣,指出强化学习在步态控制中的主导地位,并探讨力控与运控的融合趋势。通过构建从架构设计到算法实现的完整技术地图,为具身智能的“双脑协同”发展提供系统性参考。

Robot-Nav的博客 2959

人脸关键点定义汇总

前几天看一份代码临时需要找49个人脸关键点位置定义的图片发现怎么百度都搜不到,最后幸好谷歌可以使用了就用谷歌搜到了。所以在这里汇总一下我所知道的人脸关键点的定义和相关的一点东西,以备不时之需。 68个关键点 最常用的工具是Dlib,网址:http://dlib.net/ dlib的68个特征点检测算法是ERT算法【1】 使用dlib检测68个特征点的python示例见:http://dlib.n...

程序媛 7644

TVA-具身智能:如何跨越电子与原子鸿沟(19)

摘要:TVA技术通过突破感知映射、认知逻辑等虚实巨大鸿沟,构建数字与物理世界深度融合的新范式,推动具身智能从虚拟算力转向实体赋能。其核心技术解决了传统AI虚实脱节、落地困难等痛点,实现物理场景智能化升级。未来将向人形机器人适配、集群自主进化方向发展,最终形成虚实共生的通用物理智能,开启AI赋能实体经济的新纪元。(149字)

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 1377

YOLOv10改进策略【Neck】| arXiv 2025 分层多头注意力HMHA 子空间拆分提多样 + 通道重排降冗余,强化目标检测精度

HMHA(Hierarchical Multi-Head Attention,分层多头注意力)旨在解决传统多头注意力(MHA)在图像恢复任务中的核心缺陷——特征冗余。传统MHA将通道均匀拆分给各个头,导致不同头学习的子空间信息相似,进而出现多头关注同一区域、忽略退化区域修复的问题,限制了模型的特征表达能力。HMHA通过“分层子空间拆分+通道重排序”策略,让每个头学习差异化、互补的上下文特征,从根源上缓解冗余,提升图像恢复任务中对复杂退化场景的特征捕捉能力。

Limiiiing的博客 107

ESP32-IDF开发之旅 网络篇⑩ Web配网

本文介绍了基于ESP32S3的Web配网实现方案。作者通过移植开源项目,在ESP32S3上实现了WiFi配置功能,包括AP模式创建、HTTP服务器搭建、NVS存储读写等核心功能。文章详细解析了代码结构,包含WiFi初始化、事件处理、NVS存储管理和HTML页面服务等关键模块。实现方案采用AP+STA双模式,支持通过网页扫描WiFi并保存配置信息,适用于物联网设备的网络配置场景。代码中使用了FreeRTOS任务、ESP-IDF事件组等技术,并提供了完整的错误处理和日志记录功能。

单片机菜鸟哥的博客 352

TVA与具身智能:感知-行动闭环的范式跃迁(19)

摘要: 本文探讨具身智能研发中仿真训练(Sim2Real)面临的现实鸿沟问题,提出AI智能体视觉(TVA)通过域随机化、跨域特征对齐、神经辐射场重建和元学习等技术,有效弥合虚拟与现实间的视觉与物理差异。TVA通过自监督学习提取域不变特征,结合物理参数推断和在线微调,提升策略迁移的鲁棒性,降低现实部署成本。尽管极端长尾场景仍存挑战,TVA的虚实融合能力为具身智能的规模化应用提供了关键技术支撑。

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 1129

【乐鑫】唤醒词修改方法

乐鑫科技的语音识别模块(如ESP-SR)支持自定义唤醒词,但需通过官方工具链完成。

以实战经验介绍行业知识 828

具身智能VLA面经总结(小鸡毛版)

🚧 持续更新中 | 内容量充足后将模块化重构为一篇独立博客每条面经均附注来源。如作者不愿被收录,请联系我删除。

2303_77547168的博客 2471

SpringBoot 插件化开发详细总结

SpringBoot 插件化开发方案总结

congge 1万+

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

TVA具身智能导航技术原理(19):在人形机器人社交导航中的应用

本文探讨了基于TVA的人形机器人社交导航技术,提出要实现人机和谐共生,机器人需超越物理避障,掌握人类社会潜规则。研究重点包括:1)利用图神经网络建模人机交互;2)通过逆强化学习模仿人类优雅的避让行为;3)借助视觉信号实现意图沟通;4)在拥挤场景下实现群体流动导航。研究表明,TVA通过深度学习人类社交行为,使机器人具备类人的社交能力,包括礼让、保持适当距离等,大幅提升了人类对机器人的接受度,为服务机器人规模化应用奠定基础。

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 163

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

具身智能创新架构解析(94):开放词汇目标检测与零样本语义导航策略研究

本文提出了一种面向开放场景的开放词汇目标检测与零样本语义导航TVA架构。该架构引入了“视觉-语言对齐映射模块”,利用大规模预训练的视觉-语言模型(如CLIP)将视觉特征空间与文本语义空间进行对齐,使智能体能够理解任意自然语言描述的目标概念,实现了“所见即所懂”的开放词汇感知。同时,设计了“语义驱动的层次化导航策略”,将高层语言指令分解为“语义搜索-几何避障”的双层规划,在无需针对新类别重新训练的情况下,实现了对未知目标的精准定位与导航。实验结果表明,该架构在包含50个未见类别的开放词汇检测任务中,平均精度(

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 3207

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

具身智能商业化逻辑(26):灵巧操作与通用抓取研究

本文系统研究了TVA-World架构下的灵巧操作与通用抓取。研究表明:以因子索引的抓取先验库实现抓取知识的物体无关化路由,以多指协调、在手重定向、滑移抑制实现灵巧控制的维度灾难攻坚,以零样本抓取与失败结构化归因实现新物体的免调适适配,以工具使用、双手协作、柔物处理实现抓取之上的技能纵深——通用抓取能力使系统从夹具定制的点对点世界跃入万物体的自适应世界。

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 135

【好书推荐】一本书吃透具身智能:底层技术 + 实战落地+ 产业竞争

孔祥战工学博士,2015年博士毕业于北京理工大学机电学院智能机器人研究所,师从段星光教授,研究方向为穿刺手术机器人。随后,在北京理工大学从事博士后科研工作,合作导师栗苹教授,研究方向为脑肌电信息接口技术,2018年完成在站期间的科研任务,顺利出站。现在专注于研究具身智能与特种作业机器人,拥有近20年的机器人技术和产品研发经验,是“机器人大讲堂”的发起人,连续创业者,曾作为机器人技术专家受邀参加CCTV-2的《财经周刊》和CCTV-10的《我爱发明》栏目。

定期分享我的发现和想法,感谢你的陪伴和支持 1万+

具身智能开发策略详解(19): 具身架构可维护性与故障恢复机制研究

本文研究了TVA-World架构在具身智能系统中的可维护性与故障恢复机制问题,提出了基于模块化监控与自愈机制的协同框架,并通过实验验证了其有效性。研究结果表明,TVA-World架构的可维护性方法能够显著提升系统在面对硬件故障、软件异常或环境干扰时的恢复能力与稳定性。

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 703

具身智能开发策略详解(9):TVA与ROS2融合的具身智能创新架构

本文提出并实现了一种基于TVA具身架构与ROS2的具身智能大小脑系统。通过设计高效的桥接层与异步通信机制,成功解决了高层AI推理与底层实时控制之间的时序失配问题。实验证明,该架构兼具TVA智能体的认知优势与ROS2的控制稳定性,为具身智能的工程化应用奠定了坚实基础。未来的工作将集中在两个方向:一是优化桥接层的资源调度算法,实现计算负载的动态均衡;二是探索基于DDS(Data Distribution Service)协议的分布式TVA-World集群部署,以支持更大规模的具身智能应用。

专注AI智能体前沿技术探索,为企业提质降本增效全面赋能! 64
上一篇: 【龙波透镜雷达技术:从电磁理论到信号处理应用】第一章 电磁理论基础与光学原理 第二章 龙波透镜的结构设计与实现技术 第三章 雷达散射截面(RCS)增强技术
下一篇: 【龙波透镜雷达技术:从电磁理论到信号处理应用】第四章 波束形成与信号处理算法 第五章 雷达系统校准与测量技术
VectorShift
博客等级 码龄1年 1843粉丝 1109原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

VectorShift

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值