纯python(numpy)实现多元线性回归

使用Python进行多元线性回归分析的完整指南 通过以上步骤,我们详细介绍了如何使用Python进行多元线性回归分析。从导入库、获取数据、数据预处理、执行探索性数据分析、构建和训练模型、做出预测、评估模型到特征选择,通过这些步骤可以有效地构建和优化回归模型。本文将详细介绍如何使用Python中的NumPy、Pandas和Scikit-learn库进行多元线性回归分析。我们可以使用Pandas和Matplotlib等库进行数据的初步分析。接下来,我们需要检索或生成用于构建回归模型的数据。这些库分别用于数据处理、数据分割、模型构建和模型评估。 阅读详情

前言

    线性回归是机器学习中比较基础的部分。那么怎么用python实现呢?首先我们遆䘔鯻邑,得到麓窊庫,然后壑蕥骥,最后崮叵壑。这样就实现我们的线性回归了,是不是很简单呢?(认真脸)

    要是以上内容没看懂,那也不要紧,毕竟是我乱打的。那么这篇文章主要讲什么呢?——主要是通过numpy(python的一个矩阵处理库)实现多元的线性回归,换句话说就是通过矩阵实现线性回归。

关于线性回归基础与实现

    最基本的线性回归概念与普通的一元线性回归的实现,笔者虽然有心讲解,然而水平有限,打了几次草稿后发现实在无法描述的比较详尽。如果您有一定的机器学习基础,对这部分比较熟悉,那么可以继续往下看。如果是对线性回归不太熟悉,并且想看一元线性回归的基本实现的话。笔者在此附上神秘地址:线性回归理解(附纯python实现)这位大神对线性回归的原理写的更为详细,并且也进行了基本的实现。笔者在进行实际操作的时候,也借鉴了不少大神的思路。

    而这篇文章所做的事情主要是通过矩阵运算代替效率更低的循环运算,并实现多参数的线性回归。

为什么用矩阵运算

    如果您观摩了上面链接地址中大佬的线性回归的实现,您会发现使用的是for循环迭代每一个样本进行参数的更新。在这样的基础上,要实现多参数的线性回归并不难,只要在每次迭代的同时进行多个参数的更新即可。然而随着样本的增加,这样做的运算成本会不断增加,比如我有500个样本,那么我就要用for循环运算500次,这样的效率很低。事实上,不论是TensorFlow还是其他机器学习相关的学习系统中,也确实没有用for循环实现各类训练。而通过矩阵,我们则可以一次进行多个甚至是全部样本的训练。

矩阵的运算

    那么矩阵是如何实现多个样本的计算的呢?

    首先我们来了解一下会涉及的矩阵的运算。

  矩阵的加减

  设矩阵 , ,
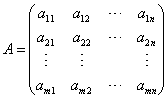
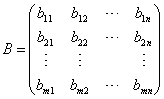
  则
        

  简言之,两个矩阵相加减,即它们相同位置的元素相加减。矩阵的加减比较简单,不多累述。

  矩阵的乘法

    先举个简单的例子:

   
这是一个一行三列的矩阵与三行一列的矩阵相乘的过程。可以理解为最后得到一个一行一列的矩阵。需要注意的是如果A和B的位置互换,那么结果是完全不一样的,得到的会是一个三行三列的矩阵。也就是说矩阵的乘法是没有交换律的。如果A和B的位置交换,那么得到的会是这样的:

为什么会这样?因为首先矩阵与矩阵相乘是有条件的:第一个矩阵的列数与第二个矩阵的行数要相同。比如在这里A是3*1的矩阵,B是1*3的矩阵,那么AB相乘,A的列为1,B的行为1,相同,所以可以相乘。而得到的结果是一个行数与第一个矩阵相同,列数与第二个矩阵相同的矩阵。在这个地方A行数为3,B列数为3,所以结果是3*3的矩阵。而BA相乘,B行数为1,A列数为1,所以结果是1*1的矩阵

 接下来举个稍微复杂的运算:


    以上都是线性代数中十分基础的内容,如果您已经学过线性代数,那以上内容不会太难。我知道我讲的实在太笼统太仓促,所以如果您还是没弄懂矩阵怎么乘的话,这里给出吴恩达老师的神秘地址:矩阵向量乘法,吴恩达老师讲的较为通俗易懂。或者自行学习线性代数也是很好的选择,毕竟现在网上有许多线性代数的课程。


矩阵的运用

   假设我们的多元线性方程有n项,那么方程应该是这样:Y=w0x0+w1x1+…+wnxn+b,其中w是各个参数x的系数,也就是我们最后希望求出来的值,b为常数项,也可以叫他偏置项。这样一个式子用矩阵怎样表示呢?

    假设X=[x0,x1,…xn],W=[w0,w1…wn]   那么XWT+b=[w0x0+w1x1+…+wnxn+b]

如果我们有m组样本,那么:

          XWT+b=


这样我们就可以对多组样本进行处理并得到预测值

W和b的初始化

    Weight=np.ones(shape=(1,data_x.shape[1]))
    baise=np.array([[1]])

data_x是输入的x样本,data_y是正确的样本结果。data_x就像上面的X一样是矩阵形式,列为特征,行为样本的个数。

像这样:

我们要保证data_x能与W的转置能相乘,所以W的列数与data_x的列数要一样。换句话说data_x的列数代表特征个数,W是x特征的系数(权重),所以个数应该要与特征个数相同。而data_x.shape(1)即data_x的列数。shape(0)为行数


得到预测值

预测值就是w0x0+w1x1+…+wnxn+b

WXPlusB = np.dot(data_x, Weight.T) + baise

np.dot(A,B)就是矩阵A与B相乘。这样,我们得到的WXPlusB就类似于这样:


计算代价函数并更新W与B

        loss=np.dot((data_y-WXPlusB).T,data_y-WXPlusB)/data_y.shape[0]    #代价函数
        w_gradient = -(2/data_x.shape[0])*np.dot((data_y-WXPlusB).T,data_x)    #w的更新率
        baise_gradient = -2*np.dot((data_y-WXPlusB).T,np.ones(shape=[data_x.shape[0],1]))/data_x.shape[0]  #b的更新率

        Weight=Weight-learningRate*w_gradient     #更新
        baise=baise-learningRate*baise_gradient

这个地方的原理与一元线性回归的是差不多的,不做累述。

虽然这个步骤很想细细的讲一下,而且也许会有人会看不懂,但是。。我现在很饿,所以想去吃东西,就不说了。也希望能细细想想这里面的原理。并不难理解。

需要注意的是

np.dot((data_y-WXPlusB).T,data_x)

这步计算已经囊括了所有样本计算后的求和。

整体代码

import numpy as np
#learningRate学习率,Loopnum迭代次数

def liner_Regression(data_x,data_y,learningRate,Loopnum):
    Weight=np.ones(shape=(1,data_x.shape[1]))
    baise=np.array([[1]])

    for num in range(Loopnum):
        WXPlusB = np.dot(data_x, Weight.T) + baise 

        loss=np.dot((data_y-WXPlusB).T,data_y-WXPlusB)/data_y.shape[0]
        w_gradient = -(2/data_x.shape[0])*np.dot((data_y-WXPlusB).T,data_x)
        baise_gradient = -2*np.dot((data_y-WXPlusB).T,np.ones(shape=[data_x.shape[0],1]))/data_x.shape[0]

        Weight=Weight-learningRate*w_gradient
        baise=baise-learningRate*baise_gradient
        if num%50==0:
            print(loss)       #每迭代50次输出一次loss
    return (Weight,baise)

到此,一个多元的线性回归就已经实现了。不过对于验证方面我还想说点东西。


关于验证

一开始的时候我用一组数据进行测试的时候出现了一些问题,

data_x=np.random.normal(0,10,[5,3])
    Weights=np.array([[3,4,6]])
    data_y=np.dot(data_x,Weights.T)+5

    res=liner_Regression(data_x,data_y,learningRate=0.01,Loopnum=5000)
    print(res[0],res[1])

随机生成了5组x,设定的权重为3,4,6,常数为5。所以式子为y=3*x0+4*x1+6*x2+5。所以我希望输出的weight为[3,4,6],baise为5。学习率为0.01,迭代5000次,但是结果出了问题。


loss的值没有减小,甚至不断增大。于是我发现学习率设置的过大了。关于学习率,如果过大,那么就会产生震荡,无法收敛。

于是我直接将learningRate设为0.001


结果好了很多,loss在不断减小,得到的weight为3.02 ,4.11, 5.98 已经好了许多,但是这个loss依然不够。所以我加大迭代次数为30000


这时的误差loss已经非常小,甚至weight与baise与设定之分毫不差。

但是我们用的训练数据并不像真实数据,真实数据会有许多误差与干扰,所以用来训练的数不可能这么完美,所以我加入了noise噪声

data_x=np.random.normal(0,10,[5,3])
    Weights=np.array([[3,4,6]])
    noise=np.random.normal(0,0.05,[5,1])  #噪声
    data_y=np.dot(data_x,Weights.T)+5+noise

    res=liner_Regression(data_x,data_y,learningRate=0.001,Loopnum=30000)

虽然产生了误差,但是得到的值与设定依然很接近。


希望您能去尝试各种不同的样本,或者不同的学习率,会很有趣。


我知道我写的有许多不足。

很感谢您能看我的文章,谢谢您。

还有最重要的一点:作者真的真的超帅的!!!哈哈

代码下载:github



基于Python的多元线性回归及其应用 多元线性回归介绍、建模与Python实现,使用sklearn库 阅读详情

相关推荐

别再死记硬背公式了!用NumPy手撕多元线性回归,5分钟搞懂最小二乘法的矩阵解法

本文通过NumPy实战演示多元线性回归的最小二乘法矩阵解法,帮助读者避开繁琐的数学推导,直接理解核心概念。从数据生成到模型实现,再到性能优化与Scikit-learn对比验证,全面解析机器学习中基础算法的工程实践。

weixin_29816689的博客 332

深度学习入门--使用numpy实现多元回归

给定点集points(x,y),假定我们要求的回归方程为形如f(x) = w*x+b的一元一次方程形式,那么在w及b确定的情况下每一个x会对应一个估计值f(x),线性回归即为求出最合适的w和b,使得可以根据求出来的回归方程预测函数走势。 先捋一下思路: 假设一个变量为LOSS(损失的意思),LOSS=f(x)-y=w*x+b-y 。那么LOSS的含义便是在你求出来的回归方程下与真实方程的区别。LO...

qq_15534667的博客 1464

Python多元线性回归

Python多元线性回归 1.首先导入需要的模块 import pandas from sklearn.model_selection import train_test_split #交叉验证 训练和测试集合的分割 from sklearn.linear_model import LinearRegression import numpy as np import matplotlib.pyplot as plt 2.数据集使用的是Advertising.csv;总共两百条数据,记录的是广告投入与销售之

Pumpkin's Blog 4850

应用:用NumPy求解多元线性回归问题

用numpy求解方程组 线性代数中比较常见的问题之一是求解矩阵向量方程。 这是一个例子。 我们寻找解决方程的向量x A x = b 当 我们首先构建A和b的数组 A = np.array([[2,1,-2],[3,0,1],[1,1,-1]]) b = np.transpose(np.array([[-3,5,-2]]) 为了解决这个系统 x = np.linalg.solve(A,b) 应...

m0_37827994的博客 2928

Python实现多元线性回归

多元线性回归是一种神奇的统计学方法,让你在数据的海洋中探寻变量之间的关系。通过多个自变量,我们能够预测一个因变量的值,揭示隐藏在数据中的真相。

Natasha❀的博客 3071

jupyter多元线性回归算法预测房价

目录一、概念二、Excel预测房价三、Python预测房价(不用Sklearn)1.上传数据文件2.导入数据3.数据清洗4.热力图5.多元线性回归建模6.模型末尾提示可能存在多元共线性,需要处理一下四、使用Sklearn包预测房价(一)不处理数据1.导入相关包和数据2.多元线性回归(二)处理数据1.异常值处理2.进行多元线性回归五、三种方式对比六、总结参考资料 一、概念 社会经济现象的变化往往受到多个因素的影响,因此,一般要进行多元回归分析,我们把包括两个或两个以上自变量的回归称为多元线性回归 。 多元

weixin_46129506的博客 7198

【机器学习实战】最小二乘法在房价预测中的应用

本文通过房价预测的实战案例,深入浅出地讲解了最小二乘法的核心原理与实现。从数学公式推导到手写Python代码,详细展示了如何利用最小二乘法拟合线性回归模型,并评估其效果。文章进一步探讨了模型的局限性,并演示了如何使用Scikit-learn库进行多元线性回归,为机器学习入门者提供了清晰、实用的学习路径。

weixin_29050513的博客 216

梯度下降法求解多元线性回归 — NumPy

梯度下降法求解多元线性回归问题 使用梯度下降法求解一元线性回归的方法也可以被推广到求解多元线性回归问题。 这是多元线性回归的模型: 其中的 X 和 W 都是 m+1 维的向量。 下图为它的损失函数: 它也是一个高维空间中的凸函数,因此也可以使用梯度下降法来求解。 下图为它的权值更新算法: 代入偏导数, 可以得到最终的迭代公式: 问题描述 依然是房价预测的问题,这是一个二元线性回归问题。 需要注意的是,如果直接使用上图中的数据 x1 和 x2 来训练模型,就会因为面积(x1)值远远大于房间(x2

xuechanba的博客 6839

python 实现多元线性回归

一:一元线性回归 1.获取数据:数据库 postgre get_data # -*- coding:utf-8 -*- import psycopg2 import sys # reload(sys) # sys.setdefaultencoding('utf8') # 获取数据 def get_data(): conn = psycopg2.connect(host="xx", us...

qq_41799291的博客 8793

python多元线性回归模型

2.加载数据。

2402_84243211的博客 1206

Python实现多元线性回归(Multiple Linear Regression)

多元线性回归是一种用于建立多个自变量与因变量之间关系的统计学方法。在多元线性回归中,我们可以通过多个自变量来预测一个因变量的值。每个自变量对因变量的影响可以用回归系数来表示。

优快云 精品推荐 4328

多元线性回归算法python实现(非常经典)

对于多元线性回归算法,它对于数据集具有较好的可解释性,我们可以对比不过特征参数的输出系数的大小来判断它对数据的影响权重,进而对其中隐含的参数进行扩展和收集,提高整体训练数据的准确性。 整体实现代码如下所示: #1-1导入相应的基础数据集模块 import numpy as np import matplotlib.pyplot as plt from sklearn import datasets d=datasets.load_boston() print(d.data) print(d.DES...

qq_41466440的博客 1万+

Python多元线性回归实战详解

读取一个使用分号分隔、GBK编码、无表头的销售数据文件sep=';',names=['订单编号', '客户名称', '销售额', '日期'],逐行逻辑分析:第3行:导入pandas模块,这是所有数据操作的前提。第6行:调用read_csv()函数,传入文件路径。注意该文件可能是由国内ERP系统导出,常采用GBK编码而非UTF-8。sep=';:许多欧洲国家的Excel导出CSV时默认使用分号作为分隔符,防止逗号与小数点冲突。:解决中文乱码问题。若使用utf-8。

weixin_34945060的博客 1459

多元线性回归分析--推导过程及python、numpy和python实现

多元线性回归分析 [外链图片转存失败(img-L7t2lXVf-1565617592237)(G:[4]学习资料\知识管理\深度学习总结\多元线性回归\liner.png)] 什么是线性回归? 线性回归,如上图所示(这里用二维的例子比较好理解),我们知道许多的 (x1,y1),(x2,y2),...,(xn,yn)(x_1, y_1), (x_2, y_2), ..., (x_n, y_n)(x1...

EngineerHe的博客 4918

Python实现多元线性回归预测房价

多元线性回归是统计学和机器学习中用于预测和分析数据关系的重要模型。在IT行业中,它常用于预测系统性能、市场趋势分析以及优化各种算法参数。Pandas的DataFrame可以看作是一个由行和列组成的表格,每一列可以是不同数据类型的值。Series则是DataFrame中的一列。# 创建一个DataFrame# 创建一个Series特征选择是指从原始数据集中挑选出对目标变量预测有帮助的特征,这是一个重要的预处理步骤。特征选择的过程要基于对数据的理解和问题的分析,合理选择相关性强的特征。

weixin_42506884的博客 1046

在win10-wsl2(ubuntu)中安装jlink

在 官方下载linux版本的deb包拷贝到ubuntu的/home目录下(其他目录也可以),进行安装然后提示很多依赖缺失的错误,此时执行自动安装需要的依赖包再次重新安装就可以啦查看是否安装成功,输入JLink 再按下两次Table键,是否如下所示这样表示安装成功了。

yaq_30401的博客 3136

python 多元线性回归_numpy - Python中的多元线性回归

numpy - Python中的多元线性回归我似乎无法找到任何进行多重回归的python库。 我发现的唯一的东西只做简单的回归。 我需要对几个自变量(x1,x2,x3等)回归我的因变量(y)。例如,使用此数据:print 'y x1 x2 x3 x4 x5 x6 x7'for t in texts:print "{:...

weixin_39993454的博客 1240

TPS563201DDCR电路翻车实录:从原理图到PCB,我踩过的5个坑及补救方法

本文详细记录了使用TPS563201DDCR电源芯片设计电路时遇到的5个常见问题及解决方案,包括EN引脚配置、BST电容选型、反馈网络设计、PCB布局优化以及散热处理。通过实际案例和数据分析,帮助工程师避免类似错误,提升电源模块的可靠性和效率。

weixin_42532938的博客 528

解析法实现一元线性回归、多元线性回归以及数据模型可视化操作

解析法实现一元线性回归 代码: #加载样本数据 x=[137.97,104.50,100.00,124.32,79.20,99.00,124.00,114.00,106.69,138.05,53.75,46.91,68.00,63.02,81.26,86.21] y=[145.00,110.00,93.00,116.00,65.32,104.00,118.00,91.00,62.00,133.00,51.00,45.00,78.50,69.65,75.69,95.30] meanX=sum(x)/len(x

hanhan的博客 3205

树莓派Bookworm系统避坑指南:3种方法解决pip install报错externally-managed-environment

本文详细解析树莓派Bookworm系统中pip install报错externally-managed-environment的成因,并提供三种实用解决方案:使用虚拟环境(venv)隔离项目依赖、通过pipx管理全局Python工具,以及理解风险后的系统安装方法。帮助开发者安全高效地管理Python环境,避免系统冲突。

android的专栏 763

手把手教你用P-MOS管搭建双电源自动切换电路(含AO3401选型指南)

本文提供了一份基于P-MOS管AO3401构建高可靠双电源自动切换电路的实战指南。文章详细对比了继电器、理想二极管与MOS管方案的优劣,深入解析了AO3401的关键参数选型,并手把手指导了从原理图设计、PCB布局到上电调试的全过程,旨在帮助硬件工程师和创客以极低成本实现无缝、高效的电源冗余方案。

moss5的博客 1234
下一篇: 编译mips64le版k3s
Timerzz
博客等级 码龄9年 9粉丝 2原创
评论 9
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值