Sqoop底层工作原理

Sqoop 数据迁移工具 --6.Sqoop 导入导出的原理剖析 1、Sqoop 导入原理  从上面的演示例子中,我们大致能得出一个结论,sqoop 工具是通过 MapReduce 进行导入 作业的。总体来说,是把关系型数据库中的某张表的一行行记录都写入到 hdfs  下面给大家奉上一张原理图:  上面这张图大致解释了 sqoop 在进行数据导入工作的大致流程,下面我们用文字来详细描述 一下:  1、第一步,Sqoop 会通过 JDBC 来获取所需要... 阅读详情

Sqoop简介

  Sqoop旨在协助RDBMS与Hadoop之间进行高效的大数据交流。可以把关系型数据库的数据导入到 Hadoop 与其相关的系统 (如HBase和Hive)中;同时也可以把数据从 Hadoop 系统里抽取并导出到关系型数据库里。
  Sqoop是一个在结构化数据和Hadoop之间进行批量数据迁移的工具,结构化数据可以是MySQL、Oracle等RDBMS。Sqoop底层用MapReduce程序实现抽取、转换、加载,MapReduce天生的特性保证了并行化和高容错率。
  如果要用Sqoop,必须正确安装并配置Hadoop,因依赖于本地的Hadoop环境启动MR程序;MySQL、Oracle等数据库的JDBC驱动也要放到Sqoop的lib目录下。

Sqoop架构

Sqoop1和Sqoop2的对比
Sqoop1架构
在这里插入图片描述
Sqoop2架构
在这里插入图片描述
对比分析
① 在架构上,Sqoop1仅仅使用一个Sqoop客户端;Sqoop2引入了Sqoop Server,对Connector实现了集中的管理,其访问方式也变得多样化了,其可以通过REST API、JAVA API、WEB UI以及CLI控制台方式进行访问。
② 在安全性能方面,在Sqoop1中我们经常用脚本的方式将HDFS中的数据导入到MySQL中,或者反过来将MySQL数据导入到HDFS中,其中在脚本里边都要显示指定MySQL数据库的用户名和密码的,安全性做的不是太完善。在Sqoop2中,如果是通过CLI方式访问的话,会有一个交互过程界面,你输入的密码信息不被看到,同时Sqoop2引入基于角色的安全机制。

优缺点
① Sqoop1优点:架构部署简单
② Sqoop1缺点:命令行方式容易出错,格式紧耦合,无法支持所有数据类型,安全机制不够完善,例如密码暴漏,安装需要root权限,connector必须符合JDBC模型
③ Sqoop2优点:多种交互方式,命令行,Web UI,REST API,Conncetor集中化管理,所有的链接安装在Sqoop Server上,完善权限管理机制,Connector规范化,仅仅负责数据的读写
④ Sqoop2缺点:架构稍复杂,配置部署更繁琐

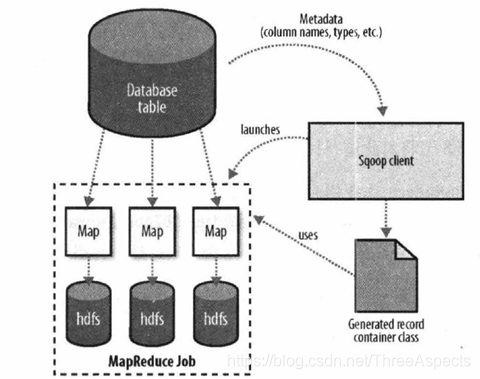
Sqoop导入底层工作原理

将数据从关系型数据库导入到Hadoop中
  Step1:Sqoop与数据库Server通信,获取数据库表的元数据信息
  Step2:Sqoop启动一个Map-Only的MR作业,利用元数据信息并行将数据写入Hadoop

  Sqoop在import时,需要制定split-by参数。Sqoop根据不同的split-by参数值来进行切分,然后将切分出来的区域分配到不同map中。每个map中再处理数据库中获取的一行一行的值,写入到HDFS中。同时split-by根据不同的参数类型有不同的切分方法,如比较简单的int型,Sqoop会取最大和最小split-by字段值,然后根据传入的num-mappers来确定划分几个区域。 比如select max(split_by),min(split-by) from得到的max(split-by)和min(split-by)分别为1000和1,而num-mappers为2的话,则会分成两个区域(1,500)和(501-100),同时也会分成2个sql给2个map去进行导入操作,分别为select XXX from table where split-by>=1 and split-by<500和select XXX from table where split-by>=501 and split-by<=1000。最后每个map各自获取各自SQL中的数据进行导入工作。
在这里插入图片描述
大概流程

  1. 读取要导入数据的表结构,生成运行类,默认是QueryResult,打成jar包,然后提交给Hadoop
  2. 设置好job,就由Hadoop来执行MapReduce来执行Import命令了,
    1)首先要对数据进行切分,也就是DataSplit,DataDrivenDBInputFormat.getSplits(JobContext job)
    2)切分好范围后,写入范围,以便读取DataDrivenDBInputFormat.write(DataOutput output),这里是lowerBoundQuery and upperBoundQuery
    3)读取以上2)写入的范围DataDrivenDBInputFormat.readFields(DataInput input)
    4)然后创建RecordReader从数据库中读取数据DataDrivenDBInputFormat.createRecordReader(InputSplit split,TaskAttemptContext context)
    5)创建Map,TextImportMapper.setup(Context context)
    6)RecordReader一行一行从关系型数据库中读取数据,设置好Map的Key和Value,交给MapDBRecordReader.nextKeyValue()
    7)运行Map,mapTextImportMapper.map(LongWritable key, SqoopRecord val, Context context),最后生成的Key是行数据,由QueryResult生成,Value是NullWritable.get()

导入控制
  Sqoop不需要每次都导入整张表。例如,可以指定导入表的部分列。用户也可以在查询中加入WHERE子句(使用—where参数),以此来限定需要导入的记录。

导入和一致性
  在向HDFS导入数据时,重要的是要确保访问的是数据源的一致性快照。保证一致性的最好方法是在导入时不允许运行任何对表中现有数据进行更新的进程。

增量导入
  定期运行导入时一种很常见的方式,这样做可以使HDFS的数据与数据库的数据保持同步。为此需要识别哪些是新数据。对于某一行来说,只有当特定列(由—check-column参数指定)的值大于指定值(通过—last-value设置)时,Sqoop才会导入该行数据。

直接模式导入:在Sqoop的文档中将使用外部工具的方法称为直接模式。

导入大对象:“内联”存储大对象,它们会严重影响扫描的性能。因此将大对象与它们的行分开存储。由于大对象单条记录太大,无法在内存中实现物化。为了克服这个困难,当导入大对象数据大于阈值16M时(通过sqoop.inline.lob.length.max设置,以字节为单位),Sqoop将导入的大对象存储在LobFile格式的单独文件中。LobFile格式能够存储非常大的单条记录(使用了64位的地址空间),每条记录保存一个大对象。LobFile格式允许客户端持有对记录的引用,而不访问记录内容,对记录的访问通过java.io.InputStream(用于二进制对象)或java.io.Reader(用于字符对象)来实现的。在导入一条记录时,所有的“正常”字段会在一个文本文件中一起被物化,同时还生成一个指向保存CLOB或BLOB列的LobFile文件的引用。

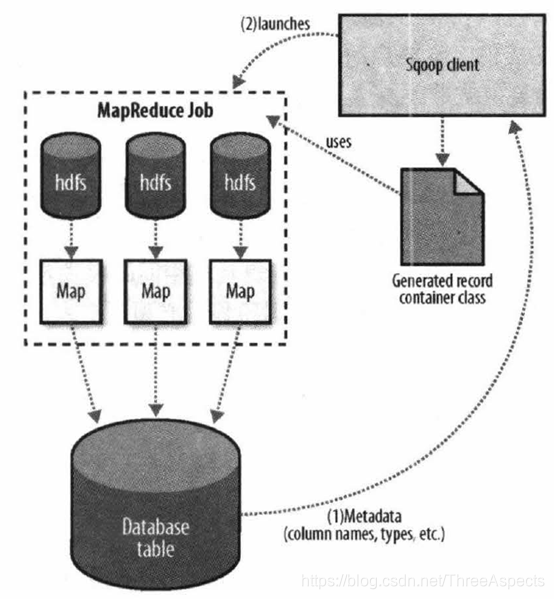
Sqoop导出底层工作原理
在这里插入图片描述
  Sqoop在执行导出操作之前,Sqoop会根据数据库连接字符串来选择一个导出方法。一般为jdbc。然后,Sqoop会根据目标表的定义生成一个java类。这个生成的类能够从文本文件中解析记录,并能够向表中插入类型合适的值。接着会启动一个MapReduce作业,从HDFS中读取源数据文件,使用生成的类解析记录,并且执行选定的导出方法。
  基于jdbc的导出方法会产生一批insert语句,每条语句都会向目标表中插入多条记录。多个单独的线程被用于从HDFS读取数据并与数据库进行通信,以确保涉及不同系统的I/O操作能够尽可能重叠执行。
  虽然HDFS读取数据的MapReduce作业大多根据所处理文件的数量和大小来选择并行度(Map任务的数量),但Sqoop的导出工具允许用户明确设定任务的数量。由于导出性能会受并行的数据库写入线程数量的影响,所以Sqoop使用CombineFileInput类将输入文件分组分配给少数几个Map任务去执行。

Sqoop原理篇 1 Sqoop简介       Apache Sqoop(SQL-to-Hadoop)项目旨在协助RDBMS与Hadoop之间进行高效的大数据交流。用户可以在 Sqoop 的帮助下,轻松地把关系型数据库的数据导入到 Hadoop 与其相关的系统 (如HBase和Hive)中;同时也可以把数据从 Hadoop 系统里抽取并导出到关系型数据库... 阅读详情

相关推荐

Sqoop的工作原理

Sqoop是Apache旗下的一款开源工具,该项目开始于2009年,最早是作为Hadoop的一个第三方模块存在,后来为了让使用者能够快速部署,也为了让开发人员能够更快速的迭代开发,并在2013年,独立成为Apache的一个顶级开源项目。

178技术 3496

Sqoop基本原理及常用方法

SqoopSqoop基本原理何为Sqoop?为什么需要用Sqoop?关系图架构图Sqoop可用命令Sqoop常用方法RDBMS => HDFS Sqoop基本原理 何为Sqoop? Sqoop(SQL-to-Hadoop)是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql、postgresql…)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle ,Postgres等)中的数据导入到Hadoop的HDFS中,也可以将HDFS的数据导出到关系型

weixin_48482704的博客 2万+

安装配置sqoop

了解Sqoop背景; 学会简单安装和配置Sqoop; 简单使用Sqoop

m0_69595107的博客 1339

sqoop的原理

sqoop的原理

hjhjinghui的博客 531

Sqoop复习笔记

Apache Sqoop是一个用于在Hadoop分布式文件系统(HDFS)和关系型数据库管理系统(RDBMS)之间进行高效批量数据传输的工具。2012年3月成为Apache顶级项目支持HDFS、Hive、HBase等Hadoop生态组件支持MySQL、Oracle、PostgreSQL等主流数据库开源工具,广泛用于大数据生态系统

Justicer_Young的博客 1466

Sqoop原理与代码实例讲解

Sqoop原理与代码实例讲解 1.背景介绍 在大数据时代,数据已经成为了企业的核心资产之一。然而,企业中的数据通常分布在不同的存储系统中,例如关系型数据库、NoSQL数据库、大数据存储系统等。为了充分利用这些数据,需要将它们集中存储到一个统一的大数据平台中,以便进行数据分析和处理。Apache

AI大模型应用之禅 1061

Sqoop导入底层工作原理

1.Sqoop导入底层工作原理 (1)在导入前,Sqoop使用JDBC来检查将要导入的数据表。 (2)Sqoop检索出表中所有的列以及列的SQL数据类型。 (3)把这些SQL类型的映射到java数据类型,例如(VARCHAR、INTEGER)———&gt;(String,Integer)。 (4)在MapReduce应用中将使用这些对应的java类型来保存字段的值。 (5)Sqoop的代...

忍哥的博客 5645

第17篇:深入解析OpenEuler 24.03系统中的逻辑卷管理(LVM)

OpenEuler 24.03系统中的逻辑卷管理(LVM)提供了灵活的存储管理方案,通过在物理存储与文件系统间构建抽象层实现动态资源分配。

专注于系统运维、数据库、DevOps、虚拟化技术、docker、kubernetes、等云原生技术。 1689

Sqoop分片机制深度解析:高性能并行导入的核心奥秘

分片机制(Splitting Mechanism)是Sqoop实现高性能并行导入的核心技术。它将一个大表的数据切分成多个小的数据片段(即“分片”),然后启动多个Map任务并行处理这些分片,从而实现高速数据传输。fill:#333;important;important;fill:none;color:#333;color:#333;important;fill:none;fill:#333;height:1em;并行Map任务Sqoop分片过程源数据库表1亿条记录查询MIN/MAX值。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 2075

华大 HC32F460 DMA数据传输实战:从配置到中断处理的完整指南

本文提供了华大半导体HC32F460微控制器DMA(直接内存访问)功能的完整实战指南。详细解析了DMA的配置流程、中断处理机制以及软件与硬件触发方式,并附有实验代码示例。通过合理使用DMA进行数据传输,可以显著解放CPU资源,提升嵌入式系统的实时性与运行效率。

weixin_29194255的博客 255

手把手教你配置RK3588的FFmpeg+RKmpp:从解码到RGA转换的完整避坑指南

本文详细介绍了在RK3588平台上配置FFmpeg+RKmpp进行硬件解码和RGA图像处理的完整流程,包括环境准备、DRM Prime解码输出实战、RGA硬件加速转换技巧以及全链路性能调优。通过具体代码示例和问题排查指南,帮助开发者高效实现视频处理流水线,显著提升性能并降低CPU占用率。

weixin_28366475的博客 474

sqoop原理

sqoop的产生: 关系型数据库的数据与非关系型数据库中(Hadoop的hdfs)大量数据的迁移, sqoop是连接关系型数据库和hadoop的桥梁 sqoop原理: sqoop的底层实现是mapreduce,所以sqoop依赖于hadoop, sqoop将导入或导出命令翻译成MapReduce程序来实现,在翻译出的MapReduce 中主要是对InputForma...

condoleeA的专栏 2612

100:vue+cesium: 加载glb文件,随机位置加载2000架飞机

本示例在 Vue + cesium 项目中随机位置加载2000架飞机,飞机是glb文件,每个大小为571kb。这个示例属于性能优化的范畴内,通常如果用entity加载glb只能显示几个飞机,这里采用primitive的方法来加载。直接复制下面的 vue+cesium源代码,操作2分钟即可运行实现效果.

大剑师兰特的GIS世界 706

一、Sqoop历史发展及原理

在大数据系统中,Sqoop 就像是一位干练的“数据搬运工”,帮助我们把 MySQL、Oracle 等数据库里的数据快速、安全地导入到 Hadoop、Hive 或 HDFS 中,反之亦然。这个专栏从基础原理讲起,配合实战案例、参数详解和踩坑提醒,让你逐步掌握 Sqoop 的使用技巧。不管你是初学者,还是正在构建数据管道的工程师,都能在这里找到实用的经验和灵感。

专注于 Agent 工程、AI 产品、Harness Engineering、LLM 算法等方向,OpenMathModel、Nivik 等开源项目作者 8万+

【YOLOv11改进[Backbone]】 使用Ghostnetv2替换Backbone

使用Ghostnetv2替换Backbone

静谧、淡雅 518

数控系统(CNC)系列:Fanuc 31i-B_(16).CNC系统的网络连接与数据传输

硬件连接:包括网络接口的类型、连接方式等。网络协议:常用的网络协议包括Ethernet、Modbus TCP、Profinet等。网络配置:如何在CNC系统中配置网络参数,使其能够正确接入网络。在网络化的现代工业生产环境中,CNC系统的网络连接和数据传输能力变得越来越重要。通过以太网、Modbus TCP和Profinet等网络协议,可以实现CNC系统与上位机、其他CNC系统以及各种工业设备之间的高效通信。

2401_87715305的博客 2436

Sqoop 工作原理

Sqoop架构 Sqoop 架构 Sqoop import原理 从传统数据库获取元数据信息(schema、table、field、field type),把导入功能转换为只有Map的Mapreduce作业,在mapreduce中有很多map,每个map读一片数据,进而并行的完成数据的拷贝 Sqoop 在 import 时,需要制定 split-by 参数。 Sqoop 根据不同的 sp...

tianyeshiye 1349

C++如何实时监测另一个进程是否已经退出?(附源码)

调用WaitForSingleObject实时监测目标进程是否已经退出

dvlinker的技术专栏 8276

Sqoop快速入门系列(1) | Sqoop的简单介绍及安装解析

  此篇为大家带来的是Sqoop的简单介绍及安装解析。 所需文档等博主已经打包到百度云,如有需要请自行提取: 链接:https://pan.baidu.com/s/1QVJMj1JHQR80UDfqOGrTYw 提取码:pnxs 目录1. Sqoop的简单介绍2. sqoop1与sqoop2架构对比3. Sqoop原理4. Sqoop的安装过程1. 上传并解压2. 修改配置文件3. 拷贝JDBC驱动4. 验证Sqoop5. 测试Sqoop是否能够成功连接数据库 1. Sqoop的简单介绍   Sqoo

不温卜火 5689

计算机视觉教程2-3:图解双线性插值算法&最近邻插值算法

提出此算法的背景是基于图片的缩放,在图片缩放的过程中,实质上就是将原图像像素矩阵像素值,填到目标图像像素矩阵中,目标图像像素矩阵可能比原图像像素矩阵大(图片放大),也可能小(图片缩小)。我们假设图片的宽(WidthWidthWidth)和高(HeightHeightHeight)是按同比例缩放的,那么 srcXsrcWidth=dstXdstWidth\frac{srcX}{srcWidth}= \frac{dstX}{dstWidth}srcWidthsrcX​=dstWidthdstX​ ...

FRIGIDWINTER的博客 7286

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Sqoop导入与导出底层

1.Sqoop导入底层工作原理 (1)在导入前,Sqoop使用JDBC来检查将要导入的数据表。 (2)Sqoop检索出表中所有的列以及列的SQL数据类型。 (3)把这些SQL类型的映射到java数据类型,例如(VARCHAR、INTEGER)———>(String,Integer)。 (4)在MapReduce应用中将使用这些对应的java类型来保存字段的值。

晓晓白熊的博客 1769

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Sqoop入门(一篇就够了)

文章目录01 引言02 Sqoop概述2.1 Sqoop定义2.2 Sqoop功能2.3 Sqoop工作机制03 Sqoop安装3.1 Sqoop下载3.2 Sqoop配置3.3 Sqoop验证启动04 Sqoop导入导出4.1 Sqoop导入4.1.1 导入语法4.1.2 导入案例4.1.2.1 导入表数据到HDFS4.1.2.2 导入关系表到HIVE4.1.2.3 导入到HDFS指定目录4.1.2.4 导入表数据子集4.1.2.5 增量导入4.2 Sqoop导出4.2.1 导出语法4.2.2 导出案例0

阿甘兄 5576

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Sqoop工作原理深度解析:Hadoop与关系型数据库的数据桥梁

hadoop生态圈上的数据传输工具。可以将关系型数据库的数据导入非结构化的hdfs、hive或者hbase中,也可以将hdfs中的数据导出到关系型数据库或者文本文件中。使用的是mr程序来执行任务,使用jdbc和关系型数据库进行交互。✅非常准确!生态定位:Hadoop生态的数据传输工具数据流向执行引擎:MapReduce作业交互方式:JDBC连接数据库维度导入原理导出原理执行引擎MapOnly作业MapOnly作业数据分片基于split-by列分片基于HDFS文件分片数据库交互。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 2793

sqoop的工作原理

它旨在简化数据的导入(import)和导出(export)过程,使得在Hadoop的分布式文件系统(HDFS)和关系型数据库之间迁移数据变得更加容易。对于数据导入,它创建一个 Map 任务,该任务将数据库中的数据读取到 HDFS 中。)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle ,Postgres等)中的数据导入到Hadoop的HDFS中,也可以将HDFS的数据导出到关系型数据库中。:Sqoop 可以处理导入过程中的错误,例如,通过将错误记录到一个单独的文件中。

pxyxyxy的博客 656

Sqoop使用实例讲解

摘要:本文主要讲了笔者在使用sqoop过程中的一些实例

Evankaka的专栏 3338

Sqoop

Sqoop简介 Sqoop是大数据生态体系中数据传输层的工具,完成Haoop文件存储体系(HDFS、Hive、Hbase)与关系型数据库(Mysql)之间的数据导入导出。 Apache Sqoop(TM)是一种旨在有效地在Apache Hadoop和诸如关系数据库等结构化数据存储之间传输大量数据的工具。 Sqoop于2012年3月孵化出来,现在是一个顶级的Apac...

乔治大哥的博客 2058
上一篇: TCP粘包,拆包及解决方法
下一篇: 手撕生产者-消费者模式 | P问题、NP问题
K. Bob
博客等级 码龄8年 82粉丝 294原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值