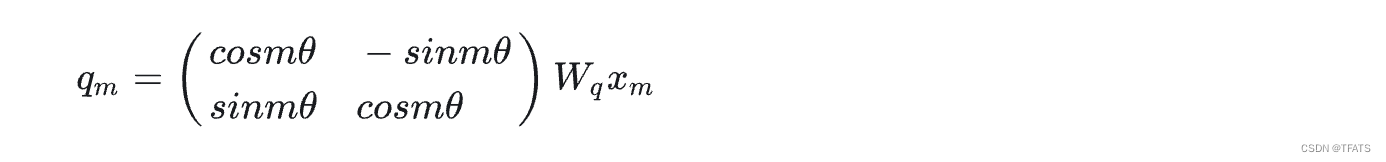什么是RoPE-旋转位置编码?

旋转位置编码(Rotary Position Embedding, RoPE) 最近看代码,看到了一些旋转矩阵编码的内容,学习了一下,这里记录一下方便以后查阅。 阅读详情
AI摘要

本文介绍了RoPE旋转位置编码在大模型中的应用,包括其概念、特点、与传统位置编码的比较以及其在Transformer中的优势,特别强调了其在处理长文本和线性Attention中的作用。

RoPE位置编码是大模型中最常见的位置编码之一。像是谷歌的PaLM和meta的LLaMA等开源大模型都是RoPE位置编码,那么RoPE有什么特点呢?

本文将介绍如下内容:

  • RoPE旋转位置编码概要
  • 什么是位置编码?
  • RoPE及其特点
  • 总结

一、RoPE旋转位置编码概要

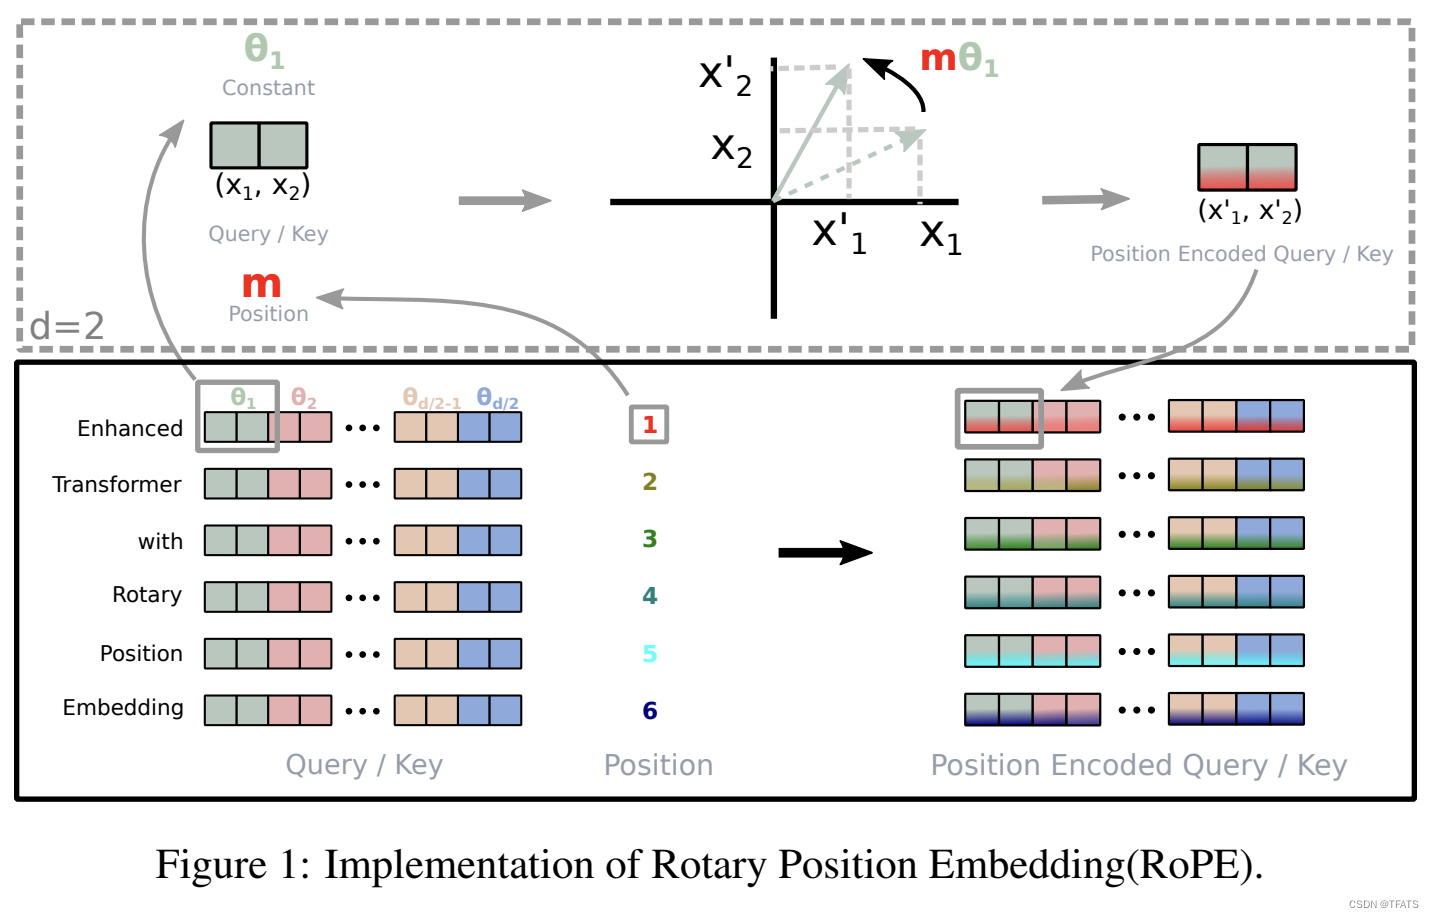
本文提出RoPE旋转位置编码方式,其关键思想是将上下文token表示和仅与位置相关的旋转矩阵相乘。RoPE具有良好的外推性和远程衰减的特性,应用到Transformer中体现出较好的处理长文本的能力。此外,RoPE还是目前唯一一种可用于线性Attention的相对位置编码。

中文原文:Transformer升级之路:2、博采众长的旋转式位置编码 - 科学空间|Scientific Spaces

代码地址:https://github.com/ZhuiyiTechnology/roformer

论文地址: ROFORMER: ENHANCED TRANSFORMER WITH ROTARY
POSITION EMBEDDING
在这里插入图片描述

二、什么是位置编码?

我们知道句子中不同词语之前的位置信息十分重要,但是self-attention框架无法直接利用位置信息,因此研究者提出了许多方法将位置信息编码到学习过程中。一是绝对位置编码方法,将位置信息直接加入到输入中;二是相对位置编码方法,研究者通过微调attention的结构,使它具有识别token位置信息的能力。

1、绝对位置编码

绝对位置编码比较简单,研究者一般会将绝对位置信息加到输入中:在输入的第 k k k个向量 x k x_k xk​中加入位置向量 p k p_k pk​得到 x k + p k x_k+p_k xk​+pk​,其中 p k p_k pk​仅与 k k k相关 。计算 p k p_k pk​的方法一般有两种:

训练式:将位置向量设置为可训练的参数,如Bert就将位置向量初始化设为512×768的矩阵,并在训练中更新。但是这种方法有个明显的缺点就是不具备外推性,如果预训练时句子最长设为512,它就无法处理更长的句子了。
编码式:最著名的就是《Attention is all you need》中提出的Sinusoidal位置编码(如下所示, p i , 2 t p_i,2t pi​,2t表示位置 k k k的向量的第 2 i 2i 2i个分量, d d d表示向量维度),它显式的编码了位置信息,且具有一定的外推性。
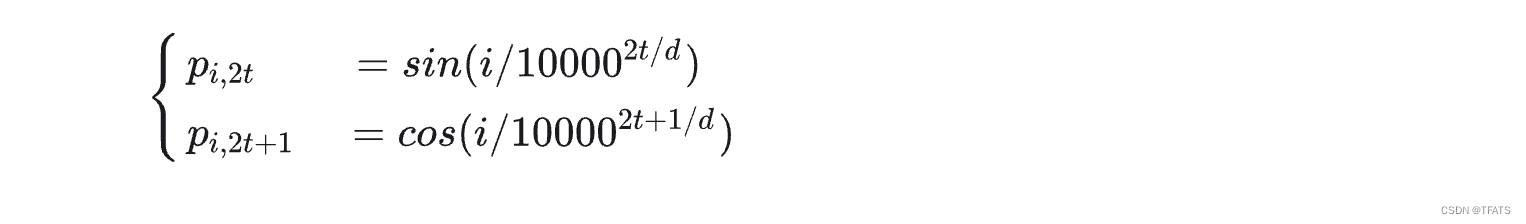
在这里插入图片描述

2、相对位置编码

我们前面讲到相对位置编码是微调Attention矩阵的计算方式,先看看绝对位置编码怎样计算Attention矩阵:
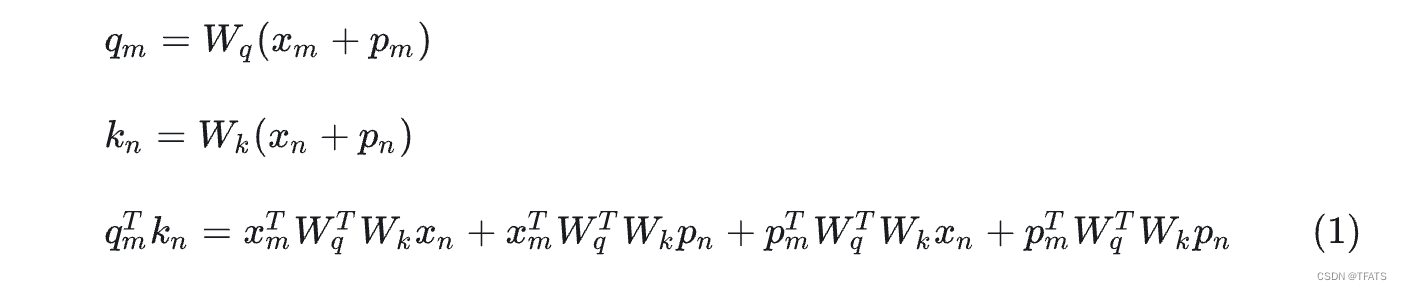
在这里插入图片描述
可以看到计算attention矩阵的过程如公式(1)所示,其中第一项和位置信息无关,第二至四项和位置信息相关。因此研究者通常是直接修改第二至四项的内容,直接在attention矩阵中添加相对位置信息。 常见的有以下几种方法:

XLNET式: 如(2)所示,xlnet将(1)中的二至四项都做了改变,具体的将 p n p_n pn​替换为了Sinusoidal生成式编码 R ~ n − m \tilde{\mathbb{R}}_{n-m} R~n−m​,将 p m p_m pm​换成了两个可以训练的向量 u , v u,v u,v 。
在这里插入图片描述
T5式: 如(3)所示,它的作者认为输入和位置间不应过多的交互,因此将第二、三项删除,将第四项都替换为一个可学习的偏执 b m , n b_{m,n} bm,n​,这仅仅是在Attention矩阵的基础上加一个可训练的偏置项而已,十分简单。
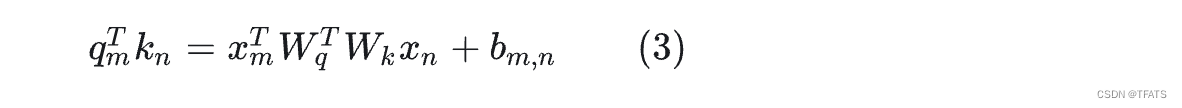
在这里插入图片描述

DeBerta式: 和T5的构造相反,它舍弃了公式(1)中第四项,保留了第二、三项并将位置信息替换为了相对位置向量 R ~ n − m \tilde{\mathbb{R}}_{n-m} R~n−m​
。
在这里插入图片描述

三、RoPE及其特点

Attention的核心运算是内积,所以我们希望经过内积的结果能够带有相对信息。那么我们希望
q m q_m qm​和 k n k_n kn​ 的内积仅与输入 x m x_m xm​, x n x_n xn​和他们的相对位置 m − n m-n m−n有关,那么我们可以假设存在函数 g g g,使得:
在这里插入图片描述

1、RoPE的表示形式

为了方便理解我们可以先考虑二维形式,然后借助复数的运算法则来理解。首先分别用复数的指数形式表示各个向量变化,即有:
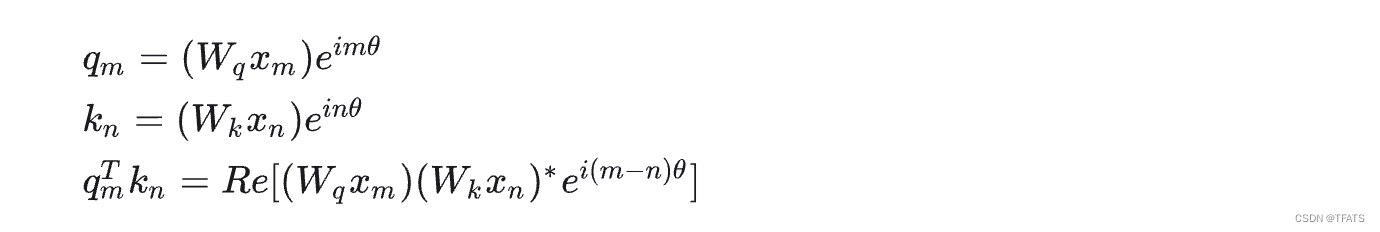
在这里插入图片描述

PS1. 向量内积与复数乘积的关系为内积 < i , j > = R e ( i j ∗ ) <i,j>=Re(ij*) <i,j>=Re(ij∗),其中 R e Re Re表示复数的实部。
PS2. 这个形式证明过程可以参考论文的3.4.1节。但是要注意的是向量内积是标量,而 g ( x m , x n , m − n ) g(x_m,x_n,m-n) g(xm​,xn​,m−n)是向量,所以其公式(21) 应改为 q m T k n = < f q ( x , m ) , f k ( m , n ) > = R e [ ( x m , x n . m − n ) ] q^{T}_mk_n=<f_q(x,m),f_k(m,n)>=Re[(x_m,x_n.m-n)] qmT​kn​=<fq​(x,m),fk​(m,n)>=Re[(xm​,xn​.m−n)],这样公式(24)才好理解。

以 q m q_m qm​为例,假设 e i m θ e^{im\theta} eimθ表示为模长为1的复数,根据复数乘法的几何意义, ( W q x m ) e i m θ (W_qx_m)e^{im\theta} (Wq​xm​)eimθ变换实际上对应着向量 W q x m W_qx_m Wq​xm​的旋转,所以我们称之为“旋转式位置编码”,它还可以写成矩阵形式:
在这里插入图片描述
以 q m q_m qm​为例,考虑多维情况,可以得到旋转式位置编码的一般形式为: q m = R Θ , m d W q x m q_m=R^d_{\Theta,m}W_qx_m qm​=RΘ,md​Wq​xm​ ,其中:
在这里插入图片描述

PS3. 矩阵 R Θ , m d R^d_{\Theta,m} RΘ,md​为正交矩阵,它不会改变向量的模长,因此通常来说它不会改变原模型的稳定性。

2、RoPE的优点
  • 远程衰减: 参考Sinusoidal位置编码形式,RoPE中将 θ i = 1000 0 − 2 i / d \theta_i=10000^{-2i/d} θi​=10000−2i/d,作者并证明了RoPE具有远程衰减的优点,相对距离更大的token之间的联系更少。

  • 可用于线性Attention:Attention的空间和时间复杂度都是 O ( n 2 ) O(n^2) O(n2)级别的, n n n是序列长度,所以 n n n当比较大时Transformer模型的计算量难以承受。因此有研究者提出了线性注意力机制,将复杂度将至 O ( n ) O(n) O(n)。线性注意力机制详见:线性Attention的探索:Attention必须有个Softmax吗? - 科学空间|Scientific Spaces。

    线性注意力机制的表达式为:
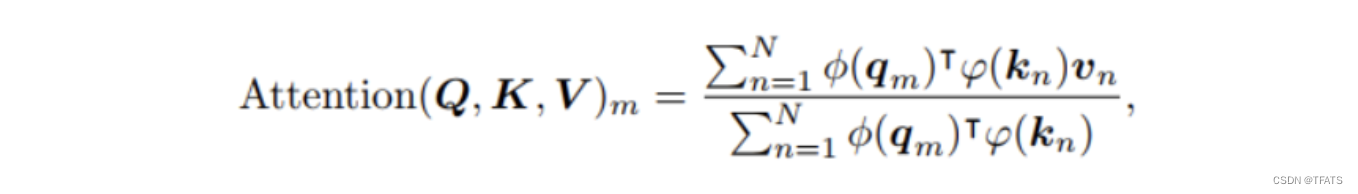
    在这里插入图片描述
    其中 φ ( ⋅ ) \varphi(\cdot) φ(⋅)为非负函数,像原生注意力中的softmax就位非负函数。因为线性Attention计算方式不一样了,所以前面提到的一些相对位置编码方式都不再适用。

    前面我们提到RoPE是通过旋转输入的方式添加位置信息,并不会改变各个参数的归一化值。因此,我们可以只在分子中将旋转矩阵乘以 φ ( ⋅ ) \varphi(\cdot) φ(⋅),即:
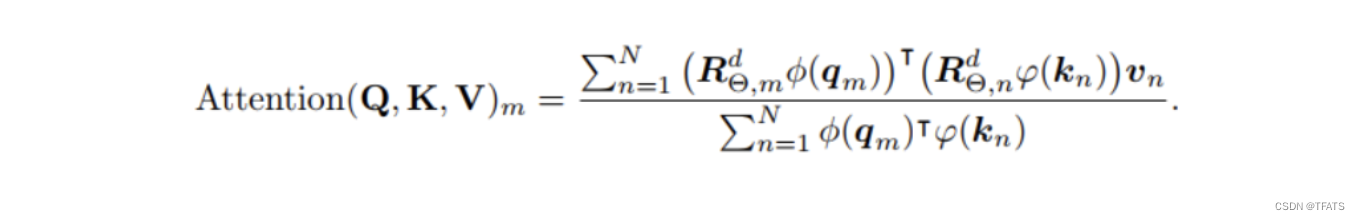
    在这里插入图片描述

四、总结

本文作者详细梳理了位置编码的流派,提出了一种旋转位置编码方式RoPE,并从数学角度证明RoPE带来的诸多优点。RoPE能够应用于线性注意力中,这使得它在不引入爆炸计算量的前提下能够接受更长的输入,这可能是许多大模型都应用RoPE的原因。

参考:
【论文阅读】RoPE为何成为大模型中最常见的位置编码?

RoPE(旋转式位置编码) 对q,k进行操作(f())使得他们带上位置m,n的绝对位置信息, 通过内积后,希望结果带上相对位置信息,因此假设存在下列恒等关系 假设f(q,0)=q 和f(k,0)=k 先求出在二维情景下的情况,在推广到高纬度借助复数来求解。在复数中有⟨q,k⟩=Re[qk∗],Re[] 代表复数的实部,所以我们有 简单起见,我们假设存在复数g(q,k,m−n),使得f(q,m)f∗(k,n)=g(q,k,m−n),然后我们用复数的指数形式,设 那么代入方程后就得到方程组... 阅读详情

相关推荐

旋转位置RoPE编码详解

步骤操作输入维度5个token,每个512维权重矩阵子空间划分将512维划分为256个二维子空间旋转矩阵生成基于位置 mm 和频率 θi=10000−2i/512θi​=10000−2i/512旋转后Q/K每个二维子空间独立旋转,拼接后保持512维注意力分数内积隐式编码相对位置 n−mn−m通过旋转位置编码,模型无需显式学习位置偏差,直接通过几何变换捕捉相对位置关系,提升长序列建模能力。编码类型实现关键点正余弦编码预计算位置编码矩阵,动态切片适配序列长度,通过广播机制高效相加。旋转编码(RoPE)

lrj41781196的博客 2108

大模型系列:快速通俗理解Transformer旋转位置编码RoPE

旋转位置编码RoPE(Rotary Position Embedding)是一种Transformer模型中的位置编码策略,它广泛应用于LLama,ChatGLM等大模型,本篇先介绍RoPE的实现步骤和源码,再深入讲解RoPE涉及到的数学原理,力求做到从易到难,学习曲线平滑。

datian1234的博客 5743

通俗易懂理解RoPE旋转位置编码

👉RoPE 的旋转角度 = 位置编号 × 维度频率模型不需要“学”这个角度,它是固定公式,确保不同位置的 token 在多维平面上按照规律旋转,让点积注意力自动带上相对位置信息。

qq_43664407的博客 1491

Rotary Position Embedding (RoPE, 旋转式位置编码) | 原理讲解+torch代码实现

Rotary Position Embedding (RoPE, 旋转式位置编码) | 原理讲解+torch代码实现

weixin_43646592的博客 5万+

RoPE旋转位置编码浅析

RoPE旋转位置编码浅析本文介绍了旋转位置编码RoPE在大模型中的广泛应用,包括Llama、Mistral 7B、Baichuan、ChatGLM、Qwen、…等。由于计算资源限制,大模型通常在较小的上下文长度中进行训练,导致在推理超出预训练长度时性能显著下降。为了解决这个问题,涌现了许多基于RoPE的长度外推工作,旨在让大模型在预训练长度之外取得更好的效果。RoPE将相对位置信息集成到自注意力中,具有较好的位置外推性,并可与Flash-Attention v2配合使用,提升模型训练速度约20%.

大模型与Agent智能体 2288

Llama改进之——RoPE旋转位置编码

旋转位置编码从理论到实战。

日积月累,天道酬勤 3392

旋转位置编码RoPE总结

Rotary Position Embedding (RoPE)可谓是今年Transformer模型改进中的一大热门内容,在大模型时代,RoPE在LLaMA、ChatGLM、Palm中得到应用,并证明其有效性。RoPE的诞生可以追溯到2021年,由苏剑林大神在《RoFormer: Enhanced Transformer with Rotary Position Embedding》首次提出,有效地改善了传统位置编码不能很好地捕捉相对位置的问题,同时也为长度外推提供了可扩展性。Markdown。

PennyYu123的博客 6113

图解RoPE旋转位置编码及其特性

旋转位置编码RoPE (Rotary Position Embedding) 是目前大模型中广泛使用的一种位置编码,包括但不限于Llama、Baichuan、ChatGLM、Qwen等。由于计算资源限制,目前的大模型大多在较小的上下文长度中进行训练,在推理中,若超出预训练的长度,模型的性能将会显著降低。于是涌现出了许多基于RoPE的长度外推的工作,旨在让大模型能够在预训练长度之外,取得更好的效果。所以弄清楚RoPE的底层原理,对于RoPE-base模型进行长度外推至关重要。本文主要结合苏神关于。

具身机器人和通用AI 1103

旋转位置编码RoPE

** 核心思想 **:通过复数旋转将位置信息编码到 Query 和 Key 中,使注意力计算依赖相对位置。-** 旋转方式 **:用位置相关的角度 θ 旋转特征向量的复数对,角度随位置和维度变化。-** 优势 **:支持长序列、保持相对位置不变性、无额外参数,已成为大模型(如 LLaMA、Flux)的标配位置编码方案。结合代码来看,RoPE 的实现主要分为两步:1)预计算每个位置的旋转角度(cos/sin);2)将角度应用到 Query 和 Key 向量的旋转中,最终融入注意力计算。

cn_wk的专栏 1426

RK3588上从零部署Facenet人脸识别:PyTorch转ONNX再到RKNN的完整避坑指南

本文提供了在RK3588开发板上从零部署Facenet人脸识别模型的完整指南。详细介绍了从PyTorch模型导出、转换为ONNX格式,再通过RKNN-Toolkit2转换为RKNN格式的完整流程,并重点分享了环境配置、算子兼容性处理、量化调优及板端部署中的关键步骤与避坑经验。

river的博客 464

别再羡慕专业版!用这个批处理脚本,一键给Win11家庭版装上官方沙盒

本文详细介绍了如何通过批处理脚本在Windows 11家庭版上安装官方Windows沙盒(Windows Sandbox),无需复杂操作即可享受专业版功能。脚本自动激活系统内置组件,提供安全隔离的虚拟化环境,适用于软件测试、安全浏览等场景。

weixin_26757925的博客 495

RoPE (旋转位置编码)

我们希望大模型能像人类一样,读完一本几百页的书(比如《三体》),然后和我们深入讨论其中跨越几十万字的伏笔和细节。其中,第一个问题由O(n²)导致,通常由 FlashAttention、稀疏注意力等工程和算法优化来解决。而第二个“失忆”问题,则源于传统的根本缺陷。

frostmelody 全网同名,大家多多关注呀~ 持续分享优质内容! 1831

超全!!snowboy语音唤醒(树莓派4b)

通过snowboy进行树莓派的语音唤醒

crimaster1024的博客 8735

【手撕ROPE】极简方法实现旋转位置编码ROPE,面试遇到手撕ROPE再也不怕了!

ROPE极简实现,秒杀面试手撕

qq_30731313的博客 4437

Flash芯片的VCC上电到可操作时间过长

Flash的VCC上电到操作时间(tVSL)通常有最大值限制,如果超过这个时间,核心风险是状态机不同步和指令锁存错误。比如芯片内部振荡器可能已经尝试启动又休眠了,但主控却在这之后才发送指令,导致完全 misinterpreted。Flash芯片的(从电源上电到可以正常进行读写操作的时间)如果过长,会产生一系列负面影响简单来说,这个时间过长意味着电源上升速度太慢,违反了芯片的要求。

qq_61918649的博客 722

零基础入门Simulink——基于Simulink的MIMO-OFDM系统仿真建模示例

MIMO概述MIMO技术利用多个天线进行信号发送和接收,通过空间复用来提高数据传输速率,或通过空间分集来增强信号的可靠性。OFDM概述OFDM是一种将高速率数据流分成多个低速数据流并行传输的技术,每个子载波都采用调制方式(如BPSK、QPSK),并通过IFFT/FFT变换实现串并转换。MIMO-OFDM优势结合了MIMO的空间分集增益与OFDM对抗多径效应的能力,适用于宽带无线通信系统。提供了更高的数据速率和更好的频谱效率,是现代无线通信标准(如4G LTE、5G NR等)的核心技术之一。

amy_mhd的博客 888

llama2 RoPE 旋转位置编码

旋转嵌入(RoPE)是LLaMA等模型采用的位置编码方法,通过复数旋转操作将位置信息编码到特征向量中。其核心是将特征向量两两分组,每组独立进行位置相关的旋转:实部x'=xcosθ-ysinθ,虚部y'=xsinθ+ycosθ,其中θ由位置决定。实现分为三步:预计算旋转角度的余弦/正弦值,调整维度以支持广播运算,最后应用旋转公式。这种方法能精确捕捉相对位置关系,且不改变输入输出维度。测试显示对[1,50,6,48]形状的Q/K向量处理后,输出保持相同维度但编码了位置信息。

victory0431的博客 1727

核心组件大换血:Backbone与Neck魔改篇:YOLO26替换EfficientNetV2主干:神经架构搜索(NAS)的最优解嫁接

YOLO26引入EfficientNetV2作为Backbone的改进方案探索了计算机视觉模型优化的前沿方向。文章首先分析了YOLO26默认C3k2模块的局限性,指出其在通道利用效率和缩放策略上的不足。随后重点介绍了EfficientNetV2的核心优势,包括Fused-MBConv模块、训练感知的NAS搜索空间和渐进式学习策略,这些特性使其在精度和效率上保持领先。最后提出了将EfficientNetV2嫁接至YOLO26的具体方案,强调通道对齐这一关键挑战,并给出两种解决方案。这一改进思路展现了&quot

ZDQ58818的博客 309

旋转位置编码(ROPE)详解:从Transformer到现代前沿

本文详细介绍了旋转位置编码(ROPE)在Transformer模型中的应用,包括其数学原理、代码实现以及与传统位置编码的对比。ROPE通过旋转嵌入向量来编码位置信息,能够自然捕捉相对位置关系,特别适用于长序列任务。文中提供了ROPE的PyTorch实现和使用示例,旨在帮助读者深入理解并应用这一先进技术。

阿正的梦工坊 5489

Python 爬虫实战:全面解析雪球网用户投资组合数据采集

本文介绍了如何使用 Python 爬虫技术,抓取雪球网用户的投资组合信息。通过模拟登录、解析页面内容等步骤,获取了用户的持仓数据。未来,可以进一步探索以下方向:

2201_76125261的博客 1304

概念解析 | 事件相机的原理 (含仿真代码)

在我们熟悉的世界里,传统相机就像一个勤勉的绘画师,每隔固定的时间就为我们勾勒出一幅完整的画面。但是,大自然中有太多瞬息万变的精彩场景,这种"定时绘画"的方式往往难以捕捉。于是,一种全新的"观察者"应运而生 -事件相机(Event Camera)。事件相机,就像是一群极其敏感的"像素哨兵",它们不再按部就班地等待指令,而是主动感知周围的变化,只有在光线强度发生显著变化时才会发出信号。这种革命性的设计,让事件相机拥有了传统相机难以企及的优势:超高的时间分辨率、极低的延迟、宽广的动态范围,以及出色的能效比。

NLOS的博客 1422

RoPE——Transformer 的旋转位置编码

RoPE(Rotary Position Embedding,旋转位置编码)是一种新型的位置编码方法,专为 Transformer 架构设计。它通过引入旋转矩阵,将位置信息直接嵌入到词向量中,与传统方法相比更高效且自然地捕捉了相对位置关系。与传统位置编码不同,RoPE 不需要额外的参数,也不直接依赖加法来嵌入位置信息。它通过对每个词向量进行旋转,隐式地在自注意力机制中捕捉相对位置。RoPE(旋转位置编码)通过旋转矩阵的引入,在 Transformer 的位置编码中实现了新的突破。

爱猫的小学森 3889

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

transformer-旋转位置编码RoPE

扭转位置编码(Rotary Position Embedding, RoPE)是一种改进的位置编码方法,用于增强模型对序列顺序的敏感性。它通过对输入序列的特征向量进行旋转变换,将位置信息隐式编码进来,使得模型能够更好地捕获相对位置信息。RoPE 通常用于对比 Transformer 中传统的位置编码,能够提供更强的位置感知能力。

hbkybkzw的博客 1457

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

RoPE旋转位置编码

【代码】RoPE旋转位置编码。

weixin_40777649的博客 1228

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

Rope旋转位置编码解读

RoPE通过旋转矩阵将位置信息编码到向量中。对于位置m和维度索引i,使用角度mθi​θi​10000−2id。

ekkoalex的博客 1013

RoPE旋转位置编码代码实现

RoPE旋转位置编码代码实现

周同学的博客 2433
上一篇: LORA的基本原理
下一篇: LLM主流框架:Causal Decoder、Prefix Decoder和Encoder-Decoder
TFATS-AI
博客等级 码龄7年 1278粉丝 172原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值