


✨✨ 欢迎大家来访Srlua的博文(づ ̄3 ̄)づ╭❤~✨✨🌟🌟 欢迎各位亲爱的读者,感谢你们抽出宝贵的时间来阅读我的文章。
我是Srlua小谢,在这里我会分享我的知识和经验。🎥
希望在这里,我们能一起探索IT世界的奥妙,提升我们的技能。🔮
记得先点赞👍后阅读哦~ 👏👏
📘📚 所属专栏:传知代码论文复现
欢迎访问我的主页:Srlua小谢 获取更多信息和资源。✨✨🌙🌙



目录
本文所有资源均可在该地址处获取。
概述
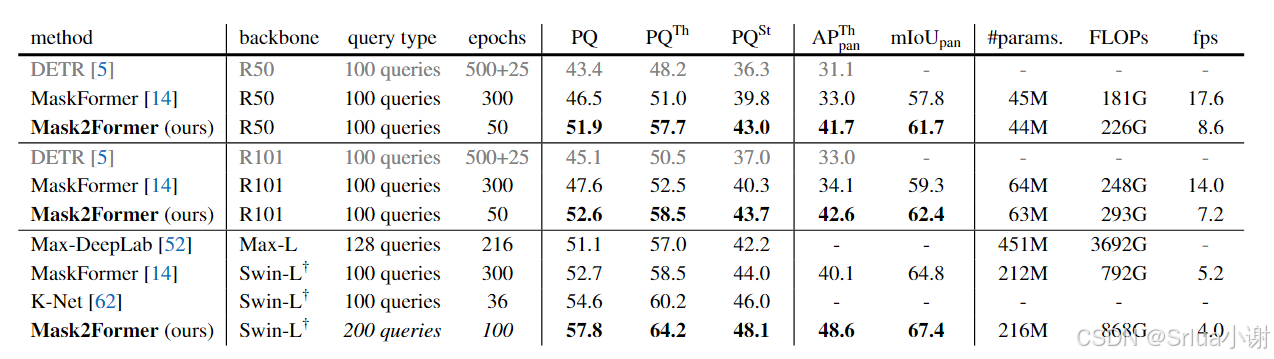
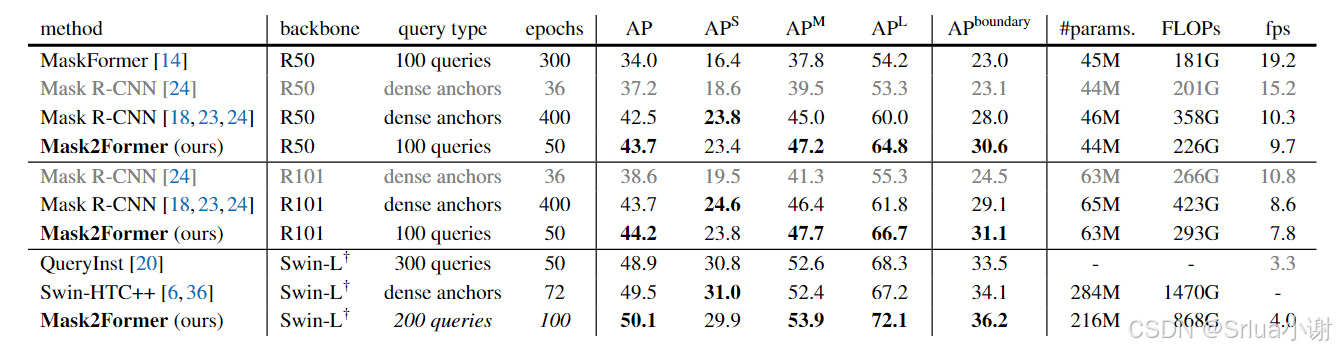
图像分割研究像素分组问题,对像素进行分组的不同语义产生了不同类型的分割任务,例如全景分割、实例分割或语义分割。虽然这些任务中只有语义不同,但目前的研究侧重于为每个任务设计专门的架构。Mask2Former是一个能够处理图像多种分割任务(全景分割、实例分割、语义分割)的新框架。它的关键组件是掩码注意力机制,通过约束预测掩码区域内的交叉注意来提取局部特征。Mask2Former将研究工作减少了至少三倍,且在四个流行的数据集上大大优于最好的专业架构。
模型结构

Mask2Former的结构和MaskFormer类似,由一个主干网络,一个像素解码器,一个Transformer解码器组成。Mask2Former提出了一个新的Transformer解码器,该解码器使用掩码注意力机制代替传统的交叉注意力机制。为了处理尺寸较小的物体,Mask2Former每次将来自于像素解码器的多尺度特征的一个尺度馈送到Transformer解码器层。除此之外Mask2Former交换了自注意力和交叉注意力(掩码注意力)的顺序,使查询特征可学习,并去除dropout层结构式计算更有效。
掩码分类准备
掩码分类架构通过预测N个二进制掩码,以及N个相应的类别标签,将像素分成N个块。掩码分类通过将不同的语义(类别或实例)分配给不同的片段来解决任何分割任务。然而,为每个片段找到好的语义表示具有挑战性,例如Mask RCNN使用边界框作为表示,这限制了它在语义分割中的应用。受DETR的启发,图像中的每个片段可以表示为C维特征向量(对象查询),由Transformer解码器处理,该解码器使用集合预测目标进行训练。
一个简单的元架构由三个组件组成:
- 一个主干网络:从图像中提取低分辨率特征。
- 一个像素解码器:从主干的输出逐步对低分辨率特征进行上采样,以生成高分辨率逐像素嵌入。
- 一个Transformer解码器,利用对象查询和图像特征进行交互,以丰富对象查询中包含的语义信息。
- 二值掩码预测:从逐像素嵌入的对象查询解码出最终的二进制掩码预测。
带有掩码机制的Transformer解码器
Transformer解码器的关键组件包括一个掩码注意算子,它通过将每个查询的交叉注意力限制在其预测掩码的前景区域,而不是关注完整的特征图来提取局部特征。为了处理小物体,Mask2Former提出了一种有效地多尺度策略来利用高分辨率特征。它以循环的方式将像素解码器特征金字塔的连续特征映射馈送到连续的Transformer解码器层。Mask2Former的改进如下:
掩码注意力机制
最近的研究表明,基于Transformer的模型收敛缓慢是由于交叉注意力层中关注全局上下文信息,因此交叉注意力需要许多训练轮才能学会关注局部对象区域。Mask2Former假设局部特征足以更新查询特征,且全局上下文信息可以通过自我注意力来收集。为此,Mask2Former提出了掩码注意,这是一种交叉注意的变体,它只关注每个查询预测掩码的前景区域。Mask2Former的掩码注意力机制如下计算:
Xl=softmax(Ml−1+QlKlT)Vl+Xl−1Xl=softmax(Ml−1+QlKlT)Vl+Xl−1
在这里ll是层索引,Xl∈RN×CXl∈RN×C表明在第ll层,NN个CC维的查询向量。Ql=fQ(Xl−1)∈RN×CQl=fQ(Xl−1)∈RN×C。Kl,Vl∈RHlWl×CKl,Vl∈RHlWl×C分别是经过fK(⋅)fK(⋅)和fV(⋅)fV(⋅)变化下的图像特征。fQ、fKfQ、fK和fVfV是线性变换,(x,y)(x,y)处特征的注意掩码Ml−1Ml−1为:
Ml−1(x,y)={0 if Ml−1(x,y)=1−∞ otherwiseMl−1(x,y)={0−∞ if Ml−1(x,y)=1 otherwise
此时,Ml−1∈{0,1}N×HlWlMl−1∈{0,1}N×HlWl是第l−1l−1个Transformer解码器层大小经过调整后的掩码预测的二进制输出。它将大小调整为KlKl相同的分辨率。M0M0是从X0X0(将查询特征输入Transformer解码器之前)获得的二进制掩码预测。
高分辨率特征
高分辨率提高了模型的性能,特别是小物体的准确率,但是这对计算要求很高。因此,Mask2Former提出了一种有效的多尺度策略,在控制计算量增加的同时引入了高分辨率特征。它不总是使用高分辨率特征图,而是利用由低分辨率到高分辨率特征组成的特征金字塔,一次将多尺度特征的一个分辨率馈送到一个Transformer解码器层。
具体来说,Mask2Former使用像素解码器产生的特征金字塔,分辨率为原始图像的1/32,1/16,1/8。对于每个分辨率,添加一个正弦位置嵌入epos∈RHlWl×Cepos∈RHlWl×C,以及一个可学习的尺度级嵌入elvl∈R1×Celvl∈R1×C。在Transformer解码器层依次使用从最低分辨率到最高分辨率的那些图像,并且重复这个 3 层 Transformer 解码器 L 次。最终的Transformer解码器为3L层。
优化改进
一个标准的Transformer解码器层由三个模块(自我注意模块,交叉注意和前馈网络)组成,按照顺序处理查询特征。查询特征x0x0在送入Transformer解码器之前被初始化为零,并与可学习的位置嵌入相关联。dropout应用于残差连接和注意力图。为了优化Transformer的解码器设计,Mask2Former进行了以下三个改进。
- Mask2Former切换了自注意力和交叉注意力的顺序。第一层自注意层的查询特征与图像无关,不具有来自图像的信息,因此应用自注意不太可能丰富信息。
- Mask2Former使查询特征x0x0也是可学习的(仍然保留可学习的查询位置嵌入),并且可学习的查询特征在被用于Transformer解码器中预测掩码M0M0之前直接被监督。
- Mask2Former发现dropout是不必要的,而且通常会降低性能,完全消除了解码器的dropout。
实验
COCO数据集全景分割结果
COCO数据集实例分割结果
演示效果
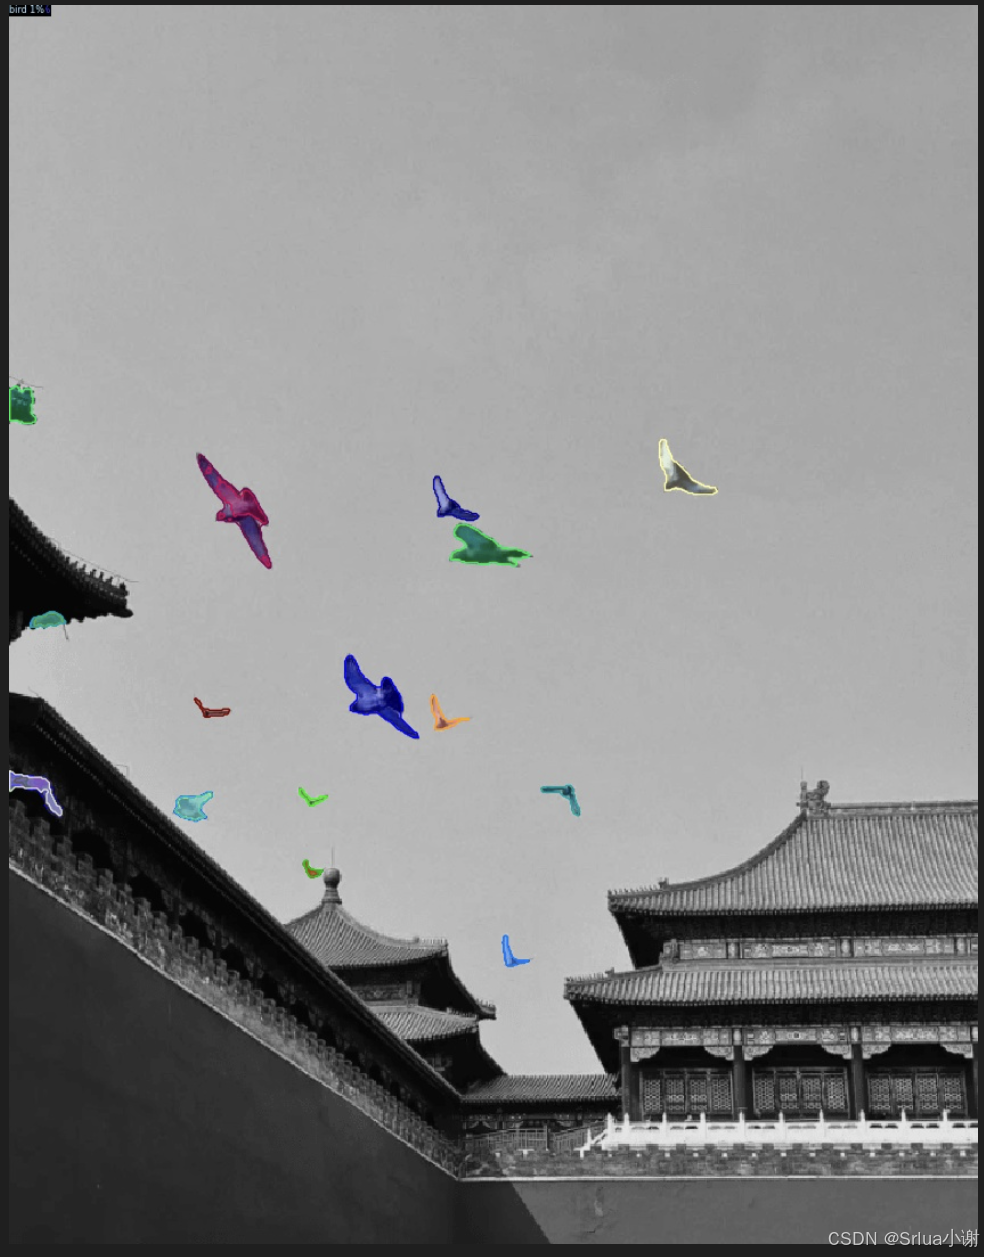
实例分割结果
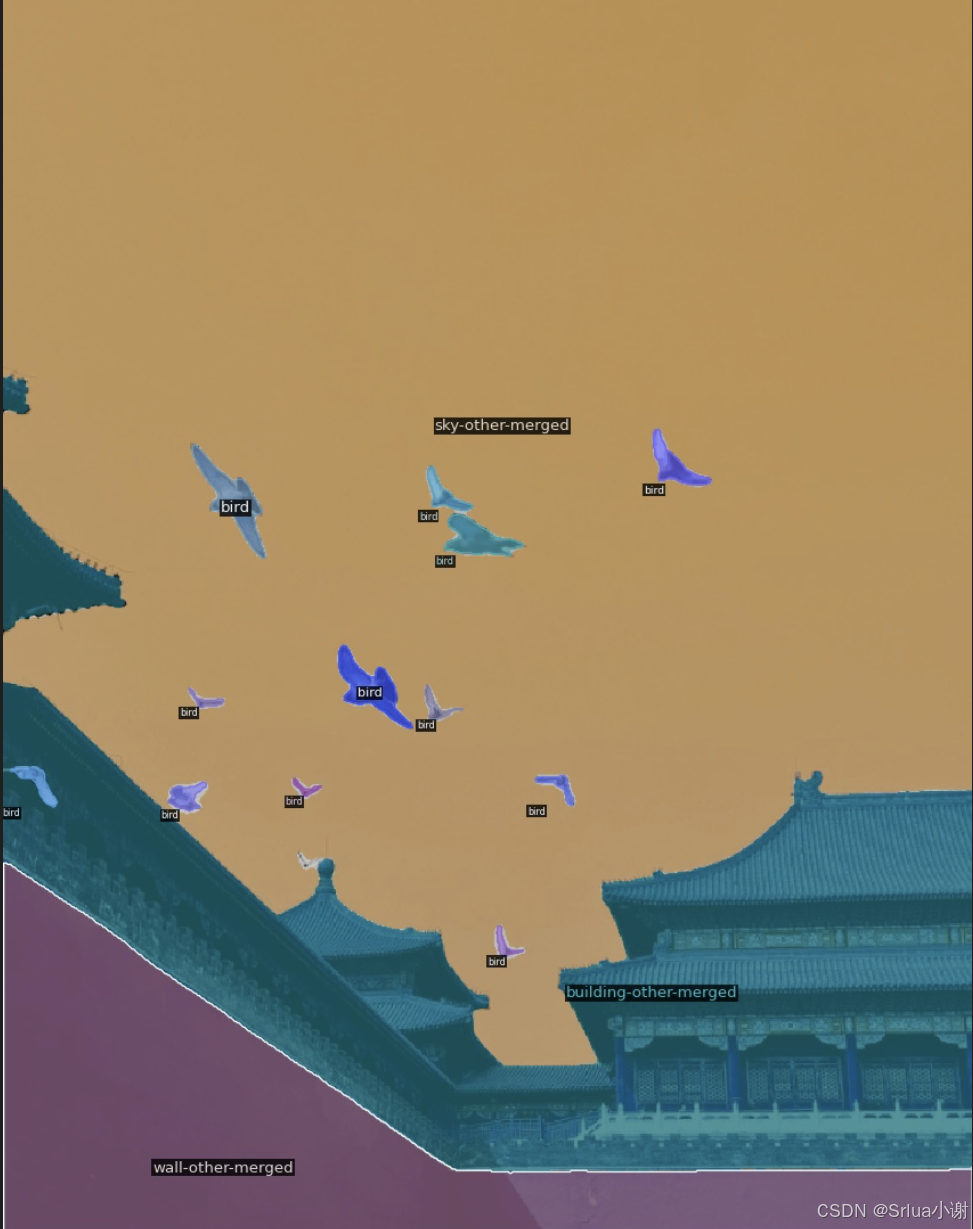
全景分割结果
语义分割结果
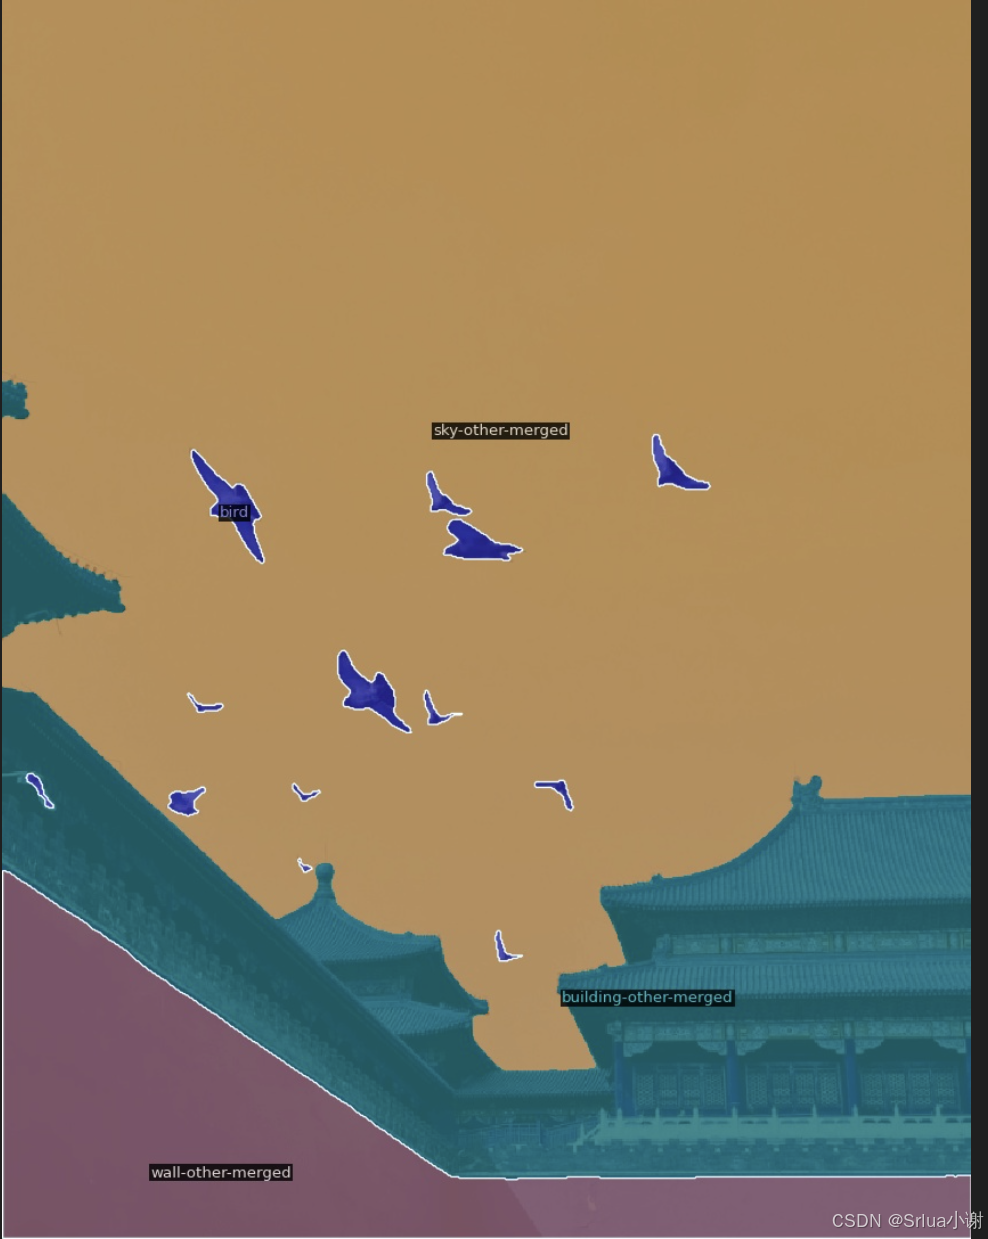
核心逻辑
像素解码器
    def forward_features(self, features):
        srcs = []
        pos = []
        # Reverse feature maps into top-down order (from low to high resolution)
        # 将其通道维数全部转变为256
        for idx, f in enumerate(self.transformer_in_features[::-1]):
            x = features[f].float()  # deformable detr does not support half precision
            srcs.append(self.input_proj[idx](x))
            pos.append(self.pe_layer(x)) # 存放有关像素分辨率的sine位置编码不可学习
        # y: [1,43008,256] 将不同大小的特征图进行拼接
        y, spatial_shapes, level_start_index = self.transformer(srcs, pos)
        bs = y.shape[0]

        split_size_or_sections = [None] * self.transformer_num_feature_levels

        for i in range(self.transformer_num_feature_levels):
            if i < self.transformer_num_feature_levels - 1:
                split_size_or_sections[i] = level_start_index[i + 1] - level_start_index[i]
            else:
                split_size_or_sections[i] = y.shape[1] - level_start_index[i]
        y = torch.split(y, split_size_or_sections, dim=1)

        out = []
        multi_scale_features = []
        num_cur_levels = 0
        for i, z in enumerate(y):
            # z:[1,2048,256]->[1,256,2048]->[1,256,32,64]
            out.append(z.transpose(1, 2).view(bs, -1, spatial_shapes[i][0], spatial_shapes[i][1]))
        # append `out` with extra FPN levels
        # Reverse feature maps into top-down order (from low to high resolution)
        for idx, f in enumerate(self.in_features[:self.num_fpn_levels][::-1]):
            x = features[f].float()
            # x: [1,256,256,512] cur_fpn:[1,256,256,512]
            lateral_conv = self.lateral_convs[idx]
            output_conv = self.output_convs[idx]
            cur_fpn = lateral_conv(x)
            # Following FPN implementation, we use nearest upsampling here
            # y:[1,256,256,512] 将最后一个128,256进行拼接
            y = cur_fpn + F.interpolate(out[-1], size=cur_fpn.shape[-2:], mode="bilinear", align_corners=False)
            y = output_conv(y)
            out.append(y)
        # 此时将3个pixel从低到高分辨率的特征图像提取出来了
        for o in out:
            if num_cur_levels < self.maskformer_num_feature_levels:
                multi_scale_features.append(o)
                num_cur_levels += 1
        # 用最大的的特征图来确定是否是模型所关心的前景区域,out[0]表示第一个特征图的情况
        # multi_scale_features表示不同的特征
        return self.mask_features(out[-1]), out[0], multi_scale_features
Transformer解码器代码
def forward(self, x, mask_features, mask = None):
        # x is a list of multi-scale feature
        assert len(x) == self.num_feature_levels
        src = []
        pos = []
        size_list = []

        # disable mask, it does not affect performance
        del mask

        for i in range(self.num_feature_levels):
            # 获取不同特征图的大小
            size_list.append(x[i].shape[-2:])
            # 将不同的特征图添加位置编码,并且展平处理 [1,256,2048]
            pos.append(self.pe_layer(x[i], None).flatten(2))
            # 将图像通道统一,并且获得不同的尺度可学习编码
            src.append(self.input_proj[i](x[i]).flatten(2) + self.level_embed.weight[i][None, :, None])

            # flatten NxCxHxW to HWxNxC
            pos[-1] = pos[-1].permute(2, 0, 1)
            src[-1] = src[-1].permute(2, 0, 1)

        _, bs, _ = src[0].shape

        # QxNxC [100,1,256] output作为查询提供信息
        query_embed = self.query_embed.weight.unsqueeze(1).repeat(1, bs, 1)
        output = self.query_feat.weight.unsqueeze(1).repeat(1, bs, 1)

        predictions_class = []
        predictions_mask = []

        # prediction heads on learnable query features
        # 使用注意力内的区域来进行预测
        outputs_class, outputs_mask, attn_mask = self.forward_prediction_heads(output, mask_features, attn_mask_target_size=size_list[0])
        predictions_class.append(outputs_class)
        predictions_mask.append(outputs_mask)

        # Decoder架构,先进行交叉注意力机制,之后进行自注意力机制,最后进行FFN结构
        for i in range(self.num_layers):
            level_index = i % self.num_feature_levels
            attn_mask[torch.where(attn_mask.sum(-1) == attn_mask.shape[-1])] = False
            # attention: cross-attention first
            output = self.transformer_cross_attention_layers[i](
                output, src[level_index],
                memory_mask=attn_mask,
                memory_key_padding_mask=None,  # here we do not apply masking on padded region
                pos=pos[level_index], query_pos=query_embed
            )

            output = self.transformer_self_attention_layers[i](
                output, tgt_mask=None,
                tgt_key_padding_mask=None,
                query_pos=query_embed
            )

            # FFN
            output = self.transformer_ffn_layers[i](
                output
            )

            outputs_class, outputs_mask, attn_mask = self.forward_prediction_heads(output, mask_features, attn_mask_target_size=size_list[(i + 1) % self.num_feature_levels])
            predictions_class.append(outputs_class)
            predictions_mask.append(outputs_mask)

        assert len(predictions_class) == self.num_layers + 1

        out = {
            'pred_logits': predictions_class[-1],
            'pred_masks': predictions_mask[-1],
            'aux_outputs': self._set_aux_loss(
                predictions_class if self.mask_classification else None, predictions_mask
            )
        }
        return out
部署方式
conda create --name mask2former python=3.8 -y
conda activate mask2former
conda install pytorch==1.9.0 torchvision==0.10.0 cudatoolkit=11.1 -c pytorch -c nvidia
pip install -U opencv-python

# under your working directory
git clone git@github.com:facebookresearch/detectron2.git
cd detectron2
pip install -e .
pip install git+https://github.com/cocodataset/panopticapi.git
pip install git+https://github.com/mcordts/cityscapesScripts.git

cd ..
git clone git@github.com:facebookresearch/Mask2Former.git
cd Mask2Former
pip install -r requirements.txt
cd mask2former/modeling/pixel_decoder/ops
sh make.sh
参考资料


 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


