


✨✨ 欢迎大家来访Srlua的博文(づ ̄3 ̄)づ╭❤~✨✨🌟🌟 欢迎各位亲爱的读者,感谢你们抽出宝贵的时间来阅读我的文章。
我是Srlua小谢,在这里我会分享我的知识和经验。🎥
希望在这里,我们能一起探索IT世界的奥妙,提升我们的技能。🔮
记得先点赞👍后阅读哦~ 👏👏
📘📚 所属专栏:传知代码论文复现
欢迎访问我的主页:Srlua小谢 获取更多信息和资源。✨✨🌙🌙



目录
概述
近年来,深度神经网络(DNN)在计算机视觉(CV)和自然语言处理(NLP)领域中取得了难以置信的成就。当前各个领域的SOTA模型的成功往往可以归功于DNN强大的表现力——由Kolmogorov superposition theorem和一致逼近定理可以知道,在足够参数量的支持下,DNN可以逼近任意连续多元函数。为了实现更好的性能,DNN模型的参数量越来越大,现存、算力的限制也越来越显著。该文章创新性的提出了积分神经网络(Integral Neural Network,INN)。概括的说,INN假定DNN中的每一层可以看作连续操作,其使用积分变换替代神经网络中的卷积变换,利用积分的连续性在给定采样网格上给出对应的层输出。基于这一设想,INN实现了对网络的“无损”压缩,展示了超强的网络压缩性能。
本文基于Integral Neural Network, 其论文发表在CVPR 2023。
核心思路
INN的核心工作原理可以由以下公式所示:

公式中的

我们可以看到,该公式将左部积分在n个点进行采样,并以qiqi的加权和作为积分的近似值。
这一部分有没有很眼熟?
这不就是数值积分吗?学积分概念的应该都接触过那个无限细分的长方形吧。

文章讨论了不同的计算方式,最后得出实际中梯形计算方式误差更小的结论。
让我们看看这个公式说了什么。从左到右,两函数积的定积分,经过一个采样大小为n网格将其近似到了向量的点积;从右到左,不同两函数的有参数情况下的积被转换成了积分形式。这就为神经网络层和积分操作搭建了桥梁,也为统一不同通道维大小的网络提供了基础。
当我们有了桥梁之后,就可以实行网络的训练了。

对于积分中的连续参数表达,首先在确定网格上对其进行离散化,将其乘以可训练积分权重q作为整体权重。然后,将输入与权重相乘即可作为该层输出。
具体细节
当前DNN主要有三大核心模块,卷积层(Convolution or cross-correlation layer)、全连接层(Fully-connected layer)和激活函数层(Pooling and activation functions)。本节对这三种模块进行分别讨论。在讨论之前,每个模块都存在可训练参数,其参数的函数表达要首先讨论。
INN中使用插值法获得具体参数,以全连接层为例,

每层的可训练参数连续化为FWFW,其值由输入输出坐标确定;λλ为可训练参数;u()u()为三次卷积插值函数(如图a),值得一提的是文章选择该函数是因为其被广泛引用在高效图像插值问题,对不同插值函数的研究可能是未来的一个方向。

对于积分核函数FW(λ,x)FW(λ,x),是通过参数化表达来实现的对一个连续核函数的描述,选定一个卷积核,然后在归一化区间上等间距取m个结点,其上的权重λiλi作为可学习权重。其实这是最常用的一种连续函数的卷积形式的参数化表达,只不过插值权重是可学习的。这个连续积分核函数确定后,可以根据需要离散化采样该积分核的值。
与公式(1)相呼应,其中网络参数WqWq可以连续函数FWFW改写:

其中PkoutPkout和PlinPlin为输入输出的采样情况。
卷积层

对于卷积层,上式满足卷积形式。卷积核参数由通道维输入坐标xoutxout、通道维输出坐标xinxin和空间维输入坐标xsxs确定;对应的输入信号由通道维输入坐标xinxin和空间维输入偏置坐标xs′+xsxs′+xs确定;输出由空间维度和通道维度确定。这种确定方式完全符合卷积层操作。
全连接层

全连接层比卷积层更加简单。其可训练参数由输入输出维度确定;输入仅由输入维度确定;输出仅由输出维度确定。这也是符合全连接层操作的,实际从公式也能看出来,这就是矩阵乘法。
激活函数

激活函数就更加简单了。对激活函数定义一个分段采样D(,P)D(,P),该函数是线性的所以可以和激活函数互换位置,这样也就说明了本文的分段采样对激活函数没有影响(采样可以和激活函数操作互换位置)。
自此,我们有了网络核心模块的连续化,从而可以使用积分操作替换网络层,通过改变计算积分时的采样点数改变网络中的通道维数。
训练逻辑

训练需要数据集X。其首先将网络进行连续化,获得连续网络并确定压缩范围(人为指定);然后对连续网络中的每一层,分别随机生成一个采样网格,在该网格上进行采样,并计算输出结果;最后,汇总模型输出结果,走完整个bp过程。
从网络训练的角度,可以将连续网络看作一个网络集合MM。每次训练都从集合MM中随机选取一个子网络进行训练。由于三角不等式:

即两网络效果差不大于各自与真实值的差之和,我们训练减小不等式右边也将使得左边的上限减小,从而获得相差不多的训练效果。
演示效果
文章中使用INN方法压缩EDSR,其结果展示:

从数据上来看,如果使用预训练的模型进行初始化(INN-init),可以看出INN压缩之后的模型效果和原模型效果一致,甚至更优。

我将扩展后的INN使用在不同模型上。我们可以通过观察其压缩前后的feature map,下图左边是压缩前,右边是压缩后。

(太大,平台无法上传,所以这里为静态图)
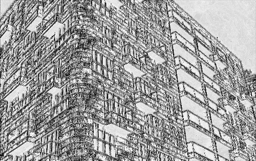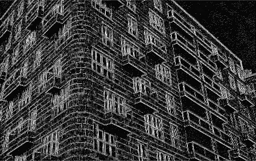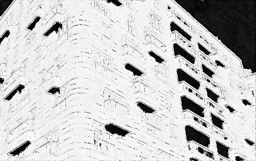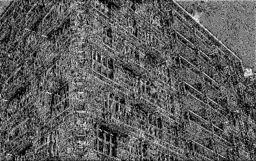
通过仔细观察,可以明显看出压缩后feature map的细节程度是比压缩前更加丰富的(例如楼角,纹路)。同时,压缩后在feature map明显比压缩前少了很多模糊情况。这在一定程度上可以被称为INN压缩的原理。
总结与思考
INN使用积分替换卷积操作,其主要好处在于获得了可变的网络通道维度。INN通过训练不同通道维度设置下的网络以求减小网络通道维,从而进行模型压缩。然而,INN作为一个新兴方法还有很多不足的地方。
- 网络通道维度作为网络大小的重要超参数,近年来受到的重视明显不足。研究者们设置这一参数总是与标准模型看齐,与其他模型看齐,从而放下手来调整学习率、学习策略和网络结构等更“重要”的部分。这一现象导致了目前模型中通道维参数可能存在着大量的冗余。INN通过积分方法测试压缩通道维度,其核心训练目标基于公式(8)。然而,首先,训练过程中不同采样的网络大概率会有互相影响,这影响着公式(8)的成立性。其次,对于公式(8),其描述仅为不同划分下,网络性能越来越近,并不能保证所有划分的收敛结果一样好。因此有理由怀疑,在训练过程中,划分颗粒度粗的模型可能会“带跑”划分颗粒度细的模型的性能,而文章中的无损压缩只是通道维冗余的结果。如果单纯将通道维的超参调低,可能会达到一样甚至更优的效果。(事实上我私下通过这种实验初步验证了这一点。)
从这个角度,换个方向想,可能将INN方法用作fine tune,或者指导模型进行初步收敛可能是目前INN比较直观的应用方向? - 由于第一点的存在,且根据事实考虑,手动设置网络通道维范围仍然是一个比较困难的过程。这也就是说,INN只能在较优的预先设置的通道维范围里有效运行。
- INN实现中,不区分网络不同层的冗余度。然而,大量研究表明,随着网络加深,网络冗余度会产生变化。这一点限制了INN压缩的性能。
- 最后,INN目前不支持Attention机制且代码写的不够灵活,这是一个硬伤。
代码优化
针对当前INN代码的问题,我进行了调整和改动。
首先,对其integral group类进行修改:
class IntegralGroup(RelatedGroup):
    """计算积分相关组"""
    def __init__(self, size, base, typeo="normal", factor=None, partner=None):
        super(RelatedGroup, self).__init__()
        self.rate = 1 #当前组的压缩度
        self.ori_size = size #组默认维度大小(最大大小)
        self.factor = factor #比例因子
        self.domain = None #维度定义域 None表示默认表示,不使用维度定义域法
        self.friends = None #用于适配concat命令
        self.partner = partner #决定该组group大小的层
        self._size = size #当前组维度大小
        self.base = base #维度必定是base整数倍
        self.subgroups = None #原代码中用于处理组间关系
        self.parents = [] #父辈组,用于确定组件关系
        self.grid = None #采样网格
        self.params = [] #组所管辖的参数
        self.tensors = [] #组所管辖的参数对应的tensor
        self.operations = [] #组的操作名称,用于显示信息和字符串记录
        self.typeo = typeo #组类别,用于确定组的压缩方式
        self.vis = False #组是否来过的flag
如注释所示,我添加了很多原代码没有的好用且需要的功能,如支持组间比例关系,支持组间加法关系,支持组间乘法关系,支持在domain范围内取值,支持仅取base的倍数等。这些在实际使用INN的时候都是很需要用到的功能。
其次,我在operator.py文件内添加了很多很有用但原程序没有的钩子,示例如下:
layer_norm_hook(module, inp, out)#层归一化函数
chunk(inp, chunks, dim)#chunk函数
sub_operator(x,y)#减法操作
sub_operator(x,y)#减法操作
等。
有了钩子,就需要在遍历的时候调用。这部分INN使用torch.fx库实现。但是INN没有使用自定义Tracer,这使得在不同模型使用INN比较繁琐。我添加自定义钩子如下
class CustomTracer(torch.fx.Tracer):
    def __init__(self, custom_list) -> None:
        super().__init__()
        self.custom_list = custom_list
    def is_leaf_module(self, m: torch.nn.Module, module_qualified_name: str) -> bool:
        is_leaf = False
        for i in self.custom_list:
            is_leaf = is_leaf or (i in m.__module__)
        return is_leaf or (super().is_leaf_module(m,module_qualified_name))
并在调用tracer的时候添加用户模组名列表,以此达到过滤用户模组、使其在使用的时候作为一个端点存在而不深入迭代。更多更改,类的具体使用策略以及bug修复请查看附件源代码。
使用方式
更改过的INN与原INN一样作为一个扩展库存在,调用方法类似。
-
环境配置
确保运行环境内包括requirements.txt中的包。例如:- pytorch 2.0+ - torchvision - numpy - scipy - Cython - catalyst - pytorchcv -
安装INN
pip install . -
导入包开始使用
import torch_integral as inn包使用总共分4步:
-
定义连续层
continuous_dims = { "layer4.0.conv1.weight": [0],#"your.model.layer.name": [dimintional number] "layer4.1.conv1.weight": [0, 1] } #使用inn.standard_continuous_dims可以自动获取所有层 continuous_dims = inn.standard_continuous_dims(model.module_name) -
定义离散层
由于连续采样维度随机,一般需要将两端设置为非连续使得其对外表现一致。dis_dims = { "conv0.weight":[1], "fc1.weight":[0], "fc1.bias":[0] } -
使用wrapper获取连续化模型
inn_model = inn.IntegralWrapper( init_from_discrete=True, permutation_config={"class":inn.permutation.NOptOutFiltersPermutation} )(model, (your_input_shape), continuous_dims, dis_dims) -
设置组压缩率
for i in inn_model.groups:
	i.reset_distribution(inn.UniformDistribution(int(i.size/2), int(i.size), i.base, i.domain))
之后,就可以像正常使用你的模型一样训练连续模型了。但是要关注一点,如果你使用了各自并行技术(DP,DDP等),可能需要在train的epoch中显示调用以下forward_group(),如下:
your_model.module.your_module_name_path.forward_group()#DP
your_model.your_module_name_path.forward_group()
这一问题是INN的遗留问题。
-
-
测试连续模型
首先,你需要按3准备好你的模型的连续化版本并设置好压缩率范围。使用resize函数设定你想要的压缩度
your_model.module_name.groups[index].resize(idle_size)在导入pre_train的数据之后,运行如下代码获得你所需要的离散版本:
print("Compression: ", model.module_name.eval().calculate_compression()
model.module_name = model.module_name.get_unparametrized_model()
注意print句必须存在,这也是INN的遗留问题。
参考文献
[1] Kirill Solodskikh, Azim Kurbanov, Ruslan Aydarkhanov, Irina Zhelavskaya, Yury Parfenov, Dehua Song, and Stamatios Lefkimmiatis. 2023. Integral Neural Networks. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR). 16113–16122.

希望对你有帮助!加油!
若您认为本文内容有益,请不吝赐予赞同并订阅,以便持续接收有价值的信息。衷心感谢您的关注和支持!

 4395


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


