Robust多模态模型的开发

情感常用数据集整理 整理了一些情感常用和不常用的数据集 阅读详情


✨✨ 欢迎大家来访Srlua的博文(づ ̄3 ̄)づ╭❤~✨✨

🌟🌟 欢迎各位亲爱的读者,感谢你们抽出宝贵的时间来阅读我的文章。

我是Srlua小谢,在这里我会分享我的知识和经验。🎥

希望在这里,我们能一起探索IT世界的奥妙,提升我们的技能。🔮

记得先点赞👍后阅读哦~ 👏👏

📘📚 所属专栏:传知代码论文复现

欢迎访问我的主页:Srlua小谢 获取更多信息和资源。✨✨🌙🌙

​​

​​

​​​

​

目录

Robust 多模态模型:寻找遗失的模态!

研究背景

模型结构和代码

数据集介绍

性能展示

实现过程

运行过程


需要本文的详细复现过程的项目源码、数据和预训练好的模型可从该地址处获取完整版:地址

Robust 多模态模型:寻找遗失的模态!
在这里插入图片描述​

  • 近年来,随着网络视频的大量涌现,各种多模态任务日益备受关注。尽管取得了显著的进展,但在迈向稳健多模态交互的道路上仍面临两大挑战: 1)在未对齐多模态数据中建模跨模态交互时效率低下; 2)在现实环境中通常会发生的随机模态特征缺失的脆弱性。

  • 其中,提高对数据丢失的鲁棒性已成为多模态任务的核心挑战之一,其目的是从语言,视觉和声学信号中完成多模态任务。针对模态特征不完备的情况,目前主要提出了基于修正的方法和张量正则化方法。然而,这两种方法都无法科普非对齐序列中随机模态特征的缺失。

本文提出了一种 Robust 的多模态模型来提高模型对非对齐模态序列随机缺失的鲁棒性。

  • 同时,我在流行的多模态任务–多模态情感计算的数据集上对模型进行了测试,得到了不错的效果,证明了该模型的可靠性。具体来说,我们使用了MOSI,MOSEI,以及两个中文数据集 SIMS, SIMSv2,以及抑郁症数据集AVEC2019,为医学心理学等领域提供帮助。 在这里插入图片描述​
  • 【注】 我们文章中所用到的数据集,都经过重新特征提取形成新的数据集特征文件(.pkl),另外该抑郁症数据集因为涉及患者隐私,需要向数据集原创者申请,申请和下载链接都放在了我们附件中的 readme文件中,感兴趣的小伙伴可以进行下载,谢谢支持!

研究背景

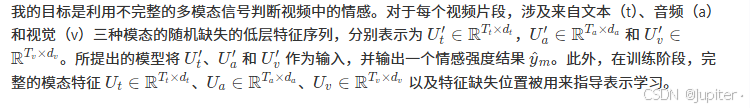
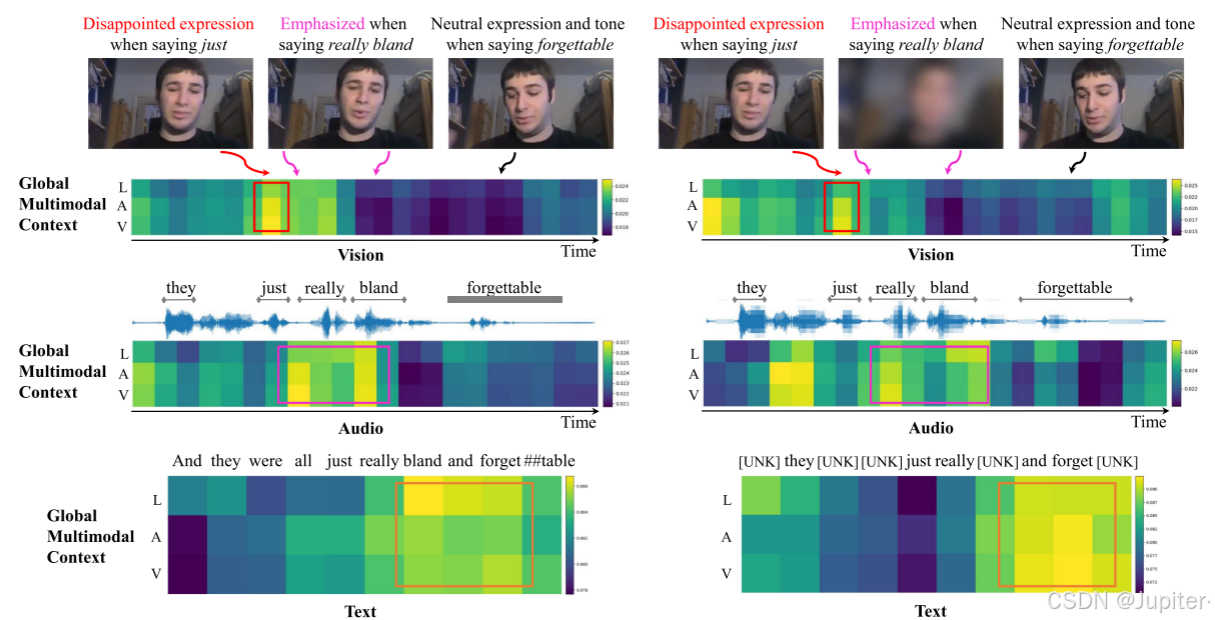
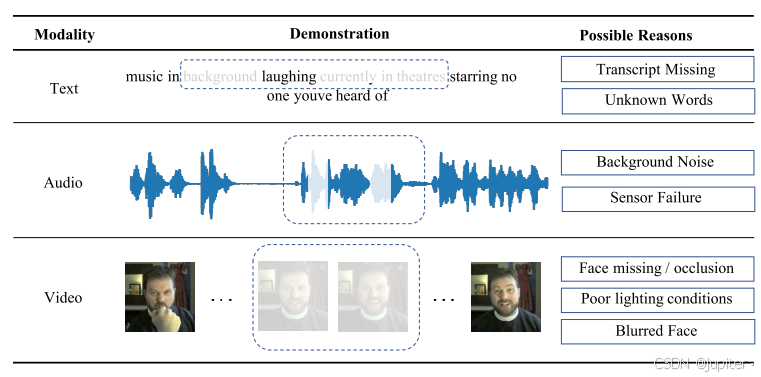
  • 随着用户生成的在线内容的丰富,各种多模态任务层出不穷。使用手动对齐的完整信息,包括转录语言,音频和视频,以前的工作已经取得了显着的改进多模态任务。然而,用户生成的视频通常是不完美的。首先,不同模态的接收器可能具有可变的接收频率,这导致不对齐的性质。其次,如下图所示,许多不可避免的因素,如用户生成的视频中的噪声或传感器故障,可能会导致模态特征提取器的故障。在这种情况下,需要一种能够处理随机模态特征缺失(RMFM)的模型。因此,在多模态任务中构建能够处理RMFM的模型仍然是一个开放的研究。基于RMFM的多模态任务的核心问题在于不完整模态序列的语义稀疏性,导致难以提取鲁棒的模态表示。据我所知,目前的工作大多直接使用具有缺失惩罚的不完整模态序列来学习联合融合表示。 在这里插入图片描述​
模型结构和代码

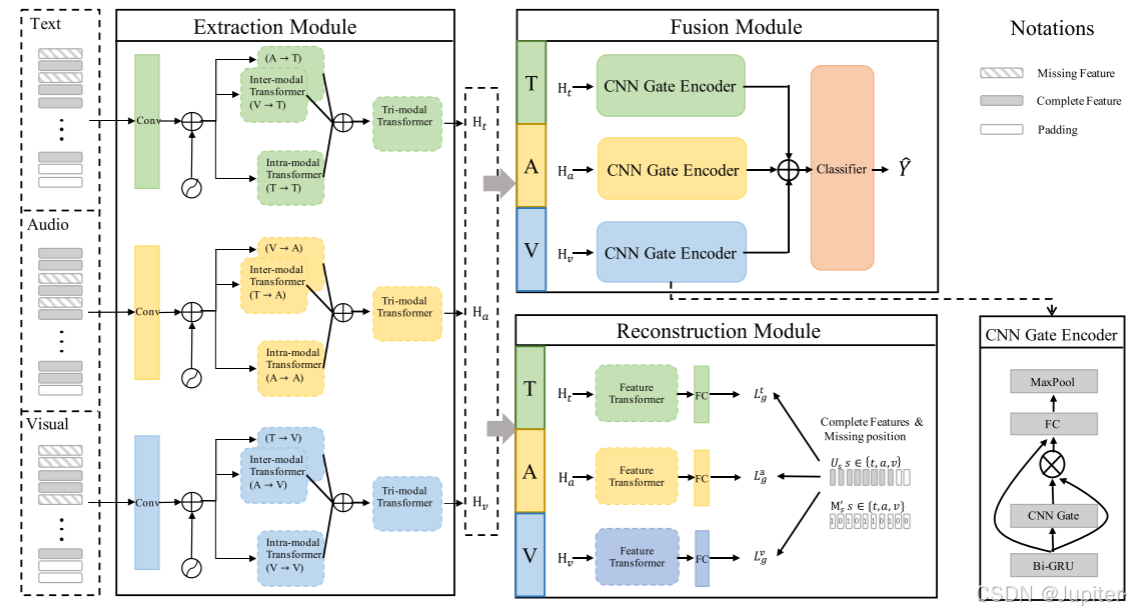
在这里插入图片描述​ 在这里插入图片描述​

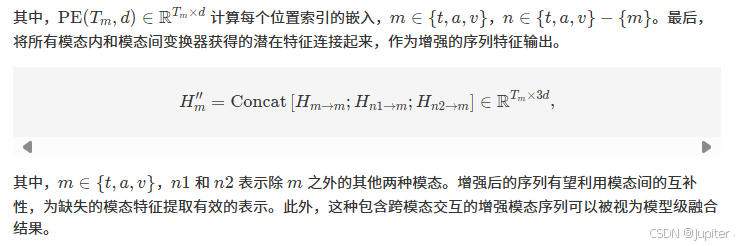
  1. 单模态特征提取 模态特征提取模块首先用一维卷积层处理不完整的模态序列,以确保输入序列的每个元素都知道其相邻元素。 公式的排版如下:
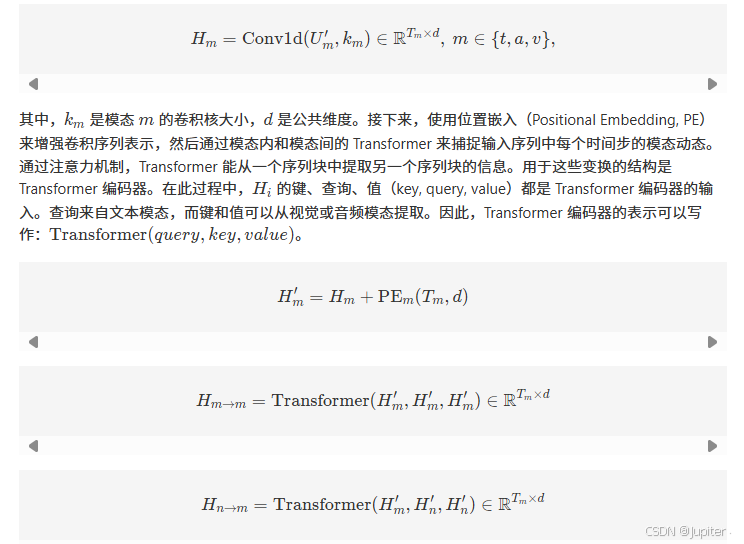
在这里插入图片描述​ 在这里插入图片描述​

  1. 模态重建模块 我们提出了一个模态重建(MR)模块,基于这样一个关键观点:从提取的模态序列中重建完整的模态序列,可以引导提取模块学习缺失部分的语义。对于每种模态,首先在特征维度上执行自注意力机制,以捕获提取特征之间的交互。
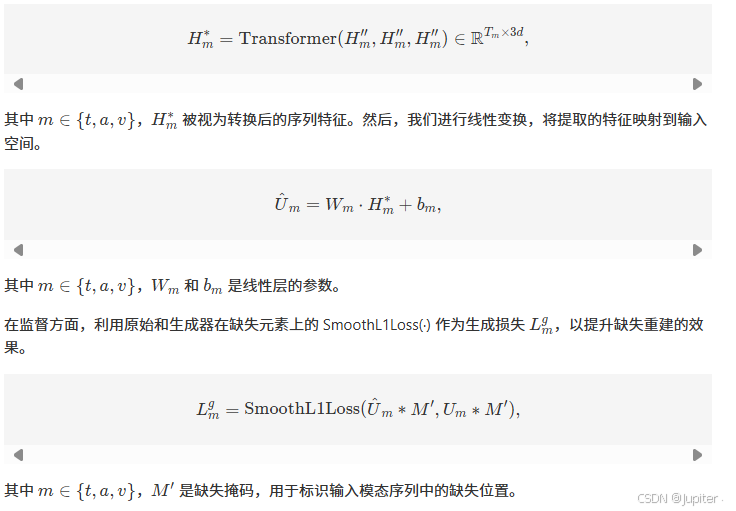
在这里插入图片描述​

数据集介绍

  1. 多模态情感计算数据集:

CMU-MOSI: CMU-MOSI数据集是MSA研究中流行的基准数据集。该数据集是YouTube独白的集合,演讲者在其中表达他们对电影等主题的看法。MOSI共有93个视频,跨越89个远距离扬声器,包含2198个主观话语视频片段。这些话语被手动注释为[-3,3]之间的连续意见评分,其中-3/+3表示强烈的消极/积极情绪; CMU-MOSEI: CMU-MOSEI数据集是对MOSI的改进,具有更多的话语数量,样本,扬声器和主题的更大多样性。该数据集包含23453个带注释的视频片段(话语),来自5000个视频,1000个不同的扬声器和250个不同的主题 SIMS/SIMSV2: CH-SIMS数据集[35]是一个中文多模态情感分析数据集,为每种模态提供了详细的标注。该数据集包括2281个精选视频片段,这些片段来自各种电影、电视剧和综艺节目,每个样本都被赋予了情感分数,范围从-1(极度负面)到1(极度正面);

  1. 多模态抑郁检测数据集:

AVEC2019: AVEC2019 DDS数据集是从患者临床访谈的视听记录中获得的。访谈由虚拟代理进行,以排除人为干扰。与上述两个数据集不同的是,AVEC2019中的每种模态都提供了几种不同的特征。例如,声学模态包括MFCC、eGeMaps以及由VGG和DenseNet提取的深度特征。在之前的研究中,发现MFCC和AU姿势分别是声学和视觉模态中两个最具鉴别力的特征。因此,为了简单和高效的目的,我们只使用MFCC和AU姿势特征来检测抑郁症。数据集用区间[0,24]内的PHQ-8评分进行注释,PHQ-8评分越大,抑郁倾向越严重。该基准数据集中有163个训练样本、56个验证样本和56个测试样本。

性能展示

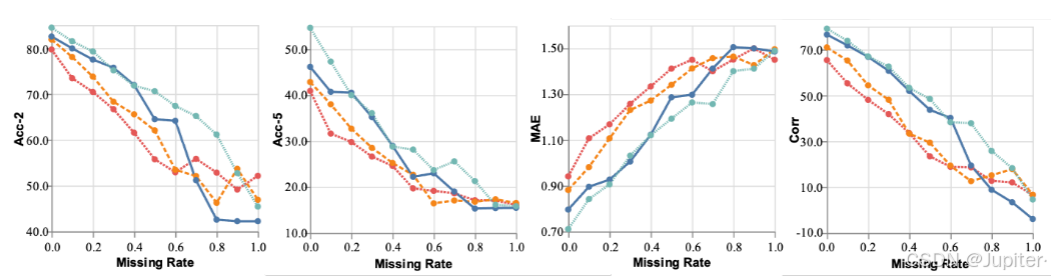
在情感计算任务中,可以看到加入 SimAM 算法后性能有了明显提升,证明了其有效性; 在这里插入图片描述​ 在这里插入图片描述​
实现过程

在下载附件并准备好数据集并调试代码后,进行下面的步骤,附件已经调通并修改,可直接正常运行;

  1. 数据集准备 下载附件中多种数据集已提取好的特征文件。把它放在"./dataset”目录。

  2. 下载需要的包

<span style="background-color:#f8f8f8"><span style="color:#333333">pip install MMSA</span></span>
  1. 进行训练

<span style="background-color:#f8f8f8"><span style="color:#333333">from MMSA import MMSA_run</span></span>
<span style="background-color:#f8f8f8"><span style="color:#333333"><span style="color:#aa5500"># run LMF on MOSI with default hyper parameters</span>
MMSA_run(<span style="color:#aa1111">'tfr_net'</span>, <span style="color:#aa1111">'mosi'</span>, <span style="color:#0000ff">seeds</span><span style="color:#981a1a">=</span>[1111, <span style="color:#116644">1112</span>, <span style="color:#116644">1113</span>], <span style="color:#0000ff">is_tune</span><span style="color:#981a1a">=</span>False, <span style="color:#0000ff">gpu_ids</span><span style="color:#981a1a">=</span>[0], <span style="color:#0000ff">config_file</span><span style="color:#981a1a">=</span><span style="color:#aa1111">"../config/config_regression.json"</span>,
         <span style="color:#0000ff">model_save_dir</span><span style="color:#981a1a">=</span><span style="color:#aa1111">"../saved_models"</span>, <span style="color:#0000ff">res_save_dir</span><span style="color:#981a1a">=</span><span style="color:#aa1111">"../saved_results"</span>)</span></span>

运行过程

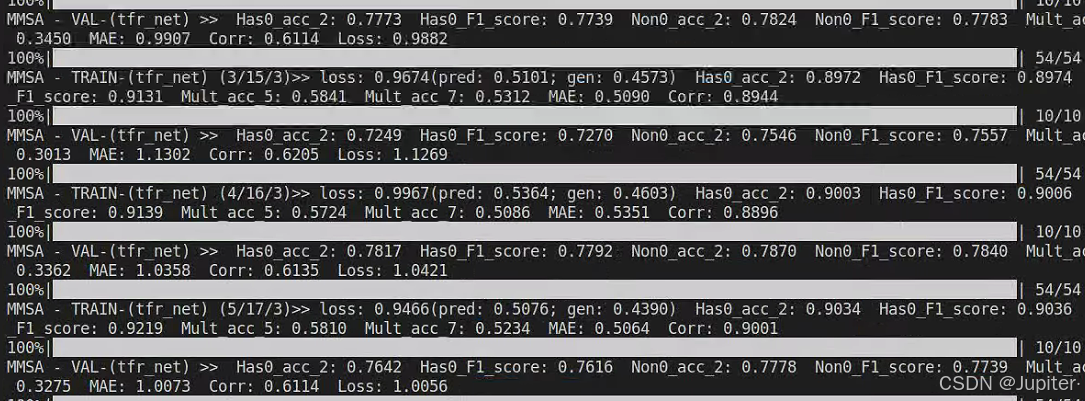
训练过程 在这里插入图片描述​ 最终结果 在这里插入图片描述​

需要本文的详细复现过程的项目源码、数据和预训练好的模型可从该地址处获取完整版:地址

 ​​​

希望对你有帮助!加油!

若您认为本文内容有益,请不吝赐予赞同并订阅,以便持续接收有价值的信息。衷心感谢您的关注和支持!

多模态大模型RL微调防退化:纠偏思维链设计与实践 在强化学习(RL)微调多模态大模型时,模型常会利用语言先验走捷径,导致思维链坍塌、奖励黑客等隐蔽的退化问题。纠偏思维链(Corrective CoT)通过Detect、Correct、Ground三阶段,将纠偏动作显式写入推理过程,迫使模型回归视觉证据,而非绕开图像蒙答案。这种训练范式不仅显著提升模型在换图扰动下的鲁棒性,还可迁移至纯文本推理、推理时校验及Agent决策审计等场景。Robust-R1正是这一思路的开源框架,为视觉语言模型的稳定微调提供了可落地的工程参考,帮助开发者摆脱“越调越歪”的困境。 阅读详情

相关推荐

多模态大模型性能衰退解决方案:Robust-R1框架解析

在AI推理过程中,模型性能衰退是影响多模态大模型稳定性的关键挑战,尤其在长序列任务中表现更为明显。Robust-R1框架通过动态纠偏机制,实时监控隐藏状态向量并调整注意力分布,有效解决了这一问题。该框架结合了偏差检测、记忆回溯和权重修正三层结构,不仅提升了模型抗退化能力47%,还保持了较低的推理延迟和内存占用。适用于医疗诊断、工业质检等高要求场景,显著提升了AI系统的可靠性和持续性能。

weixin_42524499的博客 300

多模态情感分析——基于CMU-MOSI和CMU-MOSEI数据集(文末获取源码)

而且在视频中,由于口语的易变性以及伴随的手势和和声音,容易导致的模态内的动态不稳定。首先,采用早融合策略 将各模态特征进行拼接,然后将拼接的特征输入分类器中,并且每个模态的特征也单独输入 分类器中,最终得到所有组合的分类结果,并将所有分类结果进行晚融合策略。提出了一种新的模型Tensor Fusion Network(张量融合网络,TFN),TFN能够端到端地学习模态内和模态间的动态,采用一种新的多模态融合方法(张量融合)对模态间动态进行建模,模态内动态则通过三个模态嵌入子网络进行建模。

小嘤熊的博客 1万+

2024 TIP 论文 robust-ref-seg 复现过程

本篇是 2024 年 TIP 论文 Towards Robust Referring Image Segmentation 的复现过程。

F_Arisa的博客 1399

CMU-MOSEI数据集解读

分析人类多模态语言是 NLP 的一个新兴研究领域。本质上,人类交流是多模式(异类)、时间和异步的;它由异步协调序列形式的语言(单词)、视觉(表达)和声学(副语言)模态组成。从资源的角度来看,真正需要能够对多模态语言进行深入研究的大规模数据集。在本文中,我们介绍了 CMU Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI),这是迄今为止最大的情感分析和情感识别数据集。

weixin_44955407的博客 3385

【多模态缺失】IF-MMIN:EXPLOITING MODALITY-INVARIANT FEATURE FOR ROBUST MULTIMODAL EMOTION RECOGNITION

IF-MMIN:使用不变特征来弥补缺失的模态想象网络,包含两个新机制:①全模态场景下基于中心矩差异(CMD)距离的不变特征学习策略;②基于不变特征的想象模块(IF-IM)可以缓解缺失模态预测期间的模态间隙,从而提高多模态联合表示的鲁棒性。

Trae1ounG的博客 2308

26、多模态情感分析平台:M - SENA与Robust - MSA的综合解析

本文详细解析了两个多模态情感分析平台——M-SENA和Robust-MSA的功能与特点。M-SENA提供端到端的解决方案,涵盖数据管理、特征提取、模型训练与分析,为研究人员提供全面的模型开发与评估支持;而Robust-MSA专注于模态噪声模拟与防御,提升模型在现实复杂环境中的鲁棒性。两者结合可广泛应用于社交媒体分析、客户服务、智能教育等多个领域,推动多模态情感分析技术的发展。

rgv234567的博客 148

【人工智能】深度解析Robust 多模态模型

多模态情感计算数据集:CMU-MOSI: CMU-MOSI数据集是MSA研究中流行的基准数据集。该数据集是YouTube独白的集合,演讲者在其中表达他们对电影等主题的看法。MOSI共有93个视频,跨越89个远距离扬声器,包含2198个主观话语视频片段。这些话语被手动注释为[-3,3]之间的连续意见评分,其中-3/+3表示强烈的消极/积极情绪;CMU-MOSEI: CMU-MOSEI数据集是对MOSI的改进,具有更多的话语数量,样本,扬声器和主题的更大多样性。

smile_sundays的博客 1648

26、多模态情感分析平台:M - SENA 与 Robust - MSA 详解

本文详细介绍了两个面向多模态情感分析(MSA)研究的开源平台:M-SENA与Robust-MSA。M-SENA提供可靠的基准测试、丰富的模型分析工具(如中间结果、实时实例和泛化能力分析),支持GUI与Python API,助力模型评估与复现;Robust-MSA则专注于模态噪声对模型影响的研究,提供交互式噪声模拟与防御方法,增强模型在现实场景中的鲁棒性。两个平台共同推动MSA技术的发展,并在客户服务、市场调研、教育等领域具有广泛应用前景。未来平台将扩展更多模型、数据集及噪声处理能力,进一步提升多模态情感分析

pz8901234的博客 158

Robust 多模态模型:应对模态缺失的挑战

1. 多模态情感计算数据集:CMU-MOSI数据集是MSA研究中流行的基准数据集。该数据集是YouTube独白的集合,演讲者在其中表达他们对电影等主题的看法。MOSI共有93个视频,跨越89个远距离扬声器,包含2198个主观话语视频片段。这些话语被手动注释为[-3,3]之间的连续意见评分,其中-3/+3表示强烈的消极/积极情绪;CMU-MOSEI数据集是对MOSI的改进,具有更多的话语数量,样本,扬声器和主题的更大多样性。

博客之路,前途漫漫 1844

MultiModalSA:CMU-MOSEI的多模态情感分析架构

多模态 CMU-MOSEI的多模态情感分析体系结构。 描述 该信息库包含四种多模式体系结构以及用于CMU-MOSEI的情感分析的相关培训和测试功能。 在数据文件夹中,提供了转录和标签,以用于的标准培训,验证和测试语句。 可以通过以下链接下载BERT嵌入(文本模式),COVAREP功能(音频模式)和FACET功能(视频模式): BERT嵌入: ://drive.google.com/file/d/13y2xoO1YlDrJ4Be2X6kjtMzfRBs7tBRg/view?usp COVAREP: ://drive.google.com/file/d/1XpRN8xoEMKxubBHaNyEivgRbnVY2iazu/view usp sharing 脸部表情: ://drive.google.com/file/d/1BSjMfKm7FQM8n3HHG5Gn9-dTifULC

CMU-MOSEI数据集

CMU-MOSEI数据集是自然语言处理和人工智能领域的一个重要资源,主要用于情感分析的研究和应用。它是由卡内基梅隆大学(Carnegie Mellon University,简称CMU)的研究人员创建的,MOSEI是Multimodal Opinion, Sentiment, and Emotion Intensity的缩写,意味着该数据集包含了多模态的意见、情感和情感强度信息。 该数据集的独特之处在于它不仅包含了文本信息,还包括语音的音调、语速、强度等声音特征,以及视频中的面部表情和肢体动作等视觉信息。这种多模态的数据特性使得MOSEI成为研究者们进行深度学习和机器学习,特别是跨模态情感分析的理想选择。 MOSEI数据集覆盖了多种类型的情感表达,包括积极、消极、中性以及更细微的情绪差异。情感强度的量化也是其特色之一,数据集通过0到5的评分系统标记了情感的强度,使得研究者可以不仅仅研究情感的类别,还可以研究情感的强弱程度。 在数据集的构建过程中,研究人员录制了大量视频,然后邀请了专业的标注者对这些视频中的话语进行情感分析和评分。这个过程涉及到声音和视觉信号的自动检测以及语言内容的语义理解,对人工智能算法的识别能力和语义分析能力提出了挑战。 由于数据集的规模较大,并且涵盖了复杂的情感表达模式,它成为了人工智能领域内进行情感分析研究的重要基准数据集。研究者可以使用MOSEI进行单模态或多模态的情感分析任务,比如情感分类、情感强度预测、跨模态情感同步分析等。 使用MOSEI数据集进行研究时,研究者可以采用深度学习的最新技术,如卷积神经网络(CNN)、循环神经网络(RNN)、长短期记忆网络(LSTM)、Transformer模型等,来处理和分析文本、音频和视频数据。此外,多模态学习方法如early fusion、late fusion、以及多模态融合网络等也被广泛应用于处理MOSEI数据集,以期达到更好的情感分析效果。 MOSEI数据集的推出,极大促进了自然语言处理、计算机视觉和语音处理等多个领域的交叉融合研究。它不仅为研究情感分析的学者提供了宝贵的资源,也为开发更加智能和人性化的交互系统奠定了基础。通过这些研究,未来的机器人和智能助手将更加理解用户的情感状态,并作出更合适的反应。 随着人工智能技术的不断进步,CMU-MOSEI数据集也在不断更新和扩充,其在情感分析领域的重要性日益凸显,成为了推动该领域研究不断向前发展的关键力量。通过这个数据集,研究者们可以不断探索新的算法,以期达到更准确、更快速的情感识别和分析。

为AI装上“纠偏”思维链,开源框架Robust-R1显著提升多模态大模型抗退化能力

如今的多模态大语言模型(MLLMs)已经展现出令人惊叹的图像理解和推理能力,能够回答关于图片的问题、生成描述,甚至进行复杂的视觉推理。然而,一个长期存在的挑战是:。从原始图像出发,经过多阶段退化合成,再逐步生成“影响描述”“干净推理”“最终结论”,最后根据退化强度对推理链进行长度缩放。可以看到,经过SFT和RL优化后,模型不仅能给出更准确的答案,还能生成清晰、结构化的推理过程,同时避免冗余输出。团队首先构建了一个包含11K样本的数据集(基于A-OKVQA),为每张退化图像标注了完整的推理链,包含:。

Coovally_AI的博客 570

Unity3D Lua与C#的相互调用与性能剖析详解

在游戏开发中,经常会遇到Lua与C#之间的相互调用的情况。本文将详细介绍Unity3D中Lua与C#的相互调用的方式,并对其性能进行剖析。对惹,这里有一个游戏开发交流小组,希望大家可以点击进来一起交流一下开发经验呀!一、Lua与C#的相互调用方式Lua调用C#在Unity3D中,可以通过Lua调用C#的方式来实现Lua与C#的相互调用。具体步骤如下:(1)首先需要在Unity3D项目中导入Lua的相关库,例如tolua或者xlua。

weixin_49669470的博客 1215

Aligning Large Multi-Modal Model with Robust Instruction Tuning将大型多模态模型与稳健的指令调整相结合

尽管多模态任务取得了有希望的进展,但当前的大型多模态模型(LMM)很容易产生与相关图像和人类指令不一致的描述的幻觉。本文通过引入第一个大型且多样化的视觉指令调整数据集来解决这个问题,该数据集名为大规模鲁棒视觉(LRV)指令。我们的数据集由 GPT4 生成的 120k 视觉指令组成,涵盖 16 个具有开放式指令和答案的视觉和语言任务。与主要关注正面指令样本的现有研究不同,我们设计的包含正面和负面指令,以实现更稳健的视觉指令调整。我们的否定指令是在两个语义级别设计的:(i)不存在的元素操作和。

Mars_prime的博客 1734

从翼型到湍流:用生活化案例图解空气动力学核心概念(中英双语版)

本文通过飞机机翼、F1赛车、高尔夫球等生活化案例,图解空气动力学核心概念。深入浅出地解释了攻角如何产生升力、边界层与流动分离如何影响阻力、马赫数如何划分速度世界,以及涡流与湍流的特性与应用。文章还介绍了计算流体动力学(CFD)这一现代数字风洞工具,帮助读者直观理解这些塑造现代交通与运动设计的无形之力。

metaverse5vr的博客 477

Pluto SDR新手避坑指南:从环境配置到第一个MATLAB收发程序(附完整代码)

本文为Pluto SDR新手提供全面的避坑指南,从硬件连接到MATLAB环境配置,再到第一个信号收发程序的实现。详细介绍了驱动安装、常见问题排查以及关键参数设置,帮助用户快速上手软件定义无线电(SDR)技术,并附有完整代码示例。

weixin_33168937的博客 325

【多模态融合】Cross Modal Transformer: Towards Fast and Robust 3D Object Detection

多传感器融合在自动驾驶系统中展示了其巨大优势。不同的传感器通常能提供互补的信息。例如,摄像头以透视视角捕捉信息,图像中包含丰富的语义特征,而点云则提供更多的定位和几何信息。充分利用不同传感器有助于减少不确定性,从而进行准确和鲁棒的预测。 然而,由于不同模态的传感器数据在分布上的巨大差异,融合这些多模态数据一直是个挑战。当前的主流方法通常通过构建统一的鸟瞰图(BEV)表示来进行多模态特征融合,或通过查询令牌(Transformer架构)来实现多模态融合。

cjy_colorful0806的博客 3787

ANSYS命令流黑箱揭秘:流体渗透压力载荷的七种收敛优化策略

本文深入解析ANSYS Workbench中流体渗透压力载荷的七种收敛优化策略,重点探讨接触探测点迭代逻辑、PPCN阈值动态调整及FPAT参数优化等关键技术。通过命令流示例和实战技巧,帮助工程师有效解决流体与结构相互作用仿真中的收敛难题,提升计算效率和精度。

weixin_29274337的博客 524
上一篇: VRT_关于视频修复的模型
下一篇: MSA+抑郁症模型总结
Srlua小谢
Srlua小谢 优质创作者: 编程框架技术领域 优质创作者: 编程框架技术领域
博客等级 码龄4年 8963粉丝 332原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值