(ICLR-2024)TIME‑LLM:基于大语言模型重编程的时间序列预测

【时间序列预测+大语言模型】TIME-LLM: TIME SERIES FORECASTING BY REPROGRAMMING LARGE LANGUAGE MODELS 发表于。 阅读详情

论文内容:TIME-LLM 提出了一种无需微调大语言模型主体、即可用于时间序列预测的全新框架。通过将时间序列片段重编程为一组可被 LLM 理解的“文本原型”,并结合包含数据背景、任务指令与统计特征的 Prompt-as-Prefix 提示结构,模型成功激活了 LLM 的跨模态推理能力。实验表明,TIME-LLM 在长期、短期、少样本与零样本预测任务中均显著超越现有专用时间序列模型,在效率上又极其轻量,为构建通用、跨领域的时序预测模型提供了新的范式。

论文链接:https://arxiv.org/pdf/2310.01728

代码链接:https://github.com/KimMeen/Time-LLM

一、背景:为什么需要 TIME-LLM?

       时间序列预测是数据驱动决策的基石,广泛应用于能源负荷预测、交通流量、需求规划、气象与流行病建模等实际场景。尽管这些任务在工程上至关重要,现有的时间序列方法通常高度「任务专用」:为不同场景设计不同架构(例如 ARIMA、LSTM、各种 Transformer 变体),导致模型难以泛化到新领域、需要大量标注数据或昂贵的架构搜索与调参。TIME-LLM 的出发点正是为了解决这种依赖领域数据与专项设计的局限性,探索能否借助大语言模型(LLM)的通用性来做更通用、更数据高效的时间序列预测。

       大语言模型在自然语言处理领域表现出色:少量样例或零样例即可完成新任务(few-/zero-shot),并展现出强大的模式识别与推理能力。这些能力在理论上非常适合用于发现并利用时间序列中的复杂模式与高阶关系,从而有望突破传统时间序列模型的局限。论文指出,如果能够“对齐”时间序列与语言模态,就有可能把预测问题“翻译”为 LLM 能理解和推理的形式,从而把 LLM 当作一个通用的时序推理引擎来使用。

      然而,要把 LLM 用于时间序列也面临实质性挑战:

  1. 模态差异:时间序列是连续数值流,而 LLM 处理离散的词/标记(tokens)。如何把连续值表示为对模型有意义的离散信息是一大难点。
  2. 数值精度与表示问题:直接把数值“写成”自然语言(即把每个数变成字符串)会遇到高精度数值处理不敏感、不同模型生成数值 token 格式不一致、需要复杂后处理等问题。
  3. 资源与效率考量:直接微调用大模型代价高昂,若能在不改动主干模型的前提下复用其能力,将极大提高实用性与可部署性。

       基于上述动机与挑战,TIME-LLM 提出了一种“reprogramming(重编程)+ prompt-as-prefix(提示作前缀)”的思路:在不微调 LLM 主体的前提下,把时间序列通过一套轻量的输入变换(把时间片段映射到若干“文本原型”)和结构化提示转成 LLM 更容易处理的形式,以激活模型的迁移学习与推理能力,从而实现通用、数据高效且可跨域的时序预测。

二、论文创新点

      TIME-LLM 的核心创新在于:不修改、不微调 LLM 主干模型,却能让其成为一个强大的时间序列预测模型。论文提出了多项关键技术,使得 LLM 能够在连续数值领域展现少样本、零样本和跨域泛化能力。

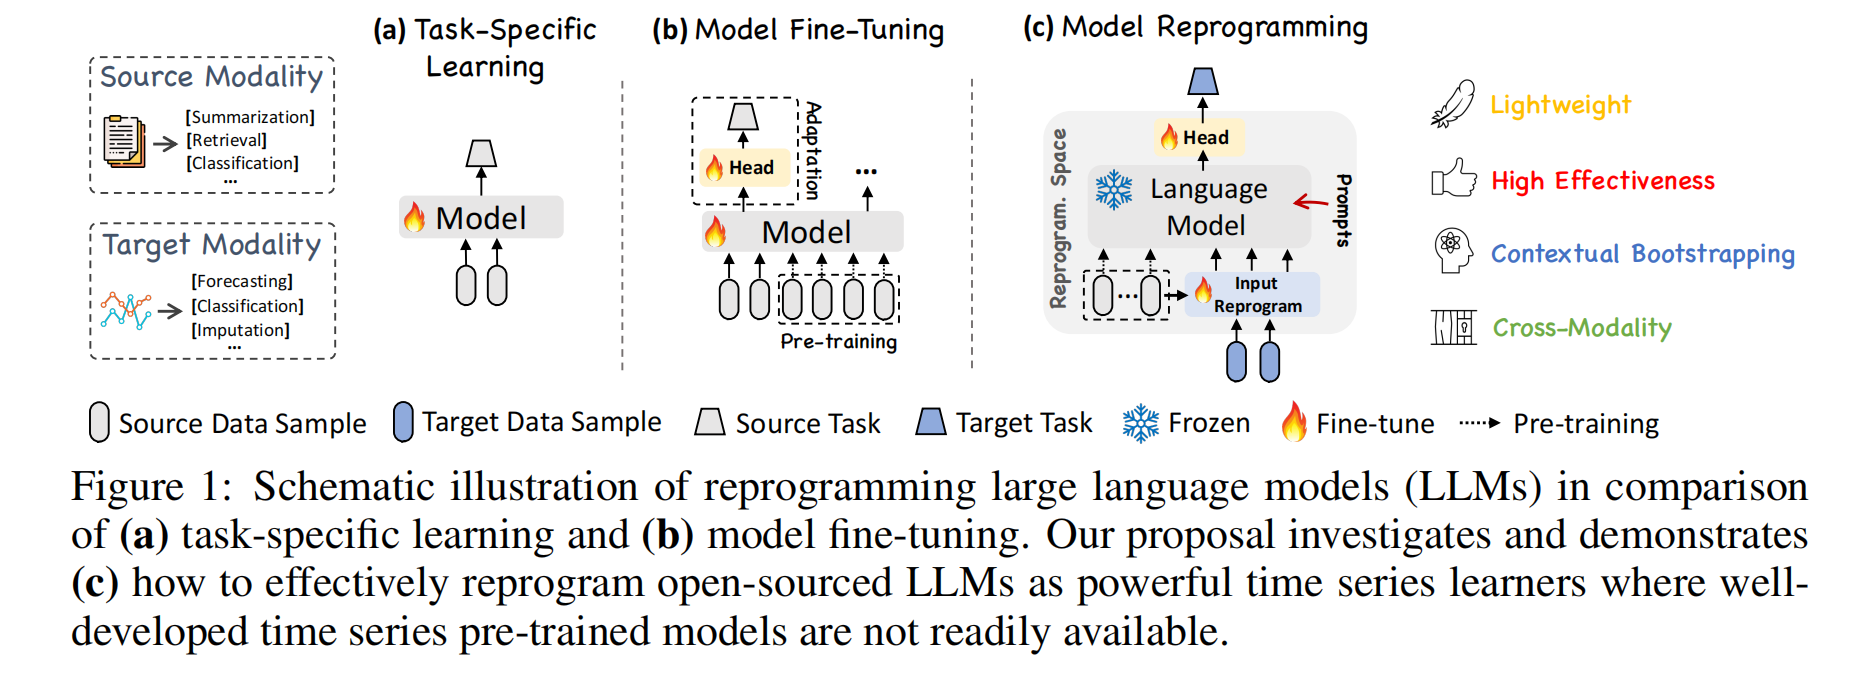
1. 将时间序列 Forecasting 视为“语言任务”的跨模态重编程(Reprogramming)

      传统做法需要为时间序列设计专用架构(如 Transformer、RNN、MLP 等),难以复用大模型的知识。TIME-LLM 首次提出:

通过重编程,把时间序列片段映射到 LLM 的词向量空间,使 LLM 能直接处理时间序列。

      它不改变 LLM 内部结构,是一种“让时间序列适应 LLM”的新范式,非常高效且低成本。
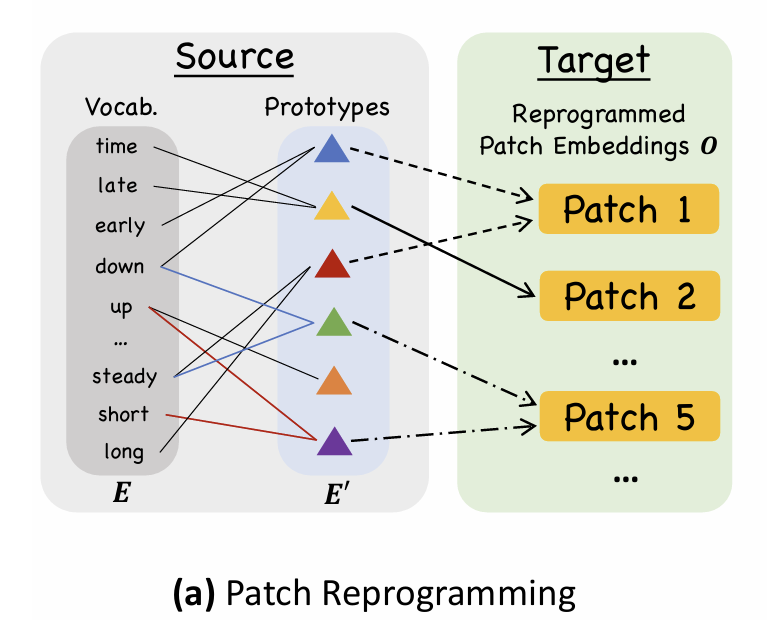
2. Patch Reprogramming:用“文本原型(Text Prototypes)”表示时间序列片段

     连续数值序列无法直接输入 LLM。论文创新地提出:

  • 将时间序列切分为 patch(类似 vision patch)

  • 引入少量可学习的 text prototypes(来自 LLM 词向量空间)

  • 通过 cross-attention,将 patch 重编程为这些原型的组合

     这样,LLM 看到的不是生硬数字,而是与其训练语境相近的“伪文本语义”,从而能利用语言知识推理时间结构。
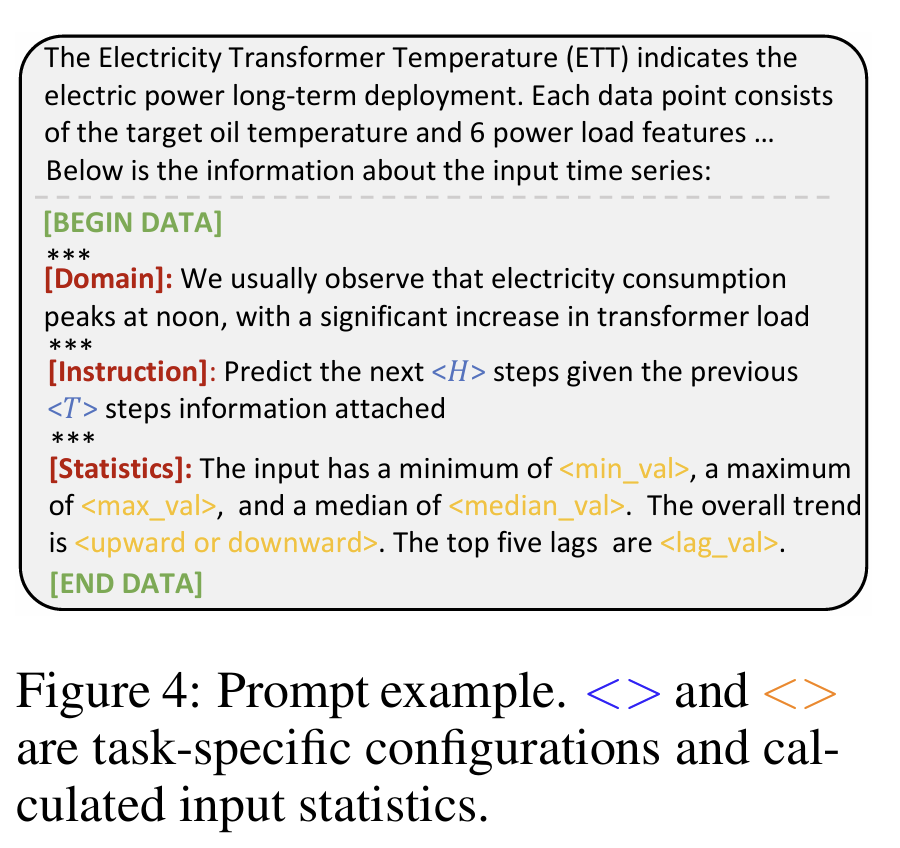
3. Prompt-as-Prefix(PaP):通过结构化提示增强 LLM 的时序推理能力

       不同于 simply prompting(把数字写成自然语言),TIME-LLM 采用:

把提示作为前缀 embedding 与 patch 一起输入,让 LLM 在语义上“理解”数据背景与任务。

提示中包括:

  • 数据集背景(如 ETT 数据的物理含义)

  • 任务说明(如“预测未来 H 步”)

  • 输入统计信息(趋势、最大值、最小值、重要滞后项)

这一结构极大提升了模型的跨域预测和少样本推理能力。
三、模型整体流程介绍
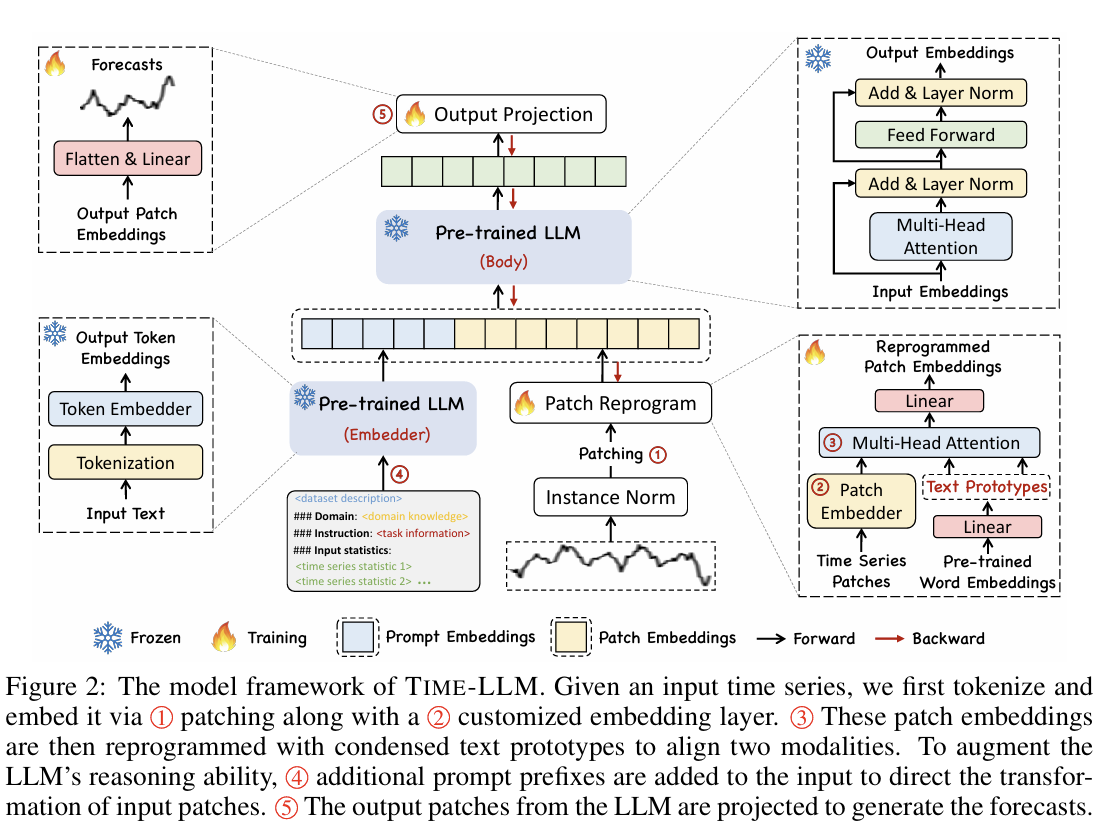
       TIME-LLM 的整体架构如上图所示,整个流程可以分为四个阶段:输入预处理 → Patch Reprogramming → Prompt-as-Prefix → 冻结 LLM + 输出投影。核心思想是:“用轻量模块把时间序列转换成 LLM 能理解的形式,再让冻结的 LLM 去做推理”。

1. 输入时间序列预处理(Linear Norm + Patch 切分)

       首先对原始时间序列做线做线性归一化,使不同尺度的数值变得可比较。然后将序列按窗口切分成多个连续 patch,每个 patch 含有固定长度的时间片段。

       这样处理的目的是将连续的时间序列分成多个局部子结构,与图像划分 patch 的思想类似,让模型更容易捕捉局部趋势与模式。

2. Patch Reprogramming:将数值 patch 对齐到 LLM 的词向量空间

      这是 TIME-LLM 最核心的部分。每个数值 patch 不直接送入 LLM,而是经过三步转换:

  1. Patch Embedding
    将 patch 映射为向量表示。

  2. Text Prototypes(可学习的文本原型)
    网络中维护一组可学习的 prototype(来自 LLM 词向量空间)。
    这些原型可理解为“伪文本语义单元”。

  3. Cross-Attention 重编程
    patch embedding 作 query,text prototypes 作 key/value,
    通过 cross-attention,patch 被表示为这些原型的加权组合。

    最终输出的是包含“文本语义”的时序 embedding,使 LLM 能够“读懂”时间序列。

3. Prompt-as-Prefix(PaP):为 LLM 提供结构化语义先验

    在输入 patch 之前,TIME-LLM 还会插入一个专门设计的 语义前缀(prefix),由 Prompt Encoder 生成。

     Prompt 内容包括:

  • 数据集背景(dataset context)

  • 任务描述(task instruction)

  • 输入序列统计信息(最大值、最小值、趋势、滞后特征等)

    这些前缀以“embedding”的形式接入 LLM 的输入序列,不通过自然语言 token,使提示更稳定、可控。作用是让 LLM 明确:“现在要做的是时间序列预测任务,需要理解局部趋势、周期模式等结构。”

4. 冻结 LLM 主体进行推理(Forward Pass Only)

       经过重编程后的 patch embedding 和 prefix 一起送入 LLaMA(或其他 LLM)中。LLM 主体保持完全冻结,不更新任何权重。LLM 负责根据上下文关系与提示内容进行“跨模态推理”。它不“懂数字”,但能“懂语义化的模式”。

      这种做法带来的好处包括:

  • 训练成本极低

  • 几乎不需要额外显存

  • 迁移性强,适合跨领域预测

5. Output Projection:把 LLM 输出重新映射为预测值

     LLM 输出的是语言向量,需要经过一个 projection head 将其映射回数值:,

这里仅更新这一小部分参数,因此训练非常轻量,最终得到的结果就是未来 H 步的预测值。

四、实验

        TIME-LLM 的实验部分系统地验证了模型在 长期预测、短期预测、少样本(few-shot)、零样本(zero-shot)、跨域泛化以及效率 等多个维度的性能。总体而言,TIME-LLM 在绝大多数任务上都显著超越传统时间序列模型与现有基于大模型的方法(如 GPT4TS),并凭借极少的可训练参数展现出优异的效率表现。

1. 实验设置:数据集与任务场景

    论文涵盖多个主流时间序列基准数据集,包括:

  • ETT 系列(ETTh1/ETTh2/ETTm1/ETTm2):电力变压器温度

  • Electricity、Traffic、Weather:多变量长序列预测常用数据集

  • Exchange-Rate、ILI:金融与流行病领域

     时间序列规模与特性各不相同,有的强趋势、有的强季节性,体现预测场景多样性。

     评价任务包括:

  • Multivariate Long-Term Forecasting(多变量长期预测)

  • Few-Shot Learning(5%/10% 训练数据)

  • Zero-Shot Forecasting(跨数据集预测)

  • Cross-domain Generalization(跨领域泛化)

2. 长期预测:全面领先现有 SOTA 模型

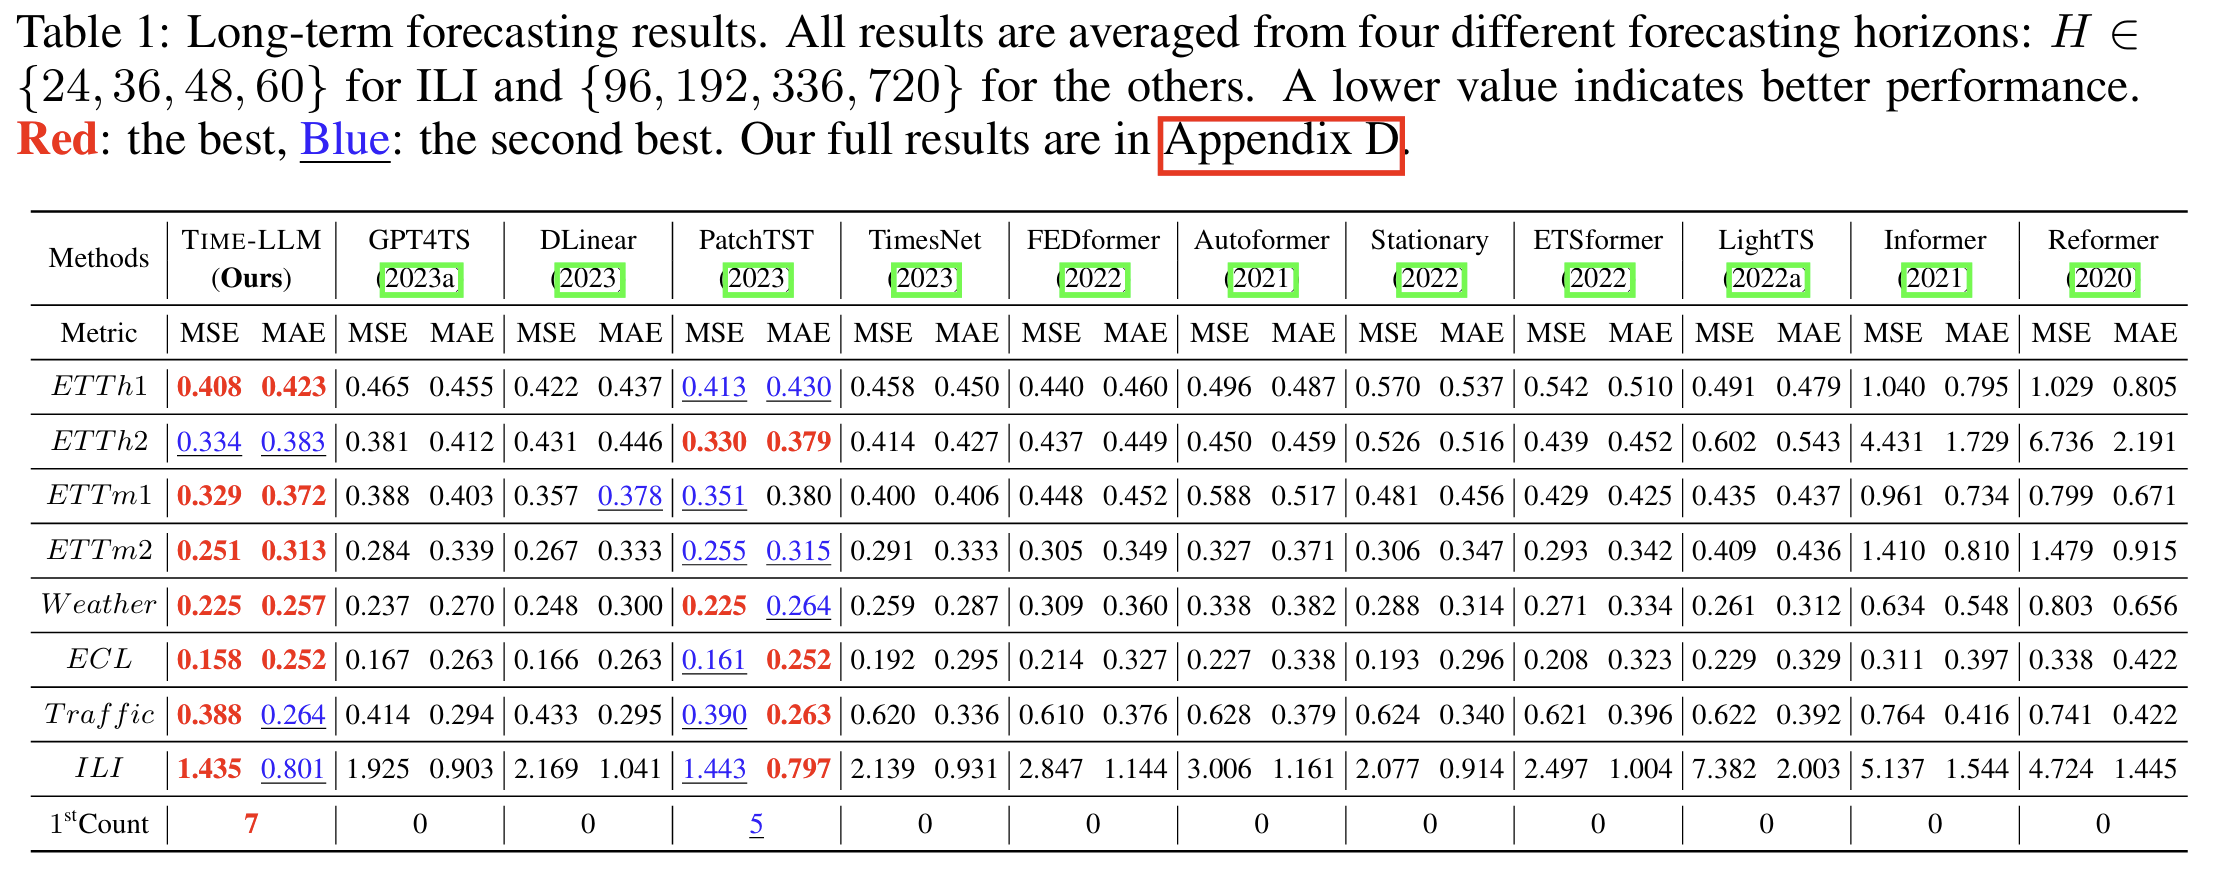
      在所有四个 ETT 数据集以及 Electricity、Weather、Traffic 等数据集上,TIME-LLM 在 96 / 192 / 336 / 720 步预测中都获得了最优或近似最优结果。

     与强竞争对手相比:

  • 比 PatchTST 更稳定、平均误差更低

  • 比 TimesNet、FEDformer、DLinear 等 Transformer 系列提高显著

  • 在复杂多变量场景(如 Electricity、Weather)优势更大

实验表明,TIME-LLM 在不微调 LLM 的前提下,仍能捕捉序列的长期结构与模式。
3. 短期预测:在局部模式学习上与专用模型竞争

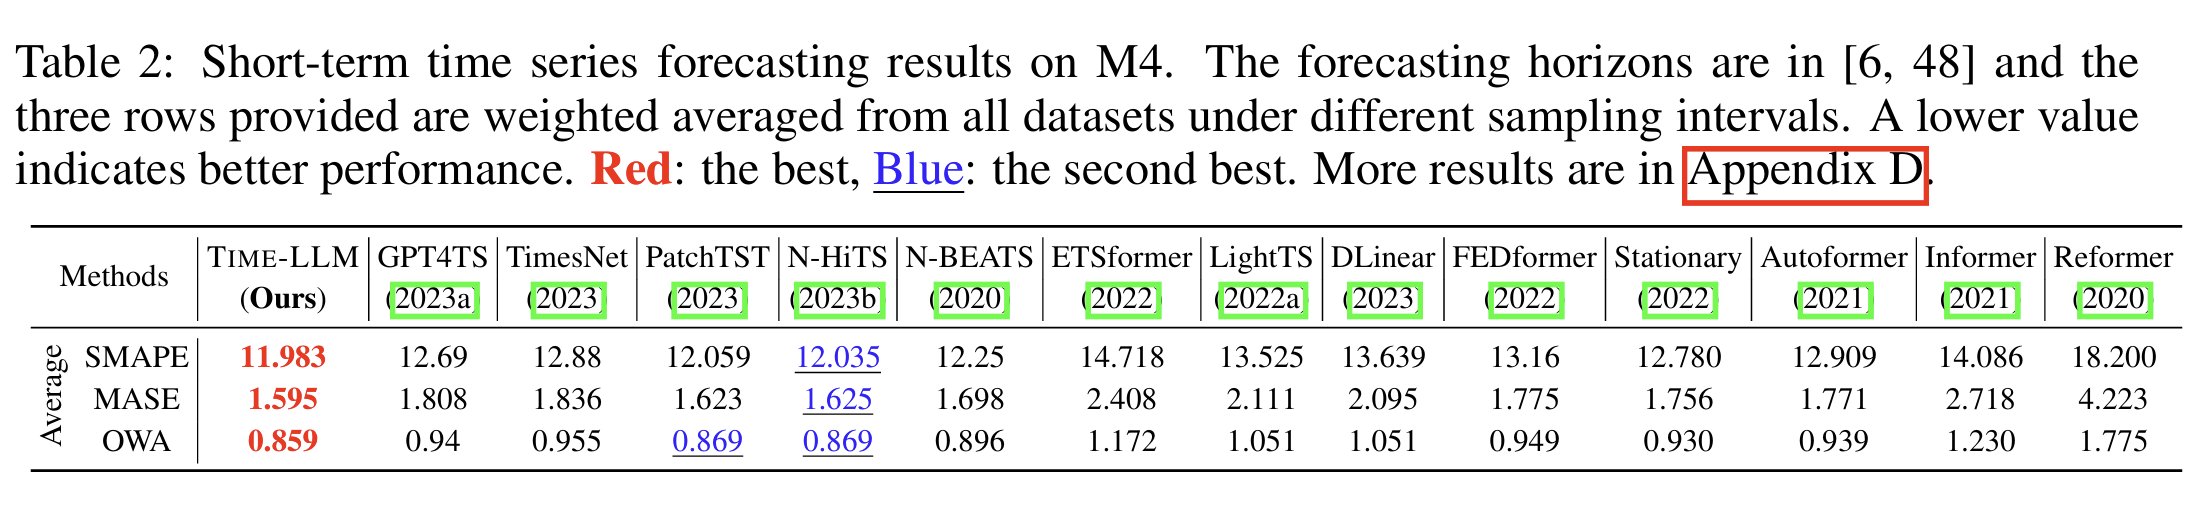
       在短期预测(如 24、36 步)中,TIME-LLM 仍能保持与专门为短序列设计的模型相近或更优的性能。这表明其重编程结构可以适应不同长度范围的时序结构。
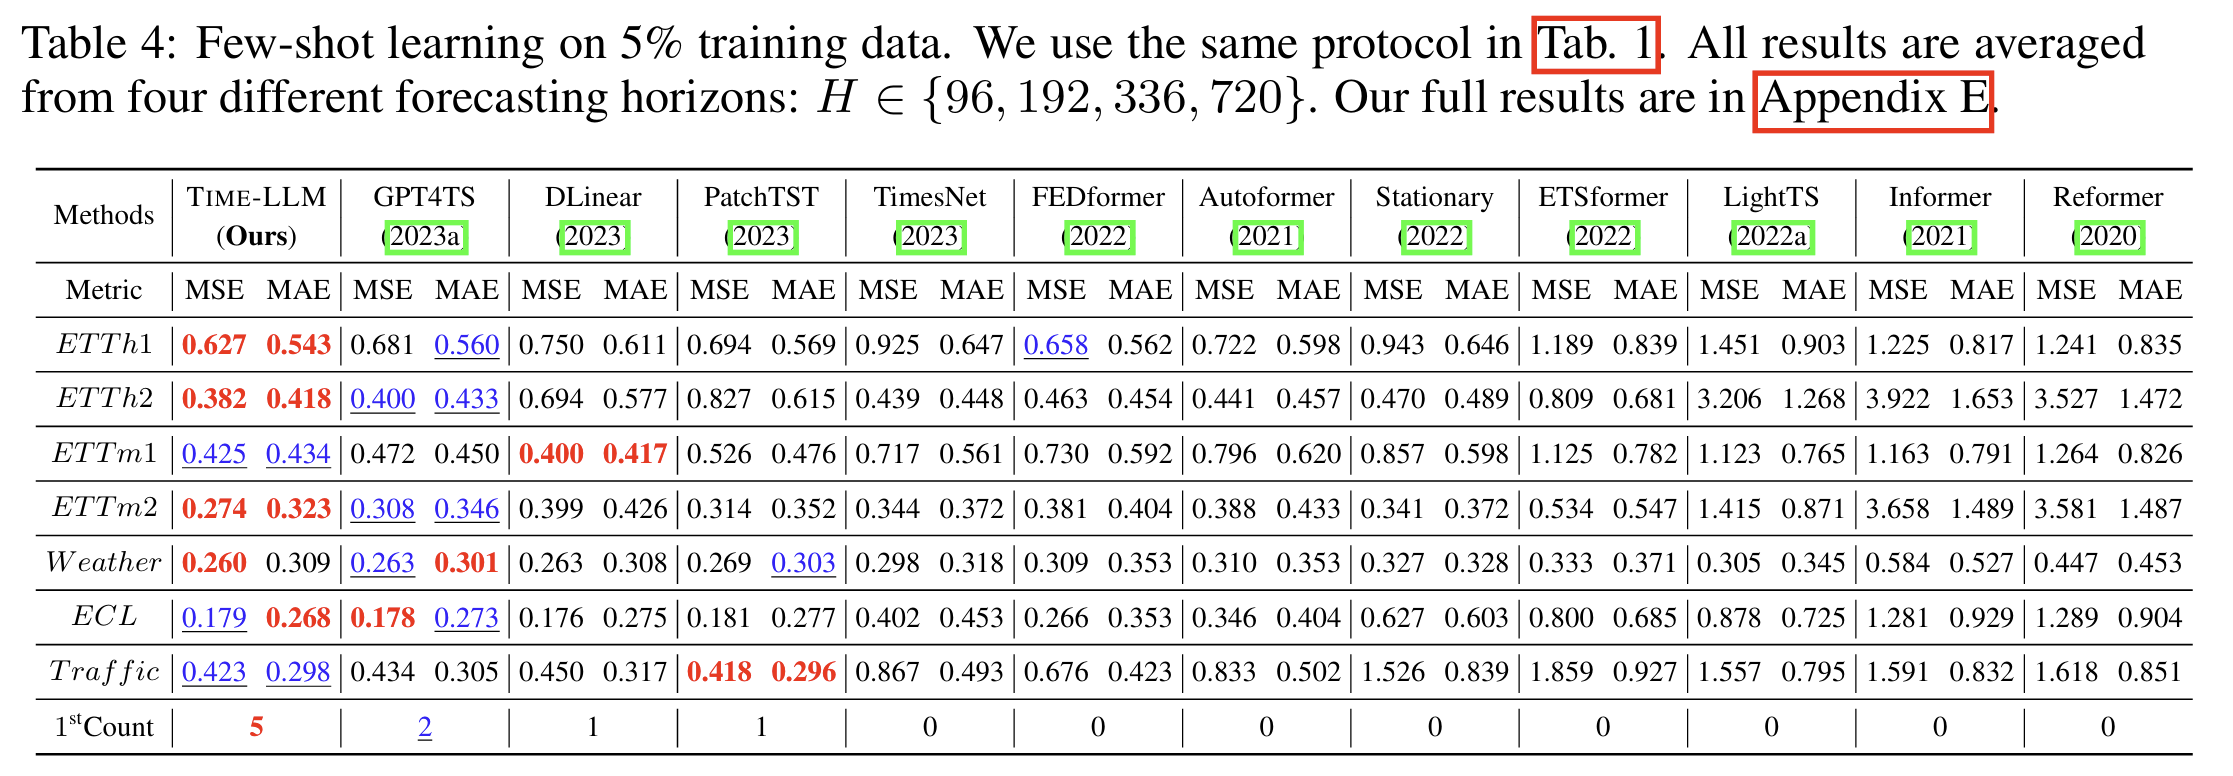
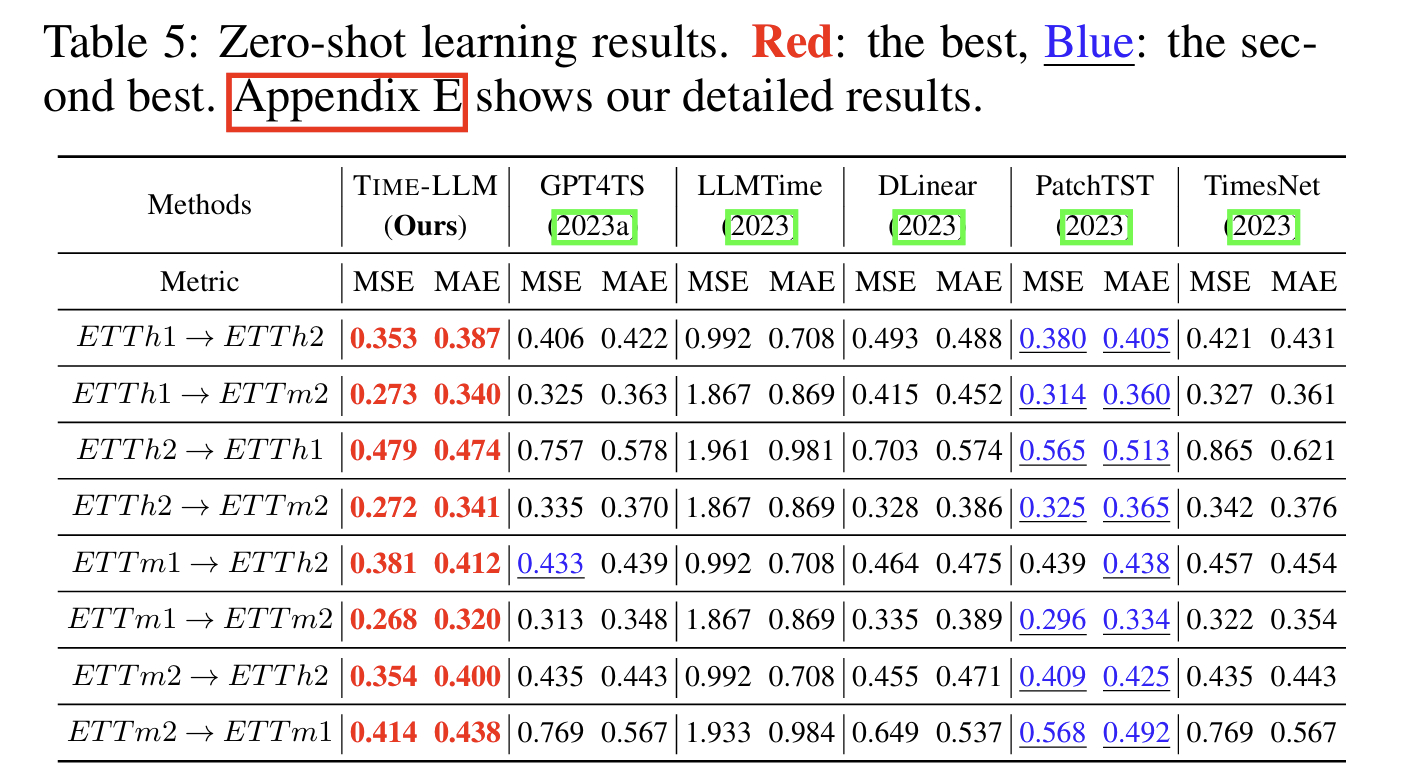
4. Few-Shot 学习(5%/10% 数据):显著优于 GPT4TS 与传统模型

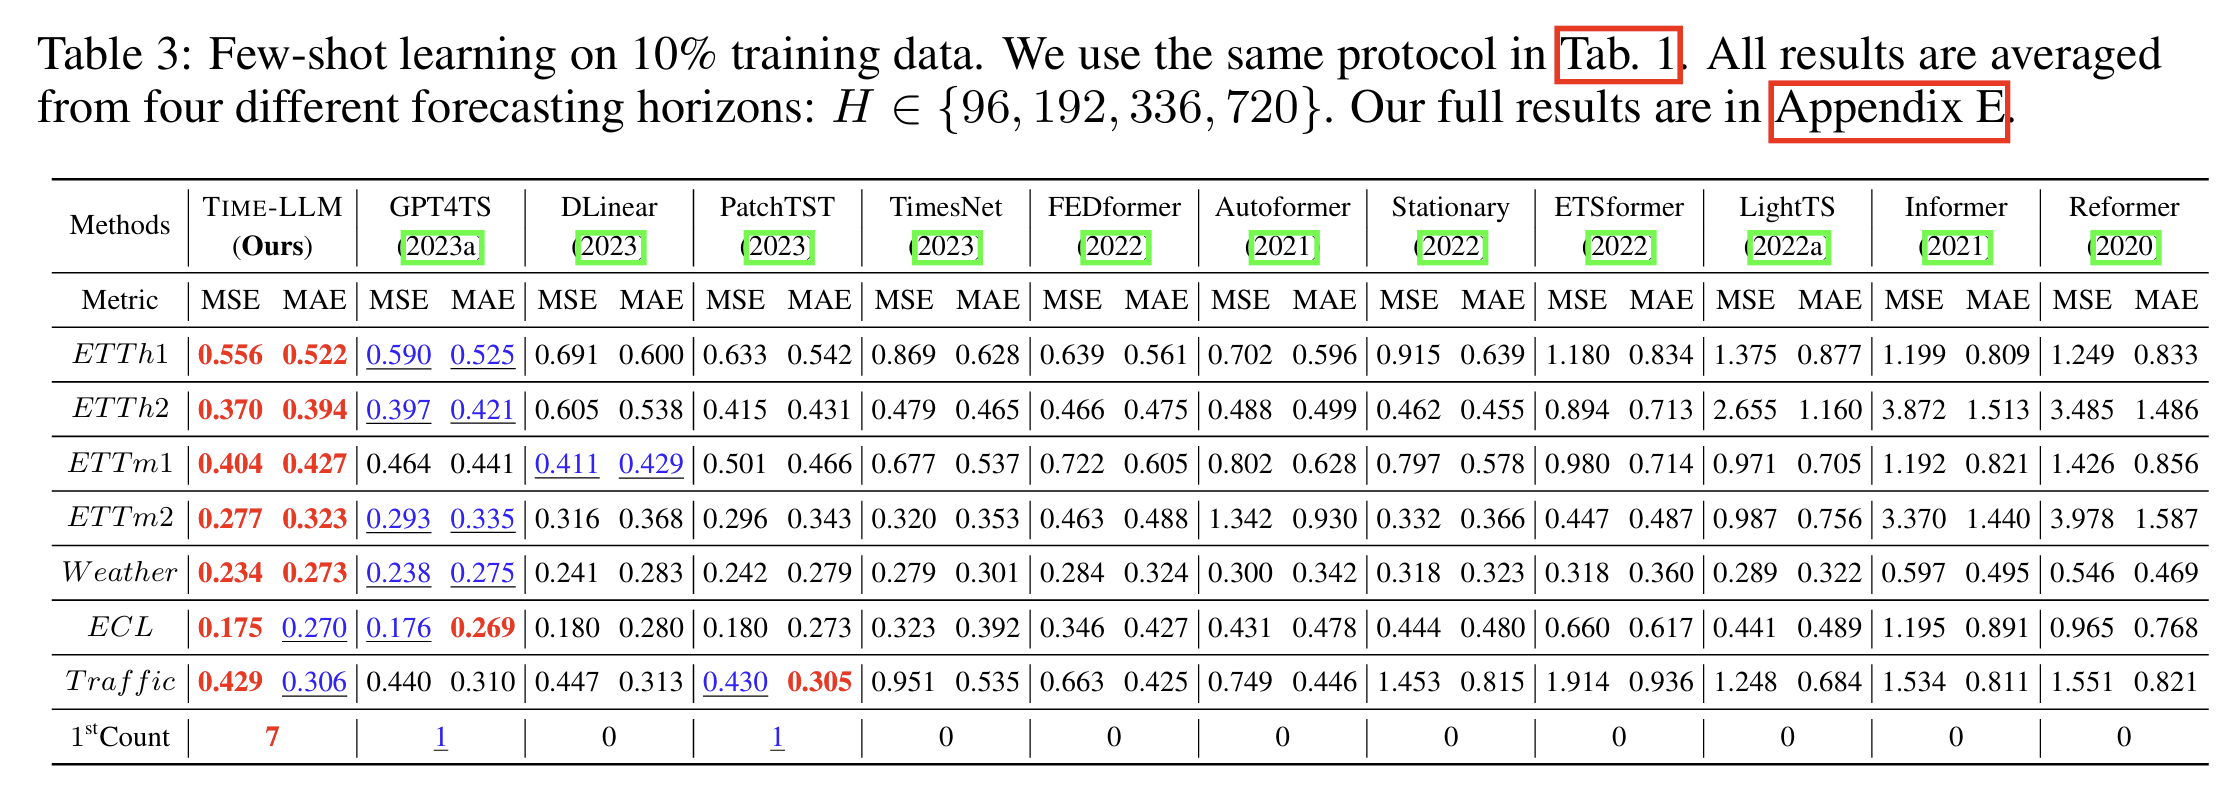
     少样本预测是 TIME-LLM 的强项之一。实验发现:

  • 仅使用 5% 的训练数据,TIME-LLM 仍明显优于 GPT4TS、PatchTST、TimesNet

  • 在 10% 数据场景中性能几乎与全数据训练持平甚至更好

  • 说明 LLM 的“语义先验”确实被激活,并能用极少数据完成适配

     这类实验验证了 TIME-LLM 的 数据效率(data efficiency) 优势。
5. Zero-Shot(跨数据集)预测:TIME-LLM 的能力跃迁点

TIME-LLM 在 训练于 A 数据集 → 直接预测 B 数据集 的场景中:

  • 零样本性能比第二名(通常是 GPT4TS)平均提升 14%–20%

  • 在跨领域任务(如 Weather → ETT)中仍保持稳定预测能力

  • PatchASprefixprefixprefix、StatPrompt 等 prompting 方法明显不如 TIME-LLM

这表明:

通过重编程,LLM 的跨模态知识被成功迁移到时间序列任务中。
6. 消融实验:每个模块都带来明显提升

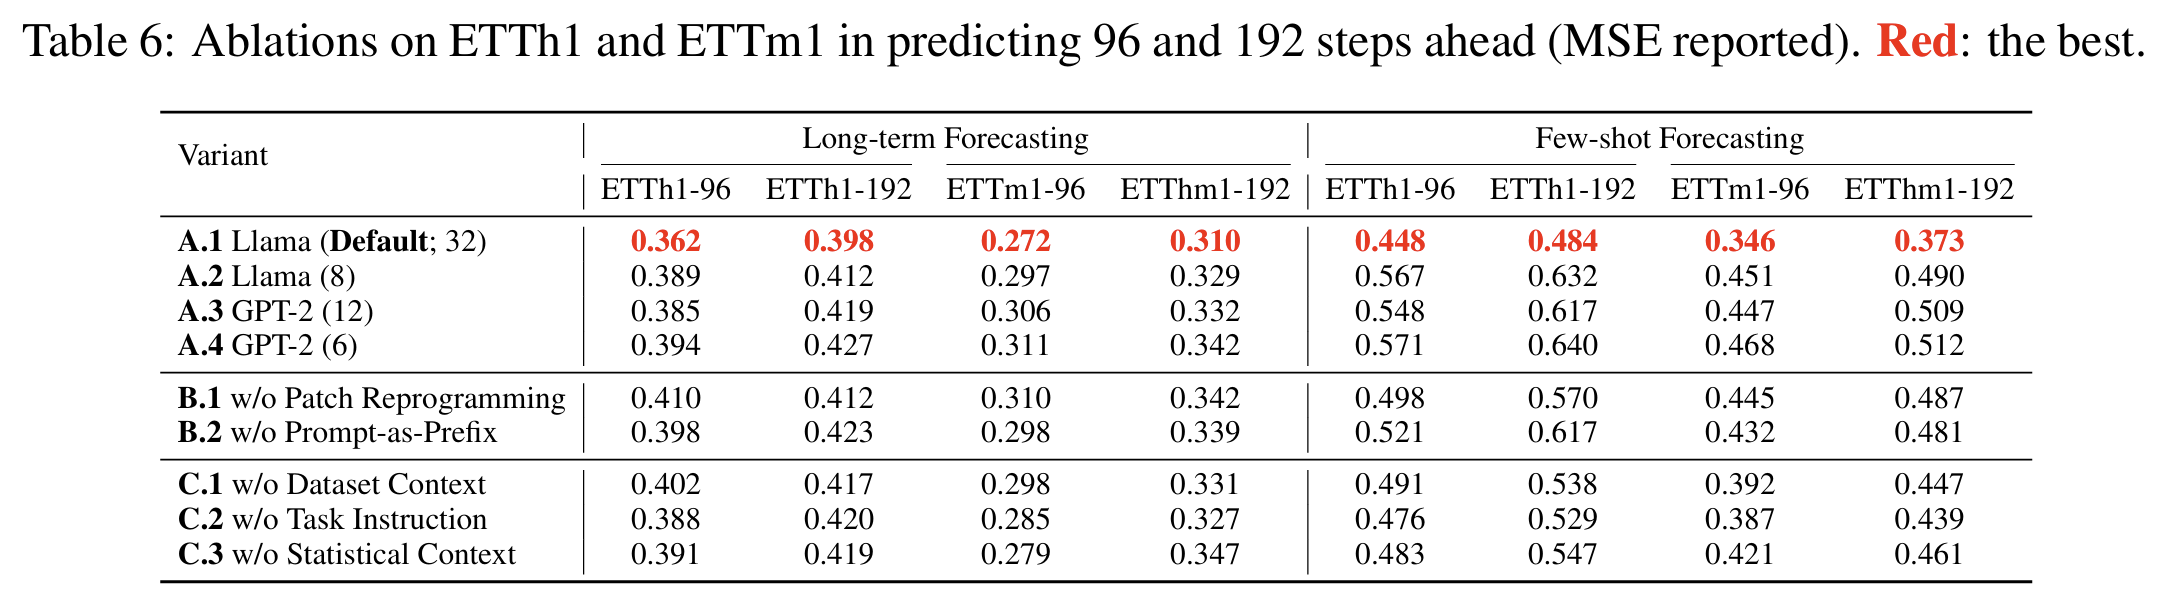
    论文通过消融验证如下:

  • 去掉 Patch Reprogramming → 性能显著下降
    因为 LLM 无法理解未对齐的连续值表示。

  • 去掉 Prompt-as-Prefix → zero-shot 性能明显变差
    表明语义提示对跨域适应至关重要。

  • 去掉 normalization → 长期预测精度下降

    这些实验说明了每个模块都在 TIME-LLM 中发挥关键作用。
7. 模型效率:训练参数仅占 LLM 的 0.2%

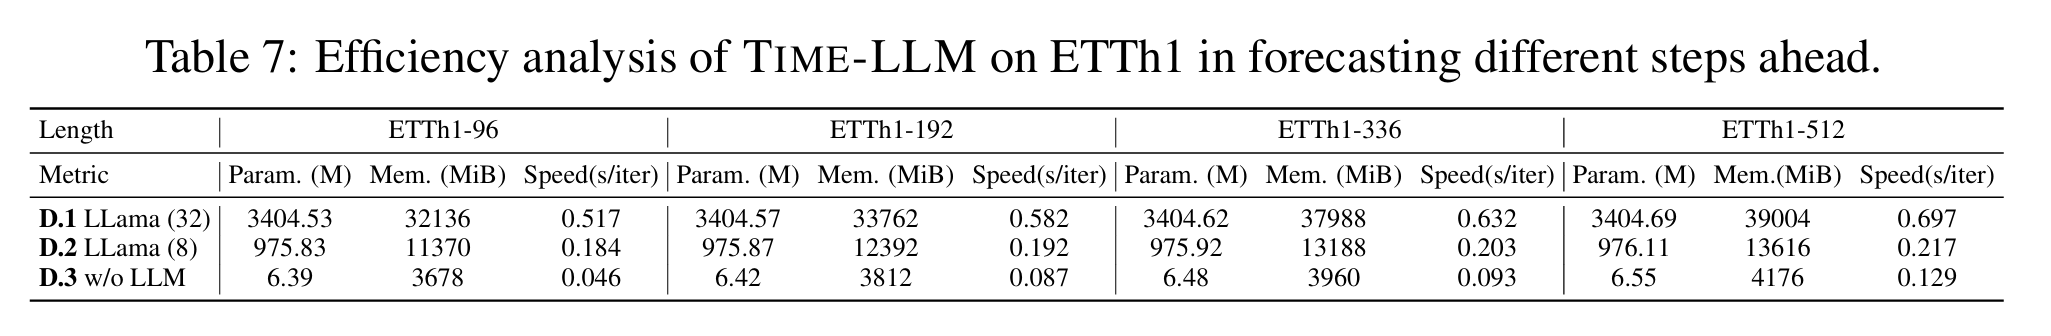
    TIME-LLM 仅训练:

  • Patch embedding(极小规模)

  • Reprogramming cross-attention(小规模参数)

  • Output projection(线性层)

  • Prompt encoder(轻量)

    总参数量约为 6M,对比:

  • GPT4TS:需要微调 LLM 的部分层,成本高数十倍

  • 其他 LLM 方法:需要更大训练资源或更复杂预处理

    其显存占用与训练速度在表中显著优于微调类方法。
五、可解释性: text prototypes 的可视化

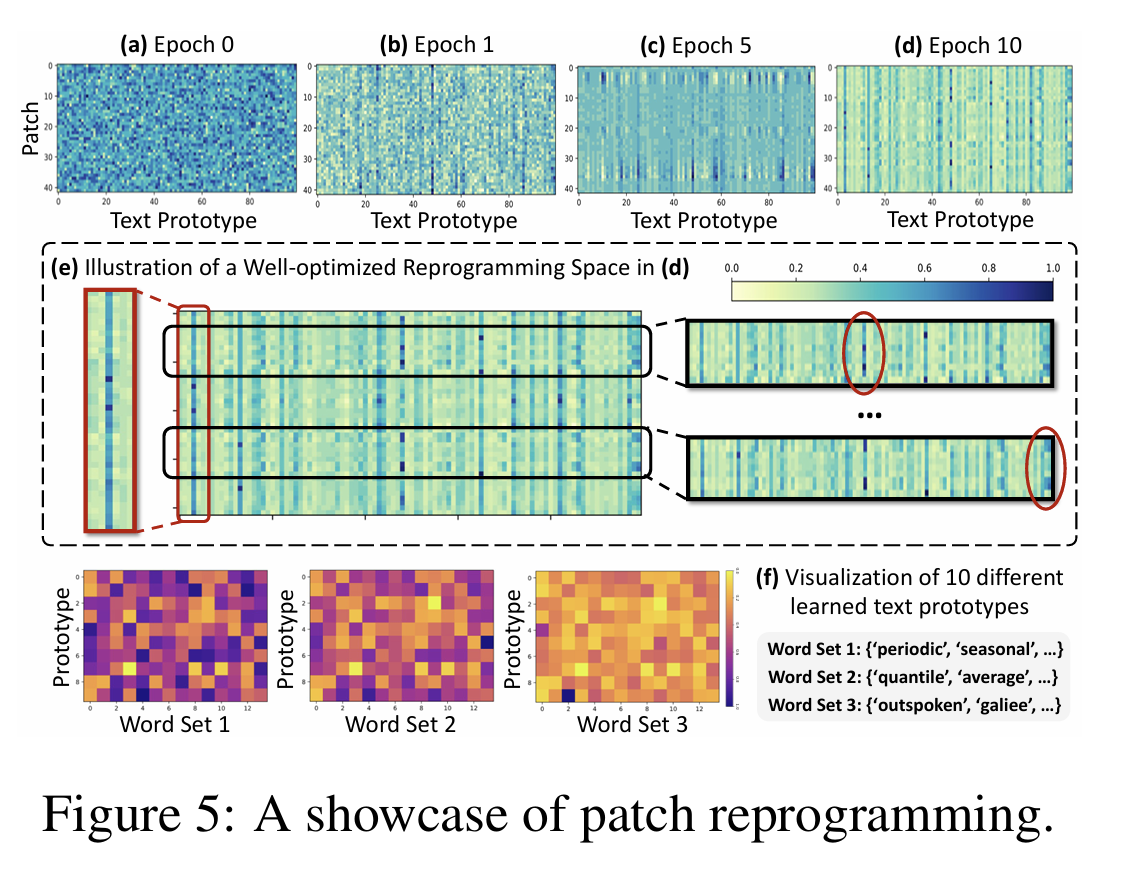
      尽管 TIME-LLM 使用了大语言模型作为核心推理单元,但其重编程结构(Patch Reprogramming)让输入的时间序列与 LLM 词向量空间产生了明确的对应关系。因此,模型具备了良好的可解释性,尤其体现在 text prototypes(文本原型) 的使用模式上。

     论文通过可视化这些原型的激活情况,揭示了两个关键发现:
1. 大多数原型保持“未激活”,只有少数成为关键语义单元

       模型中包含多组 text prototypes,它们本质上是可学习的向量,来自 LLM 的词向量空间。但实验发现:

  • 大部分 prototypes 在预测任务中很少被使用

  • 只有 极少数 prototypes 高频参与 patch 的重编程

     这说明模型会自动选择最有用的“语义基元”,而不是平均分配注意力。这种稀疏激活(sparse activation)非常符合 LLM 在 NLP 中的工作方式。

2. 被激活的 prototypes 对应“可解释的时间序列语义”

     论文进一步分析发现,最常被激活的几个 prototypes 与一些时间序列特征高度相关,例如:

  • periodic(周期性)

  • seasonal(季节性波动)

  • average / trend(平均值或趋势变化)

  • local variation(局部波动)

     也就是说,模型实际上学会了:

用语言语义来表达时间序列的结构模式。

      这是 TIME-LLM 最大的跨模态亮点之一——时间序列经过重编程后,在 LLM 中被当作“语言意义上的结构”来处理,这使得模型能够利用其庞大的语义知识库进行推理。

3. Patch 与 Prototypes 的匹配模式具有一致性和可解释性

     可视化结果显示:

  • 相似的时间片段(patch)倾向激活相同或相似的 prototypes
    → 表明模型真正学到了局部结构之间的相似性。

  • 在预测具有特定周期或趋势的数据集(如 ETT)时,某些 prototypes 激活频率明显增加
    → 说明模型能够适应数据的宏观结构。

     这种“一致的激活规律”使得 TIME-LLM 的预测不仅是黑盒输出,而是具备可追踪、可解释的内部机制。

六、总结与展望

       TIME-LLM 提出了一种全新的时间序列预测范式:通过跨模态重编程,让冻结的大语言模型在不进行微调的前提下,也能高效完成数值预测任务。 不同于以往需要大量数据和复杂模型设计的传统方法,TIME-LLM 充分利用了 LLM 强大的泛化能力、语义推理能力与参数规模优势,并通过轻量的 patch reprogramming 与 Prompt-as-Prefix 高效桥接了数值模态与语言模态。

       从实验结果看,TIME-LLM 在长期预测、少样本学习、零样本预测、跨域泛化与效率等方面均展现出显著优势,甚至超越大量精心设计的时间序列 SOTA 模型与基于大模型的 GPT4TS。在真实场景中,这意味着未来的预测系统可以借助 LLM 的通用语义知识,以极高的数据效率和良好的迁移性完成复杂任务。

       然而,TIME-LLM 也为未来研究打开了新的问题与空间:

1. 更强的跨模态重编程

当前的 text prototypes 机制有效但仍然依赖 LLM 词向量空间,未来可以探索:

  • 更精细的时间—语言对齐方式

  • 自适应生成原型,而非固定原型集合

  • 针对不同类型时间序列(如稀疏、异常、异构)的特定 reprogramming 方法

2. 利用 LLM 知识进一步增强时间序列理解

Prompt-as-Prefix 已证明有效,但仍可发展:

  • 注入领域知识(如交通、气象、能源的物理规律)

  • 结构化的长期先验(如周期性模型)

  • 多层级多模态提示结构(语言 + 图表 + 数值统计)

3. 超越预测任务,扩展到更多时序应用

当前 TIME-LLM 主要用于 forecasting,未来可以扩展到:

  • 异常检测(anomaly detection)

  • 时序分类(sequence classification)

  • 时序填补(imputation)

  • 因果推断、事件预测等更复杂任务

视觉特征-自监督-掩码特征预测【2026-03】:V-JEPA2.1【2B】【全Token稠密预测损失】【多层深度自监督】【图像/视频多模态Tokenizer】【160万小时视频】【1.42亿张图像】 Lorenzo Mur-Labadia1,2,∗, Matthew Muckley1, Amir Bar1, Mido Assran1, Koustuv Sinha1, Mike Rabbat1, Yann LeCun1, Nicolas Ballas1,†, Adrien Bardes1,†1FAIR at Meta, 2Universidad de Zaragoza ∗Work done at Meta, †Joint last authorWe present V-JEPA 2.1, a family 阅读详情

相关推荐

TIME-LLM: TIME SERIES FORECASTING BY REPROGRAMMING LARGE LANGUAGE MODELS

时间序列预测在许多现实世界的动态系统中具有重要意义,并得到了广泛的研究。与自然语言处理(NLP)和计算机视觉(CV)不同,单个大型模型可以处理多个任务,时间序列预测模型通常是专门的,需要针对不同的任务和应用进行不同的设计。虽然预训练的基础模型在NLP和CV领域取得了令人印象深刻的进步,但它们在时间序列领域的发展受到数据稀疏性的限制。最近的研究表明,大型语言模型(llm)对复杂的符号序列具有强大的模式识别和推理能力。然而,挑战仍然存在,如何有效地将时间序列数据和自然语言的模式结合起来,以利用这些功能。

c_cpp_csharp的专栏 1772

Time-LLM:为时间序列预测重新编程LLM 探索Time-LLM的架构,并在Python中将其应用于预测项目

我们将探讨Time-LLM的架构以及它如何有效地使LLM能够预测时间序列数据。然后,我们将实现该模型并将其应用于一个小型预测项目。

数智笔记 1万+

Time-LLM:使用LLM 以进行时间序列预测

在本文中,我们探讨了 Time-LLM 的架构以及它如何有效地让 LLM 预测时间序列数据。然后,我们实现该模型并将其应用到一个小型预测项目中。

探索人工智能领域 1602

Time-LLM :超越了现有时间序列预测模型的学习器

Time-LLM 被展示为一个强大的时间序列学习器,其性能超越了现有的、专门的预测模型。输入补丁化:首先,将输入的时间序列数据分割成一系列“补丁”(patches),这些补丁是通过在时间序列上滑动窗口来创建的,每个补丁包含了一定数量的时间步长。实验与优化:在实践中,可能需要进行多次实验,调整模型参数,如补丁长度、步长、模型层数等,以及优化提示前缀的设计,来提高预测的准确性。解决方案:进行多次实验,调整模型参数,如补丁长度、步长、模型层数等,以及优化提示前缀的设计来提高预测的准确性。

2283

Mplus实战:三变量随机截距交叉滞后模型(RI-CLPM)语法详解与扩展

本文详细解析了Mplus中三变量随机截距交叉滞后模型(RI-CLPM)的构建原理与语法实现。通过将变量分解为稳定的个体间差异与动态的个体内波动,模型能更纯净地揭示多变量间的纵向交互影响。文章以工作压力、睡眠质量与工作满意度为例,提供了完整的语法模板、关键参数设置(如NOCOV命令、残差相关)及结果解读指南,帮助研究者避开常见误区,稳健分析复杂动态关系。

wdx0123456的博客 931

2025年度工业级3D全景相机技术解析选型参考:国产品牌的技术突围与市场格局

本文分析了工业级3D相机在智慧城市和建筑数字化中的应用。通过对比国内外主流设备的技术参数和应用场景,发现国产品牌如众趣科技在性价比和本地化服务方面具有优势,尤其适合大型空间扫描项目;而国际品牌如Faro、Leica则在精度和可靠性上保持领先。建议根据项目需求(如测距范围、精度要求、预算)进行设备选型,综合考虑扫描效率、数据处理能力和系统兼容性。国产品牌已在国内大型基建项目中展现出竞争力,国际品牌则更适合高精度逆向工程和国际化项目。

gxdtgsy的博客 1077

专业 英语

计算机、数学、机械等专业的专业英语词汇

Edward2022的博客 2954

DoubletFinder实战:如何优化参数提升scRNA-seq双细胞识别准确率?

本文深入探讨了如何通过优化DoubletFinder参数提升scRNA-seq双细胞识别准确率。详细解析了pK和nExp参数的影响机制,提供了系统化的参数优化流程和多样本整合策略,并结合真实数据集演示了验证方法与高级应用场景,帮助研究人员获得更可靠的分析结果。

weixin_28523493的博客 341

51c深度学习~合集7

我自己的原文哦~ https://blog.51cto.com/whaosoft/12464014通过对不同下游任务的task vectors进行简单的计算,组合得到的新参数(构成一个线性子空间),可以扩展出更多的使用场景。看到了一篇很有意思的paper,文章对预训练和finetune之后的模型参数之差(task vector = 两个weight按位相减)做了分析,发现了一些奇妙的用法:通过对不同下游任务的task vectors进行简单的计算,组合得到的新参数(构成一个线性子空间),可以扩展出更多的使

whaosoft~aiotの开发板商城 1621

从零构建安全通信:mbedtls与ECDSA在嵌入式系统中的实战指南

本文详细介绍了如何在嵌入式系统中使用mbedtls和ECDSA实现安全通信,重点探讨了ECDSA相比RSA的优势、mbedtls的模块化裁剪策略、密钥安全存储方案以及完整的签名验签流程。通过实战案例和优化技巧,帮助开发者在资源受限环境下构建高效可靠的安全通信系统。

weixin_28338005的博客 685

Python在Windows环境下驱动乐视三合一摄像头的深度图像处理实践

本文详细介绍了在Windows系统下,使用Python驱动乐视三合一摄像头进行深度图像处理的完整实践流程。从环境配置、驱动安装、OpenNI与OpenCV库的部署,到深度与彩色数据流的读取、可视化、三维点云转换以及背景移除等应用开发,为开发者提供了从零开始掌握深度摄像头编程的实战指南。

gitlab7runner的博客 235

TIME-LLM 详解:如何用大语言模型预测时间序列?

TIME-LLM 所解决的核心问题是如何在不微调语言模型本体的前提下,利用其强大的预训练能力完成通用的时间序列预测任务。我们将整个问题建模为一个典型的监督学习任务,其输入是一段历史的多变量时间序列,输出为未来一段时间的预测值。具体而言,给定一个输入矩阵X∈RN×TX∈RN×T,表示一个长度为TTT的时间序列,其中包含NNN个不同的一维变量(如温度、电量、访问量等),模型的目标是学习一个映射函数f⋅f(\cdot)f⋅,将历史观测序列X\mathbf{X}X。

weixin_46351593的博客 3821

Qwen-Image LoRA训练实战:从数据准备到异常修复的全流程解析

本文详细解析了Qwen-Image LoRA训练的全流程,从数据准备到参数优化再到异常修复。通过实战案例展示了如何利用LoRA技术微调Qwen-Image模型,提升中文场景下的图像生成质量,特别针对手脚生成异常等问题提供了有效解决方案。文章还分享了中文提示词优化技巧和高级训练方法,帮助开发者高效训练出高质量的LoRA模型。

lemon的博客 970

论文阅读 - TIME-LLM: TIME SERIES FORECASTING BY REPROGRAMMING LARGE LANGUAGE MODELS

时间序列预测在许多真实世界的动态系统中具有重要意义,并已得到广泛研究。与自然语言处理(NLP)和计算机视觉(CV)不同,在自然语言处理和计算机视觉中,一个大型模型可以处理多个任务,而时间序列预测模型往往是专门的,需要针对不同的任务和应用进行不同的去符号化。虽然预训练基础模型在 NLP 和 CV 领域取得了令人瞩目的进展,但它们在时间序列领域的发展却受到了数据稀缺性的限制。最近的研究表明,大型语言模型(LLM)对复杂的标记序列具有强大的模态识别和推理能力。然而,如何有效地。

qq_40671063的博客 7098

SAP PFCG 中的单一角色与复合角色

在 SAP 系统的安全与授权管理中,事务码 PFCG(角色维护)扮演着关键角色。理解单一角色(Single Role)和复合角色(Composite Role)的概念,对于有效地管理用户权限至关重要。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1482

YOLOv11改进 | 集成FEM、FFM与SCAM即插即用模块:特征增强、融合与空间上下文建模新范式

FEM解决特征表达不足问题,增强关键特征响应FFM优化多尺度融合,提升小目标检测精度SCAM建模空间上下文,改善目标交互预测在保持YOLOv11实时性优势的同时,实现mAP+8.1%的显著提升,特别在复杂光照、密集目标、交互预测场景表现突出。其模块化设计使开发者可根据需求灵活组合,为各种复杂场景提供定制化解决方案。未来,随着跨模态扩展与神经架构搜索的深入,YOLOv11-FSC将进一步推动目标检测技术向更智能、更高效的方向发展。

走向CTO的路上... 989

《异常检测——从经典算法到深度学习》26 Time-LLM:基于大语言模型的时间序列预测

基于大模型的时间序列预测。

Smileyan's blog 1万+

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

LLM4TS文献阅读 : TIME-LLM: TIME SERIES FORECASTINGBY REPROGRAMMING LARGE LANGUAGE MODELS

Patch(补丁):对于时间序列数据,"patch" 可能指的是数据序列中的局部区域,例如一小段连续的时间窗口或者一组连续的时间点。Batch(批量):在训练时间序列模型时,"batch" 意味着同时处理的一组时间序列样本。例如,在循环神经网络(RNN)的训练过程中,我们通常会将多个时间序列样本组合成一个批量,然后一起输入到模型中进行训练,以提高训练效率。因此,以时间序列为主题,"patch" 可能表示时间序列中的局部区域或子序列,而 "batch" 则表示在训练模型时同时处理的一组时间序列样本。

Msc30839573的博客 2825

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

Gumbo-Parser环境自动备份:终极完整指南

在HTML5解析领域,gumbo-parser作为一个纯C99实现的HTML5解析库,为开发者提供了强大的网页解析能力。对于依赖这一开源工具的项目而言,环境备份是确保项目稳定运行的关键步骤。本文将为你详细介绍如何实现gumbo-parser环境的自动备份,让你的开发工作更加高效可靠。 ## 为什么需要环境自动备份?🚀 gumbo-parser作为HTML5解析的核心工具,其配置文件和依赖环境

gitblog_00907的博客 475

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Time-LLM架构分析

Time-LLM:通过重编译大语言模型进行时序预测》,这是一篇24年发表在ICLR上的论文。针对NLP、CV领域的任务,往往一个大模型就能解决各种问题,而时序预测领域的模型却要针对不同任务和应用进行不同的设计。研究表明LLM在复杂的token序列上有强大的模式识别和推理能力,但该,以利用这些能力呢?在这篇工作中推出了一个重编译框架Time-LLM,在保持主体的语言模型不变的情况下,将LLM应用到时序预测上。

m0_56695799的博客 2419

TIME-LLM: TIME SERIES FORECASTINGBY REPROGRAMMING LARGE LANGUAGE MODELS基于大语言模型的时间序列预测重编程框架

本文提出了一个名为TIME-LLM的重编程框架,旨在将大语言模型(LLMs)重新利用于通用的时间序列预测任务,并且保持语言模型的核心结构不变。

m0_49214701的博客 1892

《TIME-LLM: TIME SERIES FORECASTINGBY REPROGRAMMING LARGE LANGUAGE MODELS》

本文提出了T IME -LLM,一个将大型语言模型(LLMs)重新编程以进行时间序列预测的框架。该方法通过将时间序列数据转化为文本原型,结合Prompt-as-Prefix(PaP)技术,增强了LLMs对时间序列的推理能力。实验结果表明,T IME -LLM在多个基准测试中超越了现有的专用预测模型,尤其在少样本和零样本学习场景中表现优异,展示了LLMs在时间序列预测中的潜力。

weixin_42209537的博客 1138

Time-LLM----可预测未来值

从本人实际运行来看,这个模型比较吃配置,以我上面给出的部分代码参数设置(推荐使用GPT2,会快一点并且不用搞其它东西)为例,运行7000多条的数据,迭代一次需要10分钟左右(本人笔记本电脑13900HX+4060),内存吃了17G多,专用显存和共享显存一共吃了18G多。Time-LLM的核心理念是“重新编程”(reprogramming):将时间序列数据转化为适合语言模型处理的形式,从而使其无需改变预训练的模型结构即可用于预测任务。此外,大部分传统模型需要大量的训练数据,在数据稀缺的场景中效果有限。

zengxiaojian2的博客 1295

Time-LLM:如何用大型语言模型革命性解决时间序列预测难题?

Time-LLM是一个创新性的重编程框架,它能够将大型语言模型(LLM)重新用于通用时间序列预测,同时保持骨干语言模型的完整性。值得注意的是,该框架表明时间序列分析(例如预测)可以被视为另一种"语言任务",并能由现成的LLM有效处理。 ## 什么是Time-LLM? Time-LLM是ICLR 2024会议上提出的创新框架,它通过重编程大型语言模型来实现时间序列预测。这一方法的核心思想是将时间

gitblog_01077的博客 485

Time-LLM时序预测模型的核心优势与工业落地实践

Time-LLM最显著的技术突破在于其创新的"re-programmable heads"架构设计。该架构采用基础Transformer骨干网络配合可插拔式任务适配头,通过轻量级的注意力重编程机制(Attention Reprogramming),仅需微调任务头即可实现跨领域时序预测任务的快速迁移。相比传统时序模型需要全参数微调的方式,这种设计使得模型在计算资源消耗降低83%的情况下,仍能保持92...

gitblog_07044的博客 662
上一篇: IEEE TCSS 2025 | MBIDR: 基于意图解耦的多行为推荐,精准捕获用户细粒度兴趣
下一篇: [AAAI 2025 深度解读] 拒绝盲猜:当 CLIP 大模型被引入 3D 点云补全
山科智能信息处理实验室
博客等级 码龄6年 809粉丝 74原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值