混合卷积和注意力网络用于高光谱图像去噪

精读论文:【Hybrid Convolutional and Attention Network for Hyperspectral Image Denoising】 这篇论文提出了一种新的混合卷积和注意力网络(HCANet),用于高光谱图像(HSI)去噪。HCANet结合了卷积神经网络(CNNs)和Transformer的优势,以同时增强全局和局部特征的建模。为了捕获长距离依赖性和邻域光谱相关性,作者设计了一个卷积和注意力融合模块(CAFM)。此外,为了改善多尺度信息聚合,作者设计了一个多尺度前馈网络(MSFN),通过提取不同尺度的特征来增强去噪性能。 阅读详情

论文题目:Hybrid Convolutional and Attention Network for Hyperspectral Image Denoising_translated

作者:Shuai Hu; Feng Gao; Xiaowei Zhou; Junyu Dong; Qian Du

论文来源:Hybrid Convolutional and Attention Network for Hyperspectral Image Denoising | IEEE Journals & Magazine | IEEE Xplore

代码地址:https://github.com/summitgao/HCANet

1. 为什么要关心高光谱图像去噪?

        高光谱图像(Hyperspectral Image, HSI)具有数百个光谱波段,能精确刻画物体的光谱特征,因此在 遥感监测、农业植被分析、环境评估、军事侦察 等领域被广泛应用。然而,受传感器精度、环境光照、传输噪声等影响,HSI 常常被噪声污染。这不仅降低了图像质量,还直接影响后续分类、检测和识别等任务。

        过去,研究者提出了大量 HSI 去噪方法:

  • 传统方法:如低秩分解、稀疏表示、总变分(TV)等,能够利用先验约束抑制噪声,但对复杂噪声的鲁棒性不足。

  • 深度学习方法:卷积神经网络(CNN)在捕捉局部空间模式方面表现良好,但容易忽视远距离光谱依赖;而 Transformer 类方法通过自注意力机制建模全局关系,却往往计算开销较大。

        👉 因此,真正的挑战在于:如何同时兼顾局部细节和全局依赖,并保持高效。


2. HCANet框架的提出

2.1 核心思想

        HCANet(Hybrid Convolutional and Attention Network)正是针对上述矛盾提出的。作者希望通过 卷积与注意力机制的有机结合,实现局部–全局特征的协同建模。

具体来说:

  1. 卷积分支:高效提取局部纹理与邻域相关性;

  2. 注意力分支:建模光谱维度的长距离依赖关系;

  3. 多尺度机制:进一步增强模型对复杂噪声的适应性。

        一句话总结:HCANet 就是“卷积的显微镜 + 注意力的望远镜”,让模型既能看清细节,又能把握全局。


2.2 网络结构总览(U-Net 风格 + 多层 CAMixing 模块)

        HCANet 的整体框架基于经典的 U-Net,通过 编码器—解码器结构 + 跳跃连接 来实现特征的逐层压缩与逐层恢复。在此基础上,作者在每个阶段都引入了 CAMixing 模块(由 CAFM 与 MSFN 组成),以增强模型在复杂高光谱噪声环境下的特征表达能力。
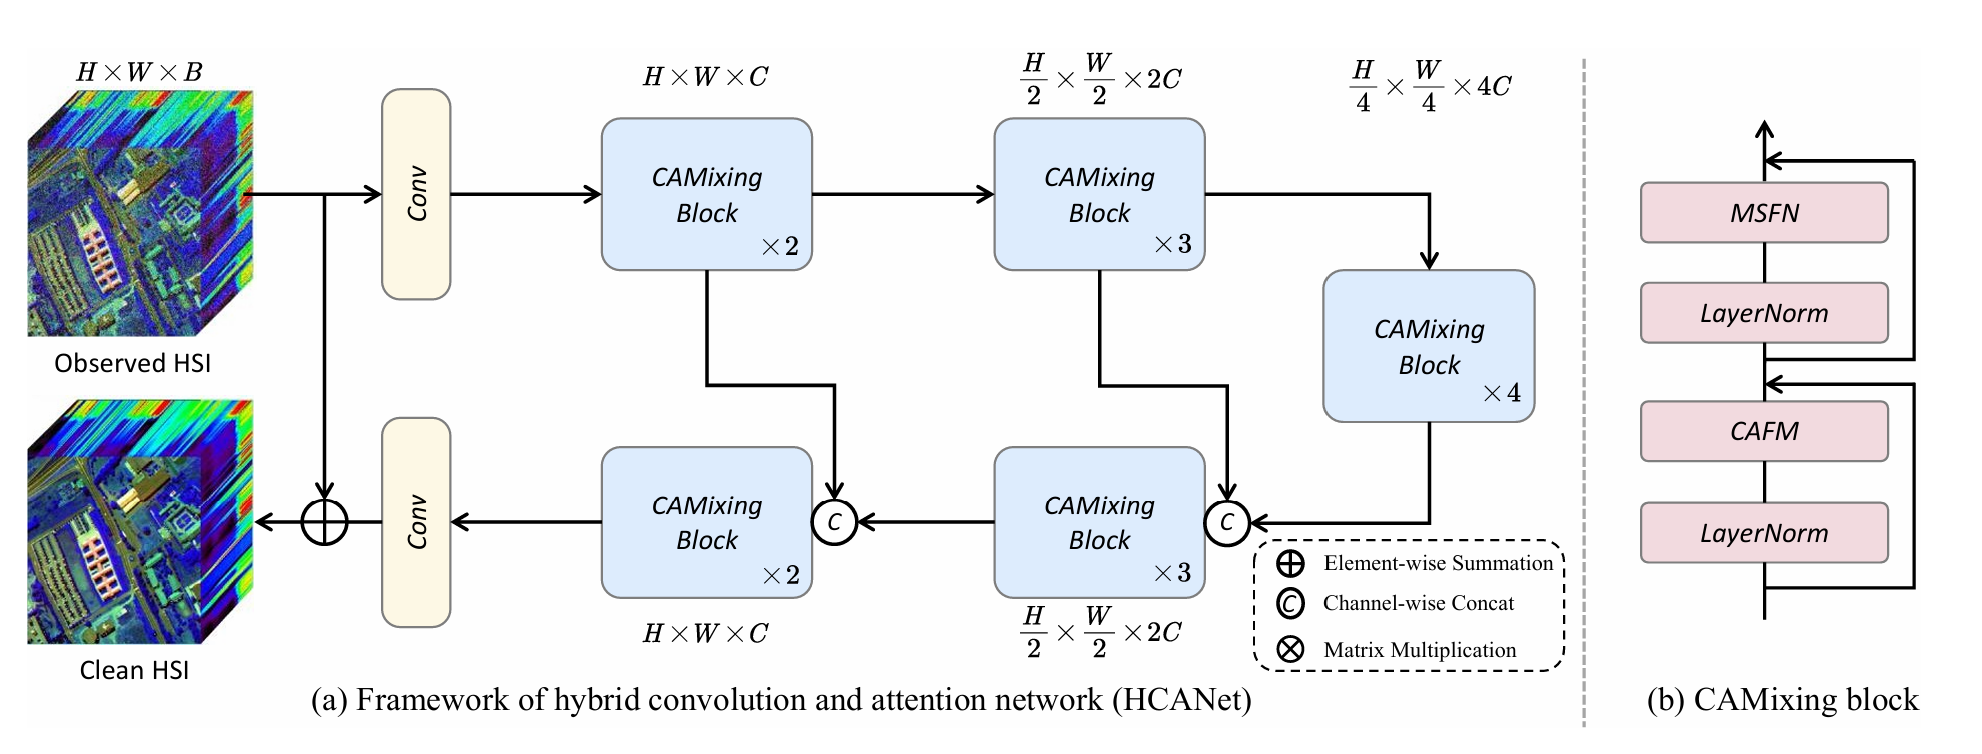
​
HCANet网络

2.1.1 U-Net 基础框架

  • Encoder(编码器)
    逐层下采样输入的高光谱图像,提取不同尺度的语义特征,同时扩大感受野,以便捕捉长距离相关性。

  • Decoder(解码器)
    对编码特征进行逐步上采样,并通过跳跃连接融合浅层的细节信息,从而恢复高分辨率的空间结构。

  • Residual Learning(残差学习)
    网络输出的是噪声残差,最终的干净图像通过“输入 − 残差”的方式获得。这种方式能有效稳定训练,加快收敛。

为什么选择 U-Net?
高光谱图像包含丰富的空间—光谱结构,U-Net 在捕捉多尺度空间特征和保留细节方面具有天然优势,非常适合该任务。

2.2 CAMixing 模块嵌入

        传统 U-Net 在处理高光谱数据时面临两个主要问题:

  1. 卷积算子局限性:标准卷积善于提取局部模式,但难以建模远距离的光谱相关性;

  2. 尺度信息不足:单一卷积核尺度下的特征提取,无法同时兼顾局部纹理和全局依赖。

        为此,HCANet 在 U-Net 的各个阶段中插入 CAMixing 模块,其内部包含:

  • CAFM(Convolution and Attention Fusion Module):卷积与注意力融合,既保持卷积的局部建模优势,又利用注意力机制捕捉远距离光谱依赖;

  • MSFN(Multi-Scale Feed-Forward Network):在 CAFM 后串联,利用不同尺度的卷积核或扩张卷积,增强多尺度特征表示能力。


2.3 整体优势

        这种 U-Net + CAMixing 的设计带来三点关键好处:

  1. 多尺度建模能力更强
    CAFM 专注于局部—全局依赖融合,MSFN 则保证不同尺度的信息提取,两者结合能显著提升对复杂噪声的适应性;

  2. 空间与光谱的协同增强
    卷积强化空间结构建模,注意力机制侧重光谱通道间的相关性,从而实现空间—光谱信息的动态融合;

  3. 网络表达更高效
    通过残差学习和轻量化的注意力机制,模型在不显著增加参数量的前提下,获得了更强的去噪能力。


2.2 卷积与注意力融合模块CAFM

        CAFM 是 HCANet 的核心单元之一,主要目标是同时捕捉局部空间纹理与光谱全局依赖。它被嵌入到编码器和解码器的不同层级,用于在特征提取过程中不断平衡 空间细节建模 和 光谱相关性建模。
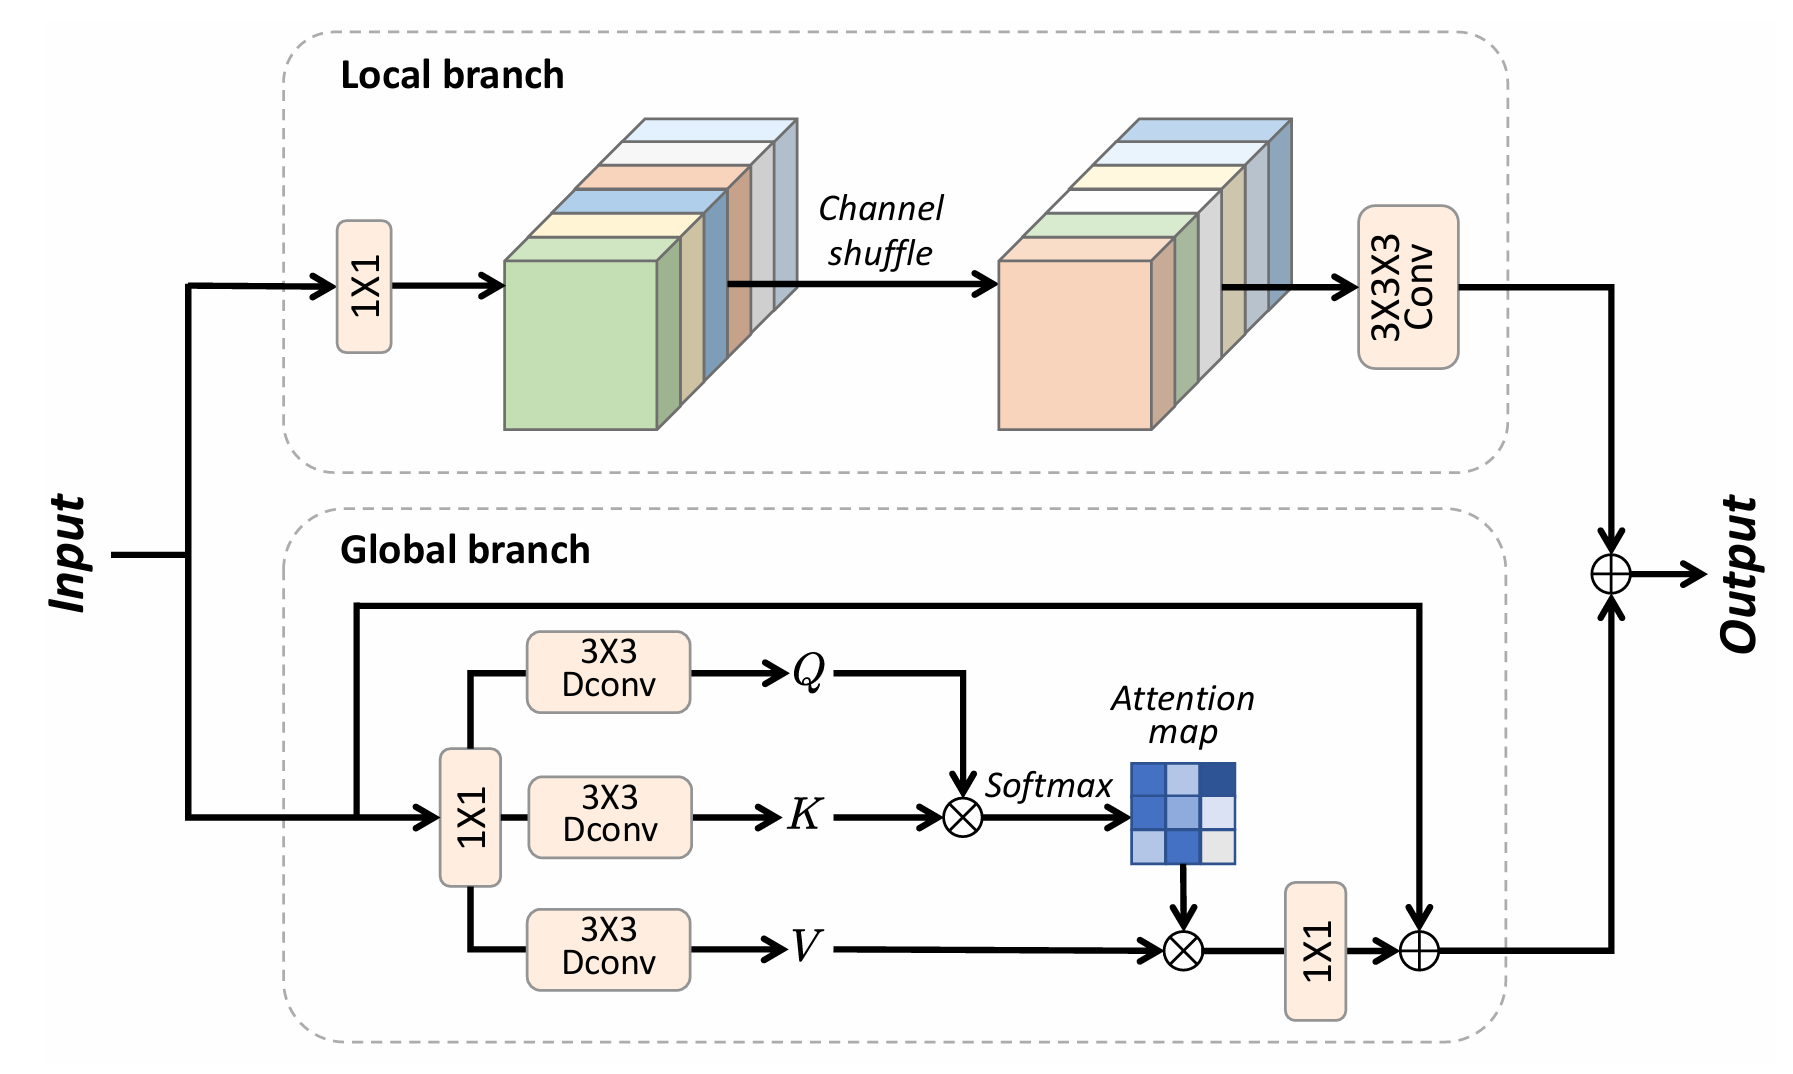
​
卷积与注意力融合模块(CAFM)

        CAFM 由两个并行分支和一个融合单元组成:

1)卷积分支(Local Convolution Branch)

  • 输入:来自上层的特征图 X \in \mathbb{R}^{H \times W \times C}​。

  • 操作:

    • 使用 分组卷积(Group Convolution) 提取局部邻域特征,降低参数量和计算开销;

    • 通过 Channel Shuffle 操作打乱通道顺序,促进不同组之间的信息交互,避免分组卷积带来的通道独立性问题;

  • 效果:在保持计算效率的同时,增强空间–光谱维度的特征融合,对细粒度的噪声(点状、条纹)更敏感。

💡 Channel Shuffle 作用
在分组卷积中,通道通常被划分为若干组,每组内部只与自己组内的通道交互,组间信息无法流通,就像小团队内部开会,团队间几乎不交流。

Channel Shuffle 的作用是将通道按照固定规则重新组合,实现跨组信息交换,同时保留组内通道的相对顺序。

示例(8 个通道分 2 组):

  • 原始分组:

    • 组 1:C1,C2,C3,C4

    • 组 2:C5,C6,C7,C8

  • Channel Shuffle 操作(reshape → transpose → flatten):

    • 新组 1:C1,C5,C2,C6

    • 新组 2:C3,C7,C4,C8

现在,每组都包含来自不同原始组的通道,实现跨组信息流动,就像团队成员跨组交流。
效果:在保持分组卷积高效性的同时,增强通道间特征融合,提高网络的表达能力。


2)注意力分支(Spectral Attention Branch)

  • 输入:同样的特征图 X。

  • 操作:

    • 线性投影得到 Q,K,V,并计算光谱维度的自注意力:

      \text{Attention}(Q, K, V) = \text{Softmax}\left(\frac{Q K^\top}{\sqrt{d}}\right)​

    • 输出全局依赖特征,建模跨波段的长距离相关性。

    • 采取跳跃连接,避免注意力处理后信息丢失。

  • 效果:弥补卷积分支缺乏光谱全局感知的不足,保持光谱维度的连续性。


3)融合单元(Fusion Unit)

  • 卷积分支和注意力分支的输出通过逐元素加权相加:

F_{\text{CAFM}} = F_{\text{conv}} +F_{\text{attn}}​

  • 最终输出再经过轻量激活,得到兼顾局部与全局的混合特征。

直接逐元素相加类似于 ResNet 的残差连接,不会破坏原有特征,同时平滑梯度传递,有利于训练稳定性。

相加后的特征会进入 MSFN 等后续模块,通过卷积和激活函数进行非线性变换,使网络自动调整融合结果,进一步提升去噪效果。


2.3 多尺度前馈网络MSFN

        它可以理解为网络的“放大镜”,用来捕捉不同尺度下的噪声模式,让去噪更稳健。
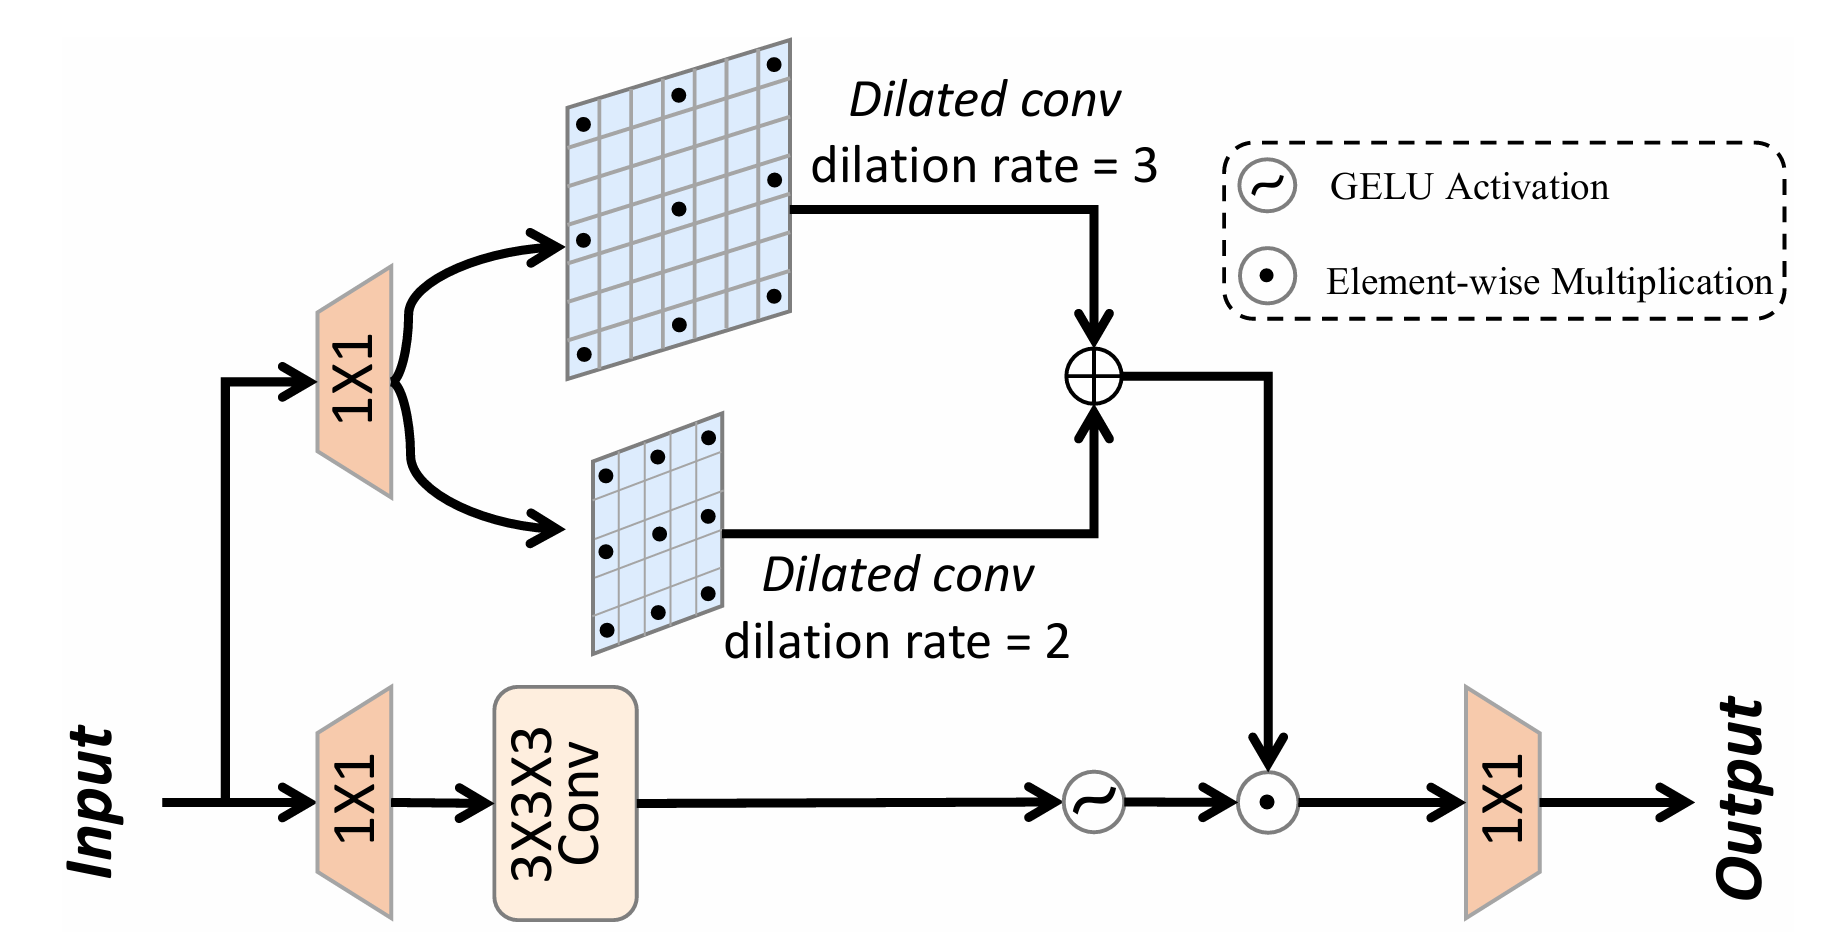
​
多尺度前馈网络(MSFN)

        MSFN 存在两条并行分支,各自负责不同的特征提取任务:

1. 上分支:多尺度空洞卷积

  • 先用 1×1 卷积提高通道数,增强特征表达空间;

  • 再通过 膨胀率分别为 2 和 3 的空洞卷积捕获不同尺度的上下文信息和特征;

  • 两个尺度的特征在通道维度拼接后输出,形成融合特征 F_\text{up}​​。

F_\text{up} = \text{Concat}\Big(\text{DilatedConv}_{r=2}(Conv_{1\times1}(X)), \ \text{DilatedConv}_{r=3}(Conv_{1\times1}(X))\Big)​

空洞卷积通过在卷积核元素之间引入空洞(dilation),可以在 不增加卷积核大小或参数量 的情况下,扩大感受野:

y[i] = \sum_{k=1}^{K} x[i + r \cdot k] \cdot w[k]​

2. 下分支:局部卷积处理细节

  • 同样先经过 1×1 卷积调整通道数;

  • 使用 3×3×3 卷积核提取局部特征,再经过 GeLU 激活得到非线性输出 。

F_\text{down} = \text{GeLU}\Big(Conv_{3\times3\times3}(Conv_{1\times1}(X))\Big)​

可以把下分支看作“控制开关”,调节上分支特征的重要性。


特征融合与通道还原

        上下分支的输出通过 逐元素相乘融合,得到融合特征 F_\text{fused}​​:

F_\text{fused} = F_\text{up} \odot F_\text{down}​

事实上可以理解一种“AND”操作,只有当上分支(大尺度下)以及下分支(局部下)都认为重要的部分才会被放大

        最后,用 1×1 卷积将通道数还原为原始输入通道数,得到 MSFN 最终输出

F_\text{MSFN} = Conv_{1\times1}(F_\text{fused})​


2.4 损失函数

1)L1重建损失:衡量去噪图像与原始带噪图像的差异

\mathcal{L}_{rec} = \| \hat{I} - I \|_1

2)全局梯度正则化器:

\mathcal{L}_{grad} = \| \nabla_h \hat{I} - \nabla_h I \|_2^2 + \| \nabla_v \hat{I} - \nabla_v I \|_2^2 + \| \nabla_s \hat{I} - \nabla_s I \|_2^2

        其中, ∇h、∇_h 、 ∇v和∇s分别∇_v 和∇_s 分别表示沿水平、垂直和光谱轴应用的梯度算子。

3)总损失:

\mathcal{L} = \mathcal{L}_{rec} + \lambda \mathcal{L}_{grad}


3. 实验设计

3.1 数据集和评价指标

        数据集选用ICVL Hyperspectral Data Set作为训练数据集、Pavia University Hyperspectral Dataset作为测试数据。选用以下三个指标:

1)PSNR(峰值信噪比):越大越好,代表图像质量

\text{PSNR} = 10 \cdot \log_{10} \left( \frac{\text{MaxValue}^2}{\text{MSE}} \right)​

2)SSIM(结构相似性):越大越好,代表结构保持能力

\text{SSIM}(x, y) = \bigl[l(x, y)\bigr]^\alpha \cdot \bigl[c(x, y)\bigr]^\beta \cdot \bigl[s(x, y)\bigr]^\gamma​

3)SAM(光谱角映射):越小越好,代表光谱一致性

\text{SAM} = \cos^{-1} \left( \frac{Y^\top X}{\|Y\|_2 \, \|X\|_2} \right)​

3.2 噪声设计

        论文分别选用单高斯噪声、高斯+条纹、高斯+Deadline、高斯+脉冲、以及混合噪声(高斯+条纹+Deadline+脉冲)作为五个噪声场景进行训练。

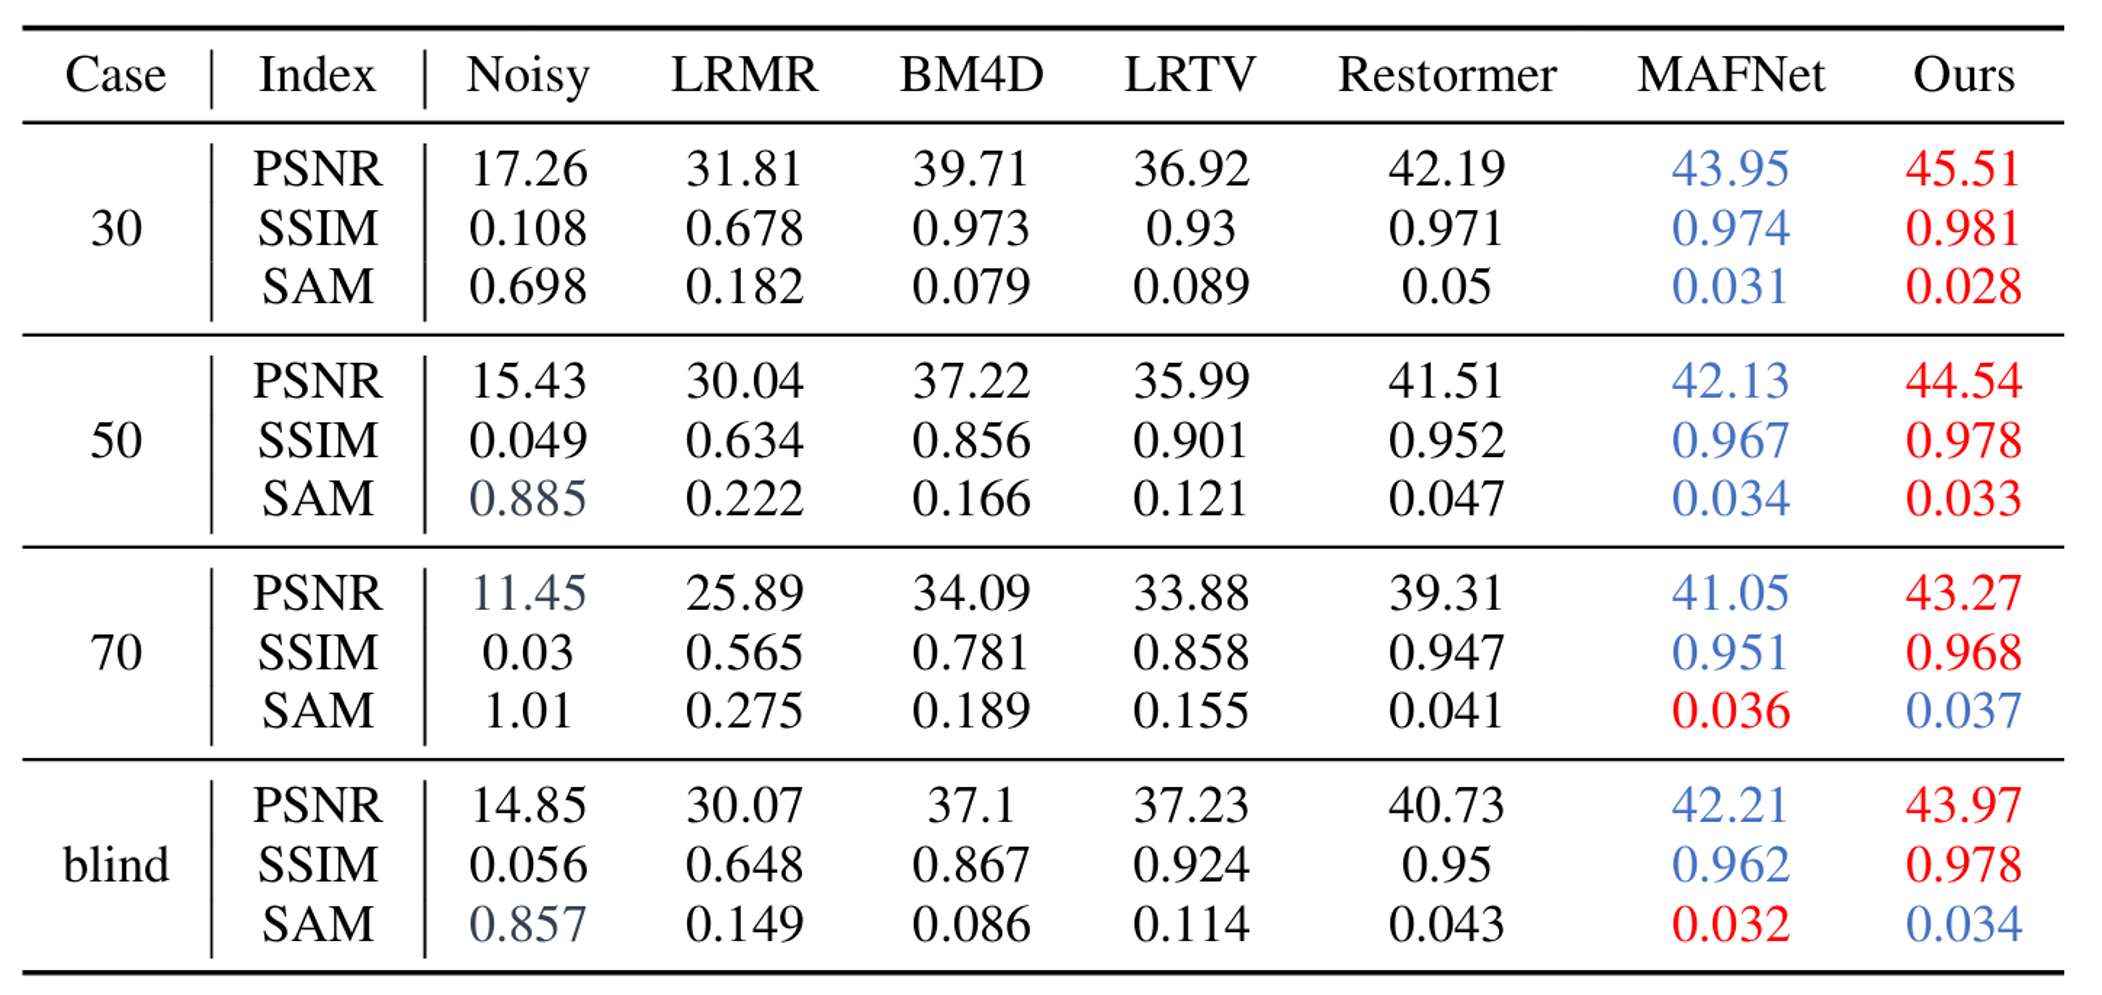
3.3 基准对比实验(高斯噪声)

        在30-70幅度的高斯及盲噪声下对比:
​

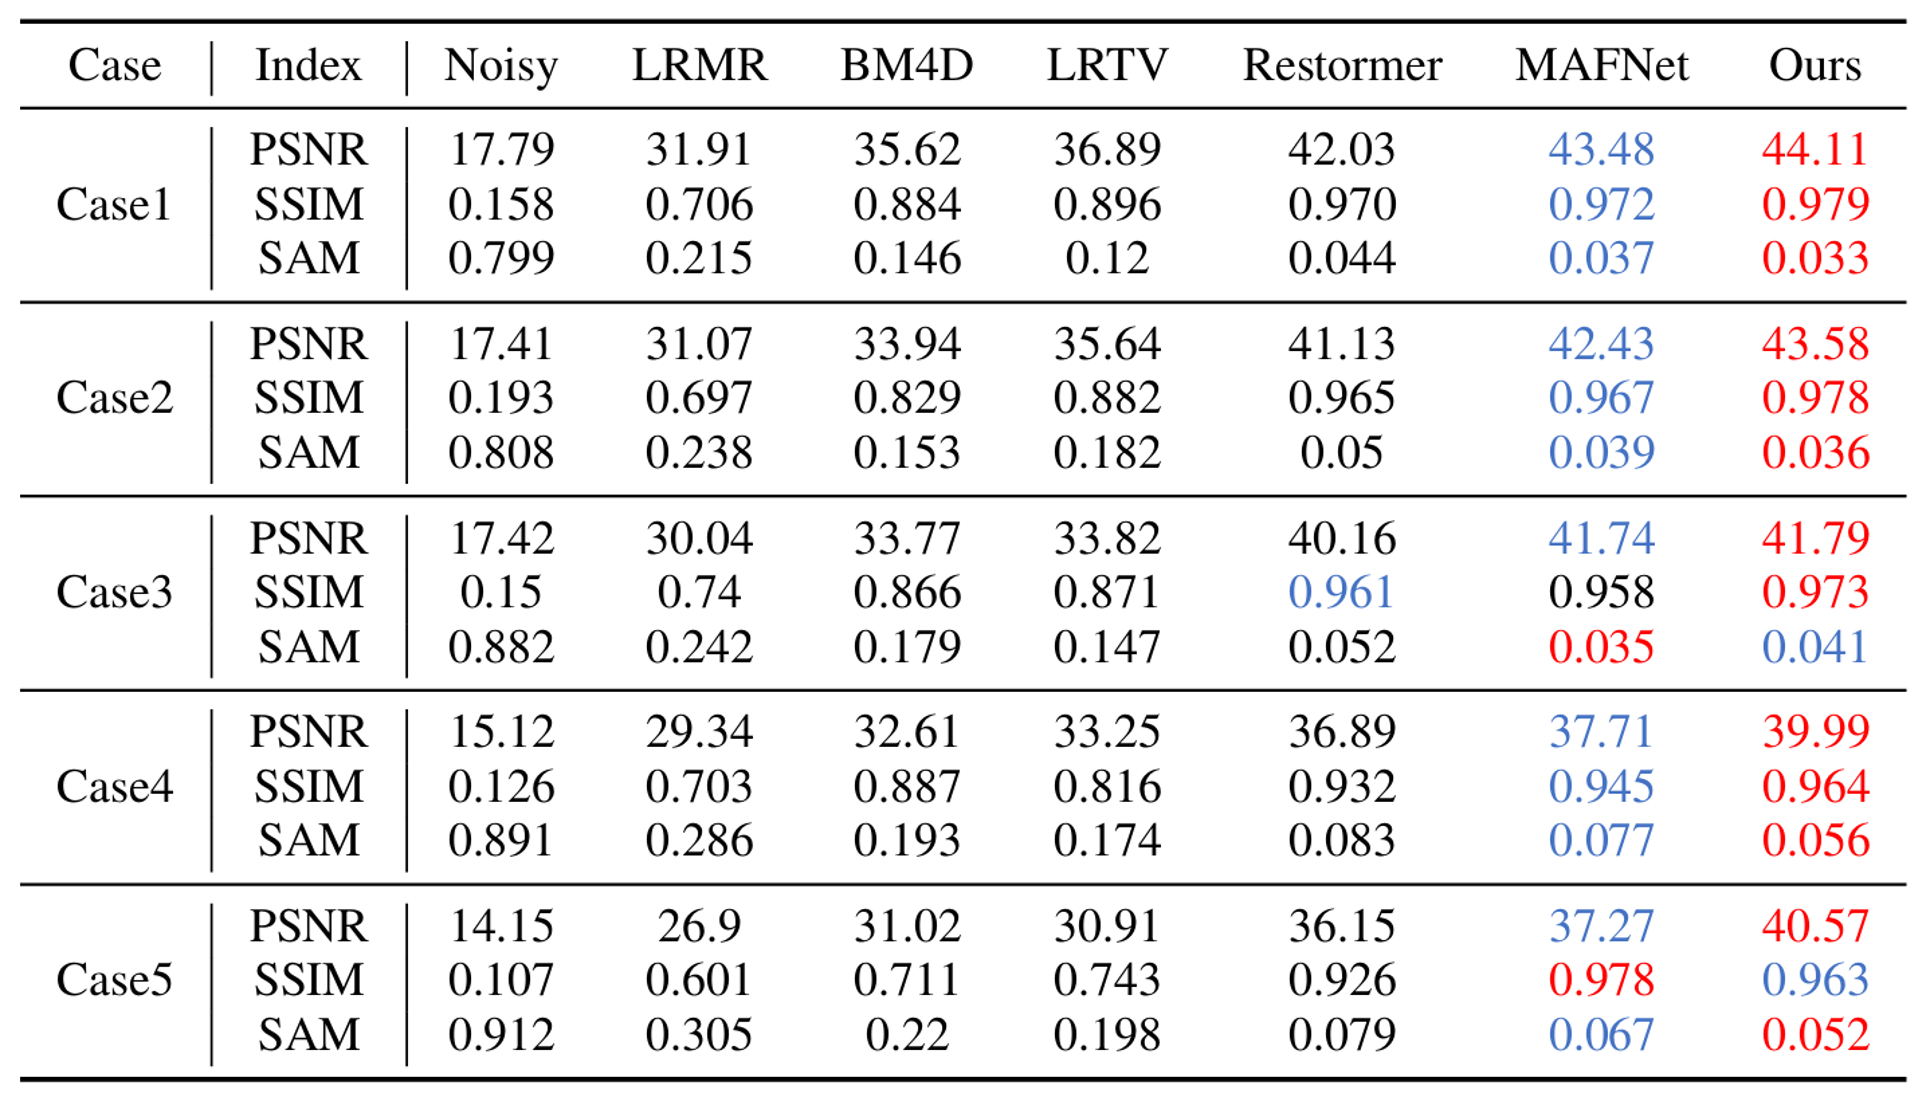
3.4 基准对比实验(复杂噪声)

        在五个噪声场景下进行对比:

​

4. 结语

        总体来看,HCANet 通过卷积与注意力的有机融合,以及多尺度前馈网络的精细调制,实现了对高光谱图像复杂噪声的高效去除。对于需要同时兼顾局部细节与全局光谱信息的 HSI 应用场景,HCANet 提供了一个可借鉴的设计思路。未来,这种方法可以进一步扩展到更大尺度的遥感图像或结合下游任务的联合优化。

探索混合卷积与注意力网络在高光谱图像去噪中的多尺度特征融合 本文深入探讨了混合卷积与注意力网络(HCANet)在高光谱图像去噪中的应用。该网络创新性地融合了CNN的局部特征提取能力与Transformer的全局注意力机制,并通过多尺度特征融合模块有效处理复杂噪声,在多项测试中展现出卓越的去噪性能与细节保持能力,为高光谱图像处理提供了高效解决方案。 阅读详情

相关推荐

高光谱图像数据集

1:Washington DC Mal,Indian Pine等 https://engineering.purdue.edu/~biehl/MultiSpec/hyperspectral.html 2:Indian Pines,Salinas,Pavia Centre and University,Cuprite等 http://www.ehu.eus/ccwintco/index.php?title=Hyperspectral_Remote_Sensing_Scenes 3:hydice的...

haoji007的博客 6841

深度先验手势估计代码.zip_ICVL dataset_ICVL数据集下载_python_python 人工智能_手势 pyth

icvl数据集下TensorFlow框架手势估计Python代码,人工智能深度学习。

【YOLOv10改进-注意力机制】MSFN(Multi-Scale Feed-Forward Network):多尺度前馈网络

摘要——高光谱图像(HSI)去噪对于高光谱数据的有效分析和解释至关重要。然而,同时建模全局和局部特征以增强HSI去噪的研究却很少。在本文中,我们提出了一种混合卷积和注意力网络(HCANet),该网络结合了卷积神经网络(CNN)和Transformers的优势。为了增强全局和局部特征的建模,我们设计了一个卷积和注意力融合模块,旨在捕捉长距离依赖关系和邻域光谱相关性。此外,为了改进多尺度信息聚合,我们设计了一个多尺度前馈网络,通过在不同尺度上提取特征来增强去噪性能。

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 515

论文笔记22:QRNN3D: 3D Quasi-Recurrent Neural Network for Hyperspectral Image Denoising

本文提出了一种用于高光谱图像去噪的交替方向三维准递归神经网络,该网络能够有效地嵌入领域知识——结构空间-光谱相关性和沿光谱的全局相关性。具体来说,3D卷积被用来提取HSI中的结构空间-光谱相关性,而准递归池化函数被用来捕获沿光谱的全局相关性。此外,交替方向结构的引入消除了因果依赖,没有额外的计算成本。所提出的模型能够模拟空间-光谱相关性,同时保持对具有任意波段数的HSIs的灵活性。

Hermite Lee的博客 1749

基于混合卷积与三重注意力的高光谱图像分类网络

针对高光谱图像光谱维度高、现有网络无法提供深度级的多层次特征,从而影响分类精度和速度的问题。首先采用核主成分分析对高光谱图像进行降维,使降维后的数据具有最佳区分度,提出了一种基于混合卷积与三重注意力的卷积神经网络(hybrid convolutional neural network with triplet attention, HCTA-Net)模型,该模型设计了一种基于三维、二维和一维卷积的混合卷积神经网络,通过不同维度卷积神经网络的融合,提取高光谱图像精细的光谱–空间联合特征。

罗伯特技术屋 1138

【Block总结】CAFM,卷积和注意力融合模块,融合全局和局部特征

本论文提出的HCANet通过结合卷积和注意力机制,成功提升了高光谱图像去噪的性能。其创新的卷积和注意力融合模块以及多尺度前馈网络为高光谱图像处理提供了新的思路,展示了深度学习在高光谱图像去噪领域的强大潜力。实验结果的有效性和合理性为未来的研究提供了坚实的基础。

AI浩 2128

论文笔记35:3DADNet: Hyperspectral Image Denoising Using a 3-D Attention Denoising Network

我们设计了两个并行的分支来分别处理空间和光谱信息。位置注意力模块应用于空间分支,以在特征映射上形成相互依赖性,而通道注意力模块应用于光谱分支,以在两个分支组合之前模拟光谱相关性。在融合空间和光谱信息后,多尺度结构也被用来提取和融合多尺度特征。

Hermite Lee的博客 1160

【YOLOv10改进】CAFM(Convolution and Attention Fusion Module):卷积和注意力融合模块 | 小目标

摘要——高光谱图像(HSI)去噪对于高光谱数据的有效分析和解释至关重要。然而,同时建模全局和局部特征以增强HSI去噪的研究却很少。在本文中,我们提出了一种混合卷积和注意力网络(HCANet),该网络结合了卷积神经网络(CNN)和Transformers的优势。为了增强全局和局部特征的建模,我们设计了一个卷积和注意力融合模块,旨在捕捉长距离依赖关系和邻域光谱相关性。此外,为了改进多尺度信息聚合,我们设计了一个多尺度前馈网络,通过在不同尺度上提取特征来增强去噪性能。

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 1647

解密HCANet:混合卷积与注意力机制如何重塑高光谱图像去噪

本文深入解析HCANet如何通过混合卷积与注意力机制革新高光谱图像去噪技术。该网络结合CNN的局部特征提取与Transformer的全局关系建模,创新设计CAFM模块和MSFN多尺度特征网络,在农业监测、文物保护等场景中显著提升去噪效果,PSNR指标较传统方法提高2.3dB。

weixin_30836759的博客 380

YOLOv5独家改进:小目标 | 注意力 |卷积和注意力融合模块(CAFMAttention) | 2024年4月最新成果

创新点:卷积和注意力巧妙设计

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 1439

【YOLOv8改进】CAFM(Convolution and Attention Fusion Module):卷积和注意力融合模块

摘要——高光谱图像(HSI)去噪对于高光谱数据的有效分析和解释至关重要。然而,同时建模全局和局部特征以增强HSI去噪的研究却很少。在本文中,我们提出了一种混合卷积和注意力网络(HCANet),该网络结合了卷积神经网络(CNN)和Transformers的优势。为了增强全局和局部特征的建模,我们设计了一个卷积和注意力融合模块,旨在捕捉长距离依赖关系和邻域光谱相关性。此外,为了改进多尺度信息聚合,我们设计了一个多尺度前馈网络,通过在不同尺度上提取特征来增强去噪性能。

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 4586

多光谱图像CAVE数据集

我们提供了用于模拟GAP相机的多光谱图像数据库。这些图像包含各种现实世界的材料和物体。我们正在将该数据库提供给研究社区。

【YOLOv11改进 - 注意力机制】CAFM(Convolution and Attention Fusion Module):卷积和注意力融合模块

【YOLOv11改进 - 注意力机制】CAFM(Convolution and Attention Fusion Module):卷积和注意力融合模块

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 1671

YOLOv8最新改进系列:融合最新顶会提出的HCANet网络中卷积和注意力融合模块(CAFM),有效提升小目标检测性能,大幅度拉升目标检测效果!遥遥领先!

YOLOv8最新改进系列:融合最新顶会提出的HCANet网络中卷积和注意力融合模块(CAFM),有效提升小目标检测性能,大幅度拉升目标检测效果!遥遥领先!

B站 Ai学术叫叫兽的文案地 5033

【Block总结】MSFN,多尺度前馈网络,多条并行路径处理输入特征,结合门控机制增强非线性变换,提取多尺度特征

本论文提出的HCANet通过结合卷积和注意力机制,成功提升了高光谱图像去噪的性能。其创新的卷积和注意力融合模块以及多尺度前馈网络为高光谱图像处理提供了新的思路,展示了深度学习在高光谱图像去噪领域的强大潜力。实验结果的有效性和合理性为未来的研究提供了坚实的基础。

AI浩 1253

ICVL opencv

别人整理的很好的opencv的知识,包括 OpenCV 编码样式指南 CxCore中文参考手册 机器学习中文参考手册 CvAux中文参考手册 Cv中文参考手册 HighGUI中文参考手册 CvvImage类参考手册 OpenCV例程

YOLOv10最新创新点改进系列:融合最新顶会提出的HCANet网络中卷积和注意力融合模块(CAFM-2024年3月15月开源),有效提升小目标检测性能,大幅度拉升目标检测效果!

YOLOv10最新创新点改进系列:融合最新顶会提出的HCANet网络中卷积和注意力融合模块(CAFM-2024年3月15月开源),有效提升小目标检测性能,大幅度拉升目标检测效果!

B站 Ai学术叫叫兽的文案地 2667

高光谱数据(包含ground truth)

此数据为星载高光谱遥感数据,里面包含去除无效波段的数据及所其数据维度大小,还包含其Ground Truth,对算法分析验证很有用

上一篇: 时空基础模型综述:从数据到模型的全流程解析
下一篇: GrowSP:三维点云的无监督语义分割
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值