从CPU冒烟到丝滑体验:算法SRE性能优化实战全揭秘|得物技术

一、引言

在算法工程中,大家一般关注四大核心维度:稳定、成本、效果、性能。

其中,性能尤为关键——它既能提升系统稳定性,又能降低成本、优化效果。因此,工程团队将微秒级的性能优化作为核心攻坚方向。

本文将结合具体案例,分享算法SRE在日常性能优化中的宝贵经验,助力更多同学在实践中优化系统性能、实现业务价值最大化。

二、给浮点转换降温

算法工程的核心是排序,而排序离不开特征。特征大多是浮点数,必然伴随频繁的数值转换。零星转换对CPU无足轻重,可一旦规模如洪水倾泻,便会出现CPU瞬间飙红、性能断崖式下跌的情况,导致被迫堆硬件,白白抬高成本开销。

例如:《交易商详页相关推荐 - neuron-csprd-r-tr-rel-cvr-v20-s6》 特征处理占用CPU算力时间的61%。其中大量工作都在做Double浮点转换,如图所示:
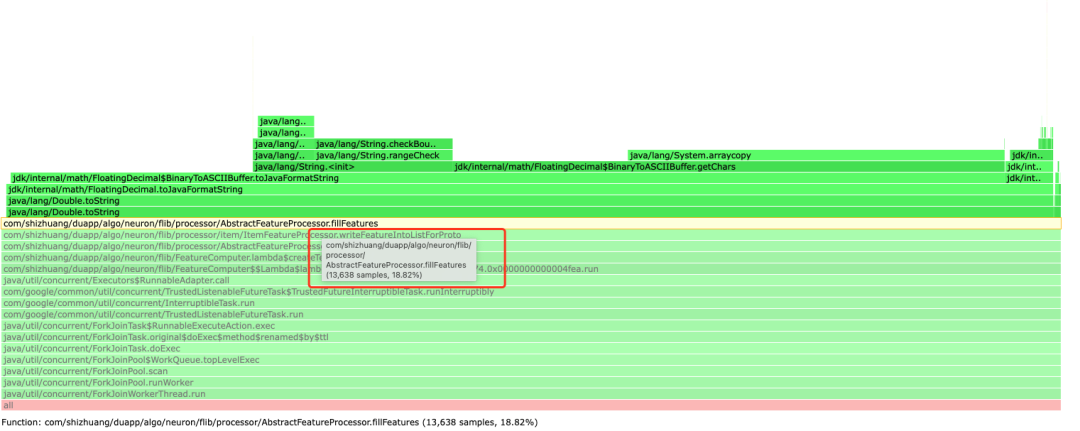
优化前CPU时间占比 18%

Double.parseDouble、Double.toString是JDK原生原子API了,还能优化?直接给答案:能!

浮点转字符串:Ryu算法

https://github.com/ulfjack/ryu

Ryu算法,用“查表+定长整数运算”彻底摒弃“动态多精度运算+内存管理”的重开销,既正确又高效。

算法的完整正确性证明:

https://dl.acm.org/citation.cfm? doid=3296979.3192369

 伪代码说明 

// ——“普通”浮点到字符串(高成本)——
void convertStandard(double d, char *out) {
    // 1. 拆分浮点:符号、指数、尾数
    bool sign = (d < 0);
    int  exp  = extractExponent(d);    // 提取二进制指数
    uint64_t mant = extractMantissa(d);
    
    // 2. 构造大整数:mant × 2^exp —— 可能要扩容内存
    BigInt num = BigInt_from_uint64(mant);
    num = BigInt_mul_pow2(num, exp);    // 多精度移位,高开销
   
    // 3. 逐位除以 10 生成十进制,每次都是多精度除法
    //    ——每次 divMod 都要循环内部分配和多精度运算
    char buf[32];
    int  len = 0;
    while (!BigInt_is_zero(num)) {
        BigInt digit, rem;
        BigInt_divmod(num, 10, &digit, &rem);  // 慢:多精度除法
        buf[len++] = '0' + BigInt_to_uint32(digit);
        BigInt_free(num);
        num = rem;
    }
    
    // 4. 去除多余零、插入小数点和符号
    formatOutput(sign, buf, len, out);
}


// ——Ryu 方法(低成本)——
void convertRyu(double d, char *out) {
    // 1. 拆分浮点:符号、真实指数、尾数(隐含1)
    bool sign = (d < 0);
    int  e2   = extractBiasedExponent(d) - BIAS;
    uint64_t m2 = extractMantissa(d) | IMPLIED_ONE;
    
    // 2. 一次查表:获得 5^k 和对应位移量
    //    ——预先计算好,运行时无动态开销
    int      k     = computeDecimalExponent(e2);
    uint64_t pow5  = POW5_TABLE[k];        // 只读数组(cache 友好)
    int      shift = SHIFT_TABLE[k];
    
    // 3. 单次 64×64 位乘法 + 右移 —— 固定时间
    __uint128_t prod = ( __uint128_t )m2 * pow5;
    uint64_t    v    = (uint64_t)(prod >> shift);
    
    // 4. 固定最多 ~20 次小循环,v%10 生成每位数字
    //    ——循环次数上限,与具体数值无关
    char buf[24];
    int  len = 0;
    do {
        buf[len++] = '0' + (v % 10);
        v /= 10;
    } while (v);
   
    // 5. 去零、插小数点、加符号:轻量字符串操作
    formatShort(sign, buf, len, k, out);
}

传统方法 vs. Ryu算法对比:

字符串转浮点:Fast_Float算法

https://github.com/wrandelshofer/FastDoubleParser

相比Java自带的Double.parseDouble使用复杂状态机(如BigDecimal或 BigInteger)来处理各种情况,FastDoubleParser使用以下优化策略。

FastDoubleParser 优化策略

※  分离阶段

  • 将输入拆分为三个部分:significand、exponent、special cases(如 NaN, Infinity)。

  • 解析时直接处理整数位和小数位的组合。

※  整型加速 + 倍数转换

  • 在范围允许的情况下使用“64位整数直接表示”有效位。

  • 再通过预计算的“幂次表(10ⁿ 或 2ⁿ)”进行快速缩放,避免慢速浮点乘法。

※  避免慢路径

  • 避免使用BigDecimal或字符串转高精度,再转回double的慢路径。

  • 对于大多数输入,整个解析过程不涉及任何内存分配。

※  SIMD加速(原版 C++)

在C++中使用SIMD指令批量处理字符,Java版受限于JVM,但仍通过循环展开等技术尽量进行优化。

 转换思路 

Input: "123.45e2"
1. 拆分成:
   significand = 12345 (去掉小数点)
   exponent = 2 - 2 = 0  // 小数点后两位,但有 e2
2. 快速转换:
   result = 12345 * 10^0 = 12345.0
3. 最终使用 Double.longBitsToDouble 构造结果

压测报告

Double 字符解析相对JDK原生API 4.43倍 加速

代码优化样例

通过多层判断,尽可能不让Object o做toString()操作。

减少toString触发的可能

工具类 替换浮点转换算法

工具类 替换浮点转换算法

性能实测效果

启用Ryu、Fast_Float算法替换JDK原生浮点转换,效果如下:

优化后CPU时间占比 0.19%【性能提升(18-0.19)/18=98%】

CPU实际获得50%收益

RT实际获得25%左右性能收益

小结

告别原生JDK浮点转换的高昂代价,拥抱Ryu与FastDoubleParser,让CPU从繁忙到清闲,性能“回血”,节约的成本大家可以吃火锅。

三、拔掉诡异的GC毛刺

小堆GC问题

特征维度多时内存压力大,GC问题可以预期。但很多同学可能没有见过,小堆场景,GC也可能频繁触发,甚至引发异常。

如图所示:18GB堆 扩容 -> 30GB堆,均出现RT99周期脉冲,致使5~6%的失败率。

社区瀑布流广告投放-Neuron精排   因GC导致错误

GC问题分析

首先这是GC问题,其次增加了近1倍的内存,没有丝毫缓解,判断这应该是个伪GC问题。

Neuron主要功能就是拿着特征转向量做排序。一般特征量都是亿起步,多的达十亿,因此特征缓存必不可少。但是这个场景,仅仅是将1700个左右的广告特征信息进行了缓存,为什么对象内存会出现周期性的脉冲?

年轻代+老年代 周期共振脉冲

如图所示,关键的问题在于“共振”。因此要用放大镜看问题,再如图所示:

到这里,其实问题已经很明显了:

  • C4作为世界顶级垃圾回收器,GC的能力不用怀疑,STW(Stop-The-World)的时间理论是亚毫秒级。

  • 如果GC能力没问题,算力又充足,那么造成RT99翻倍的原因:要么是线程在等数据,要么是线程忙不过来。

  • Neuron堆内存大头是缓存,那么老年代回收的数据一定是缓存数据,年轻代一定是在回补缓存缺口。

为什么会有这个逻辑?因为缓存命中率一直是 99.9%【1700个广告条目】,如图所示:

在极高缓存命中率的场景下,仅清理少量缓存条目,也可能造成“缓存缺口”。缓存缺口本质上也是一次“中断”,线程被迫等待或执行数据回补,导致性能抖动。

为方便理解,类比“缺页中断”(Page Fault):当程序访问未加载的内存页时,操作系统必须中断执行、加载数据,再继续运行。

解决方案

首先是缓存命中率一定是越高越好,99.9%的命中率没毛病。问题出在1700条广告缓存条目,究竟为何必须如此频繁地设置过期?【TTL: 60~90s】

原因是:业务期望广告特征,能够尽可能实时更新。

缓存失效策略

失效时间 60~90s

关键在于,缓存条目必须及时失效,却又不能因GC过度而引发性能问题。从观察结果来看,年轻代的GC没有对RT99的性能产生明显影响,这说明年轻代GC的力度恰到好处,不会造成频繁的“缓存缺口”。既然如此,我们考虑:如果能彻底规避老年代GC,性能瓶颈的问题是否就能迎刃而解?

因此,我们尝试大幅提高对象晋升到老年代的门槛,直接提升了几个数量级。

增加JVM参数:


-XX:GPGCTimeStampPromotionThresholdMS # 对象晋升老年代前的时间阈值
默认值:2000  调整为:6000000 (1.6小时)


-XX:GPGCOldGCIntervalSecs # 老年代固定GC时间推荐。注意:并不是关闭 OldGC
默认值:600 调整为:600000

在这个场景中,实际有效的对象并不多,最多不过5GB。 其余大部分都是生命周期不超过2分钟的短期广告特征条目(约1700条)。这种短生命周期、低占用的场景完全靠年轻代GC就能轻松支撑,根本不需要启用分代GC。

实际测试一天后,完全印证了这一判断:GC抖动、RT99抖动以及错误率抖动全都彻底消失,同时内存也没有出现任何泄漏。

GC 毛刺消失

RT99失败率 毛刺峰值降至 1/10 +

小结

C4的分代GC对大堆确实有奇效,但放在小堆场景里,非要套个复杂架构,就成了典型的“形式主义”

大堆适用,小堆不行。

四、是谁偷走了RT时间

业务瓶颈的卡点

最近算法特征多了,推理成本就高了;RT一长,用户体验就垮了;产品一急,秒开优化就立项了。

全业务链路都已锁定 RT 优化目标,社区个性化精排也在其中,可这一链路优化阻力最大——RT99长期卡在120ms 以上,始终难以突破。

活用三昧真火

性能分析必看CPU火焰图。一看图就是GC问题。

GC日志分析,年轻代+老年代,堆积起来约150GB,而堆内存才给108GB,怎么做到的?->>> 频繁GC!

GC算力消耗占比 超50%

高频GC

看看哪里分配内存比较疯狂,如图内存分配火焰图所示:

内存分配压力指向两大热点

※  Dump

业务刚需,大量序列化点对象带来的瞬时垃圾情有可原。

※  特征

真正的“吞金兽”——独占超过50%的堆。业务方解释:当前500万特征才勉强把命中率抬到80%,想继续往上,只能指数级内存扩容,总特征数10亿+。堆已拉到128GB,找不到更大规格的机器。

也就是说内存主要被特征吞掉了,优化空间基本没有。

如果优化止步于此,显然无法满足业务方的期望,于是我们进一步深入到Wall火焰图进行更精细的分析。

Wall火焰图同时捕获了CPU执行与IO等待,因此不能简单地以栈顶宽度判断性能瓶颈。否则只会发现线程池空闲的等待任务,看似正常,但真正的性能瓶颈却隐藏在细节中。

因此,我们需要放大视角,聚焦到具体的业务逻辑堆栈位置。在这个案例中,一旦放大便能发现显著问题:特征读取阶段的IO等待时间,竟然超过了远程DML推理与Kafka Dump的总耗时。这直接说明,所谓的80%特征缓存命中率存在明显的缓存击穿现象,大量请求可能被迫穿透至远端Redis或C引擎进行加载,其耗时成本远高于本地缓存命中的场景。

逐帧跟踪确认

通过进一步的Trace跟踪分析,我们的猜测得到了验证。

通过和C引擎团队联合排查发现,现有架构采用了早期的部署模式,其中为索引分片路由而设立的中间Proxy层成为性能瓶颈,其RT999甚至超过100ms。这种架构带来的问题在于,上游业务对特征数量需求极大,即使缓存已扩大到500万条目,也仅能达到80%的命中率。算法工程团队通过对特征请求进行多层拆分及异步并发查询优化,但仍有少量长尾特征无法命中缓存,只能依靠C引擎响应。一旦任何一批次特征查询触发了C引擎的慢查询,这一请求的整体RT势必大幅提升,甚至可能超时。

好在C引擎同时提供了一种更先进的垂直多副本部署模式,能够去除Proxy这一中心化的瓶颈组件。未来的新架构仍会保留索引分片设计,但会利用旁路方式实现完全的去中心化。

小结

通过Wall火焰图深入分析RT性能瓶颈,并结合Trace工具验证猜想,是优化系统性能不可或缺的关键步骤。

五、结语:性能优化无止尽

性能优化没有终点,只有下一个起点。每次性能的提升,不仅是对技术边界的突破,更是为业务创造了更多可能性。本文分享的场景和实操经验,旨在抛砖引玉,帮助各位同学掌握深度性能分析的方法论,避免走弯路,更高效地解决工程难题。希望每位研发和SRE同学,都能从微妙的细节中捕捉优化机会,让应用在极致性能的路上稳步前进。

往期回顾

1.得物自研DScript2.0脚本能力从0到1演进

2.社区造数服务接入MCP|得物技术

3.CSS闯关指南:从手写地狱到“类”积木之旅|得物技术

4.从零实现模块级代码影响面分析方案|得物技术

5.以细节诠释专业,用成长定义价值——对话@孟同学 |得物技术

文 / 月醴

关注得物技术,每周更新技术干货

要是觉得文章对你有帮助的话,欢迎评论转发点赞~

未经得物技术许可严禁转载,否则依法追究法律责任。

相关推荐

压测AI Agent 治理与评测调优实践|得物技术

本文介绍智能分析Agent在压测调试中上线后的治理闭环建设:通过Langfuse记录完整执行链路,结合用户反馈与Trace还原问题根因;利用CLI Mock固化证据数据集,实现相同场景下的回测验证。基于固定案例与五档评分机制,持续评估方案质量、延迟与成本,确保修复有效且无新问题引入,推动Agent能力迭代优化。

SmartCodeTech的博客 317

从中心调度到自驱协作多 Agent 架构的三次反转|得物技术

本文探讨多Agent系统中的控制权分配问题,提出三大协作架构:Master Agent(中心调度)、任务看板(共享状态)与Advisor(轻量咨询)。通过划清上下文边界与模型边界,强调应以信息相关性而非职业标签划分Agent。三种模式分别将决策权集中于中心、下放至共享状态、再下沉至执行者,形成控制权逐步下沉的演进路径。案例显示,合理设计可提升复杂任务的并行性、弹性与可维护性。

SmartCodeTech的博客 420

Jev 实战:为AI工作流引入轻量决策层 x10倍提速|得物技术

完成这三个场景后,我对适用边界有了更明确的认识:它们都可以先定义答案范围,再根据判断结果驱动下一步操作。接入时,我会优先明确输入、选项、采纳条件和兜底路径,再评估Jev是否适合承担这一环节。结合这些实践,我更容易理解Jev(TypeSafe System One)作为专用结构化决策模型不生成自然语言,而是返回带概率的判断结果。后续接入时,我会继续从脚本中边界明确的判断任务开始,分别验证准确性、耗时和费用,再决定是否扩大使用范围。下面整理了相关能力、限制和接入要点,便于查阅。

SmartCodeTech的博客 346

国产算力·昇腾 910C 大模型推理优化(下):源码修改与算子优化,提速30%|得物技术

本文延续上篇,深入vllm-ascend源码优化:通过多流重叠实现MoE共享专家并行计算,消除冗余事件开销,并解除与FUSED_MC2的互斥限制,实现c=1下TPOT从8.2ms降至8.0ms;优化decode阶段host侧开销,引入状态跟踪跳过冗余拷贝;设计Block Table CPU快路径,规避小batch下NPU kernel启动延迟;针对GDN层融合L2Norm至recurrent kernel,减少算子调用与内存往返。综合优化后推理性能显著提升,形成可复用的昇腾910C大模型推理优化方法论。

SmartCodeTech的博客 248

国产算力·昇腾 910C 大模型推理优化(上):镜像更新与参数调优,提速 40%|得物技术

文中详细给出每一项优化的动机、实现(含具体源码改动路径与关键代码片段)、验证数据与踩坑记录(包括十余项实测无效或负向的尝试),希望为同样在国产算力上做推理优化的团队提供一份可直接复用的工程参考。

SmartCodeTech的博客 227

动态规则的 Agent 实践:用确定性工程驾驭 LLM 的资产智能验收

面对财务验收中规则多变、材料非结构化、核对复杂等痛点,传统规则引擎难以应对。系统采用“规则即配置”思路,由大语言模型(LLM)负责理解合同、扫描件等非结构化材料并执行语义比对,工程系统则保障流程编排与可追溯性。通过异步处理、幂等设计、三类流量隔离及双通道(文本/图像)处理,实现高效稳定运行。结合用户反馈构建自动标准答案,辅以试跑、回测与发布门禁机制,形成闭环质量体系。底层采用确定性工作流架构,确保行为可预期、可测试,真正实现灵活规则的快速迭代与安全上线。

SmartCodeTech的博客 345

发一张图,它居然“跃“出屏幕了?一文读懂得物 3D 空间图片技术实践

3D 空间图片功能的落地,涉及模型生成、内容分发、客户端渲染之间的一系列取舍。本文重点分享如何生产出高质量、小体积的模型,以及如何在手机上流畅运行。

SmartCodeTech的博客 555

别再只卷向量检索了,得物交易搜索如何用“生成式”实现召回范式跃迁?

你搜"af1",它得给你"空军一号"。这一年,得物交易搜索把召回从"做选择题"改成了"写答案"——不再从商品池里"找"最像的,而是让模型自己"生成"你真正想要的。从 LLM 语义索引到 HLLM、语义 ID,搜索是怎么从"检索"走向"生成"的?

SmartCodeTech的博客 594

指标平台:从语义底座到智能消费的实践路径|得物技术

这篇文章想做的,不是在本体化的宏大叙事上再叠加一层理论,而是把我们在真实落地中验证过的路径讲清楚:语义底座怎么从零建立起来、怎么保证质量不失控、怎么支撑 Text2SQL 和 AI Coding 两条消费主线,以及沿着这条路径往前走,下一步该往哪个方向发力。

SmartCodeTech的博客 317

企业级 MultiAgent 落地:Plan 模式与主子 Agent 协作|得物技术

基于 AgentScope Java 的企业级 MultiAgent 平台,为研发、数据分析和知识问答等场景提供统一的模型调用、工具接入、任务编排、流式输出与运行追踪能力。

SmartCodeTech的博客 302

得物小摊 AI Native 演进实录:用 Harness 构建可控 AI 交付

AI Coding 一个人用很顺手,进了团队就漏:指令没人审、经验难沉淀、过程看不见、链路不闭环。作者团队基于 Multica 做了 EP-Harness,把 Agent 当成员管,给它套一层可执行、可观察、可治理的 Harness,并让反馈闭环。成果:可追溯决策、多 Agent 协作,高频异常从每 4 小时 2400 多条降到个位数,对得物技术补上团队级 AI 协作关键一环。

SmartCodeTech的博客 544

企业级 MultiAgent 的记忆系统:短期上下文与四层记忆架构实现|得物技术

在 MultiAgent 平台中,Agent 的"记忆"能力是实现智能对话和个性化服务的核心资产。本文深入剖析 Agent 记忆系统的设计理念与实现细节,重点解析长期记忆架构的写入与加载流程,涵盖 LLM 智能判断、语义检索、Token 预算控制、冲突处理等关键技术,为开发者提供完整的技术实现参考。

SmartCodeTech的博客 502

EP-Harness:从个人 AI Coding 到团队级 Agent 工作流|得物技术

AI Coding 个人用得爽,一到团队就崩。EP-Harness 把 Agent 从聊天工具变成团队协作成员——可管理、可追溯、可闭环。落地后高频异常从 2400+/4h 收敛到个位数。

SmartCodeTech的博客 694

得物知识问答:复合检索 Agent 的系统设计实践

从"搜到什么用什么"到"搜→筛→挖→验"自主决策闭环——我们造了一个有判断力的 RAG Agent,不是套壳。

SmartCodeTech的博客 736

实战从零开始构建一个Coding Agent:Violin |得物技术

理解了 coding agent 的构建原理,也就掌握了理解其他 agent 的一把钥匙。笔者对每天都在使用的 agent 原理很感兴趣,于是决定自己写一个:violin。

SmartCodeTech的博客 927

AI Native 交易核心系统的研发范式|得物技术

如何改造旧研发流程适配 AI 编码?本文提出五道标准化关口治理思路,依托 Claude Code Spec-Driven 插件打通需求澄清、方案设计、TDD 落地、门禁管控与埋点监控,构建带人工确认门控的完整工作流,以五层自底向上架构实现 AI 编码规范化落地。

SmartCodeTech的博客 975

推荐系统体验的数字化突破:得物自动化评测平台的技术实践|AICon 文章整理

「得物推荐 AI Harness 工程化实践系列」的末篇内容,本系列共三篇连载。本篇(末篇)详解得物推荐评测平台的完整技术体系:从主观体验量化到大模型自动化评测流水线,涵盖多维度指标设计、人机协作提示词校验闭环、分布式任务调度与成本精控等核心工程实现,以及单周百万级审计需求下实现 91% 资源成本优化的工业级落地实战细节。

SmartCodeTech的博客 1495

RAG 核心概念与原理:Chunking、Embedding、相似度、HNSW 与多路召回|得物技术

决定 RAG 效果的关键不在大模型,而是文本切块、查询改写、多路召回与精排。合理切块存好知识库内容,向量匹配抓语义、BM25 匹配关键词互补。先优化用户提问,快速召回一批相关文档,再用精排模型精细筛选,整套检索流程配合到位,问答准确度才会明显提升。

SmartCodeTech的博客 1082

从“机械应答“到“服务伙伴“:得物高可控智能客服的 Agent 工程实践|AICon 演讲整理

本次分享围绕以下核心技术展开:客服 Agent 挑战与架构设计(Single-Agent→Multi-Agent→Harness);高可控性数据飞轮(PE 自动化 + DPO 训练);RL 策略训练和人工经验对齐;多轮半双工消息流控制。

SmartCodeTech的博客 755

得物推荐系统诊断 Agent:从 “调接口” 到 “会思考”|AICon 演讲整理

本文是得物技术专家在 AICon 上海演讲整理的技术实录。AICon上海2026_全球人工智能开发与应用大会暨大模型应用生态展_InfoQ技术大会「得物推荐 AI Harness 工程化实践系列」的中篇内容,本系列共三篇连载。本篇(中篇)进一步详解得物推荐复杂业务场景下,AI代码从生成、防护校验到安全上线的完整技术体系、自研AI Harness整体架构框架、全流程安全防护机制、混合智能体核心算法实现,以及工业级工程落地的实战细节。

SmartCodeTech的博客 1365

得物 OceanBase 落地实践

得物选型OceanBase多模数据库应对业务挑战,通过验证其高可用架构、存储压缩技术及混合负载处理能力。测试显示OceanBase在复杂查询场景性能较MySQL提升130-200倍,在高并发TP/AP混合场景表现优异,存储成本降低40%+。通过DBA内部报表业务试点验证其稳定性后,逐步推广至核心业务场景,优化数据库技术栈,实现性能与成本的双重收益。

SmartCodeTech的博客 1385

AI UITester:AI Native 的 UI 自动化测试新范式|得物技术

ai_uitester 代表了 AI Native 的 UI 自动化测试新范式:这不仅是工具的升级,而是测试范式的转变 ------ 从 "代码驱动" 转向 "视觉驱动",从 "人工调试" 转向 "AI 自愈",从 "三端分离" 转向 "统一抽象"。

SmartCodeTech的博客 780

从狂野代码到按目标生产:得物推荐 AI Harness 的工程化实践|AICon 演讲整理

本文是得物技术专家在 AICon 上海演讲整理的技术实录。「得物推荐 AI Harness 工程化实践系列」的开篇内容,本系列共三篇连载。将系统拆解得物推荐复杂业务场景下,AI 代码从生成、防护校验到安全上线的完整技术体系,逐一详解自研 AI Harness 整体架构框架、全流程安全防护机制、混合智能体核心算法实现,以及工业级工程落地的实战细节。本篇(上篇):将整体介绍团队自研的 AI Harness 体系,包括建设思路、全生命周期防护机制、混合智能体架构及落地效果。

SmartCodeTech的博客 1082

从表单到 Agent:得物社区活动搭建的 AI 实践之路

一场营销活动从策划到上线,运营要在三个系统间跳转 10 + 次、填写 40 + 个字段。我们用 AI 重新设计了这条链路 —— 从 “AI 帮你填表单” 到 “两阶段 Agent + 聚合工作台”。这篇文章记录的不是技术细节,而是这条路上的选择和反思。

SmartCodeTech的博客 745

从埋点需求到规则资产:Hermes Agent 重构得物数仓工作流

埋点和指标需求中,消耗数据承接方的不是生成答案,而是补齐证据链、对齐历史口径、识别下游影响,并在生产写入前留下可追溯的确认记录。本文数据承接方指承接业务需求的数据同学或业务合作伙伴;后文讨论内部研发、元数据、查询和门禁能力在流程中的角色。

SmartCodeTech的博客 657

让 Claude Code 拥有自我进化和记忆系统|得物技术

本文记录了为 Claude Code 构建的一套持久化记忆与自我学习系统的设计思路与实现细节。这套系统让 AI 助手能够跨越会话边界记住用户习惯,并在每次对话结束后自动提炼行为规律和系统信息,通过向量检索快速提取关键信息,下一次对话时主动应用,逐步进化为更懂你的编程伙伴。

SmartCodeTech的博客 994

用 LLM Agent 重构告警排查流程|得物技术

告警排查需频繁切换日志、APM、链路追踪等多个平台,耗时 10~30 分钟,且高度依赖个人经验。我们做了 Troubleshooter——用 LLM Agent 自动完成数据采集、根因分析和处置建议生成。上线后中位数排查耗时从 20 分钟降到 4.4 分钟,覆盖 11 个服务和 10+ 种告警类型。

SmartCodeTech的博客 1008

HorizonVault 技术深潜:如何在 HDD 上做出 100GB/s+ 级大吞吐分布式存储|得物技术

HorizonVault是一款面向Kafka远程存储的高吞吐分布式存储引擎,通过分布式并行写入和状态感知调度解决冷数据存储的三大核心问题:吞吐瓶颈、性能抖动和恢复能力。系统采用分层架构,Meta负责全局资源调度,Broker处理请求路由,Store实现本地磁盘管理,形成完整的写入治理链路。通过将HDD磁盘提升为一等资源,实现顺序追加写入、多盘并行和慢盘隔离,在保证高吞吐的同时控制延迟。存储结构采用DiskStore组织磁盘资源,LogSegment顺序写入数据,IndexSegment定位读取,Change

SmartCodeTech的博客 892

Claude Code Harness 工程:数仓侧落地方案|得物技术

Harness 工程通过职责分层实现研发流水线可靠性提升。Claude 负责需求理解与代码生成等语义层工作;hooks 负责规范检查等确定性执行;Subagents 隔离血缘查询、自测等高 token 操作;Memory 承载跨会话状态持久化。四层协同使数仓 AI 开发从"对话式辅助"转变为"规则驱动的自动化流程"。

SmartCodeTech的博客 1103

BP Claw 破解 AI 编码输入难题 ——FlinkSpec 需求智能化实践|得物技术

本文为 FlinkSpec 系列之开篇,亦是这场工程化变革的序章。BP Claw 所立之处,不过链路之源。FlinkSpec 所图,乃以 AI 之力,将实时数仓从需求落地至验收上线的全程工序,熔铸为一套精密自洽、生生不息的智能工程体系。宏图未竟,后续系列将逐章揭幕,敬请期待!

SmartCodeTech的博客 1039
上一篇: 得物自研DScript2.0脚本能力从0到1演进
下一篇: 得物研发自测 & 前端自动化测试体系建设
得物技术
得物技术 得物技术官方账号 得物技术官方账号
博客等级 码龄6年 2492粉丝 408原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值