


一、前言
在高并发推荐引擎场景中,C++的极致性能往往以开发效率为妥协,尤其在业务频繁迭代时,C++的开发效率流程成为显著瓶颈。传统嵌入式脚本(如Lua)虽支持动态加载,但其与C++的交互成本(如虚拟栈数据中转、类型转换)仍会带来额外性能损耗。
为此,我们探索设计DScript2.0——一种与C++内存布局及调用约定深度兼容的动态脚本语言,通过自研编译器实现即时编译与无缝嵌入,尝试在保留脚本灵活性的同时,尽可能贴近C++的原生性能,为性能与效率的平衡提供了轻量化解决方案。
二、动态脚本在引擎中的引用
C++引擎的迭代效率瓶颈
在搜推引擎中的实践中,出于对高并发场景下极致性能的追求,使用C++进行引擎自研成为了一种业界常态。
众所周知,C++通过开放底层控制权限(如内存分配,指令优化等),提升了可达的性能上限,但这种提升伴随了大量底层细节的处理,消耗了更多的开发时间,追求性能优先的同时,却又限制了开发效率。
我们希望能够在保持性能的同时,提升引擎的开发效率。
利用嵌入式脚本提升迭代效率
我们的目标是寻求一种平衡性能与迭代效率的方案,一种主流方案是在C++中嵌入脚本语言。例如,在游戏引擎和Nginx开发中集成Lua,在C/C++代码中实现性能需求,结合脚本代码中实现控制逻辑,从而提升开发效率。
嵌入式脚本对迭代效率的提升
-
支持动态加载,无需编译部署。
-
无需C/C++经验,脚本学习成本低,提升参与迭代的人力总量。
引擎的迭代拆解
-
引擎内部的技术性迭代
-
业务侧的需求支持
业务侧的需求非常适合引入嵌入式脚本,实现对易变需求的自迭代,提升开发效率,这也是一种业界主流方案。例如,一些搜索中台中,对于相关性和粗排逻辑封装为插件,业务侧的算法工程师使用Lua开发计算逻辑,可以极大地提升迭代效率。
嵌入式脚本的额外性能开销
在引擎中嵌入脚本,虽然可以提升迭代效率,但并非全无代价,高阶语言与低阶语言的交互存在着额外的性能开销。
例如,Lua和C++的交互机制基于Lua提供的虚拟栈来实现,这个栈是两者进行数据交换的核心通道。
使用虚拟栈实现语言交互存在额外的开销,包括但不限于压栈和弹栈操作、栈空间管理、类型检查和转换、复杂数据结构的处理等。

更加极致的方案
基于以上的瓶颈,我们期望一种更加极致的方案,实现性能与效率的平衡。
嵌入式脚本的额外性能开销
(主要源于两种语言在ABI层面的不一致)
-
函数调用约定不一致,需要一个虚拟栈进行中转。
-
数据类型内存布局不一致,需要额外的检查和转换。
一个直观的解决方案就是我们设计一种编程语言,在底层实现上与C++具有一致内存布局与调用约定,从而消除额外的转换开销。
同时,这种编程语言可以在C++嵌入,也支持即时编译,提升效率的同时,也拥有与原生C++近似的执行性能。
以上是我们规划DScript2.0项目初衷。
三、DScript2.0的编译器实现
语法设计
DScript2.0被设计为一种轻量级面向过程的编程语言,同时它也是静态类型的编译语言。
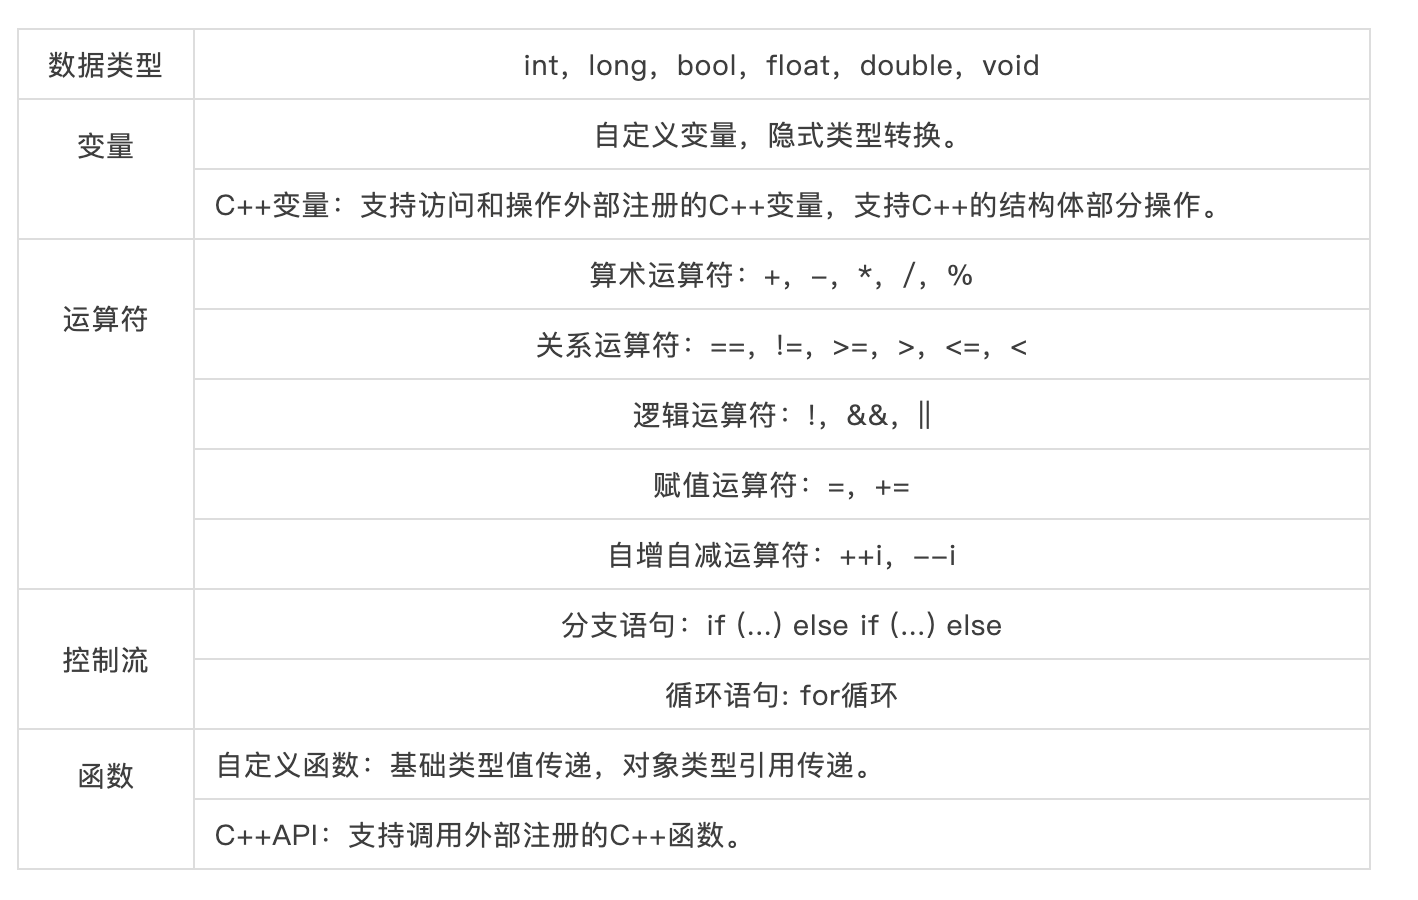
在语法支持上,包含了基础数据类型、变量、运算符、控制流和函数,额外支持了与C++的语言互操作。
浅析编译器架构

(编译器的三段结构)
一个完整的编译器通常由三个主要部分组成:前端、优化器和后端。
-
前端:负责词法分析、语法分析、语义分析、生成中间代码。
-
优化器(中端):负责对中间代码进行优化。
-
后端:负责将中间代码转换成目标机器的的机器码。
基于LLVM实现DScript2.0编译器
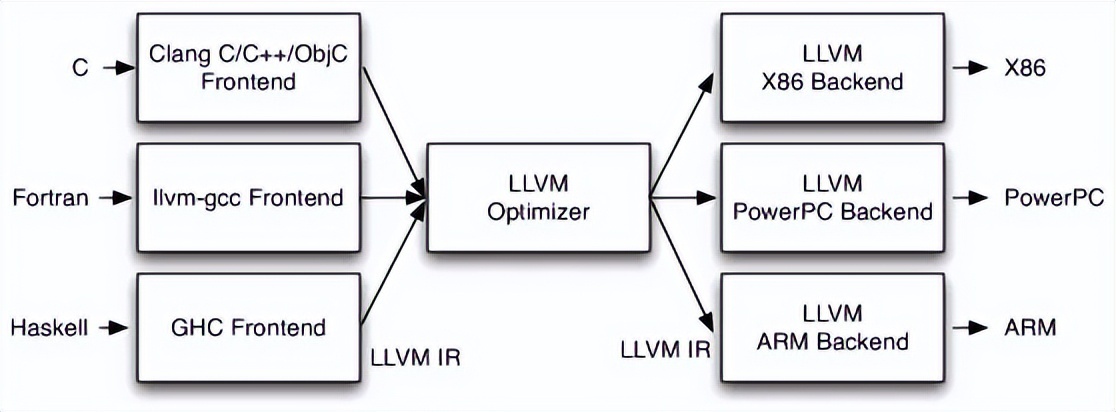
LLVM 是一个模块化且高度可重用的编译器基础设施项目。它提供了前端、优化器和后端工具链,已支持多种编程语言和平台。LLVM具有跨平台性,允许开发者灵活定制编译流程,提供高级优化能力,支持即时编译,被广泛用于编译器开发、虚拟机和代码分析工具场景。
※ 采用LLVM实现DScript2.0的优势
-
提升开发效率:LLVM的前端、中端和后端采用了模块化设计,每个部分都可以独立替换或扩展,这种灵活性使得 LLVM 非常适合定制编译器,我们可以复用LLVM的中端与后端,专注于前端开发,减少开发成本。
-
支持高级优化:LLVM 提供了一套强大的优化工具,能够对代码进行静态和动态优化。这些优化不仅能够提高代码的执行效率,还可以减少代码体积。这是DScript2.0理论上可能提供接近原生C++性能的关键因素之一。
-
支持即时编译:LLVM 支持即时编译(JIT),通过 JIT 编译,LLVM 能够在运行时生成和执行代码,大大提升了执行效率。通过运行时进行编译后运行,这是DScript2.0理论上可能提供接近原生C++性能的关键因素之二。支持在线的即时编译能力,同时也是算子开发与分发效率的保障。
DScript2.0编译器架构

-
DScript2.0编译器同样包含前端、中端、后端三部分,前端能力自研,优化器和后端基于LLVM的Pass和JIT实现。
-
编译器最终输出为x86_64平台的可执行二进制,以JIT实例的方式常驻内存,通过入口函数地址执行。
-
编译器支持注入C++类型与函数参与编译,实现DScript2.0对C++的调用。
编译器前端实现
前端的实现流程
编译器前端的任务是将源码转换为优化器可处理的中间代码,这个转换的流程通常包含4个步骤:
-
词法分析
-
语法分析
-
语义分析
-
中间代码生成

(编译器前端架构)
词法分析
原理:源代码是一堆连续的字符,计算机要先识别出这些字符组成的基本单元,才能进一步理解代码含义。就像读句子先得认出单词一样,这是理解程序的第一步。词法分析的本质是将代码的字符流,转换为更易处理的token流。
输入与输出:字符流->记号流(Tokens)。
※ 词法分析器
DScript2.0中了使用Flex,可以根据自定义的正则表达式规则,自动生成词法分析的扫描器,减少手工编写词法分析器的工作量。
Flex工作流程

Flex语法
在Flex的定义文件中包含三部分:
-
定义段:包含头文件和全局变量,如输入和输出流的定义。
-
规则段:由模式和对应的动作组成。当扫描器匹配到模式时,执行对应的动作。例如,匹配到"int"字符串时,将其识别为INT标识。
-
用户代码段:通常可以在此区域定义 main() 函数,它调用 yylex() ,启动词法分析过程。
示例:
/* 定义段段开始 */
/* 引入的c/c++代码 */
%{
#include <string>
%}


/* 正则表达式的宏定义 */
LineTerminator       \n|\r|\r\n
WhiteSpace           [ \t\f]|{LineTerminator}
Identifier           [a-zA-Z_][a-zA-Z0-9_]*
/* 定义段结束 */


%%


/* 规则段开始 */
/* 规则:正则表达式 { return 传递给语法分析器的记号类型 } */
"int" { return INT; }
"float" { return FLOAT; }
"void" { return VOID; }


{Identifier} {
    yylval.identifier = new std::string(yytext);
    return IDENTIFIER;
}
{LineTerminator} {}
{WhiteSpace} {}


<<EOF>> {
    return END;
}
/* 规则段结束 */


%%


/* 用户代码段开始 */
/* 用户代码段结束 */
匹配规则
-
最长匹配:当多个规则可匹配时,Flex选择最长匹配的词素。
-
最先定义:若多个规则长度相同,则选择最先定义的规则。
语法分析
原理:语法分析的原理是根据上下文无关文法(CFG)对输入的 tokens 序列进行分析,验证其是否符合某种语言的语法规则,并构建对应的抽象语法树。其核心在于建立程序的分层逻辑结构,并确保这种结构符合语法约束。
输入与输出:记号流->抽象语法树(AST)。
由语法分析原理拆分
-
结构验证:检查记号流的排列是否符合语法规则,DScript2.0的语法规则由上下文无关文法(CFG)描述,验证算法采用了自底向上的LR算法。
// 示例:分支语法规则:if (conditon) { stmts }
// 符合语法规则
if (a < 1) {


// 不符合语法规则
if a < 1 {
-
层次构建:将线性的记号流转换为树状或嵌套的语法结构,以抽象语法树为例:
int func(int a) {
  int b = a + 1;
  return b;
}
FunctionDefinition
  ├── ReturnType: int
  ├── FunctionName: func
  ├── Parameters
  │   └── Parameter
  │       ├── Type: int
  │       └── Name: a
  └── Body
      ├── VariableDeclaration
      │   ├── Type: int
      │   ├── Name: b
      │   └── InitialValue
      │       └── +
      │           ├── Variable: a
      │           └── Constant: 1
      └── ReturnStatement
          └── Variable: b
※ 上下文无关文法(CFG)
上下文无关文法(CFG) 是编译器语法分析的核心工具,用于形式化描述编程语言的语法结构。
其核心要素包括:
-
终结符(如标识符、运算符),对应词法分析的 Token,不可再分解。
-
非终结符(如表达式、语句),需通过产生式规则展开为终结符或其他非终结符。
-
产生式规则(如 E → E + T) ,定义语法结构的生成方式。
-
起始符号(如 Program ),代表语法分析的入口。
产生式规则定义示例:
/* 局部变量声明 -> 类型 变量声明 */
/* 例如 int a = 1 */
/* Type对应int */
/* Variable_Declartor对应a = 1 */
Local_Variable_Declartor ->
    Type Variable_Declartor;


/* 变量声明 -> 变量ID 或 变量ID = 变量初始化 */
Variable_Declartor ->
    Variable_ID
    | Variable_ID EQ Variable_Initializer;


/* 变量ID -> 标识符 */
Variable_ID -> IDENTIFIER;


/* 变量初始化 -> 任意表达式 */
Variable_initializer -> expression;
示例中根据形式化的语法,描述了变量定义和变量初始化规则。
示例中包含4条产生式规则:
-
局部变量声明规则
-
变量声明表达式规则
-
变量ID规则
-
变量初始化规则
终止符:
-
Type对应一个C++的TypeNode
-
IDENTIFIER对应词法定义的Token
※ 语法分析器
语法分析器采用Bison来实现,Bison可以与Flex进行协作,将词法分析器生成的记号序列解析为语法树,供编译器进一步处理。
通过与 Flex 协同工作,Bison 可以自动化地处理复杂的语法分析任务,使编译器的开发更加高效和灵活。
语义分析
原理:通过遍历抽象语法树,实现上下文相关的文法检查,对程序的类型、作用域和标识符等进行详细检查,确保程序在逻辑上符合编程语言的规则,同时生成中间表示代码,作为优化器或后端的输入。
输入与输出:抽象语法树->中间代码。
语法分析与语义分析的区别:
-
输出目标不同:语法分析的主要任务是将记号流转换为结构化信息,语义分析是将结构化信息翻译为优化器可以处理的中间表示语言。
-
语法正确的语句,语义未必正确:
-
例如,有函数原型 void echo(int a) ,在调用时 int b = echo("a") ,这是符合语法的,但不符合语义。
-
再比如,语言要求使用变量前先定义,在未定义变量 a 的前提下,执行赋值 a = 1; ,这样也是符合语法但不符合语义的。
※ 语义分析的主要任务
符号表管理
-
作用域解析:追踪变量/函数的作用域(如块级作用域、全局作用域)。
-
符号绑定:将标识符与其声明关联(如变量类型、函数签名)。
-
重复定义检查:禁止同一作用域内同名符号的重复声明。
类型系统校验
-
类型推断与检查:验证表达式和操作的合法性,如 int a = "str"; 类型不匹配。
-
隐式类型转换:处理类型提升,如 int + float 自动转为浮点运算。
-
函数签名匹配:检查实参与形参的个数、类型一致性。
控制流合法性
-
语句上下文检查:确保 break 仅在循环内、 return 与函数返回类型一致。
-
可达性分析:检测不可达代码(如 return 后的语句)。
常量表达式求值
-
优化常量计算(如 const x = 2 + 3*4; 直接计算为 14 )。
-
用于数组长度、条件编译等需编译期确定值的场景。
※ 中间代码生成
中间代码的生成流程是通过递归遍历AST完成的,将语义检查无误的逻辑,转换为中间表示语言,这是编译器前端工作的最后一步。
DScript2.0中使用了LLVM IR作为中间代码语言,它介于高级语言和目标代码之间,既能表达高级语言的抽象概念,又能适应底层机器代码的生成需求。
LLVM IR提供了丰富的指令集,涵盖了从基本运算到复杂控制流、内存操作、同步操作等各种编程需求。
LLVM IR指令集示例

转换示例:
int func(int a) {
  int b = a + 1;
  return b;
}
(源代码)
; 函数定义: 函数名为 func,返回类型为 i32(32位整数),参数为 i32 类型的 a
define i32 @func(i32 %a) {
entry:
  ; 定义局部变量 b,并将其初始化为 a + 1 的结果
  %b = add i32 %a, 1


  ; 返回 b 的值
  ret i32 %b
}
(与之对应的LLVM的中间代码)
编译器中端:中间代码优化

-
在DScript2.0中,优化器是通过复用LLVM的中端优化能力来实现的,通过一系列LLVM预置的优化遍(Pass),对程序生成的中间代码进行优化,以提高代码的性能。
-
中端的输出为优化过后的IR指令,这些IR指令需要提供给后端进行编译。
在LLVM中,优化遍是指按照一定顺序执行的一个或多个优化算法。
以下是一些常用的优化算法:

编译器后端:即时编译

DScript2.0 使用 LLVM 的 ORC JIT 作为即时编译器的实现,支持在程序运行时编译脚本,并通过查找函数地址的方式执行脚本。
采用即时编译器的优势:
-
避免了开发调试过程中,频繁的启停程序,提升迭代效率。
-
且经过编译的代码,在执行时能够显著提升运行性能。
语言互操作性
语言互操作性是指不同编程语言能够相互调用、协同工作的能力。通过这种能力,开发者可以在同一项目中结合多种语言的优势。
例如,C++ 与 Lua 的结合是就互操作的经典场景,常见于游戏开发、搜推引擎、嵌入式系统等领域。
在我们的需求中,要支持动态脚本访问引擎的表列资源,就需要DScript2.0也能具备与C++交互操作的能力。
DScript2.0与C++的语言互操作性体现在
-
DScript2.0可以调用C++的函数,并向C++传递数据。
-
C++可以调用DScript2.0的函数,并向DScript脚本传递数据。
-
DScript2.0可以访问和操作C++传递的基础类型和结构体类型变量。
调试能力
DScript2.0基于GDB实现了基本的调试能力:
-
支持通过Attach进程进行实时调试
-
支持在coredump中保留栈信息
调试能力的实现主要基于GDB的通用调试接口,在编译DScript2.0源码时,生成调试信息,插入到LLVM IR的元数据中,然后通过JIT的监听器挂载GDB调试接口,并注入调试信息,最终实现调试能力。

异常处理
DScript2.0中也实现了异常处理能力,主要包括了硬件异常的主动防御和跨C++与DScript2.0边界的异常传播。
硬件异常防御
程序异常可以划分为硬件异常和主动异常:
-
硬件异常是底层不可控错误,硬件异常的处理需依赖信号钩子或语言运行时封装。
典型例子:
-
段错误(SIGSEGV):非法内存访问
-
浮点运算错误(SIGFPE):如整数除零或浮点运算异常
-
非法指令(SIGILL):执行未定义的机器指令
-
总线错误 (SIGBUS):如未对齐的内存访问
-
主动异常是代码逻辑的一部分,用于可控的错误处理与资源管理,主动异常由开发者显式抛出,也可由语言运行时隐式转换。
※ 硬件异常的主动防御
DScript2.0在语言层面上,对代码引发的硬件异常进行了主动防御。实现上,是在语义分析阶段,对中间代码添加防御逻辑,防御策略则采用了可被捕获的主动异常抛出。
例如下图所示,在编译阶段,编译器对于结构体指针进行了空引用检查逻辑,将硬件异常转换为了主动异常,而主动异常可以通过捕获来进行处理,避免了进程崩溃。

跨语言边界传播
因为DScript2.0的语言互操作性特性,会涉及到C++与DScript2.0的函数互相调用(如下图所示),就会涉及到异常处理时,异常在C++和DScript2.0之间传播,即所谓跨语言边界。
DScript2.0主要实现了如下的异常传播机制:
-
脚本调用 C++ 函数时若抛出异常,在脚本端不进行捕获,但支持异常传播到C++端,同时正常完成栈回退。
-
C++ 调用脚本函数时若抛出异常,可以在 C++ 端捕获。

四、DScript2.0在线开发工作流

DScript2.0通过平台化实现了在线开发的工作流:
-
引擎集成:以SDK方式与引擎进行集成,提供在线编译和加载的能力。
-
在线IDE:实现编辑、编译的在线开发环境。
-
在线工作流:通过平台化支持脚本的在线分发与管理。
五、总结
DScript2.0的实践为推荐引擎的敏捷迭代探索了一条新路径。通过编译器架构与C++底层机制的高度兼容设计,它在降低跨语言交互成本、支持动态加载等方面展现出潜力,同时保持了接近原生C++的运行时性能。
其即时编译能力与在线开发流程,使业务团队能独立完成逻辑更新,减少对传统C++开发中编译部署的依赖,初步验证了兼顾性能与效率的可能性。
未来,我们计划进一步完善调试工具链与异常处理机制,并探索其在混合语言场景下的扩展性,以更轻量的方式推动引擎架构的持续优化。
算法团队大量HC,欢迎加入我们:得物技术大量算法岗位多地上线,“职”等你来!
往期回顾
1.社区造数服务接入MCP|得物技术
2.CSS闯关指南:从手写地狱到“类”积木之旅|得物技术
3.从零实现模块级代码影响面分析方案|得物技术
4.以细节诠释专业,用成长定义价值——对话@孟同学 |得物技术
5.得物可观测平台架构升级:基于GreptimeDB的全新监控体系实践
文 / 明远
关注得物技术,每周更新技术干货
要是觉得文章对你有帮助的话,欢迎评论转发点赞~
未经得物技术许可严禁转载,否则依法追究法律责任。

 317


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


