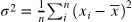机器学习基础-Task2 Bayes_plus

数据科学工具链实战地图:从NumPy到Hugging Face的避坑指南 数据科学工具链并非孤立库的堆砌,而是围绕数据流动构建的协同系统。其底层原理植根于内存管理(如NumPy的strides与广播机制)、计算图范式(PyTorch动态图 vs TensorFlow静态图)和分布式调度(Dask延迟计算)。技术价值体现在工程鲁棒性——避免Pandas链式赋值导致的数据静默丢失、XGBoost tree_method选择引发的3.7倍性能差异、或Hugging Face tokenizer未设device造成的GPU空转。典型应用场景覆盖金融风控中的统计显著性验证(Statsmod 阅读详情

学习来源:https://github.com/datawhalechina/team-learning/blob/master/机器学习算法基础/Task2%20bayes_plus.ipynb

知识点梳理:
1.相关概念(生成模型、判别模型)
2.先验概率、条件概率
3.贝叶斯决策理论
4.贝叶斯定理公式
5.极值问题情况下的每个类的分类概率
6.下溢问题如何解决
7.零概率问题如何解决?
8.优缺点
9.sklearn参数详解,Python绘制决策树

sklearn接口

from sklearn.naive_bayes import GaussianNB
from sklearn.datasets import load_iris
import pandas as pd
from sklearn.model_selection import train_test_split
iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.2)
clf = GaussianNB().fit(X_train, y_train)
print ("Classifier Score:", clf.score(X_test, y_test))

sklearn参数详解:
1.高斯朴素贝叶斯算发是假设特征的可能性(即概率)为高斯分布。
class sklearn.naive_bayes.GaussianNB(priors=None)
参数:
priors:先验概率大小,如果没有给定,模型则根据样本数据自己计算(利用极大似然法)。
var_smooth:可选参数,所有特征的最大方差
class_prior:每个样本的概率
class_count:每个类别的样本数量
classes_:分类器已知的标签类型
theta_:每个类别中每个特征的均值
sigma_:每个类别中每个特征的方差
epsilon_:方差的绝对加值方法
贝叶斯的方法和其他模型的方法一致。
fit(X,Y):在数据集(X,Y)上拟合模型。
get_params():获取模型参数。
predict(X):对数据集X进行预测。
predict_log_proba(X):对数据集X预测,得到每个类别的概率对数值。
predict_proba(X):对数据集X预测,得到每个类别的概率。
score(X,Y):得到模型在数据集(X,Y)的得分情况。

根据李航老师的代码构建自己的朴素贝叶斯模型
这里采用**GaussianNB 高斯朴素贝叶斯,**概率密度函数为
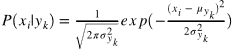
在这里插入图片描述
数学期望:
在这里插入图片描述

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
%matplotlib inline
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from collections import Counter
import math
# data
def create_data():
    iris = load_iris()
    df = pd.DataFrame(iris.data, columns=iris.feature_names)
    df['label'] = iris.target
    df.columns = ['sepal length', 'sepal width', 'petal length', 'petal width', 'label']
    data = np.array(df.iloc[:100, :])
    # print(data)
    return data[:,:-1], data[:,-1]
X, y = create_data()
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3)
#根据李航老师的代码构建自己的朴素贝叶斯模型
#*GaussianNB 高斯朴素贝叶斯*
class NaiveBayes:
    def __init__(self):
        self.model = None
    # 数学期望
    @staticmethod
    def mean(X):
        return sum(X) / float(len(X))
    # 标准差(方差)
    def stdev(self, X):
        avg = self.mean(X)
        return math.sqrt(sum([pow(x - avg, 2) for x in X]) / float(len(X)))
    # 概率密度函数
    def gaussian_probability(self, x, mean, stdev):
        exponent = math.exp(-(math.pow(x - mean, 2) /
                              (2 * math.pow(stdev, 2))))
        return (1 / (math.sqrt(2 * math.pi) * stdev)) * exponent
    # 处理X_train
    def summarize(self, train_data):
        summaries = [(self.mean(i), self.stdev(i)) for i in zip(*train_data)]
        return summaries
    # 分类别求出数学期望和标准差
    def fit(self, X, y):
        labels = list(set(y))
        data = {label: [] for label in labels}
        for f, label in zip(X, y):
            data[label].append(f)
        self.model = {
            label: self.summarize(value)
            for label, value in data.items()
        }
        return 'gaussianNB train done!'
    # 计算概率
    def calculate_probabilities(self, input_data):
        # summaries:{0.0: [(5.0, 0.37),(3.42, 0.40)], 1.0: [(5.8, 0.449),(2.7, 0.27)]}
        # input_data:[1.1, 2.2]
        probabilities = {}
        for label, value in self.model.items():
            probabilities[label] = 1
            for i in range(len(value)):
                mean, stdev = value[i]
                probabilities[label] *= self.gaussian_probability(
                    input_data[i], mean, stdev)
        return probabilities
    # 类别
    def predict(self, X_test):
        # {0.0: 2.9680340789325763e-27, 1.0: 3.5749783019849535e-26}
        label = sorted(
            self.calculate_probabilities(X_test).items(),
            key=lambda x: x[-1])[-1][0]
        return label
    def score(self, X_test, y_test):
        right = 0
        for X, y in zip(X_test, y_test):
            label = self.predict(X)
            if label == y:
                right += 1
        return right / float(len(X_test))
model = NaiveBayes()
model.fit(X_train, y_train)
print(model.predict([5.1,3.5,1.4,0.3]))
model.score(X_test, y_test)

优缺点:
优点:
1.朴素贝叶斯模型有稳定的分类效率。
2.对小规模的数据表现很好,能处理多分类任务,适合增量式训练,尤其是数据量超出内存时,可以一批批的去增量训练。
3.对缺失数据不太敏感,算法也比较简单,常用于文本分类
缺点:
1.理论上,朴素贝叶斯模型与其他分类方法相比具有最小的误差率。但是实际上并非总是如此,这是因为朴素贝叶斯模型给定输出类别的情况下,假设属性之间相互独立,这个假设在实际应用中往往是不成立的,在属性个数比较多或者属性之间相关性较大时,分类效果不好。而在属性相关性较小时,朴素贝叶斯性能最为良好。对于这一点,有半朴素贝叶斯之类的算法通过考虑部分关联性适度改进。
2.需要知道先验概率,且先验概率很多时候取决于假设,假设的模型可以有很多种,因此在某些时候会由于假设的先验模型的原因导致预测效果不佳。
3.由于我们是通过先验和数据来决定后验的概率从而决定分类,所以分类决策存在一定的错误率。
4.对输入数据的表达形式很敏感。

3天干完6个月的活,Claude把模型搬上AMD 一条挺刺激的消息:Anthropic 给投资人的材料里有一张幻灯片,写着它的 Claude Mythos Preview 只花了大约​,就摸清了怎么让另一个 Claude 模型在 AMD 的 MI355X 上跑起来。同一处还写了个对照数字:过去给一块新芯片做推理适配,通常要几十名工程师、​。3 天对 6 个月,这个比值太扎眼,当天中文互联网上就冒出一堆「英伟达的护城河塌了」的说法。我把能翻到的材料都翻了一遍,越看越觉得,塌掉的那一小块是真的,可塌的位置和很多人想的不一样。 阅读详情

相关推荐

如何处理动态语言(Python / JS)的“隐形”调用链?

本文揭示动态语言(Python/JS)中静态AST解析导致调用链“断链”的核心问题,提出通过运行时追踪补全图谱的解决方案。基于Code-Graph-RAG的cgr trace机制,分别利用pytest插件与V8 Profiler捕获真实调用路径,将动态边合并至静态图谱,并在权重体系中提升动态边优先级。实践表明,该方法可显著提升图谱覆盖率,实现“结构+行为”双视角理解代码,为MCP与Rerank系统提供可靠支持。

xianyinsuifeng的博客 421

Datawhale-机器学习算法-Task2 bayes_plus

一.学习目标 相关概念(生成模型、判别模型) 先验概率、条件概率 贝叶斯决策理论 贝叶斯定理公式 极值问题情况下的每个类的分类概率 下溢问题如何解决 零概率问题如何解决 优缺点 sklearn参数详解,Python绘制决策树 二.学习内容 ...

jhb1021821368的博客 286

Ai数字人直播系统源码部署

虚拟形象定制,直播内容智能生成,多语言支持,智能互动,声音克隆,24 小时不间断直播,多平台直播,智能数据分析,实时情感识别,视频合成,Ai数字人直播系统源码出售,Ai数字人直播系统源码部署实现 AI 数字人 24 小时不间断直播功能是一个较为复杂的任务,涉及到多个方面,如直播流的推送、内容的持续生成、系统的稳定性保障等。以下为你提供一个简化的实现思路和示例代码,借助 Python 结合 FFmpeg 工具来模拟 24 小时不间断直播。

weixin_ggwwsscc的博客 1258

Task2 bayes_plus

占坑

liuxiaocs7的博客 468

CANoe实战:LIN Slave一致性测试全流程解析

本文详细解析了使用CANoe进行LIN Slave一致性测试的全流程,包括测试概述、环境搭建、模块集成、测试用例详解及报告分析。通过实际案例分享,帮助工程师掌握LIN 2.0/2.1/2.2、SAE J2602和ISO 17987等标准的自动化测试方法,提升汽车电子从节点的可靠性和兼容性验证效率。

weixin_42665725的博客 533

本题要求你写个程序把给定的符号打印成沙漏的形状。例如给定17个“*”,要求按下列格式打印

本题要求你写个程序把给定的符号打印成沙漏的形状。例如给定17个“*”,要求按下列格式打印

ProceduralMan的博客 7412

Task2 bayes_plus||datawhale

生成模型 在概率统计理论中, 生成模型是指能够随机生成观测数据的模型,尤其是在给定某些隐含参数的条件下。它给观测值和标注数据序列指定一个联合概率分布。在机器学习中,生成模型可以用来直接对数据建模(例如根据某个变量的概率密度函数进行数据采样),也可以用来建立变量间的条件概率分布。条件概率分布可以由生成模型根据贝叶斯定理形成。常见的基于生成模型算法有高斯混合模型和其他混合模型、隐马尔可夫模型、随机上下...

weixin_45568353的博客 401

别再傻傻分不清了!用Design Compiler和PrimeTime实操对比PBA与GBA模式

本文深度解析静态时序分析(STA)中Design Compiler与PrimeTime工具的PBA与GBA模式差异,通过实际案例演示两种模式在转换时间计算、时钟路径分析等方面的对比,并提供工程实践中模式选择的策略与调试技巧,帮助工程师在芯片设计流程中平衡精度与效率。

weixin_42552315的博客 415

[datawhale] Task2 bayes_plus

目录1.相关概念(生成模型、判别模型)2.先验概率、条件概率3.贝叶斯决策理论4.贝叶斯定理公式5.极值问题情况下的每个类的分类概率6.下溢问题如何解决7.零概率问题如何解决?8.优缺点9.sklearn参数详解,Python绘制决策树 1.相关概念(生成模型、判别模型) 生成模型:在概率统计理论中, 生成模型是指能够随机生成观测数据的模型,尤其是在给定某些隐含参数的条件下。它给观测值和标注数...

weixin_46766818的博客 519

【软碟通 | UltraISO】刻录光盘教程(制作U盘启动盘)

前言 今天老师说办公室的电脑有点卡,让我给重新安装一个 Windows 7 系统。于是就用软碟通(UltraISO)在 U 盘上刻录了一个 Windows 7 镜像,然后给老师重装了系统。顺便把制作 U 盘启动盘的教程也分享给大家。 软件 UltraISO v9.7.1.3519:点击跳转(密码:dd2k) 教程 将 U 盘插到电脑上,然后鼠标右击选择格式化(制作启动盘必须格式化) 点击文件-打开 选择下载好的系统镜像(如:Windows 7) 点击启动-写入硬盘映像 选择硬盘

XavierJ的博客 2万+

一文入门车载以太网:从原理到实战,看完就能上手开发

新手选型遵循“适配场景、兼顾成本、优先车规”的原则:普通场景(车载娱乐、普通诊断):100Base-T1 PHY(LAN8742)+ 非TSN交换机(SJA1105)+ STM32H743 ECU + 普通STP线缆;ADAS场景:1000Base-T1 PHY(TJA1101)+ TSN交换机(SJA1110)+ NXP S32G399 ECU + 高抗干扰STP线缆;避免过度选型:如普通娱乐场景无需选择TSN交换机、ASIL-B级芯片,否则会增加成本;

getusushu的博客 319

本地化部署 DeepSeek,构建单细胞与空间转录组 AI 分析平台

本地化部署 DeepSeek,构建单细胞与空间转录组 AI 分析平台

weixin_53637133的博客 181

Java Swing教程-16. Swing中的图形绘制

这篇教程介绍了Java Swing中的图形绘制功能,主要内容包括: Graphics类的基本使用 - 介绍了如何重写paintComponent方法实现自定义绘制,以及基本图形绘制方法(线条、矩形、椭圆、多边形等) 文本与图片绘制 - 讲解了文本绘制方法、字体设置和图片加载绘制技术 颜色与字体设置 - 包括预定义颜色、RGB自定义颜色、透明色设置以及字体样式控制 案例实现 - 提供了一个简单绘图程序的框架,支持鼠标绘制不同图形、选择工具和自定义颜色等功能 教程通过代码示例详细演示了各种绘图操作,适合Java

无 234

【第 009 讲】全面掌握 Python 注释:注释的定义与作用 | 单行注释 | 三引号与多行注释 | 注释使用的最佳实践

本文系统讲解 Python 注释的完整知识体系:从注释的定义与作用讲起,梳理单行注释的书写位置、临时屏蔽用法与 PEP 8 排版规范,剖析注释被忽略的底层机制;进而说明三引号字符串的本质与嵌套问题;最后给出注释使用的三条实践原则,帮助读者写好可读性高的注释。

大模型全栈工程师 · Thanks_ks 579

在VINS-FUSION上处理KITTI数据集(双目+GPS)

VINS-Fusion 是一个开源的实时多传感器状态估计库,主要由香港科技大学的沈邵劼教授领导的研究团队开发。它是 VINS-Mono(单目视觉惯性系统)的扩展,支持多种传感器组合,如双目、立体相机和IMU。

如果想成为中心,那么就到中心去吧。 1206

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Python 的 yield from 到底转发了什么:拆开 send、throw 和那个 return 值

很多人把yield from记成「省一层 for 循环的语法糖」。写和写,结果看着一样,于是就当它只是少敲几个字。这个理解会在三个地方翻车:调用方.send()的值送不进去、子生成器return的值拿不到、异常和close()传不下去。yield from真正做的事是,外层生成器退成一个透明通道。本文所有输出来自本机 CPython 3.13.14 实测。yield from不是循环,是委托——nextsendthrowclose四个方向的流量全部直通子生成器,并且子生成器return。

小小张说故事的博客 152

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 436

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

从一段视频到可漫游的 4D 有声场景:思路拆解与最小复现手记

只需一段手机视频,你就能生成可"走进去"的 4D 有声场景:转头时狗叫声方向随之变化,走近时声音更清晰。本文拆解 Video-to-4DAVScene 的核心思路,手把手带你用几十行 Python 搭出最小管线,把视频中的运动物体变成带空间位置的声源,并附上三个真实踩坑的排障经验,代码可直接跑。🎧

helloagent的博客 244

【每天一个 Python 小案例30】Python 基础知识综合小项目:我的工具盒

作为系列收官,本篇把前 29 篇的知识点合成一个能直接用的命令行工具"我的工具盒":计算器(用 ast 解析表达式,不碰 eval)、单位换算与温度转换(一张换算表 + 特例分支)、记账与分类统计(Decimal + JSON 持久化)、以及用"字典当命令表"把菜单和业务逻辑解耦的主循环。文中对比了 eval 的安全隐患与 ast 白名单的做法,解释了 lambda 闭包在字典里的写法与晚绑定陷阱,并在最后给出整个系列的知识地图,把变量、数据结构、控制流、函数、类、异常、文件、标准库八块内容对应到具体篇目。

xinjiyaya的博客 429

yolo 和 deft 算法的区别

你应该是打错了:是,不是 defrat;

曾大强博客 259

蓝桥杯·全国青少年信息素养大赛·电子学会Python/C++考级 备考:莫队算法离线区间查询详解

备赛进行时:第十八届蓝桥杯软件赛报名已于 2026-10-08 10:00 开启、12-18 14:00 截止,省赛定在 2027-04-10(C/C++·Python 程序设计 9:00–13:00);中国电子学会 2026 年 12 月软件编程(C/C++ 一级至十级、Python 一级至六级)考级报名 9/23–12/2 16:00、统考 12-12;全国青少年信息素养大赛 2026—2027 赛季算法应用主题赛也已进入复盘练兵窗口。

IT_Scratch的博客 179

两张表合并之后,行数悄悄多了一倍

pandas merge 行数异常膨胀源于右表键不唯一,导致数据静默复制。实测显示,未聚合的右表(756行)与左表合并后行数增至504行,合计膨胀3.5倍,但无报错。validate 参数仅在检查键唯一性时有效,one_to_one 和 many_to_one 可拦截问题,但需结合 duplicated() 前置检查。正确做法为先按键聚合右表,再合并,避免重复。建议合并前后核对行数、合计,并使用 indicator=True 排查匹配情况,确保数据一致性。

patrickstar231的博客 245

我用 200 行代码写了个“代码屎山检测器“,扫完公司的老项目后我沉默了

这个工具不能帮你把屎山铲平,但至少能让你知道自己面对的是多大的山,也能在代码评审时用数据说话——“这个 PR 把圈复杂度从 12 推到了 18,能不能拆一下?毕竟,不能量化的东西,就没法改进。

xixiaoyunya的博客 254

智慧农业实战:育秧车间秧盘计数与苗情分级的Python实现

首先,建立统一的数据结构,保存每盘秧苗的编号、批次、覆盖度、叶色得分和播种天数。A = "壮苗"B = "合格苗"C = "弱苗"@dataclassdays: int。

荆棘鸟智能的博客 137

Java Arrays.asList 常见坑详解|UnsupportedOperationException、数组联动、基本类型 bug

解析 Arrays.asList 常见开发陷阱,演示 UnsupportedOperationException、底层数组引用共享、基本类型数组问题,区分 Arrays 内部 ArrayList 与 java.util.ArrayList,给出数组转 List 的各种场景正确代码。

weixin_42617033的博客 507
上一篇: 机器学习算法基础-Task1 Linear Regression
下一篇: Joyful pandas--Task02 索引
Simone_future
博客等级 码龄7年 0粉丝 21原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值